
Czym jest baza danych wektorowych? Jak wyszukiwanie AI rozumie znaczenie
- Autor
- Jack Limebear
- Opublikowano
PosłuchajPosłuchaj tego artykułu
Baza danych wektorowych to system przechowywania danych, który pozwala modelom AI wyszukiwać i pobierać nieustrukturyzowane dane na podstawie podobieństwa semantycznego. Pomaga AI tworzyć odpowiedzi z wykorzystaniem wiedzy wykraczającej poza dane treningowe.
Bazy danych wektorowych przechowują informacje w formacie, który LLM-y mogą łatwo przetwarzać. Dostarczają modelom AI dodatkowe informacje, by mogły generować trafne i dokładne odpowiedzi.
Ten przewodnik wyjaśnia, czym jest baza danych wektorowych, jak działa, jakie ma typowe zastosowania i rodzaje, przedstawia przykłady oraz porównuje ją z bazami relacyjnymi i grafowymi.
Podsumowanie
- Baza danych wektorowych przechowuje wyuczone reprezentacje cech jako embeddingi wektorowe w przestrzeni wielowymiarowej.
- W przeciwieństwie do tradycyjnych baz danych, które opierają się na dopasowaniu słów kluczowych, bazy wektorowe po zapytaniu zwracają dane podobne semantycznie.
- Wektorowa baza danych przechowuje dokumenty wewnętrzne, które pomagają głosowej AI i obsłudze klienta udzielać odpowiedzi uwzględniających kontekst dzięki systemowi RAG.
- Aplikacje takie jak chatboty, wyszukiwarki AI i Conversational AI korzystają z wyszukiwania semantycznego oraz obsługiwanych przez bazy wektorowe nieustrukturyzowanych typów danych.
- Wektorowe bazy danych różnią się od baz grafowych. Bazy grafowe łączą powiązane encje, aby obsługiwać wieloetapowe zapytania za pomocą algorytmów przeszukiwania grafu, a bazy wektorowe sprawdzają się w prostych zapytaniach wymagających dodatkowego kontekstu.
Czym jest baza danych wektorowych i co przechowuje?
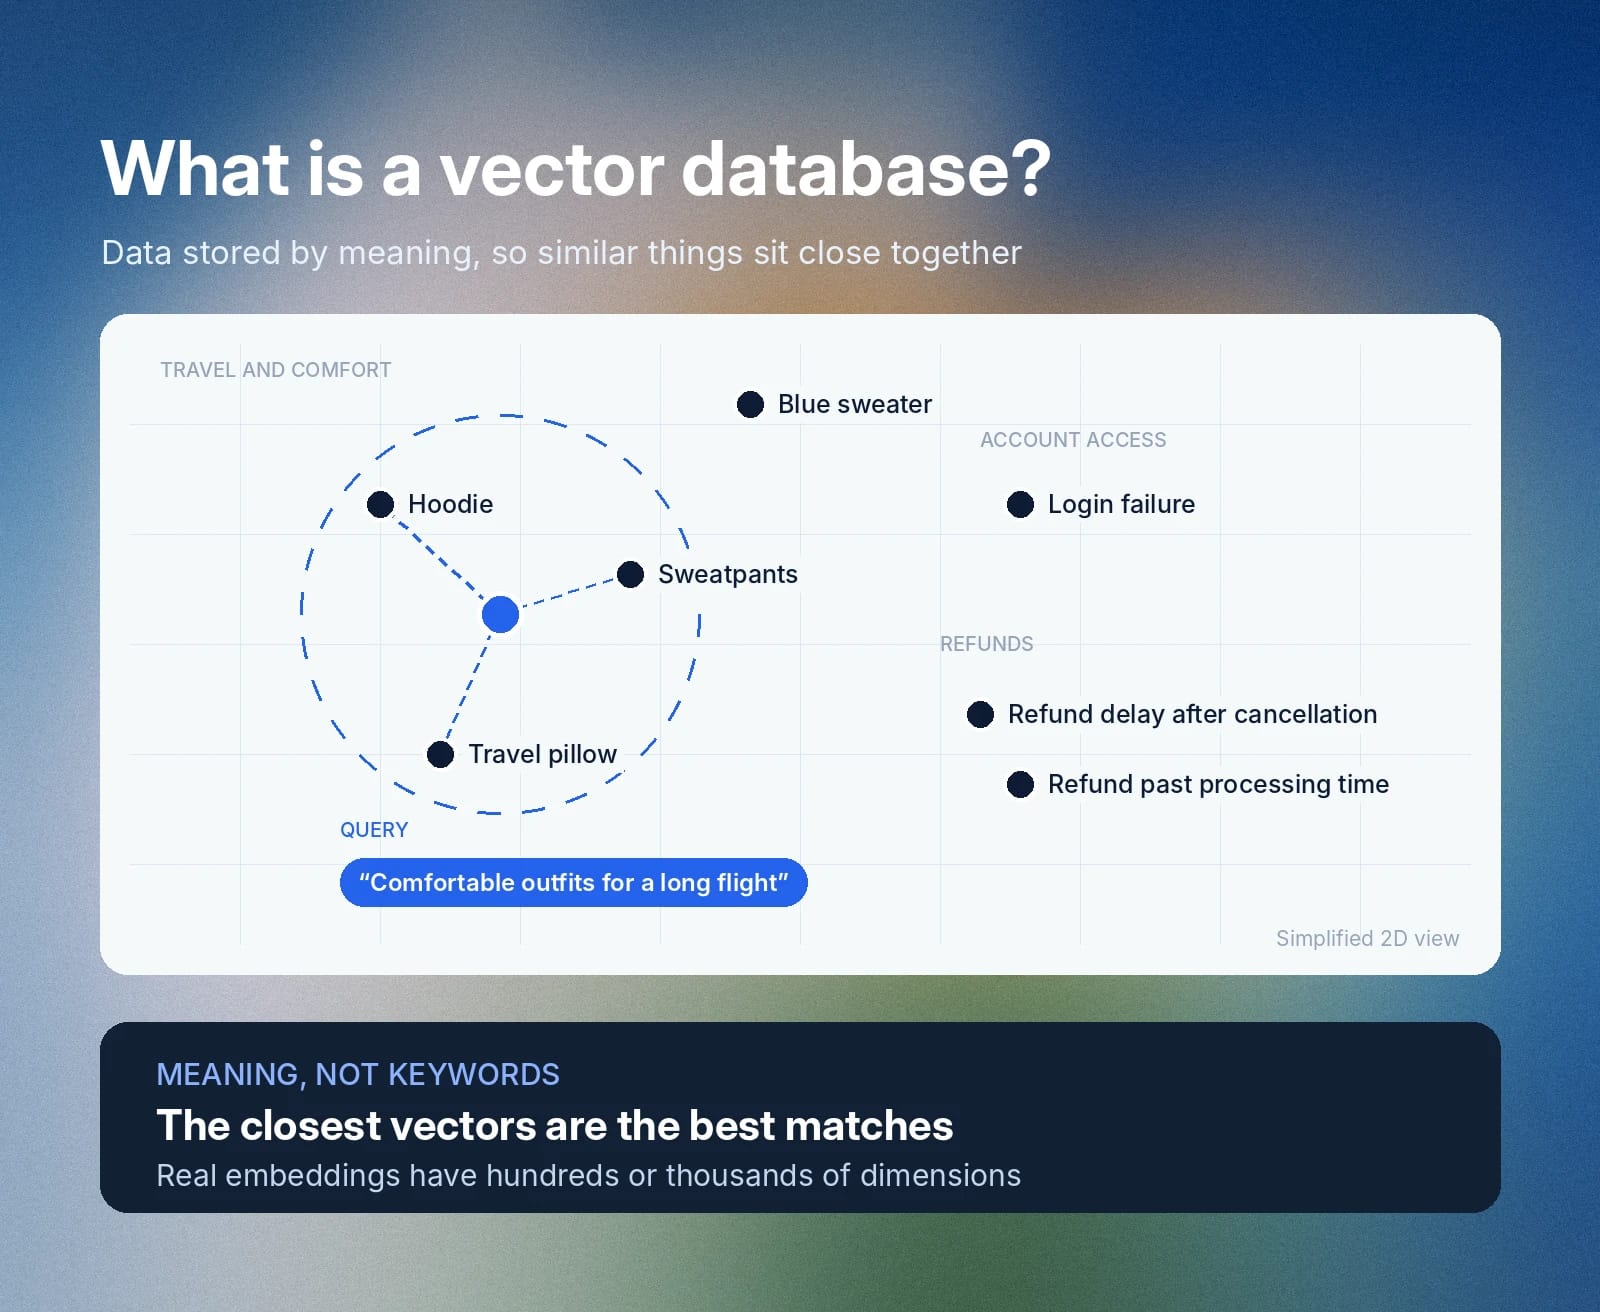
Baza danych wektorowych przechowuje dane jako reprezentacje numeryczne zwane embeddingami, umożliwiając modelom AI wyszukiwanie semantyczne z niskim opóźnieniem. W przeciwieństwie do tradycyjnej bazy danych, która przechowuje informacje w wierszach i kolumnach, wektorowa baza danych grupuje embeddingi w przestrzeni wielowymiarowej według podobieństwa semantycznego.
W AI termin „wymiar” opisuje wyuczone cechy lub właściwości konkretnego obiektu. Możesz na przykład wyobrazić sobie psa o wymiarach takich jak kolor sierści i rasa. W praktyce pojedyncze wymiary wyuczonego embeddingu rzadko odpowiadają jednej zrozumiałej cesze.
Aplikacje generatywnej AI, zwłaszcza te połączone z zewnętrznym źródłem wiedzy, używają baz danych wektorowych, by przyspieszyć pobieranie informacji. Zamiast szukać bezpośredniego dopasowania słów kluczowych w tradycyjnej bazie danych, system pobierający znajduje najbardziej podobne embeddingi w bazie wektorowej.
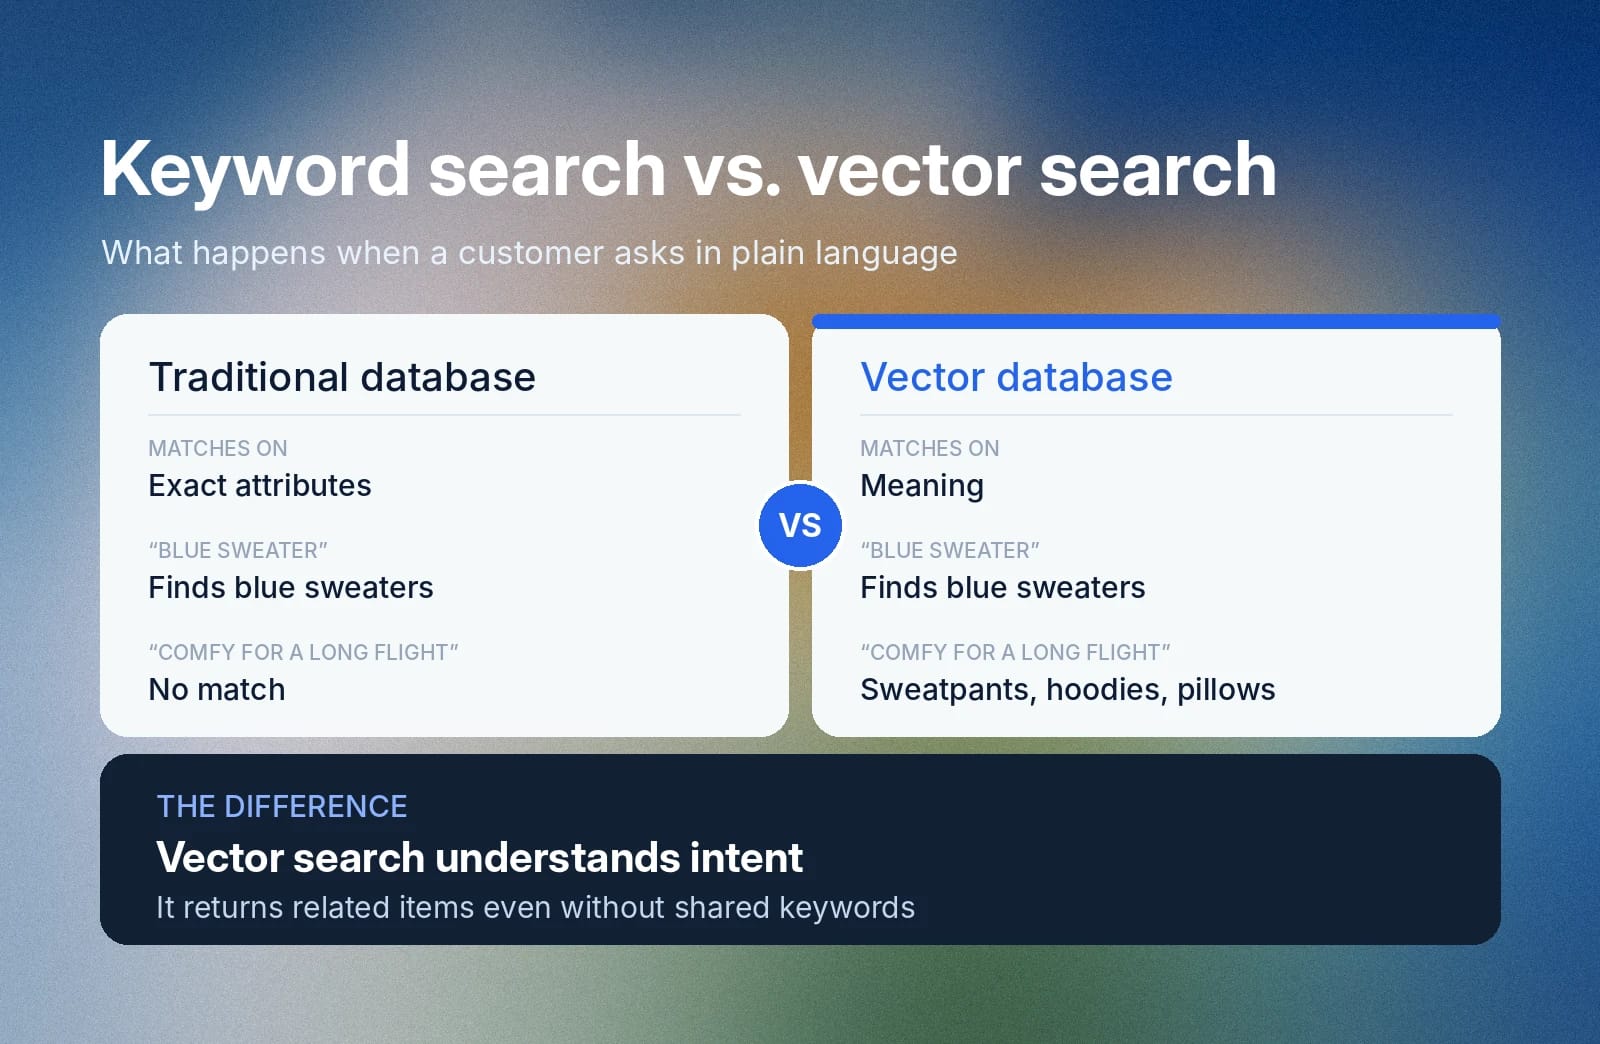
Załóżmy, że klient dzwoni i prosi o polecenie „niebieskiego swetra”. W tradycyjnej bazie danych szukasz produktów pasujących do atrybutów „niebieski” i „sweter”. Jeśli jednak klient chce „ubrań wygodnych na długi lot”, tradycyjna baza danych nie zwróci odpowiedzi.
Baza danych wektorowych wychwytuje za to semantyczne znaczenie prośby. Mapując ją do przestrzeni wektorowej, system zwraca takie produkty jak spodnie dresowe, bluzy z kapturem i poduszki podróżne, które mają ściśle powiązane reprezentacje cech. Ta zdolność dopasowywania znaczenia odróżnia wektorową bazę danych od tradycyjnej.
Embeddingi wektorowe: zamiana głosu, tekstu i obrazów na liczby
Embeddingi wektorowe to tablice liczb reprezentujące nieustrukturyzowane dane, takie jak tekst, obrazy i wideo, dzięki czemu modele AI mogą je łatwo przetwarzać.
Wektor to matematyczna reprezentacja liczb w różnych wymiarach. Sam wektor nie oddaje jednak kontekstu, struktury ani znaczenia konkretnego zbioru danych.
Na przykład lista liczb zmiennoprzecinkowych [0.82, 0.14, 0.67] jest wektorem, ale to, co reprezentuje, zależy od modelu embeddingowego.
Embeddingi wychwytują cechy danych i przechowują je jako wektor w przestrzeni wielowymiarowej. Nadają znaczenie temu, co w innym przypadku byłoby tylko listą liczb. Każda liczba w wektorze to jeden wymiar wyuczonej reprezentacji.
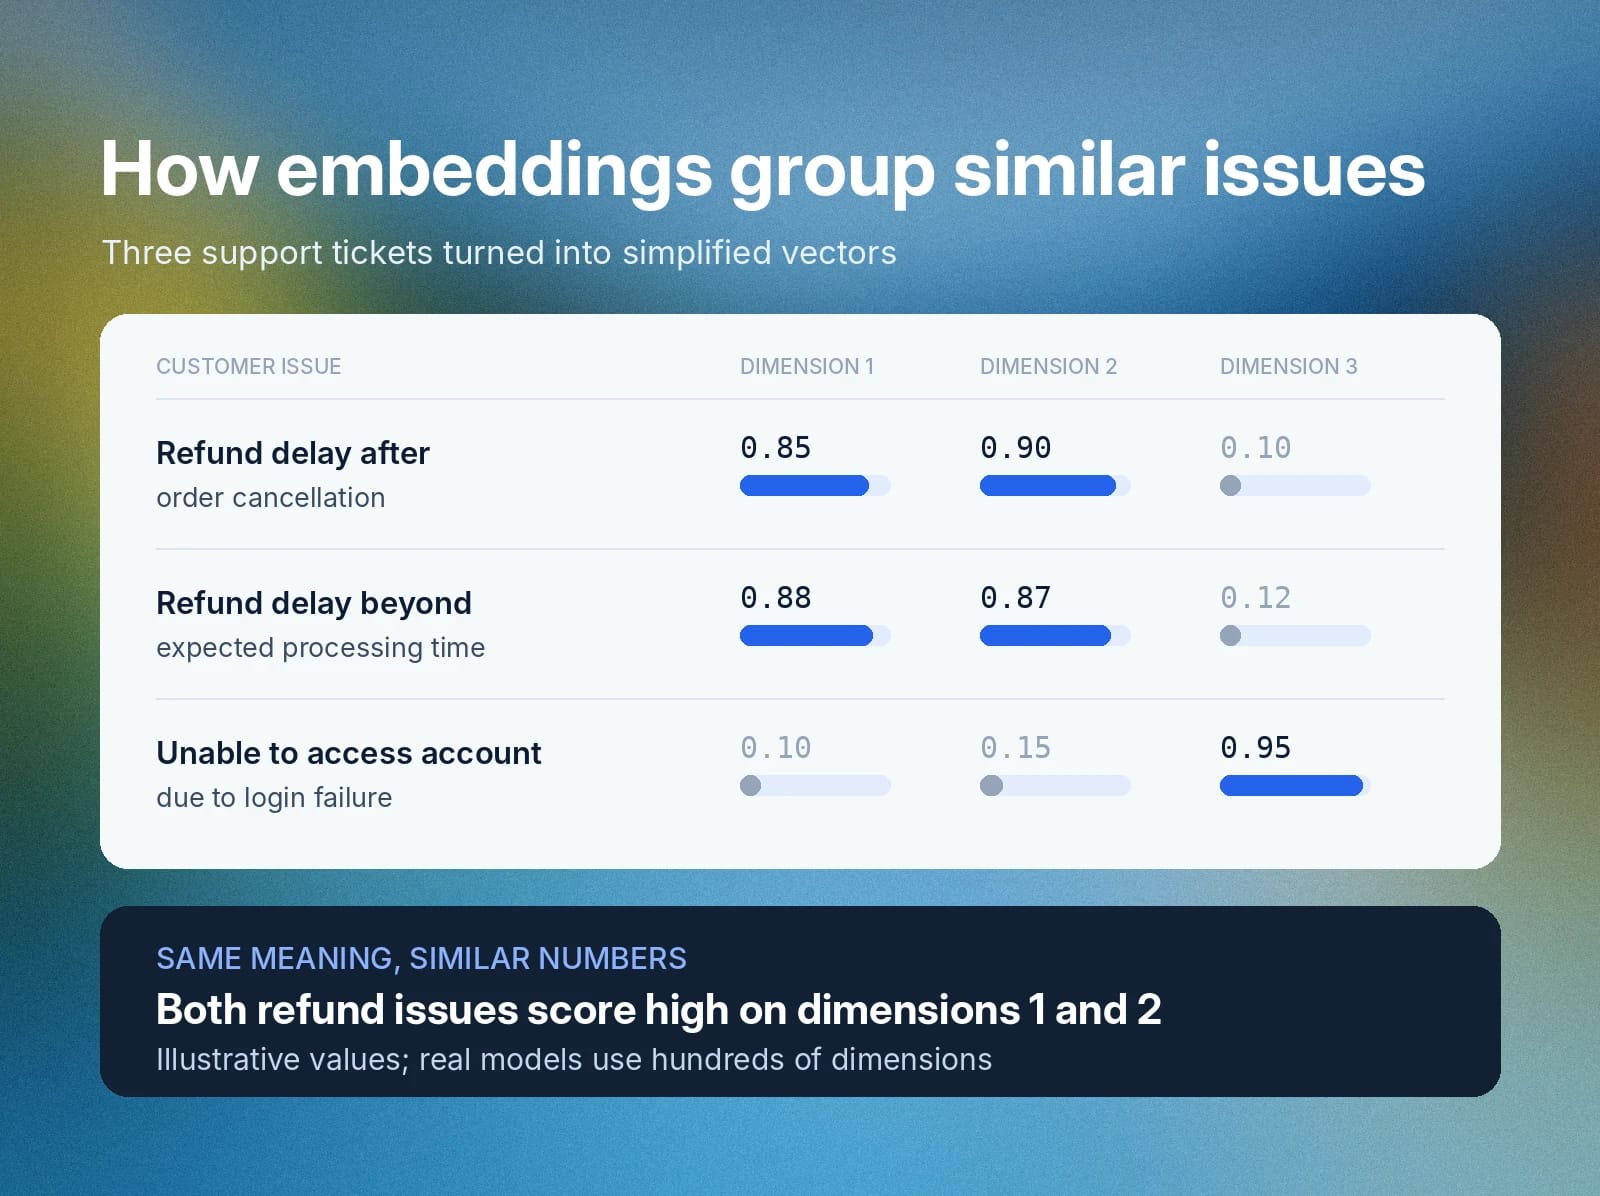
Załóżmy, że chcesz przechowywać zgłoszenia klientów w wektorowej bazie danych. Za pomocą modelu embeddingowego przekształcasz typy zgłoszeń w embeddingi o różnych wartościach w poszczególnych wymiarach. Poniższe wartości są uproszczone dla celów ilustracyjnych.
Problem klienta
Embeddingi
Opóźnienie zwrotu po anulowaniu zamówienia
[0.85, 0.90, 0.10]
Opóźnienie zwrotu przekraczające oczekiwany czas realizacji
[0.88, 0.87, 0.12]
Brak dostępu do konta z powodu błędu logowania
[0.10, 0.15, 0.95]
Oba problemy ze zwrotem, mimo różnych przyczyn, mają wyższe wartości w pierwszym i drugim wymiarze, podczas gdy problem z logowaniem ma najwyższą wartość w trzecim. Modele embeddingowe zwykle tworzą setki lub tysiące wymiarów, dlatego bazy danych wektorowych są zbudowane tak, by szybko je porównywać.
Jak działają bazy danych wektorowych?
Bazy danych wektorowych przekształcają nieustrukturyzowane dane w embeddingi, przechowują je w przestrzeni wielowymiarowej i umożliwiają wyszukiwanie podobieństwa semantycznego. Embeddingi, które są ze sobą blisko powiązane, mają do pewnego stopnia mniejszą odległość w przestrzeni wektorowej.
Gdy baza danych wektorowych otrzymuje zapytanie, używa algorytmów przybliżonego najbliższego sąsiada (ANN), aby pobrać najbardziej podobne embeddingi bez skanowania całej bazy danych.
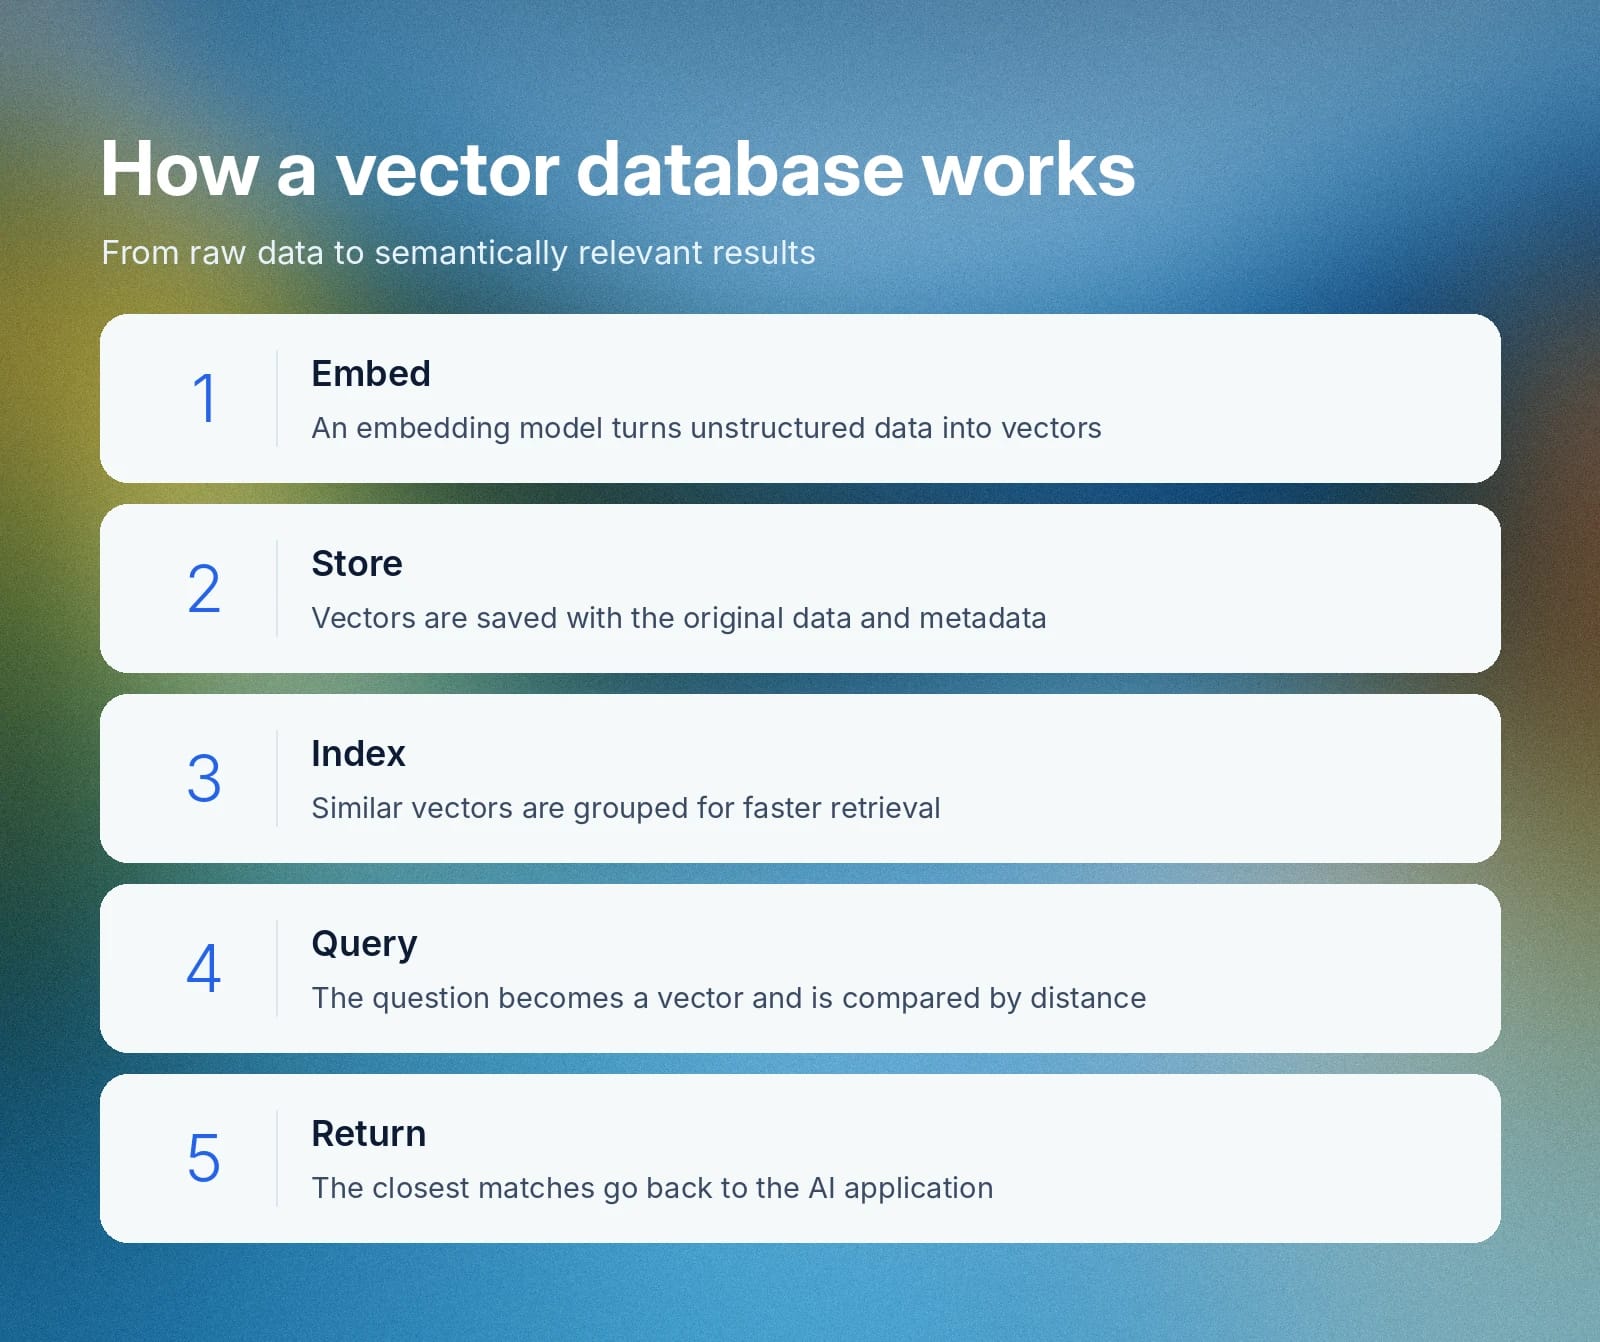
Oto etapy konfiguracji i pobierania danych z bazy danych wektorowych.
Przechowywanie embeddingów
Najpierw model embeddingowy przekształca nieustrukturyzowane dane w embeddingi. Każdy embedding reprezentuje cechy niosące semantyczne znaczenie obiektu ze świata rzeczywistego. Następnie system zapisuje embeddingi wraz z oryginalnymi danymi i metadanymi w wektorowej bazie danych.
Ponieważ embeddingi o podobnym znaczeniu znajdują się blisko siebie w przestrzeni wektorowej, baza danych może pobierać trafne dopasowania, mierząc odległość między wektorami.
Indeksowanie dla szybszego pobierania
Indeksowanie to proces organizowania embeddingów wektorowych w celu zwiększenia wydajności pobierania. Bazy danych wektorowych korzystają z kilku technik indeksowania, by grupować blisko powiązane embeddingi. Na przykład wektorowa baza danych może używać struktury listy, grafu lub drzewa, zależnie od wymagań pobierania.
Poza indeksowaniem wektorowa baza danych może kompresować dane techniką zwaną kwantyzacją produktu. Kompresuje ona embeddingi do zwięzłych kodów, oszczędzając pamięć kosztem niewielkiego spadku dokładności wyszukiwania.
Wyszukiwanie danych istotnych semantycznie
Po otrzymaniu zapytania baza danych wektorowych zamienia je w embedding. Następnie porównuje embedding zapytania z embeddingami zapisanymi w wielowymiarowej bazie wektorów, używając takich technik jak podobieństwo cosinusowe, iloczyn skalarny i odległość euklidesowa.
Na podstawie wyników baza danych wektorowych zwraca embeddingi o najwyższym wyniku podobieństwa semantycznego, których aplikacje generatywnej AI używają do uzupełniania odpowiedzi. Przechowywanie, indeksowanie i wyszukiwanie razem pozwalają bazie szybko zwracać trafne wyniki.
Jak wyszukiwanie wektorowe i wyszukiwanie podobieństwa zwracają trafne wyniki
Wyszukiwanie podobieństwa to szeroka kategoria systemów dopasowywania informacji. Obejmuje podejścia oparte na słowach kluczowych, które dopasowują dokładne słowa z zapytania, oraz wyszukiwanie wektorowe, które dopasowuje znaczenie.
Wyszukiwanie wektorowe używa bazy danych wektorowych, aby zwracać odpowiedzi powiązane semantycznie. Zamiast wyszukiwać dokładne słowa kluczowe, porównuje odległość między zapytaniem a kandydatami na odpowiedź, aby wybrać najtrafniejszy wynik.
Często wektorowa baza danych wykorzystuje metadane do wstępnego filtrowania embeddingów przed wyszukiwaniem podobieństwa. Może na przykład zawęzić wyszukiwanie, filtrując embeddingi z określonego przedziału czasu. Dzięki temu pobieranie jest szybsze.
Zastosowania baz danych wektorowych w głosowej AI i obsłudze klienta
Bazy danych wektorowych pomagają zespołom obsługi klienta wdrażać głosową AI i chatboty, które odpowiadają na podstawie dokładnej wiedzy o produktach. W systemie obsługi klienta opartym na AI baza danych wektorowych przechowuje własne bazy wiedzy, takie jak przewodniki produktowe, zasady firmy i zgłoszenia klientów.
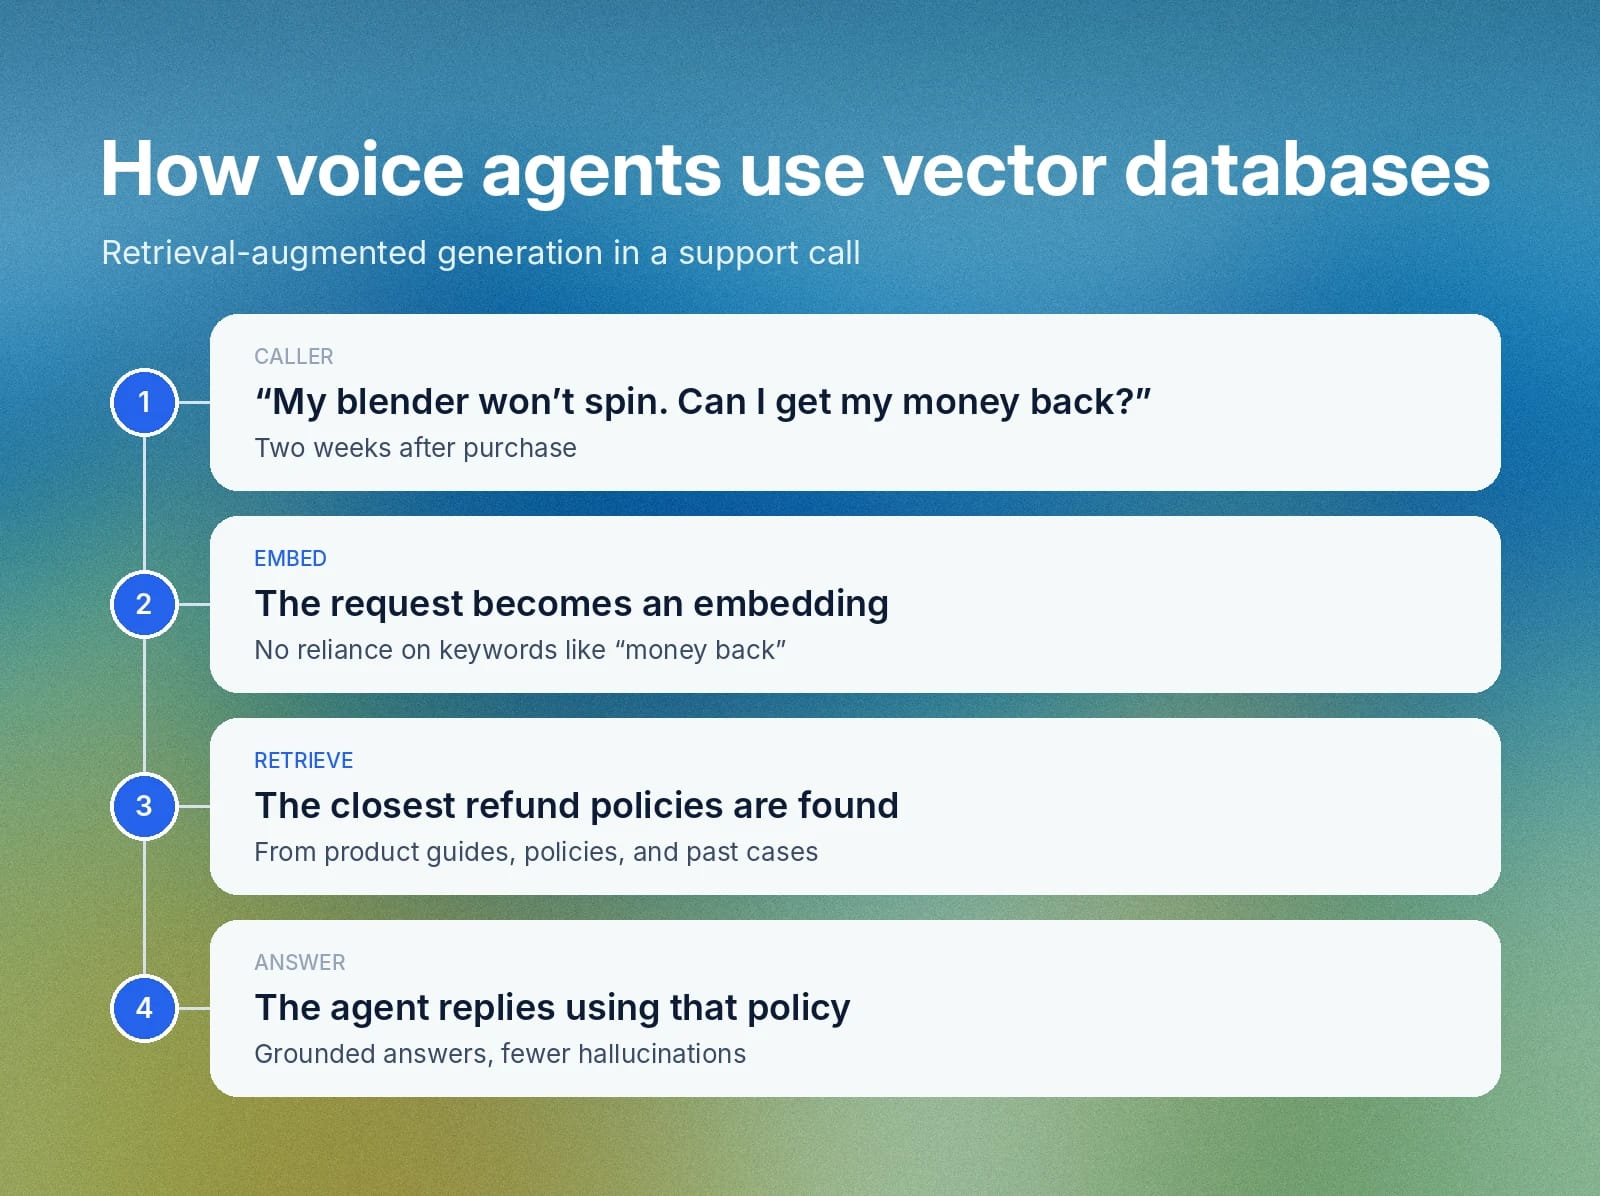
Agent AI łączy się z wektorową bazą danych za pomocą systemu generowania wspomaganego wyszukiwaniem (RAG) .
Gdy głosowy agent AI otrzymuje zapytanie, sprawdza, czy ma wystarczające informacje, by odpowiedzieć klientowi. Jeśli brakuje mu aktualnych lub wystarczających danych, RAG pobiera semantycznie dopasowane dane, aby uzupełnić odpowiedź.
Załóżmy, że agent głosowy otrzymuje następującą skargę: „Mój blender przestał się obracać po dwóch tygodniach. Czy mogę odzyskać pieniądze?”. Zamiast szukać dokładnych słów kluczowych, takich jak „przestał się obracać” i „odzyskać pieniądze”, RAG zamienia prośbę w embedding. Następnie pobiera zasady zwrotów o najbardziej zbliżonym znaczeniu.
Pobierając trafne dokumenty wewnętrzne, system RAG oparty na bazie danych wektorowych pomaga ograniczać halucynacje agentów głosowych, choć ich nie eliminuje. Zamiast zgadywać, zarówno agenci AI, jak i ludzie mogą korzystać z dokumentów wewnętrznych, aby rozwiązywać zapytania klientów.
Baza danych wektorowych a baza relacyjna: kluczowe różnice
Relacyjna baza danych używa wierszy i kolumn oraz stałego schematu do przechowywania danych. Wektorowa baza danych używa za to embeddingów, które reprezentują nieustrukturyzowane dane.
Bazy relacyjne sprawdzają się przy dokładnych dopasowaniach i zapytaniach strukturalnych, na przykład przy wyszukiwaniu wszystkich zamówień złożonych danego dnia. Bazy danych wektorowych pobierają natomiast zapisane embeddingi najbliższe znaczeniowo zapytaniu, co jest skuteczniejsze w przypadku pytań w języku naturalnym.
Zespoły najczęściej korzystają z obu, ponieważ każda z nich ma swoje miejsce w pracy z danymi.
Baza danych wektorowych a baza grafowa: kiedy której używać
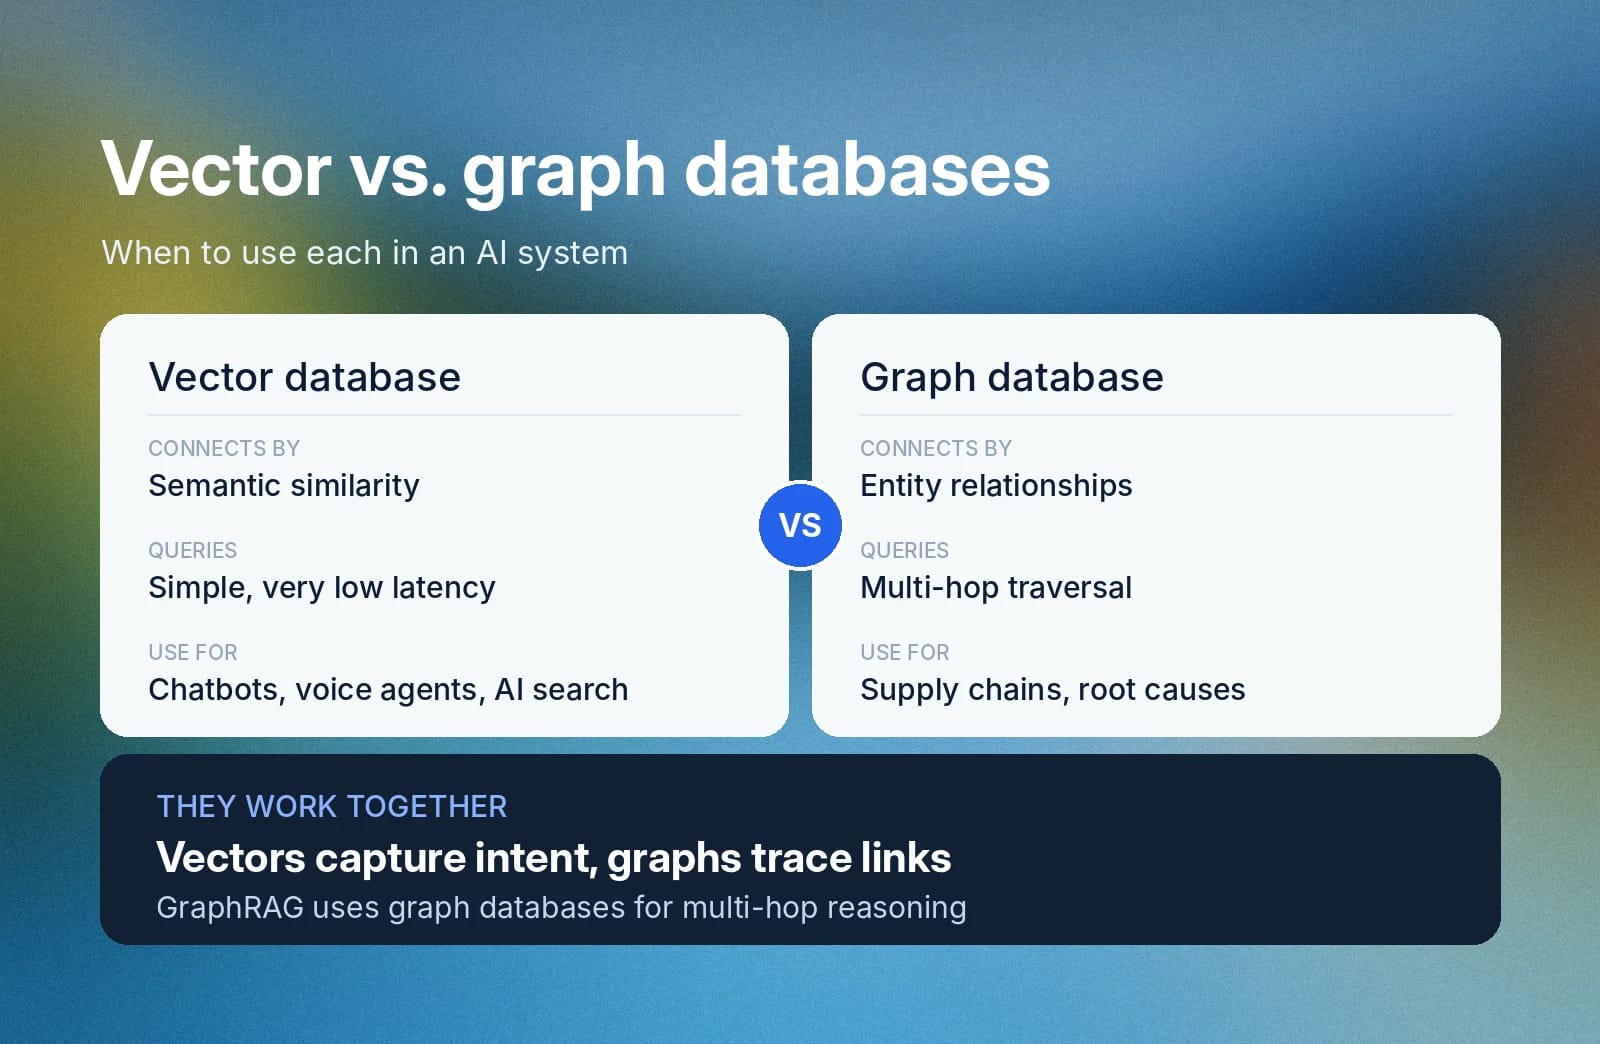
Bazy grafowe używają grafów wiedzy do łączenia różnych encji w sposób odzwierciedlający ich hierarchię i relacje. Systemy AI, takie jak GraphRAG, używają baz grafowych do odpowiadania na zapytania wymagające wieloetapowego rozumowania.
Gdy wysyłasz zapytanie do bazy grafowej, znajduje ona punkt startowy i używa algorytmu przeszukiwania grafu, aby znaleźć powiązane encje. Na przykład nazwiska klientów mogą być kolejno połączone z datami odnowienia i zgłoszeniami do obsługi.
Bazy danych wektorowych przechowują za to nieustrukturyzowane dane jako reprezentacje numeryczne oparte na ich znaczeniu semantycznym. Pozwalają systemom RAG wykonywać proste dopasowywanie zapytań z bardzo niskim opóźnieniem. Na przykład wektorowa baza danych wyświetla zasady zwrotów przy przetwarzaniu prośby „Chcę zwrot pieniędzy”.
Zarówno bazy wektorowe, jak i grafowe są przydatne dla systemów AI. Możesz używać ich razem:
- Użyj wektorowej bazy danych, gdy chcesz zasilać chatbota, agenta głosowego lub wyszukiwarkę AI, która musi rozumieć intencję wyrażoną ludzkim językiem.
- Użyj bazy grafowej, gdy chcesz rozwiązać problemy współzależności, takie jak śledzenie łańcuchów dostaw, rekomendowanie trafnych produktów czy analiza przyczyn źródłowych.
Jakie rodzaje baz danych wektorowych są dostępne?
Ogólnie wyróżniamy dwa rodzaje baz danych wektorowych, różniące się architekturą.
- Samodzielna wektorowa baza danych: Są to niezależne, wyspecjalizowane bazy danych obsługujące wielowymiarowe wyszukiwanie podobieństwa z niskim opóźnieniem. Wiele aplikacji generatywnej AI łączy się z samodzielnymi bazami wektorowymi, aby skalować intensywne obciążenia zapytaniami.
- Rozszerzenie bazy danych wektorowych: Istniejące bazy danych mogą wprowadzać funkcje wyszukiwania wektorowego, aby umożliwić modelom AI pobieranie danych na podstawie podobieństwa semantycznego. Zachowują one oryginalną architekturę, na przykład schemat SQL oparty na wierszach, ale obsługują typy danych wektorowych.
Wybór zależy głównie od tego, czy potrzebujesz dedykowanego systemu do obsługi dużego obciążenia zapytaniami, czy chcesz dodać wyszukiwanie semantyczne do bazy danych, z której już korzystasz.
Przykłady baz danych wektorowych
Oto dwa przykłady wektorowych baz danych:
- Samodzielne wektorowe bazy danych: Pinecone to zarządzana usługa bazy danych wektorowych. Milvus, Weaviate, Qdrant i Chroma to bazy danych wektorowych open source.
- Rozszerzenia wektorowych baz danych: pgvector dodaje wyszukiwanie podobieństwa wektorowego do PostgreSQL, a MongoDB Atlas Vector Search — do MongoDB.
To, które rozwiązanie pasuje, zależy od twojej skali i od tego, jaką częścią infrastruktury chcesz zarządzać.
Zacznij korzystać z ElevenAgents dla agentów głosowych gotowych na pobieranie danych
ElevenAgents pozwala agentom głosowym pobierać dane z twojej bazy wiedzy, aby prowadzić rozmowy uwzględniające kontekst. Dzięki RAG agent pobiera najbardziej podobne semantycznie treści z dokumentów, adresów URL lub tekstu dodanego do bazy wiedzy. Możesz ustawić pobieranie na „Na żądanie”, aby agent przeszukiwał bazę wiedzy tylko wtedy, gdy uzna to za potrzebne.
Co zrozumiałe, wdrożenie RAG zwiększa opóźnienie generowania odpowiedzi. Dzięki naszym pracom inżynieryjnym skróciliśmy jednak medianę opóźnienia RAG w ElevenAgents z 326 ms do 155 ms.
Zacznij korzystać z ElevenAgents i sprawdź jak skonfigurować bazę wiedzy.
Często zadawane pytania

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.


