
Czym jest RAG? Jak działa Retrieval-Augmented Generation
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Modele AI tworzą odpowiedzi na podstawie tego, czego nauczyły się podczas treningu. Nie znają więc automatycznie polityk firmy, jej produktów ani innych informacji powstałych po zakończeniu treningu. RAG (Retrieval-Augmented Generation) rozwiązuje ten problem, wyszukując istotne informacje zewnętrzne i przekazując je modelowi przed odpowiedzią.
RAG opiera odpowiedzi AI na faktycznych dokumentach firmy. agent wsparcia klienta korzystający z RAG może przed odpowiedzią sprawdzić aktualną politykę zwrotów lub specyfikację produktu, co zmniejsza ryzyko halucynacji.
Ten przewodnik wyjaśnia, czym jest RAG w AI, jak współpracują wyszukiwanie i generowanie oraz czym RAG różni się od samodzielnego LLM. Omówimy też ograniczenia RAG, zastosowania w generatywnych aplikacjach AI oraz to, jak RAG wspiera wyszukiwanie wiedzy w agentach AI.
Podsumowanie
- RAG łączy system wyszukiwania z modelem generatywnym, dzięki czemu model może korzystać z informacji spoza danych treningowych.
- Wiedza wyszukiwana przez RAG znajduje się poza modelem, więc można ją aktualizować bez ponownego treningu.
- ElevenAgents automatycznie używa RAG, gdy baza wiedzy jest zbyt duża, by zmieścić się bezpośrednio w kontekście modelu. Dzięki temu odpowiedzi pozostają szybkie i dokładne nawet przy dużych, złożonych bazach wiedzy.
Czym jest RAG w AI?
RAG to architektura systemu oparta na LLM, która dostarcza mu zewnętrzne informacje, takie jak wytyczne marki, instrukcje produktów, artykuły z bazy wiedzy czy wewnętrzne bazy danych. Dzięki temu AI może pracować z informacjami specyficznymi dla firmy, a jej odpowiedzi uwzględniają aktualne zasady, prywatną wiedzę i szczegóły firmy, na których model nigdy nie był trenowany.
LLM może też uwzględnić naraz tylko ograniczoną ilość informacji, zwaną oknem kontekstowym. Duża firmowa baza wiedzy może szybko przekroczyć ten limit, dlatego RAG przechowuje informacje poza LLM i pobiera tylko fragmenty potrzebne do odpowiedzi na bieżące pytanie.
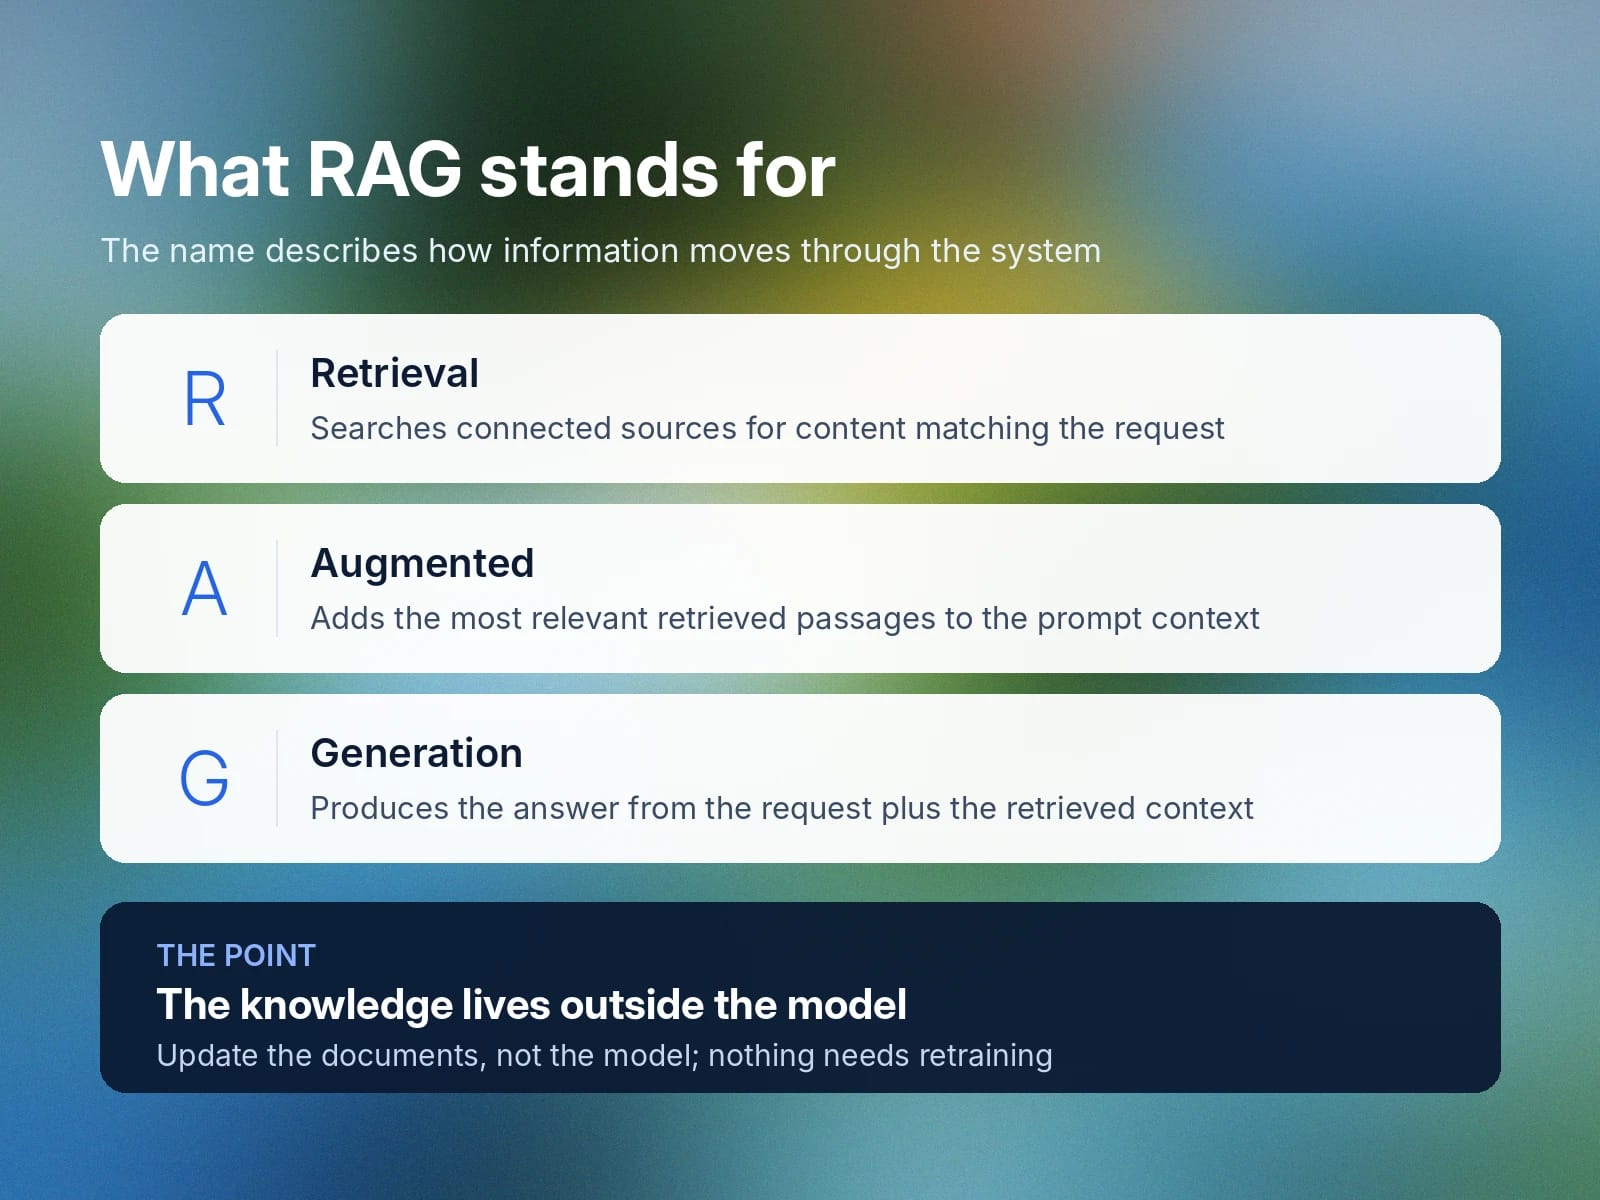
Nazwa opisuje przepływ informacji przez system:
- Retrieval: Przeszukuje połączone źródła, takie jak dokumenty dotyczące zasad, logi helpdesku czy pliki magazynowe, aby znaleźć treści pasujące do zapytania użytkownika.
- Augmented: Dodaje najtrafniejsze znalezione fragmenty do kontekstu promptu.
- Generation: Korzysta z zapytania użytkownika i znalezionego kontekstu, aby stworzyć odpowiedź.
RAG wspiera też grounding, czyli oparcie odpowiedzi AI na konkretnych informacjach źródłowych. Dostarcza LLM odpowiednie materiały, z których może skorzystać przy tworzeniu odpowiedzi. Jeśli na przykład klient pyta o zasady gwarancji, system RAG pobiera odpowiednie warunki z dokumentacji firmy i przekazuje je LLM, aby mógł na ich podstawie odpowiedzieć.
Jak działa Retrieval-Augmented Generation?
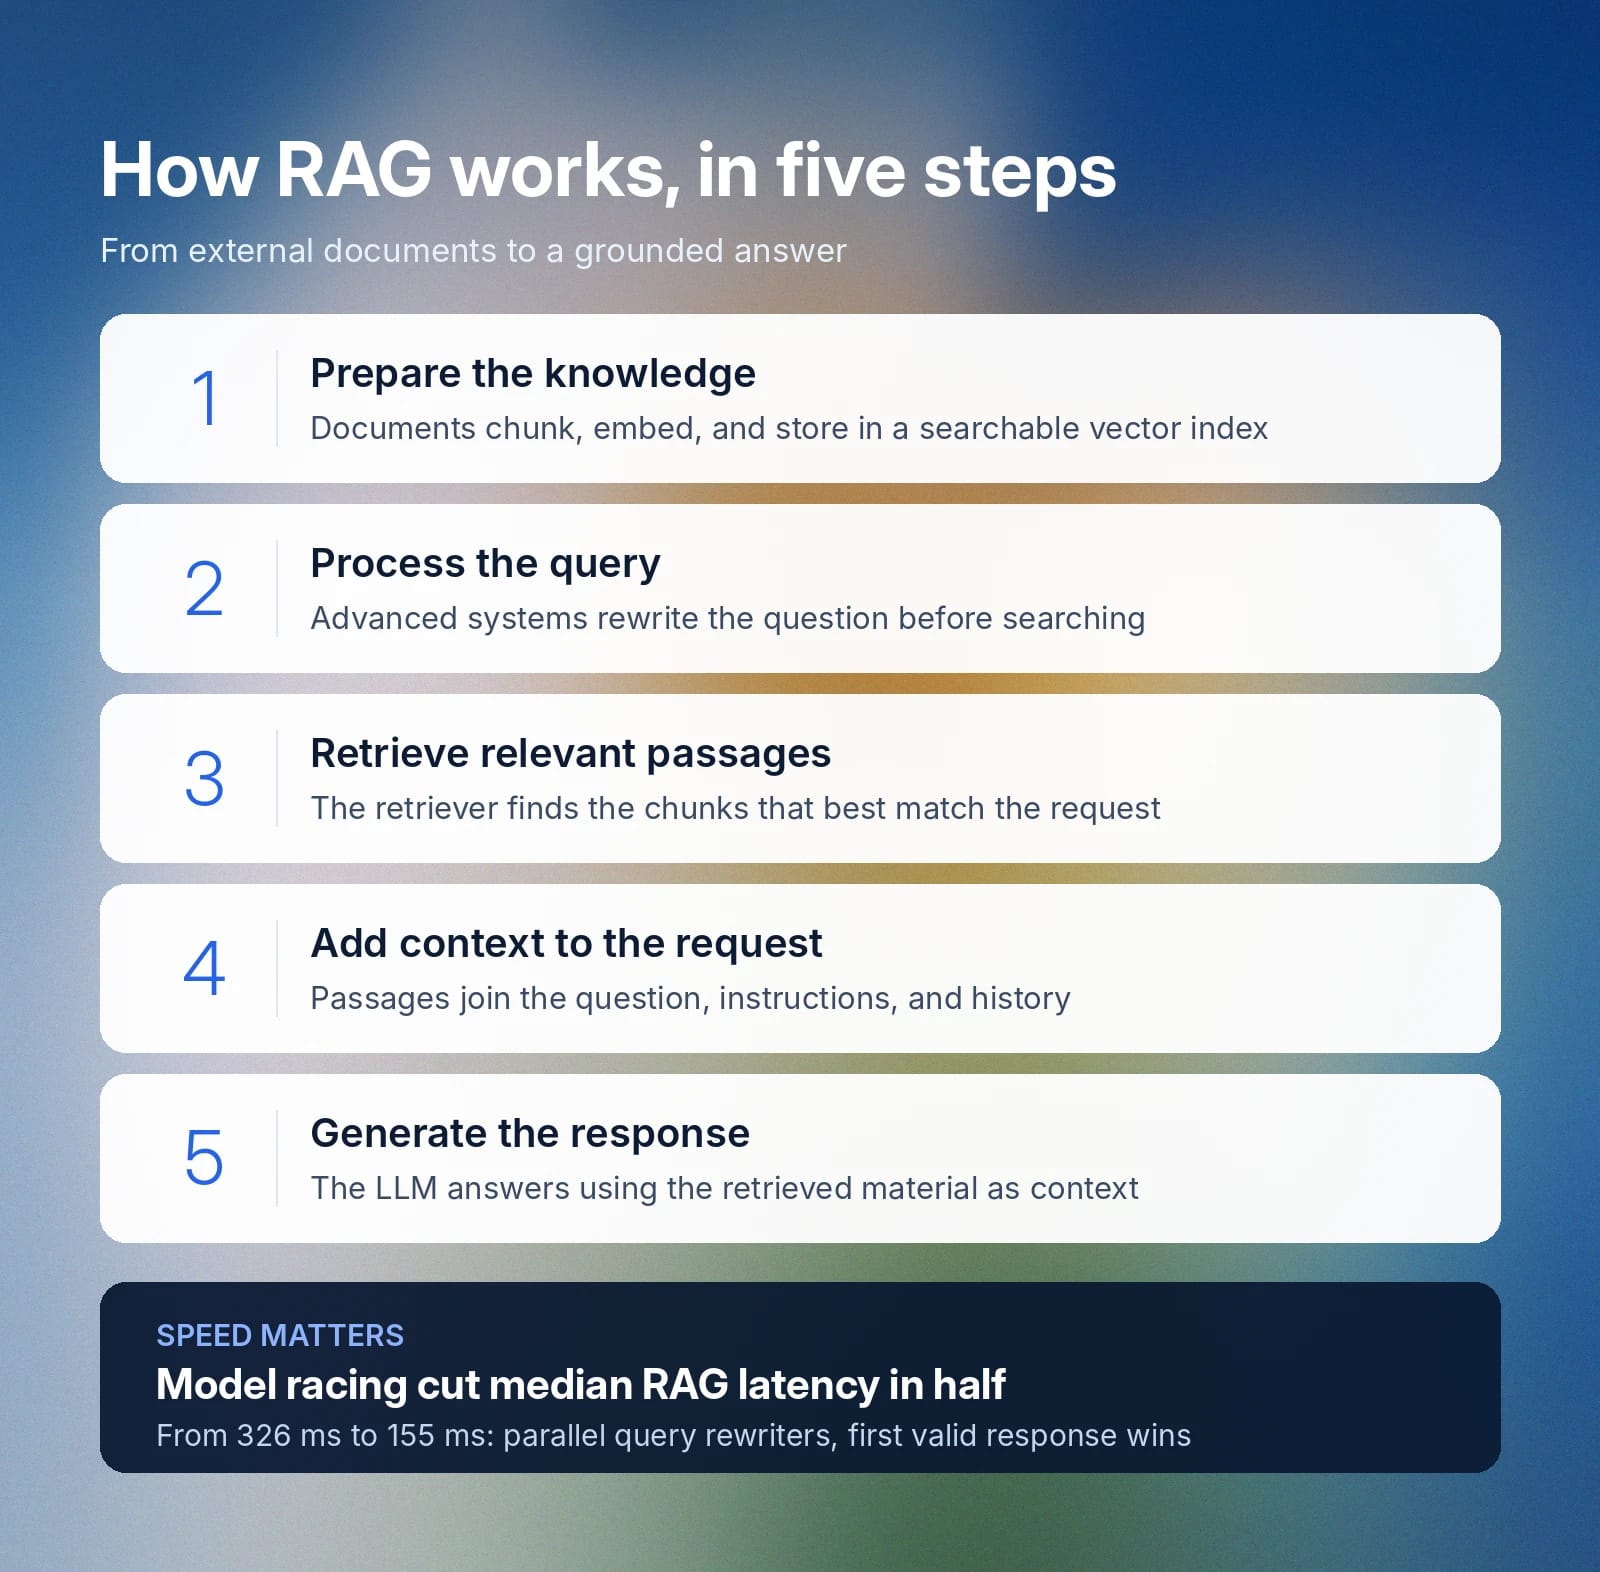
System RAG przygotowuje zewnętrzną wiedzę do wyszukiwania, znajduje informacje najbardziej istotne dla pytania użytkownika i przekazuje je LLM jako kontekst przed wygenerowaniem odpowiedzi.
Wdrożenia RAG różnią się złożonością. Podstawowy RAG stosuje prosty proces wyszukania i wygenerowania odpowiedzi, a bardziej zaawansowane podejścia mogą obejmować przeformułowanie zapytania, filtrowanie, zmianę rankingu wyników lub inne techniki wyszukiwania.
Proces RAG zwykle obejmuje pięć kroków:
- Przygotowanie wiedzy: Dokumenty są dzielone na mniejsze fragmenty (proces zwany „chunkingiem”), przekształcane w matematyczne reprezentacje zwane embeddingami i zapisywane w przeszukiwalnym indeksie lub wektorowej bazie danych.
- Przetworzenie zapytania: System interpretuje pytanie użytkownika, a w bardziej zaawansowanych systemach RAG przed wyszukiwaniem je przeformułowuje lub doprecyzowuje.
- Wyszukanie istotnych fragmentów: Moduł wyszukiwania przeszukuje zindeksowaną bazę wiedzy, aby znaleźć fragmenty tekstu najlepiej pasujące do zapytania.
- Dodanie kontekstu do zapytania modelu: Wybrane fragmenty są wysyłane do LLM wraz z pytaniem użytkownika, odpowiednimi instrukcjami i historią rozmowy.
- Wygenerowanie odpowiedzi: LLM tworzy odpowiedź, wykorzystując znalezione materiały jako część kontekstu.
Wiele systemów RAG uruchamia wyszukiwanie wybiórczo jako zewnętrzne narzędzie. ElevenAgents pozwala zespołom włączyć RAG dla bazy wiedzy bezpośrednio w ustawieniach agenta, a system używa przeformułowania zapytania, by podczas kontynuacji rozmowy zamienić wcześniejszy dialog i niejasne odniesienia w precyzyjne, samodzielne zapytanie wyszukiwania.
Aby zapewnić szybkie odpowiedzi, ElevenLabs opracowało też architekturę model racing, która wysyła każde zapytanie równolegle do wielu modeli przeformułowujących i używa pierwszej prawidłowej odpowiedzi. To podejście skróciło medianę opóźnienia RAG o połowę, z 326 ms do 155 ms, dzięki czemu wyszukiwanie jest na tyle szybkie, by zachować naturalny tok rozmowy nawet wtedy, gdy uruchamia je duża baza wiedzy.
Czym różnią się LLM i modele RAG?
LLM to model, który rozumie i generuje język. RAG to architektura otaczająca LLM, która pobiera zewnętrzne informacje, gdy aplikacja ich potrzebuje.
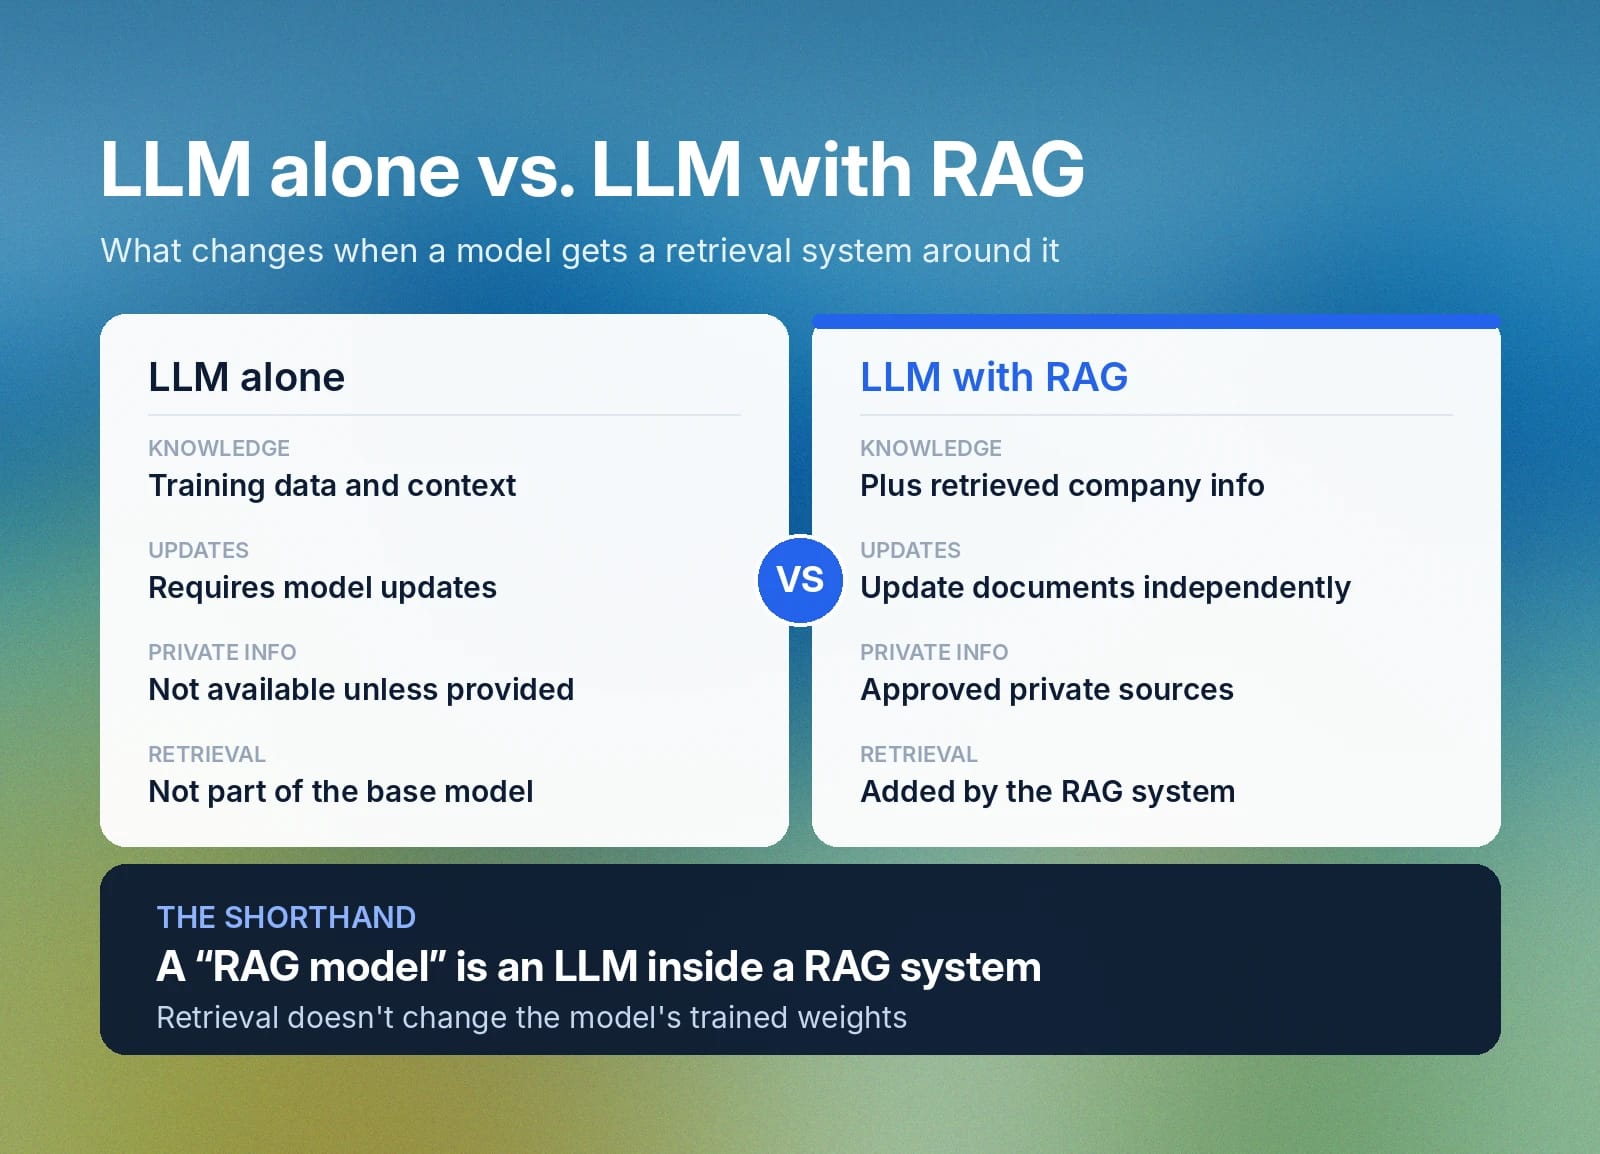
Oto co zmienia się, gdy LLM współpracuje z RAG:
Funkcja | Sam LLM | LLM z RAG |
Wiedza | Dane treningowe i bieżący kontekst | Dane treningowe, bieżący kontekst i pobrane informacje firmowe, np. zasady, dokumentacja produktów czy treści z bazy wiedzy |
Aktualizacje | Nowe informacje trzeba dostarczyć w kontekście lub przez aktualizację modelu | Zewnętrzną wiedzę można aktualizować niezależnie od modelu |
Prywatne informacje | Niedostępne, jeśli nie zostaną przekazane | Może pobierać dane z zatwierdzonych prywatnych źródeł |
Wyszukiwanie | Nie jest częścią podstawowego modelu | Dodawane przez otaczający system RAG |
„Model RAG” bywa używany jako skrót dla LLM działającego w systemie RAG. Na przykład firma może powiedzieć, że używa „modelu RAG” do obsługi klienta, choć w rzeczywistości korzysta z LLM, który przed wygenerowaniem odpowiedzi pobiera odpowiednie treści z centrum pomocy lub polityki firmy.
Ograniczenia modeli RAG w zastosowaniach praktycznych
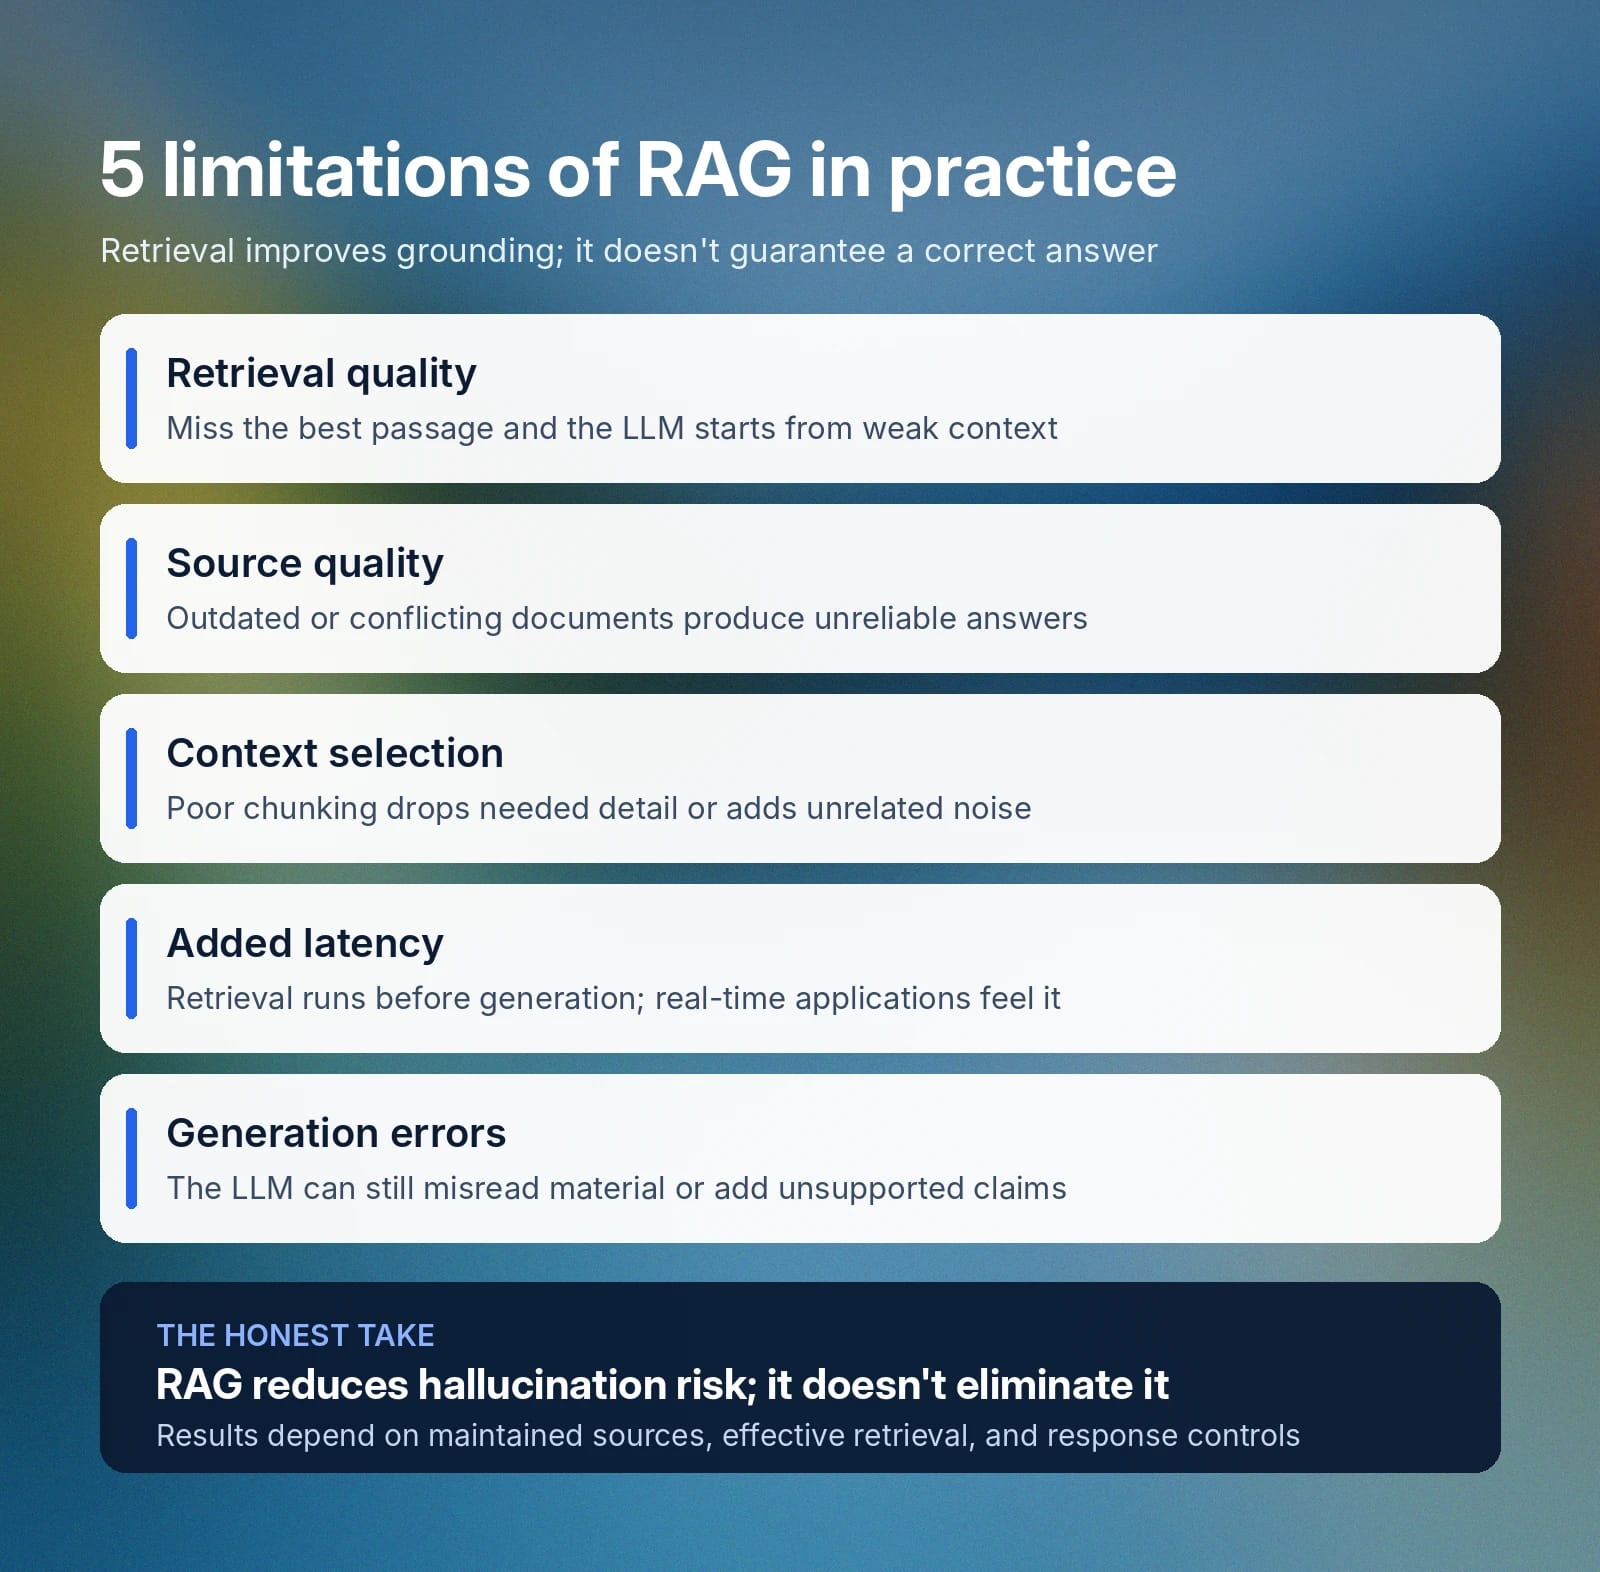
RAG ułatwia dostęp do istotnej wiedzy firmowej przechowywanej poza LLM, ale wyszukiwanie ma własne ograniczenia i nie gwarantuje poprawnej odpowiedzi. Główne ograniczenia dotyczą tego, co system znajduje, co przekazuje modelowi i jak model odpowiada:
- Jakość wyszukiwania: Jeśli system pominie najistotniejszy fragment, LLM zaczyna z niepełnym lub słabym kontekstem. Źle sformułowane zapytania, słabe dopasowania semantyczne lub niejednoznaczne sformułowania mogą skierować wyszukiwanie w złym kierunku.
- Jakość źródeł: Nieaktualne, sprzeczne lub niepełne dokumenty mogą prowadzić do niewiarygodnych odpowiedzi.
- Wybór kontekstu: Słaby chunking lub nietrafne wyniki wyszukiwania mogą usunąć potrzebne szczegóły albo dodać niepowiązane informacje.
- Dodatkowe opóźnienie: Wyszukiwanie i przetwarzanie zapytania odbywają się przed generowaniem, co może spowolnić odpowiedzi w aplikacjach działających w czasie rzeczywistym.
- Błędy generowania: LLM nadal może błędnie zinterpretować znalezione informacje lub dodać twierdzenia bez pokrycia.
RAG może zmniejszyć ryzyko halucynacji, ale nie eliminuje go całkowicie. Dokładne wyniki nadal zależą od dobrze utrzymanych źródeł, skutecznego wyszukiwania i kontroli nad końcową odpowiedzią.
RAG w generatywnej AI: praktyczne zastosowania i korzyści
RAG jest najbardziej przydatny, gdy aplikacja AI potrzebuje informacji, które często się zmieniają, należą do organizacji lub są zbyt obszerne, by dodawać je do każdego zapytania modelu.
Oto gdzie RAG robi największą różnicę:
Nadążanie za często aktualizowanymi informacjami
RAG pomaga zespołom utrzymywać odpowiedzi AI zgodne z aktualnymi szczegółami produktów, cenami, zasadami i stanem magazynowym. Zespoły mogą niezależnie aktualizować informacje źródłowe, a RAG pobiera właściwą wersję, gdy pojawia się pytanie. Na przykład agent kwalifikacji leadów może pobrać najnowsze ceny lub szczegóły planów podczas kwalifikowania rozmówcy, który sam się zgłosił.
Korzystanie z prywatnej lub specjalistycznej wiedzy
Część wiedzy jest prywatna lub specjalistyczna, a nie publiczna — na przykład wewnętrzne zasady, dokumentacja techniczna czy treści wsparcia przeznaczone dla konkretnego zespołu. RAG pozwala agentowi pobierać dane bezpośrednio z tych źródeł, zamiast polegać wyłącznie na tym, co jest publicznie dostępne lub wbudowane w model.
Na przykład wewnętrzny agent helpdesku IT lub HR może pobierać informacje z bazy wiedzy działu HR, by odpowiadać na pytania o świadczenia pracownicze, zamiast przeszukiwać publiczną dokumentację, która ich nie zawiera.
Przeszukiwanie dużych baz wiedzy
RAG pomaga, gdy firma ma znacznie więcej dokumentacji, niż LLM może uwzględnić w jednym zapytaniu. Pobiera tylko fragmenty istotne dla bieżącego pytania, zamiast wysyłać modelowi cały zbiór. W sprzedaży asystent techniczny może podczas rozmowy przeszukiwać instrukcje produktów, aby znaleźć odpowiednie wymagania.
Zacznij z ElevenAgents i zaawansowanymi rozwiązaniami RAG
ElevenAgents pozwala zespołom tworzyć głosowych i czatowych agentów AI, którzy używają RAG z połączonymi źródłami wiedzy — przez platformę internetową no-code lub API dla zespołów, które chcą osadzić agentów bezpośrednio w swoich produktach.
W przypadku agentów z RAG zespoły mogą dodawać dokumenty, adresy URL lub tekst do bazy wiedzy i pobierać tylko informacje istotne dla każdego zapytania.
ElevenLabs zoptymalizowało też wyszukiwanie dla rozmów w czasie rzeczywistym, skracając medianę opóźnienia RAG z 326 ms do 155 ms w architekturze ElevenAgents. Zespoły tworzące z ElevenAgents otrzymują te możliwości wyszukiwania od razu — niezależnie od tego, czy konfigurują agenta w panelu, czy budują rozwiązanie przez API.
Zacznij tworzyć z ElevenAgents lub skontaktuj się z naszym zespołem , aby omówić konfigurację odpowiednią dla twojej aplikacji.


