
Czym jest okno kontekstowe? Co powinien wiedzieć każdy użytkownik LLM
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Okno kontekstowe to ilość informacji, którą duży model językowy (LLM) może przetworzyć w jednym żądaniu. Mierzone w tokenach, może obejmować prompt, historię rozmowy, instrukcje systemowe, pobrane dokumenty, wyniki narzędzi i odpowiedź wygenerowaną przez model.
Większe okno kontekstowe pozwala modelowi pracować z większą ilością informacji w jednym żądaniu. Na przykład agent programistyczny badający błąd może jednocześnie analizować odpowiednie pliki źródłowe, dokumentację, wyniki testów i ostatnie zmiany w kodzie, zamiast analizować każdy element osobno i tracić przydatny kontekst między żądaniami.
Większe okno kontekstowe nie oznacza jednak idealnej pamięci. Dłuższe prompty wymagają więcej obliczeń, zużywają więcej tokenów i mogą utrudniać modelowi określenie, które szczegóły naprawdę mają znaczenie. Badania modeli z długim kontekstem, w tym Lost in the Middle oraz benchmark NVIDIA RULER, wielokrotnie wykazały, że wraz ze wzrostem kontekstu modele wykorzystują mniej dostępnych im informacji, zwłaszcza gdy istotne dane są ukryte wśród mniej przydatnych treści.
W tym artykule wyjaśniamy, jak działają okna kontekstowe, jak się je mierzy, co dzieje się po ich zapełnieniu i jak deweloperzy mogą skutecznie nimi zarządzać.
Podsumowanie
- Okno kontekstowe to całkowity budżet tokenów, z którego LLM korzysta w jednym żądaniu. Obejmuje prompt użytkownika, historię rozmowy, pobrane treści i wynik.
- Większe okna kontekstowe pozwalają obsługiwać dłuższe dokumenty, bazy kodu i rozmowy, ale nie gwarantują, że model dobrze wykorzysta każdą ich część.
- Modele najmniej niezawodnie pobierają informacje ze środka długich promptów — ten wzorzec opisano w badaniu Lost in the Middle i benchmarku RULER.
- Skuteczne zarządzanie kontekstem — pobieranie danych, podsumowywanie i cache’owanie — zwykle daje lepsze efekty niż maksymalizowanie liczby wysyłanych tokenów.
- Najlepsza strategia kontekstu odpowiada rzeczywistemu obciążeniu, a nie wykorzystuje największe reklamowane okno kontekstowe.
Czym jest okno kontekstowe w modelu AI?
Okno kontekstowe to aktywna przestrzeń robocza modelu, w której przed wygenerowaniem odpowiedzi zbierają się wszystkie informacje istotne dla bieżącego żądania.
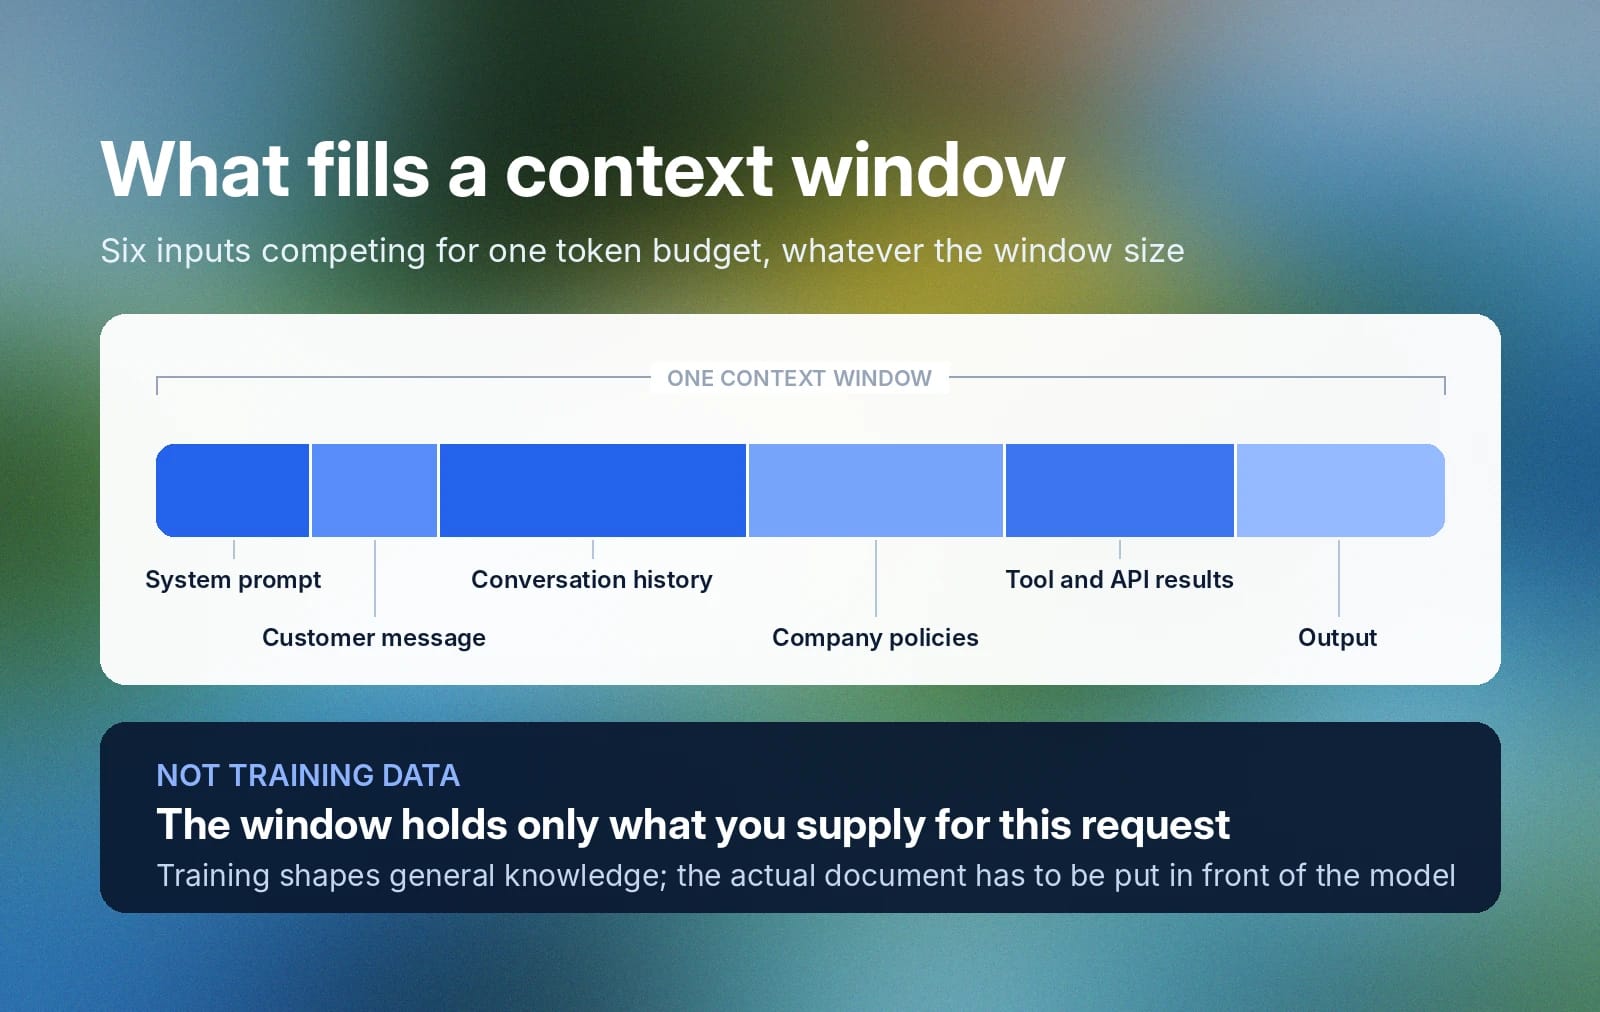
Weźmy agenta AI, który podsumowuje rozmowę z działem obsługi klienta i rekomenduje rozwiązanie. Aby zrobić to dobrze, model musi przetworzyć:
- Prompt systemowy
- Wiadomość klienta
- Historię rozmowy
- Zasady firmy
- Wyniki narzędzi i API
- Wynik
Wszystkie te elementy konkurują o miejsce w tym samym oknie kontekstowym, niezależnie od jego rozmiaru.
Okna kontekstowe nie obejmują danych treningowych. Trening na stałe zapisuje informacje w parametrach modelu, kształtując to, co model ogólnie „wie”. Okno kontekstowe zawiera natomiast tylko informacje przekazane dla bieżącego zadania.
To rozróżnienie ma praktyczne znaczenie: jeśli aplikacja potrzebuje, by model analizował konkretną zasadę, rekord klienta lub dokument techniczny, informacja ta nie jest dostępna tylko dlatego, że model trenowano na podobnych materiałach. Zwykle musi trafić bezpośrednio do kontekstu roboczego modelu — w prompcie albo przez system pobierania danych lub narzędzia. W przeciwnym razie model będzie opierał się na wiedzy ogólnej, a nie na dokumencie, który ma przed sobą.
Tokenizacja i okna kontekstowe: jak przetwarzane są dane
Zanim LLM przetworzy tekst, tokenizer dzieli go na mniejsze jednostki zwane tokenami. Token może oznaczać całe słowo, część słowa, znak interpunkcyjny lub inny krótki fragment tekstu.
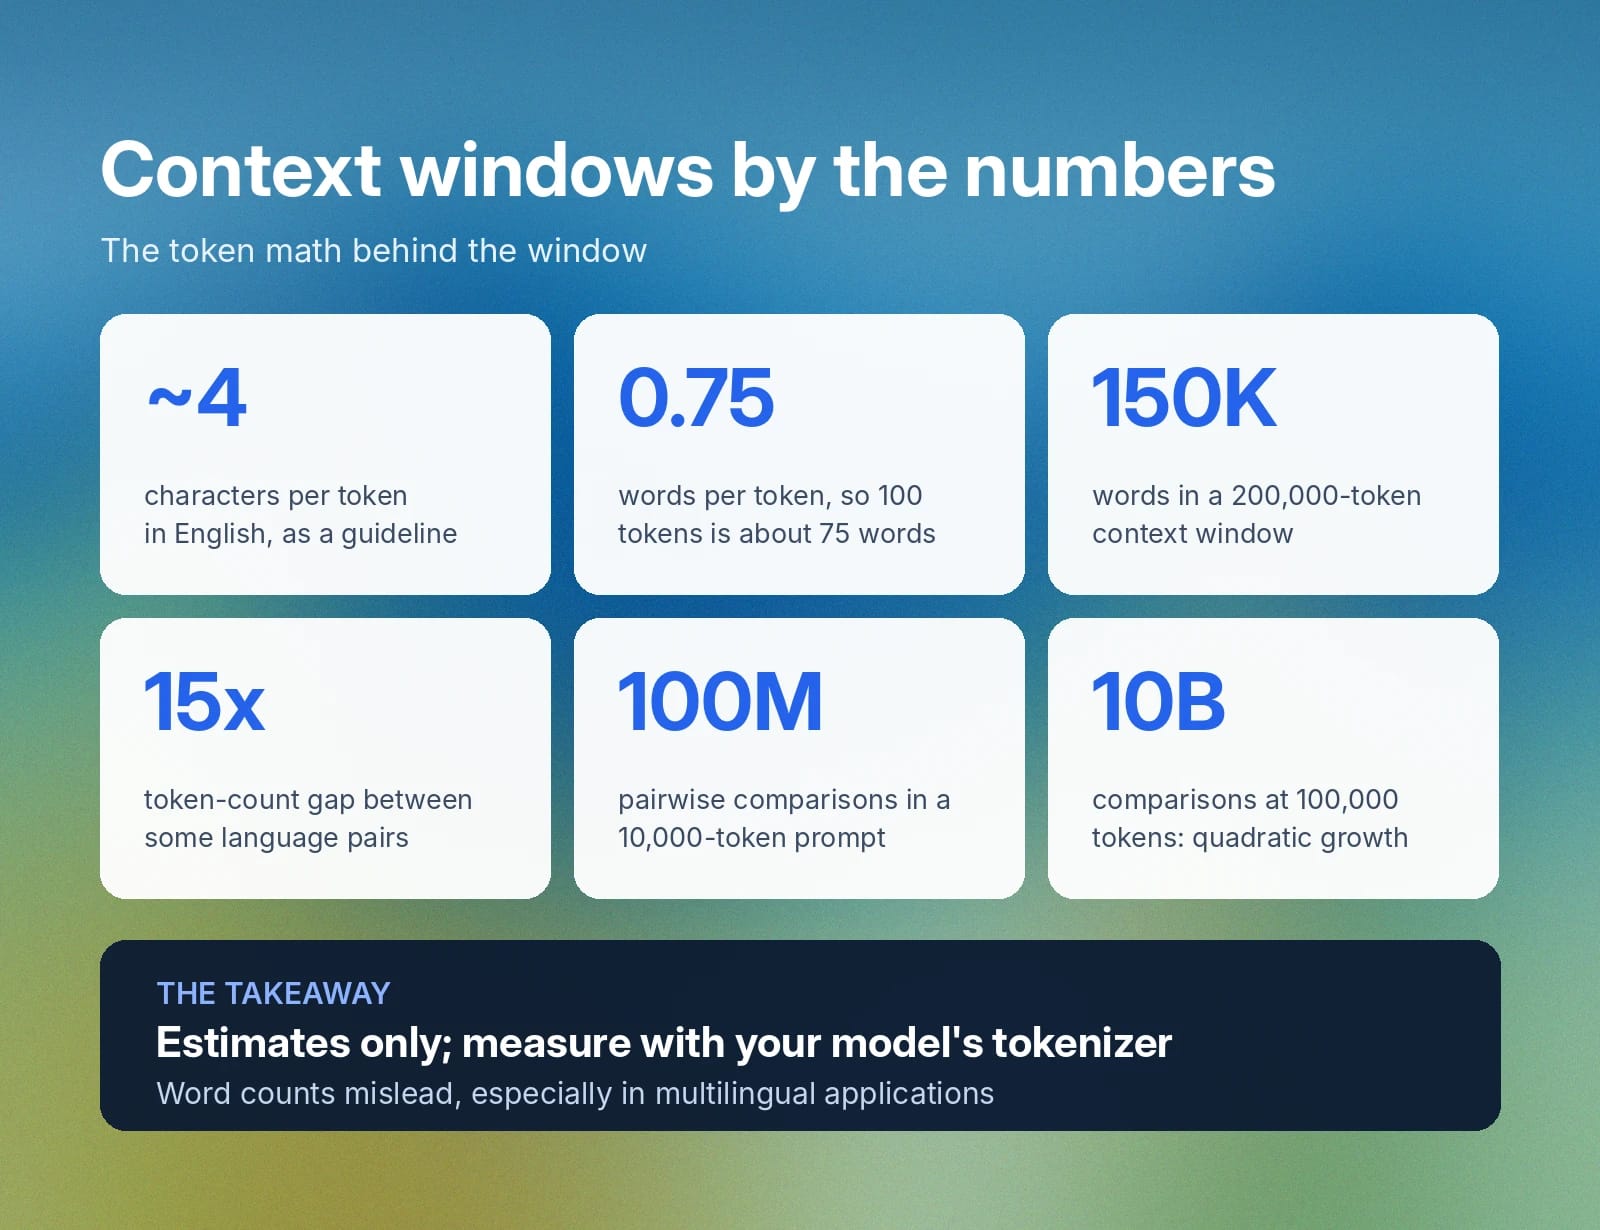
W języku angielskim przyjmuje się, że jeden token odpowiada mniej więcej czterem znakom, czyli około trzem czwartym słowa. Według tego szacunku 100 tokenów to około 75 słów. To jednak tylko przybliżenie. Rozważmy zdanie „Okna kontekstowe wpływają na wydajność aplikacji”. Tokenizer nie musi przedstawiać go jako pięciu pełnych słów; zależnie od tokenizera jedno lub więcej słów może zostać podzielonych na kilka tokenów cząstkowych.
Tokenizacja znacznie różni się też między językami. Dwa zdania o podobnym znaczeniu i podobnej widocznej długości mogą zużywać bardzo różną liczbę tokenów, zależnie od języka i tokenizera. Badania nad sprawiedliwością tokenizerów wykazały, że w przypadku niektórych par językowych tokenizowana długość równoważnego tekstu może różnić się nawet 15-krotnie, także przy tokenizerach obsługujących wiele języków. Deweloperzy tworzący aplikacje wielojęzyczne powinni mierzyć użycie tokenów rzeczywistym tokenizerem danego modelu, zamiast szacować je na podstawie liczby słów.
Okno kontekstowe o pojemności 200 000 tokenów może brzmieć imponująco, ale aplikacja, która stale dodaje historię rozmowy, pobraną dokumentację, odpowiedzi narzędzi i instrukcje systemowe, może osiągnąć ten limit szybciej, niż się spodziewasz. Dlatego aplikacje produkcyjne często monitorują użycie tokenów i stosują podsumowywanie, przycinanie historii, filtrowanie pobieranych danych oraz kompresję promptów, aby najistotniejsze informacje mieściły się w aktywnym kontekście.
Jak działa okno kontekstowe w modelach językowych?
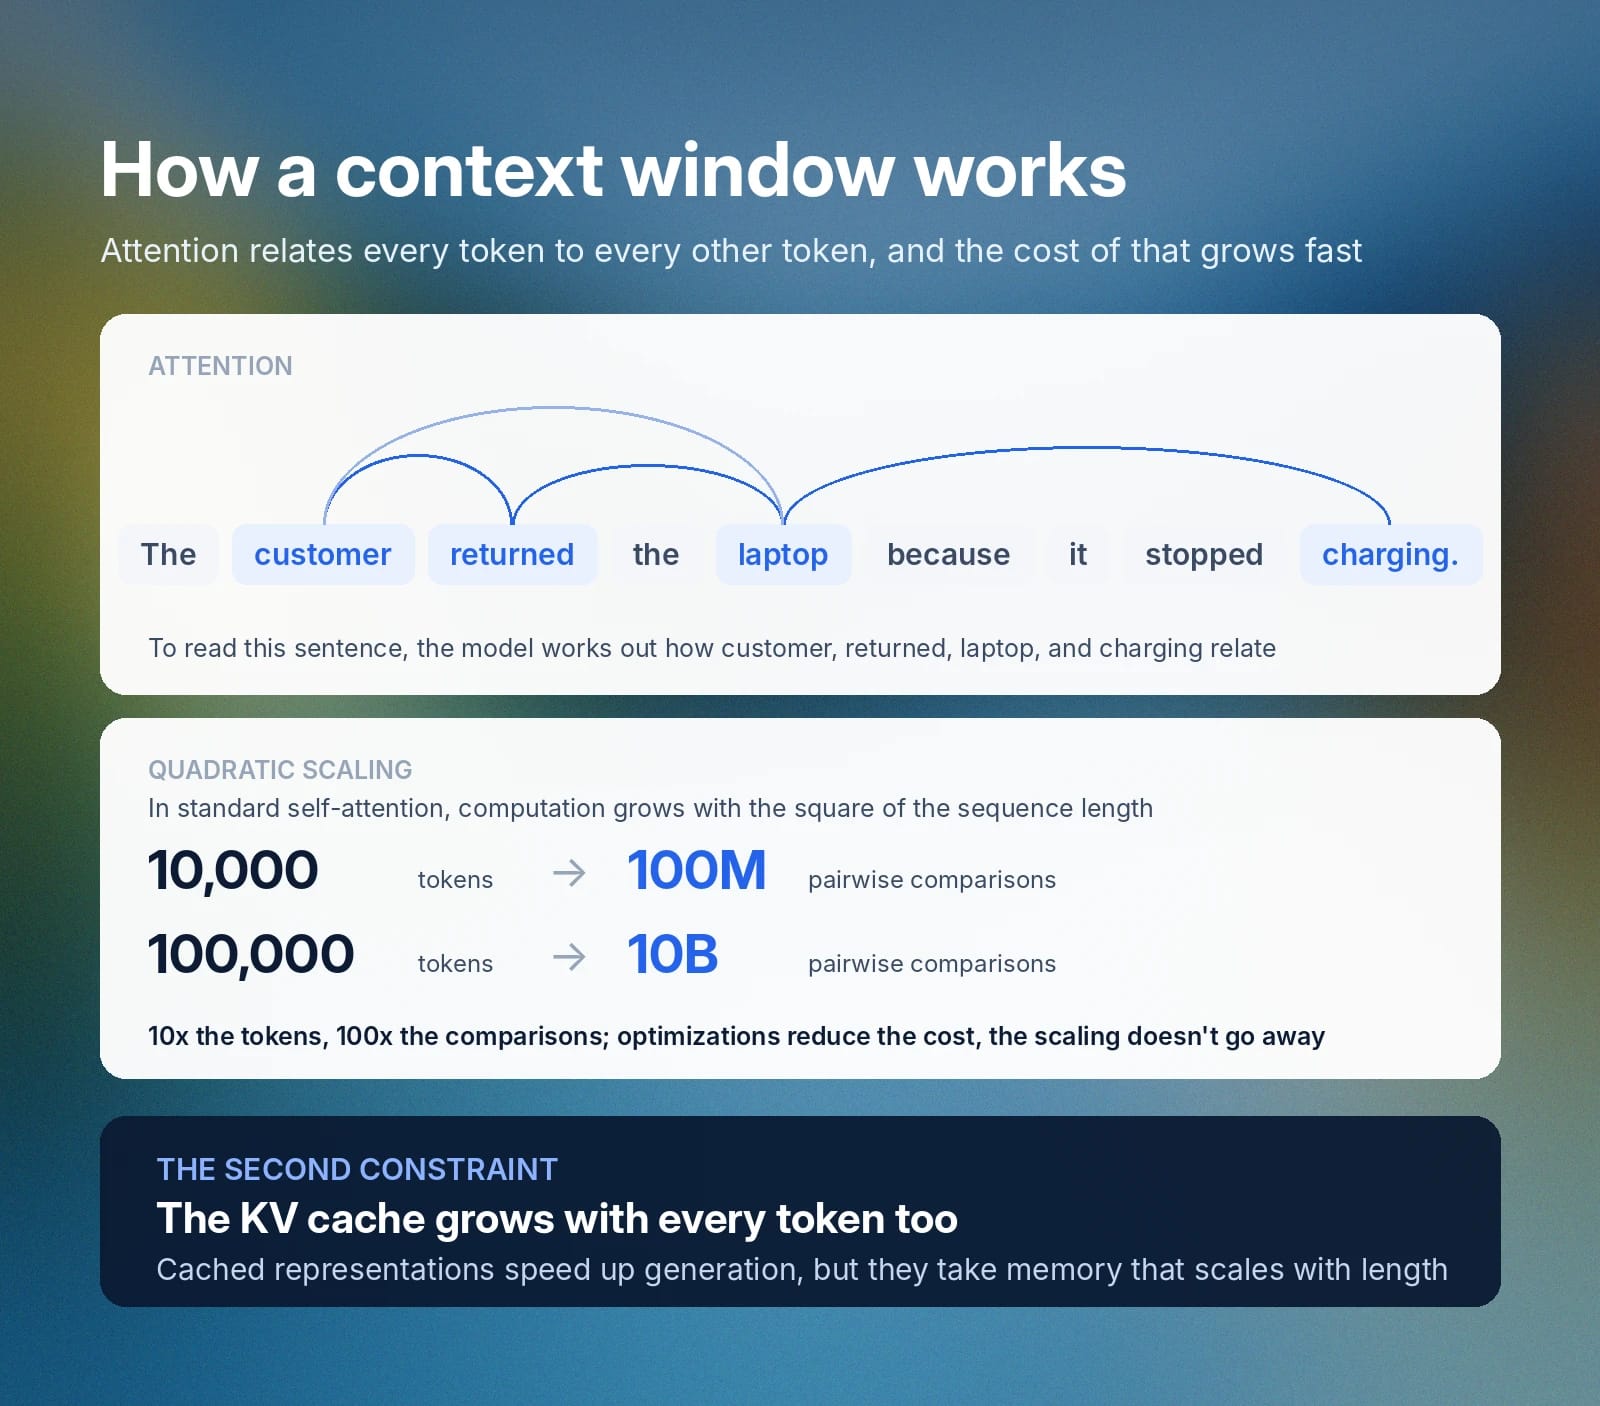
Okno kontekstowe działa dzięki mechanizmowi uwagi w architekturze transformera, który przed wygenerowaniem odpowiedzi oblicza, jak każdy token wejściowy odnosi się do każdego pozostałego tokenu.
Weźmy zdanie: „Klient zwrócił laptop, ponieważ przestał się ładować”. Aby poprawnie je zinterpretować, model musi ustalić, jak klient, laptop, zwrócił i ładowanie odnoszą się do siebie. Wraz z wydłużaniem sekwencji liczba tych zależności szybko rośnie.
W standardowym self-attention wymagane obliczenia rosną mniej więcej z kwadratem długości sekwencji. Na przykład prompt o długości 10 000 tokenów wymaga około 100 milionów porównań par, a prompt o długości 100 000 tokenów — około 10 miliardów. Współczesne modele wykorzystują różne optymalizacje architektury i infrastruktury, by w praktyce obniżyć ten koszt, ale podstawowy problem skalowania nie znika.
Długie rozmowy dodają drugie ograniczenie: cache klucz-wartość, czyli KV cache. Podczas generowania modele zachowują pośrednie reprezentacje wcześniejszych tokenów zamiast przeliczać je dla każdego nowego tokenu, co znacznie przyspiesza inferencję. Sam cache zajmuje jednak pamięć i rośnie wraz z długością sekwencji.
Maksymalna długość kontekstu w modelach AI i dlaczego ma znaczenie
Maksymalna długość kontekstu modelu określa, ile informacji może on przyjąć i przetworzyć w jednym żądaniu. Osobną kwestią jest jednak to, czy model skutecznie wykorzystuje duże okno kontekstowe.
Dłuższe okna kontekstowe umożliwiają zastosowania, które były trudne lub niepraktyczne dla wcześniejszych LLM-ów. Deweloperzy mogą przekazać modelowi całe repozytorium kodu, długi dokument prawny, artykuł naukowy, transkrypcję spotkania lub obszerną historię rozmowy bez wcześniejszego skracania materiału do kilku tysięcy tokenów.
To ważne, ponieważ zachowanie większej części oryginalnego kontekstu może poprawić zdolność modelu do trafnego odpowiadania na pytania, rozpoznawania zależności między odległymi fragmentami informacji i wykonywania zadań zależnych od całego dokumentu. Na przykład asystent programistyczny może potrzebować przeanalizować kilka plików, by zrozumieć, jak wywoływana jest funkcja, a asystent do dokumentów prawnych — porównać definicje z jednej sekcji z obowiązkami opisanymi znacznie dalej.
Większe okno kontekstowe nie zapewnia jednak automatycznie lepszych wyników. Bardzo długie dane wejściowe mogą zwiększać koszt i opóźnienie, a modele mogą poświęcać mniej uwagi informacjom ukrytym w środku dużego kontekstu. Deweloperzy powinni więc wybiórczo dodawać istotne informacje, jasno organizować długie dane wejściowe i w razie potrzeby stosować pobieranie danych, podsumowywanie oraz przycinanie kontekstu.
Porównanie rozmiarów okien kontekstowych według modelu
Okna kontekstowe znacznie różnią się w najważniejszych współczesnych rodzinach modeli — od kilkuset tysięcy do 10 milionów tokenów. Tak wypada porównanie obecnych modeli flagowych:
Model | Okno kontekstowe | Uwagi |
10 milionów tokenów | Model Meta z otwartymi wagami; największe publicznie dostępne okno w chwili pisania | |
1,05 miliona tokenów | Obecny flagowy model OpenAI do programowania i rozumowania agentowego | |
1 milion tokenów | Obecny model Google z serii Pro do analizy długich dokumentów i wielu plików | |
1 milion tokenów | Obecny model Anthropic z serii Sonnet; okno jest domyślnie stosowane w całym API Claude |
Reklamowane limity szybko się zmieniają, gdy dostawcy wydają nowe modele i podnoszą pułapy, więc taką tabelę traktuj jako migawkę, a nie stały ranking. Rozmiar kontekstu to też tylko jeden z czynników wyboru modelu. Sam w sobie nie mówi nic o jakości rozumowania, limitach wyjścia, opóźnieniu ani koszcie.
Skutki małego i dużego okna kontekstowego
Małe okno kontekstowe zmusza deweloperów do selekcji. Długie dokumenty dzieli się na fragmenty, starszą historię rozmów podsumowuje, a zewnętrzną wiedzę pobiera tylko wtedy, gdy jest naprawdę potrzebna.
Duże okno kontekstowe usuwa część tych ograniczeń. Możesz podać więcej przykładów, zachować więcej historii rozmowy lub przeanalizować większy zbiór dokumentów bez wcześniejszego dzielenia wszystkiego.
Większe okno wprowadza jednak inny problem: rozmycie uwagi. Gdy prompt zawiera dużo informacji, model może mieć trudność z ustaleniem, które szczegóły są najistotniejsze dla bieżącego żądania. Ważne instrukcje lub dowody mogą zaginąć wśród mniej istotnych treści, co zwiększa ryzyko niepełnych, niespójnych lub mniej precyzyjnych odpowiedzi.
Dlaczego modele gubią się w środku
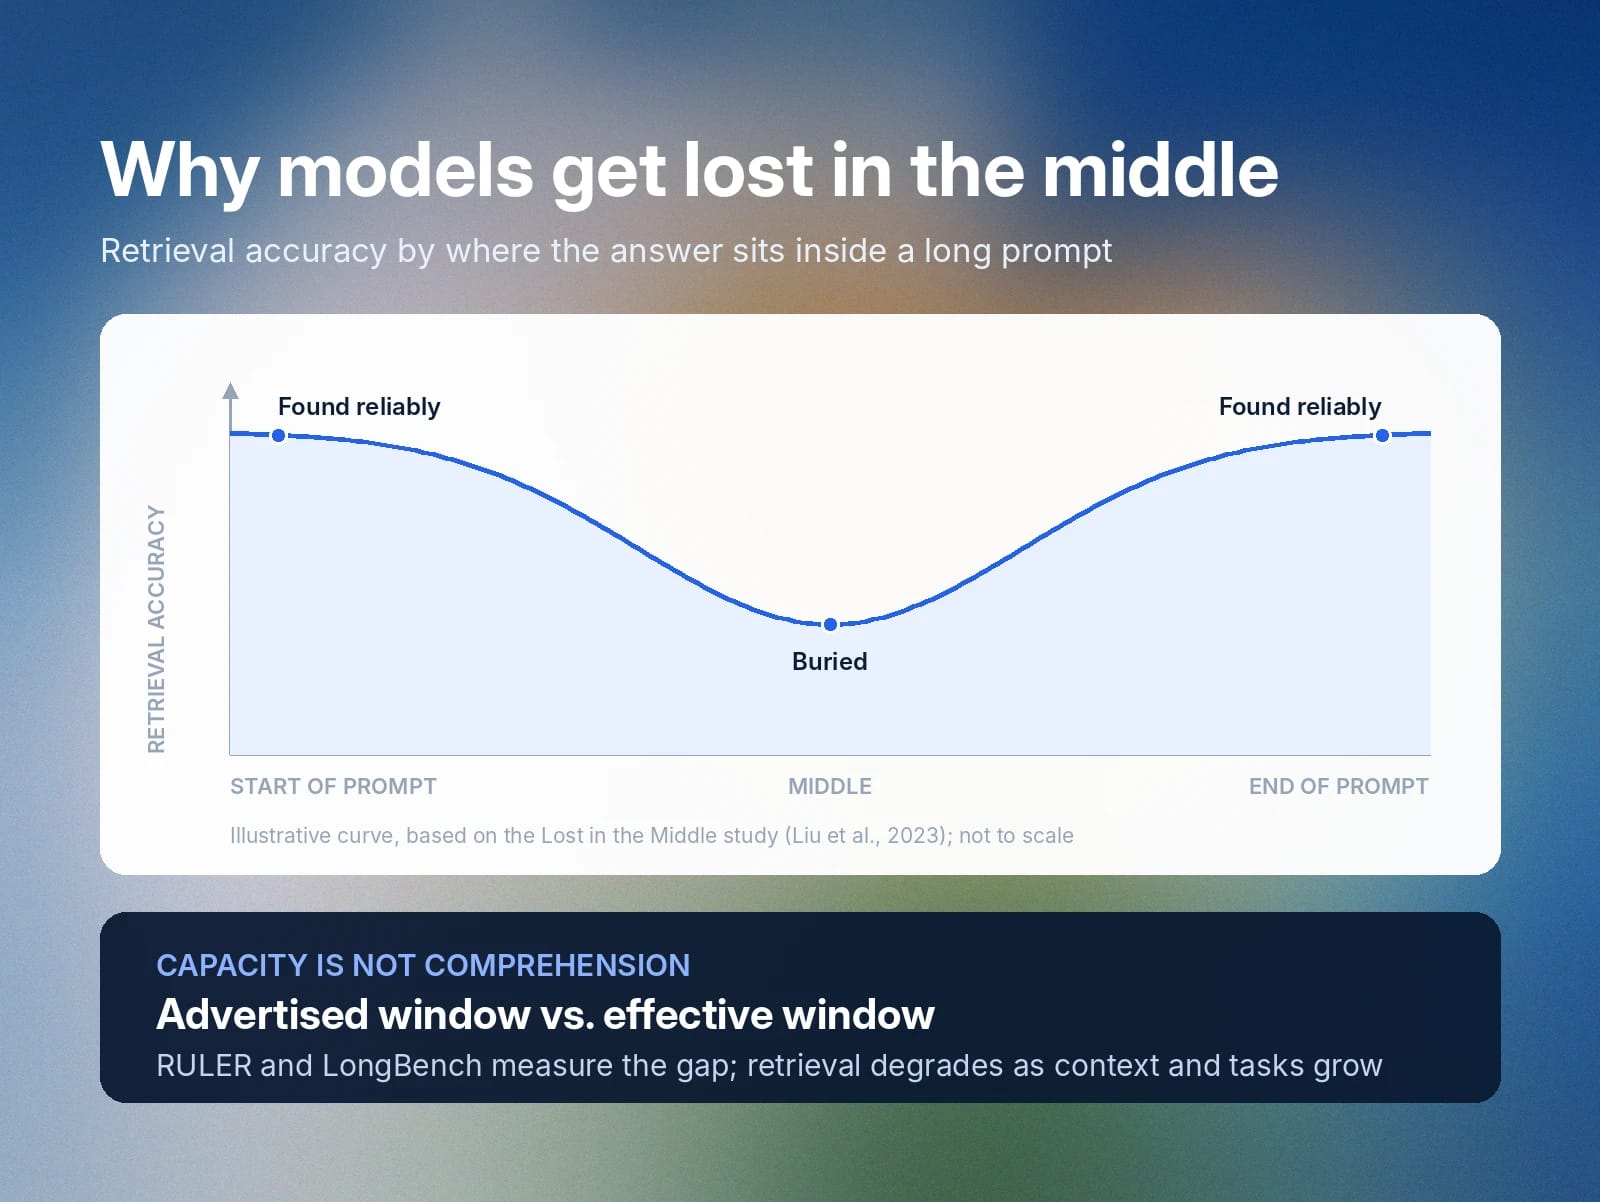
Modele zwykle najlepiej pobierają informacje znajdujące się na początku lub końcu długiego promptu, a najgorzej — ukryte w środku. Wpływowe badanie Lost in the Middle sprawdziło to bezpośrednio, umieszczając odpowiedź na pytanie w różnych miejscach długiego promptu i mierząc, jak często modele ją znajdowały. Trafność była stale najwyższa na początku i końcu kontekstu, a najniższa w środku.
Oznacza to, że model może technicznie przyjąć dokument, nie wykorzystując niezawodnie każdej jego części. Wyślij LLM-owi 100 dokumentów pomocy technicznej, bo jeden z nich zawiera odpowiedź na pytanie klienta, a większe okno kontekstowe może pomieścić je wszystkie. Model nadal musi jednak wyłowić jeden istotny fragment spośród 99 nieistotnych, a dłuższe okno tego nie gwarantuje.
Warto więc odróżniać reklamowane okno kontekstowe modelu od jego efektywnego okna kontekstowego dla danego obciążenia. Benchmarki takie jak RULER i LongBench próbują mierzyć tę różnicę. RULER wykazał, że modele uzyskujące niemal idealne wyniki w prostych testach pobierania danych nadal radziły sobie gorzej wraz ze wzrostem długości kontekstu i złożoności zadania. LongBench ocenia szersze zadania, w tym odpowiadanie na pytania o dokumenty, rozumowanie na podstawie wielu dokumentów, podsumowywanie, few-shot learning i uzupełnianie kodu.
Długi kontekst nadal wnosi realną wartość. Pojemność i rozumienie to po prostu różne właściwości, a obie mają znaczenie przy wyborze modelu do danego zadania.
Zarządzanie limitami kontekstu: dobre praktyki dla deweloperów
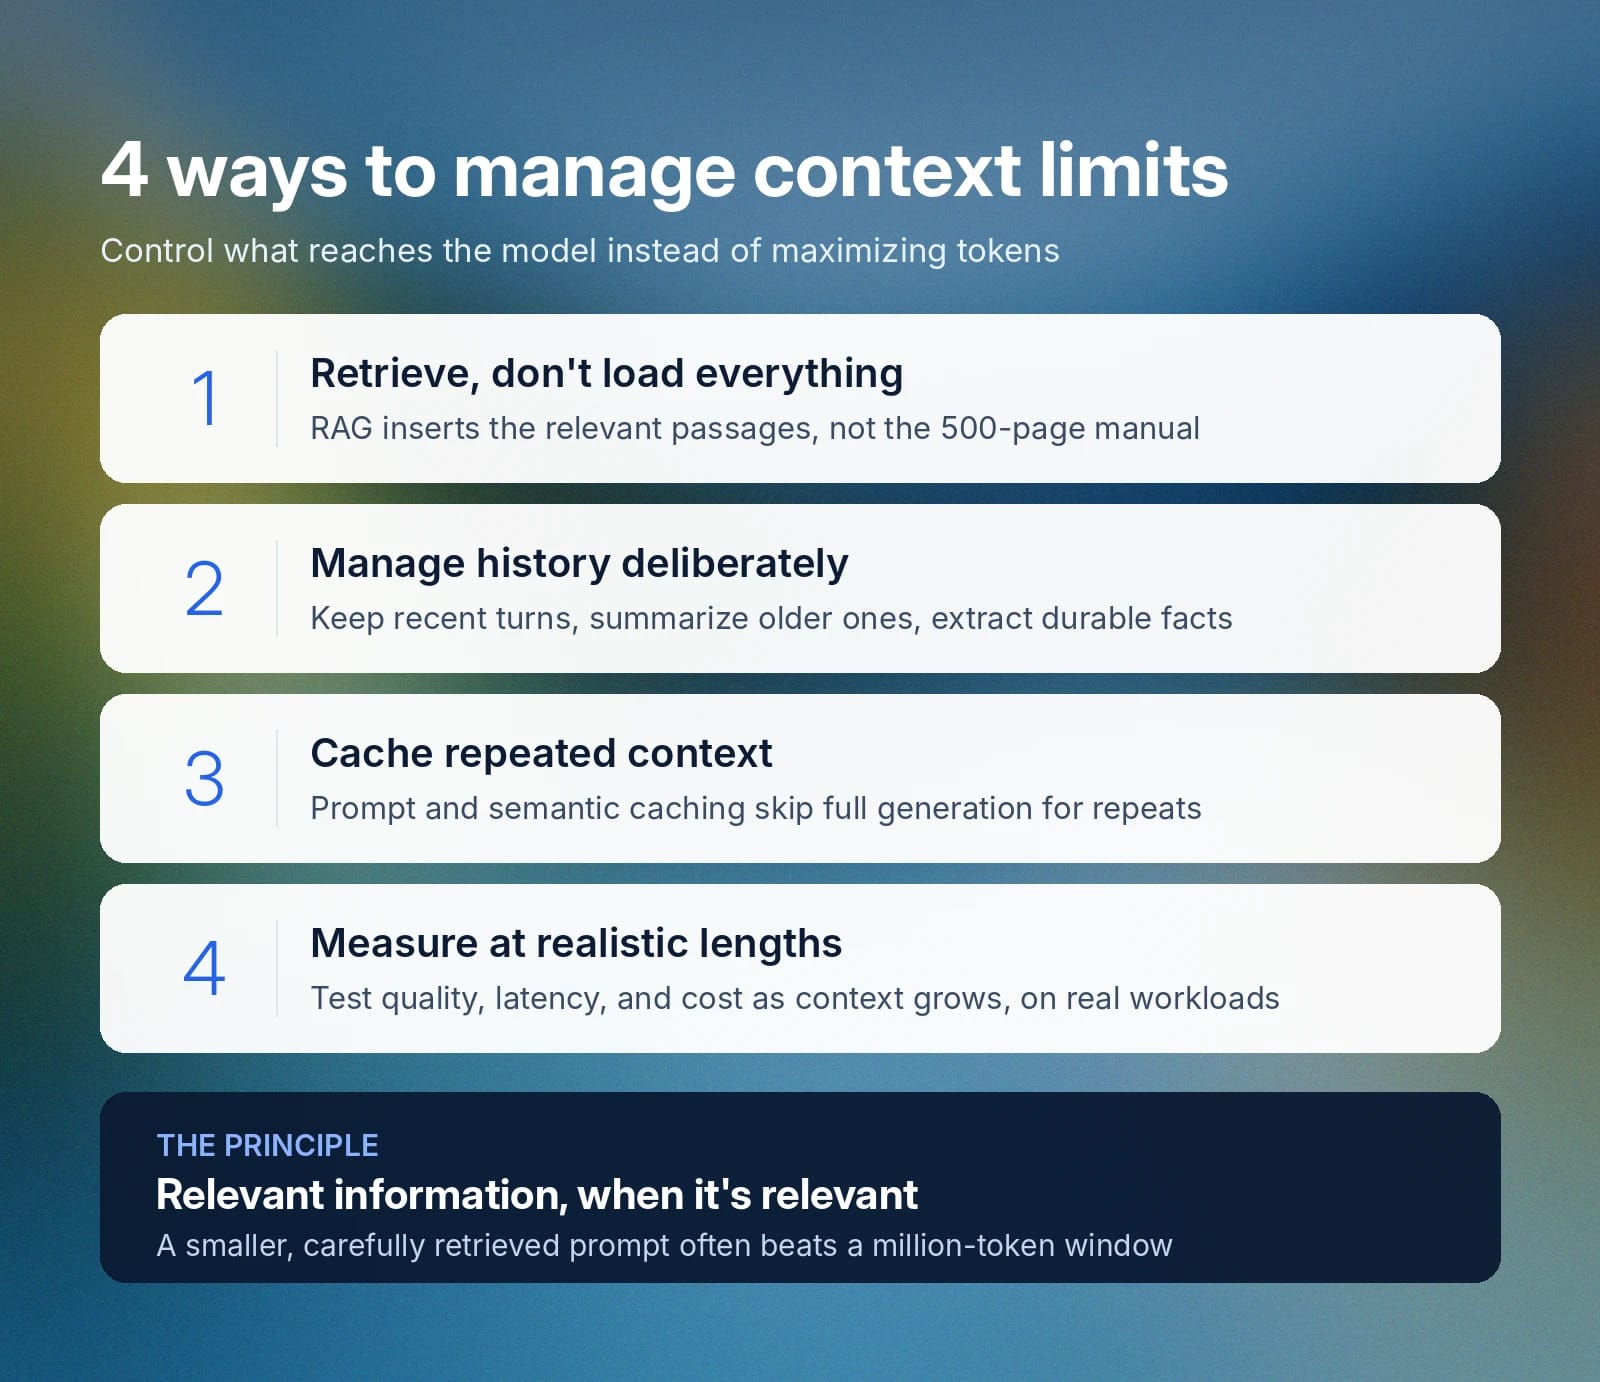
Dobre zarządzanie kontekstem oznacza kontrolowanie tego, co trafia do modelu: dostarczanie informacji istotnych dla zadania wtedy, gdy są potrzebne, zamiast maksymalizowania liczby tokenów w każdym żądaniu. Poniższe praktyki mogą pomóc deweloperom ograniczyć zbędny kontekst, poprawić jakość odpowiedzi oraz kontrolować koszt i opóźnienie.
1. Pobieraj istotne informacje zamiast ładować wszystko
Retrieval-augmented generation, czyli RAG, pozwala aplikacji przeszukać zewnętrzną bazę wiedzy i umieścić w kontekście modelu tylko istotne fragmenty. Zamiast dodawać do każdego zgłoszenia pomocy cały 500-stronicowy podręcznik, aplikacja pobiera kilka fragmentów najbliższych faktycznemu pytaniu klienta.
Zmniejsza to użycie tokenów i daje modelowi znacznie wyraźniejszy sygnał, co ma znaczenie. Jakość pobierania nadal jest ważna: produkcyjne systemy RAG zwykle poprawiają wyniki, starannie dzieląc dokumenty na fragmenty, pobierając kilka kandydatów, ponownie je rankingując i odfiltrowując nieistotne treści przed zbudowaniem końcowego promptu. ElevenLabs na przykład przebudowało pipeline RAG, dodając przepisywanie zapytań i równoległe wywołania modeli, co skróciło medianę opóźnienia pobierania o połowę.
2. Świadomie zarządzaj historią rozmowy
Aplikacje konwersacyjne szybko gromadzą kontekst. Dodawanie bez końca każdej wcześniejszej wiadomości marnuje tokeny i może wprowadzać nieistotne szczegóły do kolejnych tur.
Aplikacje radzą sobie z tym, zachowując najnowsze tury, podsumowując starsze wymiany, wyodrębniając trwałe fakty do uporządkowanej pamięci i pobierając starsze szczegóły tylko wtedy, gdy znów stają się istotne. Tworzy to użyteczny podział między krótkoterminowym kontekstem rozmowy, którego model potrzebuje od razu, a długoterminową pamięcią aplikacji, którą można później ponownie wykorzystać.
3. Używaj cache, gdy kontekst się powtarza
Wiele aplikacji wielokrotnie wysyła te same obszerne instrukcje albo odpowiada na pytania semantycznie podobne do tych, które już obsłużyły. Cache ogranicza ten narzut.
Cache promptów lub kontekstu pozwala efektywniej ponownie wykorzystywać powtarzające się dane wejściowe, a cache semantyczny idzie o krok dalej, rozpoznając, że nowe pytanie znaczy mniej więcej to samo, co pytanie, na które system już odpowiedział. „Jaka jest wasza polityka zwrotów?” i „Ile mam czasu na zwrot produktu?” to różne ciągi znaków, które cache semantyczny może potraktować jako to samo pytanie, pomijając pełne wywołanie generowania i zmniejszając zarówno opóźnienie, jak i koszt tokenów.
4. Mierz wydajność przy realistycznych długościach kontekstu
Nie wybieraj strategii kontekstu wyłącznie na podstawie reklamowanego przez dostawcę modelu limitu tokenów. Testuj reprezentatywne obciążenia produkcyjne i mierz jakość odpowiedzi, dokładność pobierania, opóźnienie, użycie tokenów, koszt i wskaźniki błędów wraz ze wzrostem długości kontekstu.
Porównuj strategie, takie jak dostarczanie większego kontekstu, pobieranie mniejszej liczby fragmentów, podsumowywanie historii rozmowy czy łączenie pobierania z podsumowywaniem. Model z oknem kontekstowym na milion tokenów może technicznie obsługiwać twoją aplikację, podczas gdy mniejszy, starannie pobrany prompt zapewni szybsze i trafniejsze wyniki przy niższym koszcie.
Zacznij z ElevenAgents i twórz skalowalne rozwiązania językowe
Zarządzanie kontekstem jest najważniejsze w agentach konwersacyjnych, które muszą łączyć bieżącą wypowiedź z poprzednimi turami, instrukcjami biznesowymi, informacjami o klientach, zawartością bazy wiedzy i wynikami narzędzi, a jednocześnie odpowiadać wystarczająco szybko, by rozmowa była naturalna.
ElevenAgents łączy te elementy na jednej platformie do tworzenia i wdrażania głosowych agentów AI. Jego silnik orkiestracji koordynuje rozpoznawanie mowy, LLM i Text to Speech, a deweloperzy konfigurują prompty, bazy wiedzy, narzędzia, workflow i bazowy model językowy. Ekspresyjny sposób mówienia, w tym to, jak agent przekazuje kontekst emocjonalny w mowie, zależy od tego samego kontekstu, który kształtuje przede wszystkim to, co agent mówi.
W zakresie zarządzania wiedzą ElevenAgents obsługuje zarówno dokumenty w pełnym kontekście, jak i RAG, konfigurowany bezpośrednio na platformie. Małe dokumenty trafiają bezpośrednio do promptu agenta, dzięki czemu ich treść pozostaje dostępna przez całą rozmowę. Większe bazy wiedzy są natomiast indeksowane, a RAG pobiera istotne fragmenty dla każdego zapytania zamiast ładować wszystko naraz do okna kontekstowego.
Zacznij już dziś, rejestrując się w ElevenAgents lub porozmawiaj z naszym zespołem o dostępnych opcjach wdrożenia.
FAQ: czym jest okno kontekstowe?

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.

