Czym jest zarządzanie turami w Conversational AI: przewodnik po naturalnym przebiegu rozmowy
- Autor
- Jack Limebear
- Opublikowano
PosłuchajPosłuchaj tego artykułu
Dobra obsługa klienta wymaga świetnych umiejętności rozmowy. Jedną z najważniejszych jest umiejętność słuchania i wiedza, kiedy się odezwać. W przeciwnym razie konsultanci mogą przerwać już zdenerwowanym klientom, którzy być może dzwonili kilka razy, by wyjaśnić swój problem.
Ten sam standard obowiązuje przy zarządzaniu turami w Conversational AI. Agenci muszą zachować delikatną równowagę: milczeć wystarczająco długo, by rozmówca mógł mówić, ale nie na tyle, by opóźnienia i cisza obniżyły jakość rozmowy.
Dlatego nowoczesne zarządzanie turami w rozmowie wymaga, by modele szybko oceniały intencję wypowiedzi, zamiast używać sztywnych liczników ciszy. Nasza zunifikowana architektura w ElevenLabs stale analizuje ton, rytm i kontekst słów, aby rozmowy przebiegały płynnie i naturalnie.
Podsumowanie
- Zespoły obsługi klienta wdrażają agentów głosowych szkolonych w zarządzaniu turami, by szybciej rozwiązywać problemy przy mniejszym wysiłku.
- Zarządzanie turami pozwala modelom określić, kiedy odpowiedzieć lub podjąć rozmowę, kontynuować wypowiedź, słuchać albo milczeć.
- Agenci AI korzystają z adaptacyjnego taktowania, wykrywania aktywności głosowej i analizy semantycznej, aby utrzymać naturalny przebieg rozmowy.
- Zespoły inżynieryjne śledzą opóźnienie odpowiedzi i częstotliwość przerwań, aby mierzyć płynność rozmów i optymalizować workflow.
Czym jest zarządzanie turami w Conversational AI?
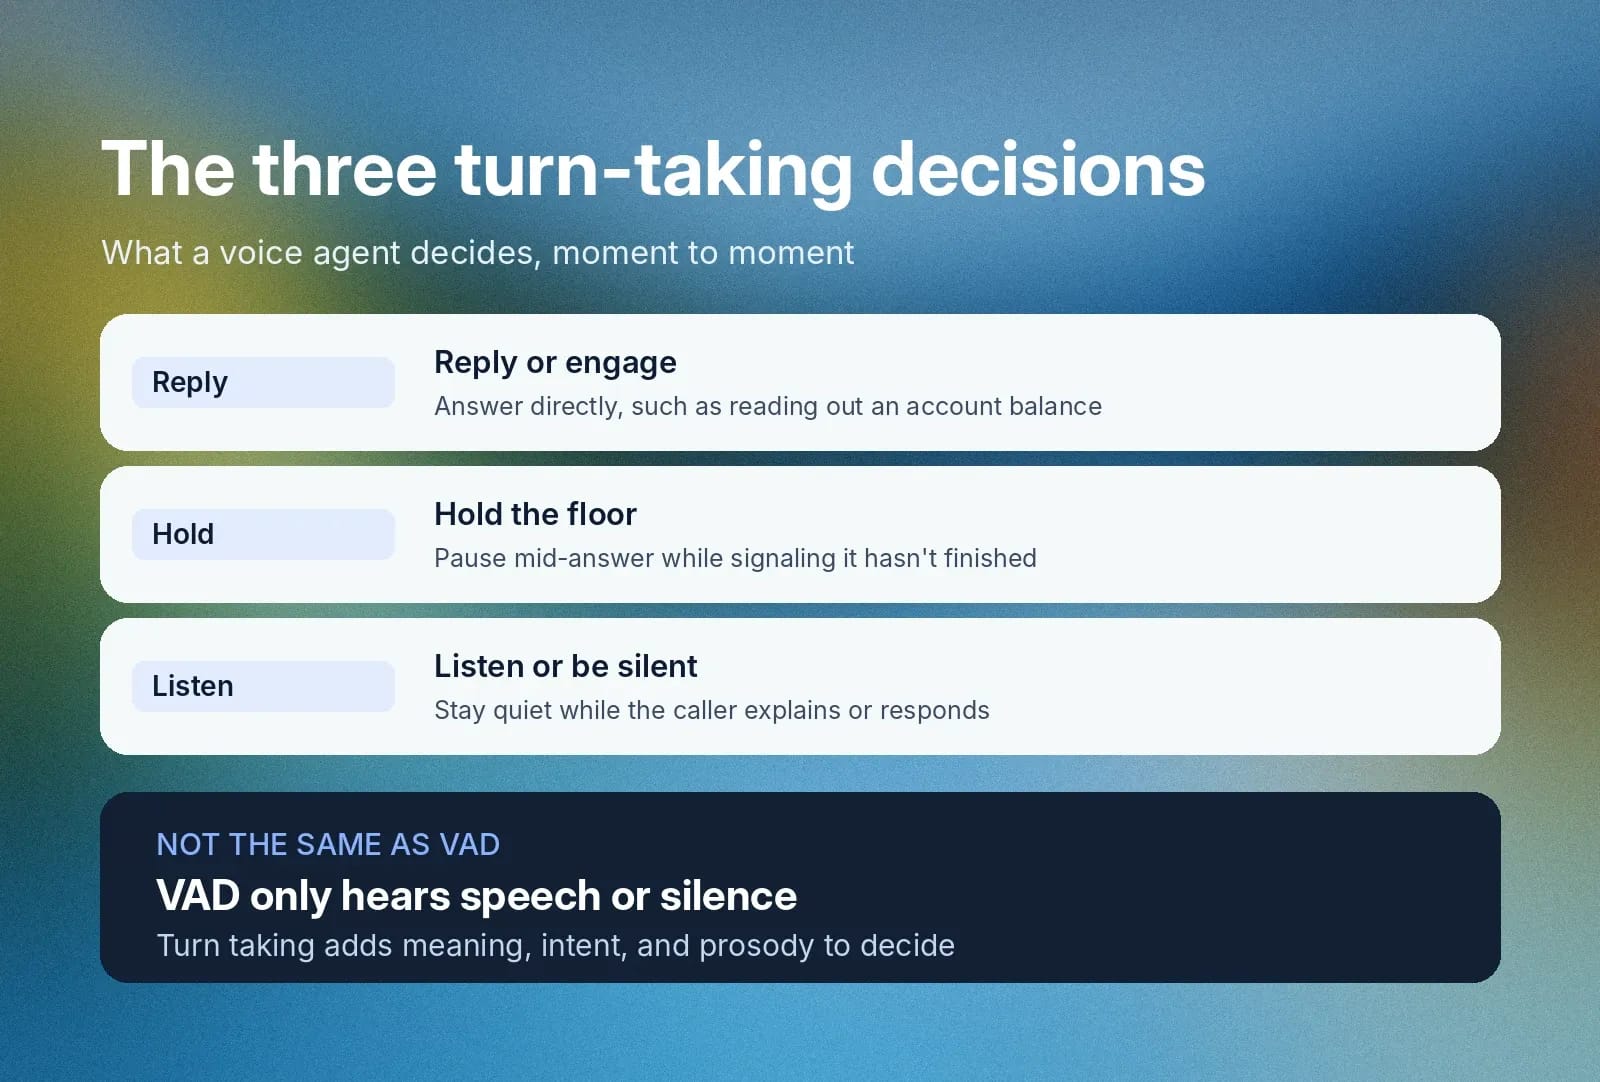
Gdy modele Conversational AI zarządzają turami, stosują zestaw reguł określających najlepszy moment, aby:
- Odpowiedzieć lub podjąć rozmowę: Agent AI odpowiada tu bezpośrednio na pytanie. Na przykład klient pyta o saldo konta, a system odpowiada: „Saldo konta wynosi 57,34 USD”.
- Kontynuować wypowiedź: W tym przypadku model mówi dalej i sygnalizuje, że jeszcze nie skończył, nawet podczas przerwy. Na przykład klient pyta o saldo konta, a system odpowiada: „Najpierw użyję podanych przez ciebie informacji, by otworzyć twoje konto… [pause]. Saldo konta wynosi 57,34 USD, ale… [pause] widzę też oczekującą płatność na tę kwotę. Dzwonisz, żeby sprawdzić, kiedy płatność zostanie zaksięgowana bez naliczenia opłaty za zwłokę?”
- Słuchać lub milczeć: W tym momencie agent milczy, czekając, aż klient wyjaśni sytuację lub odpowie. Na przykład klient potwierdza, że chce sprawdzić, czy płatność została zaksięgowana, ponieważ minęło kilka dni od jej wysłania. Model AI odpowiada: „Tak, widzę, że minęły dwa dni od wysłania płatności. Przetworzenie zwykle zajmuje trzy dni, więc powinna zostać zaksięgowana do jutra rano. Nie zostanie naliczona opłata za zwłokę. Czy mogę pomóc w czymś jeszcze?”
Dokumentacja dla deweloperów często nazywa to wykrywaniem tury lub wykrywaniem końca tury. Systemy, które łączą wykrywanie aktywności głosowej z rozumieniem języka, aby ocenić, czy rozmówca skończył mówić, często określa się jako semantyczny VAD.
Ten płynny sposób prowadzenia dialogu z klientem eliminuje sztywne komunikaty w stylu krótkofalówki i pozwala agentom głosowym prowadzić naturalną rozmowę.
Warto też zauważyć, że ta trzystopniowa warstwa decyzyjna Conversational AI różni się od zwykłego wykrywania aktywności głosowej (VAD). VAD klasyfikuje audio jako mowę lub ciszę, podczas gdy zarządzanie turami uwzględnia oprócz surowego sygnału kontekst semantyczny, intencję i prozodię. Zobacz nasz przewodnik po VAD — znajdziesz w nim dokładniejsze omówienie działania algorytmów wykrywania mowy i powodów, dla których ich potrzebujesz.
Dlaczego naturalne zarządzanie turami jest kluczowe dla agentów głosowych
Nieudane zarządzanie turami to najszybszy sposób, by zirytować klienta — zwłaszcza takiego, który już niechętnie rozmawia z mniej zaawansowanymi botami. Przestarzali agenci Conversational AI zagadują dzwoniących, robią długie i niezręczne przerwy lub nie nadążają za rozmową.
ElevenAgents używa adaptacyjnego taktowania, aby twoi zautomatyzowani agenci zachowali naturalny rytm rozmowy. Tak precyzyjne wyczucie czasu buduje zaufanie klientów do możliwości modelu. W efekcie wzmacnia też zaufanie do wdrożonej technologii i zaangażowania twojej marki w satysfakcję klientów.
Podczas korzystania z Eleven v4 Turbo z ElevenAgents mediana czasu od żądania do słyszalnej mowy wynosi 142 ms.
Dodatkowo dobrze zsynchronizowane zarządzanie turami utrzymuje zaangażowanie klientów wystarczająco długo, by rozwiązać problem za pierwszym razem, bez przekazywania rozmowy do konsultanta.
Jak działa zarządzanie turami w rozmowie w czasie rzeczywistym
Zarządzanie turami w czasie rzeczywistym korzysta z wielowarstwowego pipeline’u, który stale analizuje audio na żywo. Modele opierają się też na zestawie reguł, aby wybrać najlepsze działania zapewniające płynną rozmowę. ElevenAgents realizuje je w trzech etapach, dzięki czemu każda wymiana jest responsywna i naturalna.
Wykrywanie mowy, ciszy i intencji
Wykrywanie aktywności głosowej interpretuje i klasyfikuje przychodzące strumienie audio jako mowę lub ciszę kilkadziesiąt razy na sekundę. Gdy VAD dostarczy surowy sygnał, wykrywanie intencji określa, czy rozmówca rzeczywiście przestał mówić, czy tylko zrobił przerwę na zastanowienie. Aby potwierdzić zakończenie tury, może uwzględniać opadającą intonację lub składniowo kompletne zdanie. Z kolei o tymczasowej pauzie może świadczyć zawieszona intonacja albo słowa-wypełniacze, takie jak „yyy…” czy „jakby…”.
Decydowanie, kiedy odpowiedzieć
Ponieważ opóźnienia odpowiedzi mogą sprawić, że dzwoniący porzucą rozmowę, decyzja modelu o tym, kiedy odpowiedzieć, jest jednym z kluczowych czynników sukcesu. Tradycyjne architektury głosowe często używają restrykcyjnych liczników, by ustalić, czy osoba naprawdę przestała mówić, ale może to prowadzić do przerywania dzwoniącym, gdy próbują odezwać się ponownie, lub po prostu tworzyć niezręczną ciszę. Nowoczesne zarządzanie turami w Conversational AI wykorzystuje deep learning, by w pełni rozumieć sygnały takie jak prozodia, tempo mówienia i słowa-wypełniacze.
Zarządzanie opóźnieniem odpowiedzi od słuchania do wygenerowania mowy
Według badań lingwistycznych opublikowanych w „Journal of Cognition” przerwy między turami ludzkich rozmówców wynoszą średnio około 200 ms w różnych kulturach. Dlatego modele, które odpowiadają znacznie wolniej, tworzą niezręczne przerwy. To zwiększa zniecierpliwienie i prowadzi do wyższych wskaźników porzucania połączeń.
Obsługa przerwań, sygnałów potwierdzających i nakładającej się mowy
Dostawcy oraz sposób programowania modeli Conversational AI decydują o tym, jak dobrze agenci obsługują przerwania, sygnały potwierdzające i nakładającą się mowę.
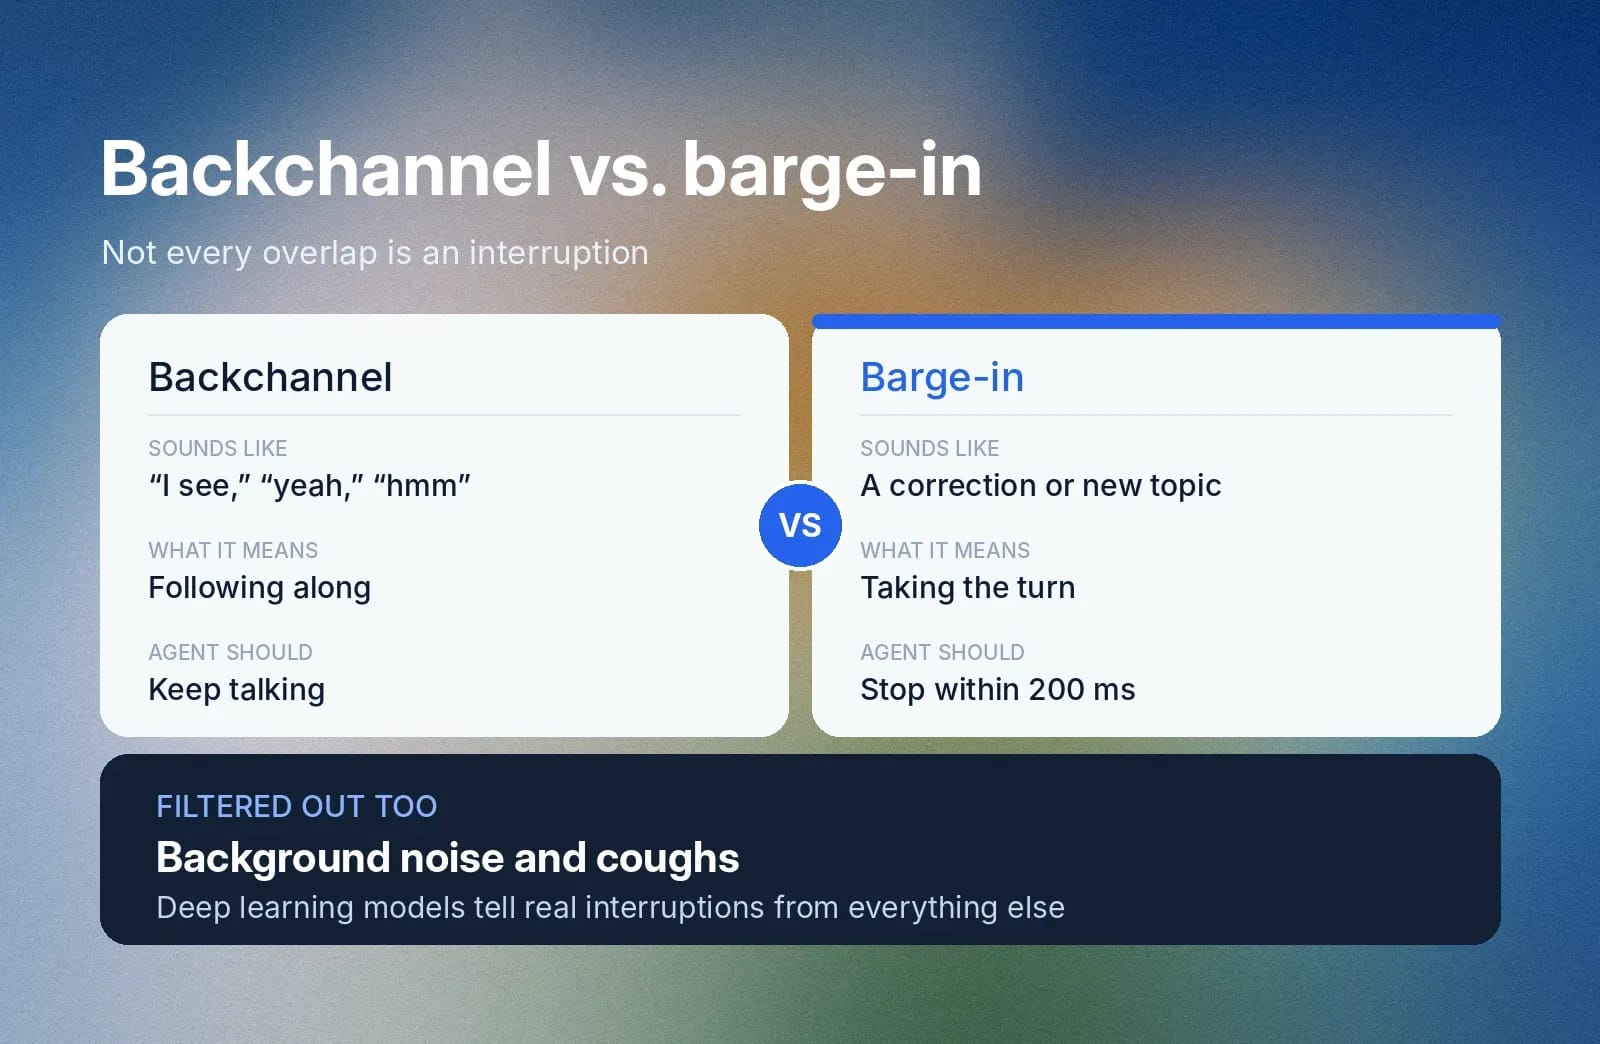
Sygnały potwierdzające to krótkie dźwięki lub słowa, takie jak „rozumiem” czy „tak”, którymi słuchacz pokazuje, że śledzi rozmowę, nie przejmując tury. Agent głosowy musi rozumieć te sygnały, aby mówić dalej, zamiast uznać je za próbę wtrącenia.
ElevenAgents obsługuje nakładające się wypowiedzi na żywo, natychmiast oddając głos, gdy dzwoniący rzeczywiście przerywa. Gdy rozmówca się wtrąca, na przykład by poprawić dane konta lub zmienić temat, ElevenAgents wysyła sygnał zatrzymania w czasie krótszym niż 200 ms. Agent przestaje wtedy mówić w połowie frazy, zamiast kończyć zaplanowane zdanie.
Nasze modele deep learning stale filtrują też szum tła i odróżniają prawdziwe przerwania od słów-wypełniaczy wyrażających potwierdzenie lub zastanowienie. Na przykład użytkownik, który mówi „rozumiem…” lub „hmmm…” podczas wypowiedzi agenta, tworzy nakładającą się mowę, ale nie próbuje się wtrącić.
Takie funkcje pomagają naszym agentom głosowym utrzymać precyzyjny czas odpowiedzi i naturalny przebieg rozmowy nawet podczas wtrąceń o wyraźnej intencji.
Typowe błędy w zarządzaniu turami i jak im zapobiegać
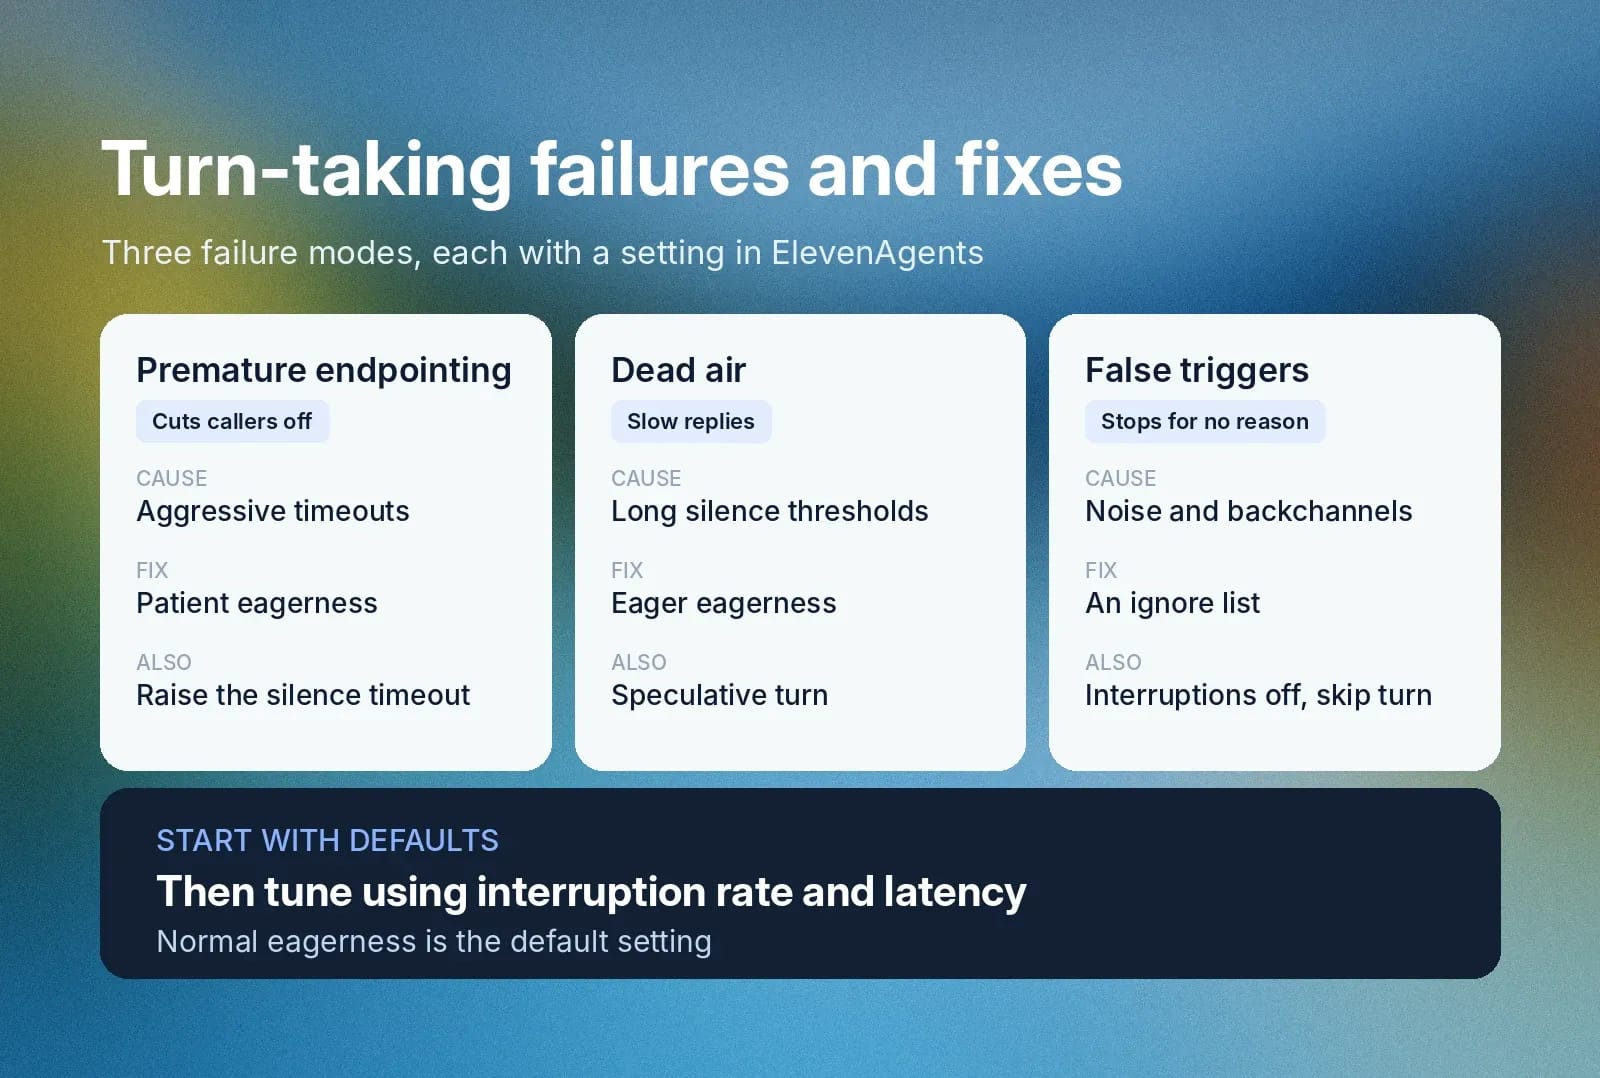
Modele Conversational AI napotykają trzy główne rodzaje błędów, które zespoły inżynieryjne muszą uwzględnić podczas konfiguracji agentów głosowych:
- Przedwczesne wykrycie końca wypowiedzi: Zbyt agresywne limity czasu mogą sprawić, że modele uznają za zakończoną turę przerwę w środku zdania, podczas której dzwoniący tylko się zastanawiał lub szukał informacji. Powoduje to częste przerywanie przez agenta głosowego i frustrację klientów.
- Cisza i opóźnione odpowiedzi: Zbyt wysokie progi ciszy powodują długie, niezręczne przerwy, które mogą zwiększać liczbę przerwanych połączeń. Przez te opóźnienia agenci głosowi wydają się powolni i niereagujący, co negatywnie wpływa na doświadczenie klienta i wizerunek marki.
- Fałszywe wyzwalacze przez słowa-wypełniacze i hałas: Źle dostrojone modele mogą też interpretować hałas otoczenia, kaszel i sygnały potwierdzające słuchacza jako prawdziwe przerwania. Model niepotrzebnie wstrzymuje się lub przestaje mówić, choć klient faktycznie słucha i nie próbuje przerwać.
Inżynierowie mogą zapobiegać tym problemom, wdrażając ElevenAgents z kontekstowymi modelami językowymi. To adaptacyjne podejście połączone z VAD eliminuje fałszywe przerwania, zbyt wolne odpowiedzi i nadmierną wrażliwość na szum tła.
Jak skonfigurować zarządzanie turami w ElevenAgents
Właściwe ustawienia zarządzania turami zależą od zastosowania i typowych połączeń, które odbierze twój agent. ElevenAgents pozwala zespołom dostroić w ustawieniach agenta każdy z opisanych wyżej rodzajów błędów.
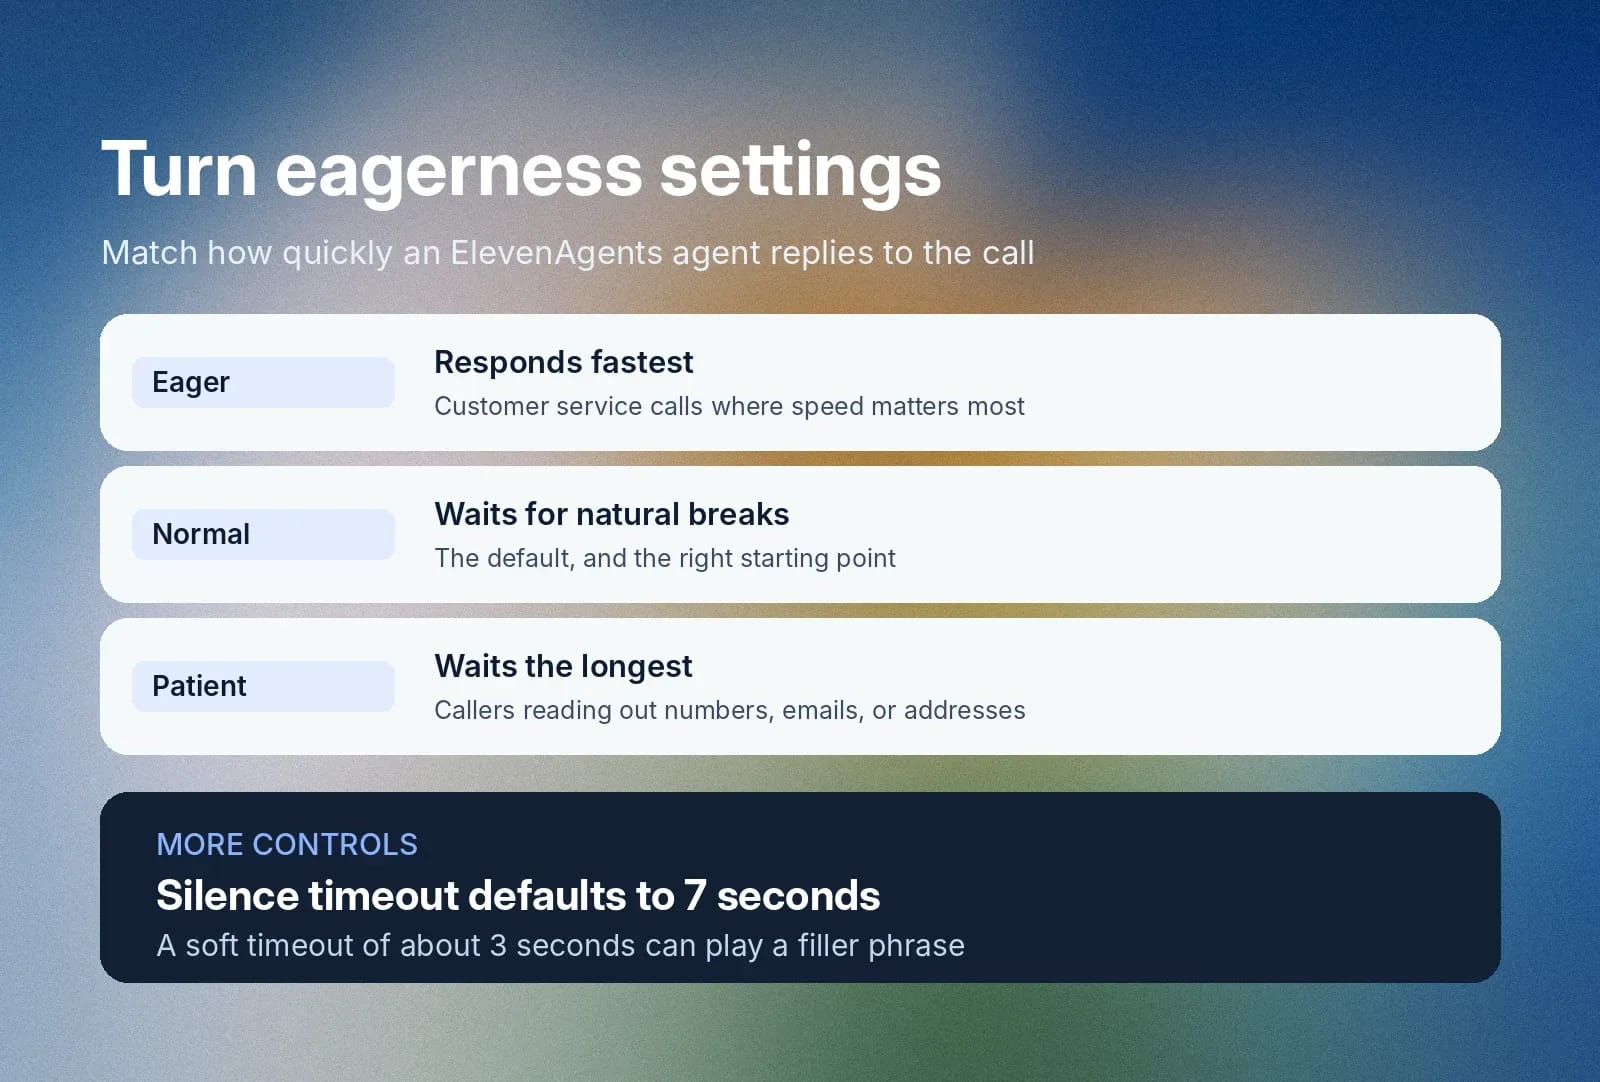
- Przedwczesne wykrycie końca wypowiedzi: Ustaw eagerness tury na Patient, gdy dzwoniący podają numery telefonów, e-maile, adresy lub inne wrażliwe dane. Eagerness ma trzy poziomy. Eager odpowiada szybciej, Normal (domyślny) czeka na naturalne przerwy, a Patient czeka najdłużej. Możesz też dostosować limit ciszy do zastosowania, na przykład 5–10 sekund dla responsywnej obsługi klienta albo 15–30 sekund dla zastrzeżeń prawnych. Domyślne i zalecane zakresy różnią się zależnie od kanału i scenariusza.
- Cisza i opóźnione odpowiedzi: Użyj ustawienia Eager w rozmowach z obsługą klienta, gdzie liczy się szybkość. Speculative turn uruchamia odpowiedź modelu językowego, zanim agent upewni się, że dzwoniący skończył, co zmniejsza opóźnienie, ale może też zwiększyć koszty LLM. Soft timeout może również odtworzyć krótką frazę-wypełniacz, gdy model działa wolno; zalecane są 3 sekundy.
- Fałszywe wyzwalacze i niechciane przerwania: Dodaj słowa potwierdzające, takie jak „racja”, do listy ignorowanych, aby nie przerywały agentowi. Wyłącz przerwania, gdy każde słowo musi zostać usłyszane, na przykład podczas odczytywania zastrzeżenia prawnego. Agent nadal może transkrybować wypowiedź dzwoniącego i przekazać ją w następnej turze. Przy frazach takich jak „daj mi chwilę” narzędzie skip-turn utrzymuje ciszę agenta i może odezwać się ponownie po ustalonym czasie.
Najlepszym sposobem użycia tych ustawień jest połączenie ich z Workflows, co pozwala agentowi dynamicznie zmieniać eagerness tury — na przykład z Normal podczas swobodnej rozmowy na Patient, gdy przechodzi do kroku zbierania numeru telefonu. Zacznij od ustawień domyślnych i dostosowuj eagerness oraz limity czasu na podstawie opisanych niżej wskaźników przerwań i opóźnień odpowiedzi.
Jak mierzyć jakość zarządzania turami w Conversational AI
Zespoły zapewnienia jakości potrzebują konkretnych wskaźników operacyjnych do oceny zarządzania turami w Conversational AI. Wymaga to przeniesienia uwagi z technologii i konfiguracji na rzeczywisty wpływ. Krótko mówiąc, muszą mierzyć więcej niż tylko to, co „brzmi naturalnie”, a co nie.
Dwa główne wskaźniki to częstotliwość przerwań i opóźnienie odpowiedzi. Częstotliwość przerwań mierzy, jak często model błędnie przerywa dzwoniącemu, a opóźnienie odpowiedzi śledzi, ile czasu model potrzebuje na odpowiedź, gdy osoba przestaje mówić i jej oczekuje. ElevenAgents rejestruje oba wskaźniki dla każdego połączenia, aby zespoły mogły wykorzystywać dane do optymalizacji progów wykrywania aktywności głosowej bez ręcznego przeglądania transkrypcji. Zobacz nasz przewodnik po pomiarze Conversational AI — znajdziesz w nim pełne omówienie ram oceny.
Zespoły QA utrzymują wysoką dokładność, tworząc ustrukturyzowany harmonogram oceny modelu. Oto przykład harmonogramu używanego przez typowy zespół.
Działanie oceniające
Częstotliwość
Cel QA
Monitoring operacyjny
Co tydzień
Śledzi działanie w czasie rzeczywistym i wykrywa problemy z czasem reakcji u działających agentów głosowych
Przeglądy satysfakcji użytkowników
Co miesiąc
Analizuje nastroje dzwoniących, aby dostroić konfigurację zarządzania turami
Pełne benchmarki systemu
Co kwartał
Ocenia dokładność end-to-end, zarządzanie turami w rozmowie i progi opóźnienia odpowiedzi
Wreszcie, choć dostępne są automatyczne wskaźniki, zespoły QA powinny nadal wybierać część danych do ręcznej analizy. Dokładniejsze dane uzyskają, badając surowe pliki audio zamiast samych transkrypcji tekstowych. Transkrypcje dodają bowiem kolejną warstwę automatyzacji i mogą pomijać błędy narzędzia do transkrypcji, zwłaszcza tam, gdzie wypowiedzi się nakładają.

Zacznij korzystać z ElevenAgents, aby prowadzić naturalne rozmowy głosowe
Agenci głosowi podobni do ludzi, którzy szybko rozwiązują problemy, obniżają koszty i zwiększają wydajność operacyjną. Aby osiągnąć te korzyści, potrzebujesz zaawansowanych modeli AI, które możesz dostroić pod kątem właściwego zarządzania turami. Zespoły inżynieryjne osiągają to, wdrażając ElevenAgents. Nasza zunifikowana architektura łączy wykrywanie aktywności głosowej z rozumieniem semantycznym, aby utrzymać naturalny przebieg rozmowy i ograniczyć opóźnienia.
Poznaj naszą dokumentację wykrywania tur w ElevenAgents i skonfiguruj naturalne zarządzanie turami w zespole obsługi klienta albo zarejestruj się, aby zacząć.
FAQ

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.