Jak mierzyć Conversational AI: kluczowe wskaźniki sukcesu
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Narzędzia Conversational AI znacząco obniżają koszty całodobowej obsługi klienta. Nie wymagają nocnych zmian ani niosącego ryzyko dla prywatności danych zlecania pracy za granicę.
Oszczędności mają jednak znaczenie tylko wtedy, gdy agent AI potrafi rozwiązywać problemy klientów. Pomiar Conversational AI za pomocą właściwych kluczowych wskaźników efektywności pokaże ci, czy działa — szczególnie w firmach obsługujących duży wolumen zapytań.
Z tego artykułu dowiesz się, jak ocena przebiegu rozmów i trafności odpowiedzi chroni doświadczenie klienta oraz twoją markę. Wyjaśniamy, jak zespoły customer experience skutecznie prowadzą testy A/B powitań dzwoniących. Dowiesz się też, jak utrzymać niezawodną, wielojęzyczną platformę Conversational AI.
Podsumowanie
- Systematyczny pomiar Conversational AI w obszarze jakości, doświadczenia i działania operacyjnego dostarcza danych potrzebnych do ochrony doświadczenia klienta.
- Zautomatyzowane narzędzia oceny stale śledzą i poprawiają wskaźniki Conversational AI na dużą skalę, a pracownicy regularnie wykonują wyrywkowe kontrole.
- Izolowanie jednej zmiennej w testach A/B ułatwia dokładne ustalenie, co poszło nie tak, dzięki czemu możesz wdrożyć poprawki bezpośrednio rozwiązujące wykryte problemy.
- Ciągłe doskonalenie jest konieczne, ponieważ firmy AI często aktualizują modele bazowe, co sprawia, że wcześniej niezawodne chatboty zachowują się inaczej na produkcji.
Czym jest pomiar Conversational AI i dlaczego ma znaczenie
Pomiar Conversational AI to systematyczna ocena tego, jak dobrze testowani lub wdrożeni agenci AI obsługują prośby klientów i rozwiązują problemy. Celem jest ustalenie, jak skutecznie twoje zautomatyzowane systemy prowadzą wieloturowe rozmowy w rzeczywistych warunkach, według ustalonych przez ciebie standardów. Zwykle określają one, jak dobrze modele rozumieją intencje użytkownika, zachowują styl marki, udzielają trafnych odpowiedzi i skutecznie rozwiązują problem.
Ocena modeli może wydawać się dodatkową pracą przy systemie, który ma odciążyć twój zespół. Bez regularnej oceny trudno jednak wiedzieć, jak dobrze model działa w prawdziwych zastosowaniach. Innymi słowy: wiesz, że system AI obniża koszty obsługi klienta, ale czy możesz potwierdzić, że klienci są zadowoleni, a nie szukają innych rozwiązań?
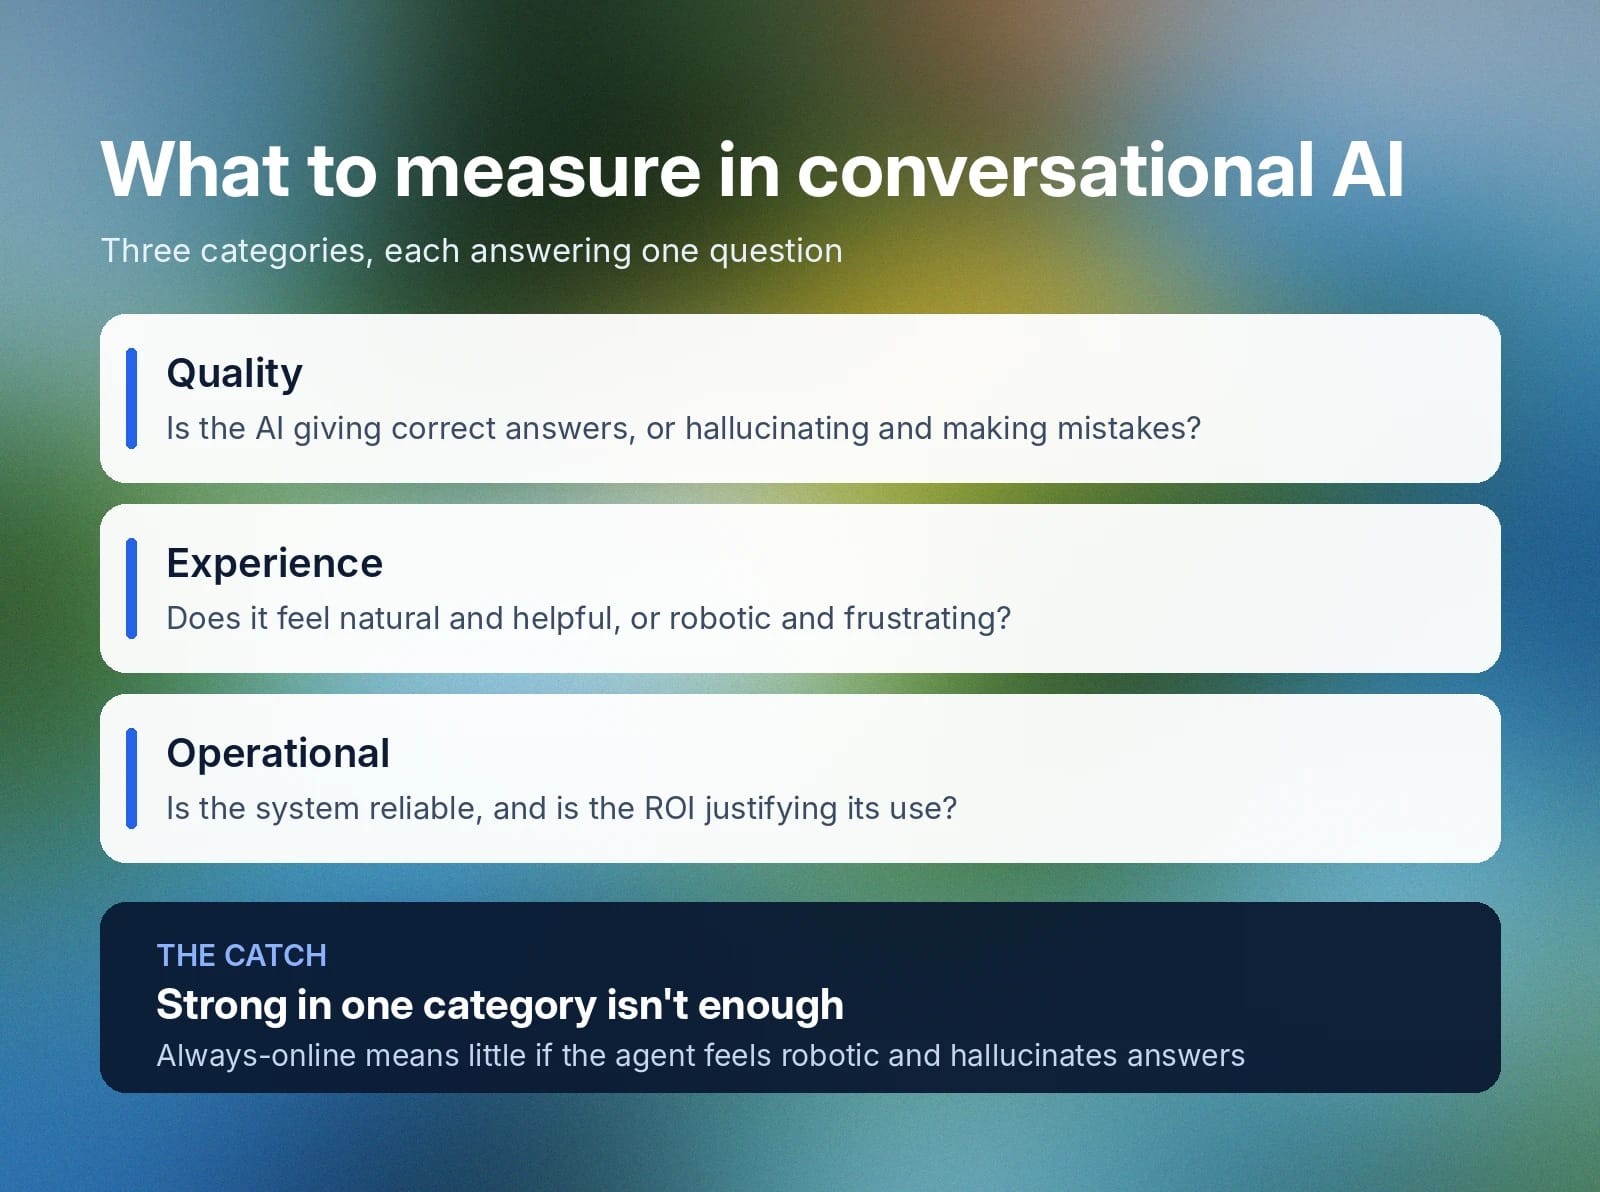
Pełny pomiar wymaga oceny modelu w trzech głównych kategoriach:
- Jakość: Oceń, czy odpowiedzi AI są trafne, spójne i adekwatne do początkowego pytania użytkownika. Kluczowe pytanie brzmi: czy AI podaje poprawne odpowiedzi, czy halucynuje i popełnia błędy?
- Doświadczenie: Oceń doświadczenie klienta — na przykład, czy AI odpowiedziało szybko i ilu tur potrzebowało, by udzielić satysfakcjonującej odpowiedzi. Kluczowe pytanie brzmi: czy użytkownik odbiera rozmowę jako naturalną i pomocną, czy jako robotyczną i frustrującą?
- Działanie operacyjne: Sprawdź, czy system działa niezawodnie i pozostaje opłacalnym rozwiązaniem dla obsługi klienta. Najczęstsze pytania to: czy system ma wysoką dostępność i zapewnia zwrot z inwestycji uzasadniający jego użycie?
Sukces dla każdego zespołu wygląda inaczej, a duże znaczenie mają początkowe problemy przed automatyzacją obsługi. Jeśli na przykład twój zespół miał trudności z utrzymaniem całodobowego wsparcia klienta, całodobowa dostępność agentów AI łatwo poprawi wyniki obsługi klienta. Każda z tych kategorii jest jednak ważna dla ogólnego sukcesu. System stale dostępny i rzadko ulegający awarii niewiele pomoże klientom, jeśli brzmi robotycznie i halucynuje odpowiedzi.
Kluczowe wskaźniki Conversational AI do śledzenia
Śledź jasne, praktyczne wskaźniki, aby oceniać pracę agentów z klientami i sprawdzać, czy obecne wdrożenie tworzy realną wartość biznesową. Ciągła ocena ułatwia też regularne ulepszenia. Gdy dokładnie określisz wąskie gardła w workflow lub obszary wymagające zmian, masz dane potrzebne do skutecznego usunięcia przyczyny problemu.
Przy ocenie rozmów głosowych i działania chatbotów potraktuj te wskaźniki Conversational AI jako punkt wyjścia:
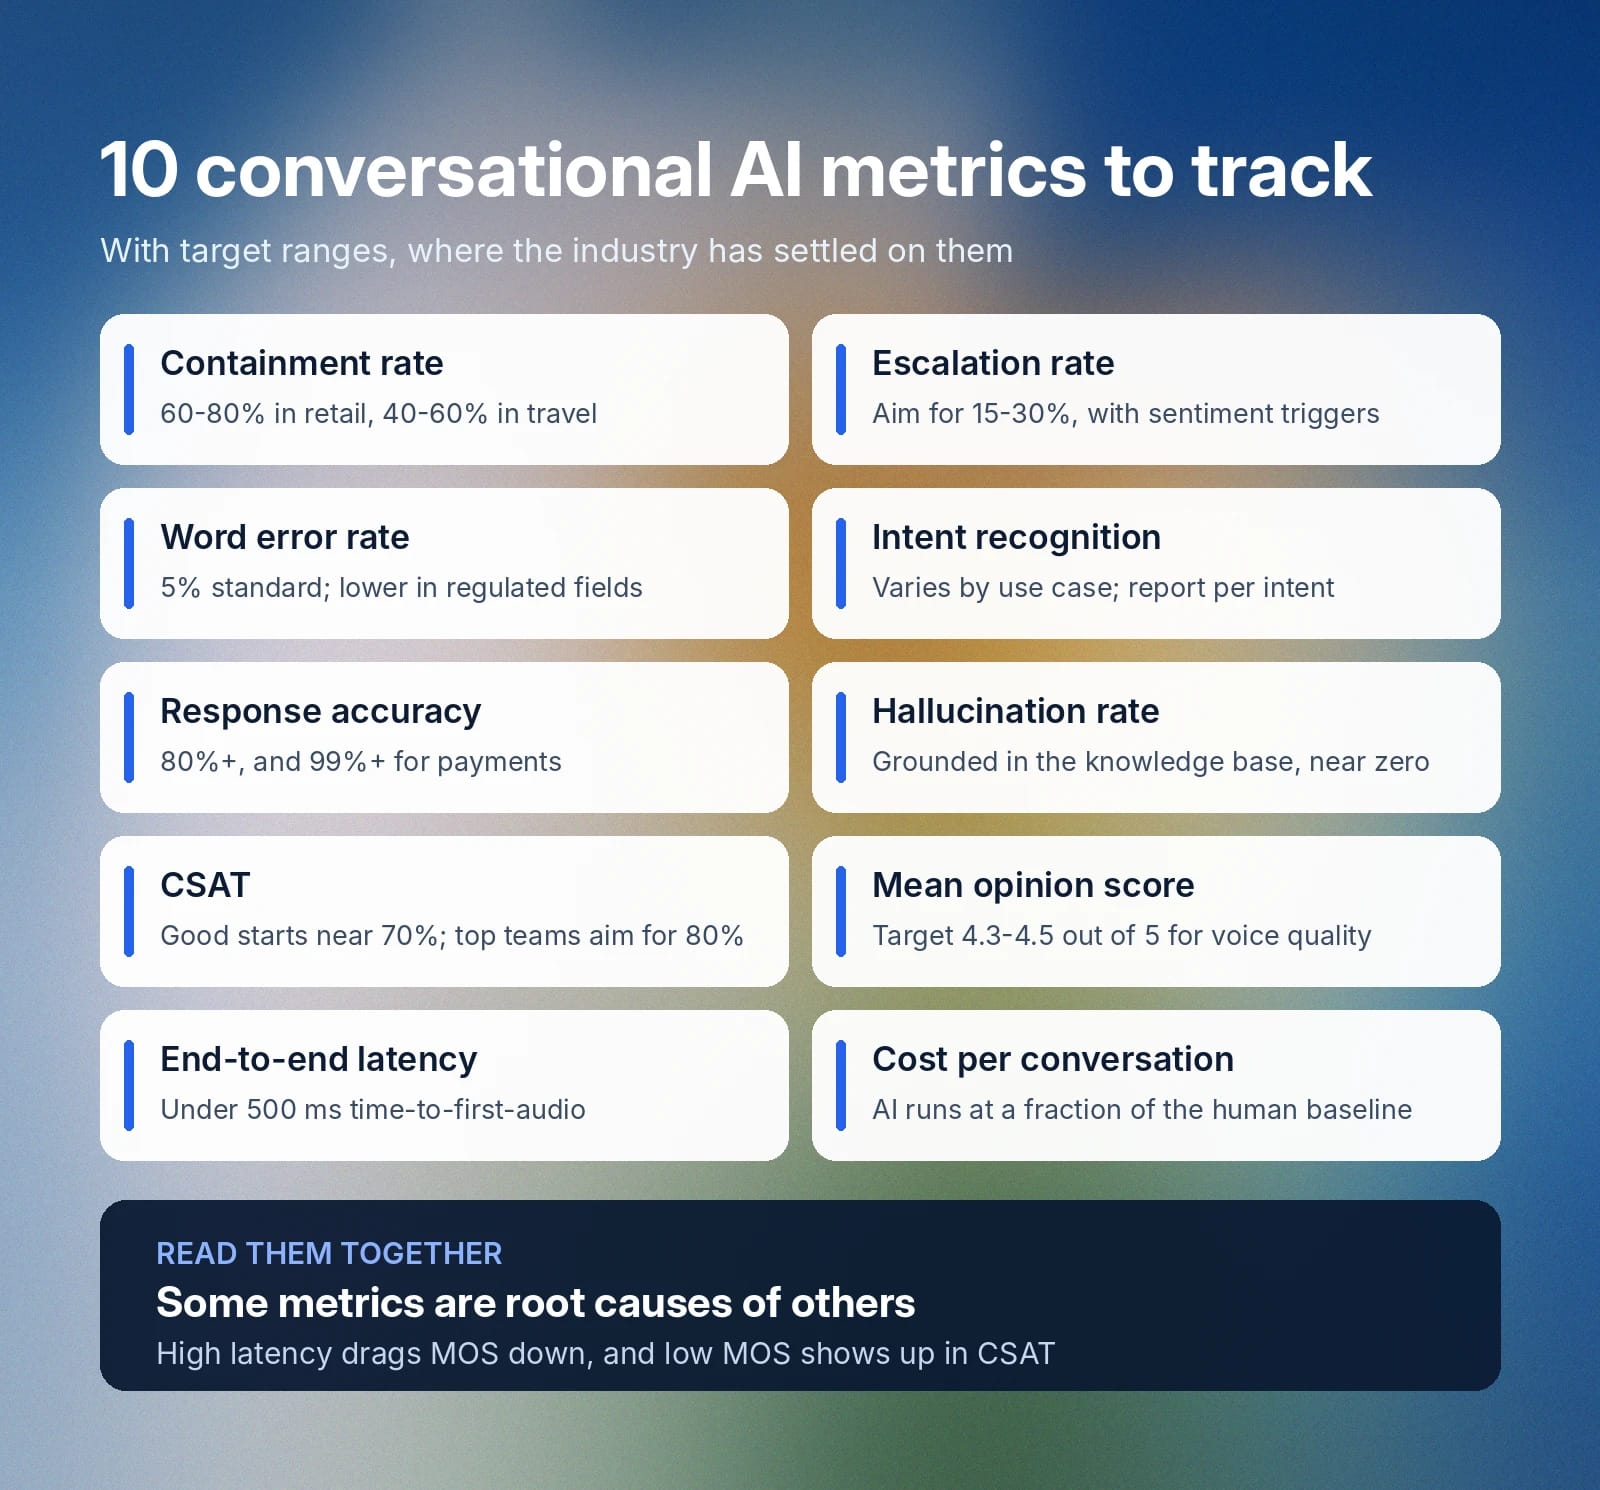
- Współczynnik obsługi w kanale: Śledź odsetek zapytań w pełni rozwiązanych w zautomatyzowanym kanale. Cele zależą od branży, kontekstu, zastosowania i typu bota. Na przykład 60–80% to dość standardowy wynik w handlu detalicznym, a dla serwisów turystycznych wynosi on 40–60%.
- Współczynnik eskalacji: Mierz, jak często agenci AI obsługują rozmowy bez przekazywania ich człowiekowi. Proaktywne firmy ustalają automatyczne progi przekazania rozmowy człowiekowi, gdy tylko nastroje stają się negatywne. Dobry współczynnik eskalacji zależy od branży i złożoności zadania, ale celuj w 15–30%.
- Współczynnik błędów słów (WER): Śledź, jak dobrze AI „słyszy” słowa podczas rozmowy lub transkrypcji. Dobry standard branżowy to 5%, ale potrzebujesz niższego WER w zastosowaniach podlegających regulacjom lub przetwarzających wrażliwe informacje, takich jak ochrona zdrowia, finanse i prawo.
- Trafność rozpoznawania intencji: Skuteczne działanie agenta AI wymaga nie tylko rozpoznawania słów, ale też dokładnego zrozumienia problemu i potrzeb użytkownika. Cele dotyczące trafności zależą od zastosowania i kategorii intencji.
- Trafność odpowiedzi: Określ, jak niezawodnie model udziela prawdziwych i sensownych odpowiedzi. To kluczowe, by klienci mogli rozwiązać swoje problemy. Ogólne zapytania do obsługi klienta wymagają wyniku co najmniej 80%, a wrażliwe zastosowania, takie jak płatności — 99% lub więcej.
- Współczynnik halucynacji: Choć jest ściśle powiązany z trafnością odpowiedzi, określa konkretnie ich zgodność z faktami na podstawie bazy wiedzy. Niski współczynnik halucynacji jest kluczowy dla użyteczności i zapobiega składaniu przez modele obietnic, których firma nie może spełnić.
- Satysfakcja klienta (CSAT): Zbieraj opinie klientów w ankietach po rozmowie, aby określić poziom satysfakcji. Firmy zbierają te dane na pięciostopniowej skali, ale często przedstawiają wyniki procentowo. Według SurveyMonkey dobre wyniki CSAT zwykle zaczynają się od około 70%, a niektóre firmy celują w 80% lub więcej.
- Średnia ocena opinii (MOS): Ten wskaźnik z perspektywy człowieka również używa pięciostopniowej skali, lecz mierzy naturalność odpowiedzi AI i klarowność syntetycznego głosu. Celuj w MOS na poziomie około 4,3–4,5.
- Opóźnienie głosowe end-to-end: Mierz całkowite opóźnienie od chwili, gdy użytkownik kończy prośbę, do momentu, gdy agent zaczyna odpowiadać. Agenci gotowi do pracy produkcyjnej dążą do czasu end-to-end do pierwszego audio (TTFA) poniżej 500 milisekund. Model ElevenLabs Flash v2.5 osiąga obecnie wewnętrzne opóźnienie inferencji na poziomie około 75 ms. Rzeczywiste opóźnienie end-to-end zależy od takich czynników jak twoja lokalizacja i użyty typ endpointu.
- Koszt rozmowy: Mierz całkowity koszt obsługi każdej zautomatyzowanej interakcji z klientem w porównaniu z rozmowami prowadzonymi przez ludzi. Rozmowy w ElevenLabs zaczynają się od 10 centów za minutę, podczas gdy średnie stawki godzinowe pracowników obsługi klienta wskazują, że rozmowy z człowiekiem kosztują około 32 centów za minutę. Daje to oszczędność rzędu 70%, choć ceny mogą się różnić zależnie od planu i wykorzystania. Sprawdź stronę z cennikiem ElevenLabs , aby poznać aktualne ceny.
Wybierając wskaźniki do pomiaru działania modelu, weź pod uwagę obszary najważniejsze dla twojej branży i modelu biznesowego. Na przykład trafność i zgodność z faktami są szczególnie istotne w bankowości i przy danych pacjentów, a opóźnienie, MOS i współczynniki eskalacji są najważniejsze dla firm stawiających na doświadczenie klienta.
Pamiętaj, że niektóre wskaźniki wyjaśniają przyczyny innych. Na przykład wysokie opóźnienie prawdopodobnie prowadzi do niskiego wyniku MOS, a w efekcie do niskiej satysfakcji klienta wyrażonej jako CSAT.
Jak mierzyć trafność Conversational AI
Mierz trafność modelu, tworząc referencyjny zestaw testowy z około 500–1000 prawdziwych rozmów historycznych. Rzeczywiste logi zawierają naturalne, nieuporządkowane sformułowania, których często brakuje w danych syntetycznych, takie jak literówki, slang i błędy użytkowników. Następnie oceń system na tych prawdziwych logach pod kątem rozpoznawania intencji, trafności odpowiedzi i współczynnika halucynacji.
Przeprowadzaj automatyczne oceny tych interakcji metodą punktacji LLM-as-a-judge. Zawsze weryfikuj jednak automatyczne wyniki względem systemów oznaczonych przez ludzi, aby upewnić się, że są zgodne. Następnie recenzenci wykonują co tydzień wyrywkowe kontrole działania chatbotów według prostej, trzypunktowej skali:
- Poprawna: Odpowiedź jest zgodna z faktami, trafna w kontekście i bezpośrednio realizuje główną intencję użytkownika.
- Akceptowalna: Odpowiedź jest poprawna technicznie i pomocna, ale ma drobne problemy stylistyczne, niezręczne sformułowania lub formatowanie niezgodne ze stylem marki.
- Błędna: Odpowiedź wymaga natychmiastowej korekty, ponieważ zawiera błędy rzeczowe, poważne halucynacje lub całkowicie błędnie rozumie intencję użytkownika.
Najlepiej oceniać model osobno dla każdej intencji, ponieważ agenci AI dobrze działają w jednych kontekstach, a całkowicie zawodzą w innych. Liczby zbiorcze sprawiają, że obszary o wysokiej skuteczności ukrywają krytyczne słabości.
Uprościliśmy ten workflow, wbudowując testowanie Next Reply (Scenario) bezpośrednio w testy ElevenAgents. Funkcja Next Reply ocenia kolejną wiadomość wysyłaną przez agenta zamiast całej wieloturowej rozmowy. Podajesz jednak historię czatu poprzedzającą punkt oceny i oceniasz odpowiedź pod kątem zasad, tonu i standardów jakości.
Jak testować odpowiedzi Conversational AI metodą A/B
Testy A/B zbierają opinie z rzeczywistego świata, więc nie musisz zgadywać, co preferują klienci. Następnie wykorzystujesz te dane empiryczne do dopracowania działania modelu AI. Po prześledzeniu wskaźników twój zespół prawdopodobnie ma listę zmian i eksperymentów do przeprowadzenia. Zmiana wielu rzeczy naraz utrudnia jednak ustalenie, co zadziałało, a co nie.
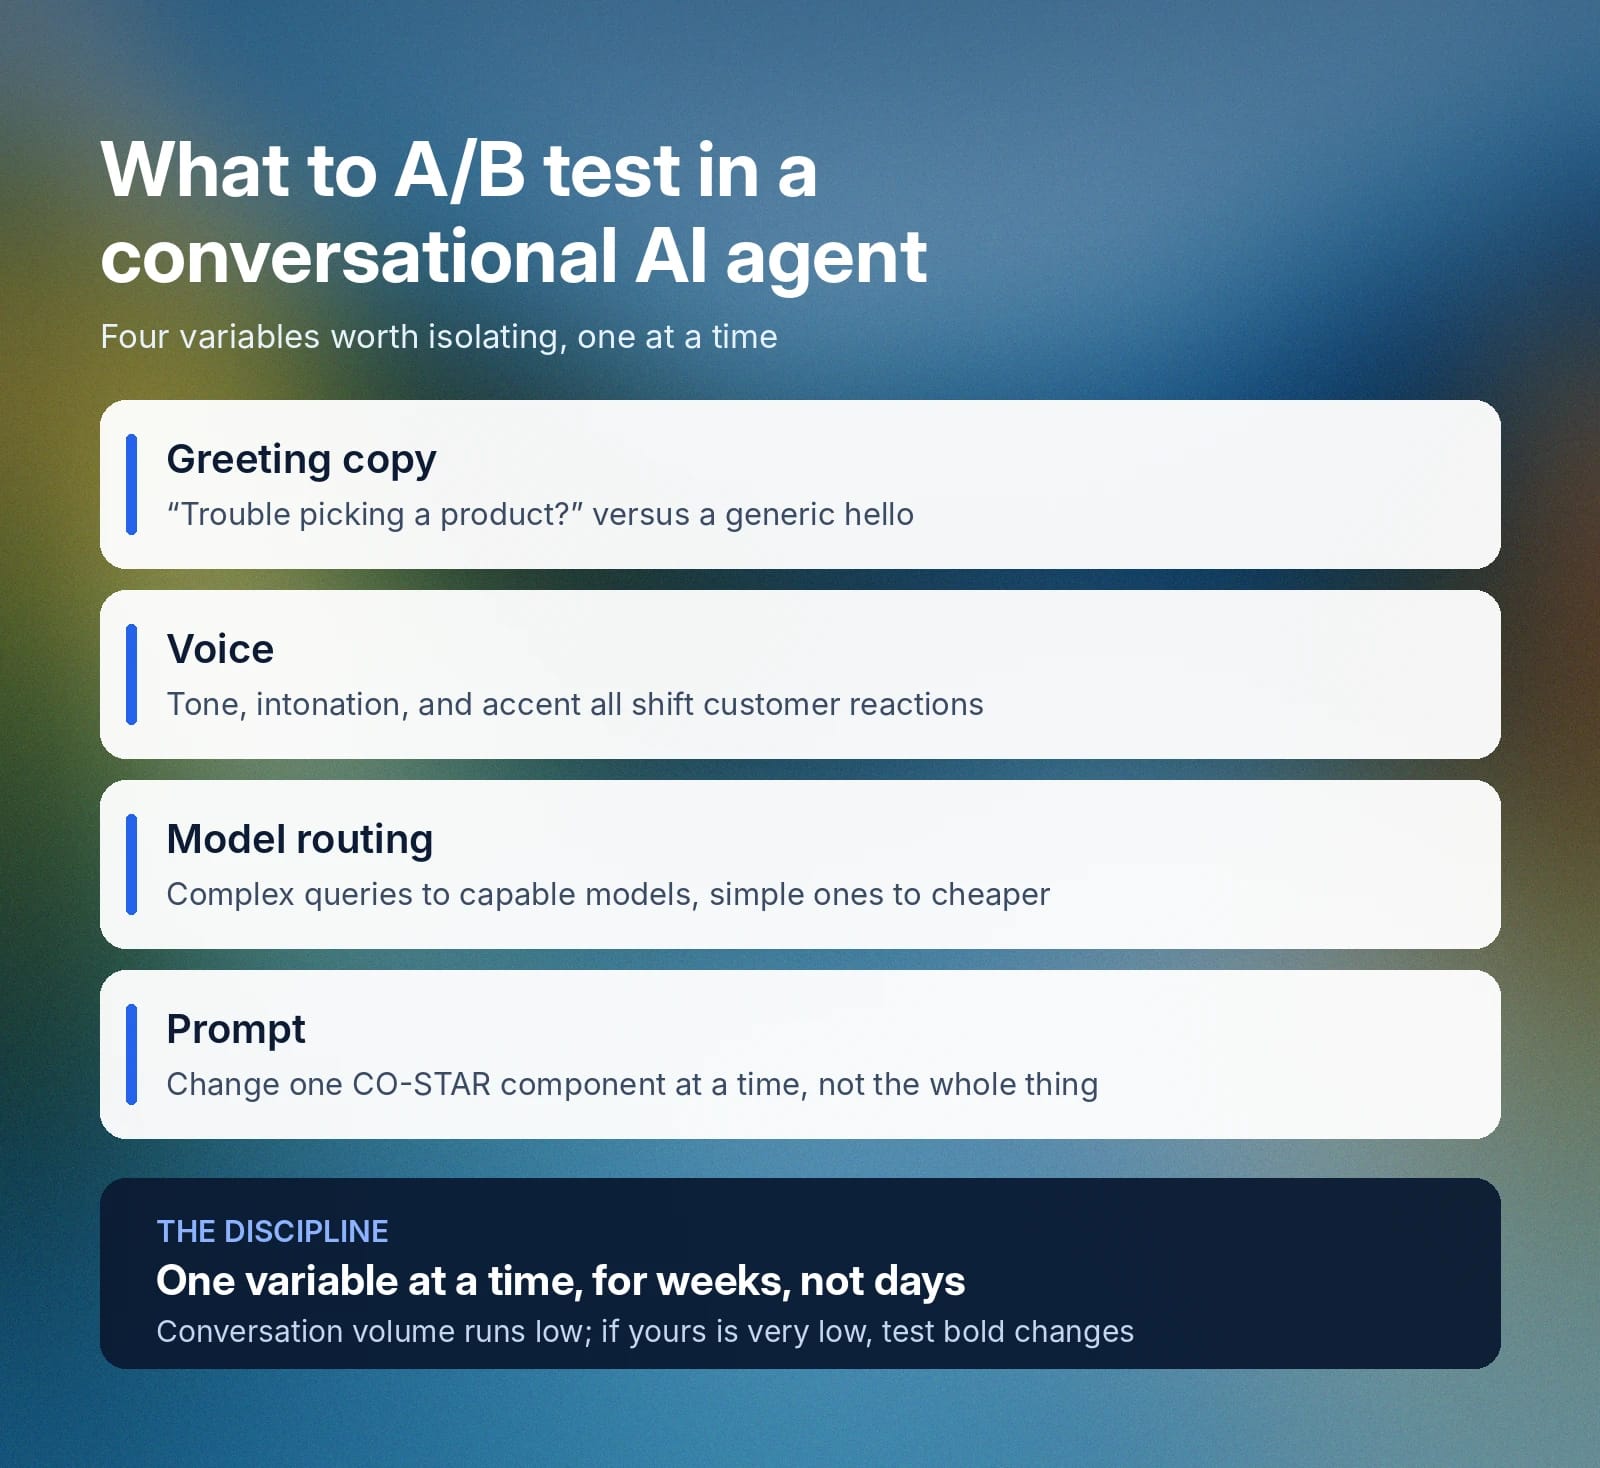
Wiarygodny test wymaga więc izolowania jednej konkretnej zmiennej naraz, przy zachowaniu reszty bazowej wiedzy bez zmian. Możesz zmieniać między innymi:
- Treść powitania: Zmień pierwszą wiadomość powitalną na bardziej konkretną, np. „Cześć. Trudno wybrać produkt?”, zamiast tylko „Dzień dobry, jak mogę pomóc?”.
- Głos: W określonych sytuacjach klienci mogą lepiej reagować na jedne głosy niż na inne, zależnie od tego, czy głos jest męski czy żeński, a także od tonu, intonacji, a nawet akcentu.
- Kierowanie do modelu: Bardzo zaawansowane modele zwykle kosztują więcej, dlatego wydajnym i opłacalnym rozwiązaniem jest odpowiednie kierowanie złożonych i prostych zapytań.
- Prompt: Prompty mają kilka elementów, więc zmieniaj tylko jeden naraz, np. kontekst, cel, styl, ton, odbiorców lub szablon odpowiedzi (CO-STAR).
Zespoły powinny też dostosować harmonogram testów. Ruch konwersacyjny jest zwykle znacznie mniejszy niż liczba wyświetleń stron, więc aby uzyskać istotność statystyczną, test trzeba prowadzić tygodniami, a nie dniami. Przy bardzo niskim wolumenie testuj duże, wyraźne zmiany zamiast drobnych poprawek.
Praktyczny workflow wymaga też narzędzi do wersjonowania agentów, porównywania i wycofywania zmian. Wbudowaliśmy je bezpośrednio w ElevenAgents.
Jak testować agenta Conversational AI przed wdrożeniem
Obsługa klienta to bezpośredni kontakt z osobami wpływającymi na twoje wyniki finansowe, a AI czasem nieprzewidywalnie reaguje na drobne zmiany. Dlatego zawsze testuj nowego lub zmienionego agenta Conversational AI przed uruchomieniem go na produkcji. Samo „testowanie na wyczucie” nie wystarczy.
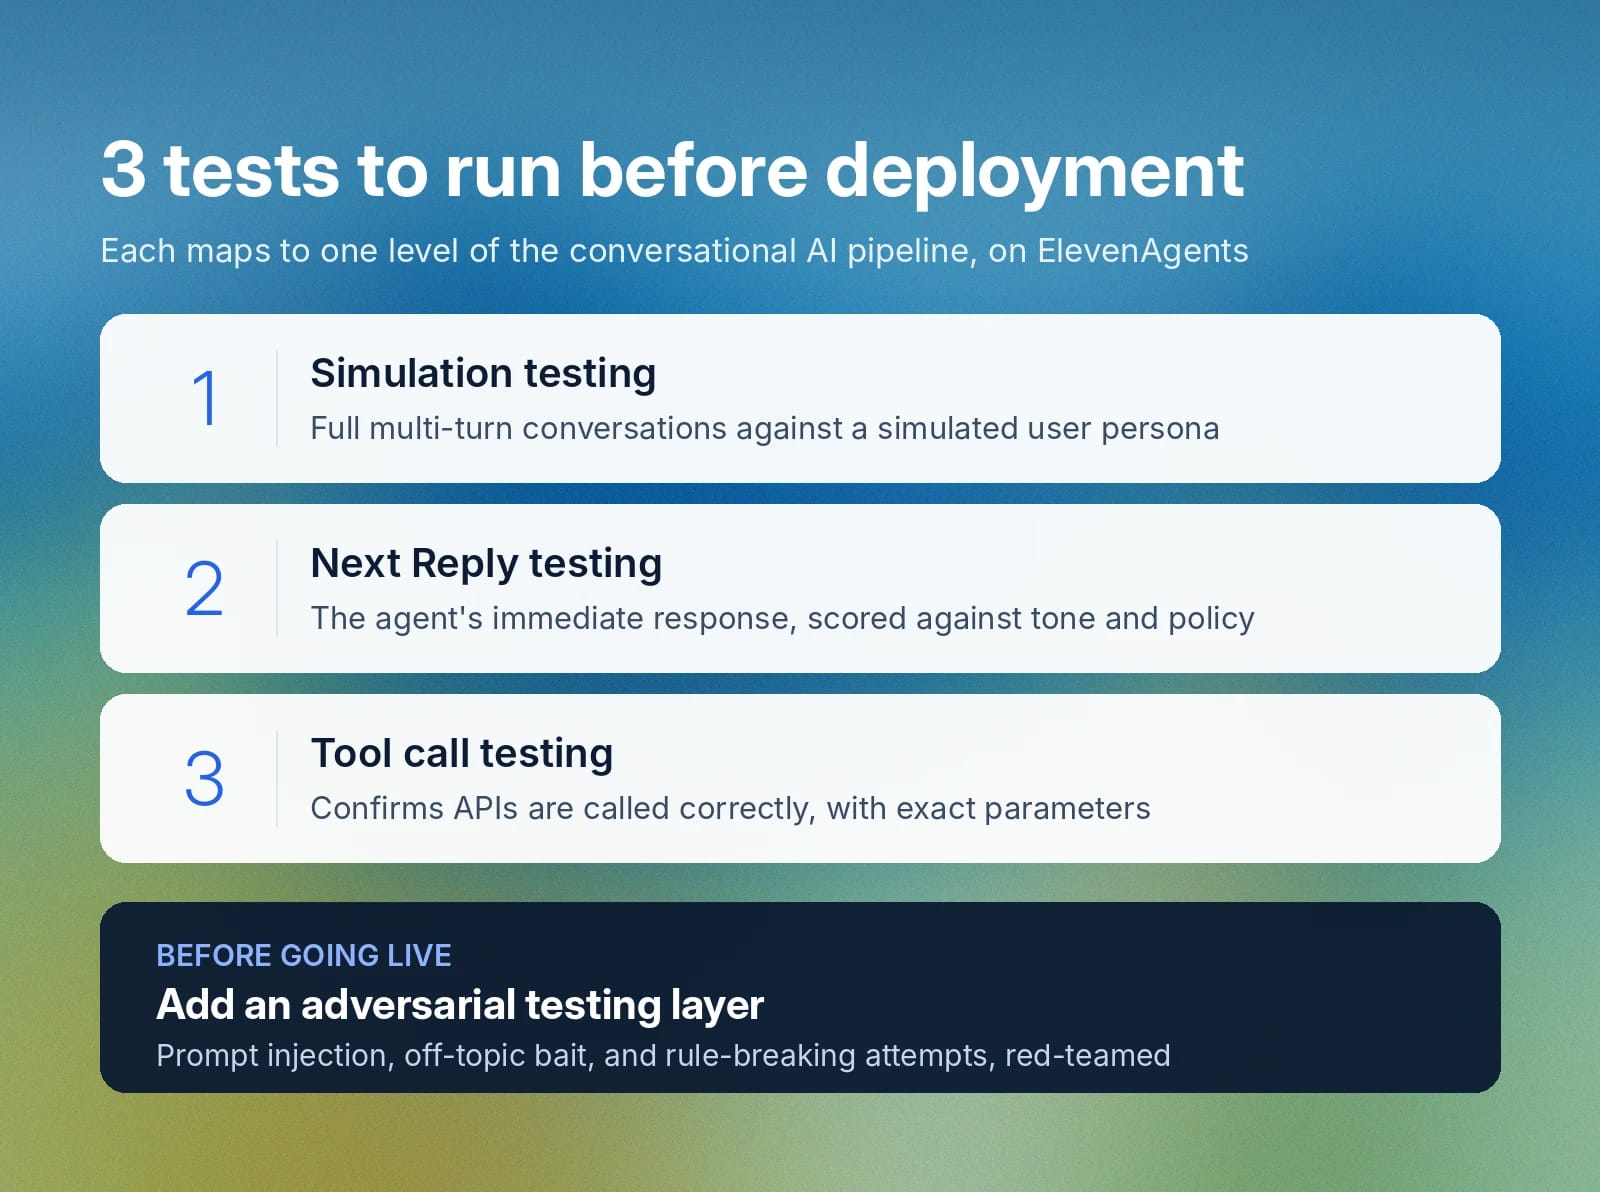
Nasz framework testowy ElevenAgents opiera się na trzech głównych typach testów, obejmujących konkretne poziomy pipeline’u Conversational AI:
- Testowanie symulacji: Prowadzi pełną wieloturową rozmowę z symulowanym użytkownikiem o określonej personie, aby potwierdzić, że dialog osiąga pożądany poziom działania.
- Testowanie Next Reply: Testuje tylko bezpośrednie odpowiedzi agenta względem określonego tonu, zasad lub innych ograniczeń, aby potwierdzić ich stosowność i trafność.
- Testowanie wywołań narzędzi: Zapewnia, że agenci poprawnie wywołują połączone API i przekazują dokładne parametry potrzebne przy kluczowych wyszukiwaniach w bazie danych lub transferach.
Ponieważ wielu atakujących próbuje jailbreakować modele w złych celach, przed uruchomieniem potrzebujesz także warstwy testów adversarialnych. Współpracuj z zespołami QA, inżynierami promptów i specjalistami ds. cyberbezpieczeństwa red team, aby testować prompt injection, przynęty niezwiązane z tematem oraz próby łamania zasad.
Na koniec, wdrażaj rozwiązanie etapami: uruchom wersje pilotażowe dla małej grupy użytkowników i monitoruj ich zachowanie w rzeczywistych warunkach. Ustal rygorystyczne kryteria, które model musi spełnić przed udostępnieniem go większej grupie lub całej bazie klientów. Wyznacz też jedną osobę odpowiedzialną za nadzór nad wdrożeniem i przygotuj ścieżkę wycofania zmian, jeśli korekta obniży wskaźniki działania.
Ocena działania chatbota na produkcji
Przed uruchomieniem modelu Conversational AI określ, jak wygląda sukces w każdym zastosowaniu. Jest to szczególnie ważne w aplikacjach z silnie regulowanych branż, gdzie trafność i prywatność danych podlegają wyższym standardom i surowszym wymaganiom.
Zautomatyzowane odpowiedzi ułatwiają testowanie modeli A/B na dużą skalę, ale obiektywne testy wymagają połączenia ich z doraźnym czytaniem transkrypcji i opiniami ludzkich testerów. Ludzie w procesie wychwytują niuanse rozmów pomijane przez modele AI oraz nietypowe dane, które inaczej znikają w liczbach zbiorczych. Pełna strategia oceny obejmuje też analizę sentymentu i bezpośrednie opinie użytkowników.
Ciągłe doskonalenie dodatkowo wyróżnia dojrzałe systemy zapewniające wysoki zwrot z inwestycji. Konkurenci traktują testowanie i monitorowanie jako osobne zadania, podczas gdy dojrzały pipeline łączy je w jedno. W takim przypadku błędy produkcyjne bezpośrednio zasilają zestaw testowy służący do trenowania kolejnego zoptymalizowanego agenta.
Regularne korekty są też konieczne, gdy firmy AI aktualizują modele bazowe, na których działa twój agent. Taka zmiana często sprawia, że wcześniej skuteczny prompt nagle zaczyna prowadzić do nierzetelnych lub nawet nieodpowiednich odpowiedzi.
Wbudowaliśmy tę pętlę informacji zwrotnej bezpośrednio w naszą platformę. Skorzystaj z naszych narzędzi do analizy rozmów , aby automatycznie zbierać uporządkowane dane i łatwo oceniać sentyment. Duże organizacje korzystają też z naszej infrastruktury Conversational AI dla przedsiębiorstw , by z pewnością monitorować i skalować swoich agentów na całym świecie.
Zacznij korzystać z ElevenAgents do pomiaru obsługi klienta
Skuteczne wdrożenie Conversational AI na dużą skalę wymaga czegoś więcej niż wysokiej jakości głosów i modeli o niskim opóźnieniu. Potrzebujesz spójnego ekosystemu do projektowania, tworzenia, testowania, wdrażania i dostosowywania workflow z wieloma agentami.
ElevenAgents zapewnia skalowalną infrastrukturę, której potrzebujesz. Twój zespół zyskuje dostęp do narzędzi takich jak weryfikacja Next Reply, śledzenie sentymentu i automatyczne zbieranie danych, aby stale monitorować i optymalizować modele dla najlepszych wyników. Co więcej, wykrywasz regresje, zanim dotrą do klientów.
Chcesz uprościć pomiar Conversational AI? Poznaj nasze funkcje testowania agentów i zobacz, jak nasze zespoły enterprise wdrażają niezawodnych agentów, którzy poprawiają wskaźniki obsługi klienta.
Dowiedz się więcej o ElevenAgents lub zarejestruj się i zacznij już dziś.
Najczęstsze pytania o pomiar Conversational AI

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.