
Ramy oceny agentów głosowych: 6 filarów wyjaśnionych
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Agenci głosowi muszą koordynować symfonię niemal równoczesnych narzędzi. To precyzyjny taniec: rejestrowanie wypowiedzi klienta za pomocą działającego w czasie rzeczywistym zamiany mowy na tekst (STT), przetwarzanie kontekstu i tworzenie odpowiedzi przez duży model językowy (LLM), a następnie generowanie pliku audio przez oprogramowanie zamiany tekstu na mowę (TTS).
Jak dokładnie ocenić działanie agenta głosowego przy tak wielu elementach?
W tym artykule przedstawimy sześciopunktowy framework oceny agentów głosowych, który wskazuje dokładnie, co mierzyć przy ocenie ich skuteczności. Omówimy też, dlaczego branże różnie ważą te filary i jakich częstych błędów unikać podczas oceny.
Podsumowanie
- Sześć głównych filarów oceny agentów głosowych to jakość głosu TTS, jakość rozmowy, użycie narzędzi i realizacja zadań, inteligencja, zgodność i zabezpieczenia oraz niezawodność.
- Najważniejsze cele produkcyjne to MOS na poziomie 4,3, TSR powyżej 85% i czas do pierwszego audio poniżej 500 ms.
- Różne branże inaczej ważą każdy z filarów, a w niektórych wdrożeniach jeden z nich będzie ważniejszy od pozostałych.
- Częste błędy testowe to ocenianie tylko czystego audio i ignorowanie skoków opóźnienia P99.
- ElevenLabs przoduje w najważniejszych metrykach: Scribe v2 osiąga najniższy w branży WER — 2,2% (Artificial Analysis, czerwiec 2026), Flash v2.5 i Turbo v2.5 należą do najszybszych modeli (Artificial Analysis, czerwiec 2026), a ElevenAgents zapewnia opóźnienie inferencji modelu na poziomie ~75 ms.
Czym jest framework oceny agentów głosowych?
Framework oceny agentów głosowych AI to uporządkowany system, który pozwala testować działanie w wielu wymiarach. Kompleksowy framework obejmuje metryki oceniające wszystko — od wierności audio po przebieg rozmowy i zgodność z przepisami.
W przeciwieństwie do chatbota tekstowego agent głosowy kieruje każdą interakcję przez co najmniej trzy połączone technologie: automatyczne rozpoznawanie mowy (ASR), które zamienia słowa użytkownika na tekst; LLM, który tworzy odpowiedź; oraz system TTS, który zamienia ją z powrotem na audio. Awaria któregokolwiek z tych systemów pogarsza całe doświadczenie.
Właśnie ta złożoność sprawia, że firmy muszą oceniać agentów głosowych przed wyborem dostawcy i wdrożeniem. Dodatkowe opóźnienie lub nieprecyzyjne odpowiedzi mogą mieć realne skutki, takie jak utrata klientów, a w najgorszym razie kary regulacyjne i szkody wizerunkowe.
Framework oceny agentów głosowych wykorzystuje benchmarki i mierzalne dane, by określić, czy agent nadaje się do konkretnych zastosowań. Z perspektywy firmy możliwość oceny różnych modeli głosowych pozwala wybrać najlepszy dla twoich klientów.
Sześć filarów oceny agentów głosowych
Choć tworzenie i wdrażanie agenta AI nigdy nie było prostsze, procesy działające w tle są dość złożone. Kilka komponentów jednocześnie słucha użytkownika, rozumie jego potrzeby, przekazuje informacje do LLM, a następnie tworzy odpowiedź audio.
Firmy, które chcą współpracować z najlepszym możliwym agentem głosowym, potrzebują rygorystycznego frameworku do benchmarkingu.
Jeśli bardziej interesują cię wyniki testów, Artificial Analysis oferuje kilka porównań agentów opartych na różnych komponentach. Poniżej zobaczysz wyniki bezpośredniego porównania szybkości modeli, w którym ElevenLabs Turbo v2.5 i Flash v2.5 wyraźnie prowadzą pod względem liczby przetwarzanych znaków na sekundę.
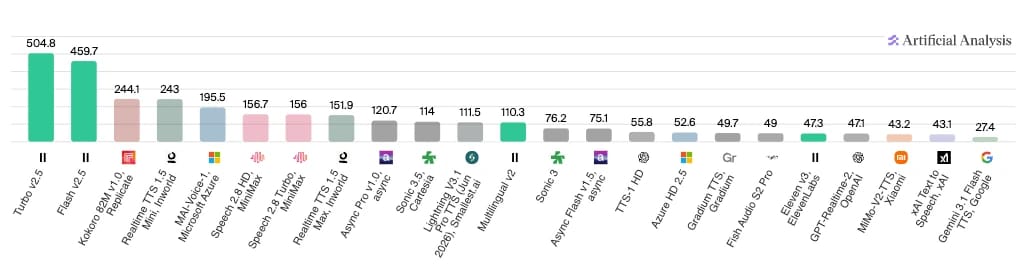
Dla deweloperów i firm, które chcą przeprowadzić własne eksperymenty, oto sześć filarów frameworku oceny agenta AI:
- Jakość głosu TTS: Jak naturalnie, wyraźnie i ekspresyjnie brzmi syntezowana mowa dla użytkowników końcowych. Czołowe modele, takie jak Eleven v4, oferują ludzką, emocjonalną ekspresję w ponad 70 językach.
- Jakość rozmowy: Czy model rozumie ludzką mowę, przetwarza znaczenie i szybko odpowiada w kontekście w rozmowie wieloturowej?
- Użycie narzędzi: Zakres, w jakim agent AI realizuje zadania przy użyciu dostępnych zasobów bez interwencji człowieka.
- Inteligencja: Jak dobrze model rozumuje, radzi sobie z nowymi danymi wejściowymi i unika niedokładnych lub zmyślonych odpowiedzi.
- Zgodność i zabezpieczenia: Oprócz wszystkich możliwości agenci głosowi AI muszą spełniać wszystkie wymogi regulacyjne i dotyczące zgodności, w tym aktywne mechanizmy ochronne.
- Niezawodność: Elementy takie jak całkowita dostępność i stabilne działanie pod obciążeniem, które pozwalają określić, czy agent Conversational AI może skalować się wraz z popytem.
Choć każdy z tych filarów jest niezależny, łączą się one, tworząc wysokiej jakości doświadczenie użytkownika. Na przykład model może poprawić jakość głosu, ale przy wysokim opóźnieniu klient nadal będzie niezręcznie czekać na wypowiedź modelu.
Przyjrzyjmy się bliżej każdemu z tych filarów oceny głosu AI.
Jakość głosu TTS
Zaczynamy od jakości głosu, bo to prawdopodobnie pierwsza rzecz, którą człowiek zauważy podczas interakcji z konwersacyjnym agentem AI. Jeśli brzmi robotycznie lub nienaturalnie, subiektywne doświadczenie będzie znacznie gorsze.
Jedną z pierwotnych metryk oceny, zdefiniowaną przez Międzynarodowy Związek Telekomunikacyjny (ITU-T), jest Mean Opinion Score (MOS). MOS działa w skali 1–5, gdzie 1 oznacza wynik nieużyteczny, a 5 — doskonały. To subiektywny pomiar oparty na ludzkich słuchaczach, od których zbiera się opinię po rozmowie.
Wynik poniżej MOS 3,5 jest dość słaby, zwłaszcza według współczesnych standardów, i prawdopodobnie wpłynie na zadowolenie klientów.
Choć MOS jest metryką skupioną na odbiorze przez człowieka, wpływa na niego kilka wymogów technicznych:
- Stabilność wysokości głosu i jitter: Wysokość głosu i jitter to dwa elementy językowe, które ludzie naturalnie wychwytują podczas słuchania. „Wysokość głosu” oznacza zmienną intonację w trakcie mówienia, np. gdy naturalnie podnosisz głos, zadając pytanie. Jitter występuje, gdy model głosowy różnie interpretuje wysokość głosu i nie potrafi utrzymać spójnej prozodii w całym zdaniu. Branżowy punkt odniesienia dla jittera wynosi 30 ms.
- Ekspresja emocjonalna: Nawet wyraźny i precyzyjny głos brzmi źle, jeśli ton nie odpowiada zamierzonemu emocjonalnemu wydźwiękowi zdania. Bez trafnych wskazówek tonalnych słuchacze będą gorzej odbierać konwersacyjnych agentów AI i niżej ich oceniać. ElevenAgents oferuje ekspresję niemal jak u człowieka, aby każda odpowiedź miała jasny wydźwięk emocjonalny.
- Szum tła: Szum tła w agentach głosowych ma dwa odrębne wymiary, które warto ocenić. Po stronie wyjściowej do odpowiedzi subtelnie dodaje się dźwięki otoczenia, by agenci brzmieli naturalniej. Po stronie wejściowej filtrowanie szumu tła w warstwie STT jest opcjonalnym ustawieniem poprawiającym dokładność. Podczas oceny agenta przetestuj oba: sprawdź, czy dźwięki otoczenia brzmią naturalnie, i oceń dokładność STT z filtrem szumu włączonym i wyłączonym.
Przy obliczaniu MOS warto dążyć do wyniku 4,3–4,5, co oznacza wysokie oceny we wszystkich tych kategoriach percepcji. Do przewidywania MOS na dużą skalę bez paneli ludzkich możesz użyć narzędzi takich jak UTMOS i NISQA.
Jakość rozmowy
Jakość rozmowy to złożony filar między jakością głosu a realizacją zadań. Mierzy, jak skutecznie agent głosowy rozumie potrzeby użytkownika, przerywa mu w odpowiednim kontekście i prowadzi rozmowę wieloturową do zakończenia.
Główną metryką jest tu dokładność klasyfikacji intencji. Zwykle wynosi ona od 85% do 92%, a najlepsi osiągają ponad 96%. Choć 85% może wydawać się wysokim wynikiem, nadal oznacza, że 15% całego ruchu przychodzącego jest błędnie sklasyfikowane i kierowane do niewłaściwych zasobów.
Elementy techniczne wpływające na wysoką dokładność klasyfikacji intencji to:
- Naprzemienność wypowiedzi: Określa, jak dobrze agent głosowy zarządza naturalnym przebiegiem rozmowy. Ocenia, czy wie, kiedy słuchać, odpowiadać lub czekać na więcej informacji. Obejmuje też obsługę przerwań, gdy model anuluje tworzoną odpowiedź i generuje nową na podstawie nowego sygnału wejściowego. ElevenLabs używa websocketu wielokontekstowego do płynnej obsługi takich przerwań.
- Opóźnienie: Opóźnienie opisuje opóźnienie end-to-end między zakończeniem wypowiedzi użytkownika a rozpoczęciem odpowiedzi audio przez agenta. Agenci głosowi gotowi do produkcji powinni osiągać czas do pierwszego audio poniżej 500 ms, a poniżej 300 ms to wynik jeszcze lepszy. Modele ElevenLabs Flash oferują wiodący w branży czas inferencji modelu ~75 ms, co daje ci przewagę w tej kategorii.
- Wskaźnik fallbacków: Wskaźnik fallbacków pokazuje, jak często agent AI nie rozumie użytkownika i prosi o wyjaśnienie lub powtórzenie. W dużej mierze wynika z dokładności STT: jeśli warstwa rozpoznawania mowy źle usłyszy lub błędnie zinterpretuje wypowiedź klienta, LLM otrzymuje zniekształcone dane wejściowe. To proste wyliczenie według wzoru: Wskaźnik fallbacków (%) = (Liczba fallbacków / Łączna liczba interakcji) * 100.
ElevenLabs Scribe V2 ma najniższy WER — 2,2% — w ocenie modeli zamiany mowy na tekst Artificial Analysis
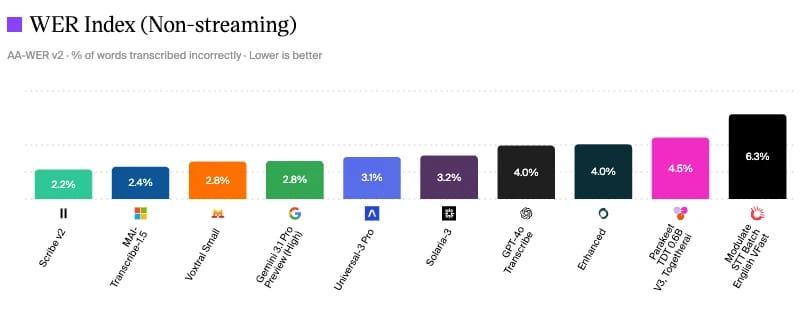
Ocena modeli zamiany mowy na tekst Artificial Analysis
Jednym ze sposobów oceny jakości rozmowy jest analiza branżowych standardów benchmarkowych dla różnych komponentów. Jak widać, Scribe v2 od ElevenLabs ma najniższy Word Error Rate — 2,2% według danych z czerwca 2026 roku, co oznacza mniej błędnie usłyszanych słów, mniej fallbacków i dokładniejszą klasyfikację intencji.
Firmy mogą zauważyć, że jakość rozmowy zależy też od workflow, w którym działa agent głosowy. Na przykład w obsłudze klienta liczy się również jakość przekazania sprawy do eskalacji lub rozwiązywania pytań FAQ.
Użycie narzędzi i realizacja zadań
Jakość mierzy to, jak rozmowa była odbierana, a realizacja zadań — czy doprowadziła do sukcesu. Firmy powinny uważnie przyjrzeć się tej części frameworku oceny agentów głosowych, ponieważ bezpośrednio wiąże się z wynikami biznesowymi.
Jedną z miar użycia narzędzi jest dokładność wypełniania pól, która określa, jak dobrze agenci AI realizują rutynowe zadania, np. uzupełnianie formularza danymi klienta. Wysoka dokładność pokazuje, że agent płynnie przechodzi od rozmowy do działania bez utraty informacji.
Task Success Rate (TSR) to procentowa miara zadań end-to-end pomyślnie zrealizowanych przez agenta. Realizacja zależy tu zarówno od zrozumienia prośby, jak i użycia właściwych połączonych narzędzi (API, baz danych, Retrieval-Augmented Generation (RAG), a także wewnętrznych baz wiedzy).
Wzór na TSR:
TSR = (Zadania w pełni zrealizowane / Łączna liczba podjętych zadań) x 100
Agenci głosowi gotowi do produkcji powinni osiągać TSR powyżej 85%, a także monitorować dokładność i niezawodność wywołań narzędzi. Aby uniknąć spadku TSR, przeprowadzaj testy regresji po każdej zmianie promptu lub podłączonego modelu. Nawet niewielkie odchylenie może mieć istotne skutki dla TSR.
Inteligencja
Inteligencja obejmuje zdolność rozumowania i bardziej zaawansowane możliwości agenta głosowego. To właśnie ten filar wyraźnie odróżnia głosowy IVR (Interactive Voice Response) od głosowego agenta AI.
Kluczowe wymiary oceny to:
- Ryzyko halucynacji: Halucynacje, czyli generowanie przez agenta informacji nieprawdziwych lub niezgodnych z dokumentami firmy, są szczególnie szkodliwe w głosowym AI, ponieważ mogą być przekazywane pewnym tonem. Najnowsze badania wskazują , że częste halucynacje znacząco obniżają zadowolenie klientów z agentów głosowych.
- Obsługa pytań poza zakresem: Inteligentne agenty rozumieją, kiedy pytanie wykracza poza ich domenę kontekstową, i potrafią odpowiednio zareagować. Zamiast wymyślać odpowiedź, odmawiają lub kierują rozmowę z powrotem na obszar objęty kontekstem.
- Utrzymywanie kontekstu: Czy agent potrafi śledzić encje i wcześniejsze zobowiązania w kilku turach rozmowy? Bez tej zdolności klienci mogą być zmuszeni powtarzać informacje lub otrzymywać sprzeczne odpowiedzi.
- Rozumowanie i logika wieloetapowa: Czy agent poprawnie obsługuje logikę warunkową albo łączy wnioski w wielu turach? Zwłaszcza w bardziej technicznych zastosowaniach, takich jak usługi finansowe, zdolność rozumowania w zdefiniowanym kontekście jest kluczowa.
Dla tych wymiarów i komponentów istnieje kilka benchmarków zewnętrznych. Na przykład Holistic Evaluation of Language Models (HELM) ze Stanfordu ocenia działanie LLM w różnych kategoriach. W przypadku halucynacji TruthfulQA oferuje solidną analizę częstotliwości pojawiania się fałszywych odpowiedzi.
Jedną z zalet ElevenAgents jest to, że w przeciwieństwie do niektórych platform głosowych, które ograniczają cię do jednego modelu bazowego, możesz całkowicie wymienić warstwę LLM. W praktyce oznacza to, że możesz podłączyć model, który najlepiej wypada w benchmarkach rozumowania dla twojego zastosowania.
Zgodność i zabezpieczenia
Firmy muszą wdrażać aktywne mechanizmy ochronne, aby zapobiegać szkodliwym odpowiedziom lub takim, które naruszają zasady. W przeciwieństwie do instrukcji w promptach systemowych, które można obejść lub nadpisać, niezależne kontrole mechanizmów ochronnych działają jako osobna warstwa poza samym modelem. Ocieniają odpowiedzi, zanim dotrą do użytkownika, i zatrzymują rozmowę, jeśli schodzi ona na niebezpieczny obszar.
Audytowalność to powiązany wymóg: agenci produkcyjni muszą prowadzić szczegółowe logi decyzji i odpowiedzi w formacie umożliwiającym późniejszą analizę. Zwłaszcza w silnie regulowanych branżach wykazanie zgodności po fakcie jest równie ważne jak jej zapewnienie od początku.
Dokładne przepisy, które musi spełniać twoja firma, zależą od branży. Najczęściej stosowane frameworki to:
- HIPAA: Dla chronionych danych zdrowotnych w kontekście opieki zdrowotnej w USA.
- PCI-DSS: Dla każdego agenta przetwarzającego dane kart płatniczych.
- GDPR: Obowiązki w zakresie prywatności danych w UE oraz dla firm obsługujących klientów z UE.
Dla firm oceniających poziom zgodności ElevenLabs spełnia wymogi AICPA SOC Type II i GDPR oraz uzyskało certyfikację AIUC-1. AIUC-1 to standard bezpieczeństwa stworzony specjalnie dla agentów AI.
Niezawodność
Niezawodność to ostatni filar naszego frameworku oceny agentów głosowych. Obejmuje to, czy agent może konsekwentnie działać w czasie rzeczywistym.
Przy ocenie agenta głosowego zwróć uwagę na:
- Dostępność: Każde wdrożenie skierowane do klientów wymaga dostępności na poziomie 99,9%, aby uniknąć przestojów. Niezawodna dostępność ma ogromne znaczenie zwłaszcza w zastosowaniach działających stale, takich jak wsparcie przychodzące.
- Kontrolowane ograniczanie działania: Ze względu na złożoność agentów głosowych, gdy jeden komponent zaczyna zawodzić, agent powinien płynnie ograniczyć działanie. W praktyce oznacza to przekierowanie do człowieka, zamiast dalszego działania pod większym obciążeniem lub zwracania błędów.
- Działanie pod obciążeniem:Przed uruchomieniem testy obciążeniowe powinny symulować co najmniej 2x oczekiwanej szczytowej współbieżności. Testowanie pod dużym obciążeniem może wykryć wzrost opóźnień lub spadki wydajności widoczne tylko na dużą skalę.
Nawet wysokiej jakości model, który spełnia wszystkie pozostałe wymagania, może być bezużyteczny, jeśli nie skaluje się wraz z zapotrzebowaniem klientów. ElevenAgents zaufało 1 000 000 czołowych twórców i firm, co pokazuje zdolność platformy do wdrożeń na skalę enterprise bez kompromisów w zakresie wydajności.
Jak mierzyć MOS dla agentów głosowych — krok po kroku
Jeśli twoja firma chce mierzyć MOS ręcznie, potrzebujesz dużej grupy ludzkich słuchaczy i próbek audio z prawdziwych rozmów. To uporządkowany proces obejmujący zbieranie opinii, uśrednianie i interpretację danych.
Tak w praktyce zmierzyć MOS dla agentów głosowych:
- Przygotuj zestaw testowy: Wybierz reprezentatywną próbę odpowiedzi audio agenta, obejmującą co najmniej 100 klipów z różnych rozmów.
- Przeprowadź sesję oceny: Poproś słuchaczy, aby ocenili każdy klip w skali 1–5 na podstawie jakości komunikacji.
- Zbierz oceny i oblicz wyniki: Uśrednij oceny dla każdego klipu, a następnie dla wszystkich klipów w próbce, aby uzyskać ogólny MOS. MOS na poziomie 4,3 lub wyższym wskazuje, że agent głosowy jest gotowy do produkcji.
Choć ten proces wymaga dużo pracy ręcznej, da ci solidny MOS dla wybranego agenta głosowego. Jeśli chcesz prowadzić test na dużą skalę, możesz zastąpić ludzkich słuchaczy automatycznymi narzędziami, takimi jak NISQA, które programowo przewidują wyniki MOS. Możesz zintegrować te systemy z aktywnymi pipeline'ami, aby stale monitorować MOS.
Benchmarki testów AI i ludzi: FCR, AHT i CSAT
Wielokrotne obliczanie MOS w czasie pozwala obserwować poprawę lub regresję modelu, ale dodatkowy kontekst uzyskasz, porównując wyniki z ludzką wydajnością. Sprawdzenie, co ludzie osiągają w podobnych rolach, pokaże, czy twój agent głosowy zbliża się do idealnego poziomu.
Oto kilka metryk, które warto uwzględnić w benchmarkach AI i ludzi.
Agenci AI powinni dorównywać ludziom pod względem FCR i CSAT, jednocześnie znacząco poprawiając AHT. Wynika to z faktu, że agenci AI zwykle obsługują bardziej ogólne rozmowy niż agenci ludzcy. Wiele firm wdraża workflow, w którym agenci AI są pierwszą linią kontaktu i przekazują rozmowy ludziom tylko wtedy, gdy są zbyt złożone, by obsłużyć je samodzielnie.
Dane Poe, agregatora porównań AI, z 2025 roku pokazują, że ElevenLabs zachowało największą ogólną skuteczność w realizacji próśb, wykonując 74,4% wszystkich przychodzących próśb. Sukces przełożył się na szybko rosnące użycie: Eleven v3 i v2.5-Turbo stanowiły z czasem ponad 60% wiadomości wysyłanych do modeli AI.
Aby zapewnić lepsze doświadczenie, użyj Eleven v4 — naszego najbardziej emocjonalnego modelu TTS.
Wiadomości wysyłane do modeli AI w czasie — ElevenLabs prowadzi w frameworku oceny agentów głosowych Poe
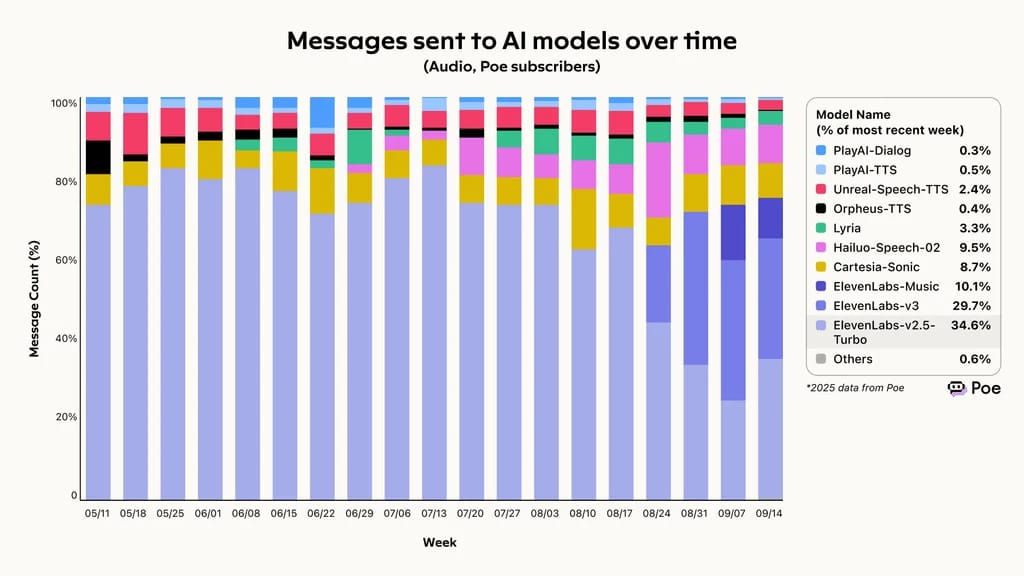
Wiadomości wysyłane do modeli AI w czasie według benchmarku Poe
Częste błędy w testowaniu agentów głosowych
Stosując framework oceny agentów głosowych, łatwo ulec pokusie testowania najlepszych możliwych scenariuszy. W rzeczywistości codzienne doświadczenia klientów korzystających z twoich systemów głosowych AI nie wynikają z idealnych warunków.
Oto trzy częste błędy w testowaniu agentów głosowych i sposoby ich naprawy:
- Testowanie najłatwiejszej ścieżki: Szczególnie przy wyborze klipów audio do MOS pamiętaj o przypadkach brzegowych. Klipy z szumem tła lub mową z akcentem są bardzo częste w rzeczywistości, więc testowanie wyłącznie „czystych” plików audio prowadzi do błędnej kalibracji MOS.
- Stawianie retencji ponad rozwiązaniem problemu: Optymalizowanie modeli tak, by utrzymywały użytkowników w systemie agenta, zawyża wskaźnik retencji bez poprawy wyników. Jeśli FCR jest niski mimo wysokiej retencji, agent prowadzi użytkowników przez frustrującą pętlę. Zapewnij możliwość rozmowy z ludzkim agentem dla osób, które tego chcą.
- Ignorowanie percentyli opóźnienia: SLA często określają opóźnienie na poziomie P95. Ta metryka jest ważna dla zapewnienia spójnego doświadczenia większości klientów, ale pamiętaj, że ostatnie 5% to też prawdziwi klienci. W systemie obsługującym 10 000 rozmów dziennie 5% oznacza nadal 500 osób doświadczających wolnej rozmowy. Głównym celem SLA powinno być P99, a nie tylko mediana lub P95.
Pamiętając o tym, możesz ustalić uczciwe i reprezentatywne wartości bazowe zamiast opierać się na wyidealizowanych średnich.
Dlaczego warto oceniać pod kątem konkretnego zastosowania
Choć sześć filarów opisanych w tym frameworku wskazuje obszary, które warto zbadać, waga każdego z nich zależy od branży. Na przykład firma z sektora usług finansowych może priorytetowo traktować zgodność i użycie narzędzi, a marka konsumencka — jakość głosu TTS.
Oto dwa przykłady ocen dostosowanych do zastosowania i tego, jak zmieniają równowagę między filarami.
Obsługa klienta
W niektórych branżach, np. w call center, ważną rolę odgrywają inne metryki realizacji zadań, takie jak rozwiązanie sprawy przy pierwszym kontakcie (FCR). Skuteczna obsługa rozmowy przychodzącej bez interwencji człowieka znacząco zmniejsza obciążenie pracowników obsługi klienta. McKinsey szacuje , że call center korzystające z agentów głosowych mogą zmniejszyć liczbę interakcji nawet o 50%.
Choć mniej ważny niż wskaźnik sukcesu zadań, warto rozważyć też wskaźnik retencji. To metryka analizująca całkowity czas trwania rozmowy. Jeśli wskaźnik retencji jest bardzo wysoki, a FCR niski, twoi agenci zatrzymują ludzi na linii bez rozwiązania ich problemu. W praktyce może to oznaczać frustrujące krążenie w kółko.
Warto śledzić także AHT, ponieważ agenci AI mają szybko rozwiązywać rutynowe problemy. Dlatego obszar obsługi klienta będzie bardziej priorytetowo traktował jakość rozmowy — zwłaszcza naprzemienność wypowiedzi i wskaźnik fallbacków — niż inne obszary.
Opieka zdrowotna
Opieka zdrowotna to silnie regulowana branża o rygorystycznych wymogach zgodności, przez które działanie agentów głosowych jest wyjątkowo delikatne. Zgodność jest kluczowa, więc waga filaru bezpieczeństwa w frameworku wyraźnie przesuwa się w jej stronę i w stronę inteligencji.
Chatboty medyczne muszą obsługiwać umawianie wizyt, ścieżki dostępu do telemedycyny, wstępną ocenę objawów i pytania dotyczące ubezpieczeń. Wszystko to wymaga wysokiego poziomu inteligencji i użycia narzędzi, co ponownie pokazuje, że wymagania branży lub roli wpływają na to, który filar jest najważniejszy.
Niezależnie od branży, w której działa twoja firma, zrozumienie głównych filarów oceny agentów głosowych i wyważone stosowanie ich pomoże znaleźć najlepszych agentów dla ciebie.
Twórz z ElevenAgents — wysoka wydajność i niskie opóźnienie
Platforma, na której tworzysz, bezpośrednio wpływa na działanie agentów głosowych w prawdziwych workflow. Szczególnie w kontaktach z klientami musisz mieć pewność, że twój agent sprawdzi się w każdej kategorii.
ElevenAgents stworzono z myślą o produkcyjnych wdrożeniach głosowych. Łączy wiodące w branży TTS dzięki Eleven v4, STT w czasie rzeczywistym przez Scribe v2 oraz warstwę orkiestracji agentów zaprojektowaną dla skali enterprise. Każdy komponent działa zgodnie z benchmarkami opisanymi w tym frameworku, dzięki czemu możesz dostarczać klientom wysokiej jakości doświadczenia.
Niezależnie od tego, czy rozważasz opcje, czy chcesz od razu zacząć tworzyć, ElevenLabs ma ścieżkę dla ciebie. Poznaj platformę ElevenAgents i sprawdź, jak pasuje do twojego zastosowania, albo zarejestruj się i zacznij tworzyć już dziś.
FAQ o ocenie agentów głosowych

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.


