
Czym jest LLM? Praktyczny przewodnik po modelach językowych
- Autor
- Jack Limebear
- Opublikowano
PosłuchajPosłuchaj tego artykułu
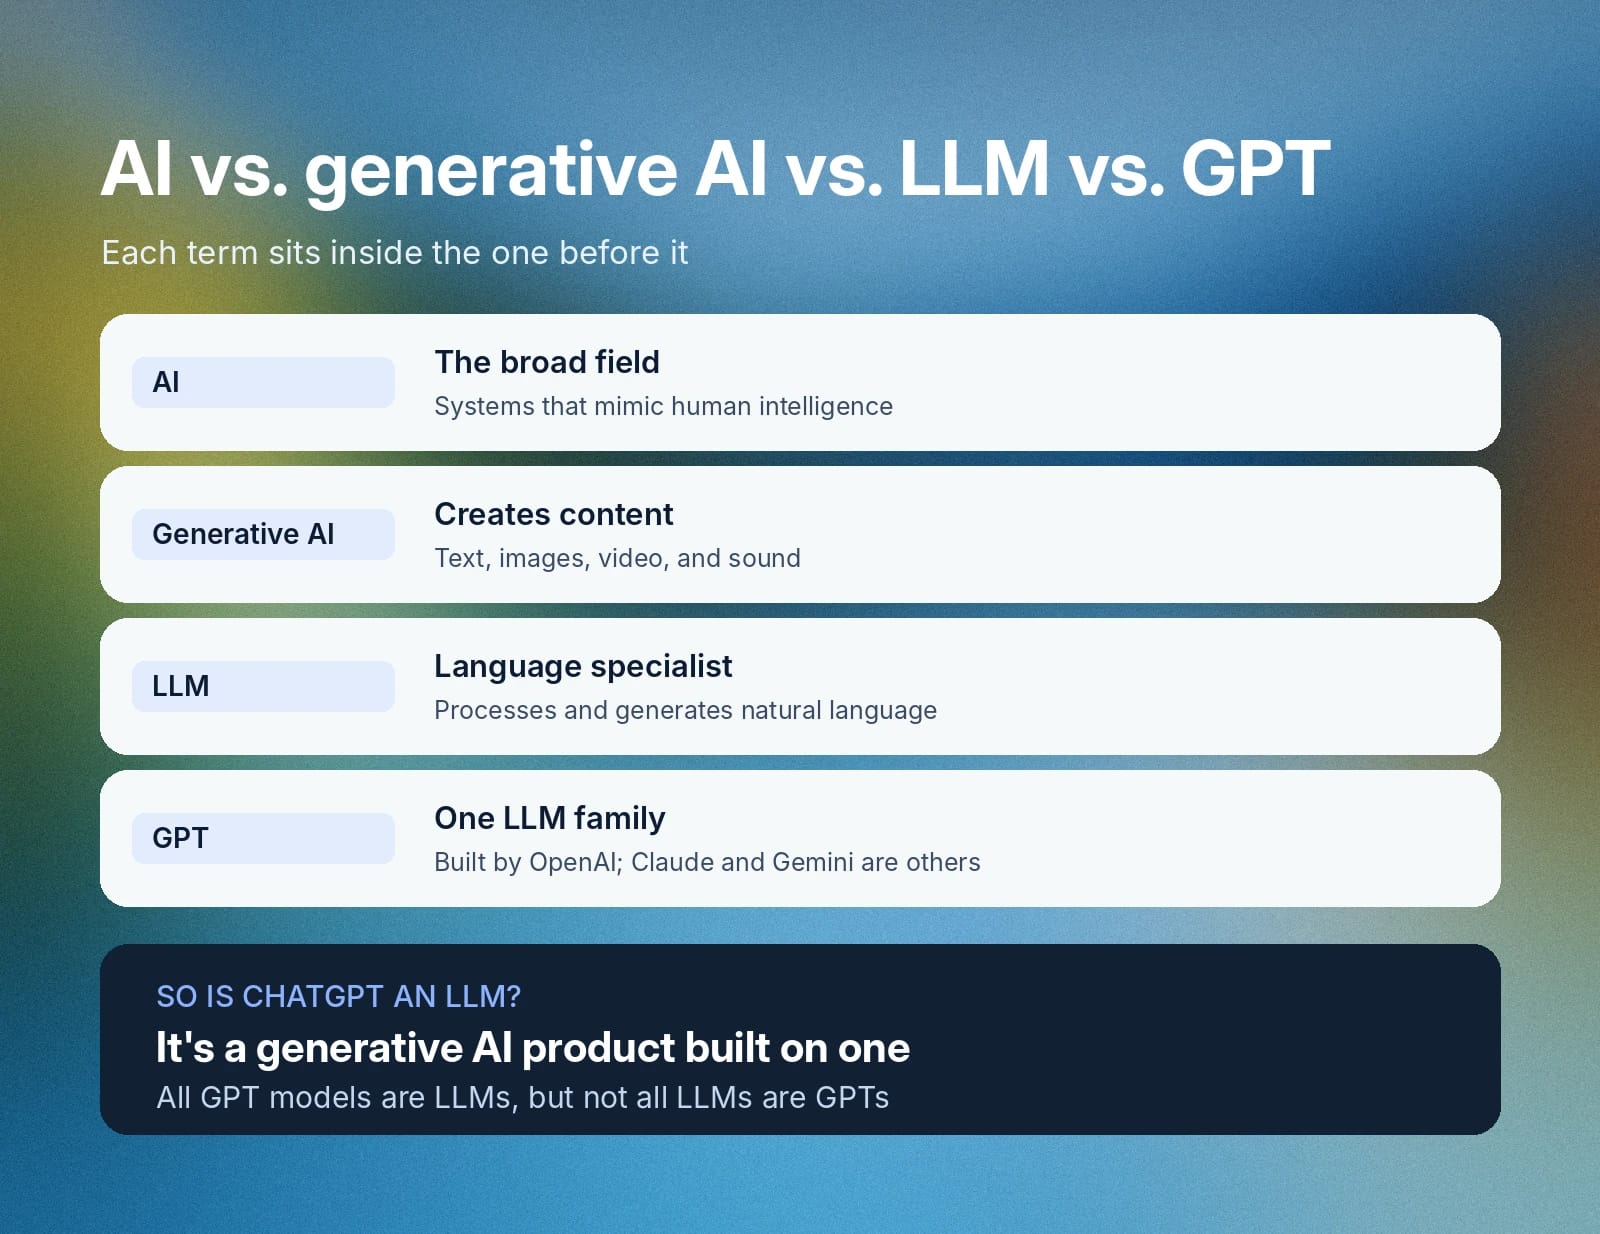
Duży model językowy (LLM) to system sztucznej inteligencji trenowany na ogromnym zbiorze danych, który analizuje, przewiduje i generuje język naturalny. Popularne LLM-y to modele GPT od OpenAI, Claude od Anthropic i Gemini od Google. Często wykorzystuje się je do pisania, redakcji i programowania.
Początkowo zbiory danych LLM-ów obejmowały głównie teksty z książek, blogów, a nawet forów internetowych. Współczesne LLM-y wykorzystują dane multimodalne, co poszerza ich zastosowania — mogą na przykład zasilać konwersacyjnych agentów głosowych lub tworzyć muzykę.
Przed wdrożeniem tej technologii organizacje często szukają odpowiedzi na pytania: czym jest LLM, jak działa i jaką architekturę powinien wybrać zespół? Ten przewodnik odpowiada na te pytania, a także pokazuje praktyczne zastosowania tej technologii i konkretne korzyści.
Podsumowanie
- Duży model językowy (LLM) to model sztucznej inteligencji trenowany na ogromnych zbiorach danych tekstowych i multimodalnych, aby analizować, przewidywać i generować wyniki.
- Główna różnica między GPT a LLM polega na tym, że GPT (Generative Pre-trained Transformer) to konkretna rodzina LLM-ów stworzona przez OpenAI, a LLM to szersze określenie modeli takich jak Claude i Gemini.
- Generatywna AI to szeroka kategoria modeli tworzących różne rodzaje treści na podstawie danych treningowych, a LLM-y to wyspecjalizowana część generatywnej AI skupiona na przetwarzaniu języka naturalnego.
- LLM-y działają dzięki transformerowym sieciom neuronowym, które dzielą tekst na mniejsze jednostki zwane tokenami, a następnie przewidują kolejny token na podstawie kontekstu promptu i historii czatu.
- Praktyczne przykłady dużych modeli językowych to chatboty obsługi klienta, automatyczne narzędzia do pisania, generatory kodu i warstwy przetwarzania języka naturalnego w aplikacjach głosowych.
Czym jest LLM? Definicja dużego modelu językowego
Duży model językowy to program AI oparty na sieciach neuronowych głębokiego uczenia, który analizuje, przewiduje i generuje język naturalny. Deweloperzy trenują te modele na zbiorach zawierających miliardy tekstów z książek, publikacji naukowych, stron internetowych i blogów. Określenie „duży” odnosi się zarówno do ogromnej ilości danych treningowych, jak i miliardów wewnętrznych parametrów sterujących zachowaniem modelu.
Duże modele językowe znacząco różnią się od wcześniejszego oprogramowania. Tradycyjne programy opierały się na jawnych poleceniach składniowych, a LLM-y nie. Zamiast przetwarzać każde słowo osobno, LLM-y wykorzystują zależności kontekstowe, by rozpoznawać złożone wzorce językowe i gramatykę. Interpretują nieustrukturyzowany ludzki język i odpowiadają na otwarte prompty użytkownika, dostosowując się do zmian kontekstu w trakcie rozmowy.
Te postępy w przetwarzaniu języka naturalnego napędzają ElevenAgents, dzięki czemu rozumie złożone intencje klientów i wykonuje zautomatyzowane workflow.
Jak działają duże modele językowe?
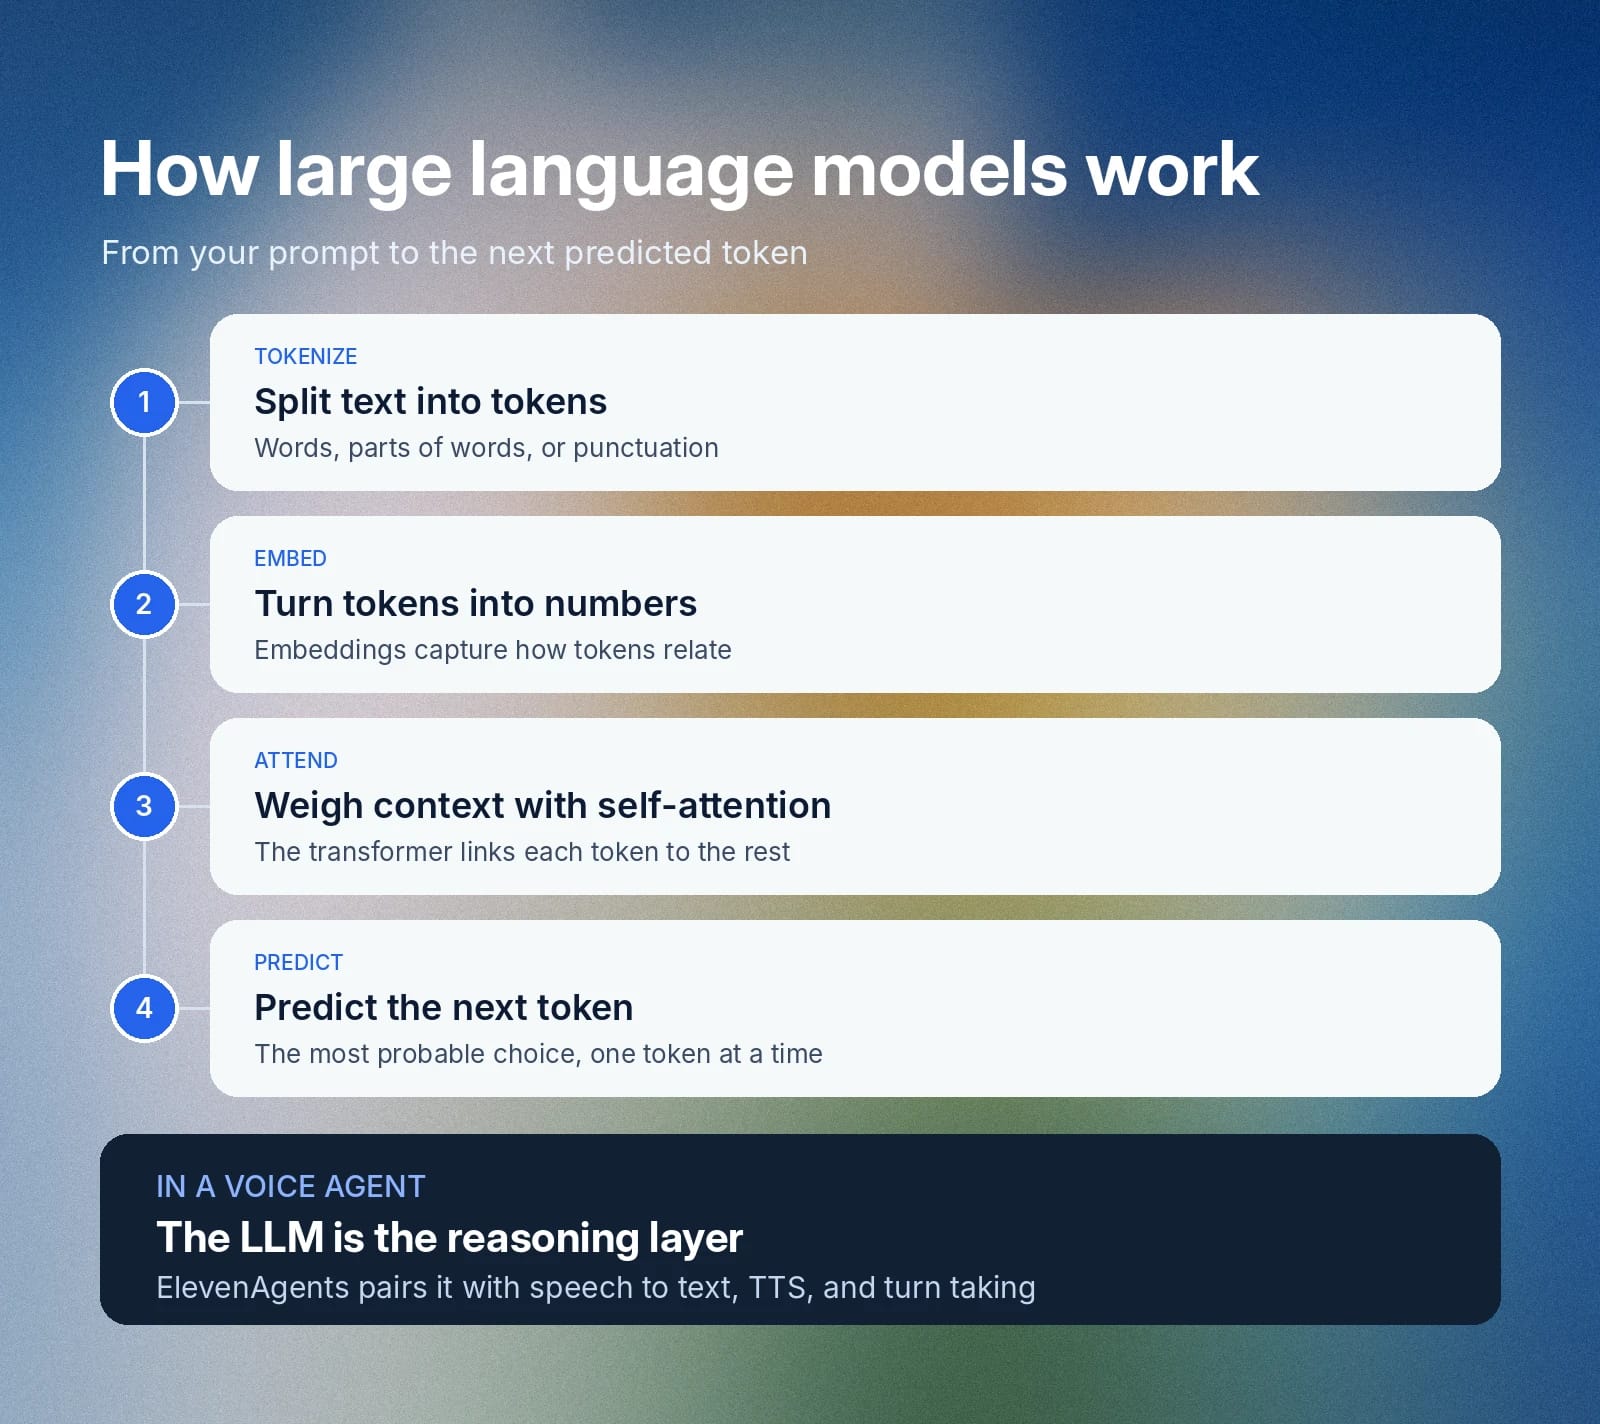
Duże modele językowe przetwarzają tekst za pomocą sztucznych sieci neuronowych, aby analizować dane wejściowe w języku naturalnym i tworzyć trafne treści. Proces zaczyna się od tokenizacji, podczas której model dzieli tekst wejściowy na mniejsze jednostki zwane tokenami. Następnie przekształca tokeny w reprezentacje liczbowe, zwane embeddingami, aby ocenić matematyczne lub statystyczne zależności między nimi.
Większość współczesnych systemów LLM opiera się na architekturze transformerowych sieci neuronowych. Transformery wykorzystują mechanizmy self-attention, które oceniają zależności kontekstowe między tokenami. Model przewiduje token o największym prawdopodobieństwie statystycznym, który uzupełni sekwencję, wykorzystując wyuczone wzorce do obliczania rozkładów prawdopodobieństwa.
Self-attention pozwala modelom przetwarzania języka naturalnego zachować kontekst długiego zasięgu i dostosowywać się do zmian w trakcie rozmowy. Integracje platformy z ElevenAgents wykorzystują te możliwości, by zapewniać trafne odpowiedzi o niskim opóźnieniu, przypominające naturalną ludzką rozmowę.
Czym jest temperatura w LLM?
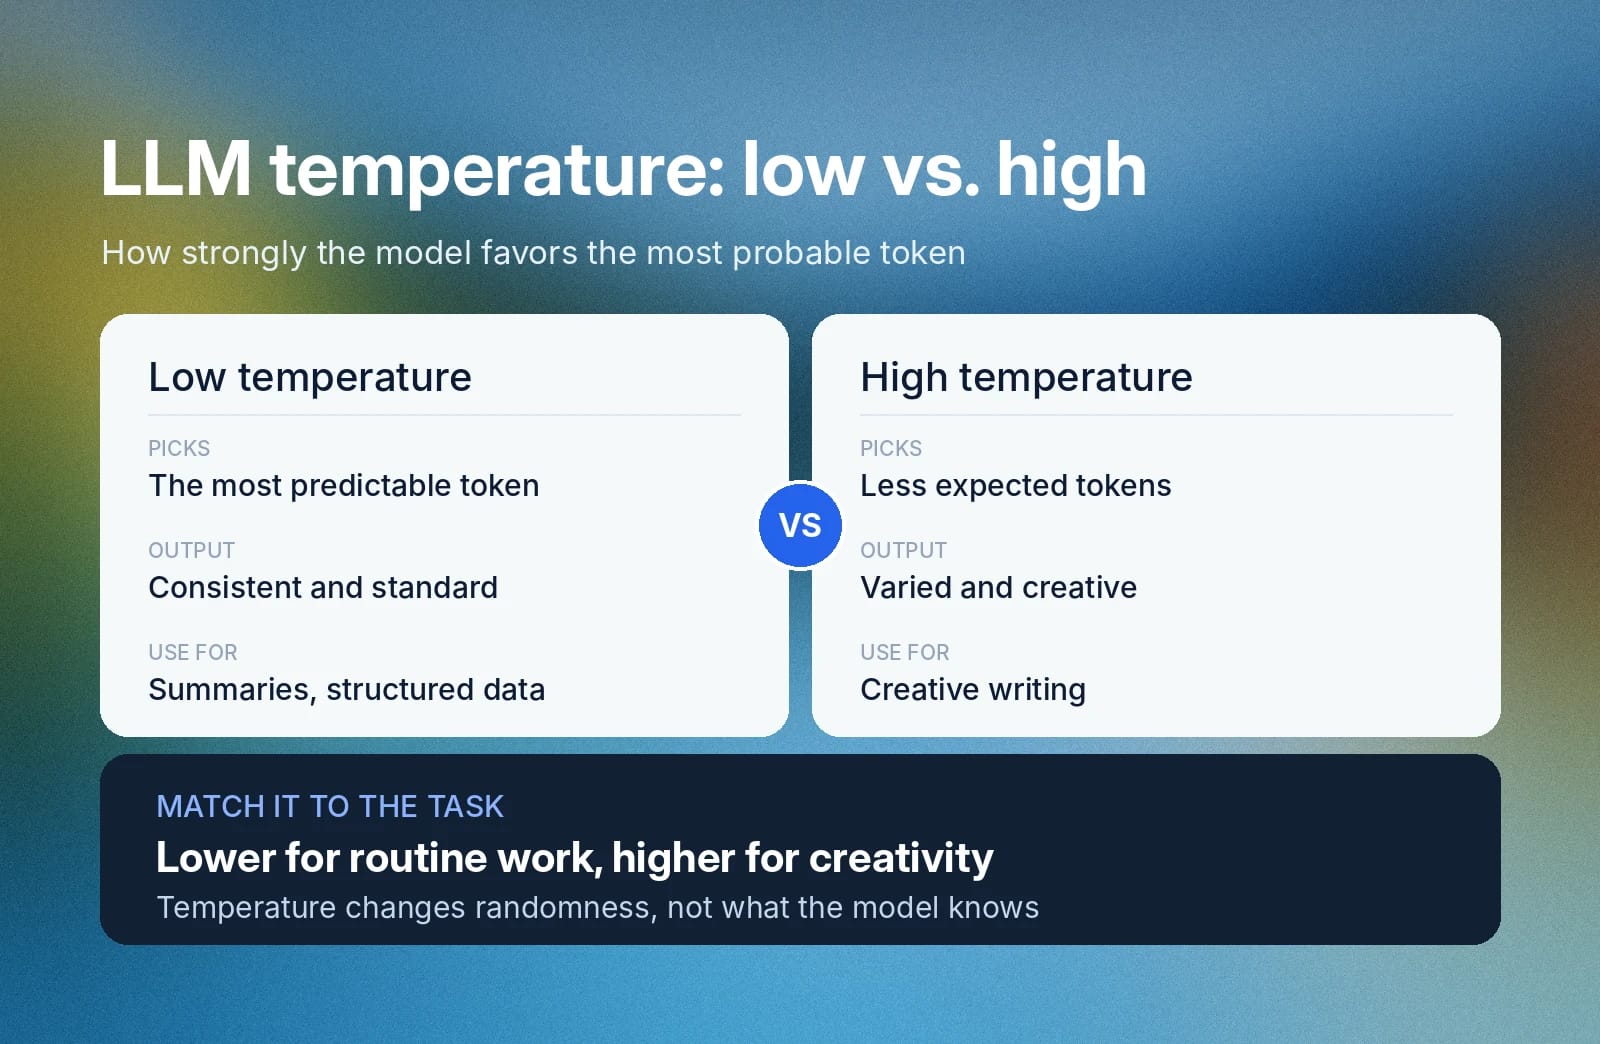
Temperatura LLM to zmienne ustawienie, które deweloperzy mogą skonfigurować, aby określić, jak losowe będą odpowiedzi modelu. LLM-y generują kolejny token w ciągu słów, wybierając najczęstszą opcję. Przy każdym wyborze modelu może jednak istnieć kilka alternatyw o podobnej wadze.
Zmieniając temperaturę LLM, określasz, jak silnie model preferuje najbardziej prawdopodobną opcję. Niska temperatura daje standardowe i spójne wyniki, ponieważ model będzie zwykle wybierał najbardziej przewidywalny kolejny token w ciągu. Z kolei wysoka temperatura częściej odchodzi od oczekiwanego wyboru, tworząc bardziej kreatywne i zróżnicowane wyniki.
Dostosuj temperaturę LLM do zadania, które chcesz wykonać. Zadania wymagające kreatywności powinny korzystać z wyższej temperatury, a rutynowe zadania lub ustrukturyzowane wyniki, takie jak podsumowania danych, z niższej.
Jak trenuje się i dostraja LLM-y?
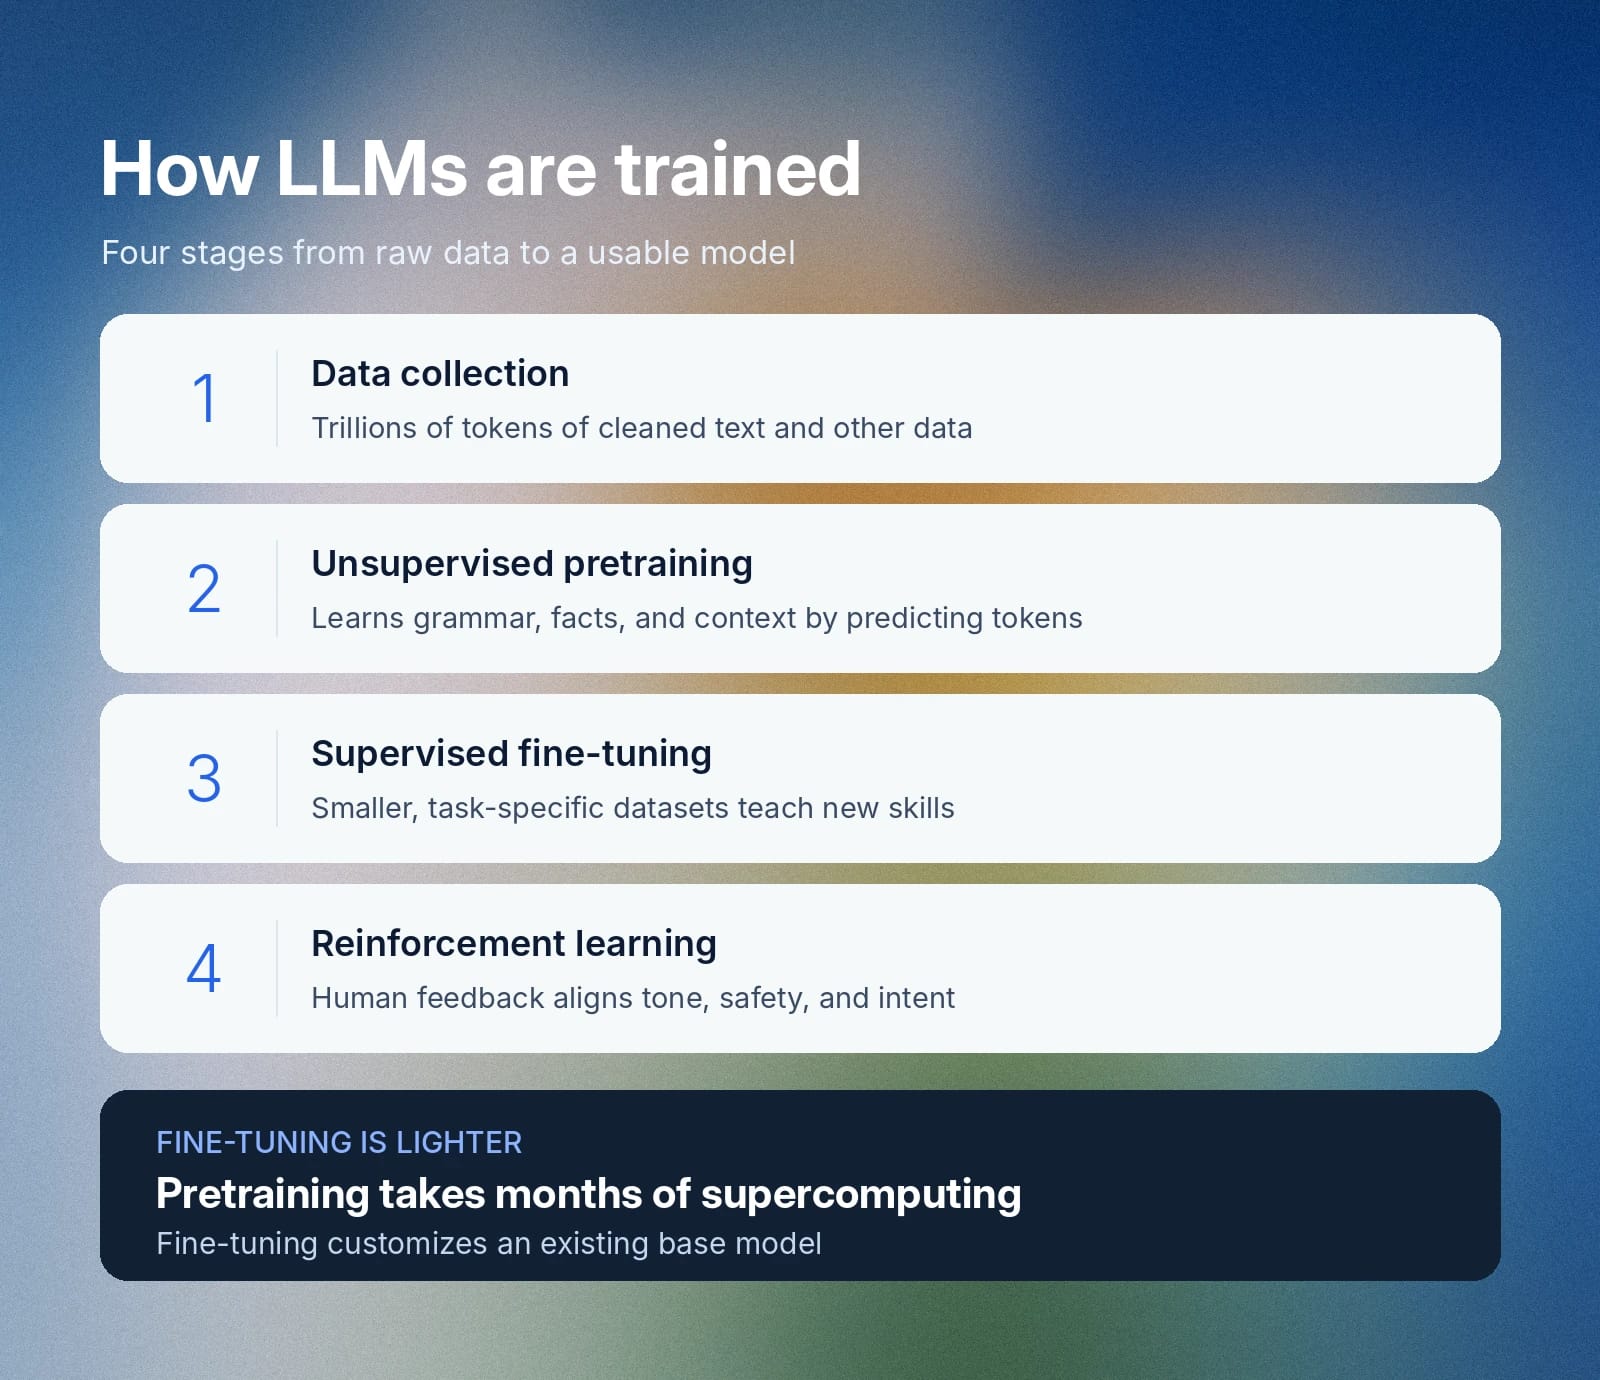
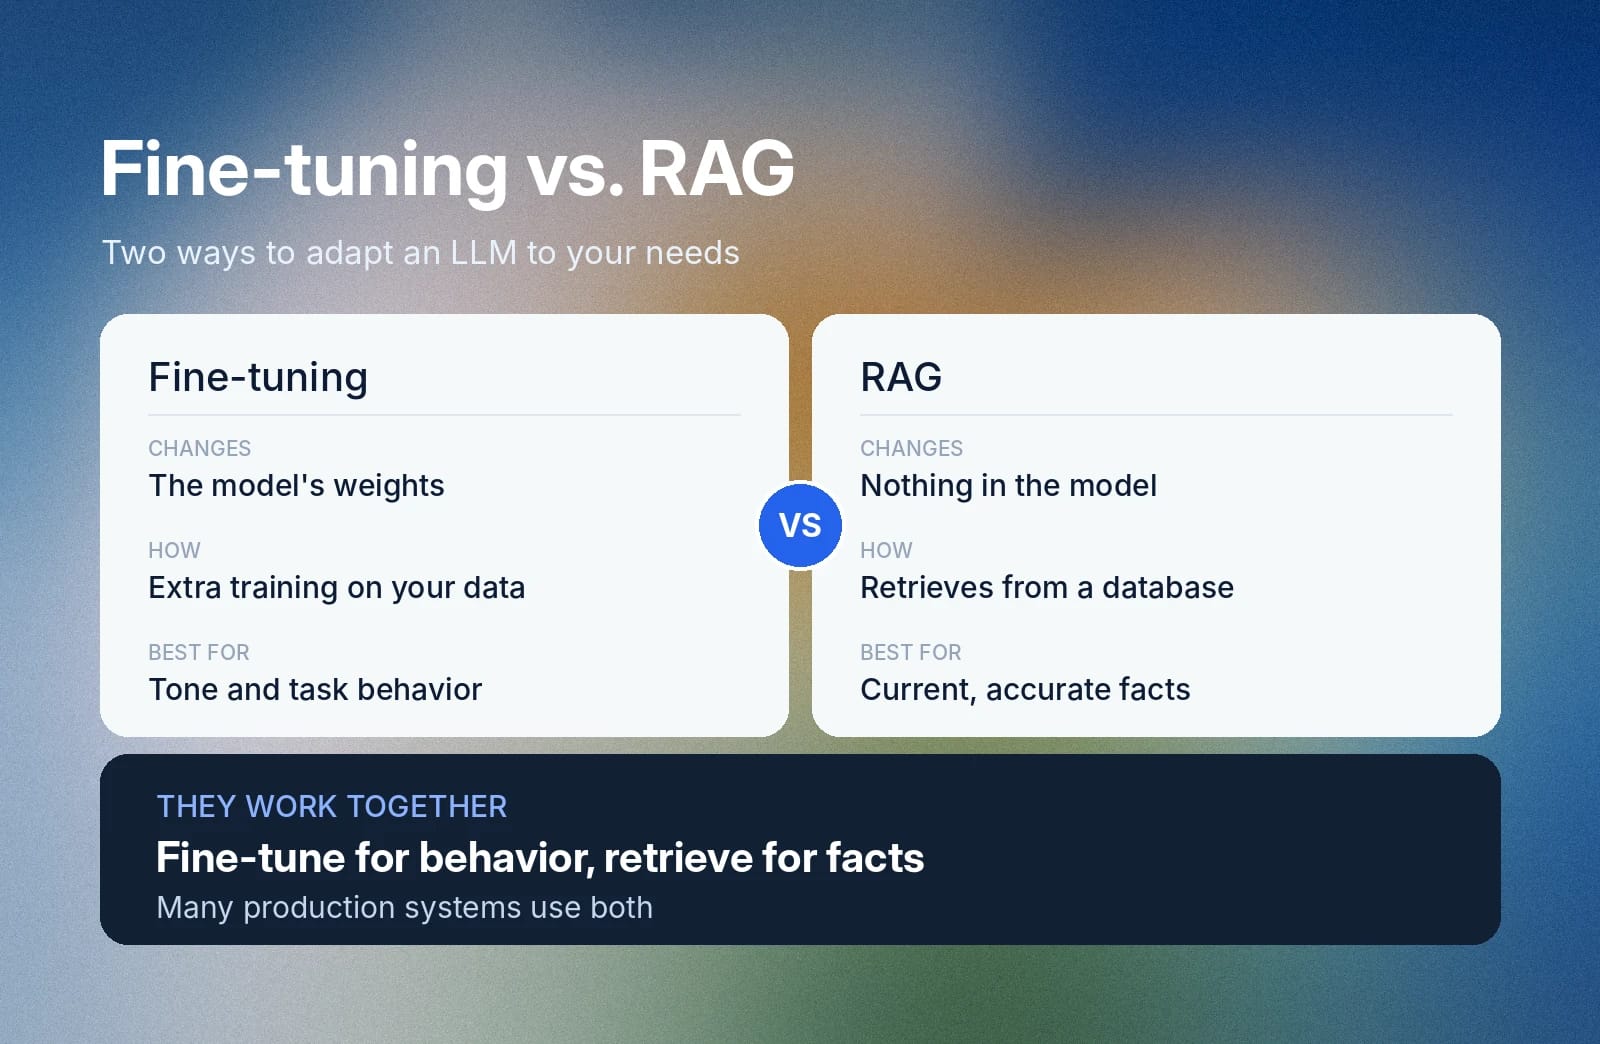
Trenowanie LLM-ów wymaga wieloetapowego procesu, który zamienia surowy tekst i dane multimodalne w działające systemy językowe. Firmy potrzebują zaawansowanej mocy superkomputerów działających przez kilka miesięcy, natomiast fine-tuning to lżejszy proces dostosowujący istniejący model bazowy.
Firmy tworzące najbardziej zaawansowane AI zwykle traktują szczegóły procesu trenowania jako informacje zastrzeżone, a większość nie ujawnia kodu źródłowego ani wag modelu. Zazwyczaj trening przebiega jednak tak:
- Zbieranie i wstępne przetwarzanie danych: Deweloperzy tworzą zbiory danych z wielu źródeł oraz korpusy do pretreningu obejmujące biliony tokenów z terabajtów oczyszczonego tekstu. Pobieranie lub wydobywanie tekstu ze źródeł internetowych to jeden z głównych sposobów budowania takich zbiorów.
- Pretrening bez nadzoru: Duży model językowy przetwarza biliony tokenów, aby poznać reguły gramatyczne, zależności faktograficzne i kontekst językowy. W praktyce wstępnie trenuje się sam poprzez autoregresyjne modelowanie języka oparte na mechanizmach self-attention, które obliczają najbardziej prawdopodobny statystycznie kolejny token w sekwencji.
- Fine-tuning z nadzorem: Inżynierowie wykorzystują mniejsze, bardziej wyspecjalizowane zbiory danych, aby dostosować wstępnie wytrenowany model. Ten etap uczy model konkretnych umiejętności — od odpowiadania na ogólne pytania po tworzenie logo czy prowadzenie badań laboratoryjnych.
- Uczenie ze wzmocnieniem i dostrajanie: Deweloperzy dopracowują zachowanie modelu na podstawie opinii ludzkich recenzentów i modeli nagrody. Ten etap dostosowuje wyniki modelu do wytycznych dotyczących zabezpieczeń, wymagań co do tonu i ludzkich intencji.
Rodzaje architektur LLM: enkodery, dekodery i modele hybrydowe
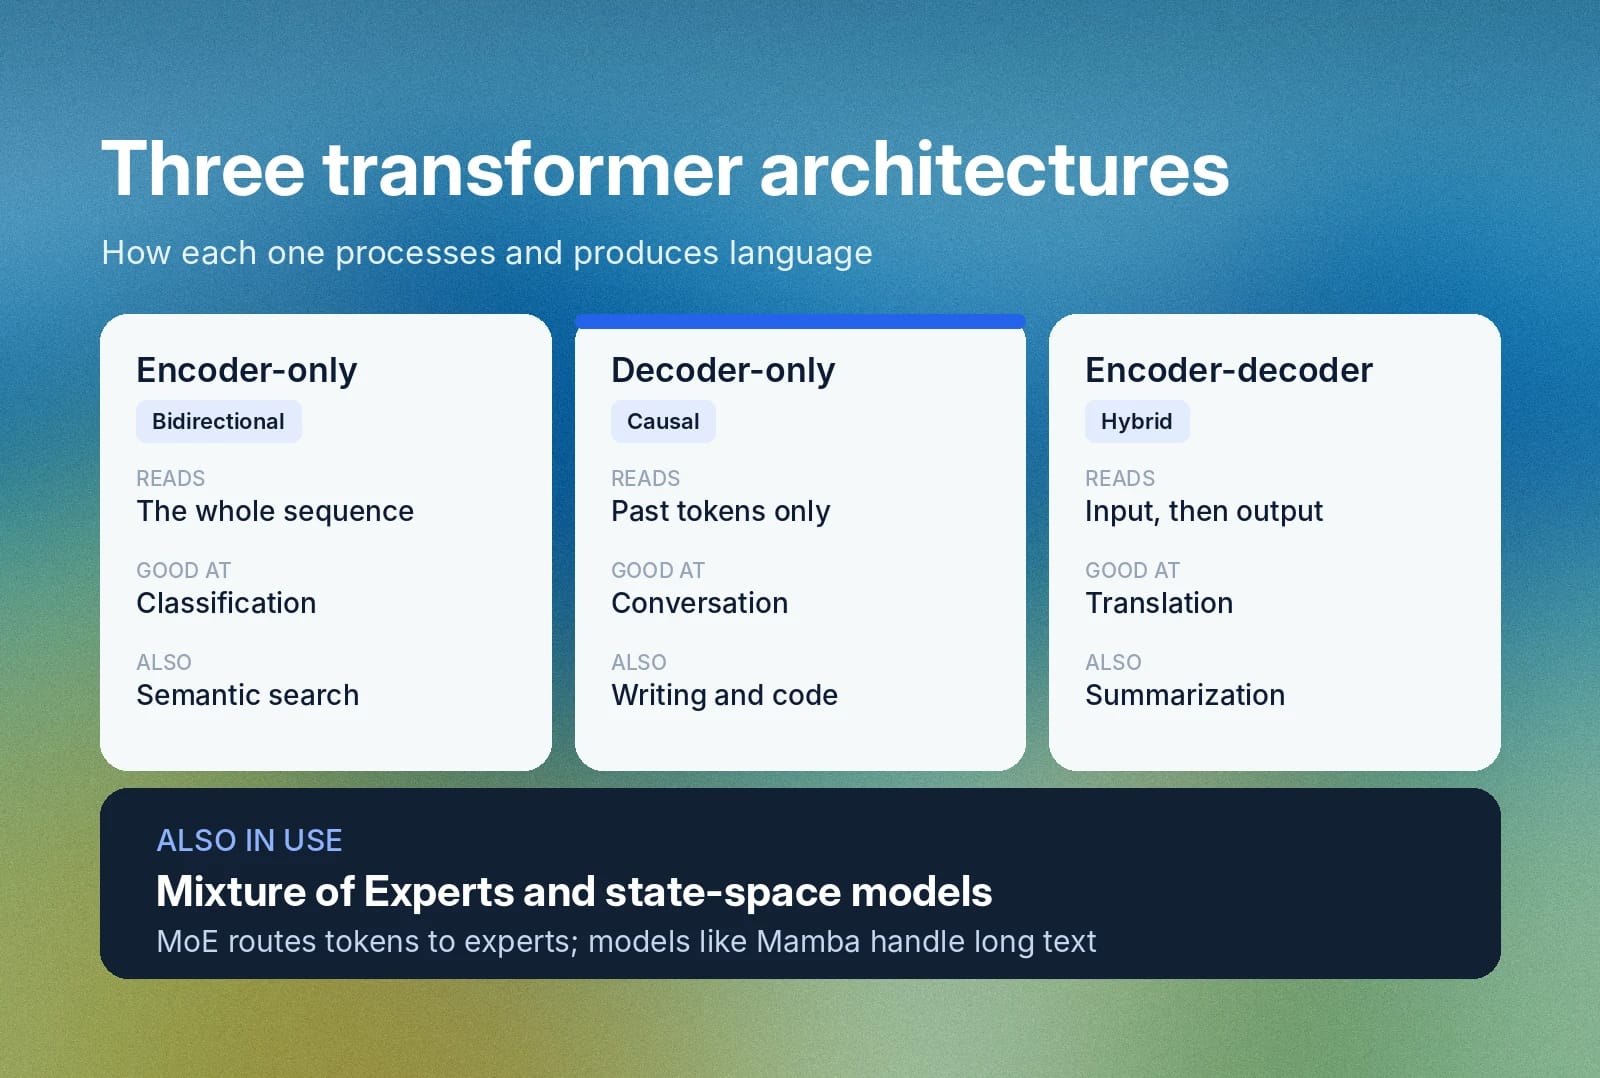
Architektury transformerowe organizują warstwy sieci neuronowych na różne sposoby, aby przetwarzać dane wejściowe i tworzyć treści. Klasyczne transformery dzielą się na trzy główne kategorie: modele tylko z enkoderem, tylko z dekoderem oraz enkoder-dekoder, czyli hybrydowe. Współczesne systemy wykorzystują też architektury zwiększające wydajność, by skalować możliwości.
Modele tylko z enkoderem
Architektury tylko z enkoderem przetwarzają całe sekwencje naraz, wykorzystując dwukierunkowe self-attention. Pozwala to modelowi oceniać relację każdego tokenu z innymi wcześniejszymi i późniejszymi tokenami. W praktyce optymalizuje to modele do zadań takich jak:
- Klasyfikacja tekstu
- Analiza sentymentu
- Wyszukiwanie informacji
- Wyszukiwanie semantyczne
Takie zadania występują też w workflow związanych z mową. Model Scribe speech to text od ElevenLabs transkrybuje mowę w ponad 90 językach, a funkcja wykrywania encji oznacza w transkrypcjach wrażliwe dane i obraźliwy język.
Modele tylko z dekoderem
Architektury tylko z dekoderem wykorzystują uwagę przyczynową do przetwarzania tokenów i przewidują każde słowo na podstawie wcześniejszych tokenów. Modele te tworzą płynne rozmowy i stanowią główną architekturę współczesnych konwersacyjnych chatbotów, asystentów do pisania otwartych tekstów i narzędzi do generowania kodu.
W ElevenAgents wybrany przez ciebie LLM, zwykle model tylko z dekoderem, generuje odpowiedzi agenta, a własnościowy model naprzemienności wypowiedzi zarządza tempem rozmowy.
Modele enkoder-dekoder (hybrydowe)
Modele enkoder-dekoder używają enkodera do przetwarzania danych wejściowych i dekodera do generowania wyników. Ta podwójna struktura sprawia, że modele hybrydowe lepiej sprawdzają się w zadaniach wymagających ścisłego zachowania kontekstu, takich jak podsumowywanie dokumentów, tłumaczenie języków i formatowanie danych.
Tłumaczenie to klasyczne zadanie dla modelu enkoder-dekoder, a ElevenLabs Dubbing obsługuje ponad 90 języków.
Mixture of Experts (MoE) i modele przestrzeni stanów
Zamiast aktywować każdy parametr sieci neuronowej dla każdego słowa, Mixture of Experts (MoE) kieruje poszczególne tokeny do mniejszych zespołów wyspecjalizowanych pod-sieci „ekspertów”. Zapewnia to głębię rozumowania porównywalną z ogromnymi modelami, ale przy większej szybkości i niższych kosztach obliczeniowych. Z kolei modele przestrzeni stanów, takie jak Mamba, wydajnie przetwarzają bardzo długie teksty.
ElevenAgents obejmuje LLM-y open source, które ElevenLabs hostuje we własnej infrastrukturze.
Przykłady dużych modeli językowych i codzienne zastosowania
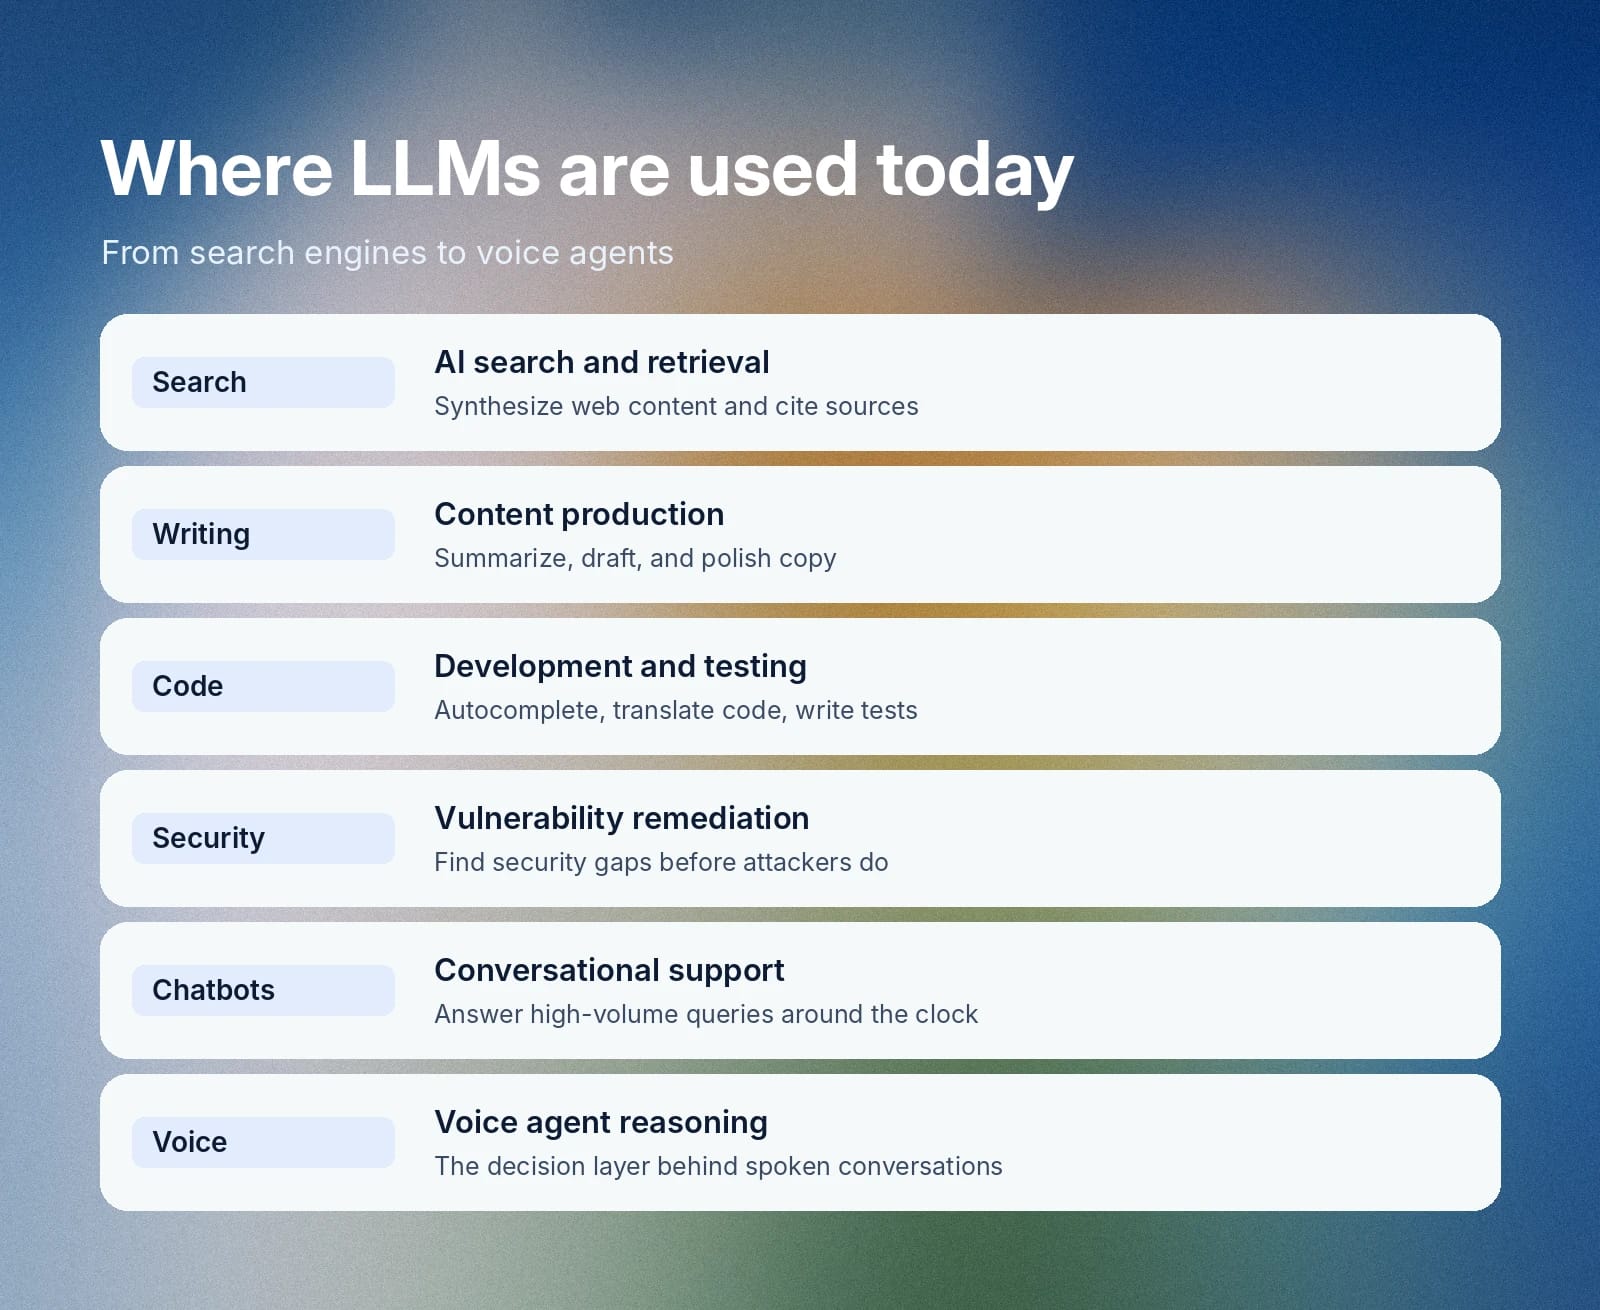
Organizacje znalazły szeroki zakres zastosowań dla dużych modeli językowych. Pokazują one, jak AI przeszła od badań eksperymentalnych do standardowej funkcji internetu, aplikacji i urządzeń codziennego użytku. Naukowcy AI wciąż badają i optymalizują architekturę bazową, ale przykłady LLM-ów z praktyki pokazują, jak zespoły wykorzystują je już dziś:
- Wyszukiwanie AI i pozyskiwanie informacji: Konwersacyjne wyszukiwarki, takie jak Bing, Google AI Overviews i Perplexity, używają LLM-ów do analizowania treści z internetu w czasie rzeczywistym. Modele syntetyzują informacje, bezpośrednio wskazują źródła i pozwalają użytkownikom zadawać pytania uzupełniające.
- Pisanie, redakcja i tworzenie treści: LLM-y i inne narzędzia AI ułatwiają pisanie oraz redagowanie materiałów do użytku wewnętrznego i zewnętrznego. Na przykład NotebookLM podsumowuje długie raporty, Jasper AI pisze reklamy, a Grammarly poprawia teksty.
- Generowanie kodu, rozwój i testowanie: AI napędza narzędzia programistyczne, takie jak GitHub Copilot, które automatycznie uzupełniają funkcje i tłumaczą kod z jednego języka programowania na drugi. Zespoły mogą też generować zautomatyzowane zestawy testów, aby łatwo wykrywać i naprawiać błędy przed wdrożeniem.
- Cyberbezpieczeństwo i usuwanie podatności: Czołowe firmy AI udostępniły wyspecjalizowane modele do wykrywania luk w zabezpieczeniach, co pomaga organizacjom wdrażać poprawki, zanim atakujący je znajdą i wykorzystają.
- Chatboty i asystenci konwersacyjni: Organizacje wdrażają interfejsy konwersacyjne, aby zapewnić obsługę klienta 24/7. Integracja z platformami takimi jak ElevenAgents pozwala firmom automatyzować liczne zapytania dzięki rozwiązaniom konwersacyjnym, zamiast opierać się na FAQ.
- Silnik rozumowania agenta głosowego: LLM-y są też centralną warstwą rozumowania w systemach głosowej AI. ElevenAgents łączy wybrany przez ciebie LLM z Speech to Text, Text to Speech o niskim opóźnieniu oraz własnościowym modelem naprzemienności wypowiedzi, aby prowadzić naturalne rozmowy w czasie rzeczywistym.
Jakie są ograniczenia dużych modeli językowych?
LLM-y stanowią podstawę większości produktów AI, z którymi kontaktują się konsumenci. To potężny element architektury, pomocny w wielu workflow i zastosowaniach. Jeśli jednak chcesz budować rozwiązania z LLM-ami lub trenować własny model, poznaj ich główne ograniczenia:
- Halucynacje: Nie ma gwarancji, że to, co generuje LLM, jest poprawne. Odpowiedź może łatwo zawierać zmyślone lub po prostu błędne informacje.
- Statyczna wiedza: Bez RAG LLM jest ograniczony do zakresu wiedzy, który otrzymał podczas treningu.
- Stronniczość: Jeśli dane treningowe zawierają uprzedzenia, model je odzwierciedli. To szczególnie ważne, gdy używasz LLM do klasyfikacji danych lub podejmowania decyzji na podstawie informacji, ponieważ ukryte uprzedzenia w danych mogą negatywnie wpłynąć na wyniki bez twojej wiedzy.
- Ograniczone okno kontekstowe: LLM-y zwykle pracują tylko z określoną ilością tekstu, więc w dłuższych rozmowach mogą zacząć tracić szczegóły i z czasem działać mniej skutecznie.
- Koszt i opóźnienie: Im większy LLM, tym więcej mocy obliczeniowej potrzebuje do działania. Jeśli wybierzesz wydajniejsze modele, prawdopodobnie zapłacisz więcej za lepszą usługę.
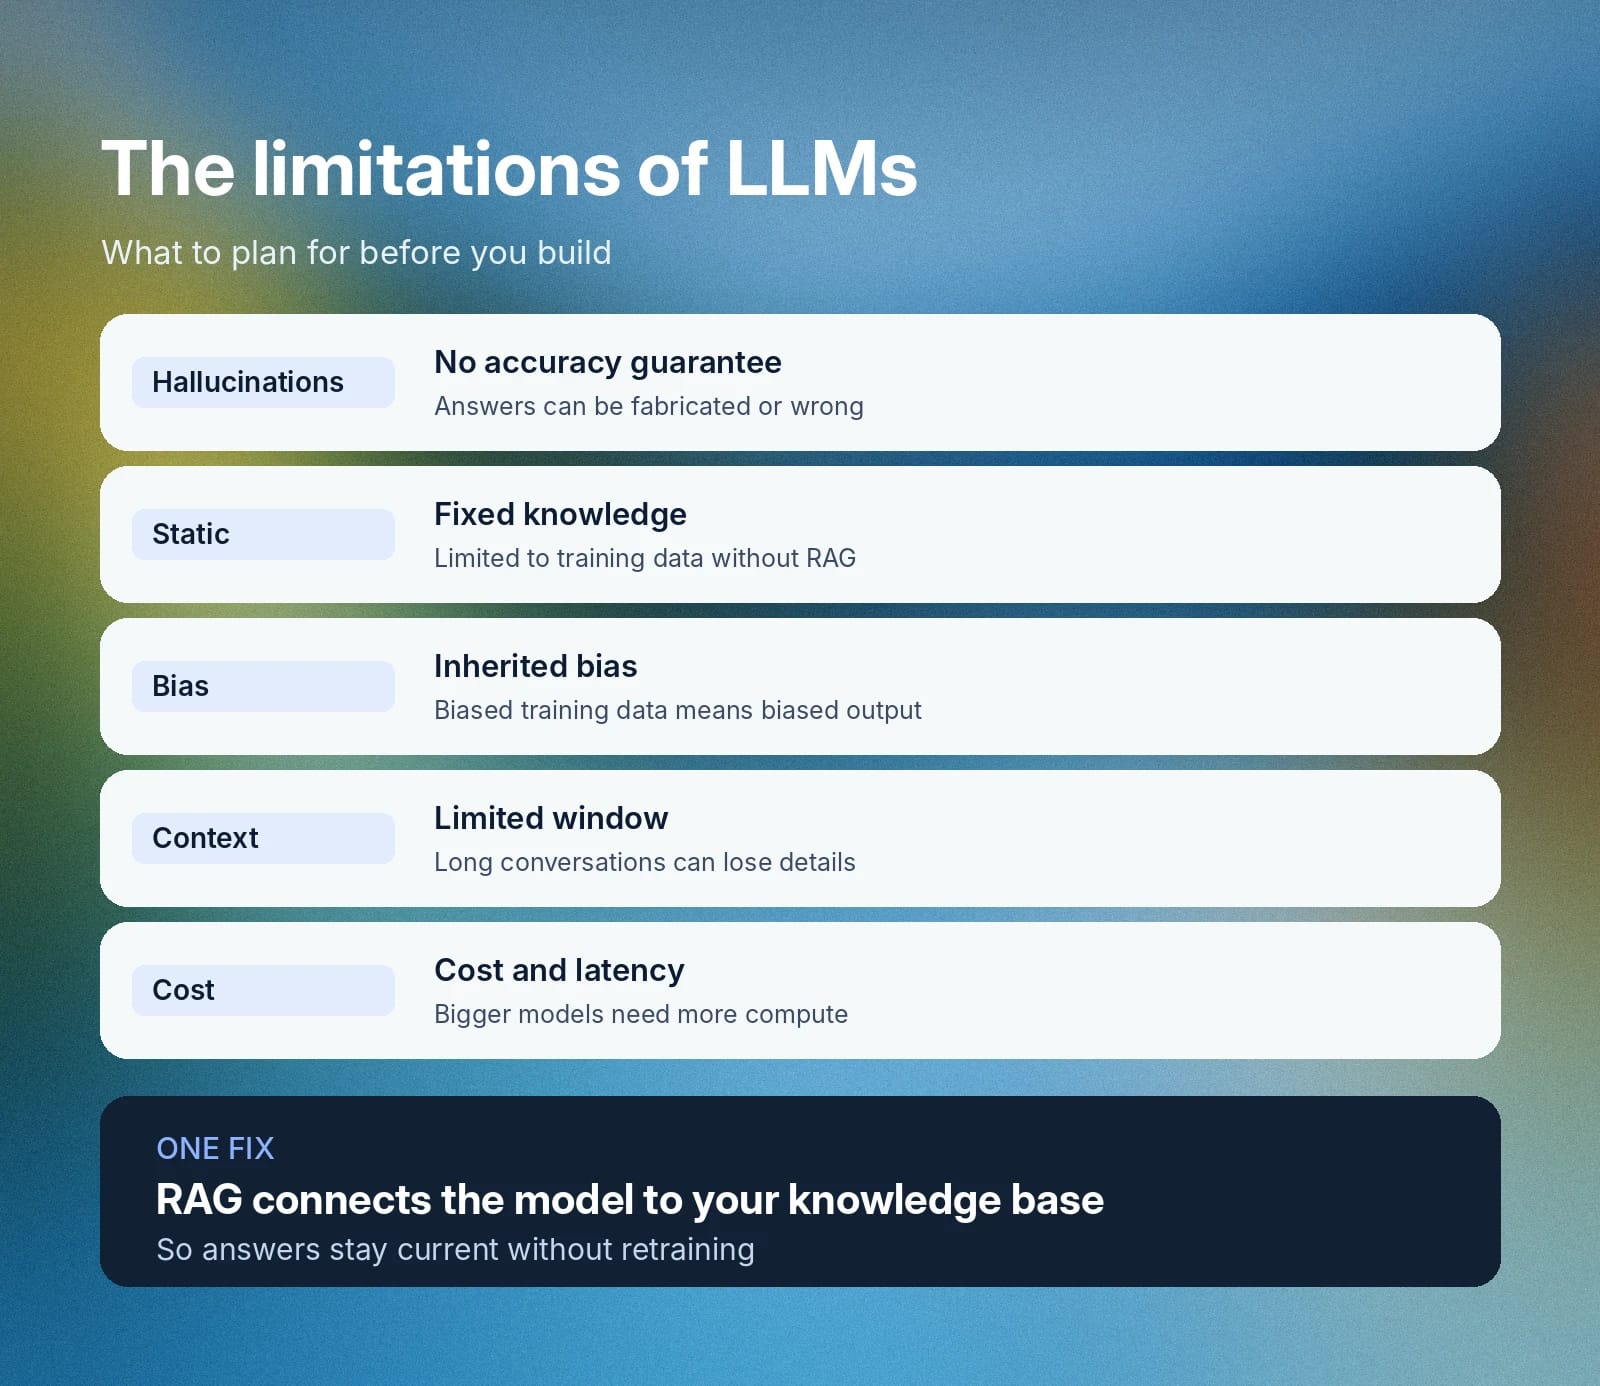
Możesz rozważyć kilka strategii i wdrożeń, by ograniczyć wpływ tych ograniczeń. Na przykład włączenie RAG w LLM i podłączenie stale rozbudowywanej bazy wiedzy rozwiązałoby problem statycznej wiedzy.
Twórz doświadczenia LLM z obsługą głosu dzięki ElevenAgents
Wybór dużego modelu językowego do twojego zastosowania to kluczowa decyzja, którą może być trzeba zmienić wraz z ewolucją potrzeb firmy, a nawet wymagań regulacyjnych. Unikanie uzależnienia od jednego dostawcy pozwala zachować elastyczność biznesową przy tworzeniu konwersacyjnych rozwiązań głosowej AI.
ElevenAgents pozwala wybrać obsługiwane LLM-y od dostawców takich jak OpenAI, Anthropic i Google lub podłączyć własny model niestandardowy przez endpoint zgodny z OpenAI. Dzięki temu łatwo dobierzesz optymalny balans szybkości, zdolności rozumowania i kosztu do swoich potrzeb.
Poznaj ElevenAgents, aby zobaczyć, jak hostowane LLM-y usprawniają workflow głosowe, lub skontaktuj się z działem sprzedaży, aby już dziś zacząć tworzyć swoje agenty głosowe o niskim opóźnieniu.
Najczęściej zadawane pytania o LLM-y

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.


