
Rozwiązuj problemy z dokładnością zamiany mowy na tekst dzięki lepszemu workflow
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Dokładność zamiany mowy na tekst (STT) zależy od trzech rzeczy: jakości audio, sposobu mówienia i używanych słów. Szum oraz silna kompresja odbierają nagraniu szczegóły, więc nawet dobre modele mają problem z nakładającymi się głosami lub nieznanym żargonem. Ten przewodnik pokazuje, skąd biorą się problemy z STT i jak je rozwiązać.
Błędy transkrypcji rzadko pozostają tylko w transkrypcji. Źle usłyszana nazwa leku w notatce klinicznej albo błędny numer konta w rejestrze rozmowy trafiają do każdego systemu korzystającego z tego tekstu — od wyszukiwania i analityki po agentów AI, którzy działają na podstawie wypowiedzianych słów. Niska dokładność wydłuża też weryfikację, bo ktoś musi ręcznie znaleźć i poprawić błędy.
Dobra wiadomość jest taka, że większość problemów z dokładnością STT da się rozwiązać. Wiele z tych poprawek wymaga tylko niewielkich zmian w obecnej konfiguracji lub sposobie nagrywania, więc nie musisz zmieniać ustawień modelu.
Temat ten może też występować jako dokładność rozpoznawania mowy, dokładność ASR lub dokładność transkrypcji. Zamiana mowy na tekst, rozpoznawanie mowy i automatyczne rozpoznawanie mowy (ASR) opisują ten sam proces przekształcania mówionego audio w tekst. Rozwiązania z tego przewodnika działają niezależnie od używanego terminu.
Podsumowanie
- Dokładność zamiany mowy na tekst zależy od jakości wejściowego audio, dynamiki mówców oraz kwestii leksykalnych i kontekstowych.
- Aby rozwiązać problem z dokładnością, ustal, gdzie w pipeline’ie — na wejściu, podczas przetwarzania lub na wyjściu — możesz wprowadzić zmianę.
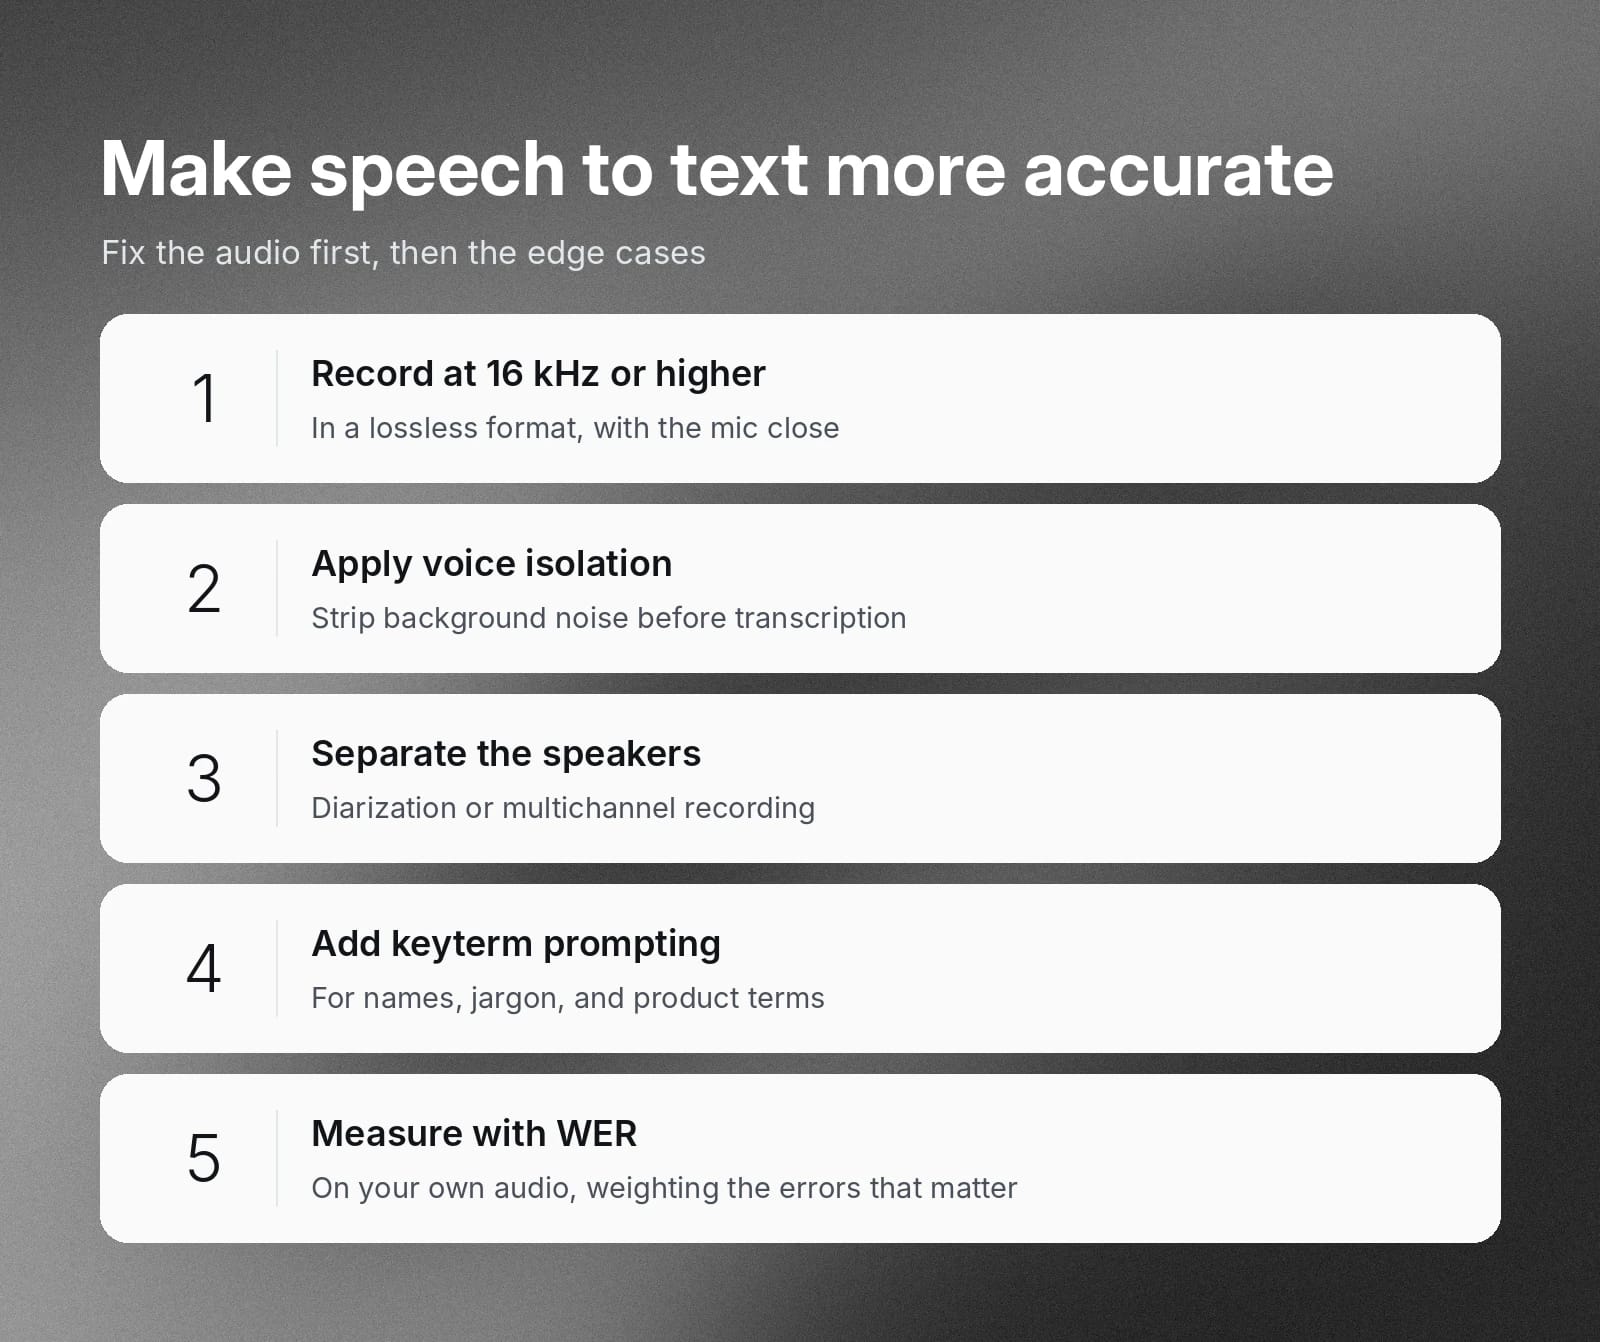
- Nagrywaj w 16 kHz lub wyżej, używaj formatów bezstratnych i umieszczaj mikrofony 10–15 cm od mówcy.
- Używaj Voice Isolator, diarizacji lub nagrywania wielokanałowego, a także promptingu słów kluczowych, by radzić sobie z szumem, nakładającymi się mówcami i specjalistycznym słownictwem.
- Mierz dokładność za pomocą współczynnika błędów słów (WER) i sprawdzaj, które błędy mają największe znaczenie w twoim zastosowaniu.
Co powoduje problemy z dokładnością zamiany mowy na tekst?
Wyobraź sobie, że ktoś prosi cię o transkrypcję nagrania profesora z silnym akcentem, który opisuje złożoną fizykę teoretyczną w zatłoczonej restauracji z muzyką i rozmowami w tle. Cyfrowe systemy komputerowe nie są z natury dostrojone do zmienności akustycznej. Aby STT działało skutecznie, potrzeba znacznego treningu i dostrajania. Choć nowoczesne narzędzia AI są bardzo skuteczne, na wynik nadal może wpływać wiele problemów. Gdy je zrozumiesz, możesz uwzględnić je w swoich workflow transkrypcji.
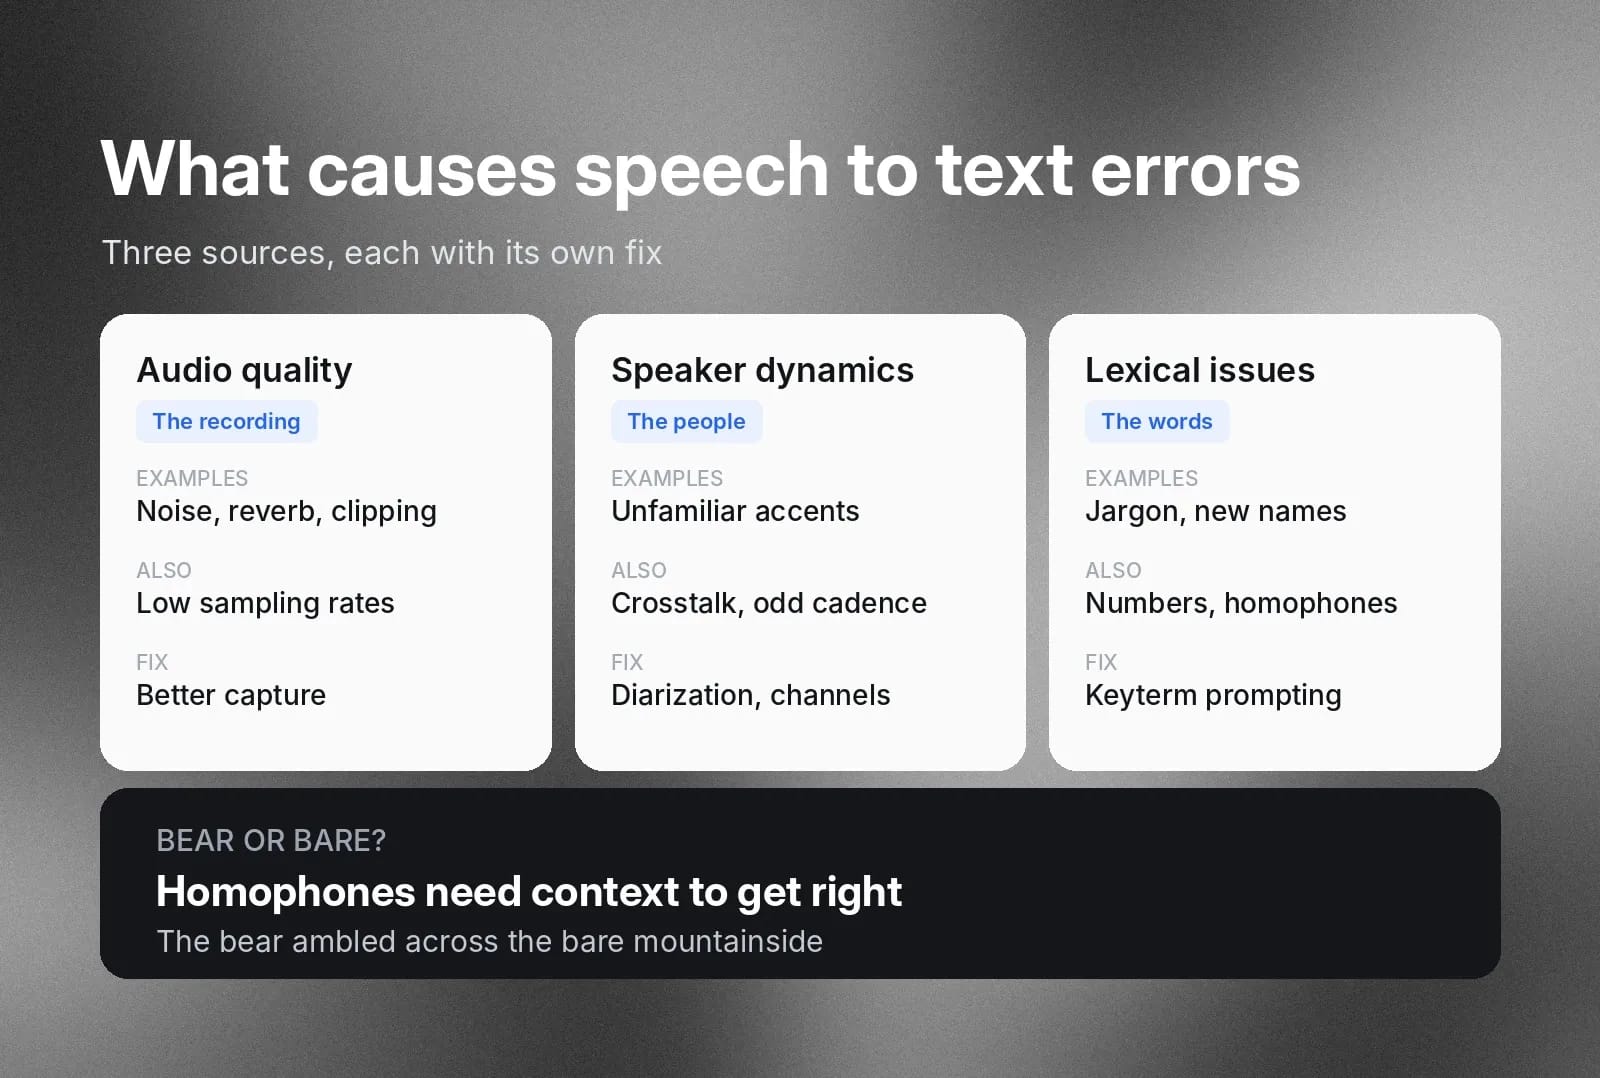
Niedokładną zamianę mowy na tekst powodują trzy główne czynniki:
- Problemy z jakością wejściowego audio
- Dynamika mówców
- Kwestie leksykalne i kontekstowe
Każda z tych przyczyn wymaga innego rozwiązania, omówionego w kolejnych sekcjach.
Problemy z jakością audio
Problemy może mieć samo nagranie audio. Usterki mikrofonu mogą powodować zniekształcenia lub obcinanie mowy. Pogłos wynikający z akustyki miejsca, niski stosunek sygnału do szumu (SNR) albo niska częstotliwość próbkowania mogą usuwać z nagrania ważne informacje fonetyczne.
Dynamika mówców
Pojedynczy mówca z neutralnym akcentem, mówiący w cichym miejscu, będzie stosunkowo łatwy do transkrypcji. Rzadko jednak chcemy transkrybować właśnie takie nagrania. Nieznane akcenty oraz urywane lub niestandardowe tempo mowy mogą zmylić model STT wytrenowany na ustandaryzowanej mowie. Przesłuchy i nakładający się mówcy również utrudniają modelowi dokładne rozpoznanie wypowiedzi.
Kwestie leksykalne i kontekstowe
Treść wypowiedzi też może być wyzwaniem dla niektórych modeli STT. Branżowy żargon i nazwy nowych produktów mogą nie występować w danych treningowych modelu. Ponieważ wybiera on wynik najbardziej prawdopodobny statystycznie, nieznana mowa może nie być główną przewidywaną opcją. Wyrażenia liczbowe i matematyczne, a także wypowiedzi zwykle zapisywane cyframi, również mogą nie zostać jasno przepisane.
Homofony to słowa, które brzmią tak samo, lecz zapisuje się je inaczej. Model STT potrzebuje wystarczającego zrozumienia kontekstu, aby je odróżnić. Na przykład angielskie „the bear ambled across the bare mountainside”. Model musi wiedzieć, że zwierzę zapisuje się „bear”, a przymiotnik określający niepokrytą powierzchnię — „bare”.
Jak rozwiązać problemy z dokładnością zamiany mowy na tekst — od audio po wynik
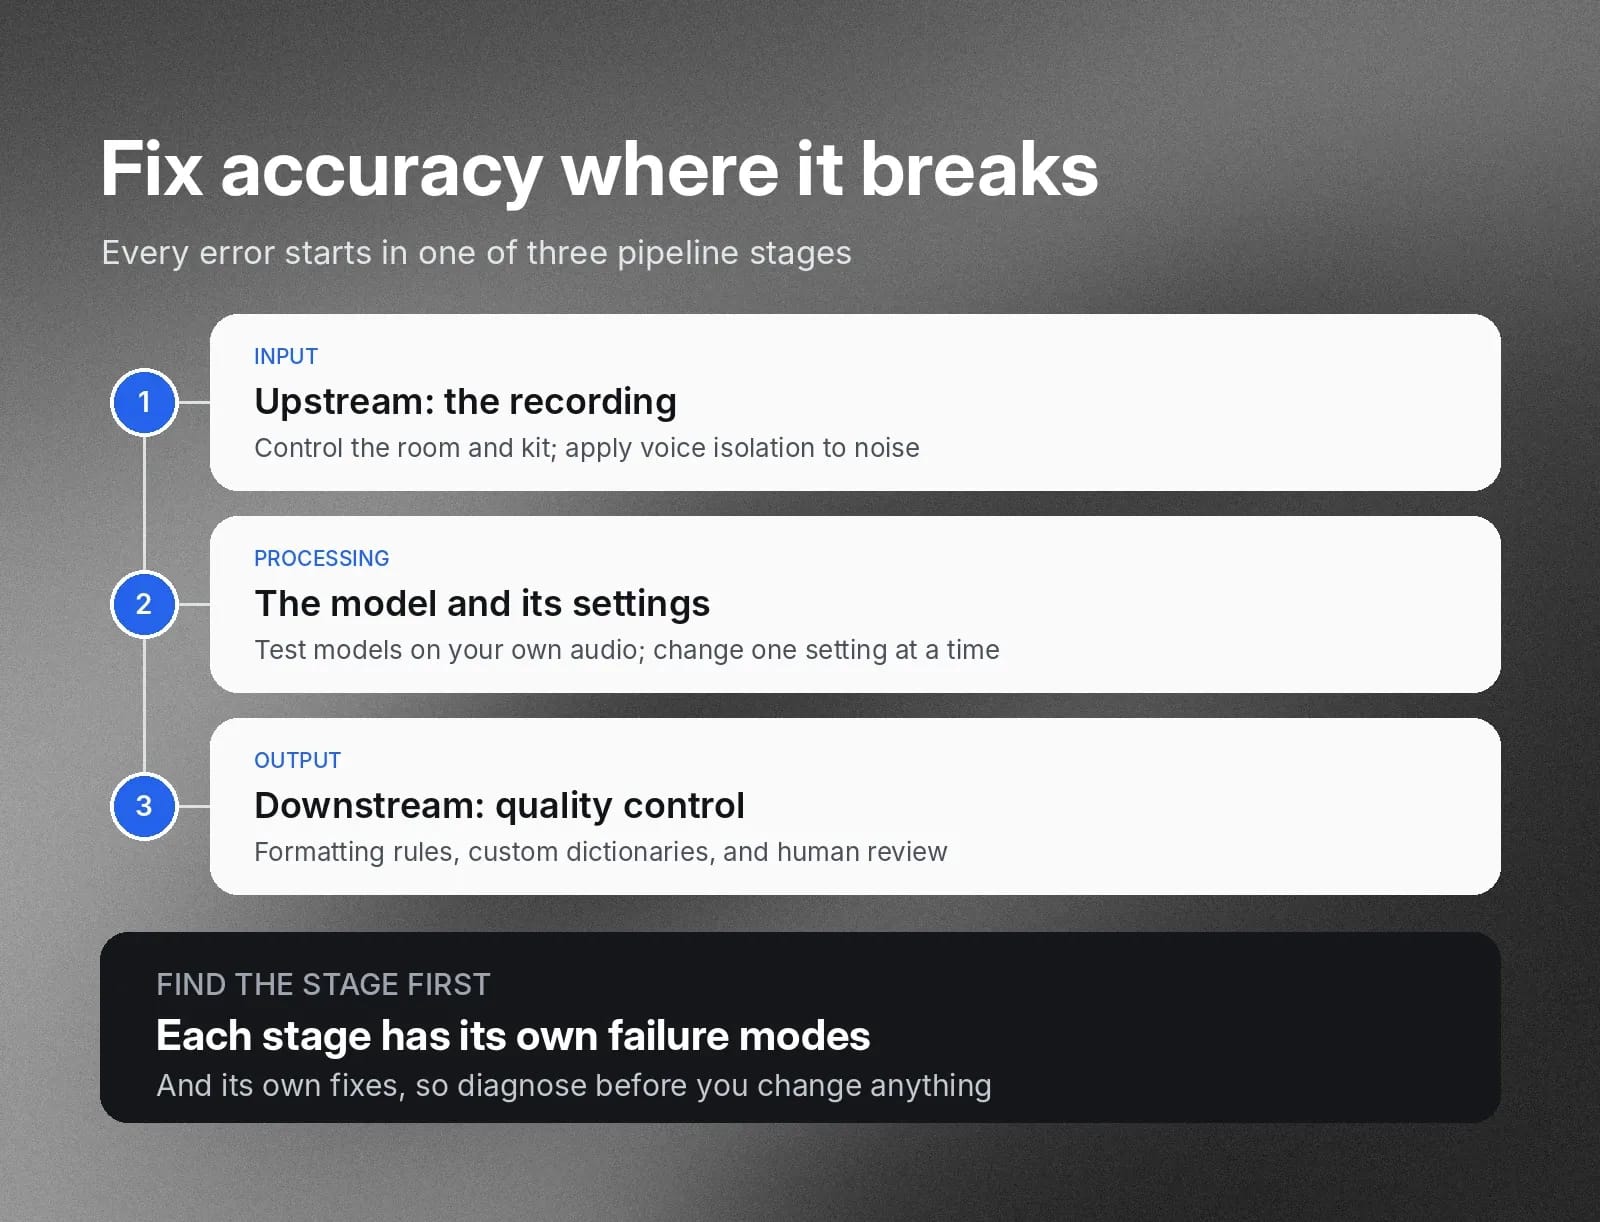
Przetwarzanie zamiany mowy na tekst przebiega w serii jasno określonych etapów. Aby rozwiązać problem z dokładnością, musisz ustalić, gdzie w tym pipeline’ie możesz wprowadzić zmianę. Ogólnie proces STT dzieli się na:
- Wejście
- Przetwarzanie
- Wyjście
Każdy etap ma własne tryby awarii i sposoby ich rozwiązania.
Problemy z dokładnością na wejściu
Problemy może powodować środowisko, w którym nagrywasz. Często chodzi o hałas w tle lub echo. Źródłem problemu może też być wadliwy sprzęt nagrywający.
Rozwiązywanie problemów na tym etapie zwykle polega na ustaleniu ich przyczyny i jej usunięciu. Jeśli na przykład wiesz, że narzędzie STT ma problem z głośnym tłem, warto prowadzić rozmowy w środowisku, nad którym masz większą kontrolę.
W przypadku szumu, którego nie możesz uniknąć, zastosuj Voice Isolator, zanim audio trafi do modelu.
Problemy z dokładnością podczas przetwarzania
Sposób konfiguracji API dla silnika STT może wpływać na przetwarzanie. Na jakość i liczbę błędów wpływa też struktura promptu oraz wybrany model.
Rozwiązywanie problemów na tym etapie oznacza testowanie konfiguracji na własnym audio. Przepuść te same przykładowe nagrania przez każdy rozważany model, porównaj ich współczynniki błędów słów, a następnie zmieniaj po jednym ustawieniu, aby dopracować wynik.
Jeśli model stale nie rozpoznaje jednego rodzaju mowy, na przykład zaszumionej rozmowy lub konkretnego regionalnego akcentu, przetestuj dokładność różnych modeli dokładnie w środowisku, w którym będą używane.
Problemy z dokładnością na wyjściu
To warstwa kontroli jakości, w której wyspecjalizowane procesy usuwają błędy i niejednoznaczności transkrypcji pominięte przez główny silnik. Pipeline’y STT regularnie używają dopasowywania wzorców opartego na regułach, aby ujednolicić formatowanie, np. zmienić „dziesięć dolarów” na „$10.00”. Proces ten nazywa się odwrotną normalizacją tekstu (ITN). Jeśli jednak mówca użyje takiego wyrażenia nietypowo lub je źle wymówi, sztywne narzędzie wyszukaj i zamień tego nie wychwyci.
Ważne jest też, czy człowiek w pętli (HITL) sprawdza jakość wyniku. Jeśli nie, błędy mogą trafić do środowiska produkcyjnego. Jak przy każdej czynności wykonywanej przez człowieka, istnieje ryzyko błędu ludzkiego.
Na tym etapie naprawa polega na wyłapywaniu błędów pozostawionych przez główne silniki. Możesz porównać transkrypcje z próbką referencyjną, aby znaleźć powtarzające się pomyłki, a następnie dodać ukierunkowane reguły lub własny słownik dla tych terminów. Zwłaszcza przy transkrypcjach wysokiego ryzyka zawsze dodawaj etap weryfikacji przez człowieka.
Jak poprawić dokładność rozpoznawania mowy dzięki lepszemu audio
Poprawa jakości audio podczas nagrywania może ograniczyć wiele późniejszych problemów z dokładnością. Używaj wyższej częstotliwości próbkowania, stosuj minimalną kompresję lub nie stosuj jej wcale i dbaj o możliwie czyste środowisko nagrywania.
Jakość próbkowania
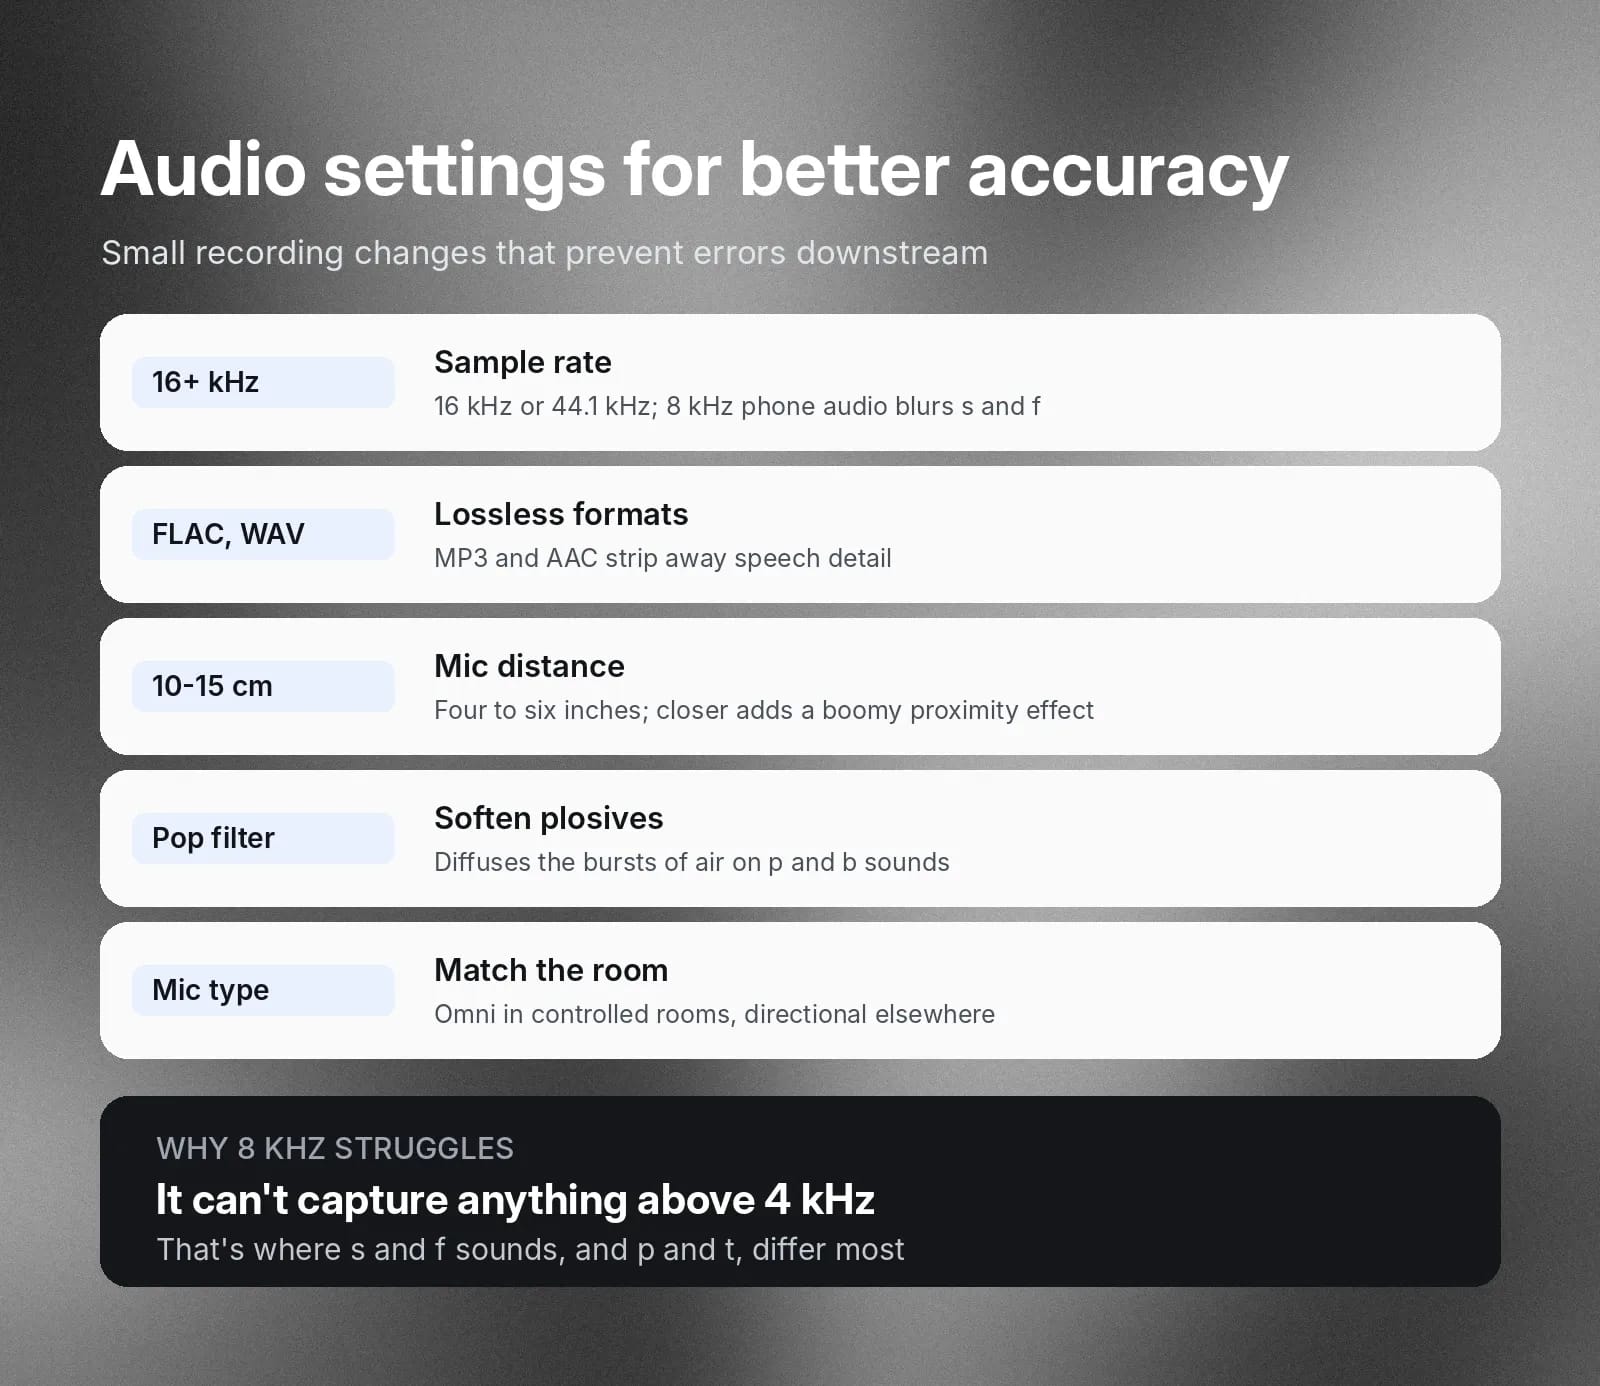
Do nagrywania używaj audio 16 kHz lub 44,1 kHz. Próbkowanie starszej jakości telefonicznej 8 kHz i niższe może być trudne do rozpoznania przez modele STT. Dla modeli brzmi ono stłumienie i niewyraźnie, a nie mogą one poprosić mówcy o powtórzenie, jak człowiek podczas rozmowy.
Częstotliwość próbkowania może odtworzyć tylko częstotliwości do połowy swojej wartości. Nazywa się to częstotliwością Nyquista systemu. Przy zaledwie 8 kHz odcięte zostanie wszystko powyżej 4 kHz, co szczególnie utrudni modelowi STT odróżnienie spółgłosek szczelinowych (dźwięków „s” i „f”) od zwartych (dźwięków „p” i „t”).
Kompresja
Nagrywanie w formatach stratnych, takich jak MP3 i AAC, również może usuwać subtelności mowy. Model ma wtedy mniej sygnału do analizy. Wybieraj formaty bezstratne lub nieskompresowane, takie jak FLAC czy PCM WAV.
Środowisko nagrywania
Stosuj dobre praktyki inżynierii dźwięku przy używaniu mikrofonów. Mikrofony dookólne najlepiej działają w kontrolowanych warunkach. W innych sytuacjach mikrofony kierunkowe lepiej izolują mowę. Umieść mikrofon 10–15 cm od ust mówcy i staraj się, by mówcy nie pochylali się bliżej — wywoła to efekt zbliżeniowy i zamuli nagranie podbitymi niskimi częstotliwościami.
Gdy to możliwe, używaj też filtra pop na mikrofonie. Filtry pop rozpraszają podmuchy powietrza powstające przy wymawianiu spółgłosek zwartych, np. dźwięków „p” i „b”.
Ogranicz hałas w tle, aby poprawić rozpoznawanie mowy
Jak wspomniano wcześniej, nagrywaj z mikrofonem blisko mówcy, najlepiej 10–15 cm od jego ust. Unikaj szumu białego i hałasu w tle, które zamulają nagrania. Bez doświadczenia w nagraniach terenowych możesz nie zauważyć takich źródeł jak buczenie systemów HVAC, klikanie klawiatury czy zwykły hałas uliczny. Każde z nich może utrudnić modelowi STT rozpoznanie mowy.
Często jednak nie da się uniknąć hałasu w tle. Wtedy przed wysłaniem audio do modelu STT zastosuj Voice Isolator jako etap wstępnego przetwarzania. Voice Isolator używa algorytmów lub lekkiego, wyspecjalizowanego modelu neuronowego, aby odfiltrować dźwięki tła z nagrań mowy.
Radzenie sobie z akcentami, nakładającymi się mówcami i specjalistycznym słownictwem
Nowoczesne modele wielojęzyczne są trenowane na różnorodnych zbiorach mowy, ale ich dokładność nadal różni się w przypadku rzeczywistego audio. Przeprowadź własne benchmarki różnych modeli, używając przykładowego audio od odpowiednich grup demograficznych. Jeśli masz archiwalne rozmowy z obsługą klienta, przepuść przez transkrypcję te z akcentami, tempem i wzorcami mowy, które chcesz rozpoznawać w praktyce.
Sprawdź wyniki pod kątem błędów i znajdź istotne wzorce. Czy model ma problem ze slangiem używanym przez młodsze grupy? Czy potyka się na konkretnym regionalnym akcencie, z którym często się spotykasz?
Obsługa nakładających się mówców
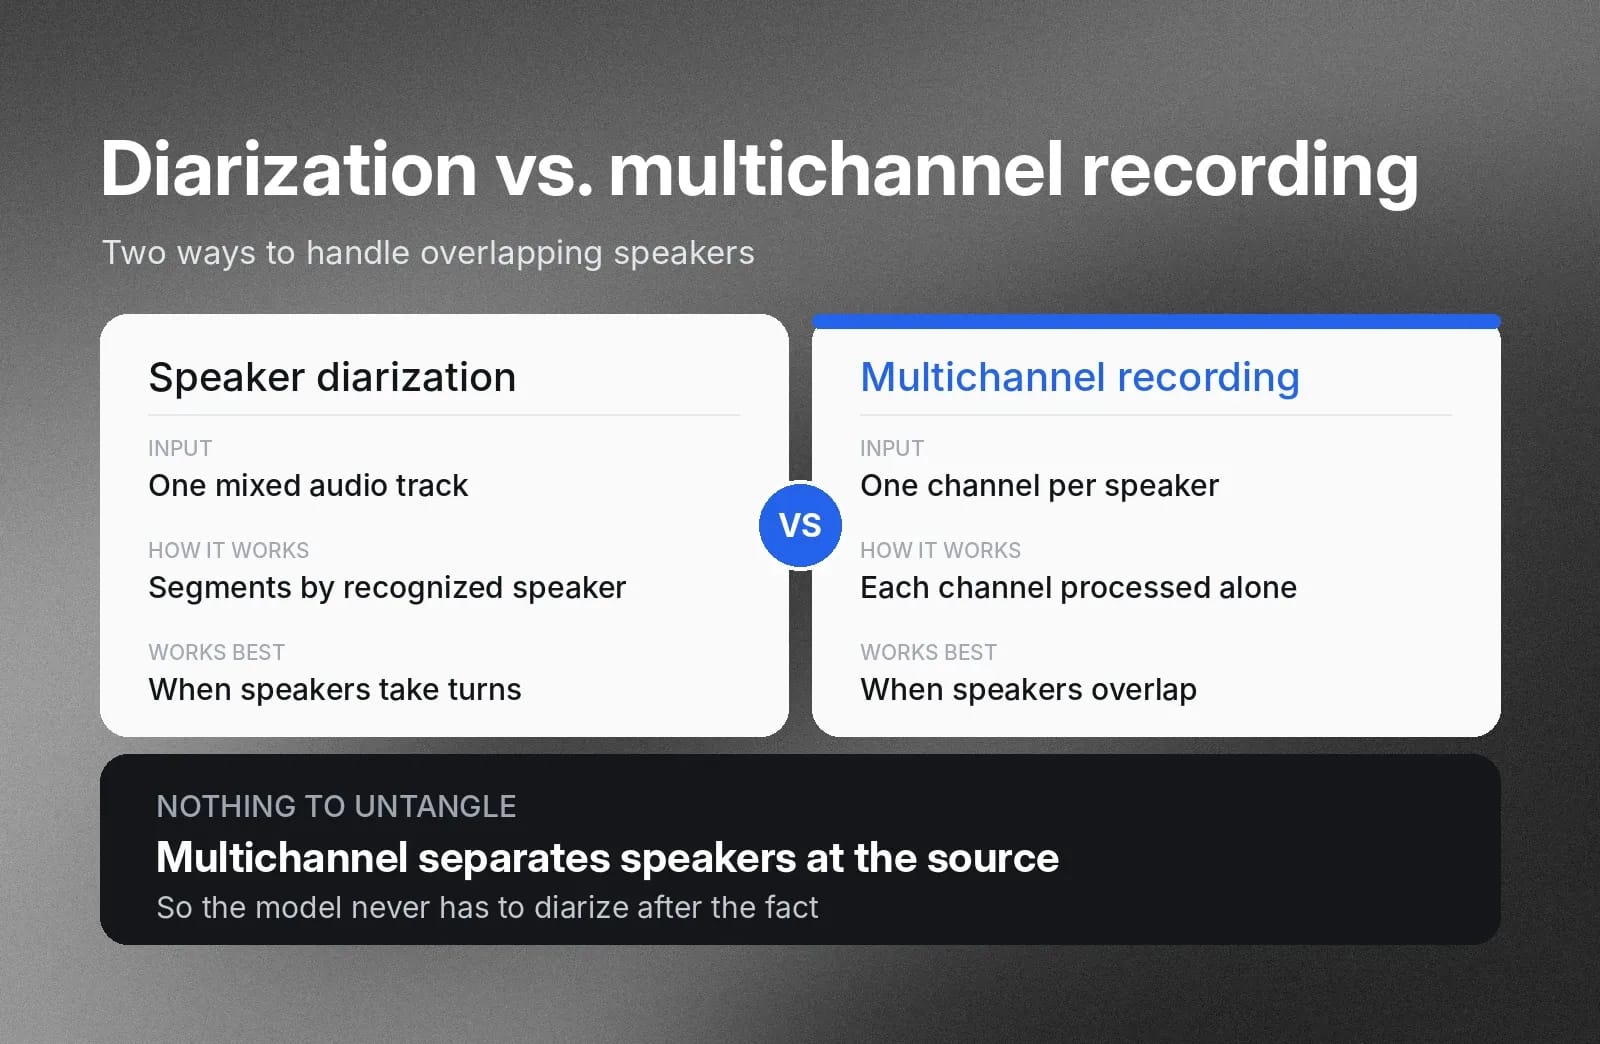
Dwa główne narzędzia do dokładnej transkrypcji nakładającej się mowy to diarizacja i nagrywanie wielokanałowe. Diarizacja pobiera surowe audio i dzieli je według indywidualnie rozpoznanych mówców. Działa dobrze, gdy mówcy wyraźnie zabierają głos na zmianę.
Zamiast łączyć wszystkie strumienie głosu w jedną ścieżkę audio, natywne nagrywanie wielokanałowe pozwala zachować każdego mówcę na osobnym kanale, który model STT może rozpoznać i przetworzyć niezależnie. Każdy mówca jest natywnie rozdzielony w nagraniu, więc model mowy nie musi niczego diarizować po fakcie.
Prompting słów kluczowych tworzy pozytywne uprzedzenie
Nazwy marek, nowe nazwy produktów, branżowy żargon i inne unikalne terminy często nie zostaną dokładnie przepisane, jeśli nie było ich w danych treningowych modelu STT. Prompting słów kluczowych polega na podaniu modelowi STT konkretnych pisowni, które ma preferować. Zwykle nie są to prompty do zastępowania jeden do jednego — po prostu skłaniasz model, by zależnie od kontekstu wybierał wskazaną pisownię.
Dokładna transkrypcja liczb, identyfikatorów i nazw leków
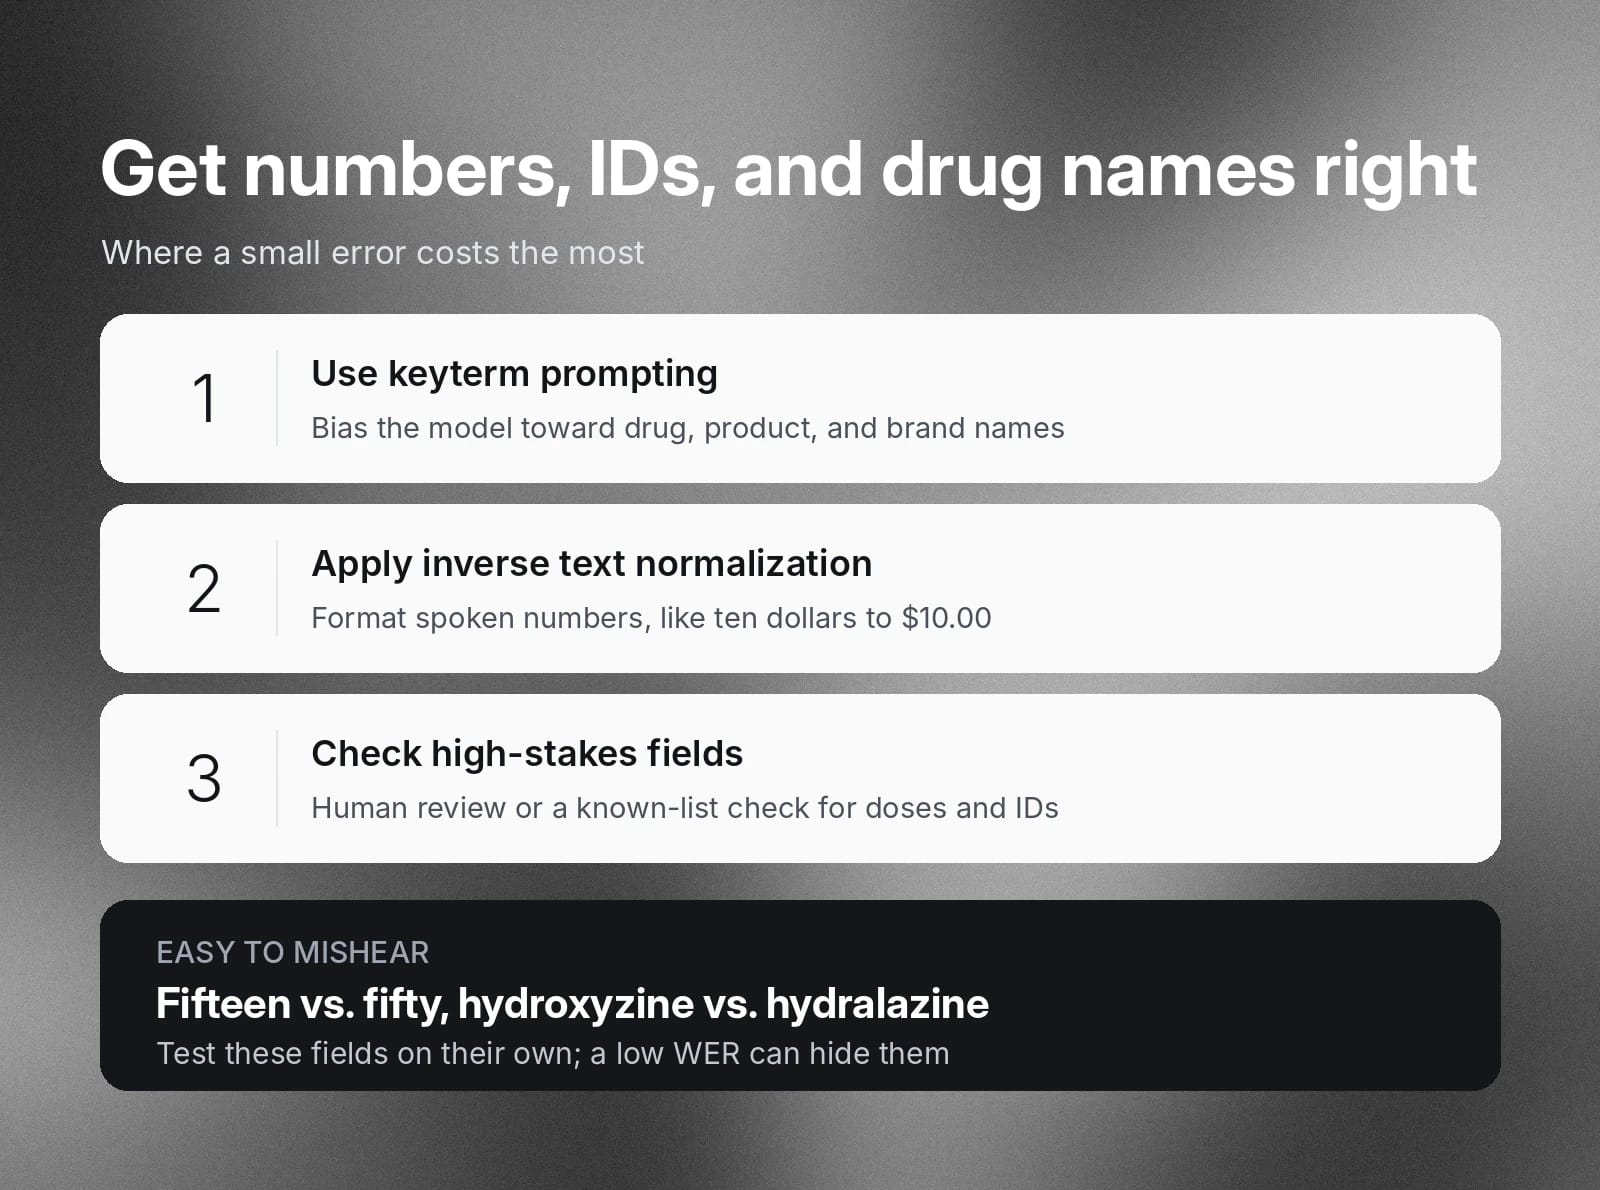
Przy liczbach, identyfikatorach kont, kodach pocztowych i nazwach leków niewielki błąd kosztuje najwięcej. Model może usłyszeć „fifteen” jako „fifty” albo pomylić dwie nazwy leków różniące się jedną sylabą, takie jak hydroksyzyna i hydralazyna.
Pomagają trzy kroki:
- Używaj promptingu słów kluczowych: Skłoń model do preferowania pisowni nazw leków, produktów i innych oczekiwanych terminów.
- Stosuj odwrotną normalizację tekstu (ITN): Konsekwentnie formatuj wypowiadane liczby, na przykład zmieniając „dziesięć dolarów” na „$10.00”.
- Dodaj kontrolę pól wysokiego ryzyka: W przypadku pól takich jak dawki leków i numery kont korzystaj z weryfikacji przez człowieka lub automatycznego sprawdzenia względem znanej listy.
Testuj te pola osobno, ponieważ niski ogólny WER może ukrywać błędy właśnie w słowach, które mają największe znaczenie.
Mierz jakość za pomocą współczynnika błędów słów w rozpoznawaniu mowy
Współczynnik błędów słów (WER) to przydatna metryka do oceny dokładności silnika STT. Możesz porównywać WER w różnych testach modeli, aby poznać ich względną dokładność.
WER oblicza się tak:
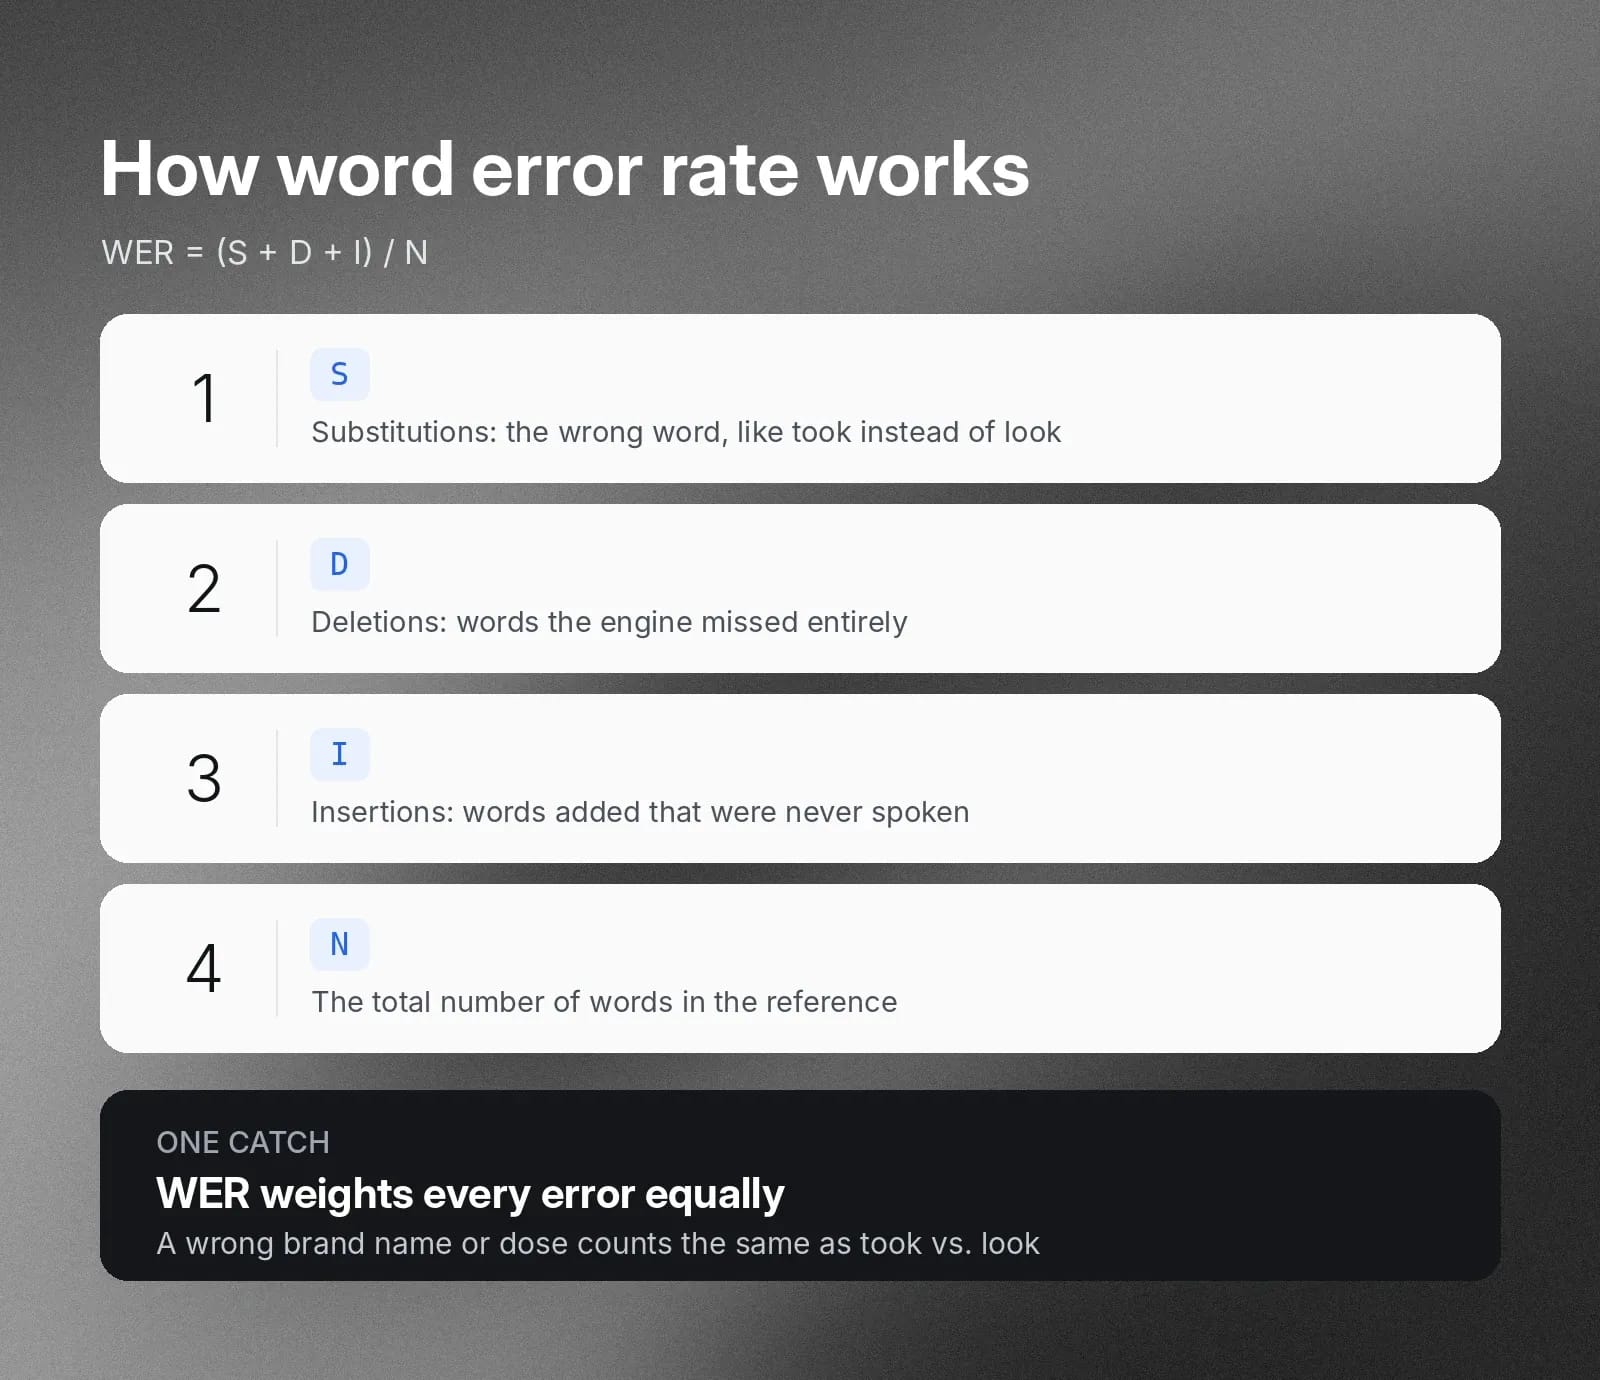
WER = (S + D + I) / N
- Zastąpienia (S): liczba przypadków, gdy silnik STT podał w transkrypcji niewłaściwe słowo, np. „took” zamiast „look”.
- Usunięcia (D): liczba słów całkowicie pominiętych przez model.
- Wstawienia (I): liczba słów dodanych przez model, choć nigdy nie zostały wypowiedziane.
- Łączna liczba słów referencyjnych (N): całkowita liczba słów w przykładowym wejściu mowy.
Warto pamiętać, że WER traktuje wszystkie błędy jednakowo. Na przykład zastąpienie „look” słowem „took” liczy się tak samo jak nierozpoznanie nazwy marki lub ważnej liczby, takiej jak wielkość dawki leku. Sprawdzaj WER dla różnych modeli.
Jaki współczynnik błędów słów jest dobry?
Nie ma jednej dobrej wartości WER, ponieważ właściwy cel zależy od twojego audio i zastosowania. Czyste audio z jednym mówcą daje znacznie niższy poziom błędów niż zaszumione rozmowy z nakładającymi się mówcami. Porównuj modele na własnych nagraniach, zamiast polegać na nagłówkowej liczbie.
Jako punkt odniesienia dla specjalistycznego audio, Scribe v2 Medical należy do najlepszych modeli w publicznych benchmarkach medycznego ASR. Sprawdzaj aktualne wyniki benchmarków, aby poznać najnowsze dane.
Wyniki benchmarków zmieniają się wraz z premierami nowych modeli. Przed porównaniem sprawdź aktualne wyniki.
Dokładność a precyzja: co powinny mierzyć zespoły transkrypcji
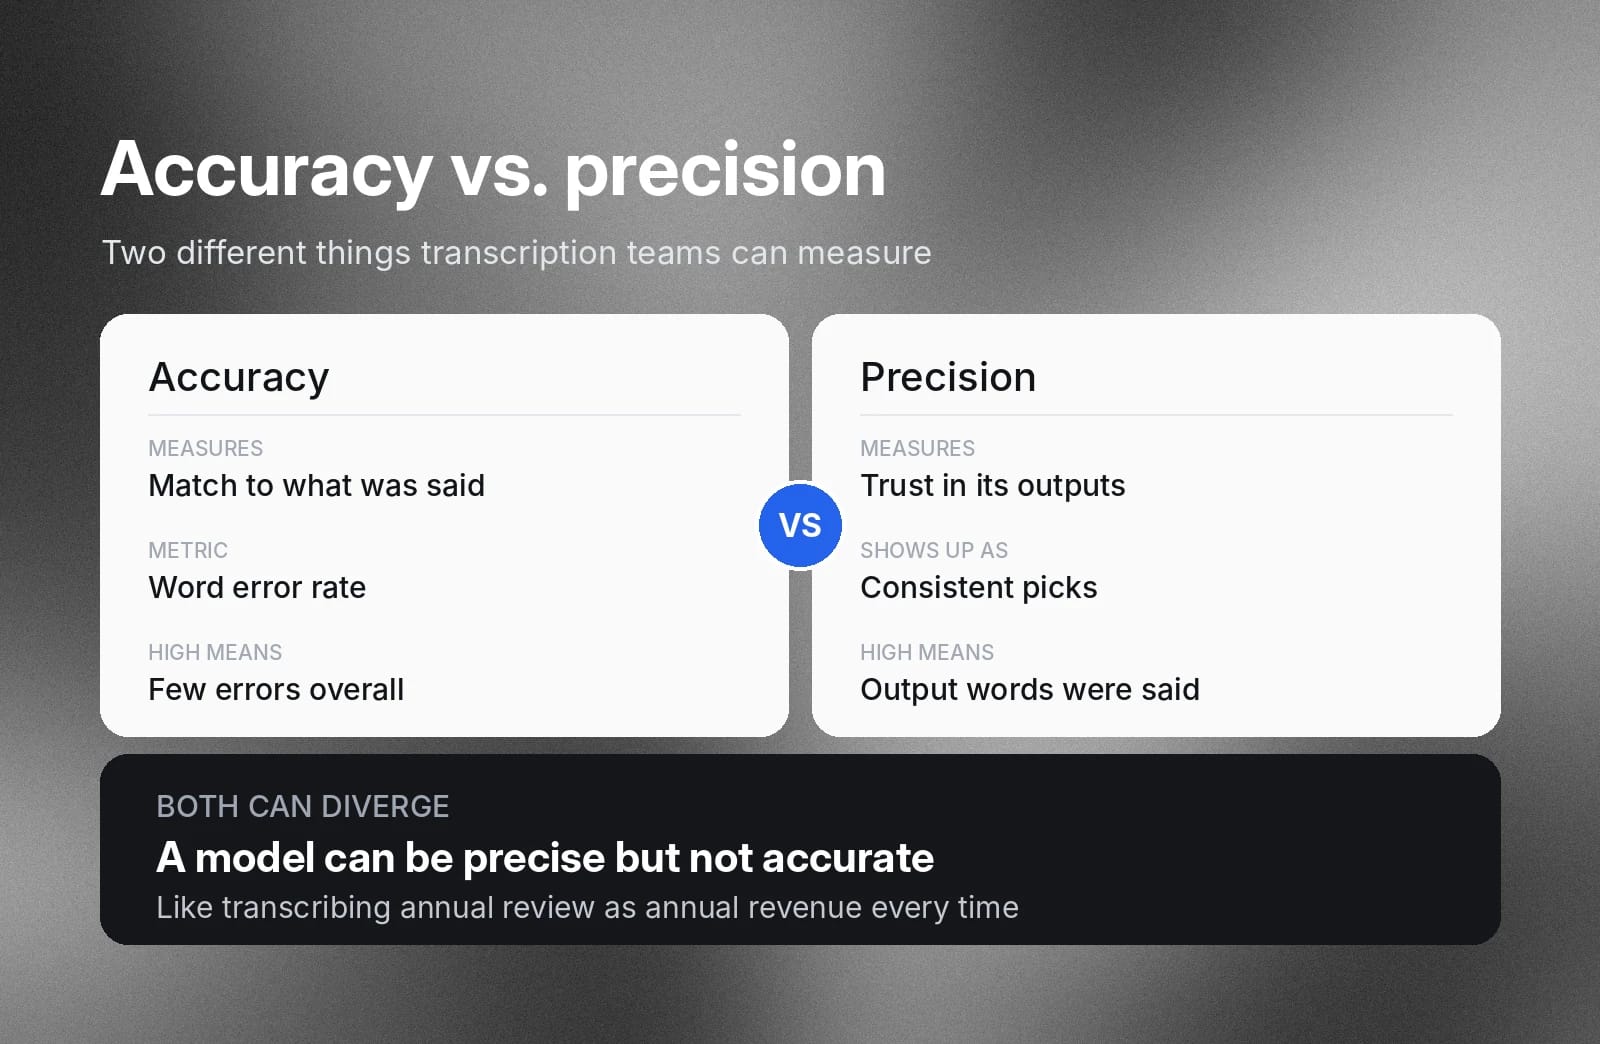
Dokładność określa, jak bardzo wynik transkrypcji odpowiada wypowiedzianej „prawdzie referencyjnej”. Współczynnik błędów słów mierzy dokładność.
Precyzja określa, na ile wiarygodne są pozytywne predykcje modelu STT. Bardzo precyzyjny model wybierze to samo słowo dla złożonej mowy w wielu uruchomieniach. Jeśli model poda słowo, możesz ufać, że wystąpiło ono w wypowiedzi. Jednak bardzo precyzyjny model nadal może mieć niską dokładność, czyli usuwać wiele słów.
Zacznij z ElevenAPI, aby uzyskać dokładniejszą transkrypcję
ElevenAPI daje ci dostęp do Scribe v2, modelu ElevenLabs do zamiany mowy na tekst, oraz funkcji rozwiązujących problemy z dokładnością opisane w tym przewodniku: promptingu słów kluczowych dla nazw i żargonu, transkrypcji wielokanałowej dla nakładających się mówców oraz diaryzacji mówców.
Jeśli chcesz transkrybować bez używania API, możesz też skorzystać z ElevenCreateive STT.
Zacznij już dziś tworzyć wysokiej jakości zamianę mowy na tekst z ElevenAPI albo dowiedz się więcej o możliwościach zamiany mowy na tekst w ElevenAPI.
Najczęściej zadawane pytania o dokładność zamiany mowy na tekst

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.


