Scribe v2 Medical jest już dostępny dla wszystkich
- Autor
- Min Kim
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Nagrania kliniczne to jedno z najtrudniejszych wyzwań dla dokładnego rozpoznawania mowy. Nazwy leków są długie, rzadkie i łatwo je pomylić (hydroksyzyna i hydralazyna różnią się jedną źle usłyszaną sylabą). Słownictwo jest specjalistyczne, a dawki, jednostki oraz terminy z anatomii i patologii mogą padać szybko, jeden po drugim. Stawka jest też wyższa, bo błąd w transkrypcji może trafić do dokumentacji pacjenta.
Dlatego ElevenLabs udostępnia dziś Scribe v2 Medical, nasz model Speech to Text dostrojony do nagrań klinicznych, który jest teraz ogólnie dostępny w ElevenAPI. We wszystkich przedstawionych poniżej testach konsekwentnie osiąga jeden z najniższych współczynników błędów słów (WER) spośród porównywanych modeli i obniża WER dla nagrań klinicznych o około 35% względem naszego podstawowego modelu Scribe v2.
Modele ogólnego przeznaczenia świetnie radzą sobie z codzienną mową, ale mogą tracić jakość tam, gdzie workflow kliniczne potrzebują ich najbardziej. Wytrenowaliśmy medyczną wersję Scribe v2, skupioną na nazwach leków i dyktowaniu klinicznym, na publicznych benchmarkach, które każdy może odtworzyć.
Scribe v2 Medical jest zoptymalizowany pod zastosowania kliniczne
Dyktowanie kliniczne (MedDictate)
MedDictate firmy Corti testuje transkrypcję dyktowanych notatek klinicznych, zawierających następujące po sobie nazwy leków, dawki i jednostki w języku angielskim, francuskim i niemieckim. W naszej ocenie Scribe v2 Medical uzyskał najniższy łączny WER spośród testowanych modeli oraz WER o około 35% niższy niż podstawowy Scribe v2.
Model | EN | FR | DE | Łączny WER |
Scribe v2 Medical | 3.0% | 8.3% | 7.2% | 4.9% |
OpenAI GPT Transcribe | 3.9% | 7.8% | 9.6% | 5.9% |
Scribe v2 (podstawowy) | 5.0% | 10.7% | 11.7% | 7.6% |
Muse Voice Transcribe 1.0 | 4.5% | 11.0% | 13.3% | 7.8% |
Deepgram Nova-3 Medical* | 5.5% | - | - | - |
*Tylko angielski (24 nagrania) — Deepgram Nova-3 Medical nie obsługuje języka francuskiego ani niemieckiego.
Terminologia medyczna (MedTerm)
MedTerm to również zbiór danych opublikowany przez Corti. Obejmuje benchmark terminologii klinicznej z 600 próbkami w tych samych trzech językach, z oznaczonymi terminami medycznymi w każdej próbce. Oznaczenia pozwalają oceniać modele w dwóch wymiarach poza WER dla całej transkrypcji. Recall terminów to odsetek oznaczonych terminów medycznych, które poprawnie pojawiają się w transkrypcji (więcej znaczy lepiej). Term-WER to współczynnik błędów wyłącznie dla tych terminów, bez uwzględniania zwykłej mowy wokół nich (mniej znaczy lepiej).
Scribe v2 Medical przewodzi wszystkim testowanym modelom w obu wymiarach i wyprzedza każdego innego dostawcę we wszystkich trzech językach:
Model | Recall terminów ↑ | Term-WER ↓ |
Scribe v2 Medical | 77.7% | 10.4% |
Scribe v2 (podstawowy) | 77.1% | 10.7% |
OpenAI GPT Transcribe | 74.0% | 12.3% |
Muse Voice Transcribe 1.0 | 73.4% | 12.9% |
Deepgram Nova-3 Medical* | 72.5% | 13.6% |
Benchmark Eka Medical ASR
Benchmark Eka Medical ASR zawiera 3619 angielskich próbek nagrań klinicznych — od pojedynczych nazw leków i schorzeń, przez zdania kliniczne, po rozmowy lekarzy z pacjentami — z oznaczeniami dla każdego terminu i opublikowanym rankingiem na karcie zbioru danych.
Ponieważ opublikowany zbiór danych obejmuje starsze modele, takie jak Gemini 2.5 Flash i GPT-4o, przeprowadziliśmy ocenę z nowszymi modelami. SemWER (semantyczny WER) sprawdza, czy model usłyszał właściwą treść, niezależnie od formatu („mg” i „miligramy” są liczone jako ta sama odpowiedź), a kwWER (WER słów kluczowych) stosuje tę samą ocenę tylko do oznaczonych medycznych słów kluczowych.
Model | semWER | kwWER |
Scribe v2 Medical | 6.50% | 6.02% |
Scribe v2 (podstawowy) | 7.35% | 7.04% |
Deepgram Nova-3 Medical | 7.79% | 7.65% |
Muse Voice Transcribe 1.0 | 8.85% | 8.99% |
OpenAI GPT Transcribe | 13.90% | 13.20% |
Eka oznacza terminy medyczne w każdej próbce, co pozwala dokładniej ocenić przewagę Scribe v2 Medical nad wersją podstawową wyłącznie dla terminów medycznych. Scribe v2 Medical popełnia o 15% mniej błędów niż wersja podstawowa (9,5% vs. 11,1%), a największą poprawę widać, gdy terminy występują w pełnych zdaniach klinicznych (7,5% vs. 9,9%).
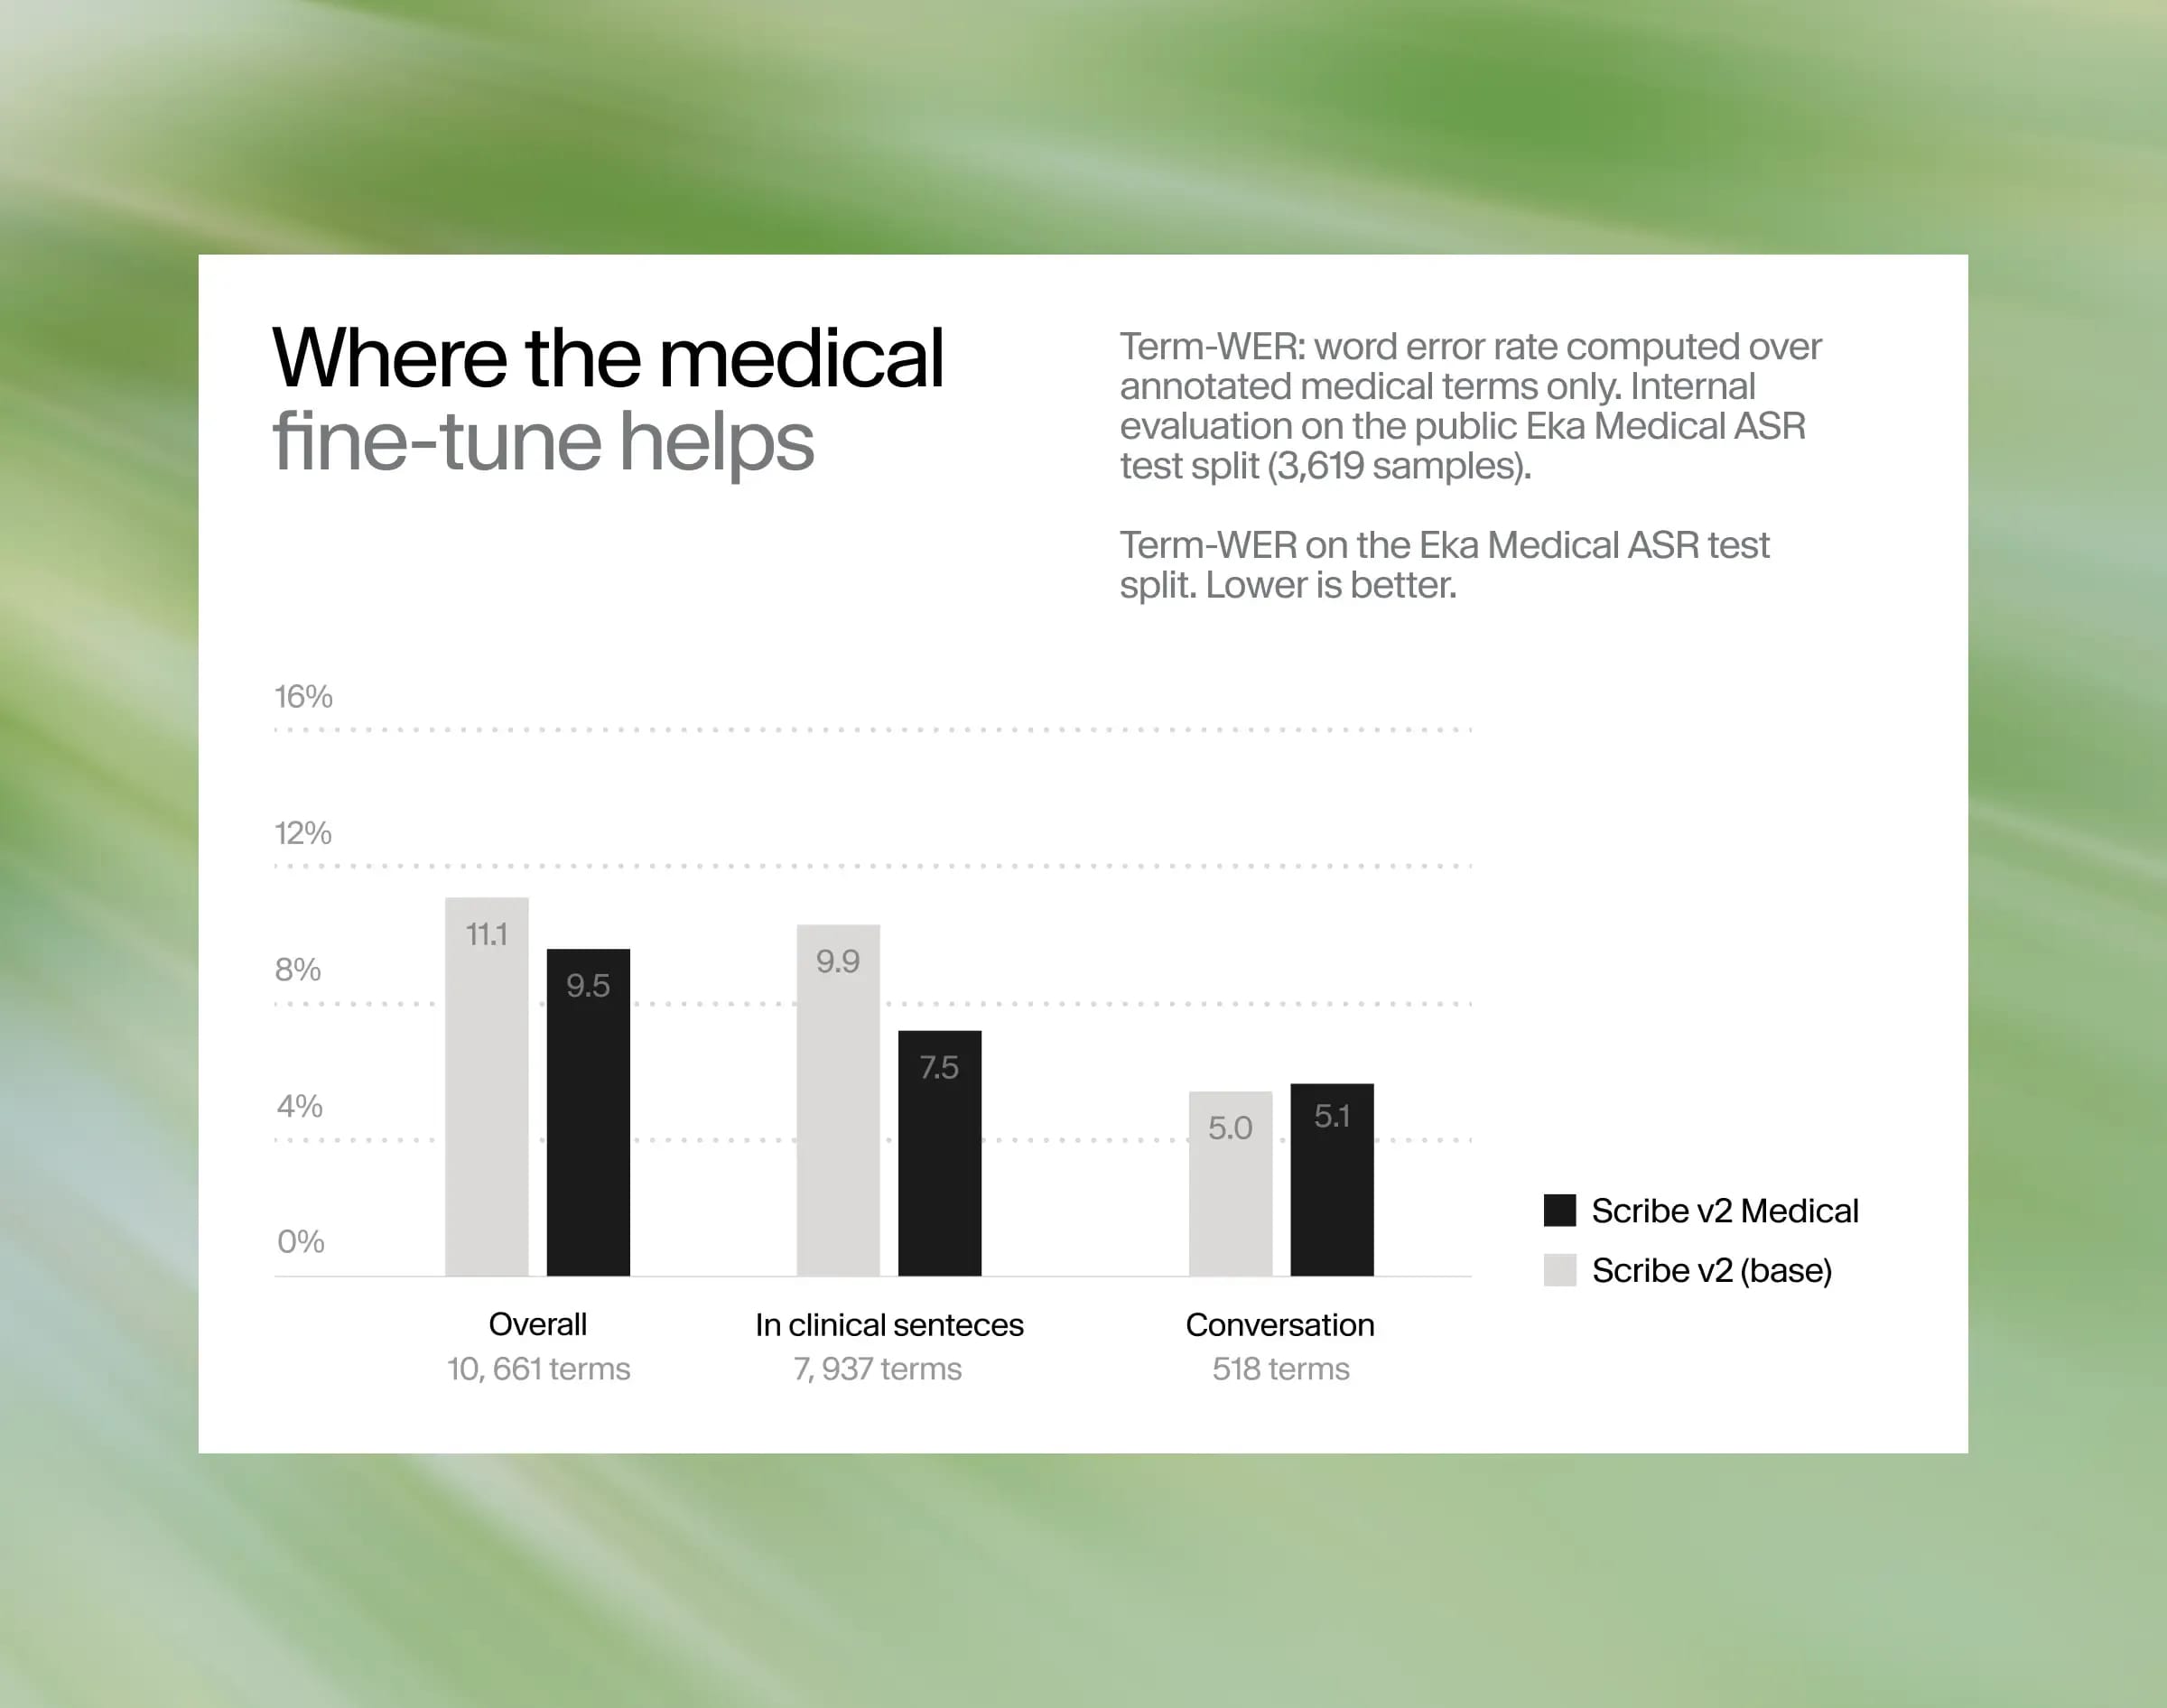
Te same dane pokazują jednak, że pojedyncze nagrania jednowyrazowe (samodzielnie wypowiedziana nazwa leku, bez kontekstu) pozostają najtrudniejszym przypadkiem dla każdego modelu w rankingu, w tym Scribe v2 Medical. Model uzyskał 14,3% WER dla pojedynczych terminów, wobec 7,5%, gdy pojawiają się one w zdaniach. Bez żadnego kontekstu źle usłyszana sylaba może prowadzić do pamiętnych błędów:
- etodolak (NLPZ) → „It'll do the luck”
- lewomilnacipran (lek przeciwdepresyjny) → „Leave me alone now, Sephora.”
- metdylazyna (lek przeciwhistaminowy) → „Let's play our scene.”
Jednym ze sposobów na ograniczenie tych błędów jest promptowanie kluczowych terminów, które pozwala wyróżnić nazwy leków lub zwroty medyczne, aby zwiększyć szanse modelu na ich poprawną transkrypcję.
Klienci korzystający z modelu w produkcji
Klienci już korzystają z Scribe v2 Medical w środowisku produkcyjnym i widzą poprawę w nagraniach klinicznych.
„Od czasu przejścia z Deepgram na ElevenLabs Scribe v2 Medical widzimy znacznie wyższą dokładność w terminologii klinicznej, co zmieniło sposób pracy zespołu” — mówi Mendel Erlenwein, CEO i założyciel CareCo. „Gdy nasi koordynatorzy ufają transkrypcjom, mogą poświęcać mniej czasu na poprawianie notatek, a więcej na rozmowy telefoniczne z pacjentami. Nasi pacjenci stosują złożone terapie, więc notatka czytana przez zespół opieki musi być poprawna.”
Wysoka skuteczność w ogólnej mowie
Zespół sprawdził też, że dostrojenie medyczne nie pogarsza wyników w innych obszarach. W 6000 próbek codziennej, niemedycznej mowy pochodzących z Common Voice Scribe v2 Medical po zaokrągleniu uzyskuje taki sam wynik jak podstawowy Scribe v2: w obu przypadkach WER wynosi 5,3%. Dzięki v2 Medical zyskujesz więc zalety wyspecjalizowanego modelu medycznego bez utraty dokładności w tym benchmarku.
Zaprojektowany do obsługi chronionych informacji zdrowotnych
Scribe v2 Medical kwalifikuje się do zgodności z HIPAA dla klientów Enterprise z zawartą umową Business Associate Agreement i włączonym Zero Retention Mode (ZRM).
Gdy ZRM jest włączony dla żądań Speech to Text API, dane wejściowe audio i tekst wyjściowy są usuwane natychmiast po zakończeniu każdego żądania. ElevenLabs nie przechowuje żadnych z nich, a twoja aplikacja otrzymuje pełną odpowiedź API i kontroluje sposób przechowywania transkrypcji.
Pierwsze kroki
Scribe v2 Medical jest dostępny w Speech to Text API. Wystarczy przekazać nowy identyfikator modelu: scribe_v2_medical
Model działa w zbiorczym endpointzie Speech to Text.