
Speech to text dla twórców treści: przewodnik po napisach i ponownym wykorzystaniu treści
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Dokładne narzędzie speech to text to niezbędny element zestawu narzędzi każdego twórcy treści. Dzięki wspieranemu przez AI speech to text możesz zamienić istniejące audio w napisy do filmów, notatki do odcinków podcastu, wpisy na blogu i nie tylko. Ułatwia ono ponowne wykorzystanie treści w różnych kanałach, by dotrzeć do szerszej grupy odbiorców.
Speech to text to także duża oszczędność czasu dla zapracowanych twórców. Ręczna transkrypcja każdego nałożonego głosu i podcastu może zająć godziny, ale modele speech to text wykonują to zadanie w kilka minut, dzięki czemu nie wypadasz z harmonogramu publikacji.
W tym artykule wyjaśniamy, jak działa speech to text dla twórców treści, dlaczego jest tak skuteczne i jak włączyć je do swojego workflow tworzenia treści.
Podsumowanie
- Twórcy treści używają modeli speech to text do generowania napisów do filmów, tworzenia notatek do odcinków podcastów i przerabiania treści audio na formaty pisemne.
- Modele speech to text oparte na AI zapewniają dokładniejszą transkrypcję i formatowanie niż automatyczne napisy w mediach społecznościowych.
- Transkrybując podcasty za pomocą speech to text, możesz szybko tworzyć notatki do odcinków albo przerabiać je na blogi i newslettery.
- Dzięki keyterm prompting możesz doprecyzować nazwy i terminy branżowe, aby uzyskać dokładniejsze transkrypcje.
- Aby przetłumaczyć napisy, zdubinguj film na wybrany język, a następnie użyj speech to text do transkrypcji zdubbingowanego audio.
Do czego twórcy treści najczęściej używają speech to text?
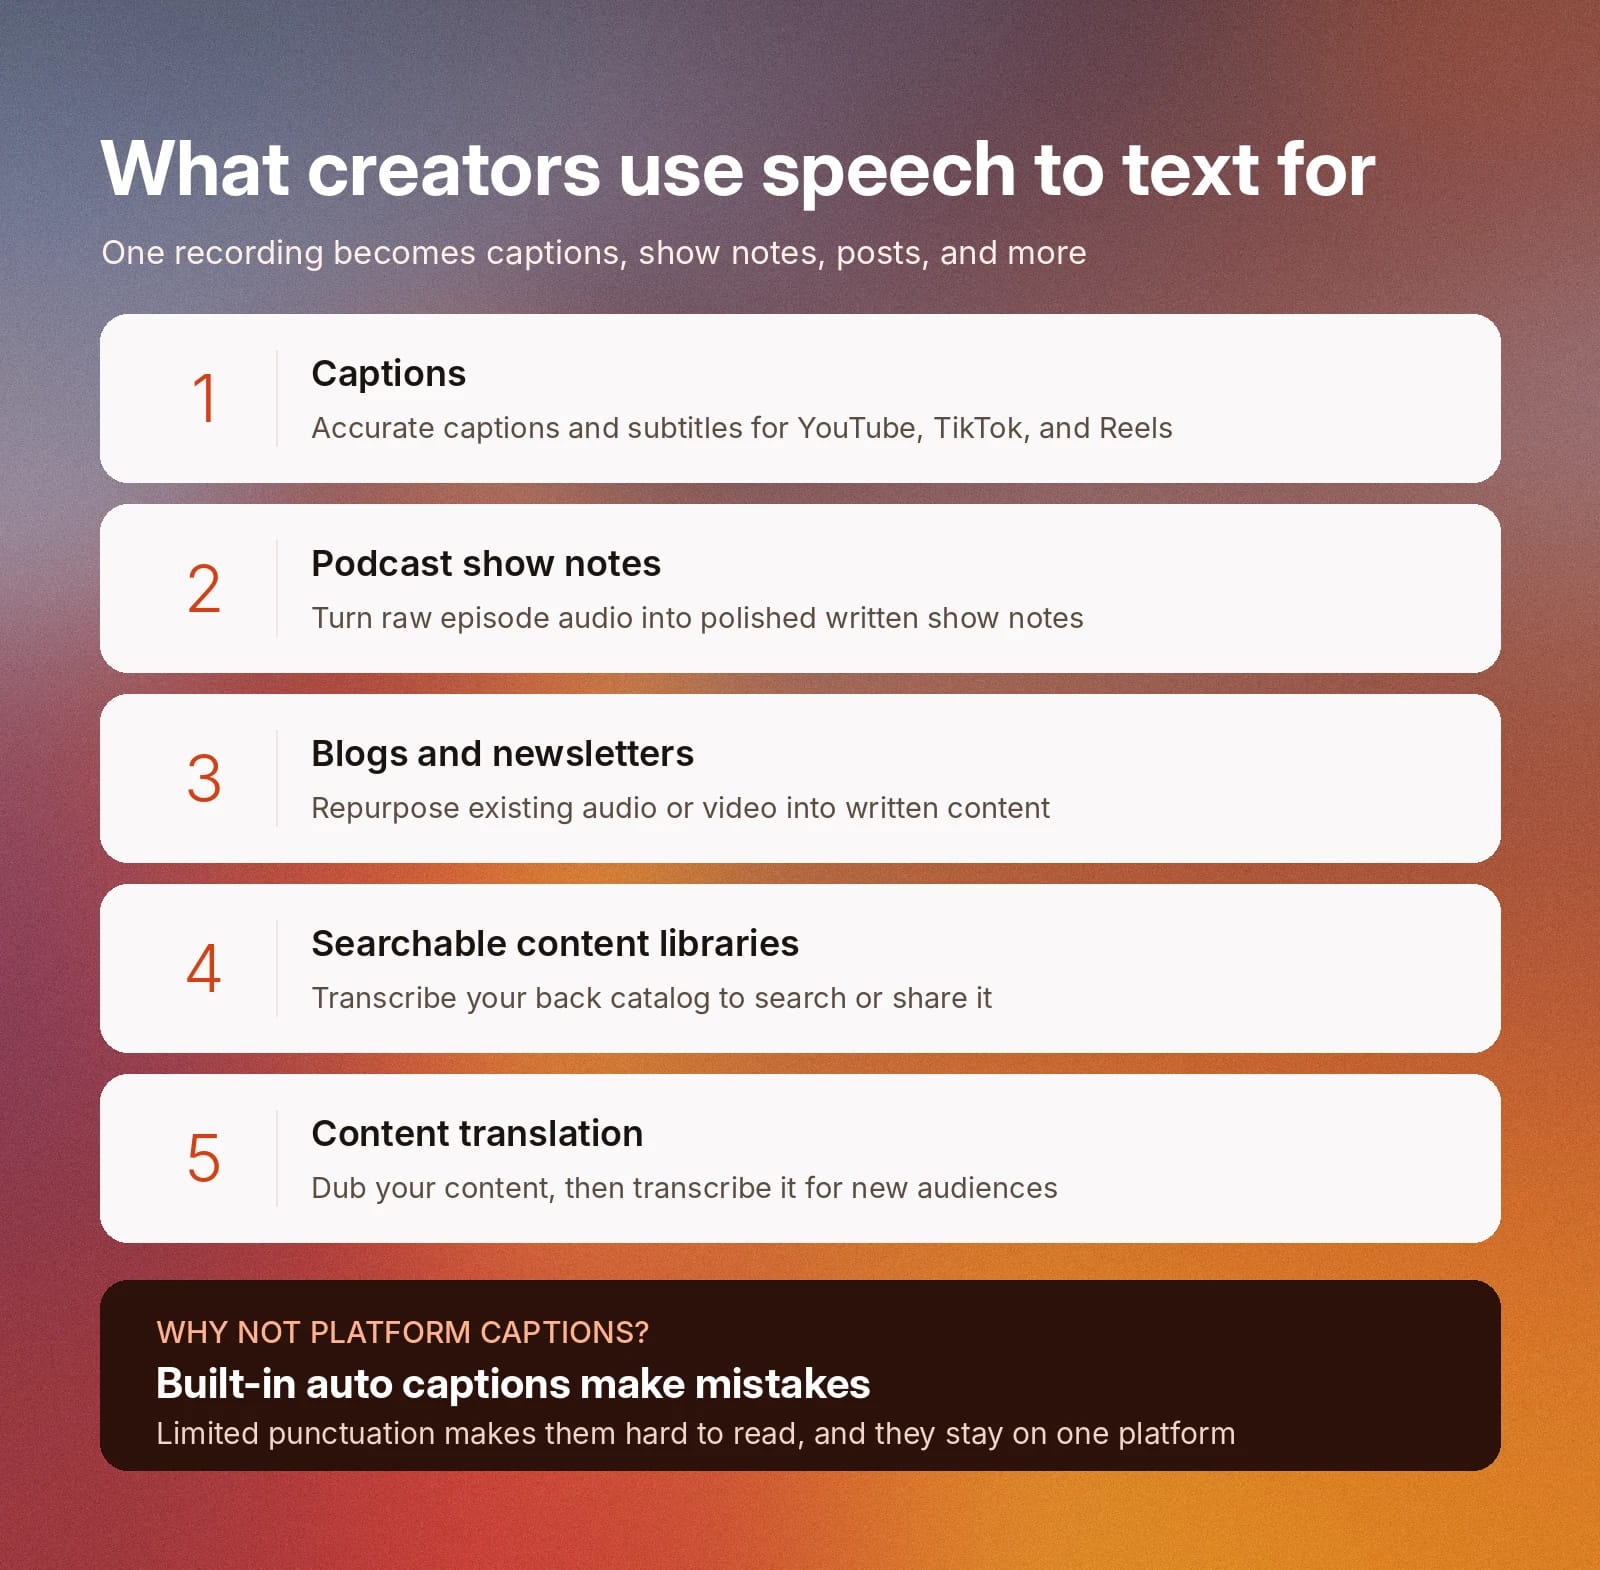
Twórcy treści używają speech to text do wielu zadań, w tym:
- Napisy: Speech to text generuje dokładne napisy i napisy dialogowe do krótkich i długich filmów na platformach takich jak YouTube, TikTok i Instagram Reels.
- Notatki do odcinków podcastu: Speech to text pomaga zamienić surowe audio odcinka w dopracowane, pisemne notatki do odcinka.
- Blogi i newslettery: Dzięki speech to text możesz zamienić istniejące treści audio lub wideo w blogi, newslettery i inne treści pisemne.
- Przeszukiwalne biblioteki treści: Automatyczne narzędzia speech to text transkrybują Twoją bibliotekę treści, dzięki czemu można ją przeszukiwać. Możesz użyć tego, aby zachować porządek wewnętrznie lub stworzyć zewnętrzną bibliotekę materiałów dla odbiorców.
- Tłumaczenie treści: Speech to text tłumaczy Twoje treści na różne języki, aby dotrzeć do odbiorców na całym świecie.
Wiele platform społecznościowych oferuje automatyczne generowanie napisów do wideo. Narzędzia te mogą jednak popełniać błędy i stosować ograniczoną interpunkcję, przez co napisy trudno się czyta.
Dedykowany model speech to text pomaga tworzyć czyste i dokładne napisy do filmów. Możesz też pobrać transkrypcję i wykorzystać ją ponownie na różnych platformach.
Jak zamienić transkrypcję w napisy
Napisy i napisy dialogowe nie są już opcjonalne w filmach do mediów społecznościowych. Ułatwiają dostęp do filmów wszystkim, niezależnie od poziomu słuchu. Pozwalają też oglądać filmy bez dźwięku.
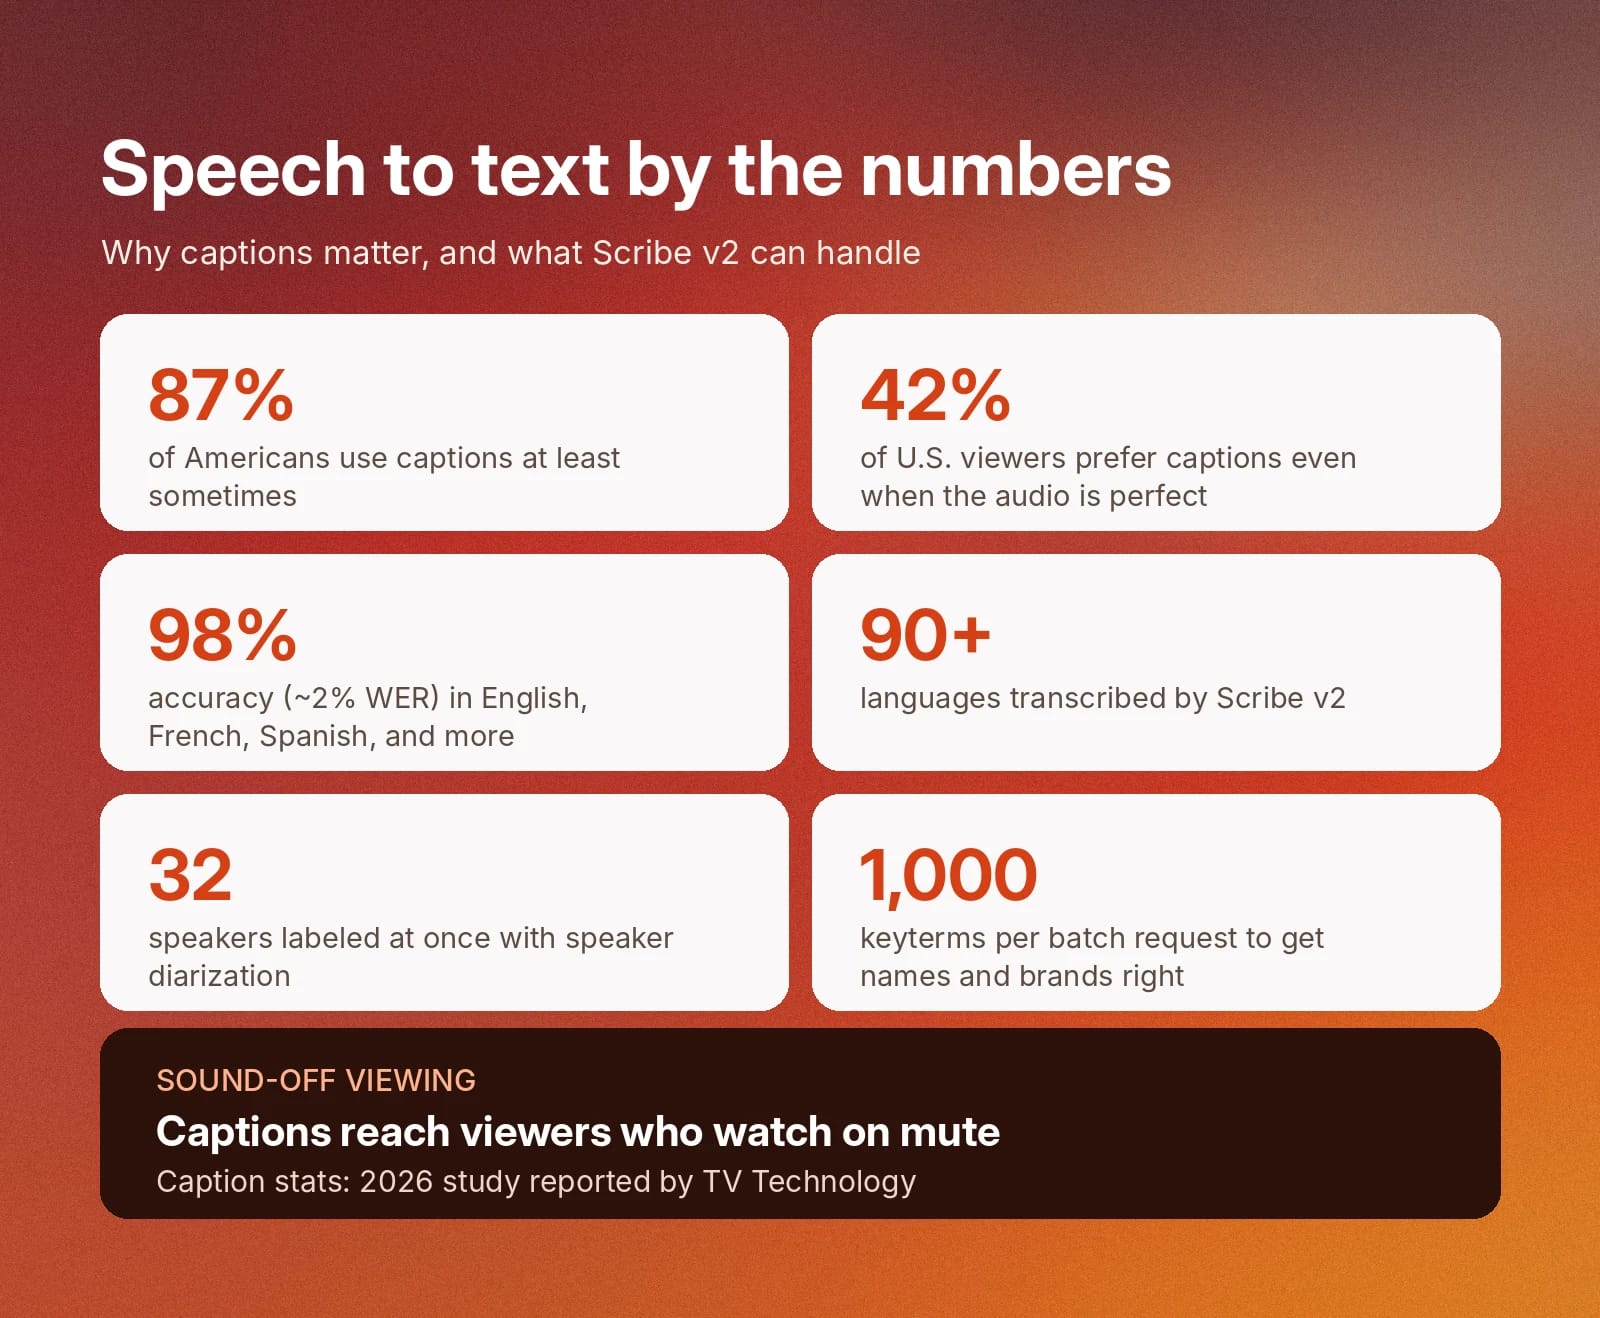
Oglądanie bez dźwięku stało się standardem dla wielu użytkowników mediów społecznościowych, zwłaszcza w miejscach publicznych lub gdy nie mają pod ręką słuchawek. Badanie z 2026 roku wykazało, że 87% Amerykanów przynajmniej czasem korzysta z napisów podczas oglądania wideo.
Co więcej, 42% widzów w USA preferuje napisy, nawet gdy dźwięk w filmie jest doskonały. To pokazuje, jak bardzo napisy do każdego filmu zwiększają atrakcyjność Twoich treści.
Speech to text transkrybuje Twoje filmy do mediów społecznościowych, aby generować napisy. ElevenLabs Caption Generator tworzy transkrypcje ze znacznikami czasu na poziomie słów i znaków, dzięki czemu synchronizują się z mową w filmie. Znaczniki pozostają zachowane, nawet jeśli potniesz oryginalny film na krótsze klipy dla różnych platform.
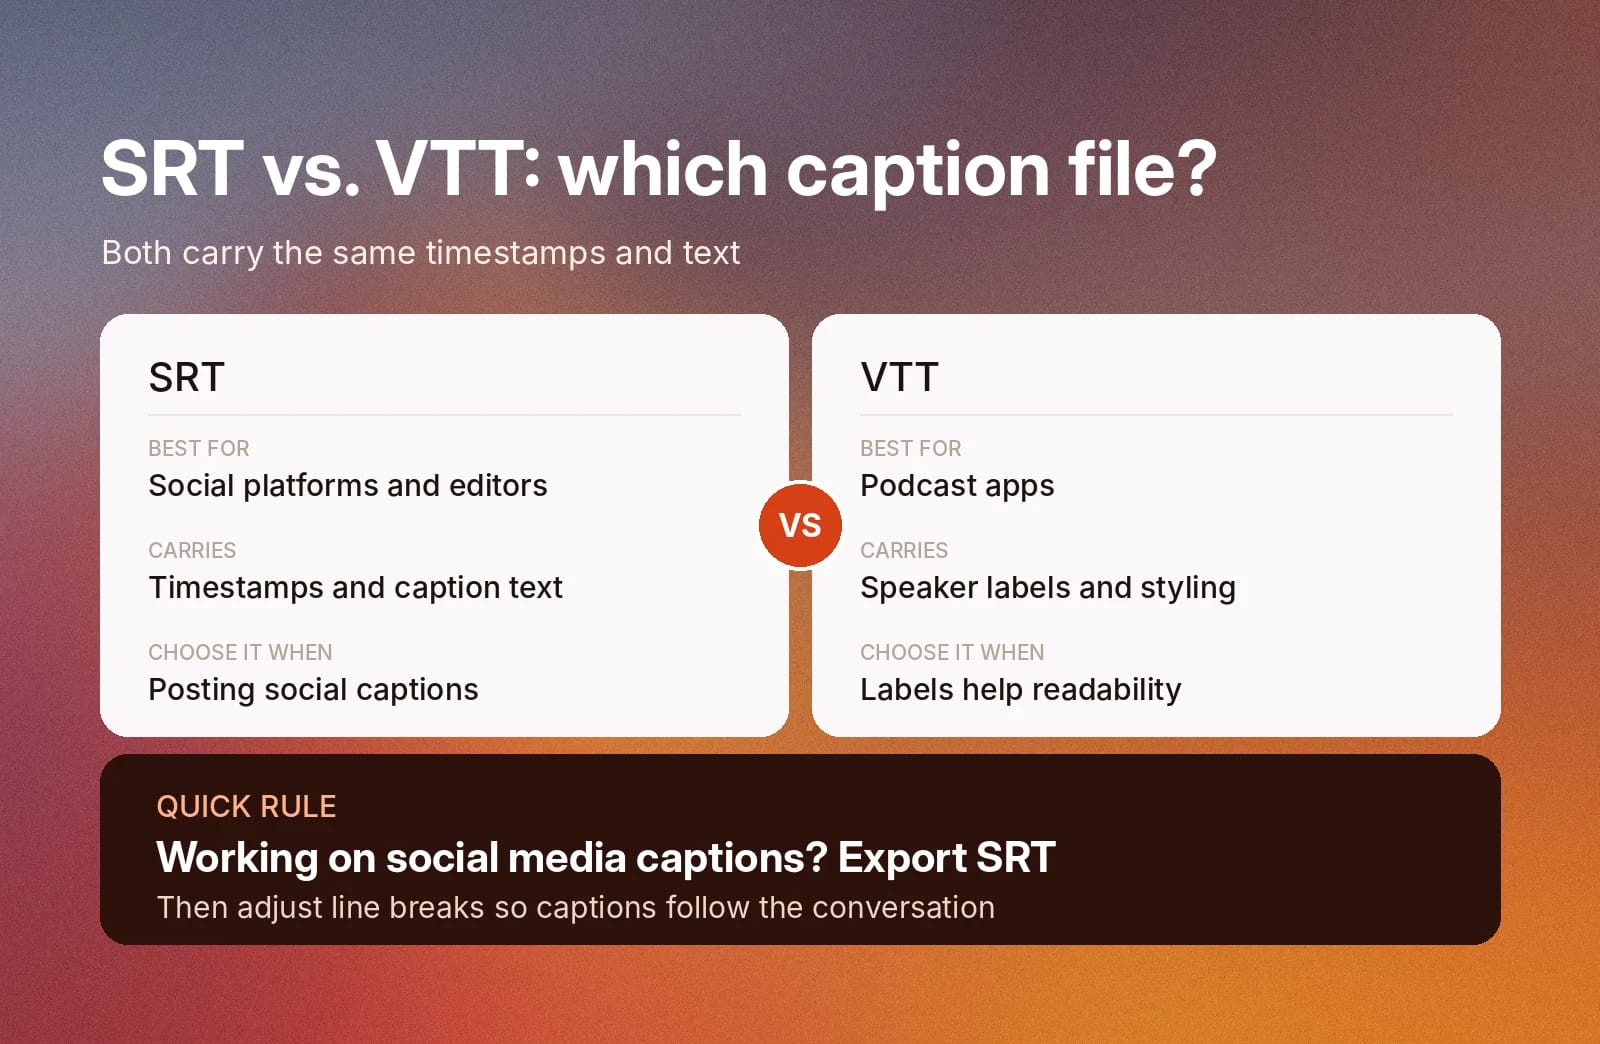
Napisy możesz też eksportować jako pliki SRT i VTT, aby przesłać je bezpośrednio do mediów społecznościowych lub wybranej platformy do edycji wideo. Podczas edycji filmu dostosuj podziały wierszy, aby dobrze współgrały z flow rozmowy.
SRT czy VTT: który plik napisów wyeksportować?
SRT i VTT zawierają te same znaczniki czasu i tekst.
Kiedy wybrać każdy z nich:
- Eksportuj SRT, gdy potrzebujesz prostego pliku obsługiwanego przez większość platform społecznościowych i programów do edycji wideo.
- Eksportuj VTT, gdy publikujesz napisy lub transkrypcje w aplikacjach podcastowych, ponieważ może on dodać etykiety mówców i podstawowe style poprawiające czytelność.
Jeśli tworzysz napisy do mediów społecznościowych, SRT będzie prawdopodobnie właściwym wyborem.
Czysta a dosłowna transkrypcja napisów do mediów społecznościowych
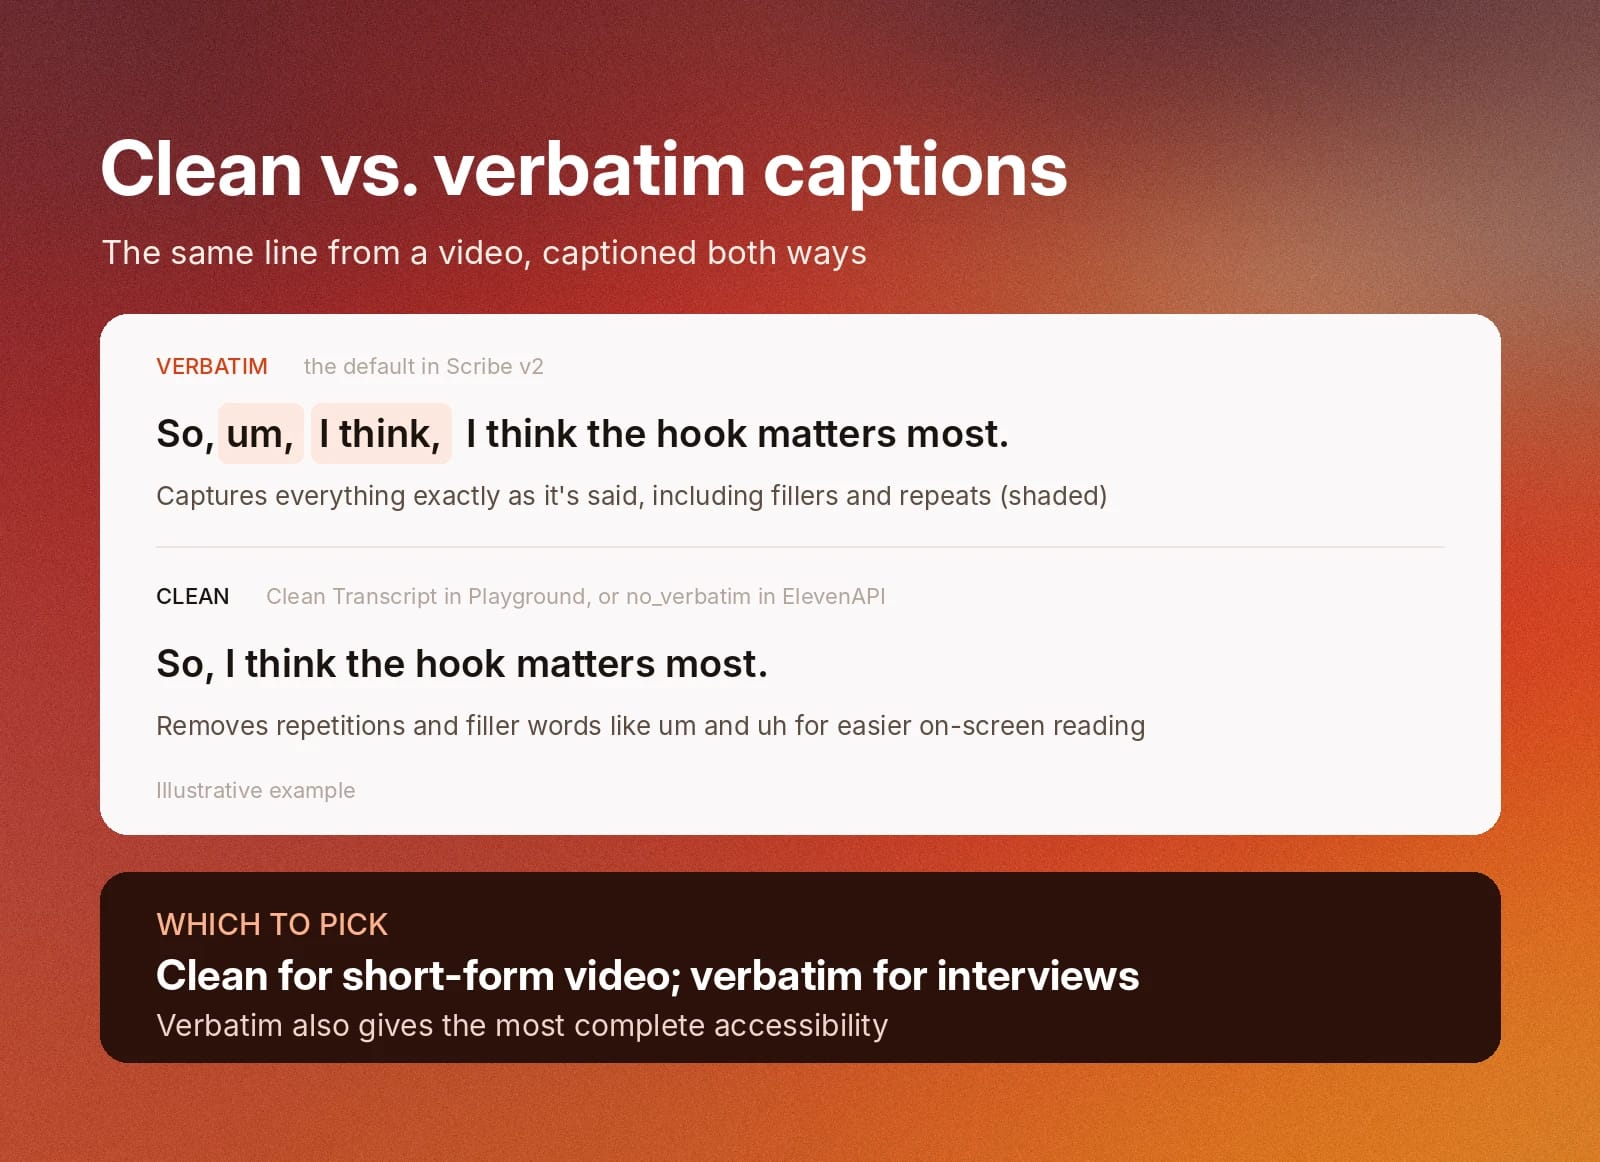
Tworząc napisy do mediów społecznościowych, możesz wybrać między czystą a dosłowną transkrypcją. Czysta transkrypcja usuwa powtórzenia i wypełniacze, takie jak „yyy” i „eee”, a dosłowna zapisuje wszystko dokładnie tak, jak zostało powiedziane.
Czyste napisy łatwiej czyta się na ekranie, ale dosłowne lepiej zapewniają pełną dostępność. Właściwy wybór zależy od Twoich odbiorców i ich potrzeb.
ElevenLabs Scribe v2 domyślnie używa dosłownej transkrypcji. Możesz jednak przełączyć się na czystą transkrypcję, włączając „Clean Transcript” w ElevenLabs Playground lub używając parametru no_verbatim z ElevenAPI.
Wybierz czystą transkrypcję do krótkich filmów, które widzowie prawdopodobnie będą czytać podczas szybkiego przeglądania. Dosłowna sprawdzi się lepiej w dłuższych wywiadach lub badaniach, gdy liczy się dokładne brzmienie słów.
Transkrypcja podcastów na potrzeby notatek i ponownego wykorzystania treści
Twój podcast jest podstawą całej strategii treści. Aby dotrzeć do szerszej grupy odbiorców, zamieniaj pomysły omawiane w każdym odcinku w notatki do odcinka, blogi, newslettery i krótkie treści do mediów społecznościowych.
Narzędzia speech to text pomagają transkrybować odcinki podcastu, aby łatwo wykorzystać je ponownie. Po utworzeniu transkrypcji możesz przeredagować ją w notatki do odcinka, do których odbiorcy wrócą w każdej chwili.
Zamiast pisać artykuły od zera, możesz też zamieniać fragmenty każdej transkrypcji w treści na blog i do newslettera. Dzięki temu dotrzesz do osób, które wolą czytać niż słuchać.
Biblioteki treści pisemnych można łatwo przeszukiwać. Jeśli odbiorca chce wrócić do pomysłu z poprzedniego odcinka, wystarczy, że przeszuka notatki do odcinka lub blog. Treści pisemne częściej pojawiają się też w wynikach wyszukiwania niż audio, więc zwiększają Twoją widoczność online.
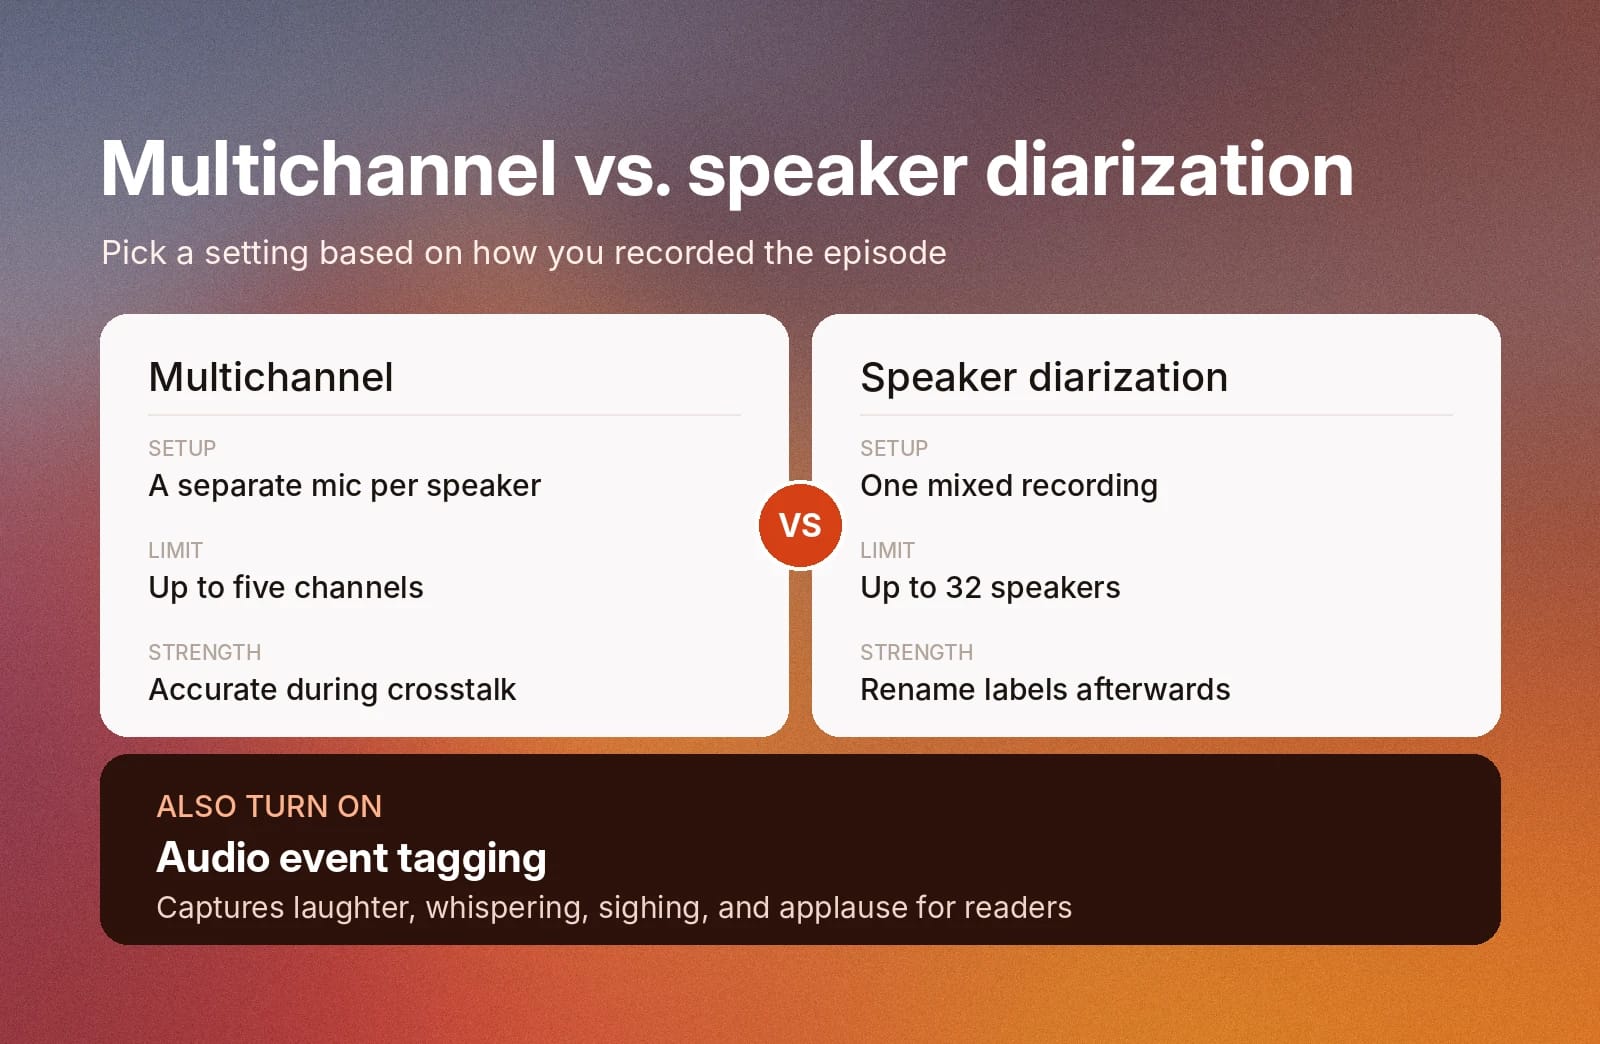
Najwydajniejszym sposobem transkrypcji podcastów jest konfiguracja transkrypcji wielokanałowej. Użyj osobnego mikrofonu dla każdego mówcy. Model transkrypcji zapisze wypowiedzi każdej osoby osobno, więc uzyskasz dokładne wyniki nawet wtedy, gdy rozmówcy mówią jednocześnie.
Dodatkowo podczas transkrypcji podcastów włącz tagowanie zdarzeń audio. To ustawienie wychwytuje śmiech, szepty, westchnienia i oklaski, dzięki czemu czytelnicy otrzymują pełny kontekst. W ElevenLabs Speech to Text włącz opcję „Tag Audio Events” lub użyj parametru tag_audio_events z ElevenAPI.
Rozpoznawanie mówców w jednym nagraniu
Transkrypcja wielokanałowa obsługuje do pięciu kanałów. Jeśli nagrywasz wszystkie głosy na jednej zmiksowanej ścieżce lub masz więcej głosów niż kanałów, włącz zamiast tego diaryzację mówców. Scribe v2 oznacza każdego mówcę w transkrypcji i obsługuje jednocześnie do 32 osób. Po transkrypcji możesz zmienić nazwy mówców, klikając przycisk edycji obok ich etykiety w panelu ElevenLabs.
Przerabianie nagrań na klipy, blogi i newslettery
Transkrybuj wywiad raz i wykorzystaj go ponownie w każdym kanale, w którym publikujesz.
Ta sama transkrypcja dostarcza napisy oraz materiał do klipów i treści pisemnych. Twórcy i firmy na całym świecie używają ElevenLabs STT, aby przyspieszyć proces zamiany podcastów w treści pisemne.
Każdy podcast, keynote i wywiad, który robię, przechodzi przez speech to text. Jedna transkrypcja daje mi dokładne napisy do całości, najlepsze momenty do wycięcia na krótkie filmy oraz kluczowe cytaty, które zamieniam w treści pisemne.
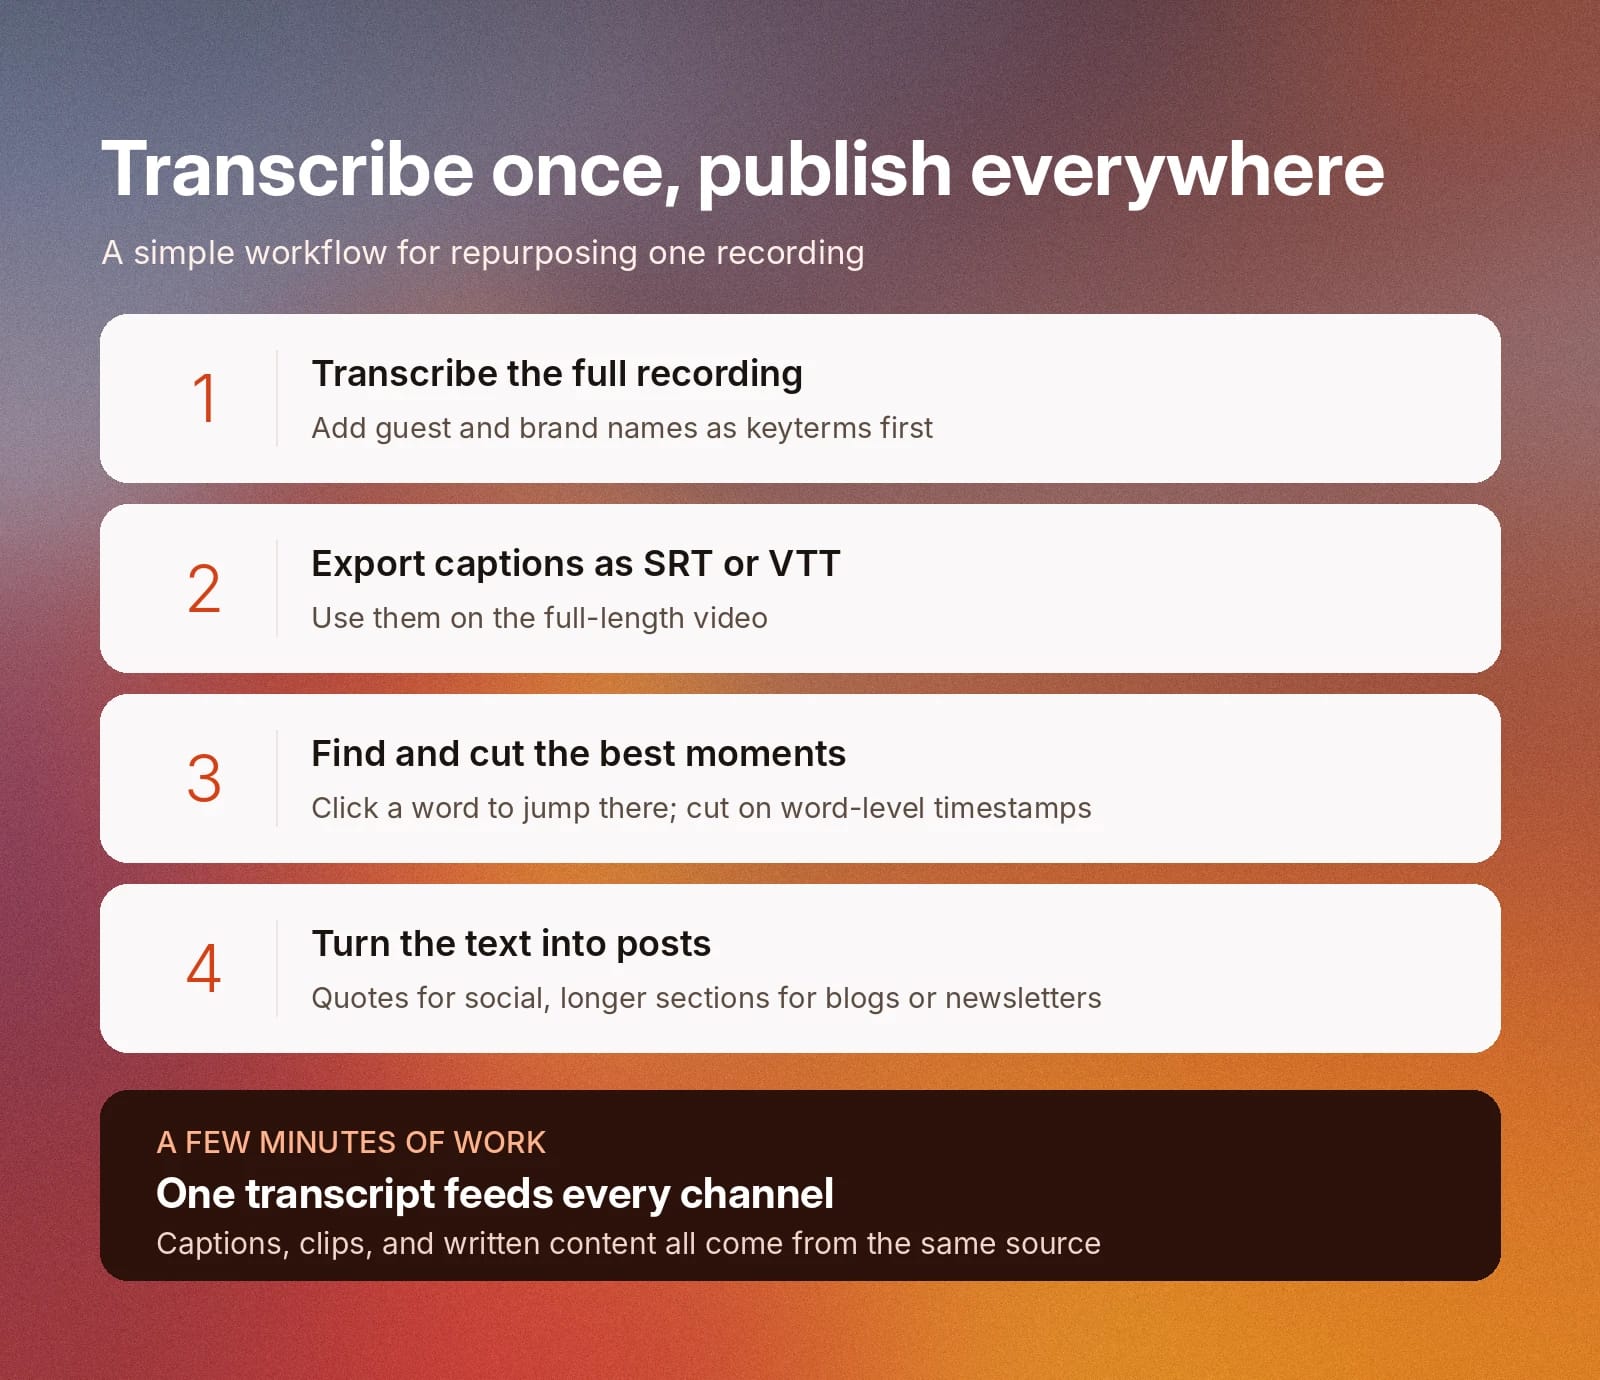
Oto prosty workflow ponownego wykorzystania treści:
- Transkrybuj całe nagranie i dodaj nazwy gości oraz marek do swojego słownika wymowy.
- Wyeksportuj napisy jako SRT lub VTT i użyj ich w pełnym filmie.
- Przeczytaj transkrypcję, szukając najmocniejszych fragmentów. Kliknij słowo w transkrypcji, aby przejść do tego miejsca w audio, a następnie użyj znaczników czasu na poziomie słów, aby przyciąć każdy klip dokładnie na początku i końcu.
- Skopiuj kluczowe cytaty do postów społecznościowych, a dłuższe fragmenty przeredaguj na wpis na blogu lub newsletter.
Stworzenie długich treści z transkrypcji podcastu STT zajmuje tylko kilka minut.
Zamiana filmów w transkrypcje do analizy LLM
Po zamianie filmów w tekst możesz zbiorczo przesłać treści do LLM w celu analizy. Znajdź nowe pomysły, wskaż punkty do wykorzystania w innych treściach lub po prostu sprawdź, co działa w Twoich treściach.
Wszystko, co tworzę, zaczyna się od mojego głosu, ale większość narzędzi AI nadal najlepiej działa z tekstem. ElevenLabs Scribe to moja warstwa tłumacząca: zamienia filmy w transkrypcje, dzięki czemu każdy LLM może przeanalizować, co działa, a co nie. Moim zdaniem wypełnia to jedną z największych luk w AI.
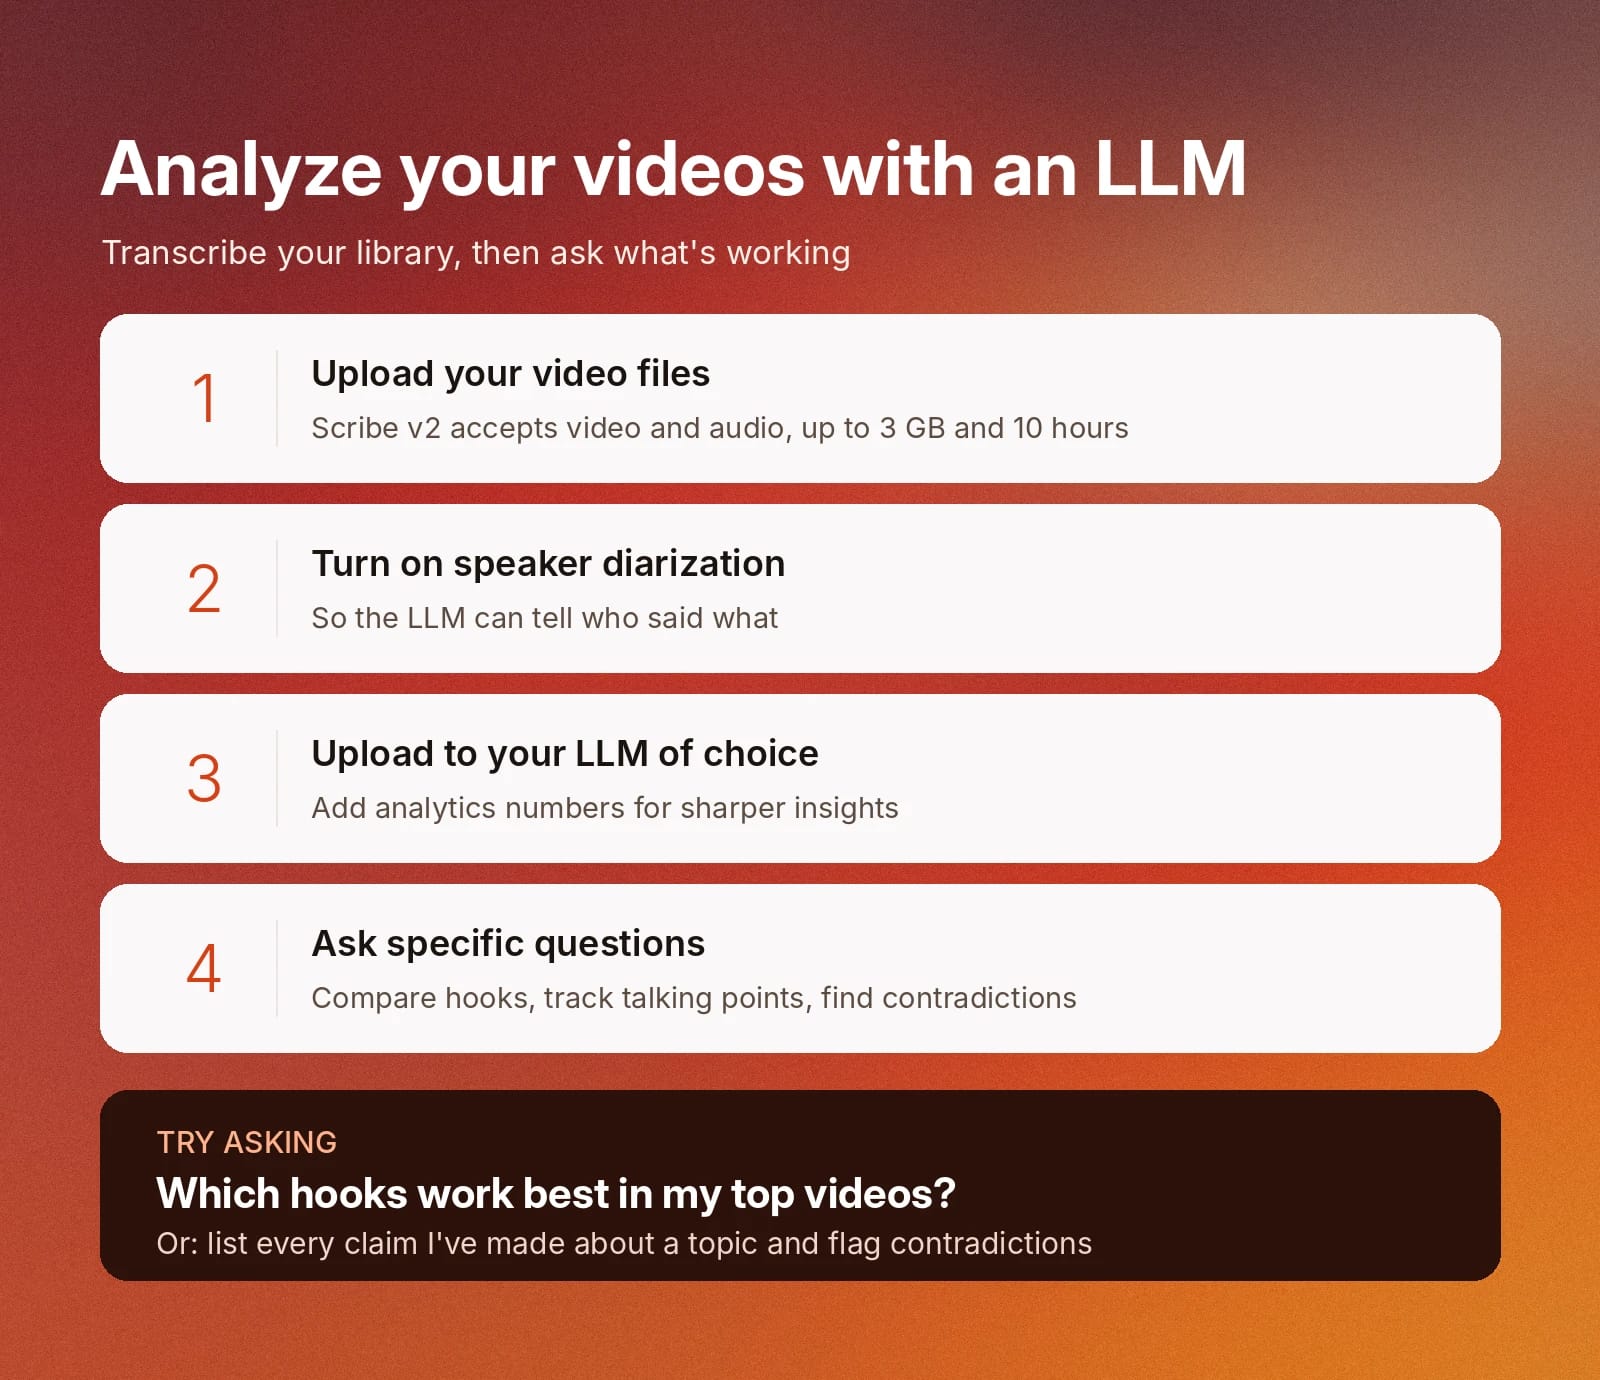
Tak skonfigurujesz podobny workflow:
- Prześlij pliki wideo do transkrypcji: ElevenLabs STT obsługuje wideo i audio, a pliki mogą mieć do 3 GB i trwać do 10 godzin.
- Włącz diaryzację mówców: Jeśli mówi więcej niż jedna osoba, włącz diaryzację, aby LLM rozróżniał, kto co powiedział.
- Prześlij do wybranego LLM: Dodaj dane analityczne lub dodatkowe informacje, aby uzyskać lepsze wnioski.
- Zadawaj konkretne pytania o treści: Pytania takie jak: „Porównaj pierwsze 20 sekund moich najlepiej działających filmów, aby sprawdzić, które haczyki najlepiej działają na moich odbiorców” albo „Wypisz wszystkie twierdzenia, jakie padły z mojej strony na temat X, i oznacz wszelkie sprzeczności” mogą ujawnić nowe wnioski.
Dyktowanie promptów i notatek
Pisanie głosowe pozwala przekazać narzędziu AI kontekst i niuanse, które mogłyby zostać pominięte, gdyby trzeba było wszystko wpisać. Speech to text zamienia Twoje słowa w tekst, który możesz od razu wkleić do promptu, briefu lub notatek. Niektórzy autorzy zaczynają używać STT, by pisać szybciej, transkrybując mowę zamiast wpisywać wszystko ręcznie.
Nie wyobrażam sobie pracy bez tego, zwłaszcza przy promptach. Każda interakcja z AI wymaga tak wielu niuansów, że nie chce mi się tego wszystkiego wpisywać.
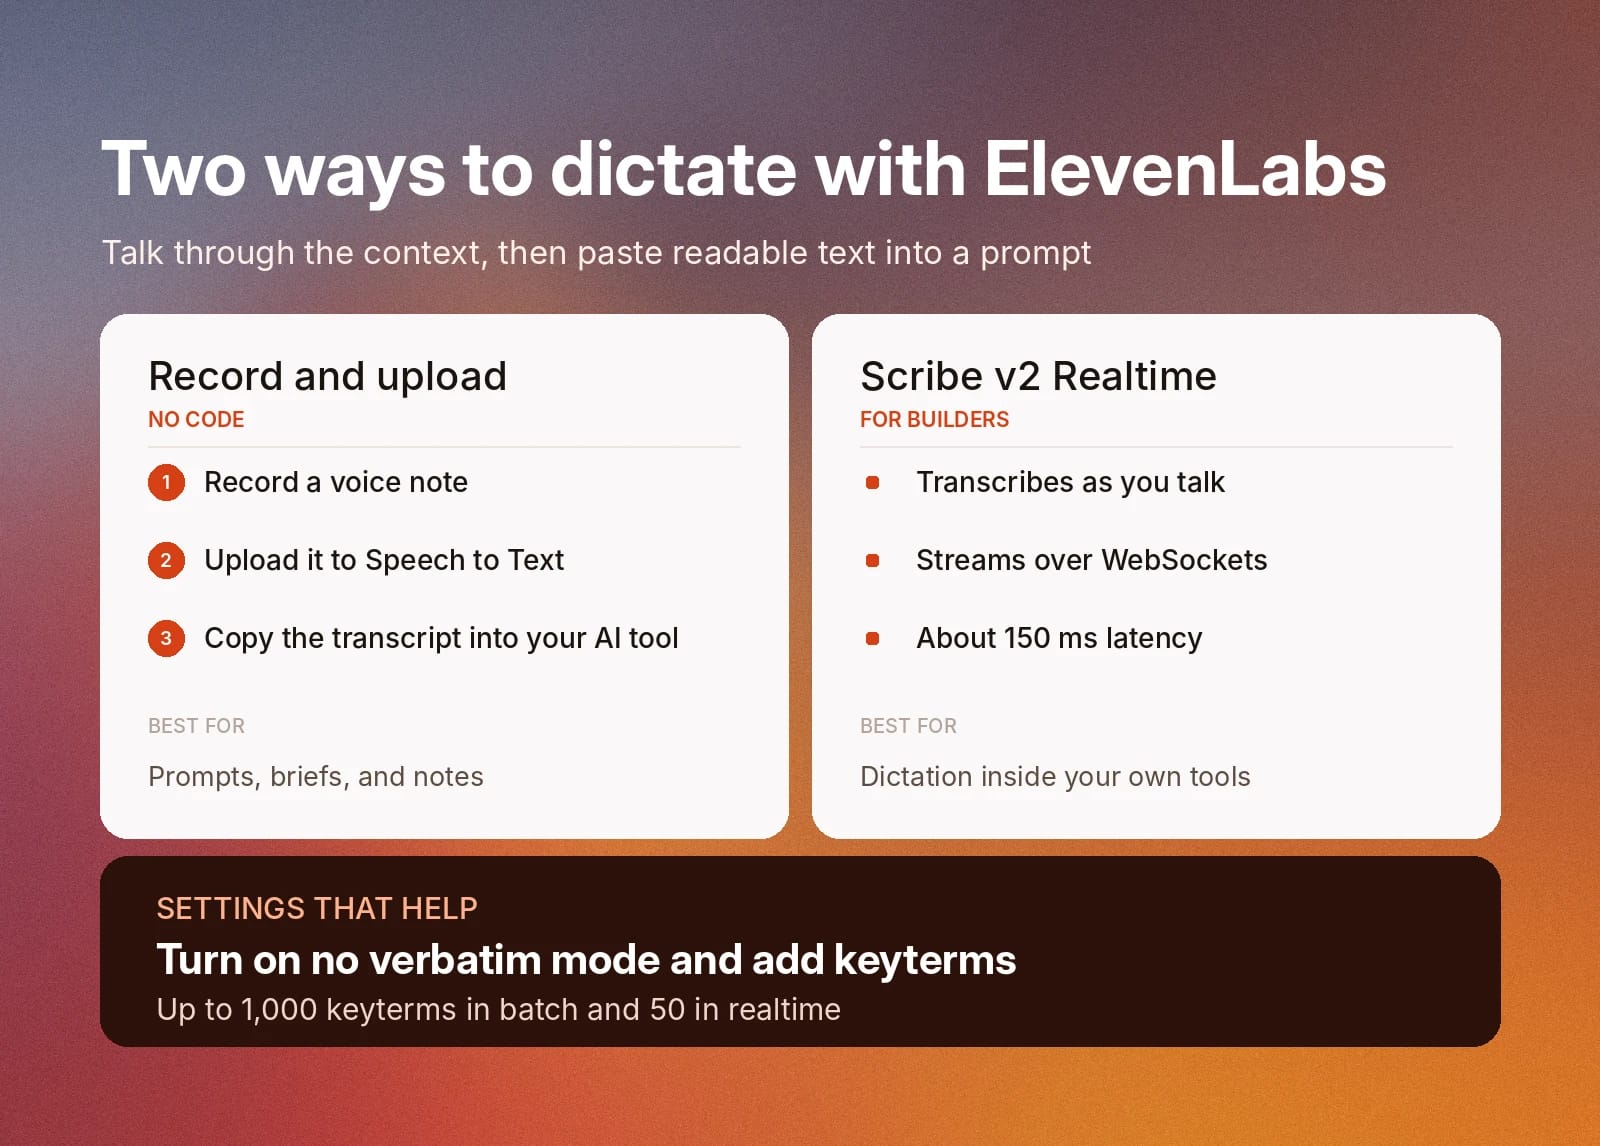
Istnieją dwa sposoby dyktowania z ElevenLabs:
- Nagraj i prześlij: Nagraj notatkę głosową, prześlij ją na stronę ElevenLabs Speech to Text i skopiuj transkrypcję do narzędzia AI.
- Przesyłaj w czasie rzeczywistym: Jeśli tworzysz własne narzędzia, Scribe v2 Realtime transkrybuje mowę podczas mówienia przez WebSockets, z niskim opóźnieniem wynoszącym według dokumentacji około 150 ms.
Pamiętaj, by włączyć tryb no verbatim, który usuwa wypełniacze, fałszywe początki i niepłynności, aby rozwlekła notatka głosowa zamieniła się w czytelny tekst. Następnie dodaj nazwy produktów i żargon, których często używasz, za pomocą keyterm prompting, aby za każdym razem były poprawnie transkrybowane. Transkrypcja wsadowa obsługuje do 1000 kluczowych terminów, a tryb realtime — do 50.
Poprawne nazwy, marki i niszowe terminy dzięki STT
Modele speech to text nie zawsze rozpoznają nazwiska mówców, nazwy marek ani terminy branżowe. Podczas transkrypcji treści użyj keyterm prompting do doprecyzowania pisowni i formatowania.
Keyterm prompting pozwala podać prawidłową pisownię nazw lub niszowych terminów przed rozpoczęciem transkrypcji. Do każdego filmu lub odcinka podcastu dodaj nazwy gości, kanałów lub marek, które często wspominasz. Może być też konieczne dodanie branżowego żargonu lub innych niszowych terminów.
Keyterm prompting zwiększa dokładność transkrypcji i ułatwia odbiorcom ich czytanie. Przyspiesza też edycję, ponieważ nie musisz ręcznie poprawiać tych terminów.
Docieranie do odbiorców w innych językach
Modele speech to text oferują więcej niż transkrypcję. Jako twórca treści możesz ich także używać do lokalizacji treści i docierania do odbiorców mówiących innymi językami.
ElevenLabs Scribe v2 transkrybuje treści w ponad 90 językach. Możesz połączyć go z ElevenLabs Dubbing Studio i stworzyć kompletny workflow lokalizacji.
Aby to zrobić, prześlij audio do Dubbing Studio, aby zdubbingować treść na wybrany język. Następnie transkrybuj zdubbingowane audio, aby stworzyć zlokalizowane napisy, notatki do odcinka lub inne treści pisemne.
Czego speech to text nie zrobi za Ciebie
Speech to text to potężne narzędzie, ale ma ograniczenia. Modele speech to text transkrybują audio z dokładnymi znacznikami czasu, lecz nie są edytorami wideo. Do stworzenia finalnego materiału potrzebujesz osobnej platformy do edycji wideo.
Tworząc treści, zacznij od użycia speech to text do transkrypcji audio. Następnie wyeksportuj zarówno surową transkrypcję, jak i napisy, aby wykorzystywać je w różnych treściach. Prześlij napisy do swojego edytora wideo lub bezpośrednio do mediów społecznościowych, a transkrypcję wykorzystaj jako podstawę do notatek do odcinka, wpisów na blogu i innych materiałów pisemnych.
Przejrzyj każdą transkrypcję przed publikacją, szczególnie nazwy i fragmenty, w których mówcy mówią jednocześnie. Transcript Editor pozwala łatwo poprawiać błędy w aplikacji.
Jak wybrać najlepsze narzędzie speech to text dla twórcy treści
Odpowiednie narzędzie STT zamienia nagranie w czysty, poprawnie zapisany tekst ze znacznikami czasu, które maksymalnie ułatwiają ponowne wykorzystanie treści.
Szukając najlepszej platformy speech to text, upewnij się, że oferuje te pięć rzeczy:
- Dokładność w Twoim języku: Skuteczność STT może różnić się między językami, zwłaszcza tymi z mniejszą ilością dostępnych danych. Szukaj opublikowanych danych o dokładności. Na przykład ElevenLabs Scribe v2 ma 98% dokładności (około 2% WER) w językach takich jak angielski, francuski, włoski, hiszpański i innych.
- Obsługa nazw i żargonu branżowego: Twój model STT musi rozumieć kontekst rozmów i dokładnie je transkrybować. Szukaj platform STT oferujących keyterm prompting i słowniki wymowy.
- Znaczniki czasu i formaty eksportu: Potrzebujesz znaczników czasu na poziomie słów oraz opcji eksportu napisów SRT lub VTT.
- Obsługa mówców: Zwłaszcza gdy pracujesz z audio, w którym występuje więcej niż jeden mówca, dokładne rozpoznanie poszczególnych głosów pomoże zachować przejrzystość transkrypcji.
- Limity plików: W przypadku większych projektów audio lub wideo, takich jak podcasty, możesz pracować z większymi plikami. ElevenLabs obsługuje pliki do 3 GB i, w trybie standardowym, do 10 godzin.
Tak dedykowany model STT, taki jak Eleven Scribe v2, wypada na tle automatycznych narzędzi do napisów wbudowanych w platformy społecznościowe:
Czego potrzebujesz
Automatyczne napisy platformy
Dedykowany model, np. Scribe v2
Poprawna pisownia nazw i marek
Może popełniać błędy
Keyterm prompting, do 1000 terminów na żądanie wsadowe
Czytelna interpunkcja
Często ograniczona
Czysty wynik w trybie no verbatim
Wykorzystanie tekstu w innych miejscach
Napisy pozostają na platformie
Pobierz transkrypcję i napisy oraz używaj ich wszędzie
Timing
Powiązany z odtwarzaczem platformy
Znaczniki czasu na poziomie słów, które możesz przenieść do klipów
Języki
Zależy od platformy
Ponad 90 języków
Dwa sposoby na start: przesłanie bez kodu lub API
Z ElevenLabs masz dwa sposoby na transkrypcję treści wideo za pomocą speech to text.
Pierwsza opcja to przesłanie pliku audio do panelu ElevenLabs Playground. Dostosuj ustawienia transkrypcji, edytuj wynik bezpośrednio w Transcript Editor, a następnie wyeksportuj go w potrzebnym formacie. To szybki i prosty proces, który nie wymaga kodowania.
Jeśli tworzysz własny workflow publikowania treści, możesz też transkrybować za pomocą ElevenAPI. Dodaj API bezpośrednio do narzędzi, które już tworzysz, aby uzyskać równie dokładne transkrypcje bez przełączania się między narzędziami.
Zarejestruj się w ElevenLabs i zacznij korzystać z STT już dziś lub dowiedz się więcej o tym, jak speech to text dla twórców zmienia zasady gry.
FAQ

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.



