Czym jest transkrypcja wielojęzyczna i jak działa?
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Niezależnie od tego, czy organizujesz międzynarodową konferencję, czy po prostu potrzebujesz dokładnych zapisów rozmów z obsługą klienta w dowolnym języku, transkrypcja wielojęzyczna jest dziś potrzebna bardziej niż kiedykolwiek.
Narzędzia do transkrypcji wielojęzycznej zamieniają dane audio w dokładny tekst z możliwością wyszukiwania, dzięki czemu rozmowy stają się użytecznymi zapisami. Technologia umożliwiająca transkrypcję w różnych językach rozwijała się wraz z badaniami nad modelami Speech to Text (STT). Deweloperzy mogą teraz osadzać zaawansowane API STT w swoich workflow, aby tworzyć złożone procesy transkrypcji wielojęzycznej.
W tym artykule wyjaśnimy, czym jest transkrypcja wielojęzyczna, krótko omówimy jej działanie w aplikacji desktopowej i przez API oraz pokażemy, dlaczego jest niezbędna firmom na całym świecie.
Podsumowanie
- Transkrypcja wielojęzyczna zamienia plik audio w tekst pisany w kilku językach.
- Najlepsze narzędzia do transkrypcji wielojęzycznej oferują dodatkowe funkcje, takie jak diaryzacja mówców, podpowiedzi słów kluczowych i wykrywanie encji.
- Z narzędzi do transkrypcji wielojęzycznej możesz korzystać online albo zintegrować API Speech to Text ze swoim workflow deweloperskim.
- Transkrypcja automatyczna zapewnia szybkość i skalę, a transkrypcja wykonywana przez człowieka może sprawdzić się w złożonych materiałach z nakładającymi się wypowiedziami wielu osób.
- Dokładność transkrypcji wielojęzycznej mierzy się wskaźnikiem Word Error Rate (WER), który różni się zależnie od języka.
Czym jest transkrypcja wielojęzyczna i dlaczego ma znaczenie?
Transkrypcja wielojęzyczna zamienia mowę w tekst pisany w więcej niż jednym języku. Systemy sztucznej inteligencji automatycznie wykrywają używany język lub języki i transkrybują audio. Wynikiem wielojęzycznego STT może być dosłowna transkrypcja albo tekst z warstwą tłumaczenia, która ujednolica języki wejściowe w jednym języku wyjściowym.
Na przykład podczas globalnej konferencji uczestnicy mogą zadawać prelegentom pytania w ich języku ojczystym. Narzędzie speech to text dla wielu języków może bezpośrednio transkrybować wypowiedź każdego prelegenta w jego języku albo tworzyć jeden wynik w języku docelowym, który odbiorcy mogą przeczytać. Dzięki tym narzędziom STT organizacje mogą zwiększać dostępność swoich wydarzeń.
ElevenLabs wbudowuje funkcje wielojęzycznego STT bezpośrednio w nasz model Speech to Text Scribe v2. Scribe v2 obsługuje automatyczne wykrywanie języka, więc jeden plik może zawierać wiele języków. Możesz wskazać języki obecne w klipie audio lub pozostawić ustawienie „Wykryj”, aby nasz system rozpoznał języki w przesłanym pliku.
W ElevenAPI parametr language_code domyślnie korzysta z automatycznego wykrywania. Jeśli wiesz już, jakie języki występują w nagraniu, podanie ich z góry poprawia wyniki.
Dlaczego transkrypcja wielojęzyczna ma znaczenie
Najnowsze badania wskazują, że globalny rynek usług transkrypcji osiągnie wartość 6 mld USD do 2035 roku. Jednym z czynników napędzających jego wzrost jest szeroki zakres zastosowań wielojęzycznego STT.
Oto kilka praktycznych powodów, dla których transkrypcja wielojęzyczna jest ważna:
- Dostępność: Napisy zależą od dokładnej transkrypcji wielojęzycznej, zanim będzie można rozpocząć tłumaczenie lub dubbing. Wielojęzyczne STT może znacznie poprawić dostępność dla użytkowników.
- Możliwość wyszukiwania: Transkrybowane audio może stać się tekstem indeksowanym przez wyszukiwarki, dzięki czemu rozmowy z obsługą klienta lub spotkania staną się użytecznym źródłem dla innych. Jest to szczególnie ważne, gdy systemy AI zaczynają wydobywać więcej danych z dokumentów wewnętrznych, a czytelne transkrypcje pomagają stworzyć pełne źródło danych wejściowych.
- Zgodność z przepisami: Wiele regulowanych branż potrzebuje możliwych do audytu pisemnych zapisów interakcji głosowych. Wielojęzyczne STT pozwala zapewnić je w każdym języku używanym przez klientów. Na przykład Financial Conduct Authority wymaga od instytucji finansowych przechowywania nagrań i transkrypcji rozmów telefonicznych.
- Globalne procesy tworzenia treści: Niezależnie od tego, czy chodzi o dubbing czy napisy, workflow zawsze zaczyna się od bardzo dokładnej transkrypcji. Dobre narzędzia do transkrypcji wielojęzycznej umożliwiają pierwszy krok w szerszych globalnych procesach dystrybucji treści.
Transkrypcja wielojęzyczna jest potrzebna w wielu branżach: operatorzy telekomunikacyjni transkrybują rozmowy z obsługą klienta, firmy finansowe spełniają wymogi zgodności, zespoły medyczne dokumentują kontakty z pacjentami, a studia filmowe lokalizują treści. Niezależnie od tego, czy działasz w SaaS, turystyce czy usługach komunalnych, skuteczny system zapewnia wysoką jakość i precyzję transkrypcji.
Najważniejsze funkcje rozwiązań do transkrypcji wielojęzycznej
Narzędzia do transkrypcji wielojęzycznej muszą dostosowywać się do przetwarzanego audio, dynamicznie rozpoznawać języki i transkrybować je z dużą dokładnością.
Oto najważniejsze funkcje, których warto szukać w dobrym rozwiązaniu do transkrypcji wielojęzycznej:
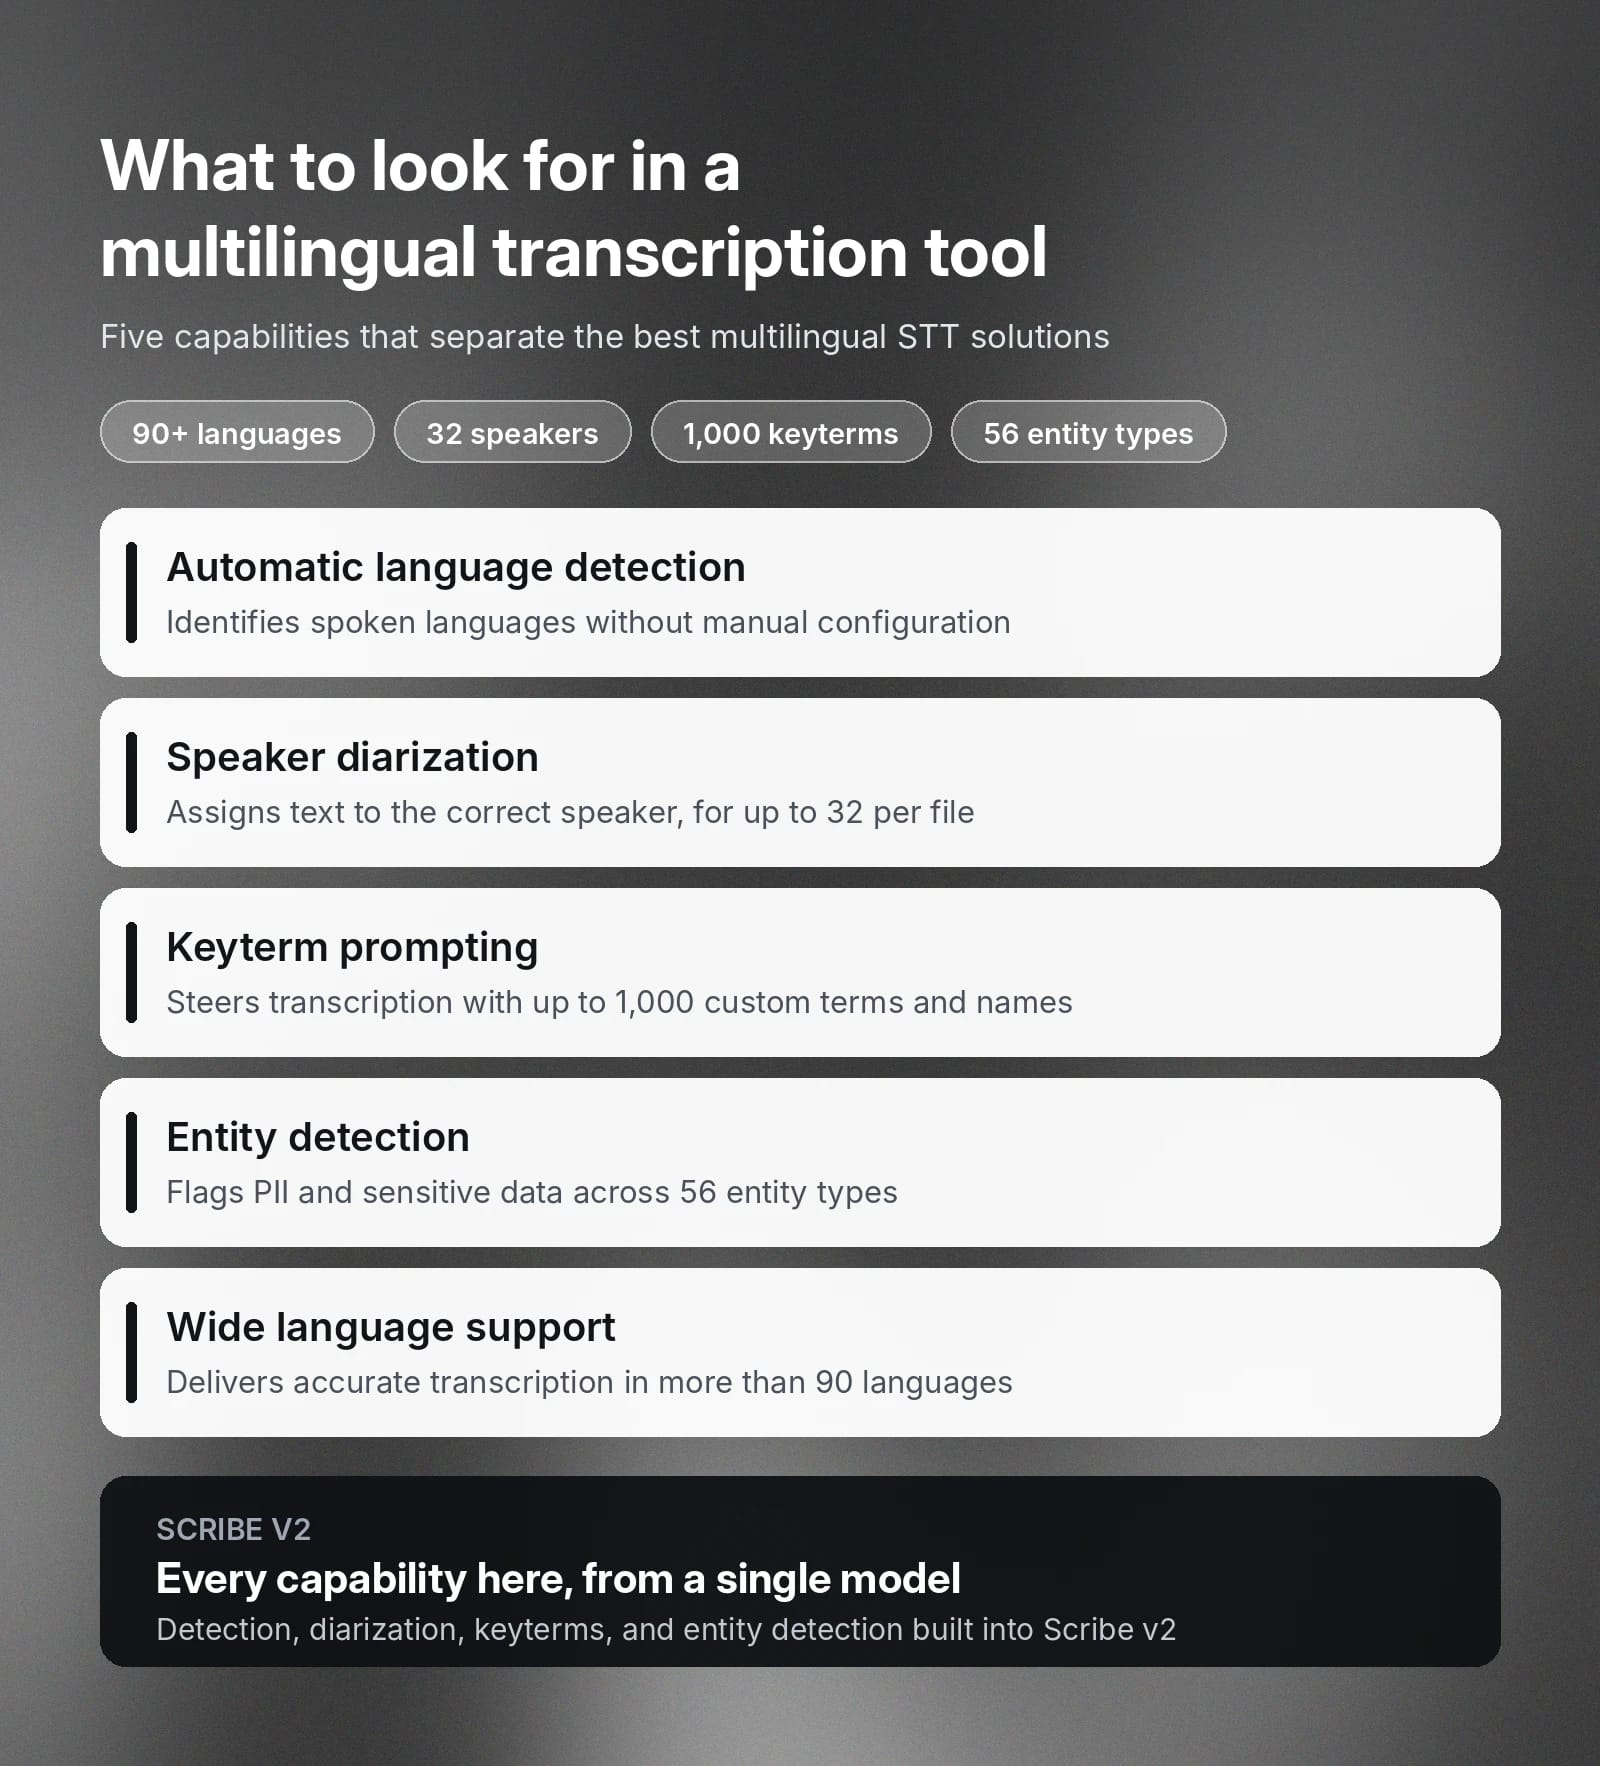
- Automatyczne wykrywanie języka: System powinien sam rozpoznawać język mówiony, zamiast wstrzymywać transkrypcję do chwili podania przez użytkownika języka źródłowego. Zwłaszcza gdy język wejściowy jest nieznany albo klip zawiera kilka języków, automatyczne wykrywanie języka pozwala obsługiwać je bez ręcznej konfiguracji.
- Diaryzacja mówców: Diaryzacja przypisuje transkrybowany tekst właściwemu mówcy w pliku. Jest to ważne w każdej transkrypcji audio z wieloma osobami. Może chodzić na przykład o kilku uczestników panelu, których trzeba rozróżnić, albo po prostu o wyraźne odróżnienie wypowiedzi klienta i agenta wsparcia. Scribe v2 obsługuje diaryzację dla maksymalnie 32 mówców w jednym pliku.
- Podpowiedzi słów kluczowych: Słowa kluczowe pozwalają użytkownikom ręcznie wpisać konkretne słownictwo, na przykład nazwy produktów lub nazwy własne, aby zapewnić poprawną transkrypcję. W systemach wsadowych Scribe v2 obsługuje do 1000 słów kluczowych, a Scribe v2 Realtime do transkrypcji na żywo — do 50.
- Wykrywanie encji: Wykrywanie encji identyfikuje konkretne słowa w transkrypcji. To kluczowe dla zgodności z przepisami i ochrony wrażliwych danych. Zapoznaj się z dokumentacją ElevenLabs dotyczącą wykrywania encji, aby poznać 56 obsługiwanych typów encji.
- Szeroka obsługa języków: Najlepsze rozwiązania wielojęzycznego STT obsługują transkrypcję w bardzo wielu językach. Dla porównania Scribe v2 oferuje dokładną transkrypcję w ponad 90 językach.
Razem te funkcje obsługują szeroki zakres zastosowań, pozwalając wykorzystać niezawodny system STT, który precyzyjnie obsługuje wiele języków.
Jak skutecznie transkrybować audio w różnych językach
Najskuteczniejszy sposób transkrypcji audio w różnych językach zależy od planowanego obciążenia. W przypadku pojedynczych plików wsadowych strona ElevenLabs Speech to Text pozwala przesłać plik i szybko otrzymać transkrypcję.
W ElevenCreative transkrypcja audio jest bardzo prosta:
- Prześlij audio: Przejdź do Speech to Text i kliknij „Transkrybuj pliki”.
- Wybierz opcje: Wybierz główny język albo pozostaw opcję „Wykryj”, włącz zdarzenia audio, jeśli chcesz oznaczać śmiech lub inne zdarzenia pozamowne, i w razie potrzeby dodaj słowa kluczowe.
- Zobacz wyniki: Po przesłaniu plików kliknij nazwę pliku audio, aby zobaczyć jego transkrypcję. Możesz ją sprawdzić i dopracować bezpośrednio w Edytorze transkrypcji, a następnie wyeksportować w formacie wymaganym przez kolejne workflow.
Do programistycznej transkrypcji na dużą skalę użyj API Speech to Text. Oto kilka szczegółów, które pomogą Ci zbudować procesy produkcyjne:
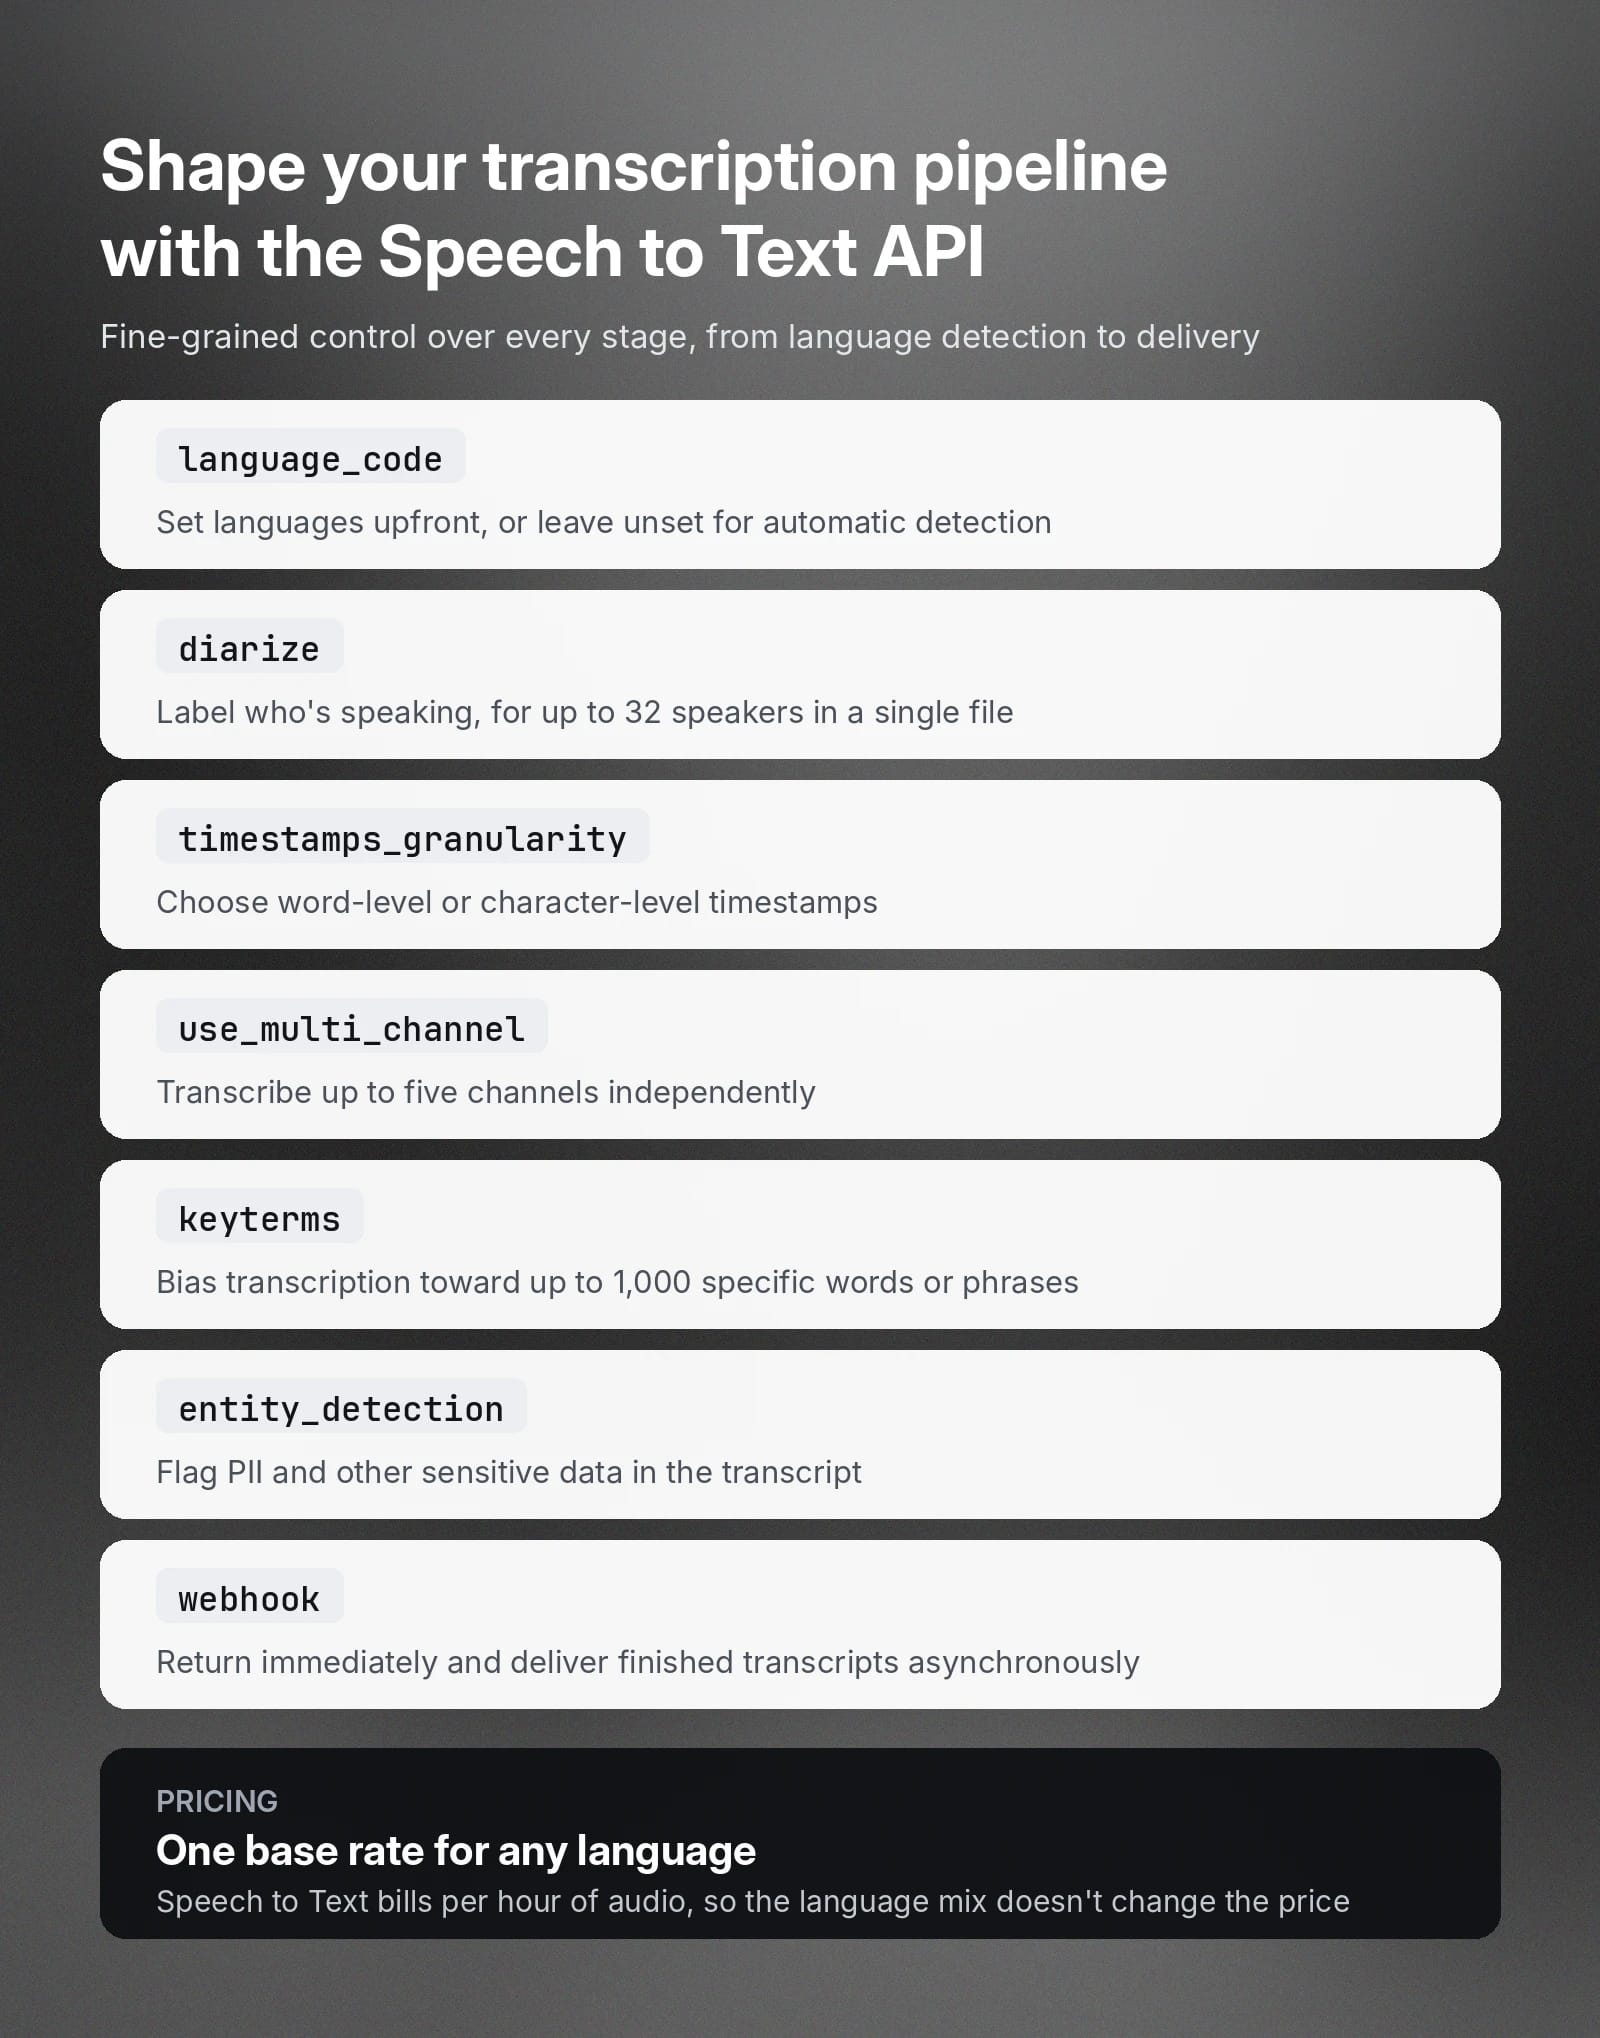
- Wybór modelu: Parametr model_id wybiera między scribe_v2 a scribe_v1, dzięki czemu proces może wskazać konkretny model zamiast polegać na wartości domyślnej, która może się z czasem zmienić.
- Obsługa języka: Parametr language_code przyjmuje kod ISO-639-1 lub kod ISO-639-3 i domyślnie korzysta z automatycznego wykrywania, jeśli nie zostanie ustawiony. Bezpośrednie podanie języka może poprawić wyniki.
- Kontrola diaryzacji mówców: Ustawienie diarize na true oznacza, który mówca aktualnie mówi. Parametr num_speakers ogranicza liczbę mówców od 1 do 32. Aby uzyskać bardziej szczegółową kontrolę, użyj parametru diarization_threshold i dostosuj kompromis między rozróżnianiem mówców.
- Precyzja znaczników czasu: Parametr timestamps_granularity kontroluje szczegółowość danych wyjściowych, oferując znaczniki czasu na poziomie słów lub znaków znaczniki czasu (albo ich brak).
- Asynchroniczne przetwarzanie na dużą skalę: Ustawienie webhook na true zwraca odpowiedź od razu, a gotową transkrypcję wysyła do skonfigurowanego webhooka po zakończeniu przetwarzania. Pole webhook_metadata dołącza do każdej odpowiedzi webhooka własne dane śledzące, takie jak wewnętrzny identyfikator zadania.
- Audio wielokanałowe: Ustawienie use_multi_channel na true transkrybuje każdy kanał niezależnie — do pięciu kanałów — i oznacza każde słowo polem channel_index.
- Obsługa specjalistycznych treści: Parametr keyterms ukierunkowuje transkrypcję na maksymalnie 1000 konkretnych słów lub fraz, entity_detection oznacza PII i inne dane wrażliwe, a no_verbatim usuwa z wyniku wypełniacze i fałszywe początki wypowiedzi.
Parametry te dają precyzyjną kontrolę nad każdym etapem procesu. Od wykrywania języka i oznaczania mówców po formatowanie oraz dostarczanie wyników — API Speech to Text dopasowuje się do potrzeb produkcyjnych.
Obsługiwane języki w usługach transkrypcji
Obsługiwane języki w dużej mierze wyróżniają najlepsze narzędzia do transkrypcji wielojęzycznej. ElevenLabs Scribe v2 i Scribe v2 Realtime obsługują ponad 90 języków, a dokumentacja Speech to Text zawiera pełną listę obsługiwanych języków.
Języki takie jak angielski, hiszpański, włoski, polski, francuski i niemiecki mają więcej danych treningowych, dlatego STT dla nich często cechuje się większą dokładnością. Niektóre języki, takie jak amharski, ganda, joruba i zulu, mają niższą dokładność niż wymienione wcześniej języki.
Modele ElevenLabs Scribe osiągają <5% wskaźnika błędów słów dla 36 języków i WER poniżej 10% dla kolejnych 21. Więcej informacji o obsługiwanych językach i ich WER znajdziesz w ElevenLabs zestawieniu obsługi języków.
Ile kosztuje transkrypcja wielojęzyczna?
Ceny transkrypcji automatycznej zwykle zależą od długości pliku audio, a nie liczby słów czy języków. ElevenLabs rozlicza Speech to Text według długości audio — za godzinę nagrania. Konkretne stawki różnią się zależnie od planu i modelu.
Oto główne czynniki wpływające na cenę transkrypcji wielojęzycznej:
- Dodatkowe funkcje transkrypcji: Niektórzy dostawcy pobierają dodatkowe opłaty za włączenie wybranych funkcji, takich jak wykrywanie encji.
- Audio wielokanałowe jest rozliczane za kanał: Po włączeniu use_multi_channel każdy kanał jest rozliczany niezależnie, więc nagranie dwukanałowe kosztuje mniej więcej dwa razy więcej niż jednokanałowe.
- Język nie zmienia stawki bazowej: Rozliczanie według długości oznacza, że wielojęzyczne STT może obsługiwać dowolny język przy tej samej stawce godzinowej, co ułatwia planowanie budżetu zespołom pracującym w kilku językach.
Więcej informacji o cenach ElevenLabs Speech to Text znajdziesz na naszej stronie z cennikiem.
Zacznij korzystać z ElevenAPI do dokładnej transkrypcji wielojęzycznej
ElevenAPI pozwala wdrożyć transkrypcję wielojęzyczną w dowolnym workflow produkcyjnym w zaledwie kilku krokach. Niezależnie od tego, czy transkrybujesz treści dla globalnych archiwów medialnych, obsługę klienta, spotkania lub wywiady badawcze, czy po prostu szukasz dokładnego rozpoznawania mowy w dziesiątkach języków, nasz wydajny silnik wielojęzycznego STT może pomóc.
Poznaj API ElevenAPI Speech to Text i sprawdź wszystkie jego możliwości albo utwórz konto ElevenLabs, aby już dziś zacząć transkrybować wielojęzyczne audio.
FAQ: transkrypcja wielojęzyczna

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.