
음성 AI 인프라: 2026년 스택 해설
- 게시일
- 최종 업데이트
음성 AI 인프라는 AI 에이전트가 통화를 듣고, 수행할 작업을 결정하며, 다른 시스템에서 작업을 실행하고, 음성으로 답변할 수 있게 하는 모델, 연결, 도구, 서비스의 집합입니다. ElevenLabs와 같은 선도적인 제공업체를 이용하면 이 모든 과정이 순식간에 이루어집니다.
프로덕션 음성 에이전트는 음성 인식, 턴 테이킹, 대규모 언어 모델, 오케스트레이션, 도구, 지식 검색, 음성 합성, 전화 통신, 모니터링을 포함하는 계층형 스택에서 작동합니다.
이 가이드는 실제로 작동하는 음성 에이전트의 AI 에이전트 아키텍처를 설명합니다. 각 섹션에서는 계층의 역할, 더 넓은 인프라에서 중요한 이유, 그리고 Eleven v4를 음성 계층의 예로 들어 ElevenAgents가 이를 구현하는 방식을 다룹니다.
음성 AI 인프라의 구성 방식
음성 에이전트는 오디오를 텍스트로 변환하고, 그 입력을 바탕으로 추론해 답변을 생성한 뒤, 고객이 듣는 오디오로 다시 변환합니다. 이러한 작업의 연쇄는 견고한 AI 에이전트 아키텍처 스택으로 구성됩니다.
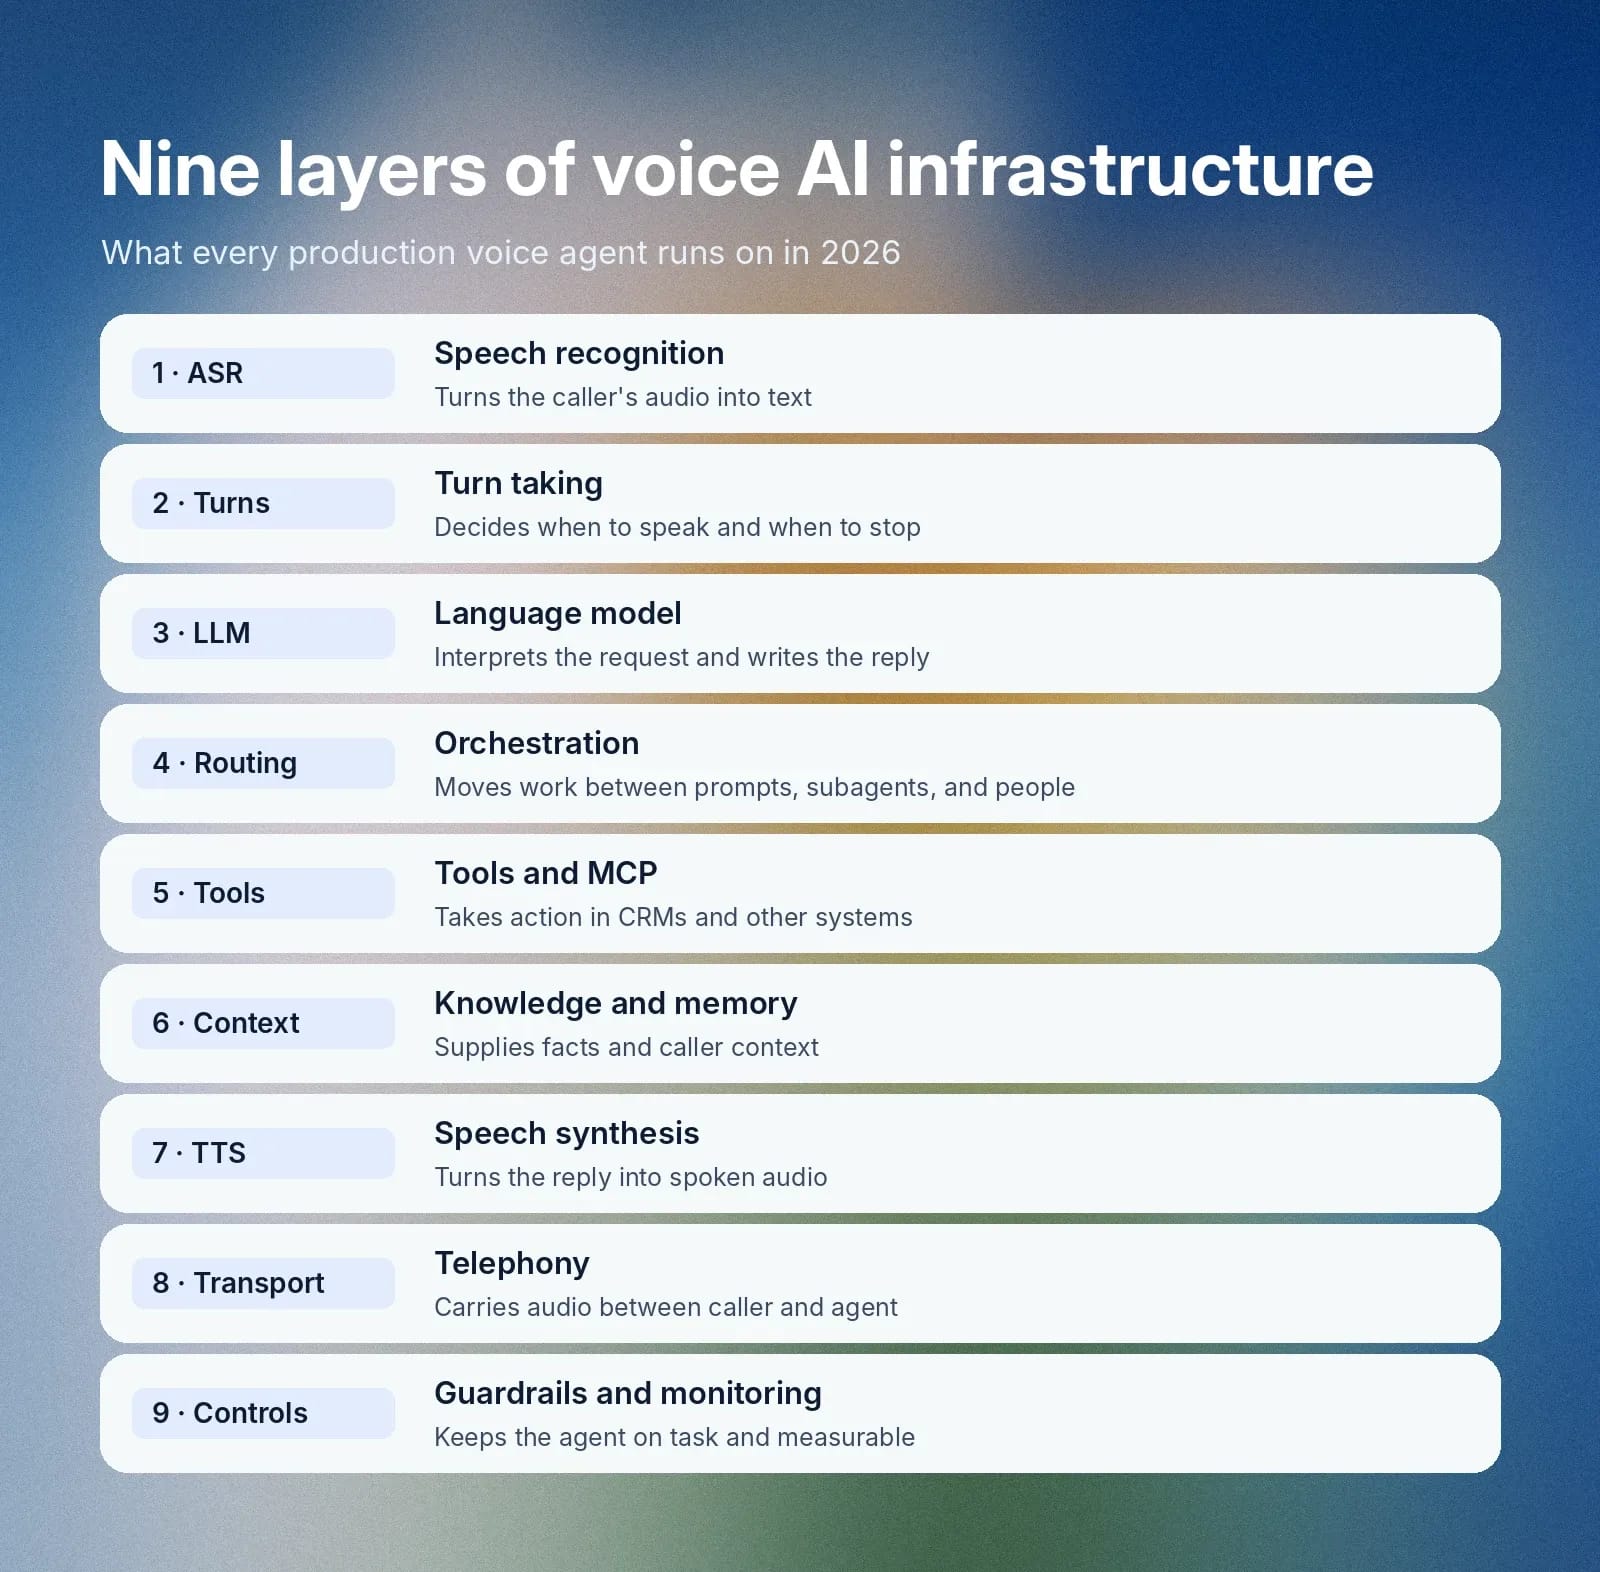
2026년 음성 AI 인프라를 구성하는 주요 계층은 다음과 같습니다.
- 음성 인식: 자동 음성 인식(ASR) 기술이 발신자의 오디오를 처리할 텍스트로 변환합니다.
- 턴 테이킹: 턴 테이킹은 발신자가 말을 마친 시점과 에이전트가 말을 멈출 시점을 판단해 더 자연스럽고 즉각적인 대화를 가능하게 합니다.
- 언어 모델: 필요한 컨텍스트를 가져온 후 전사된 요청을 해석하고 답변을 생성합니다.
- 오케스트레이션: AI 오케스트레이션 계층이 프롬프트, 하위 에이전트, 도구, 사람 사이로 대화를 라우팅합니다.
- 도구와 MCP: 작업을 수행할 수 있도록 에이전트를 CRM 플랫폼이나 컨택 센터 등의 외부 시스템에 연결합니다.
- 지식과 메모리: 검색 증강 생성을 통해 사실 정보와 발신자 컨텍스트를 제공합니다.
- 음성 합성: 텍스트 음성 변환을 사용해 텍스트 생성 응답을 오디오로 바꿉니다.
- 전송과 전화 통신: 에이전트와 발신자 간 오디오를 전달합니다.
- 가드레일, 테스트 및 모니터링: 에이전트가 업무에 집중하도록 하고 측정 가능하게 만듭니다.
이 구성 요소들은 함께 AI 에이전트와 통화 고객 간의 실시간 대화를 만듭니다.
음성 AI 아키텍처 다이어그램
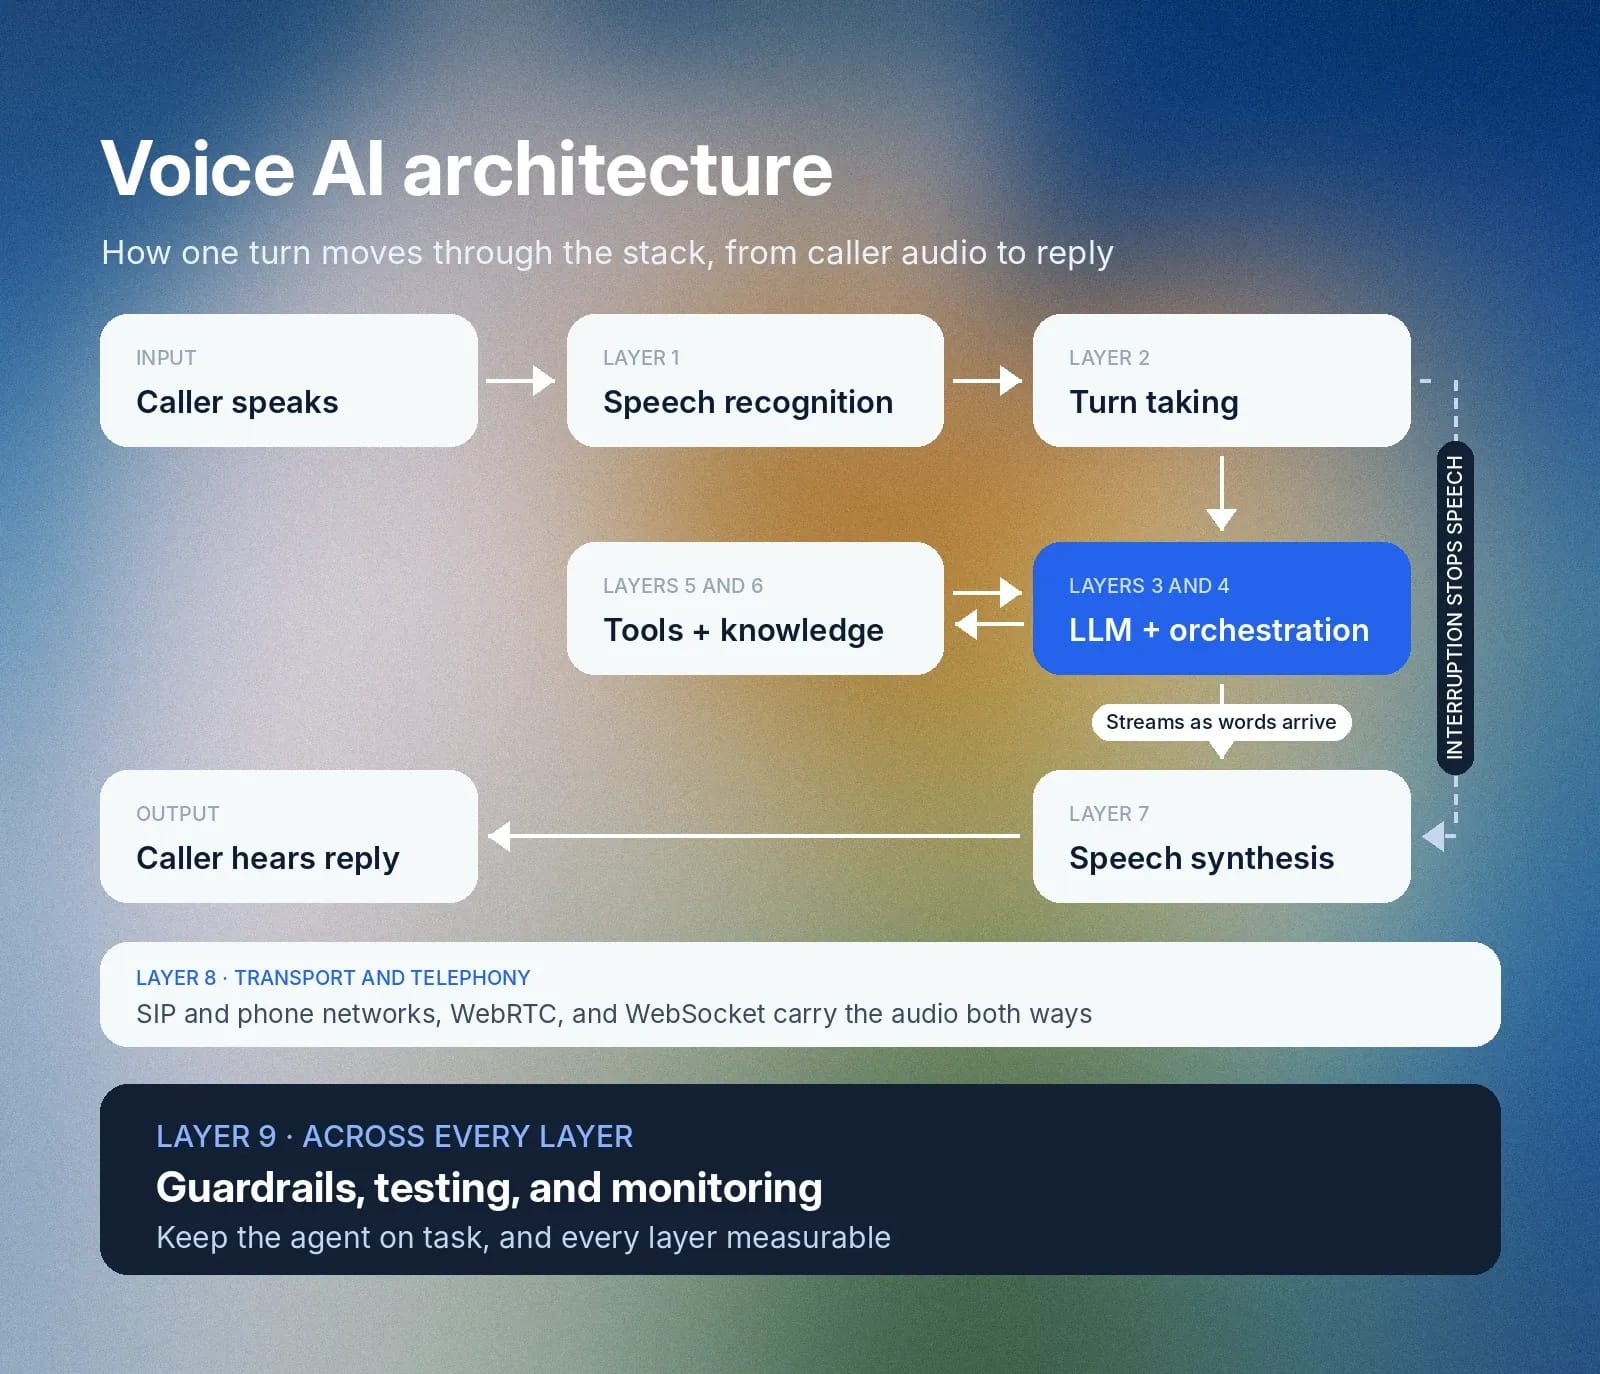
흐름은 직선이 아닙니다. ElevenAgents는 언어 모델에서 “충분한 단어와 쉼표”를 받으면 말하기를 시작하므로, 전체 응답이 완성되기 전에도 오디오 재생이 시작됩니다. 도구 호출과 검색은 턴 중간에 실행됩니다. 음성을 생성하는 동안에도 인터럽트가 들어올 수 있으며, 에이전트가 자연스럽게 처리합니다.
음성 AI 아키텍처를 구축하는 두 가지 방법
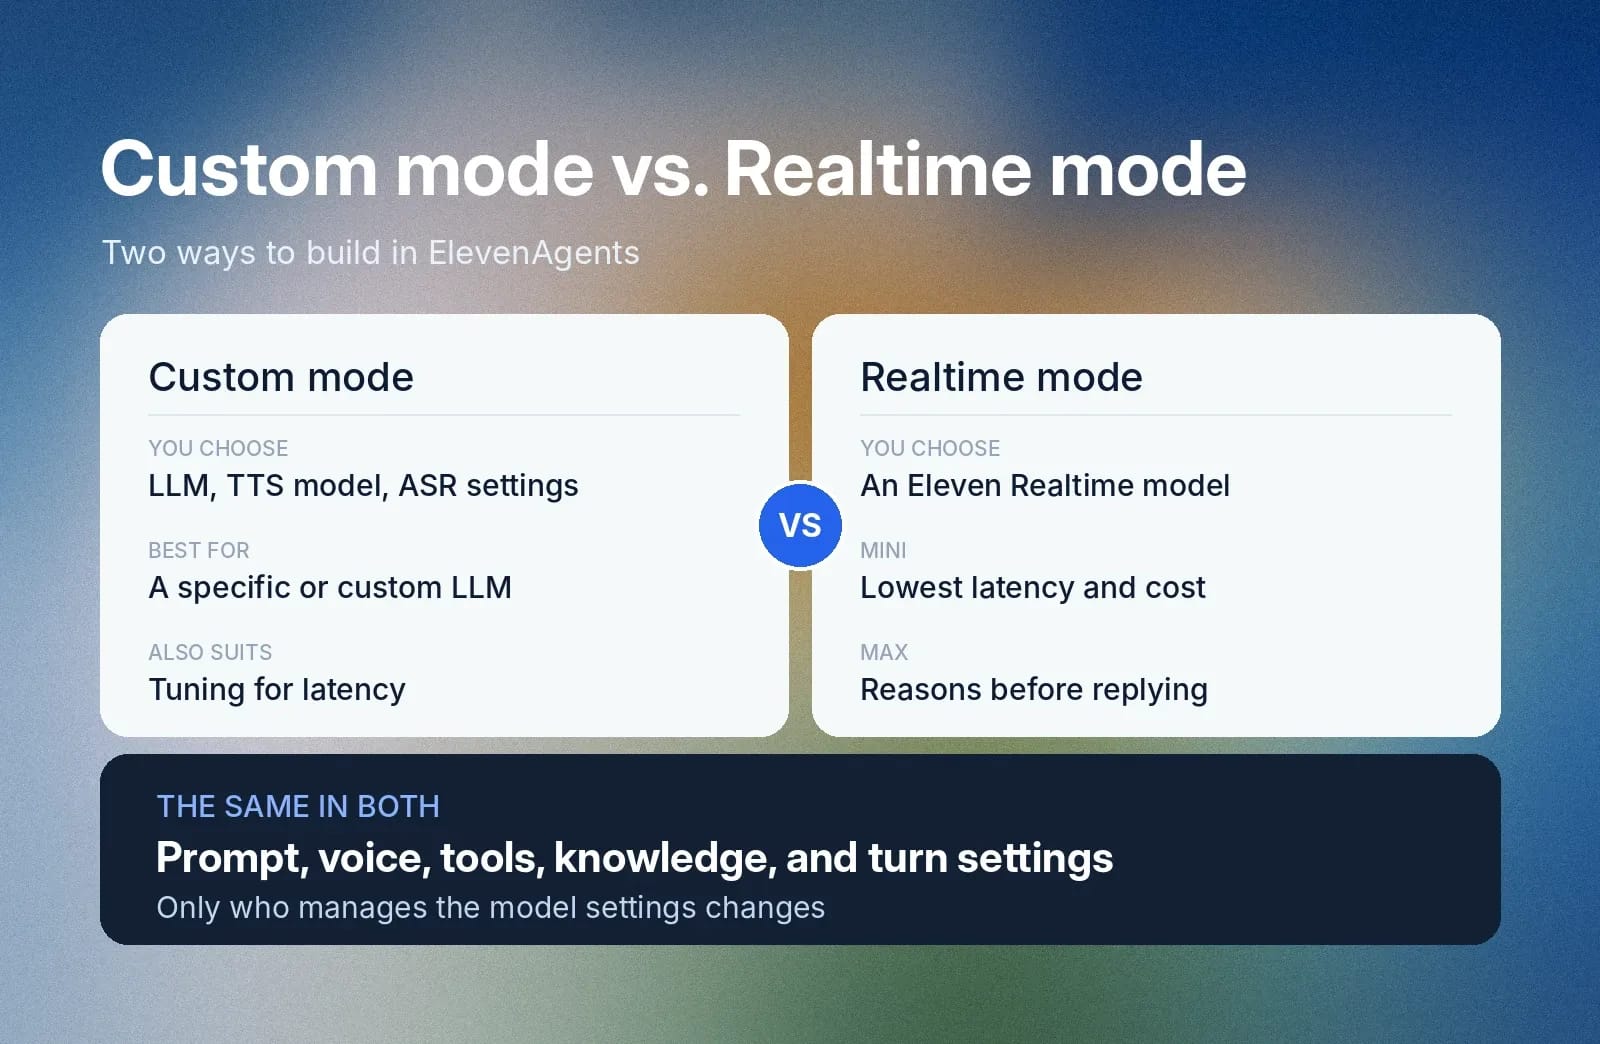
ElevenAgents는 두 가지 음성 모드를 지원합니다. Custom 모드에서는 언어 모델, 텍스트 음성 변환 모델, 음성 인식 설정을 직접 선택합니다.
Realtime 모드에서는 Eleven Realtime 모델을 선택하면 ElevenLabs가 해당 설정을 관리합니다. Eleven Realtime v1 Mini는 기본값이며 지연 시간과 비용이 가장 낮습니다. Eleven Realtime v1 Max는 응답 전에 추론하므로, 더 복잡한 지침과 다단계 도구 사용이 필요한 경우에 적합합니다.
시스템 프롬프트, 선택한 음성, 도구, 연결된 지식 베이스, 턴 설정은 두 모드에서 동일하게 작동합니다. 특정 언어 모델, 커스텀 LLM 또는 특정 TTS 모델(성능 또는 지연 시간 최적화를 위한)이 필요하다면 Custom 모드가 더 적합합니다.
음성 인식: 오디오를 텍스트로 변환하기
ASR 또는 음성 텍스트 변환이라고도 하는 음성 인식은 스택의 첫 번째 계층입니다.
역할
모델은 발신자가 말하는 동안 오디오를 지속적으로 전사합니다. 지속적으로 전사하면 문장이 끝나기 전부터 파이프라인의 나머지 부분이 작동을 시작할 수 있어 지연 시간을 줄입니다. 고급 모델은 강한 억양과 다양한 말하기 속도부터 배경 소음까지 처리합니다.
음성 AI 인프라에서 중요한 이유
전사 오류는 이후 모든 단계로 전파되므로 전사는 스택에서 가장 중요한 계층 중 하나입니다. 예약 참조 번호를 잘못 들으면 잘못된 고객 레코드를 처리하게 됩니다. 약 이름을 잘못 알아들으면 심각한 문제가 될 수 있습니다.
ElevenLabs는 헬스케어 신뢰 프레임워크에서 hydroxyzine과 hydralazine처럼 한 음절을 잘못 들었을 때 얼마나 큰 위험이 발생할 수 있는지 보여줍니다.
ElevenAgents의 구현 방식
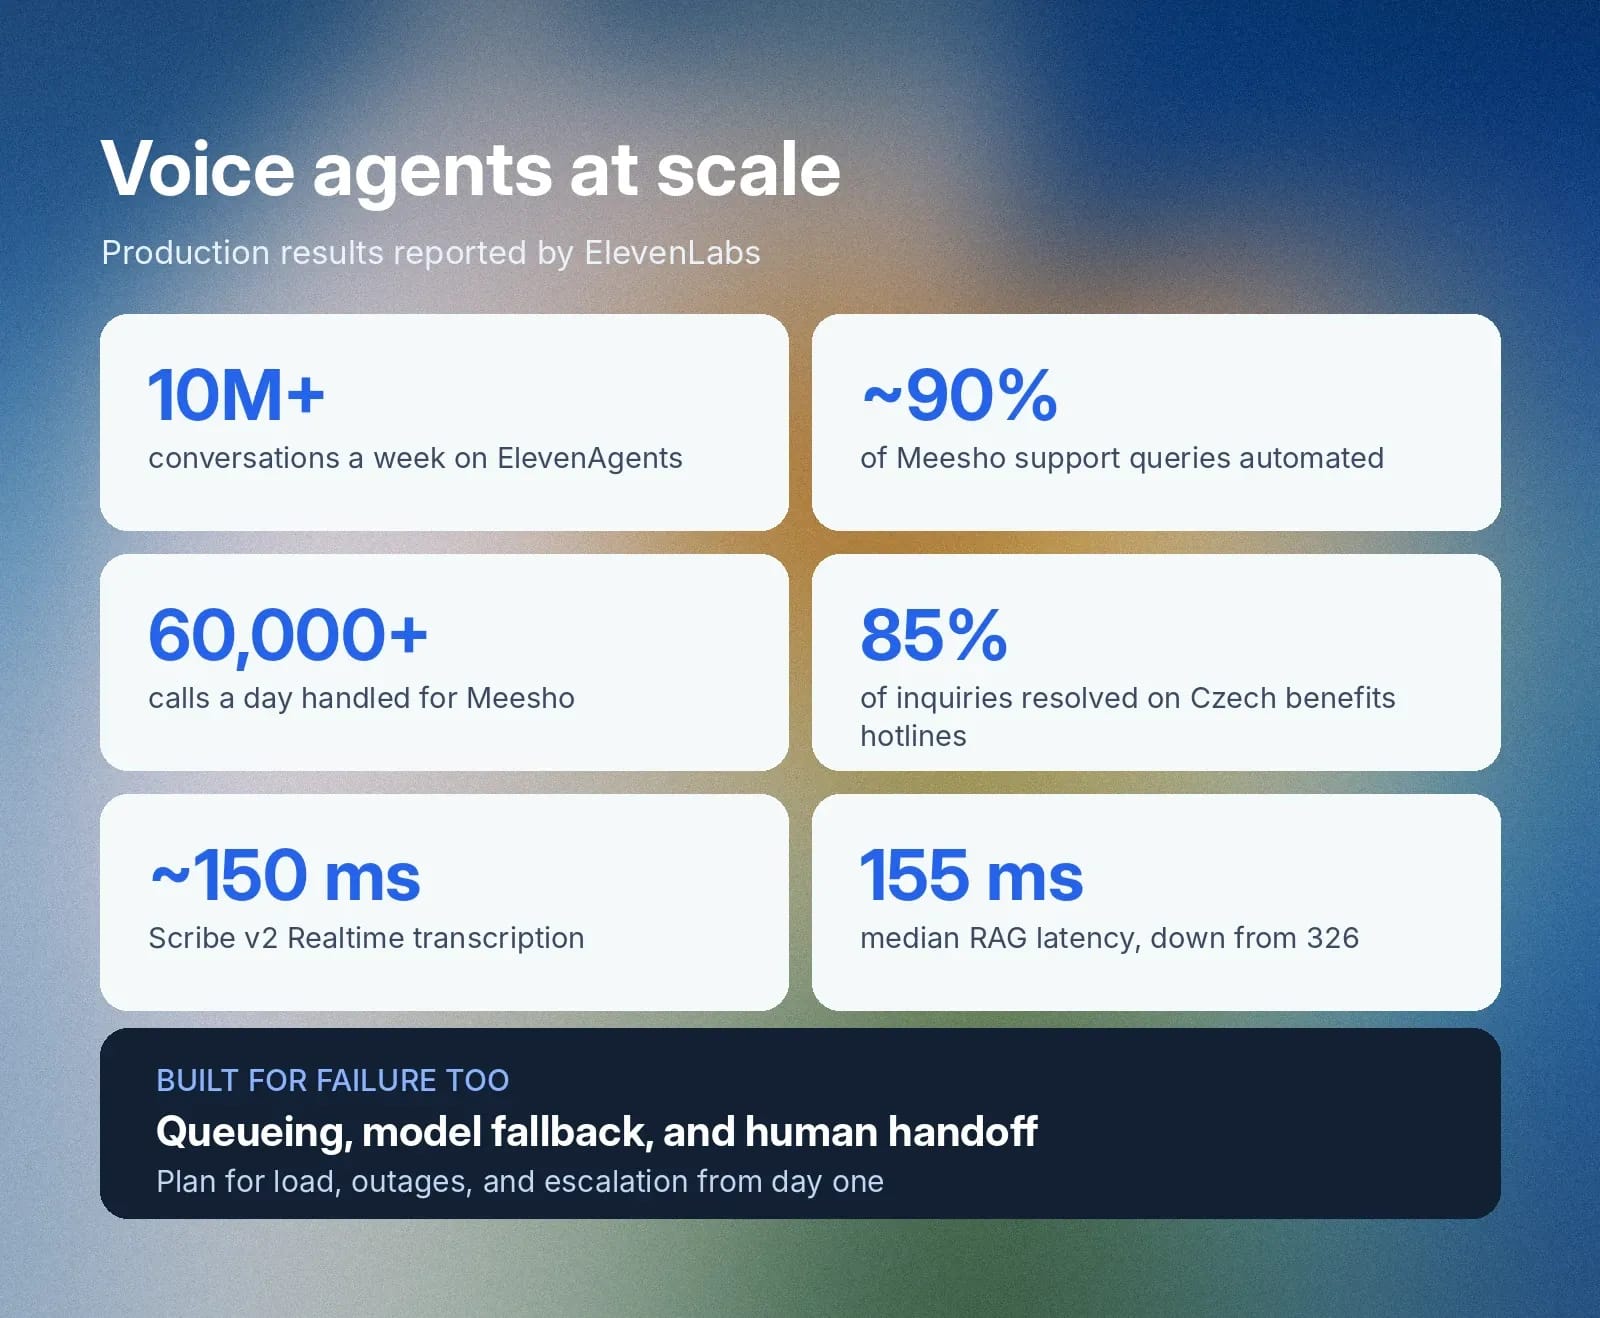
ElevenAgents는 약 150ms 안에 음성을 전사하는 Scribe v2 Realtime을 사용합니다. ElevenLabs는 이를 소음이 많은 환경, 다양한 억양, 이름·이메일·ID 같은 식별자를 처리하도록 학습시켰습니다. 30개 언어를 대상으로 한 FLEURS 다국어 벤치마크에서 ElevenLabs는 모든 저지연 ASR 모델 중 가장 낮은 단어 오류율을 보고했습니다.
에이전트 구성의 고급 섹션에서 이를 활성화할 수 있습니다. 앞서 언급한 백서에서 ElevenLabs는 Scribe v2 Medical이 공개 Eka Medical ASR 벤치마크에서 발행 시점 기준 7.0% 단어 오류율로 모든 모델을 앞선다고 밝혔습니다.
정확하고 빠른 전사는 상당한 지연 시간을 추가하지 않으면서 다음 계층에 필요한 깔끔한 입력을 제공합니다.
턴 테이킹: 말할 때와 멈출 때 알기
턴 테이킹은 에이전트가 응답할 때와 들을 때를 결정하는 규칙 집합입니다. 대화의 턴을 효과적으로 이해하고 이에 따라 행동하는 능력이 대화와 기존 IVR 전화 메뉴를 구분합니다.
역할
턴 테이킹 구성 요소가 음성 AI 인프라에 제공하는 기능은 다음과 같습니다.
- 음성 활동 감지(VAD): VAD는 수신 오디오를 초당 수십 회 음성 또는 무음으로 분류합니다.
- 턴 종료 감지: 억양, 리듬, 단어 컨텍스트를 사용해 발신자가 말을 마쳤는지 판단합니다.
- 바지인: 발신자가 에이전트를 중단시킬 수 있으며, 이때 에이전트는 사용자에게 계속 말할 기회를 주기 위해 발화를 멈춥니다.
- 백채널: 턴을 가져가지 않는 “네” 같은 짧은 호응입니다.
중요한 이유
사람 간 대화에서 화자 사이의 일반적인 간격은 약 200ms입니다. 너무 일찍 답하는 에이전트는 발신자의 말을 끊고, 너무 오래 기다리면 통화가 끊겼거나 반응하지 않는 듯한 침묵이 생깁니다.
예를 들어 발신자가 “금요일 오후로 예약하고 싶은데…”라고 말하고 멈춘 상황을 생각해 보세요. 무음 타이머는 그 멈춤에서 응답해 조건을 놓칩니다. 단어와 리듬을 읽는 모델은 사용자가 “오후 3시부터 5시 사이는 바빠서 안 됩니다.”라고 끝까지 말할 수 있도록 기다립니다.
한 에이전트는 발신자의 의도를 잘못 파악해 잘못된 시간에 회의를 예약합니다. 반면 효과적인 턴 테이킹 기능을 갖춘 다른 에이전트는 지정된 시간을 피하도록 합니다.
ElevenAgents의 구현 방식
ElevenAgents는 무음 타이머에만 의존하지 않고 억양, 리듬, 단어 컨텍스트를 분석하는 독점 턴 테이킹 모델을 실행합니다. 발신자가 인터럽트하면 에이전트를 멈추는 신호가 200ms 이내에 도착합니다.
ElevenLabs는 ElevenAgents의 Eleven v4 Turbo에서 요청부터 들을 수 있는 음성까지의 중앙값을 약 150ms로 측정했습니다.
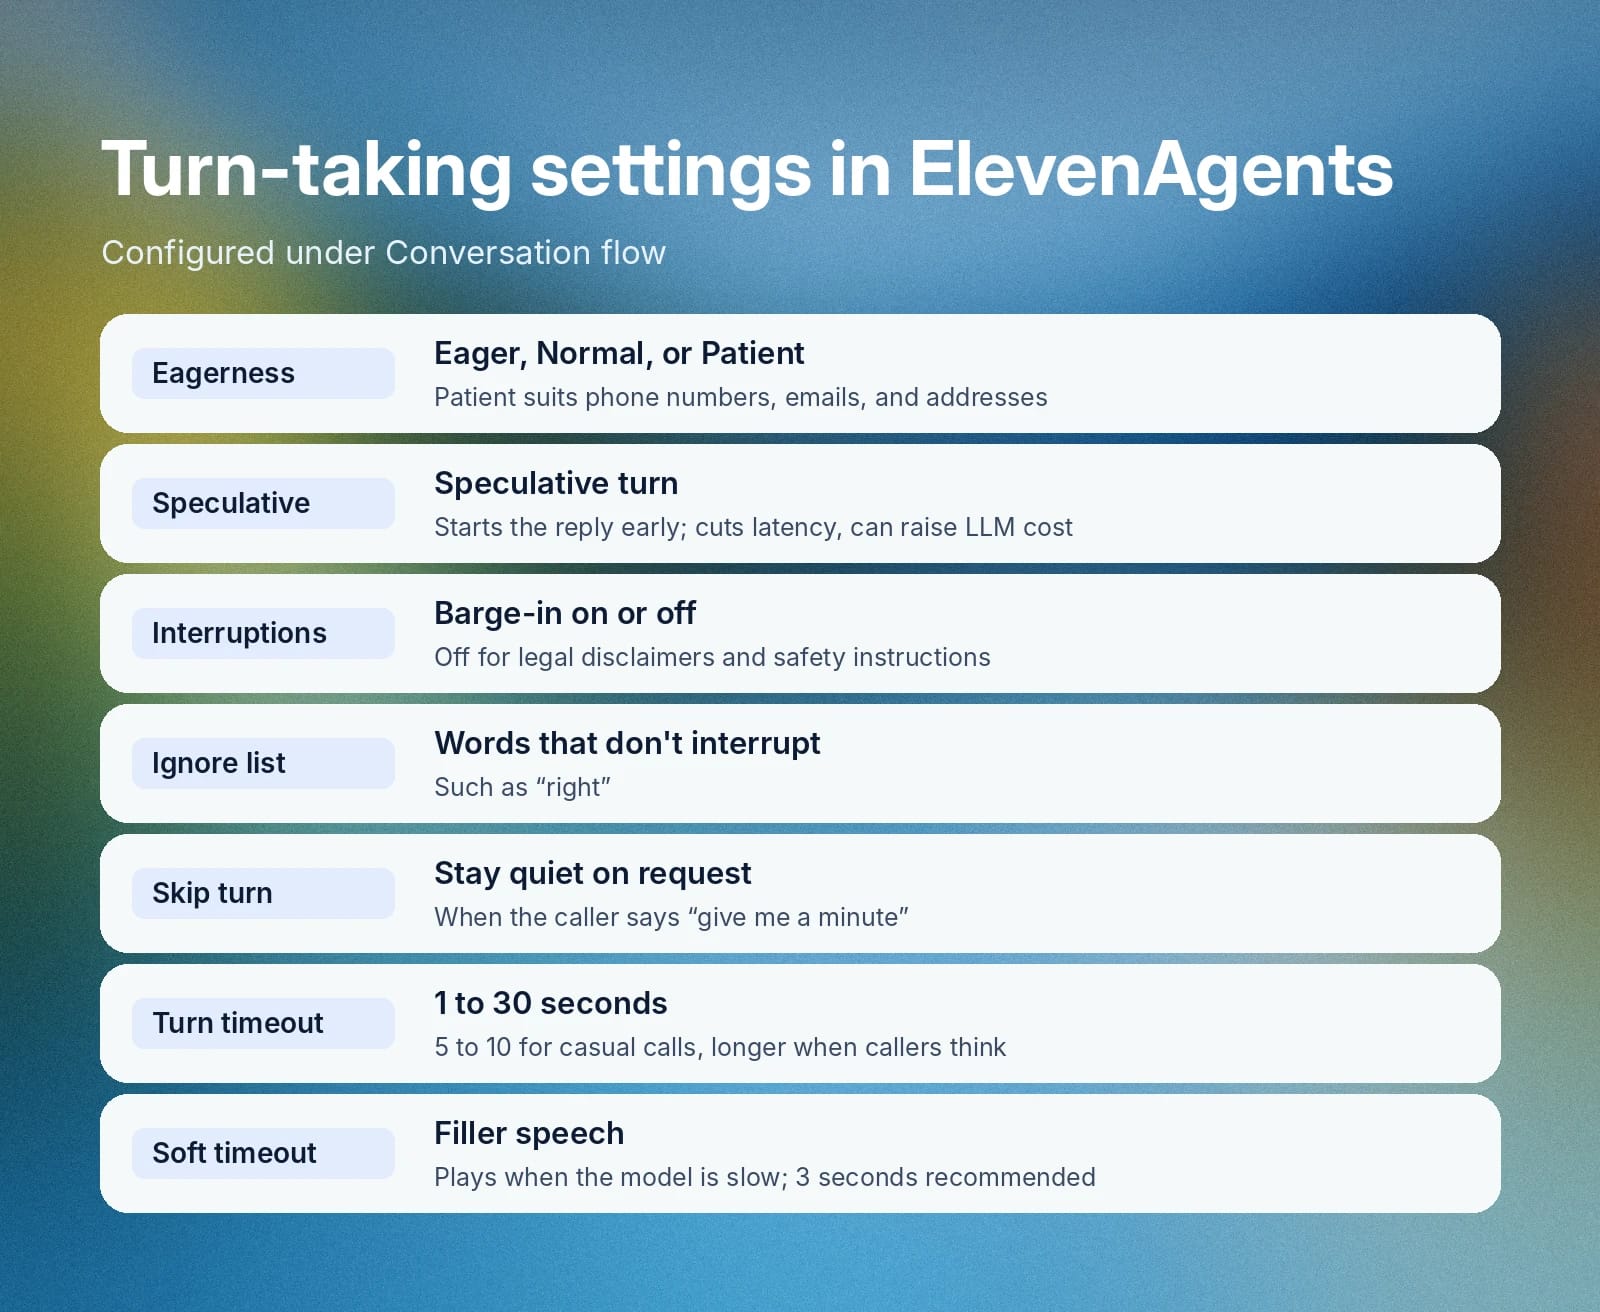
대화 흐름을 통해 동작을 구성할 수 있습니다.
설정
제어하는 항목
턴 적극성
Eager는 가장 이른 시점에 응답합니다. Normal은 균형 잡힌 기본값입니다. Patient는 더 오래 기다리며 전화번호, 주소, 이메일에 적합합니다.
예측 턴
발신자가 말을 마쳤다고 확인되기 전에 언어 모델 응답을 시작합니다. 지연 시간은 줄이지만 LLM 비용은 높아질 수 있습니다.
인터럽트
법적 고지나 안전 안내처럼 모든 단어를 들어야 하는 경우에는 끄세요.
무시 목록
에이전트를 중단시키지 않아야 하는 “맞아요” 같은 단어입니다.
턴 건너뛰기 도구
발신자가 “잠시만요”라고 말할 때 에이전트가 조용히 있도록 합니다.
턴 타임아웃
1~30초간 무음이 이어지면 턴을 가져갑니다. 일반 대화에는 5~10초를, 발신자에게 생각할 시간이 필요한 경우에는 10~30초를 사용하세요.
소프트 타임아웃
모델이 느릴 때 “음… 네.” 같은 필러 음성을 재생합니다. 범위는 0.5~8초이며, 3초를 권장합니다.
시끄러운 환경 감지
배경 음성을 감지하고 발신자에게 더 조용한 곳으로 이동해 달라고 요청하는 엔터프라이즈 설정입니다. 대화당 최대 한 번만 요청합니다.
워크플로는 통화 중간에 턴 적극성을 변경할 수 있습니다. 클라이언트는 사용자가 말하고 있을 확률을 0~1로 나타내는 vad_score 이벤트도 받습니다.
잘 조정된 턴 테이킹은 발신자가 에이전트를 주의 깊다고 느낄지, 성급하다고 느낄지를 결정합니다. 개념에 관해 자세히 알아보려면 턴 테이킹 전체 가이드를 참고하세요.
언어 모델: 추론과 응답 생성
대규모 언어 모델(LLM)은 추론 계층입니다. 전사본, 지침, 지금까지의 대화를 읽고 응답을 작성하거나 도구 호출 여부를 결정합니다.
역할
스크립트형 음성 봇은 소수의 명령만 인식합니다. LLM은 다양하게 표현된 요청을 해석하고, 턴 전반에 걸쳐 컨텍스트를 유지하며, 정보를 검색하거나 이관할 시점을 결정합니다.
중요한 이유
모델마다 추론 깊이, 속도, 비용이 다릅니다. 실시간 음성 대화에서는 응답 시간이 답변 품질만큼 중요하므로 모델 선택은 지연 시간과 비용 모두에 관한 결정입니다.
ElevenAgents의 구현 방식
ElevenAgents는 Google, OpenAI, Anthropic 모델과 ElevenLabs가 호스팅하는 오픈 모델을 하나의 인터페이스로 제공합니다. 엔드포인트를 지정하고 자격 증명을 시크릿으로 저장해 자체 LLM을 연결할 수도 있습니다. ElevenLabs는 타사 LLM 비용을 제공업체의 공개 요율 그대로 마진 없이 청구합니다.
하위 에이전트별로 모델을 선택할 수 있습니다. 엔터프라이즈 대화형 에이전트 플레이북 2권에서는 복잡한 추론에는 고성능 모델을 사용하고, 의도 분류나 FAQ 같은 작업에는 더 저렴한 저지연 모델을 사용할 것을 권장합니다.
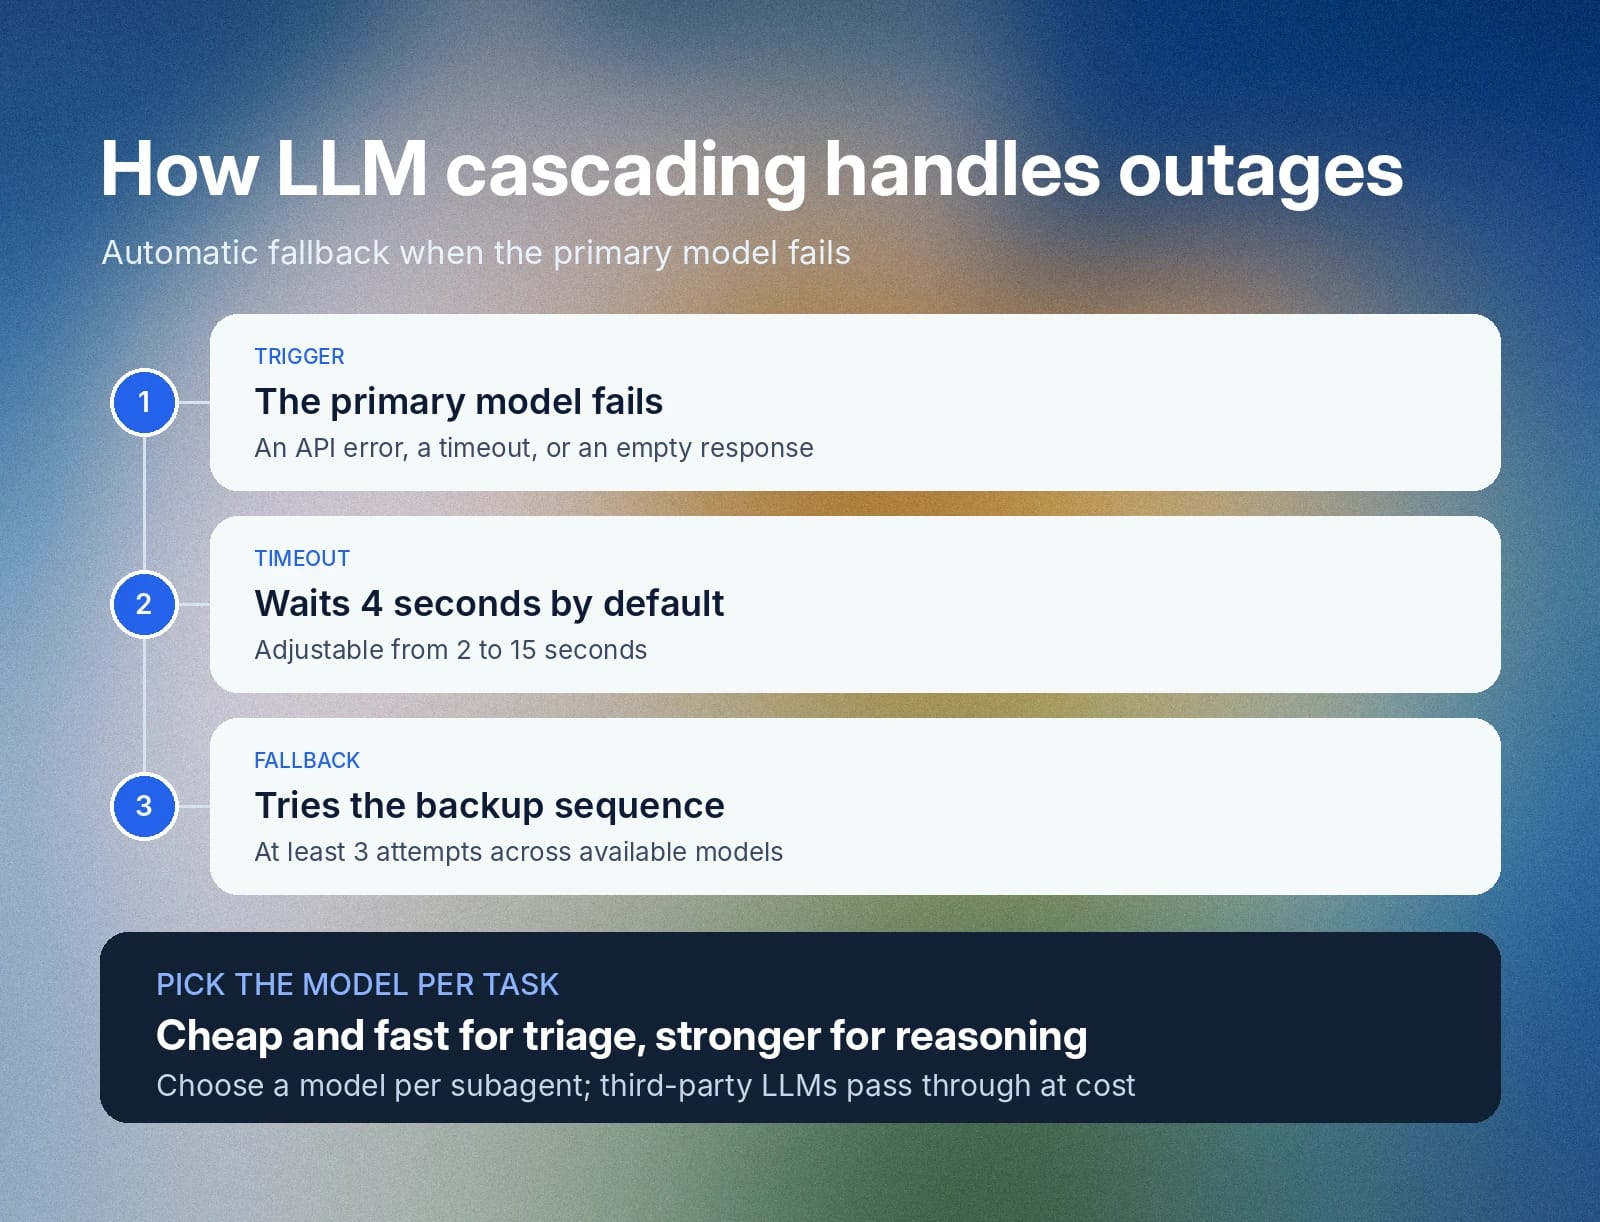
제공업체에는 장애가 발생할 수 있습니다. LLM 캐스케이딩은 이를 처리합니다. 기본 모델이 API 오류를 반환하거나 타임아웃되거나 빈 응답을 보내면 ElevenAgents가 백업 순서를 시도합니다. 기본 모델에서 백업 모델로 전환하는 기본 타임아웃은 4초이며 2~15초로 조정할 수 있고, 시스템은 사용 가능한 모델 전반에서 최소 3회 시도합니다.
기본 모델로 사용되는 커스텀 LLM은 자체 백업 순서를 정의하지 않는 한 최소 3회 재시도합니다. 작업별로 적합한 모델을 선택하면 에이전트의 속도와 비용 효율을 모두 유지할 수 있습니다.
오케스트레이션: 에이전트와 사람 간 작업 라우팅
에이전트 오케스트레이션은 작업 완료에 관여하는 프롬프트, 하위 에이전트, 도구, 사람을 조정합니다. 통화의 모든 지점에서 다음에 일어날 일을 결정합니다.
역할
하나의 긴 프롬프트를 사용하는 단일 에이전트는 책임이 늘어날수록 관리하기 어려워집니다. 오케스트레이션은 작업을 각자 지침, 모델, 도구를 가진 단계로 나누고 발신자를 그 사이로 이동시킵니다.
중요한 이유
작은 프롬프트는 상호작용마다 불러오는 텍스트가 적어 테스트하기 쉽고 실행 비용도 낮습니다. 흐름을 분리하면 저렴한 모델이 트리아지와 FAQ를 처리하고, 요청에 필요할 때만 더 강력한 모델로 이관할 수 있습니다.
ElevenAgents의 구현 방식
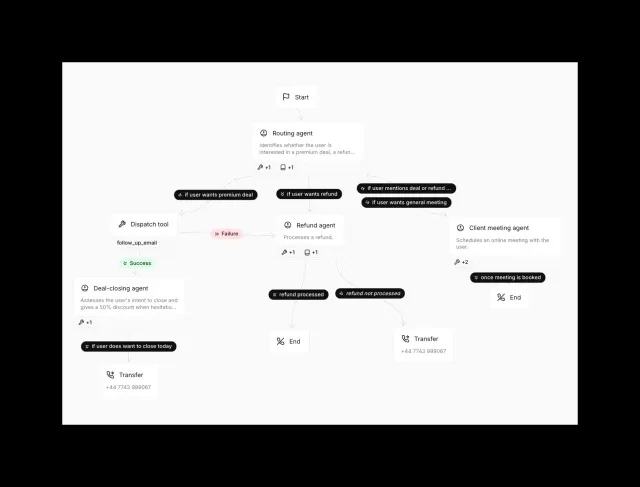
ElevenAgents의 워크플로는 분기형 대화 그래프를 만드는 시각적 빌더입니다.
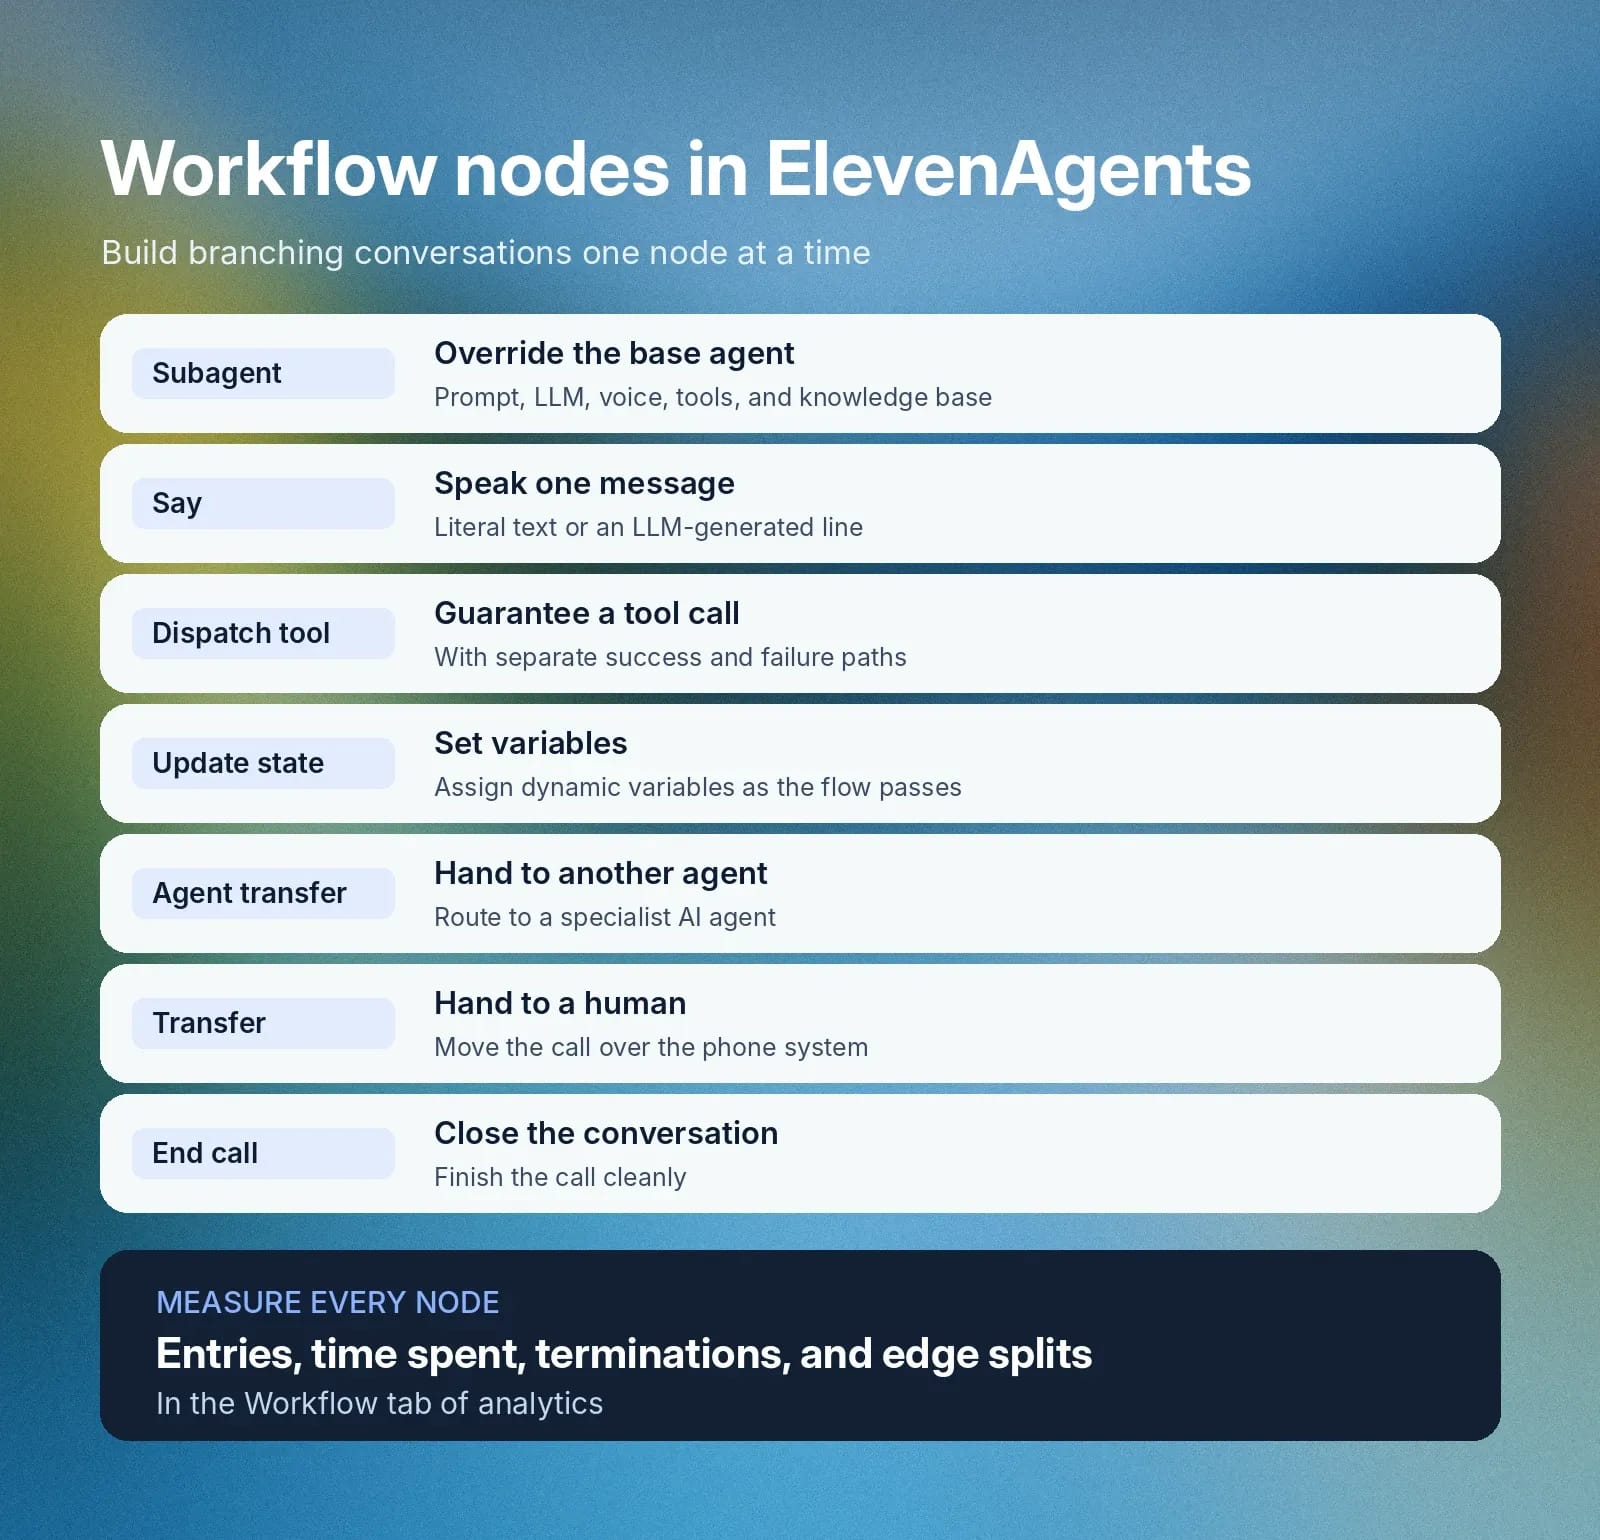
노드 유형은 다음과 같습니다.
- 하위 에이전트: 프롬프트, LLM, 음성, 도구, 지식 베이스를 포함해 기본 에이전트를 변경하거나 재정의합니다.
- 말하기: 리터럴 텍스트 또는 LLM 생성 문장으로 하나의 메시지를 말합니다.
- 도구 디스패치: 성공 및 실패 경로를 분리해 도구 호출을 보장하는 전용 단계입니다.
- 상태 업데이트: 흐름이 진행되며 동적 변수를 할당합니다.
- 에이전트 이관: 통화를 다른 에이전트에게 넘깁니다.
- 번호로 이관: 전화 시스템을 통해 AI 에이전트의 통화를 사람에게 넘깁니다.
- 통화 종료: 대화를 종료합니다.
노드 간 엣지에는 LLM이 실시간으로 평가하는 자연어 조건이 포함됩니다. 지원 흐름은 빠른 모델의 라우팅 하위 에이전트로 시작해 청구 관련 질문을 더 강력한 모델의 청구 하위 에이전트로 보내고, 발신자가 사람을 요청하면 번호로 이관 노드로 마무리할 수 있습니다. 출시 후 분석의 Workflow 탭에서는 각 노드의 진입 수, 평균 소요 시간, 종료, 엣지 분포를 확인할 수 있습니다.
오케스트레이션은 단일 에이전트를 노드별로 설계, 측정, 개선할 수 있는 시스템으로 바꿉니다.
도구와 MCP: 에이전트가 행동하게 하기
도구 호출이라고도 하는 함수 호출은 에이전트가 기술 스택에 연결한 외부 소프트웨어에 작업을 요청할 수 있게 합니다.
질문에 답하는 인터페이스를 작업을 완료하고 다른 도구와 상호작용할 수 있는 에이전틱 AI 시스템으로 전환합니다.
역할
내일 예약을 금요일로 옮겨 달라는 발신자를 생각해 보세요. 에이전트는 예약을 조회하고, 금요일의 가능 여부를 확인하고, 일정 시스템을 업데이트한 뒤 변경 사항을 확인합니다. 각 단계는 작업을 수행하는 도구 호출입니다.
중요한 이유
도구를 통해 대화가 실제 결과를 만듭니다. 각 도구에는 명확한 입력과 출력이 필요하며, 에이전트는 발신자에게 완료되었다고 알리기 전에 호출이 성공했는지 알아야 합니다.
ElevenAgents의 구현 방식
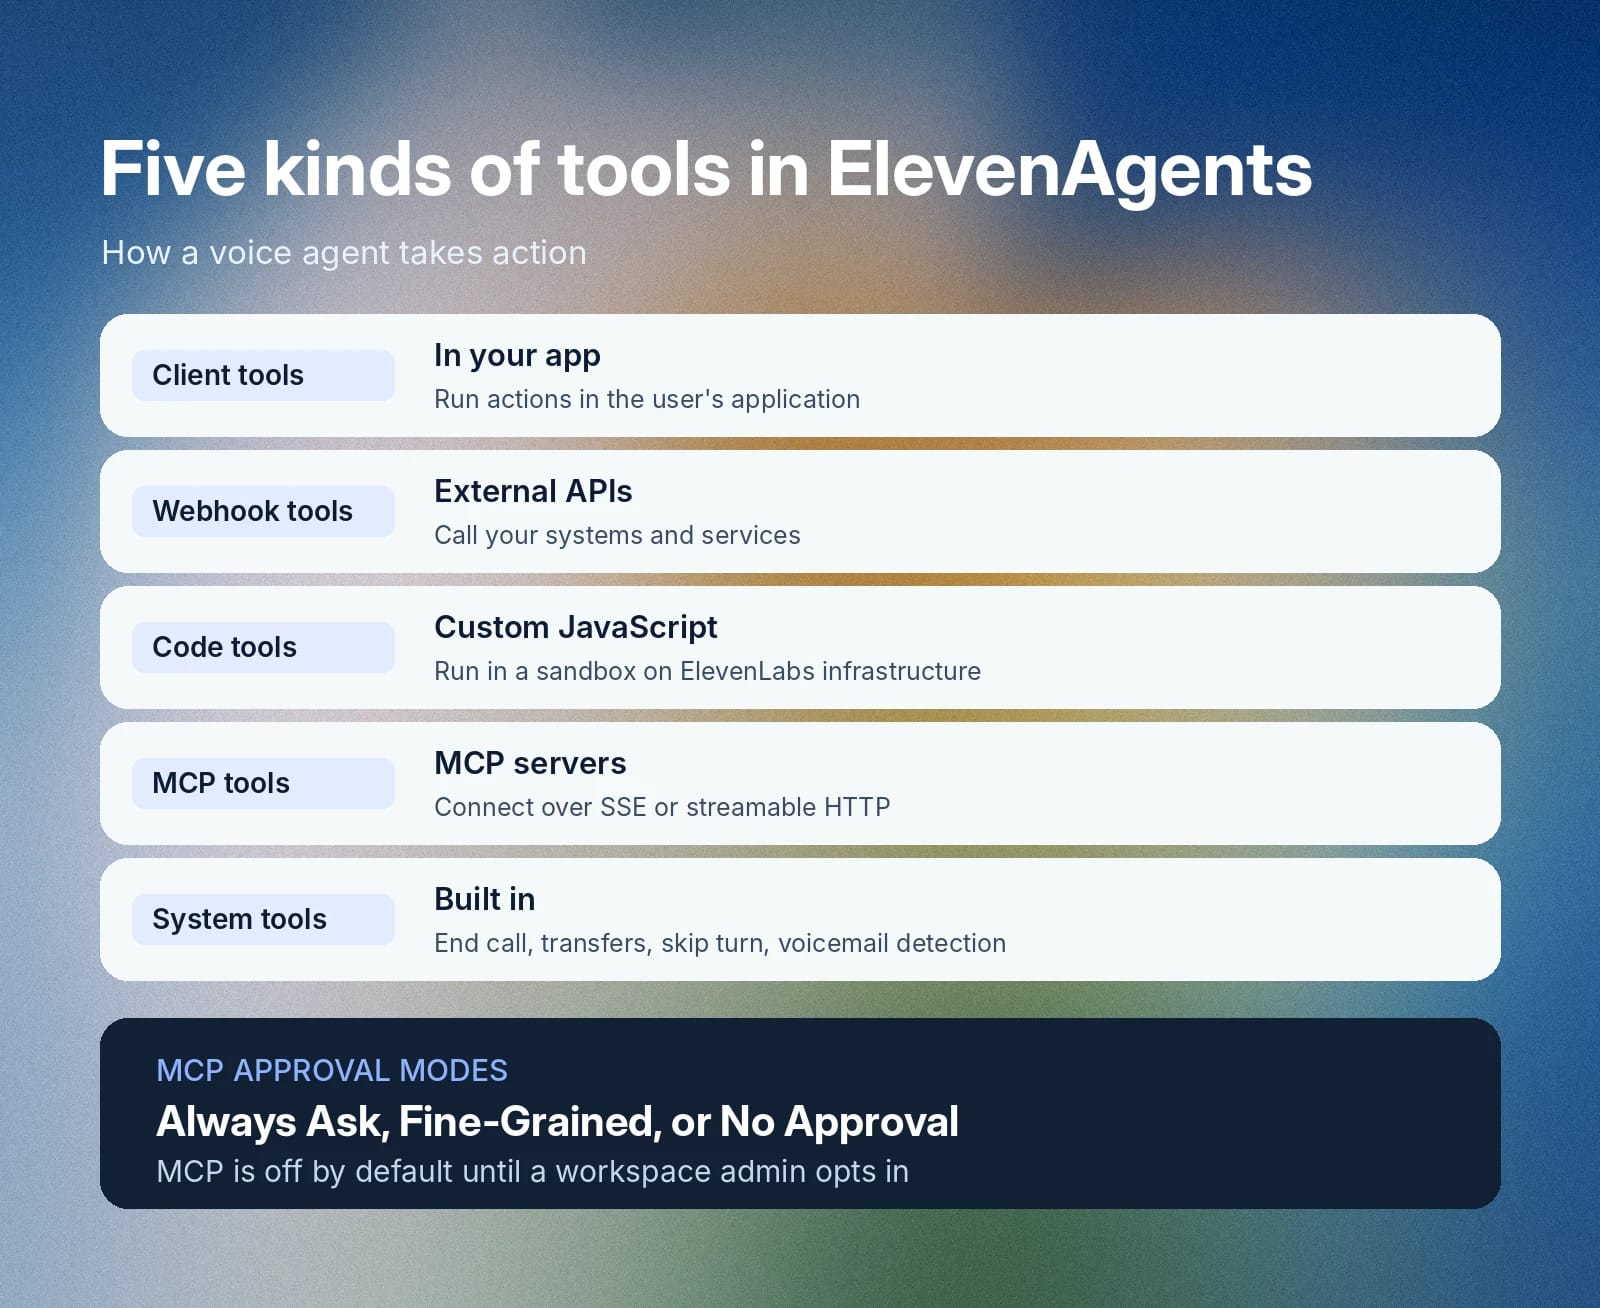
ElevenAgents는 사용자 애플리케이션에서 실행되는 클라이언트 도구, 외부 API를 호출하는 웹훅 도구, ElevenLabs 인프라의 샌드박스에서 커스텀 JavaScript를 실행하는 코드 도구, MCP 도구, 기본 제공 시스템 도구를 지원합니다.
시스템 도구에는 통화 종료, 언어 감지, 에이전트 이관, 번호로 이관, 턴 건너뛰기, 키패드 터치음 재생, 음성사서함 감지가 포함됩니다. 도구 실행 중 앰비언트 오디오를 추가하고, 실행 중 발신자가 인터럽트할 수 있는지도 제어할 수 있습니다.
모델 컨텍스트 프로토콜(MCP)은 애플리케이션이 언어 모델에 컨텍스트와 도구를 제공하는 방식에 관한 개방형 표준입니다. ElevenAgents는 SSE와 스트리밍 가능한 HTTP를 통해 MCP 서버에 연결합니다. 모든 워크스페이스에서 MCP는 기본적으로 비활성화되어 있으므로, 먼저 워크스페이스 관리자가 옵트인해야 합니다. 그런 다음 서버별로 Always Ask, Fine-Grained Tool Approval, No Approval 중 승인 모드를 선택합니다.
client_tool_call 및 mcp_tool_call 같은 클라이언트 이벤트는 도구 활동을 보고하며, MCP 이벤트 보고서는 로딩, 승인 대기, 성공, 실패의 네 가지 상태를 제공합니다. 신뢰할 수 있는 도구는 에이전트가 현실 세계에서 작업할 수 있게 하고, 명확한 승인 규칙은 그 권한을 통제합니다.
지식과 메모리: 사실 정보와 발신자 컨텍스트
검색 증강 생성(RAG)은 내부 사실 데이터베이스나 더 광범위한 고객 이력 로그 같은 자체 콘텐츠에서 얻은 사실을 에이전트에 제공합니다. 메모리와 개인화는 에이전트가 발신자에 관한 컨텍스트를 이해하게 하여 비즈니스에 맞는 개인화와 활용도를 높입니다.
역할
언어 모델에는 학습 데이터 마감 시점이 있으며, 문서나 기록에 접근할 수 없습니다. RAG는 쿼리마다 지식 베이스를 검색하고, 가장 관련성 높은 구절을 가져와 모델에 제공함으로써 유용한 응답에 필요한 추가 컨텍스트를 제공합니다.
개인화 데이터는 누가 전화했는지와 그 사람에게 관련된 정보가 무엇인지 에이전트에 알려 줍니다.
중요한 이유
승인된 콘텐츠에 응답을 근거로 두면 답변의 정확성을 유지할 수 있습니다. 검색이 추가하는 매 밀리초는 고객이 더 기다려야 하는 시간이므로 검색 속도도 중요합니다. 개인화 기능은 새 세션 시작 시 에이전트가 CRM 기록을 보유하므로, 발신자가 여러 통화에서 정보를 반복하지 않아도 되게 합니다.
ElevenAgents의 구현 방식
파일(PDF, DOCX, TXT, MD, HTML, EPUB, 각 최대 20MB), URL 또는 붙여넣은 텍스트로 지식 베이스에 문서를 추가할 수 있습니다. 추출된 텍스트가 약 300,000자까지 프롬프트에 들어가면 문서는 전체 컨텍스트를 사용합니다. 더 큰 문서는 RAG를 사용합니다. 검색은 매 턴 또는 필요할 때 실행할 수 있으며, 기본 사용 모드는 Auto로, RAG가 활성화되어 있고 문서가 인덱싱되면 RAG를 사용합니다.
ElevenLabs는 검색 속도를 직접 개선합니다. 엔지니어링 문서인 How we reduced RAG latency에서는 ElevenLabs가 이미 운영하는 인프라에서 자체 호스팅한 모델을 사용해 RAG 중앙값 지연 시간을 326ms에서 155ms로 줄인 사례를 설명합니다.
발신자 컨텍스트를 위해 ElevenAgents는 메시지, 시스템 프롬프트, 도구에 값을 채우는 {{ var_name }} 형식의 동적 변수를 사용합니다. Twilio, SIP 트렁크, WhatsApp, SMS를 통한 인바운드 통화의 경우 대화 시작 전에 서버에서 시작 데이터를 가져올 수 있습니다. 서버는 caller_id로 발신자를 조회하고 CRM 등의 변수 값을 최대 256KB 응답으로 반환합니다. 통화 후에는 통화 후 웹훅이 평가 결과와 추출 데이터를 외부 시스템으로 전달합니다.
검색과 개인화를 함께 사용하면 에이전트는 올바른 사실과 올바른 발신자 정보를 모두 확보합니다.
음성 합성: 에이전트에게 목소리 부여하기
텍스트 음성 변환(TTS)은 언어 모델의 응답을 음성 오디오로 바꿉니다. 발신자가 실제로 듣는 계층입니다.
역할
모델은 자연스러운 속도와 감정 표현으로 텍스트를 오디오로 변환합니다. 실시간 통화에서는 전체 응답이 생성되기 전에 재생이 시작되도록 오디오를 청크 단위로 스트리밍합니다.
중요한 이유
지연 시간과 전달 방식은 모두 발신자의 통화 평가에 영향을 줍니다. 실시간 작업에서는 오디오 생성 시간과 발신자가 첫 소리를 듣기까지 걸리는 시간이 중요합니다. 이름, 약물명, 전문 용어도 정확히 발음해야 하며, 그렇지 않으면 발신자가 에이전트에 대한 신뢰를 잃게 됩니다.
Eleven v4가 음성 계층을 지원하는 방식
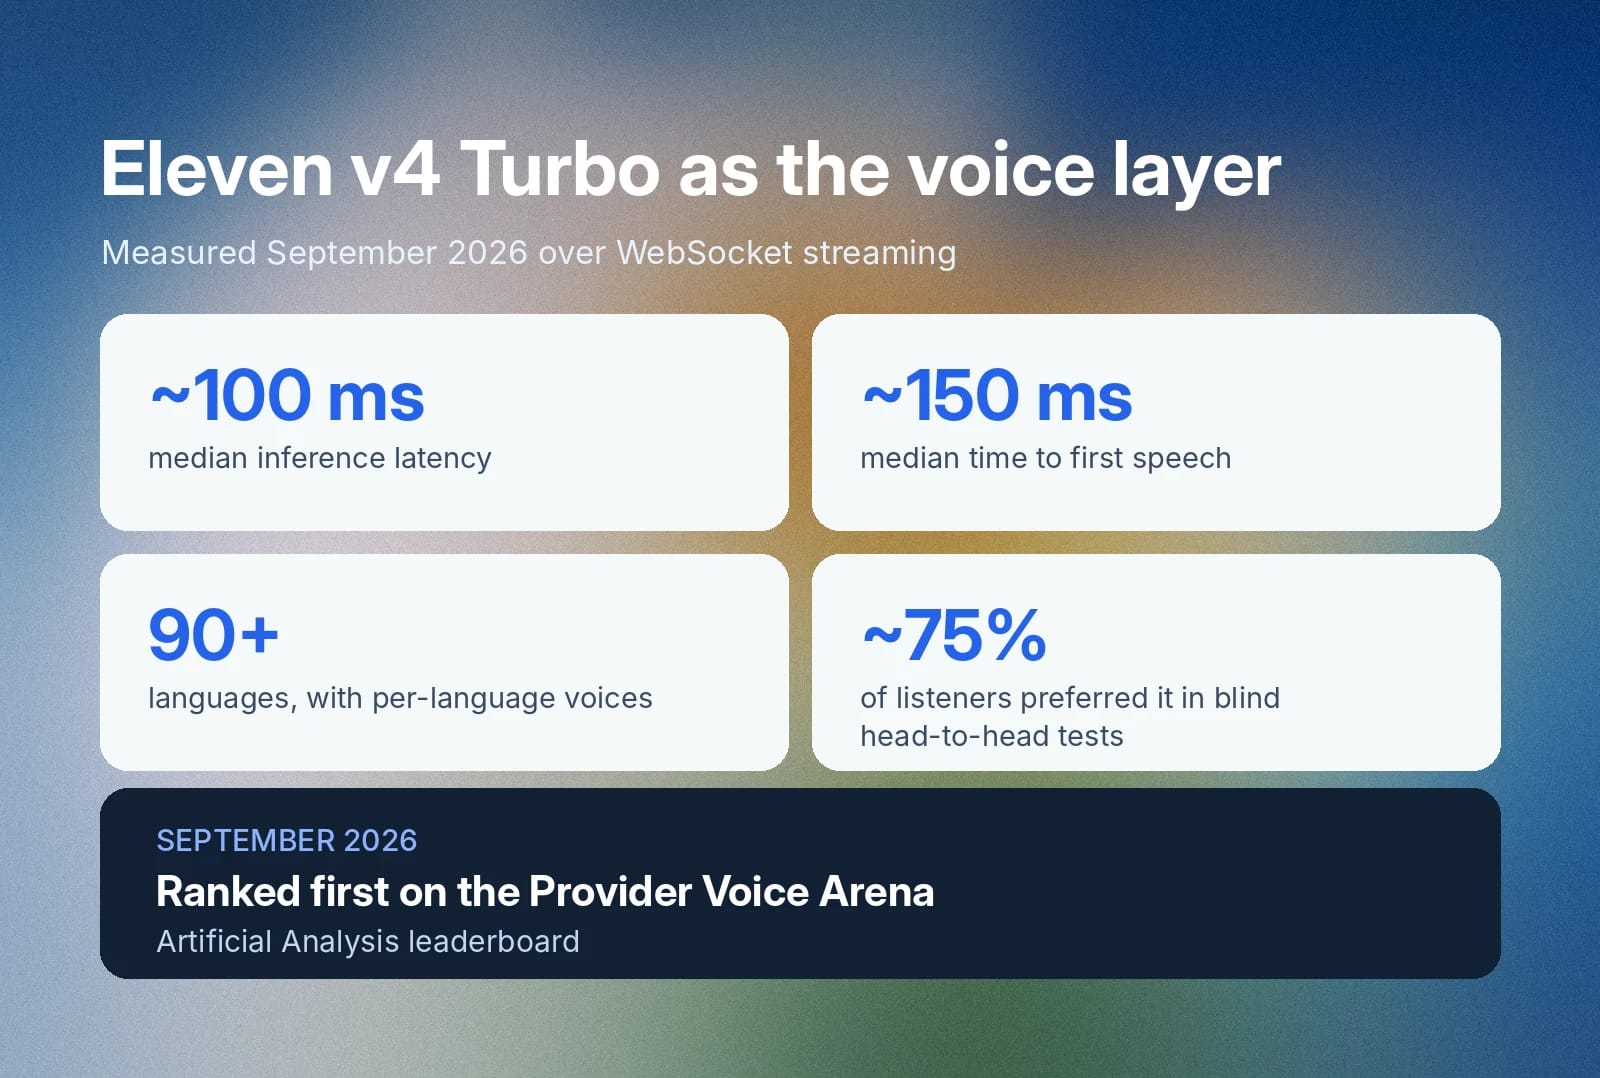
Eleven v4는 완전히 새로운 아키텍처로 구축된 ElevenLabs의 가장 감정 표현력이 뛰어난 텍스트 음성 변환 모델입니다. Eleven v4 Turbo는 에이전트와 같은 실시간 사용을 위한 저지연 버전으로, 하나의 시스템으로 ElevenAgents와 최적화되었습니다.
Eleven v4 Turbo
수치
중앙값 추론 지연 시간
약 100ms
첫 음성까지의 중앙값 시간
약 150ms
언어
90+
ElevenLabs는 네트워크 지연 시간을 제외한 WebSocket 스트리밍 환경에서 2026년 9월 지연 시간 수치를 측정했습니다. Eleven v4는 2026년 9월 Artificial Analysis Provider Voice Arena Leaderboard에서 1위를 차지했으며*, 블라인드 테스트에서 청취자의 약 75%가 선호했습니다**.
* Artificial Analysis, Provider Voice Arena Leaderboard, 2026년 9월
** Cartesia Sonic 3.6, Inworld TTS-2, Google Gemini 3.8 Flash-Lite TTS, Google Gemini 3.8 Flash TTS와의 일대일 사용자 선호도 테스트 기반.
Eleven v4는 전달 방식을 위한 [laughs] 같은 인라인 오디오 태그와 발음을 위한 IPA 음소 지원을 제공합니다. 헬스케어 에이전트에서는 이 발음 제어로 의료 용어를 처리할 수 있습니다. ElevenAgents는 여기에 에이전트 수준의 제어 기능을 추가합니다. 멀티 음성 지원을 통해 하나의 에이전트가 여러 캐릭터 대화에서 음성을 전환할 수 있습니다. 속도 범위는 0.7x~1.2x입니다. 추가 언어마다 자체 음성을 사용할 수 있습니다. 발음 사전은 특정 단어에 IPA 또는 CMU 표기법을 적용합니다.
빠른 첫 음성과 정확하고 표현력 있는 목소리는 에이전트를 대화 상대처럼 느끼게 합니다.
전화 통신과 전송: 에이전트를 발신자에게 연결하기
전송 계층은 발신자와 에이전트 간 오디오를 전달합니다. 사용하는 전화 통신 채널에 따라 음성 AI 인프라에 포함할 통합 기능도 달라집니다.
역할
전화 통화는 전화 네트워크와 SIP를 통해 전달되며, 브라우저와 앱 대화는 WebRTC 또는 WebSocket을 통해 전달됩니다. 웹사이트 위젯은 브라우저 연결을 즉시 사용할 수 있는 인터페이스로 감쌉니다.
중요한 이유
채널마다 필요한 설정과 오디오 제약이 다르므로 채널을 일찍 결정해야 합니다. 전화 우선 배포에는 트렁킹과 번호 관리가 필요하고, 제품 배포에는 SDK가 필요합니다.
ElevenAgents의 구현 방식
- SIP 트렁킹: 인바운드와 아웃바운드 모두 전화 시스템을 ElevenLabs에 직접 연결합니다. Twilio, Vonage, Sinch, Infobip, Telnyx 및 기타 표준 제공업체와 작동합니다. 시그널링은 포트 5060에서 TCP로, 또는 포트 5061에서 TLS 1.2 이상으로 작동하며, 오디오는 G.711 또는 G.722를 사용합니다. 통화당 최소 100Kbps를 계획하세요. 동시 통화 제한은 구독 티어를 따르며, 통화 대기열을 활성화하면 발신자는 대기합니다.
- 네이티브 Twilio 통합: 구매한 Twilio 번호를 인바운드 및 아웃바운드 통화에 가져옵니다. 확인된 발신자 ID는 아웃바운드에서만 작동합니다.
- 일괄 통화: CSV 또는 XLS 수신자 목록을 업로드하면 추가 열마다 동적 변수가 됩니다. 즉시 실행하거나 시작 시간을 예약할 수 있습니다. 일괄 작업은 워크스페이스 동시성 제한의 50% 또는 에이전트 동시성 제한의 70% 중 더 낮은 값을 사용해 인바운드 통화 용량을 남겨 둡니다.
- WebRTC 및 WebSocket: SDK는 기본적으로 음성에 WebRTC를, 텍스트 전용 대화에 WebSocket을 사용합니다. 비공개 에이전트는 서명된 URL 또는 서버에서 생성한 대화 토큰으로 인증합니다. WebSocket 엔드포인트는 wss://api.elevenlabs.io/v1/convai/conversation입니다.
- SDK: Python, JavaScript, React, React Native, Swift, Kotlin, Unity.
- 위젯: 페이지에 <elevenlabs-convai> 요소를 추가하세요. 음성 전용, 음성+텍스트, 채팅 모드를 지원하며 에이전트는 빠른 답장과 캐러셀을 표시할 수 있습니다.
하나의 에이전트가 전화, 웹, WhatsApp, SMS, 이메일을 지원하므로 팀은 한 번 구축해 여러 채널에 배포할 수 있습니다.
가드레일: 에이전트가 업무에 집중하도록 하기
가드레일은 에이전트의 행동을 정의된 경계 안에 유지하는 제어 장치입니다. 가드레일은 에이전트가 말할 수 있는 내용을 제한하지만 그 근거가 되는 사실까지 정확하게 만들지는 않으므로, 그라운딩과 함께 작동합니다. 가드레일은 에이전트 대화와 병렬로 실행되어 AI 에이전트 대화의 규정 준수와 정확성을 돕습니다.
역할
ElevenAgents는 가드레일을 적용하는 세 가지 수준을 제공합니다. 시스템 프롬프트는 이상적으로 # Guardrails 제목 아래 허용 및 금지 행동을 설정합니다. 사용자 입력 검증은 프롬프트 인젝션을 위해 메시지를 검사합니다. 응답 검증은 전송 전 각 응답을 확인합니다.
중요한 이유
주제에서 벗어나거나 정책을 지어내는 에이전트는 빠르게 신뢰를 잃습니다. 고객 지원 에이전트는 답변하기 전에 승인된 출처에서 환불 정책을 검색해야 하며, 가드레일은 그 경계를 강제합니다.
ElevenAgents의 구현 방식
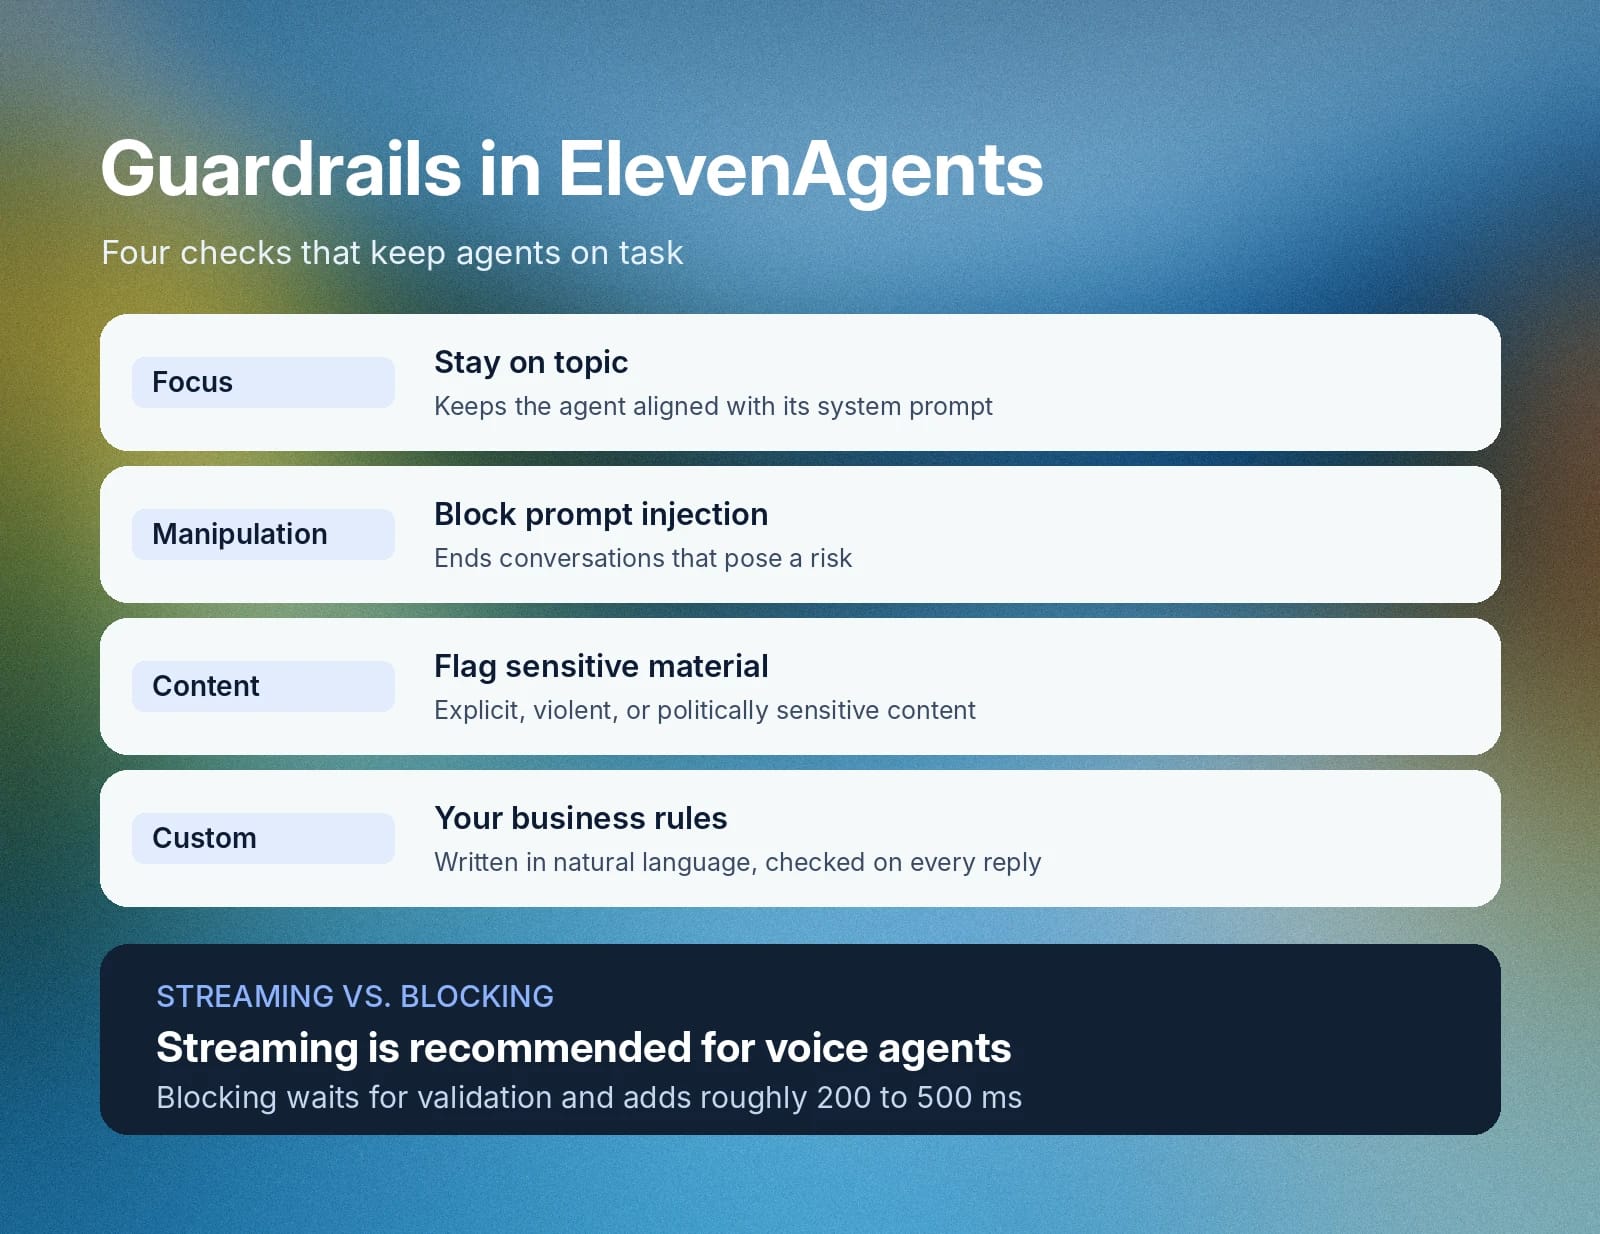
ElevenAgents는 2026년 9월 Guardrails 2.0을 도입했습니다. 이 새로운 시스템에서 가드레일이 효과적으로 작동하도록 돕는 구성은 다음과 같습니다.
- Focus: 에이전트가 주제를 유지하고 시스템 프롬프트에 맞게 행동하도록 합니다.
- Manipulation: 프롬프트 인젝션을 감지하고 위험을 초래하는 대화를 종료합니다.
- Content: 성적으로 노골적인 내용, 폭력적 또는 정치적으로 민감한 자료 같은 카테고리를 플래그합니다.
- Custom: 자연어로 작성하는 비즈니스 규칙으로, 모든 응답에서 평가됩니다.
실행 모드는 지연 시간의 트레이드오프를 결정합니다. 스트리밍 모드에서는 검사가 완료되기 전에 응답을 시작할 수 있으므로, 차단이 통화를 종료하기 전 최대 500ms 미만의 오디오가 재생될 수 있으며 ElevenLabs는 음성 에이전트에 이를 권장합니다. 차단 모드는 검증을 기다리며 약 200~500ms를 추가합니다.
커스텀 가드레일이 트리거되면 트리거 작업은 통화를 종료하거나, 작성한 피드백을 바탕으로 응답을 최대 세 번 재시도합니다. 클라이언트는 guardrail_triggered 이벤트를 수신할 수 있습니다.
선택한 지연 시간 프로필을 갖춘 계층형 가드레일은 모든 응답을 늦추지 않으면서 동작을 예측 가능하게 유지합니다.
테스트와 실험: 에이전트가 작동함을 입증하기
테스트는 출시 전에 에이전트를 확인합니다. 실험은 출시 후 실제 트래픽을 대상으로 변경 사항을 확인합니다.
역할
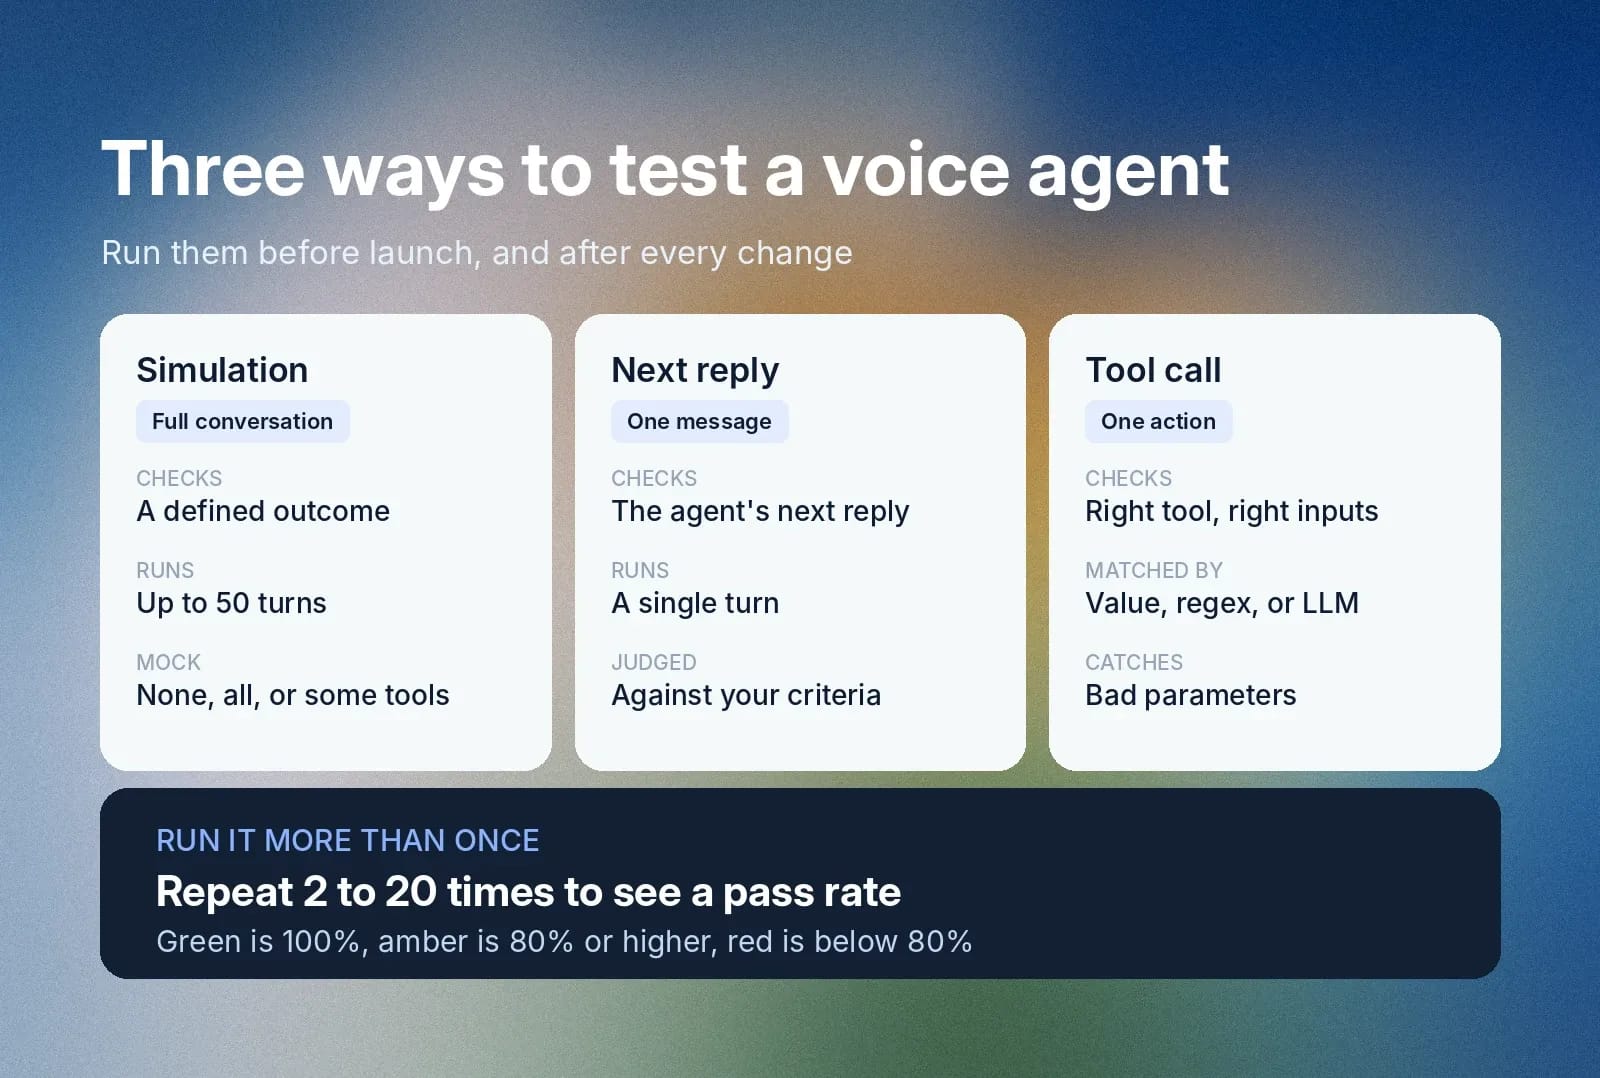
ElevenAgents에는 세 가지 에이전트 테스트 유형이 있습니다. Simulation은 시뮬레이션 사용자와 전체 대화를 실행하고 정의된 결과에 도달하는지 최대 50턴(기본값 5)까지 확인합니다. Next Reply 테스트는 정의한 기준에 따라 에이전트의 다음 메시지만 평가합니다. Tool Call 테스트는 정확한 값, 정규식 또는 LLM 평가를 통해 에이전트가 올바른 도구를 올바른 파라미터로 사용하는지 검증합니다. 시뮬레이션에서는 도구를 전혀 모킹하지 않거나, 모든 도구 또는 선택한 도구를 모킹할 수 있습니다.
중요한 이유
한 번의 통과 실행은 에이전트가 성공할 수 있음을 보여 줍니다. 반복 테스트는 얼마나 자주 성공하는지 보여 줍니다. API는 2~20의 repeat_count를 지원하며 결과는 통과율을 표시합니다. 초록색은 100%, 주황색은 80% 이상, 빨간색은 80% 미만을 의미합니다. 실패는 원인별로 그룹화됩니다. 프롬프트, 모델, 워크플로, 통합 기능은 모두 동작을 변경하므로 출시 후에도 테스트를 계속해야 합니다.
실험 작동 방식
실험은 에이전트 버전 관리를 기반으로 한 A/B 테스트입니다. 구성을 분기하고 시스템 프롬프트, 워크플로, 음성, 도구, 지식 베이스 또는 LLM 설정 같은 변수 하나를 변경한 뒤, 실제 트래픽의 일부를 변형에 라우팅합니다. ElevenLabs는 5~10%부터 시작할 것을 권장합니다.
라우팅은 대화 ID별로 결정되므로 사용자는 동일한 분기에 유지되며, 비율의 합계는 100%여야 합니다. ElevenLabs 고객인 CARS24는 보고서에 설명된 대로 각 단계에서 이틀간 유지하며 트래픽을 5%, 10%, 20%, 50%, 100%로 늘렸습니다.
출시 전 테스트와 실제 실험을 함께 사용하면 변경 사항을 측정된 개선으로 전환할 수 있습니다.
관측 가능성: 프로덕션에서 발생하는 일 측정하기
관측 가능성이란 에이전트가 무엇을 했는지, 어떻게 수행했는지, 필요할 경우 어디에서 실패했는지를 볼 수 있는 능력입니다. 테스트에서 작동하는 에이전트도 실제 발신자와는 다르게 동작할 수 있으므로, 완전한 관측 가능성과 감사 가능한 기록 보관은 필수입니다.
역할
대화 분석은 모든 통화를 점수화합니다. 성공 평가는 목표 달성과 품질에 대해 정의한 기준을 적용하고, 데이터 수집은 연락처 세부 정보와 문제 유형 같은 구조화된 필드를 추출합니다. 분석 대시보드는 통화량, 기간, 비용, 오류율, 지연 시간을 추가로 제공합니다. 활성 통화는 실시간으로 업데이트되며 오류율이 급증하면 알림이 발생합니다.
중요한 이유
모니터링이 없으면 좋지 않은 통화는 일화에 그칩니다. 모니터링이 있으면 어떤 노드, 도구 또는 모델이 문제를 일으켰는지 확인할 수 있습니다.
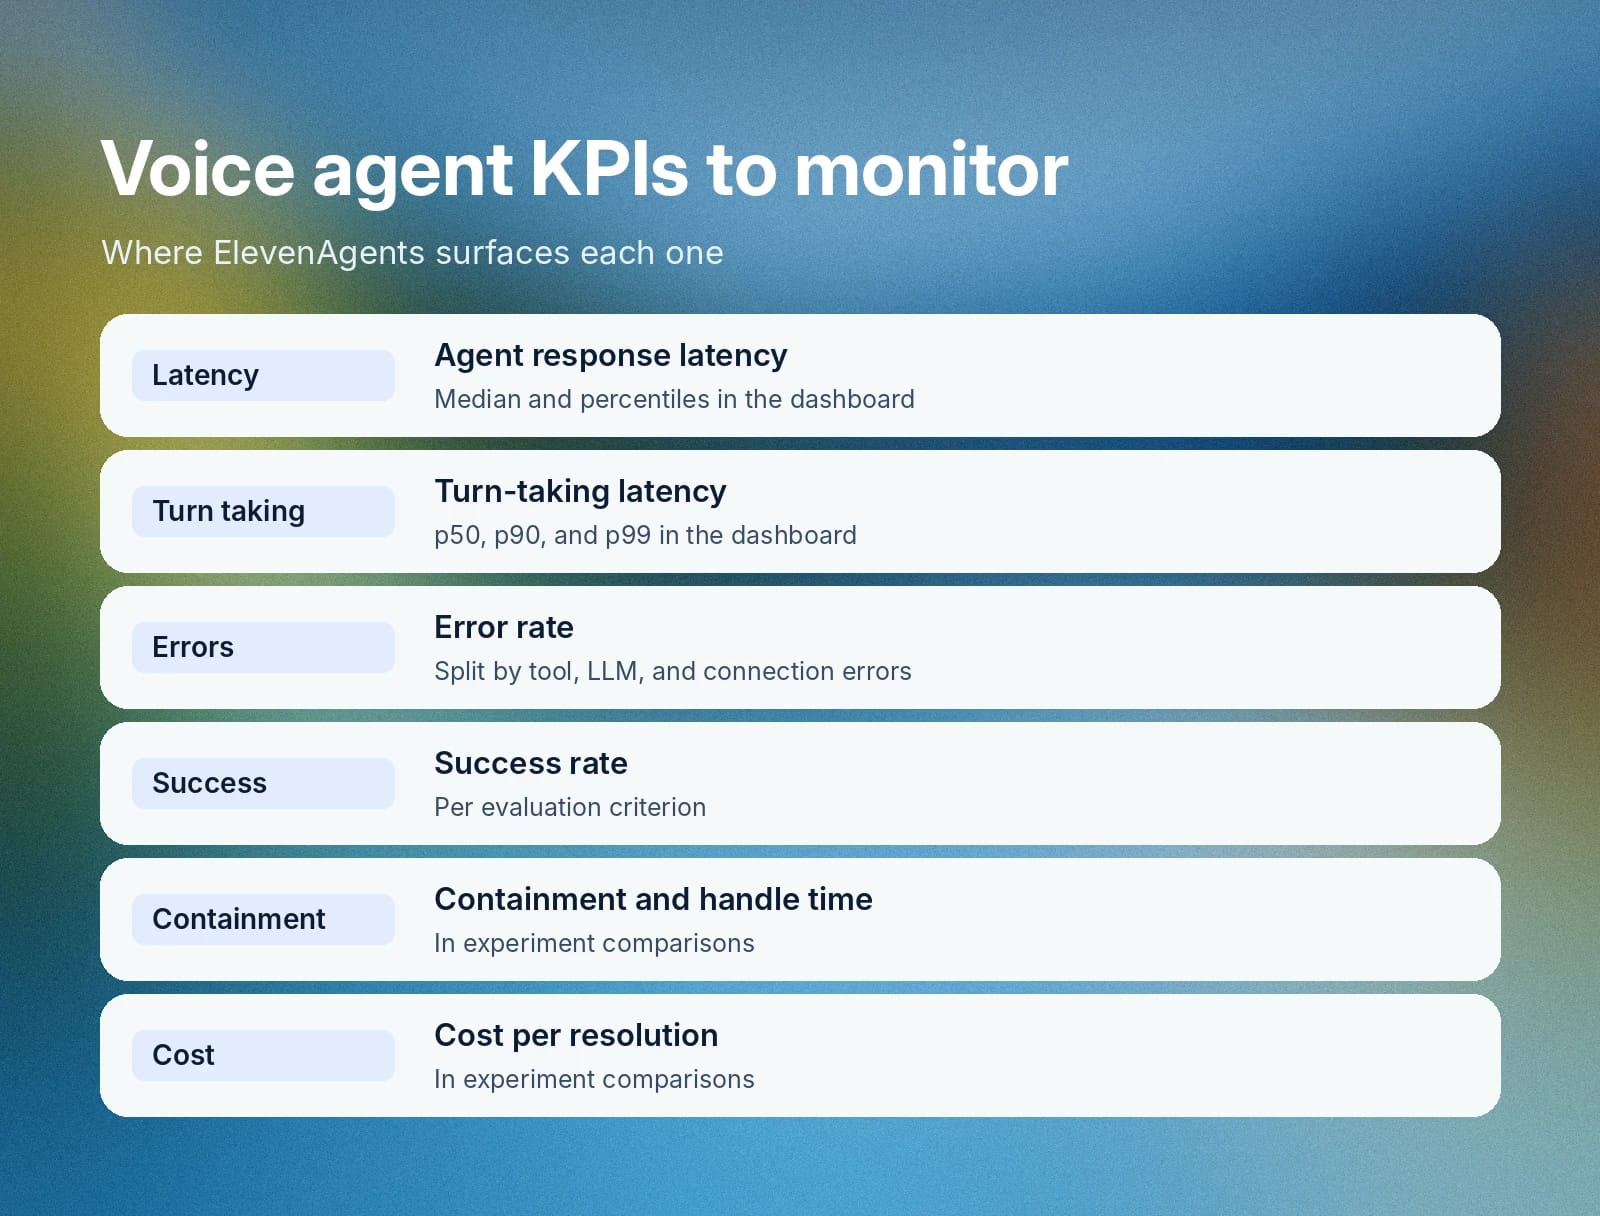
KPI
의미
ElevenAgents에서 확인하는 위치
에이전트 응답 지연 시간
발신자가 응답을 기다리는 시간
분석 대시보드, 중앙값 및 백분위수
턴 테이킹 지연 시간
에이전트가 턴을 가져오는 속도
분석 대시보드, p50, p90, p99
오류율
오류가 있는 대화의 비율
대시보드, 도구·LLM·연결 오류별 분류
성공률
기준별 목표 달성
성공, 실패, 알 수 없음 비율을 포함한 평가 기준
컨테인먼트율과 처리 시간
사람 없이 해결된 통화와 통화 기간
실험 비교
해결당 비용
해결된 대화당 비용
실험 비교
수행하려는 특정 업무에 가장 유용한 지표를 선택하세요. 지원 에이전트는 해결과 에스컬레이션에 중점을 두는 반면, 아웃바운드 에이전트는 주로 연결과 완료에 집중합니다.
확장성, 신뢰성 및 사람에게 이관
음성 AI 인프라는 고객 5명과 대화하든 500,000명과 대화하든 안정적으로 제공할 수 있어야 합니다. 대규모로 운영할 때도 이러한 구성 요소는 장애를 견디고 필요하면 사람에게 에스컬레이션할 수 있어야 합니다.
역할
확장성이란 음성 인식, LLM 추론, 음성 합성, 통합, 전화 통신 전반에서 많은 동시 대화를 지원하는 것을 의미합니다. 신뢰성이란 각 종속성에 정의된 장애 경로가 있는 것을 의미합니다. 이관은 사람에게 연결되는 명확한 경로를 의미합니다.
엄밀히 말해 음성 AI 인프라 내의 구성 요소는 아니지만, 이 모두는 실무에서 좋은 시스템을 만드는 핵심 요소입니다.
중요한 이유
테스트 통화 10건을 처리하는 시스템도 1만 건에서는 다르게 동작할 수 있습니다. 타임아웃된 예약 도구가 실제로 이루어지지 않은 예약을 에이전트가 확인하게 해서는 안 됩니다. 사람을 요청하는 발신자는 일반적으로 웜 트랜스퍼를 통해 컨텍스트가 유지된 상태로 사람에게 연결되어야 합니다.
ElevenAgents의 구현 방식
동시성 제한은 구독 티어를 따르며, 제한에 도달하면 통화 대기열이 발신자를 대기시킵니다. LLM 캐스케이딩은 모델 장애를 처리합니다. 번호로 이관 노드, 번호로 이관 시스템 도구, 에이전트 이관이 핸드오프를 지원하며, 평가 기준으로 에스컬레이션 시점을 결정할 수 있습니다. 무음 구간은 일반 분당 요금의 5%로 청구됩니다.
ElevenLabs는 대규모 프로덕션 결과를 보고합니다. ElevenAgents는 주당 1,000만 건 이상의 대화를 지원합니다. Building Enterprise-grade Voice Agents 보고서에 따르면 Meesho는 하루 60,000건 이상의 통화에서 지원 문의 약 90%를 자동화합니다. 체코에서는 State of Conversational Agents in Government 보고서에 따르면 ElevenLabs 기반 에이전트가 국가 복지 핫라인에서 하루 약 5,000건의 통화를 처리하고 문의의 85%를 독립적으로 해결합니다.
처음부터 부하, 장애, 핸드오프를 계획하는 것이 데모와 실제 배포를 구분합니다.
2026년 프로덕션 준비가 된 음성 AI 인프라에서 확인할 사항
이 체크리스트로 모든 음성 AI 플랫폼이 요구 사항에 맞는지 평가하세요.
- 음성 인식: 이름과 식별자를 포함해 언어, 억양, 오디오 품질에 맞는 정확한 전사.
- 턴 테이킹: 구성 가능한 턴 종료 동작, 바지인, 측정된 인터럽트 응답 시간.
- 모델 선택: 에이전트 또는 하위 에이전트별 선택 가능한 LLM, 커스텀 LLM 옵션, 자동 폴백.
- 오케스트레이션: 다단계 워크플로와 전문 에이전트 간 라우팅.
- 도구: 웹훅, 클라이언트 도구, MCP 지원, 승인 제어.
- 지식: 검색 지연 시간을 측정할 수 있는 자체 문서.
- 개인화: 첫마디 전부터 사용할 수 있는 발신자 데이터.
- 음성: 짧은 첫 음성 도달 시간과 발음 및 표현 제어.
- 채널: SDK와 API를 갖춘 전화, 웹, 모바일, 메시징.
- 가드레일: 알려진 지연 시간 비용을 가진 구성 가능한 행동 제한.
- 테스트: 시뮬레이션 대화, 도구 호출 검사, 반복 실행.
- 실험과 분석: A/B 테스트, 백분위수 지연 시간, 오류 세부 분석.
- 확장성과 핸드오프: 문서화된 동시성, 대기열, 사람에게 에스컬레이션.
ElevenAgents 같은 선도적인 AI 음성 에이전트 시스템은 이러한 모든 구성 요소를 하나의 플랫폼으로 제공합니다.
지금 팀에 문의하거나 계정을 등록하여 자체 AI 에이전트 시스템을 구축해 보세요.
음성 AI 인프라에 관한 자주 묻는 질문

Jack Limebear는 Growth 팀에서 블로그와 인사이트 페이지의 콘텐츠 작가이자 전략가로 활동하고 있습니다. ElevenLabs에 합류하기 전에는 빠르게 성장하는 SaaS 스타트업부터 포춘 500대 기업까지 다양한 조직에서 10년 넘게 콘텐츠 전략을 이끌었습니다. 케임브리지 대학교에서 영문학 석사 학위를 취득했습니다.


