
벡터 데이터베이스란? AI 검색이 의미를 찾는 방법
- 게시일
벡터 데이터베이스는 AI 모델이 의미적 유사성을 바탕으로 비정형 데이터를 쿼리하고 검색할 수 있게 하는 저장 시스템입니다. AI가 학습 데이터 너머의 지식을 바탕으로 응답을 생성하도록 돕습니다.
벡터 데이터베이스는 LLM이 쉽게 처리할 수 있는 형식으로 정보를 저장합니다. AI 모델에 추가 정보를 제공해 관련성 높고 정확한 답변을 생성하도록 지원합니다.
이 가이드에서는 벡터 데이터베이스의 정의와 작동 방식, 일반적인 사용 사례, 유형, 예시, 그리고 관계형 및 그래프 데이터베이스와의 차이를 설명합니다.
요약
- 벡터 데이터베이스는 학습된 특성 표현을 다차원 공간의 벡터 임베딩으로 저장합니다.
- 키워드 일치에 의존하는 기존 데이터베이스와 달리, 벡터 데이터베이스는 쿼리 시 의미적으로 유사한 데이터를 검색합니다.
- 벡터 DB는 RAG 시스템을 사용해 음성 AI와 고객 서비스가 맥락을 인식한 응답을 제공하도록 돕는 내부 문서를 저장합니다.
- 챗봇, AI 검색 엔진, 대화형 AI 같은 애플리케이션은 벡터 데이터베이스가 지원하는 의미 검색과 비정형 데이터 유형의 이점을 누릴 수 있습니다.
- 벡터 DB는 그래프 데이터베이스와 다릅니다. 그래프 데이터베이스는 그래프 탐색 알고리즘을 사용해 관련 엔터티를 연결하고 멀티홉 쿼리를 지원하는 반면, 벡터 데이터베이스는 추가 맥락이 필요한 단순 쿼리에 적합합니다.
벡터 데이터베이스란 무엇이며, 무엇을 저장하나요?
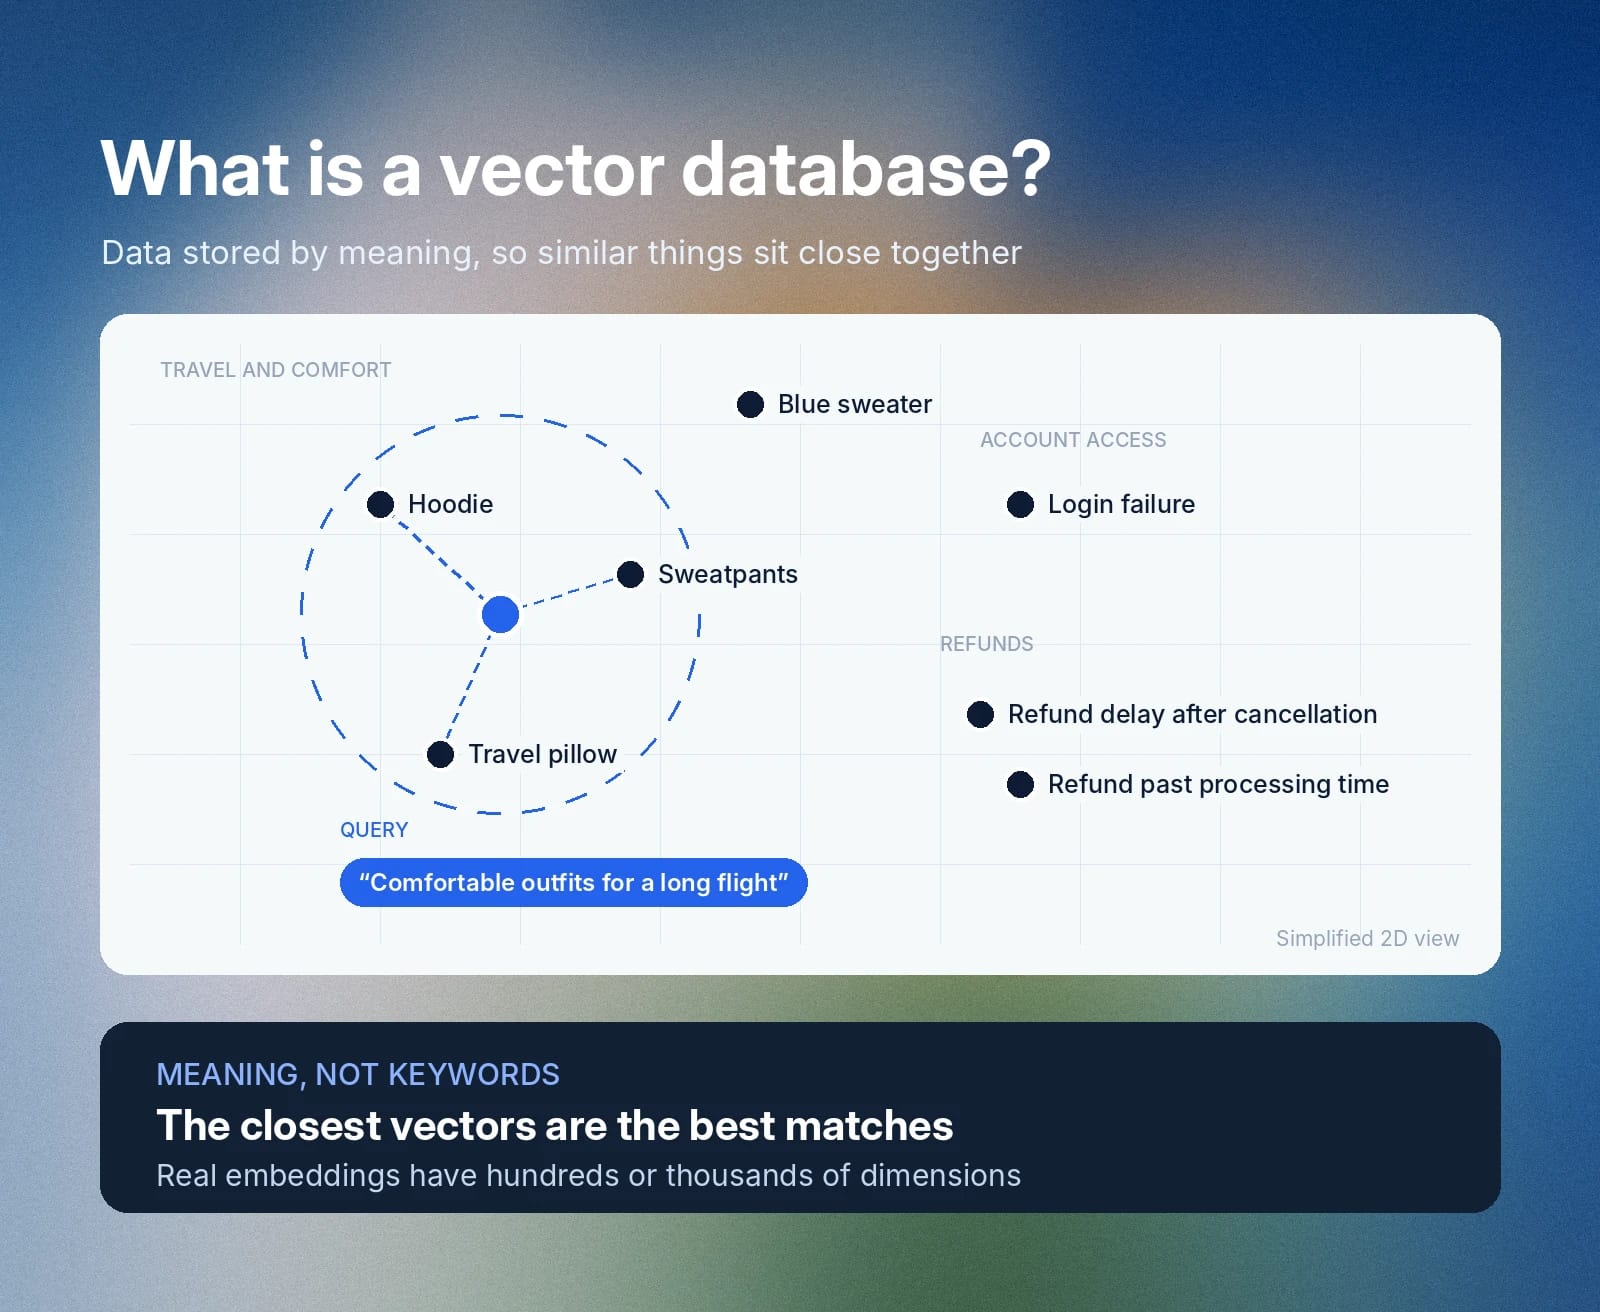
벡터 데이터베이스는 데이터를 임베딩이라는 수치 표현으로 저장하여 AI 모델을 위한 저지연 의미 검색을 지원합니다. 행과 열에 정보를 저장하는 기존 데이터베이스와 달리, 벡터 DB는 의미적 유사성을 바탕으로 다차원 공간에 임베딩을 군집화합니다.
AI에서 '차원'은 특정 객체의 학습된 특성이나 특징을 설명하는 용어입니다. 예를 들어 개는 털 색깔이나 품종 같은 차원을 가진다고 생각할 수 있습니다. 실제로는 학습된 임베딩의 개별 차원이 읽을 수 있는 하나의 특성에 직접 대응하는 경우가 드뭅니다.
특히 외부 지식 소스와 연결되는 생성형 AI 애플리케이션은 검색 속도를 높이기 위해 벡터 데이터베이스를 사용합니다. 기존 데이터베이스에서 정확히 일치하는 키워드를 찾는 대신, 검색기 시스템은 벡터 DB에서 가장 유사한 임베딩을 찾습니다.
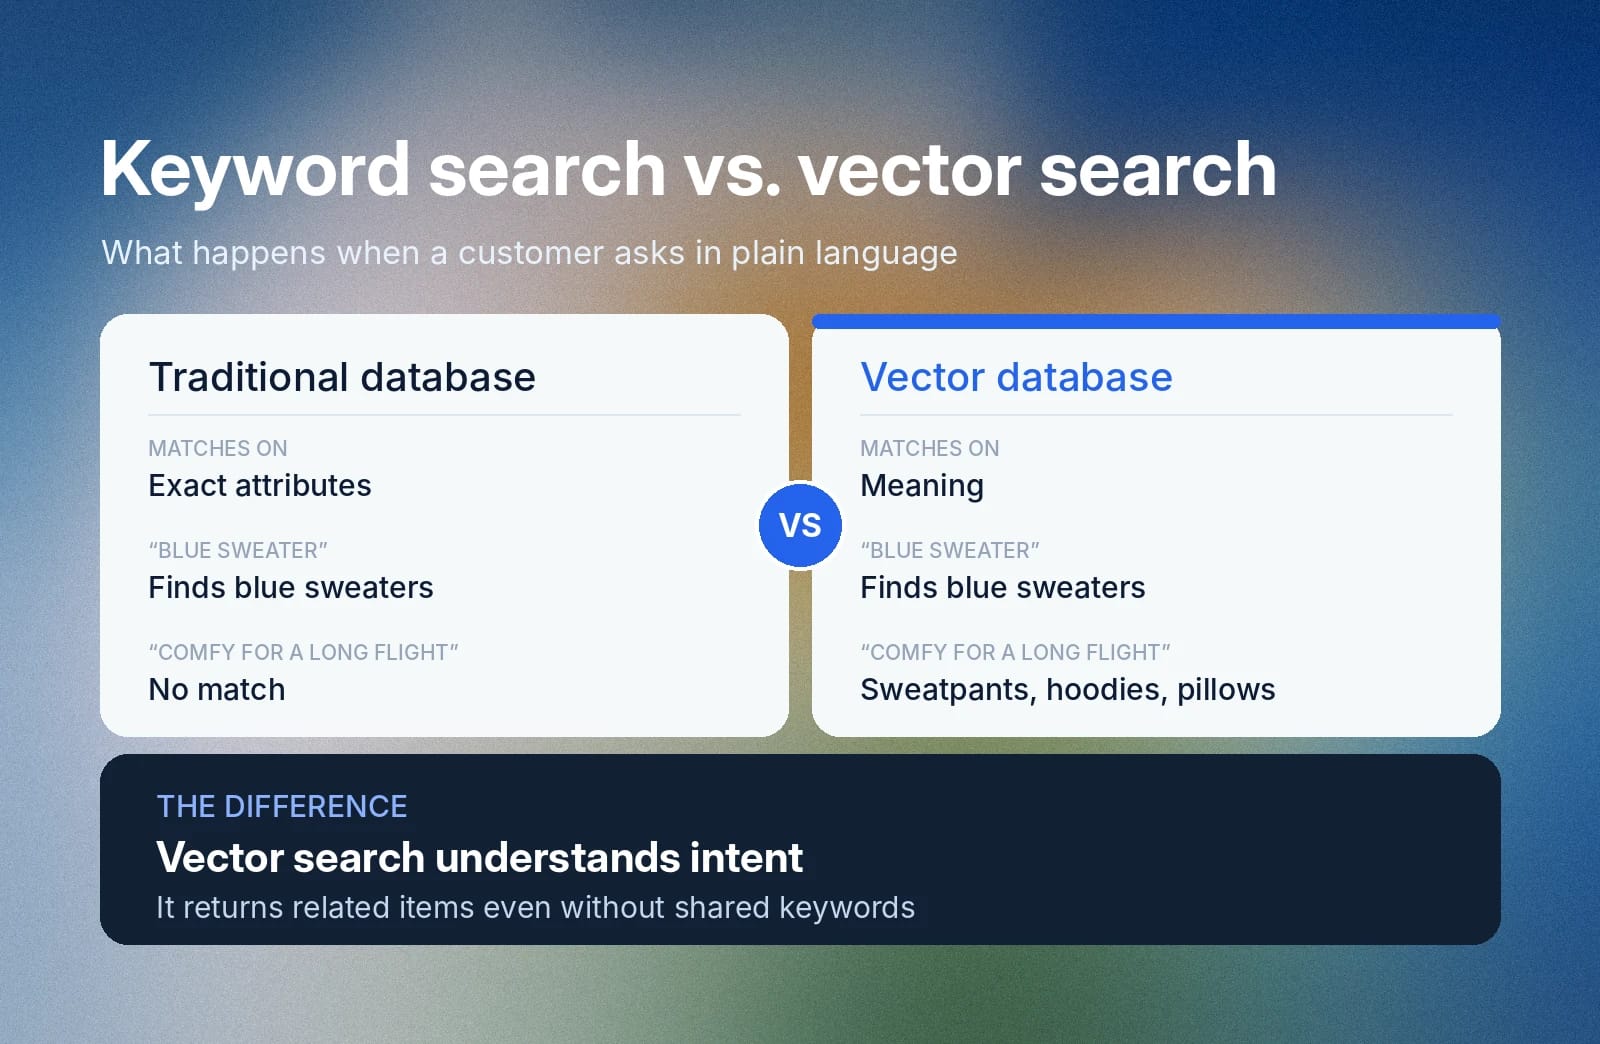
고객이 전화해 “파란색 스웨터”를 추천해 달라고 했다고 가정해 보겠습니다. 기존 데이터베이스에서는 “파란색”과 “스웨터”라는 속성에 맞는 제품을 찾습니다. 하지만 고객이 “장거리 비행에서 편안하게 느껴지는 옷”을 원한다면 기존 데이터베이스는 답을 반환할 수 없습니다.
반면 벡터 데이터베이스는 요청의 의미를 포착합니다. 이를 벡터 공간에 매핑하면 시스템은 밀접하게 연관된 특성 표현을 가진 스웨트팬츠, 후디, 여행용 베개 같은 제품을 반환합니다. 의미를 일치시키는 이 능력이 벡터 DB와 기존 데이터베이스를 구분하는 핵심입니다.
벡터 임베딩: 음성, 텍스트, 이미지를 숫자로 변환하기
벡터 임베딩은 AI 모델이 쉽게 처리할 수 있도록 텍스트, 이미지, 비디오 같은 비정형 데이터를 표현하는 숫자 배열입니다.
벡터는 서로 다른 차원에 걸친 숫자의 수학적 표현입니다. 하지만 벡터 자체는 특정 데이터 세트의 맥락, 구조, 의미를 담지 않습니다.
예를 들어 부동소수점 수 목록 [0.82, 0.14, 0.67]은 벡터이지만, 무엇을 나타내는지는 임베딩 모델에 따라 결정됩니다.
임베딩은 데이터의 특성을 포착해 다차원 공간의 벡터로 저장합니다. 단순한 숫자 목록에 불과했을 정보에 의미를 부여합니다. 벡터의 각 숫자는 학습된 표현의 한 차원입니다.
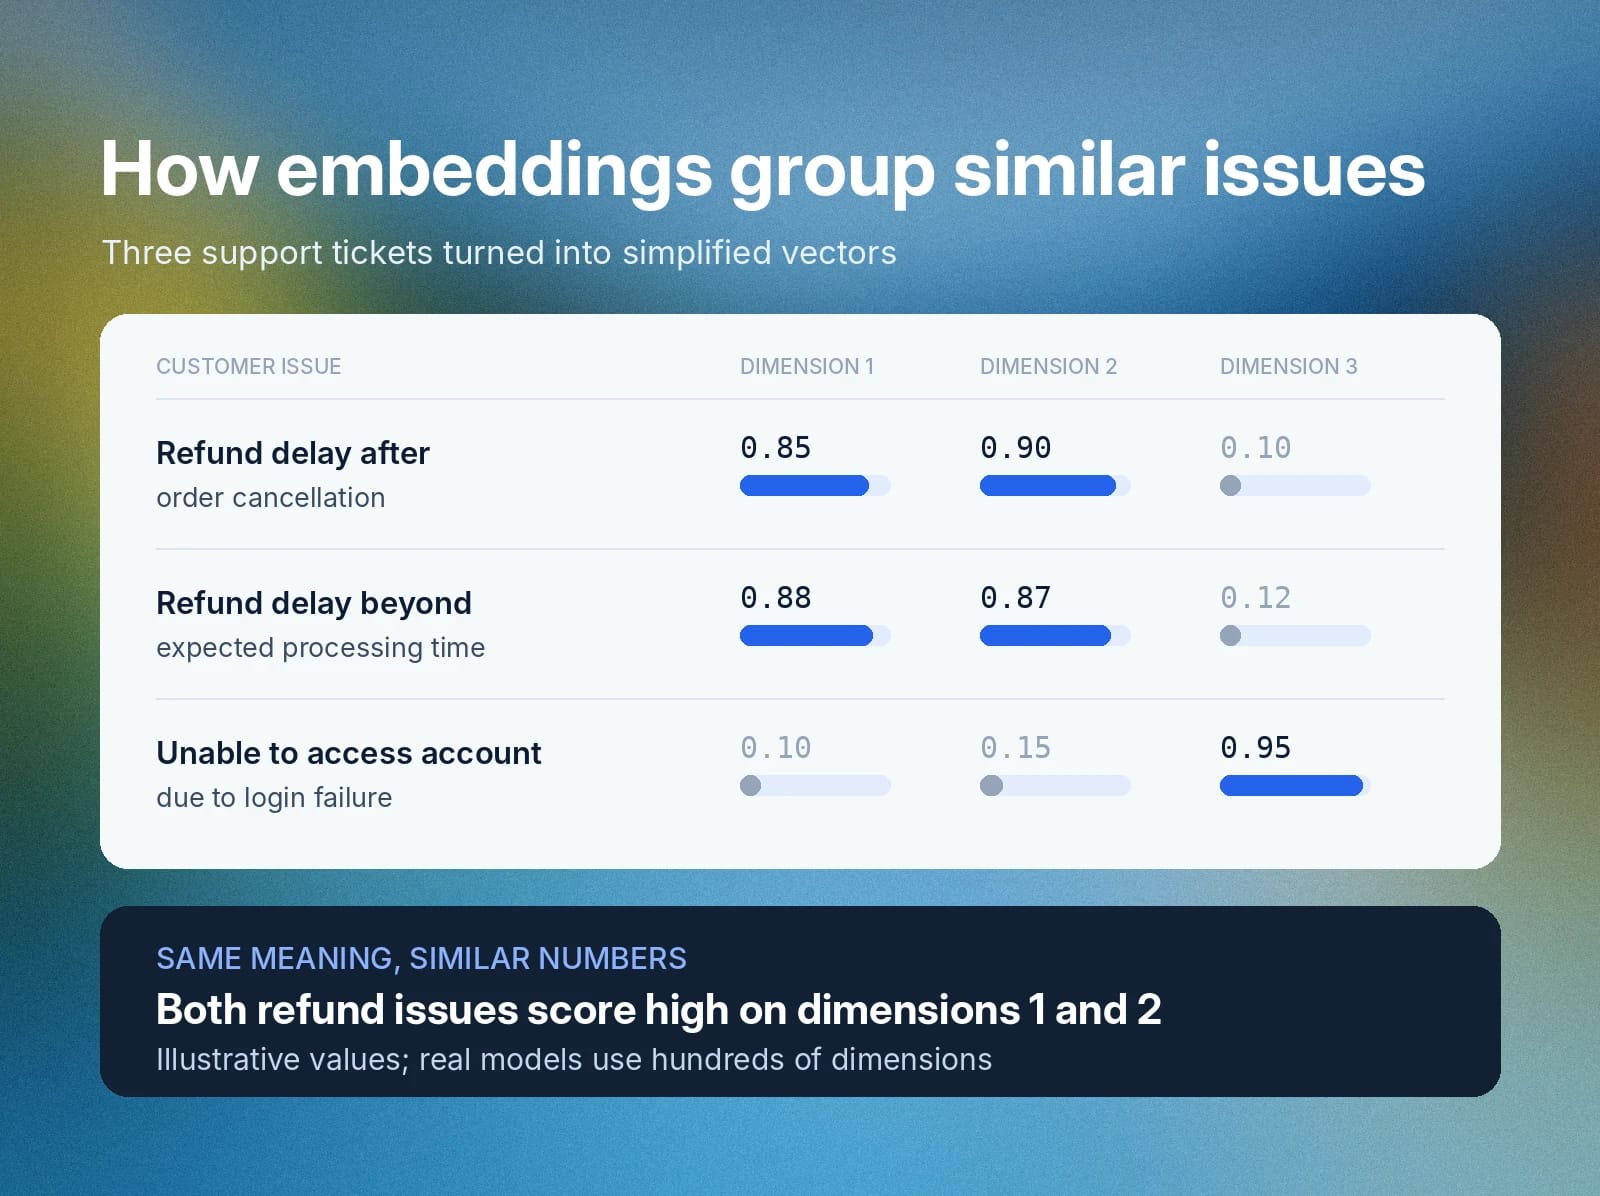
고객 사례를 벡터 DB에 저장하려 한다고 가정해 보겠습니다. 임베딩 모델을 사용하면 티켓 유형을 차원별로 서로 다른 값을 지닌 임베딩으로 변환합니다. 아래 값은 설명을 위해 단순화한 것입니다.
고객 문제
임베딩
주문 취소 후 환불 지연
[0.85, 0.90, 0.10]
예상 처리 기간을 넘긴 환불 지연
[0.88, 0.87, 0.12]
로그인 실패로 인한 계정 접근 불가
[0.10, 0.15, 0.95]
두 환불 문제는 원인이 다르지만 첫 번째와 두 번째 차원의 수치가 더 높고, 로그인 문제는 세 번째 차원의 수치가 가장 높습니다. 임베딩 모델은 일반적으로 수백 또는 수천 개의 차원을 생성하므로, 벡터 데이터베이스는 이를 빠르게 비교하도록 설계됩니다.
벡터 데이터베이스는 어떻게 작동하나요?
벡터 데이터베이스는 비정형 데이터를 임베딩으로 변환하고 다차원 공간에 저장하며, 의미적 유사성 검색을 지원합니다. 서로 밀접하게 연관된 임베딩은 벡터 공간에서 어느 정도 더 작은 거리를 갖습니다.
벡터 데이터베이스는 쿼리를 받으면 전체 데이터베이스를 스캔하지 않고 근사 최근접 이웃(ANN) 알고리즘을 사용해 가장 유사한 임베딩을 검색합니다.
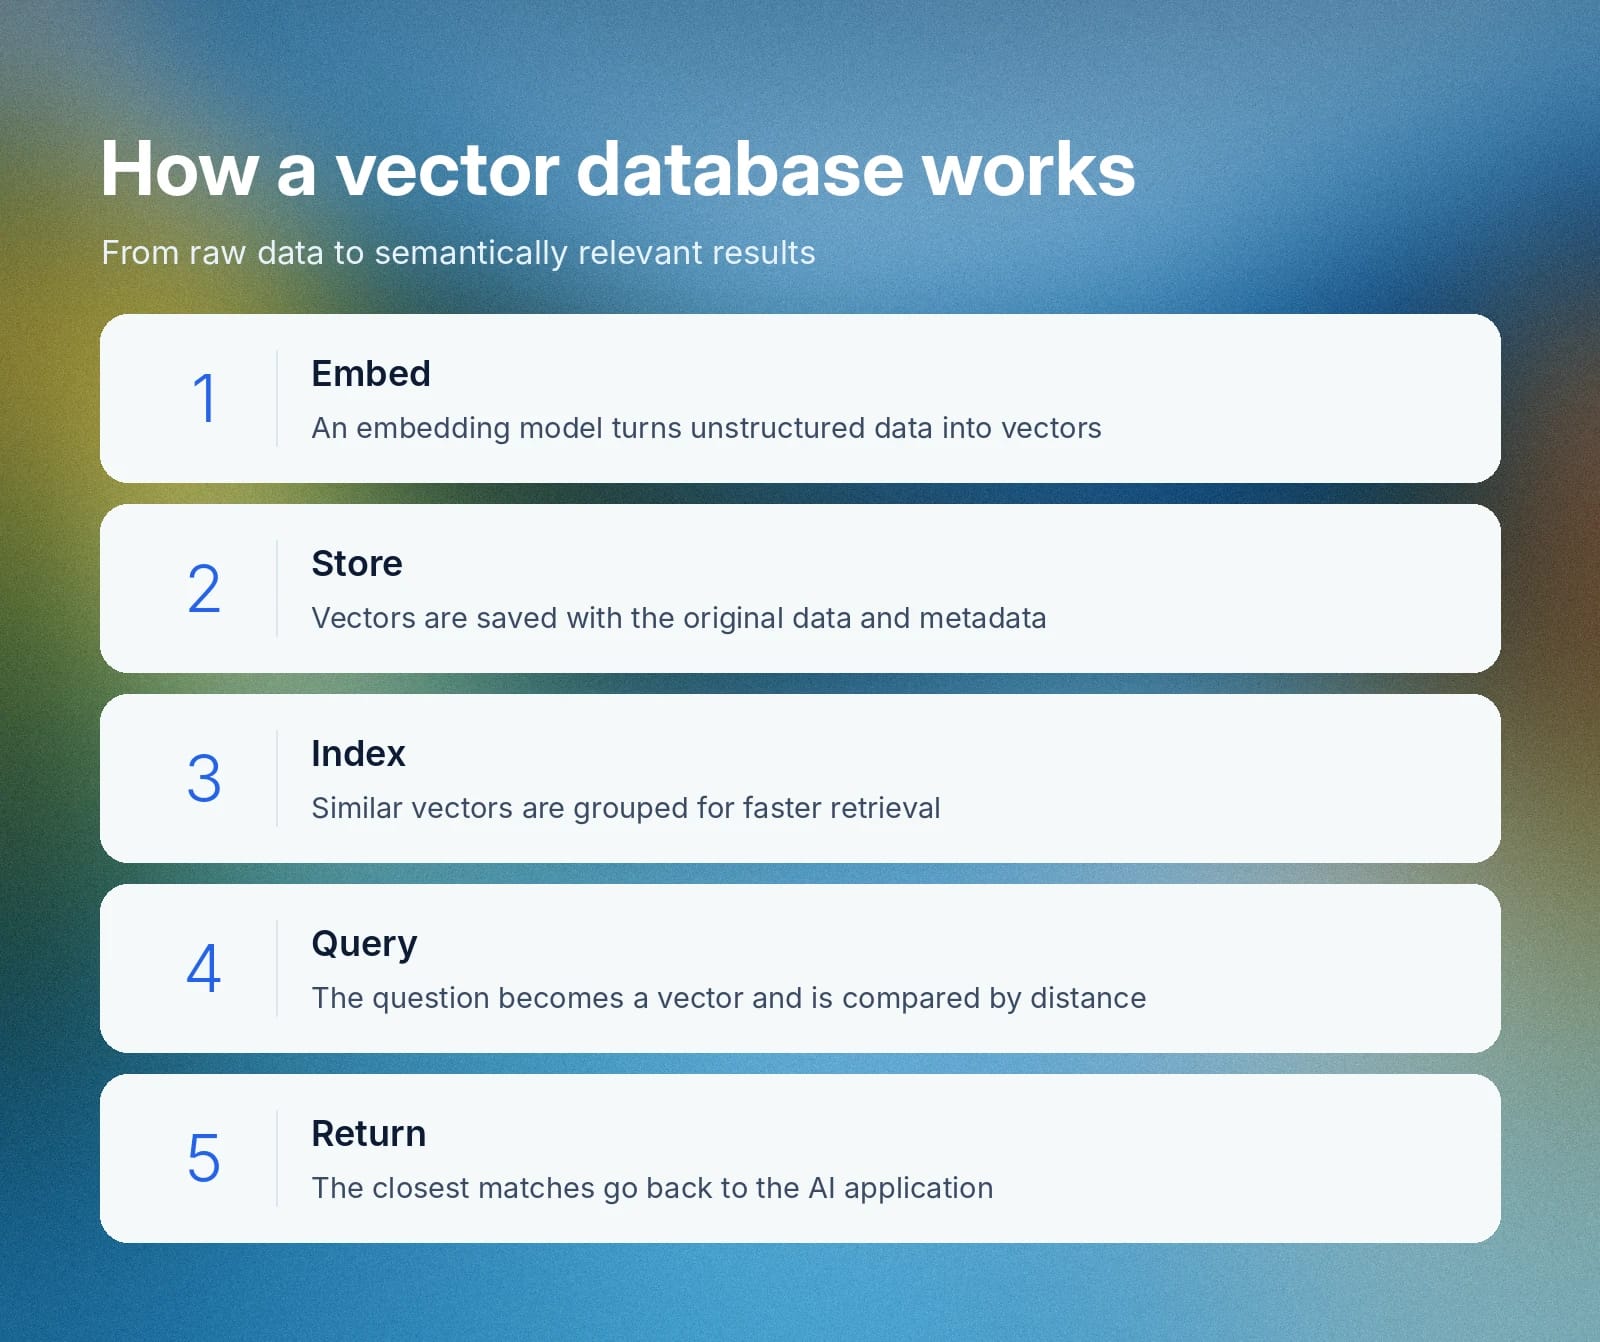
다음은 벡터 데이터베이스를 설정하고 데이터를 검색하는 단계입니다.
임베딩 저장
먼저 임베딩 모델이 비정형 데이터를 임베딩으로 변환합니다. 각 임베딩은 실제 객체의 의미를 담은 특성을 나타냅니다. 그런 다음 시스템은 원본 데이터 및 메타데이터와 함께 임베딩을 벡터 DB에 저장합니다.
의미가 유사한 임베딩은 벡터 공간에서 가까이 위치하므로, 데이터베이스는 벡터 간 거리를 측정해 관련성 높은 일치 항목을 검색할 수 있습니다.
더 빠른 검색을 위한 인덱싱
인덱싱은 검색 효율을 높이기 위해 벡터 임베딩을 정리하는 과정입니다. 벡터 데이터베이스는 밀접하게 관련된 임베딩을 그룹화하기 위해 여러 인덱싱 기법을 사용합니다. 예를 들어 벡터 DB는 검색 요구 사항에 따라 목록, 그래프 또는 트리 구조를 사용할 수 있습니다.
벡터 DB는 인덱싱 외에도 프로덕트 양자화라는 기법으로 데이터를 압축할 수 있습니다. 프로덕트 양자화는 임베딩을 압축 코드로 변환해 검색 정확도를 조금 희생하는 대신 메모리를 절약합니다.
의미적으로 관련성 높은 데이터 쿼리
벡터 데이터베이스는 쿼리를 받으면 이를 임베딩으로 변환합니다. 그런 다음 코사인 유사도, 내적, 유클리드 거리 같은 기법을 사용해 쿼리 임베딩과 벡터의 다차원 데이터베이스에 저장된 임베딩을 비교합니다.
결과에 따라 벡터 데이터베이스는 의미적 유사성 점수가 가장 가까운 임베딩을 반환하며, 생성형 AI 애플리케이션은 이를 활용해 답변을 보강합니다. 저장, 인덱싱, 쿼리가 함께 작동해 데이터베이스가 관련성 높은 결과를 빠르게 반환할 수 있습니다.
벡터 검색과 유사성 검색이 관련성 높은 결과를 반환하는 방법
유사성 검색은 광범위한 정보 매칭 시스템 범주입니다. 쿼리의 정확한 단어를 일치시키는 키워드 기반 접근 방식과 의미를 기준으로 일치시키는 벡터 검색을 모두 포함합니다.
벡터 검색은 벡터 데이터베이스를 사용해 의미적으로 관련된 답변을 반환합니다. 정확한 키워드 검색을 수행하는 대신, 벡터 검색은 쿼리와 답변 후보 간 거리를 비교해 가장 적절한 결과를 선택합니다.
벡터 DB는 흔히 유사성 검색을 실행하기 전에 메타데이터를 사용해 임베딩을 사전 필터링합니다. 예를 들어 특정 기간 내의 임베딩만 필터링하여 검색 범위를 좁힙니다. 이렇게 하면 검색 속도가 더 빨라집니다.
음성 AI와 고객 지원을 위한 벡터 데이터베이스 사용 사례
벡터 데이터베이스는 고객 지원팀이 정확한 제품 지식을 바탕으로 응답하는 음성 AI와 챗봇을 배포하도록 돕습니다. AI 기반 고객 지원 시스템에서 벡터 데이터베이스는 제품 가이드, 비즈니스 정책, 고객 사례 같은 독점 지식 베이스를 저장합니다.
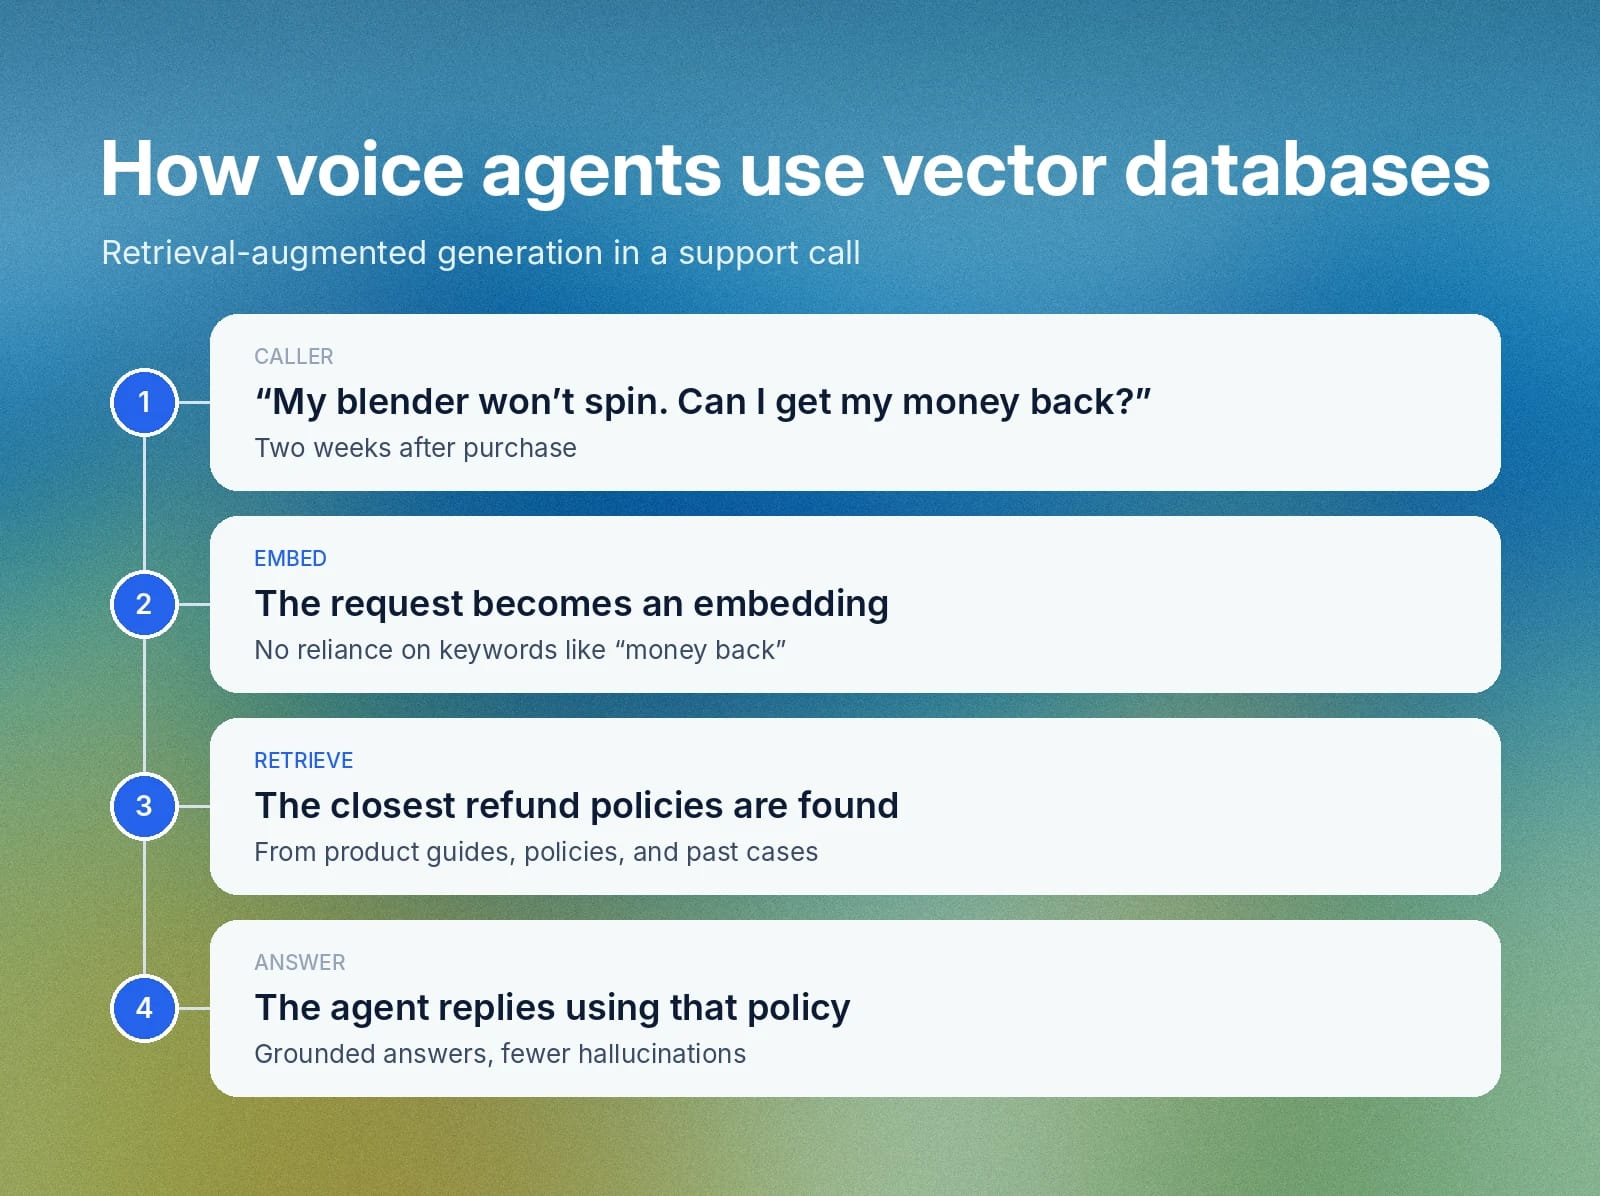
AI 에이전트는 검색 증강 생성(RAG) 시스템을 사용해 벡터 DB에 연결됩니다.
AI 음성 에이전트가 쿼리를 받으면 고객에게 답변하기에 충분한 정보가 있는지 확인합니다. 최신 데이터가 없거나 정보가 충분하지 않으면 RAG가 의미적으로 일치하는 데이터를 검색해 답변을 보강합니다.
음성 에이전트가 다음과 같은 불만을 받았다고 가정해 보겠습니다. “블렌더가 2주 후부터 작동하지 않아요. 환불받을 수 있나요?” RAG는 “작동하지 않아요”, “환불” 같은 정확한 키워드를 검색하는 대신 요청을 임베딩으로 변환합니다. 그런 다음 의미가 가장 가까운 환불 정책을 검색합니다.
벡터 데이터베이스 기반 RAG 시스템은 관련 내부 문서를 검색하여 음성 에이전트의 환각을 줄이는 데 도움이 되지만, 완전히 없애지는 못합니다. AI 에이전트와 상담원 모두 추측하는 대신 내부 문서를 활용해 고객 문의를 해결할 수 있습니다.
벡터 데이터베이스와 관계형 데이터베이스: 주요 차이점
관계형 데이터베이스는 고정된 스키마와 함께 행과 열을 사용해 데이터를 저장합니다. 반면 벡터 DB는 비정형 데이터를 나타내는 임베딩을 사용합니다.
관계형 데이터베이스는 특정 날짜에 접수된 모든 주문을 찾는 것처럼 정확한 일치와 구조화된 쿼리에 적합합니다. 반면 벡터 데이터베이스는 쿼리와 의미가 가장 가까운 저장된 임베딩을 검색하므로 자연어 질문에 더 효과적입니다.
대부분의 경우 팀은 데이터 작업에서 각각의 용도가 있으므로 두 가지를 모두 사용합니다.
벡터 데이터베이스와 그래프 데이터베이스: 각각을 사용해야 할 때
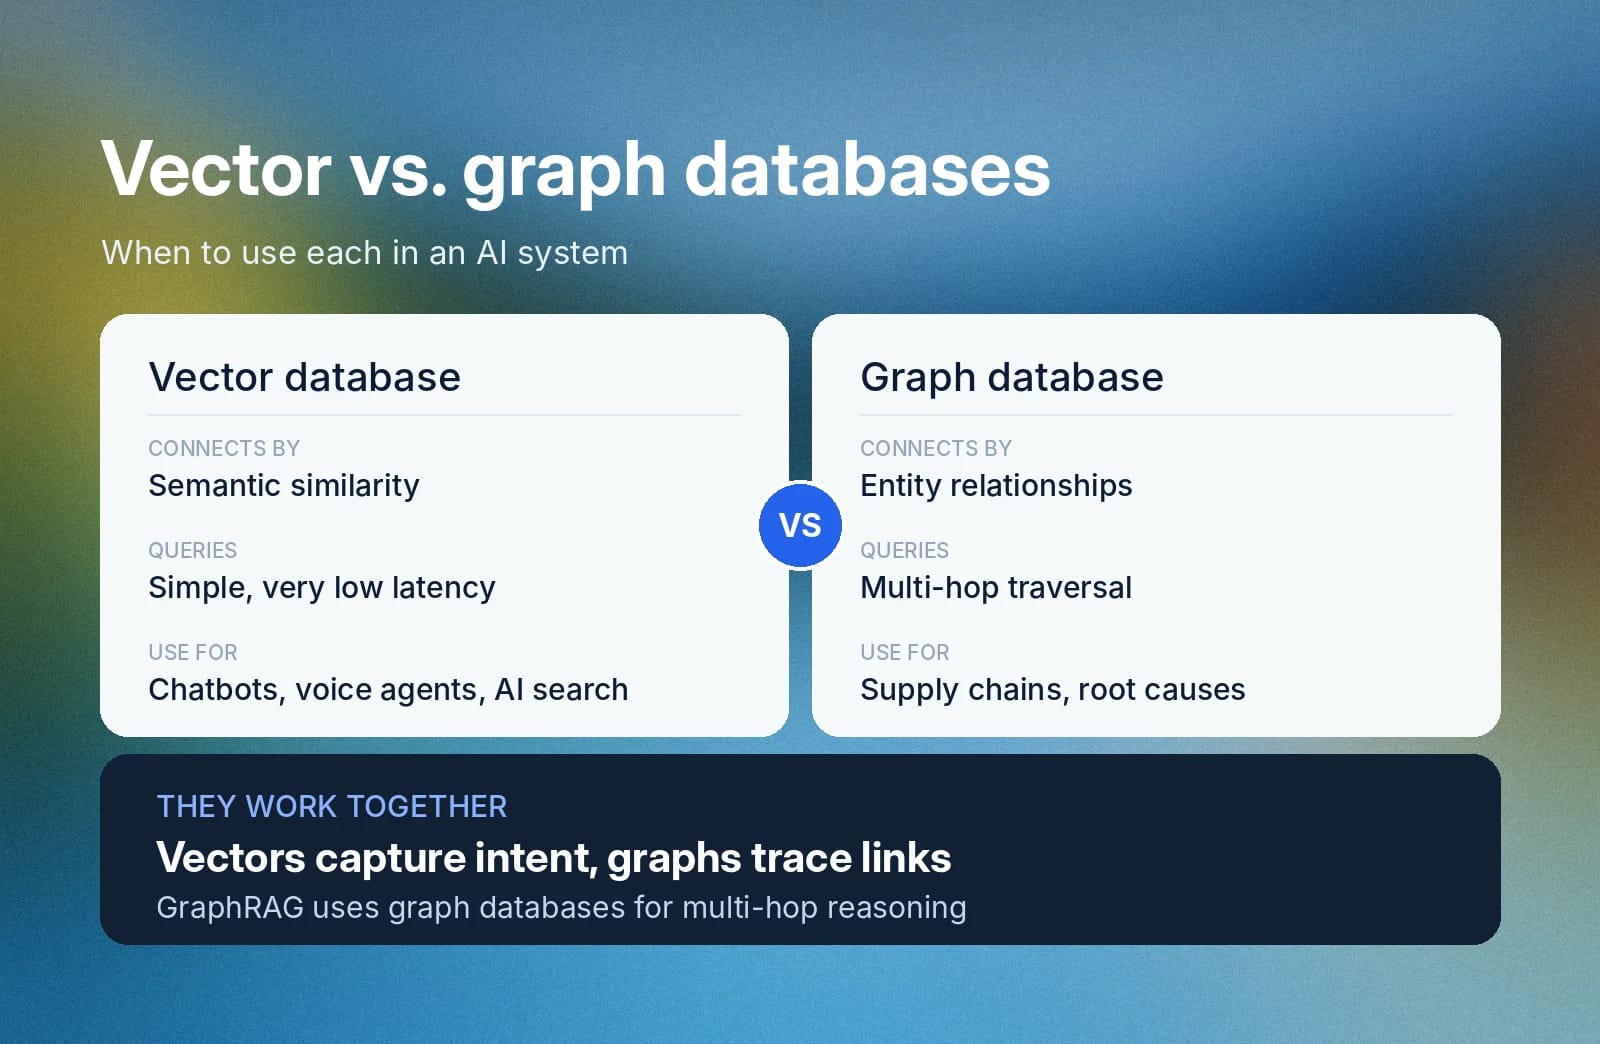
그래프 데이터베이스는 계층 구조와 관계를 반영하는 방식으로 서로 다른 엔터티를 연결하기 위해 지식 그래프를 사용합니다. GraphRAG 같은 AI 시스템은 멀티홉 추론이 필요한 쿼리에 답하기 위해 그래프 데이터베이스를 사용합니다.
그래프 데이터베이스를 쿼리하면 시작 데이터 포인트를 찾고 그래프 탐색 알고리즘을 사용해 관련 엔터티를 찾습니다. 예를 들어 고객 이름은 갱신일과 지원 티켓에 순차적으로 연결될 수 있습니다.
반면 벡터 데이터베이스는 의미를 기반으로 한 수치 표현으로 비정형 데이터를 저장합니다. RAG 시스템이 매우 짧은 지연 시간으로 단순한 쿼리 매칭을 수행하도록 지원합니다. 예를 들어 벡터 DB는 “환불을 원해요”라는 요청을 처리할 때 환불 정책을 찾아 제공합니다.
벡터 데이터베이스와 그래프 데이터베이스 모두 AI 시스템에 유용합니다. 두 가지를 함께 사용할 수 있습니다:
- 사람의 언어로 표현된 의도를 포착해야 하는 챗봇, 음성 에이전트 또는 AI 검색 엔진을 구축하려면 벡터 DB를 사용하세요.
- 공급망 추적, 관련 제품 추천, 근본 원인 분석처럼 상호 의존성 문제를 해결하려면 그래프 데이터베이스를 사용하세요.
사용 가능한 벡터 데이터베이스 유형은 무엇인가요?
일반적으로 벡터 데이터베이스는 아키텍처 스타일에 따라 두 가지 유형으로 나뉩니다.
- 독립형 벡터 DB: 저지연 다차원 유사성 검색을 지원하도록 독립적으로 설계된 전용 데이터베이스입니다. 많은 생성형 AI 애플리케이션은 대규모 쿼리 워크로드를 확장하기 위해 독립형 벡터 DB에 연결합니다.
- 벡터 데이터베이스 확장 기능: 기존 데이터베이스는 AI 모델의 의미 기반 검색을 지원하기 위해 벡터 검색 기능을 도입할 수 있습니다. 이러한 데이터베이스는 SQL 행 기반 스키마 같은 기존 아키텍처를 유지하면서 벡터 데이터 유형을 지원합니다.
선택은 주로 대규모 쿼리 워크로드를 위한 전용 시스템이 필요한지, 아니면 이미 운영 중인 데이터베이스에 의미 검색 기능을 추가하려는지에 따라 달라집니다.
벡터 데이터베이스 예시
벡터 DB의 두 가지 예시는 다음과 같습니다:
- 독립형 벡터 DB: Pinecone은 관리형 벡터 데이터베이스 서비스입니다. Milvus, Weaviate, Qdrant, Chroma는 오픈 소스 벡터 데이터베이스입니다.
- 벡터 DB 확장 기능: pgvector는 PostgreSQL에 벡터 유사성 검색을 추가하며, MongoDB Atlas Vector Search는 MongoDB에 이를 추가합니다.
어떤 것이 적합한지는 규모와 직접 관리하려는 인프라의 수준에 따라 달라집니다.
검색 기능을 갖춘 음성 에이전트를 위한 ElevenAgents 시작하기
ElevenAgents를 사용하면 음성 에이전트가 자체 지식 베이스에서 정보를 검색하여 대화형 맥락 인식 응답을 제공할 수 있습니다. RAG를 사용하면 에이전트는 지식 베이스에 추가한 문서, URL 또는 텍스트에서 의미적으로 가장 유사한 콘텐츠를 검색합니다. 검색을 “온디맨드”로 설정하면 에이전트가 필요하다고 판단할 때만 지식 베이스를 검색합니다.
RAG 구현 시 응답 생성 지연 시간이 늘어나는 것은 당연합니다. 하지만 엔지니어링 개선을 통해 ElevenAgents의 RAG 중앙 지연 시간을 326ms에서 155ms로 줄였습니다.
ElevenAgents를 시작하고 여기에서 지식 베이스 설정 방법을 알아보세요.
자주 묻는 질문

Jack Limebear는 Growth 팀에서 블로그와 인사이트 페이지의 콘텐츠 작가이자 전략가로 활동하고 있습니다. ElevenLabs에 합류하기 전에는 빠르게 성장하는 SaaS 스타트업부터 포춘 500대 기업까지 다양한 조직에서 10년 넘게 콘텐츠 전략을 이끌었습니다. 케임브리지 대학교에서 영문학 석사 학위를 취득했습니다.


