RAG 속도를 50% 높인 엔지니어링 방법
- 게시일
- 최종 업데이트
RAG는 LLM 응답을 대규모 지식 베이스에 기반하도록 해 AI 에이전트의 정확도를 높입니다. 전체 지식 베이스를 LLM에 전달하는 대신, RAG는 쿼리를 임베딩하고 가장 관련성 높은 정보를 검색한 뒤 모델에 컨텍스트로 전달합니다. ElevenLabs 시스템에서는 검색 전에 대화 기록을 정확하고 독립적인 쿼리로 압축하는 쿼리 재작성 단계를 먼저 추가합니다.
지식 베이스가 매우 작다면 모든 내용을 프롬프트에 직접 넣는 편이 더 간단할 수 있습니다. 하지만 지식 베이스가 커지면 RAG는 모델에 과도한 부담을 주지 않으면서 응답 정확도를 유지하는 데 필수적입니다.
많은 시스템이 RAG를 외부 도구로 처리하지만, ElevenLabs는 모든 쿼리에서 실행되도록 요청 파이프라인에 직접 통합했습니다. 이를 통해 일관된 정확도를 보장하는 한편, 지연 시간의 위험도 발생합니다.
쿼리 재작성으로 속도가 느려진 이유
대부분의 사용자 요청은 이전 대화 내용을 참조하므로, 시스템은 대화 기록을 정확하고 독립적인 쿼리로 압축해야 합니다.
예를 들면 다음과 같습니다.
- 사용자가 다음과 같이 묻는 경우: “피크 트래픽 패턴에 따라 그 제한을 맞춤 설정할 수 있나요?"
- 시스템은 이를 다음과 같이 재작성합니다: “엔터프라이즈 요금제의 API 속도 제한을 특정 트래픽 패턴에 맞게 맞춤 설정할 수 있나요?”
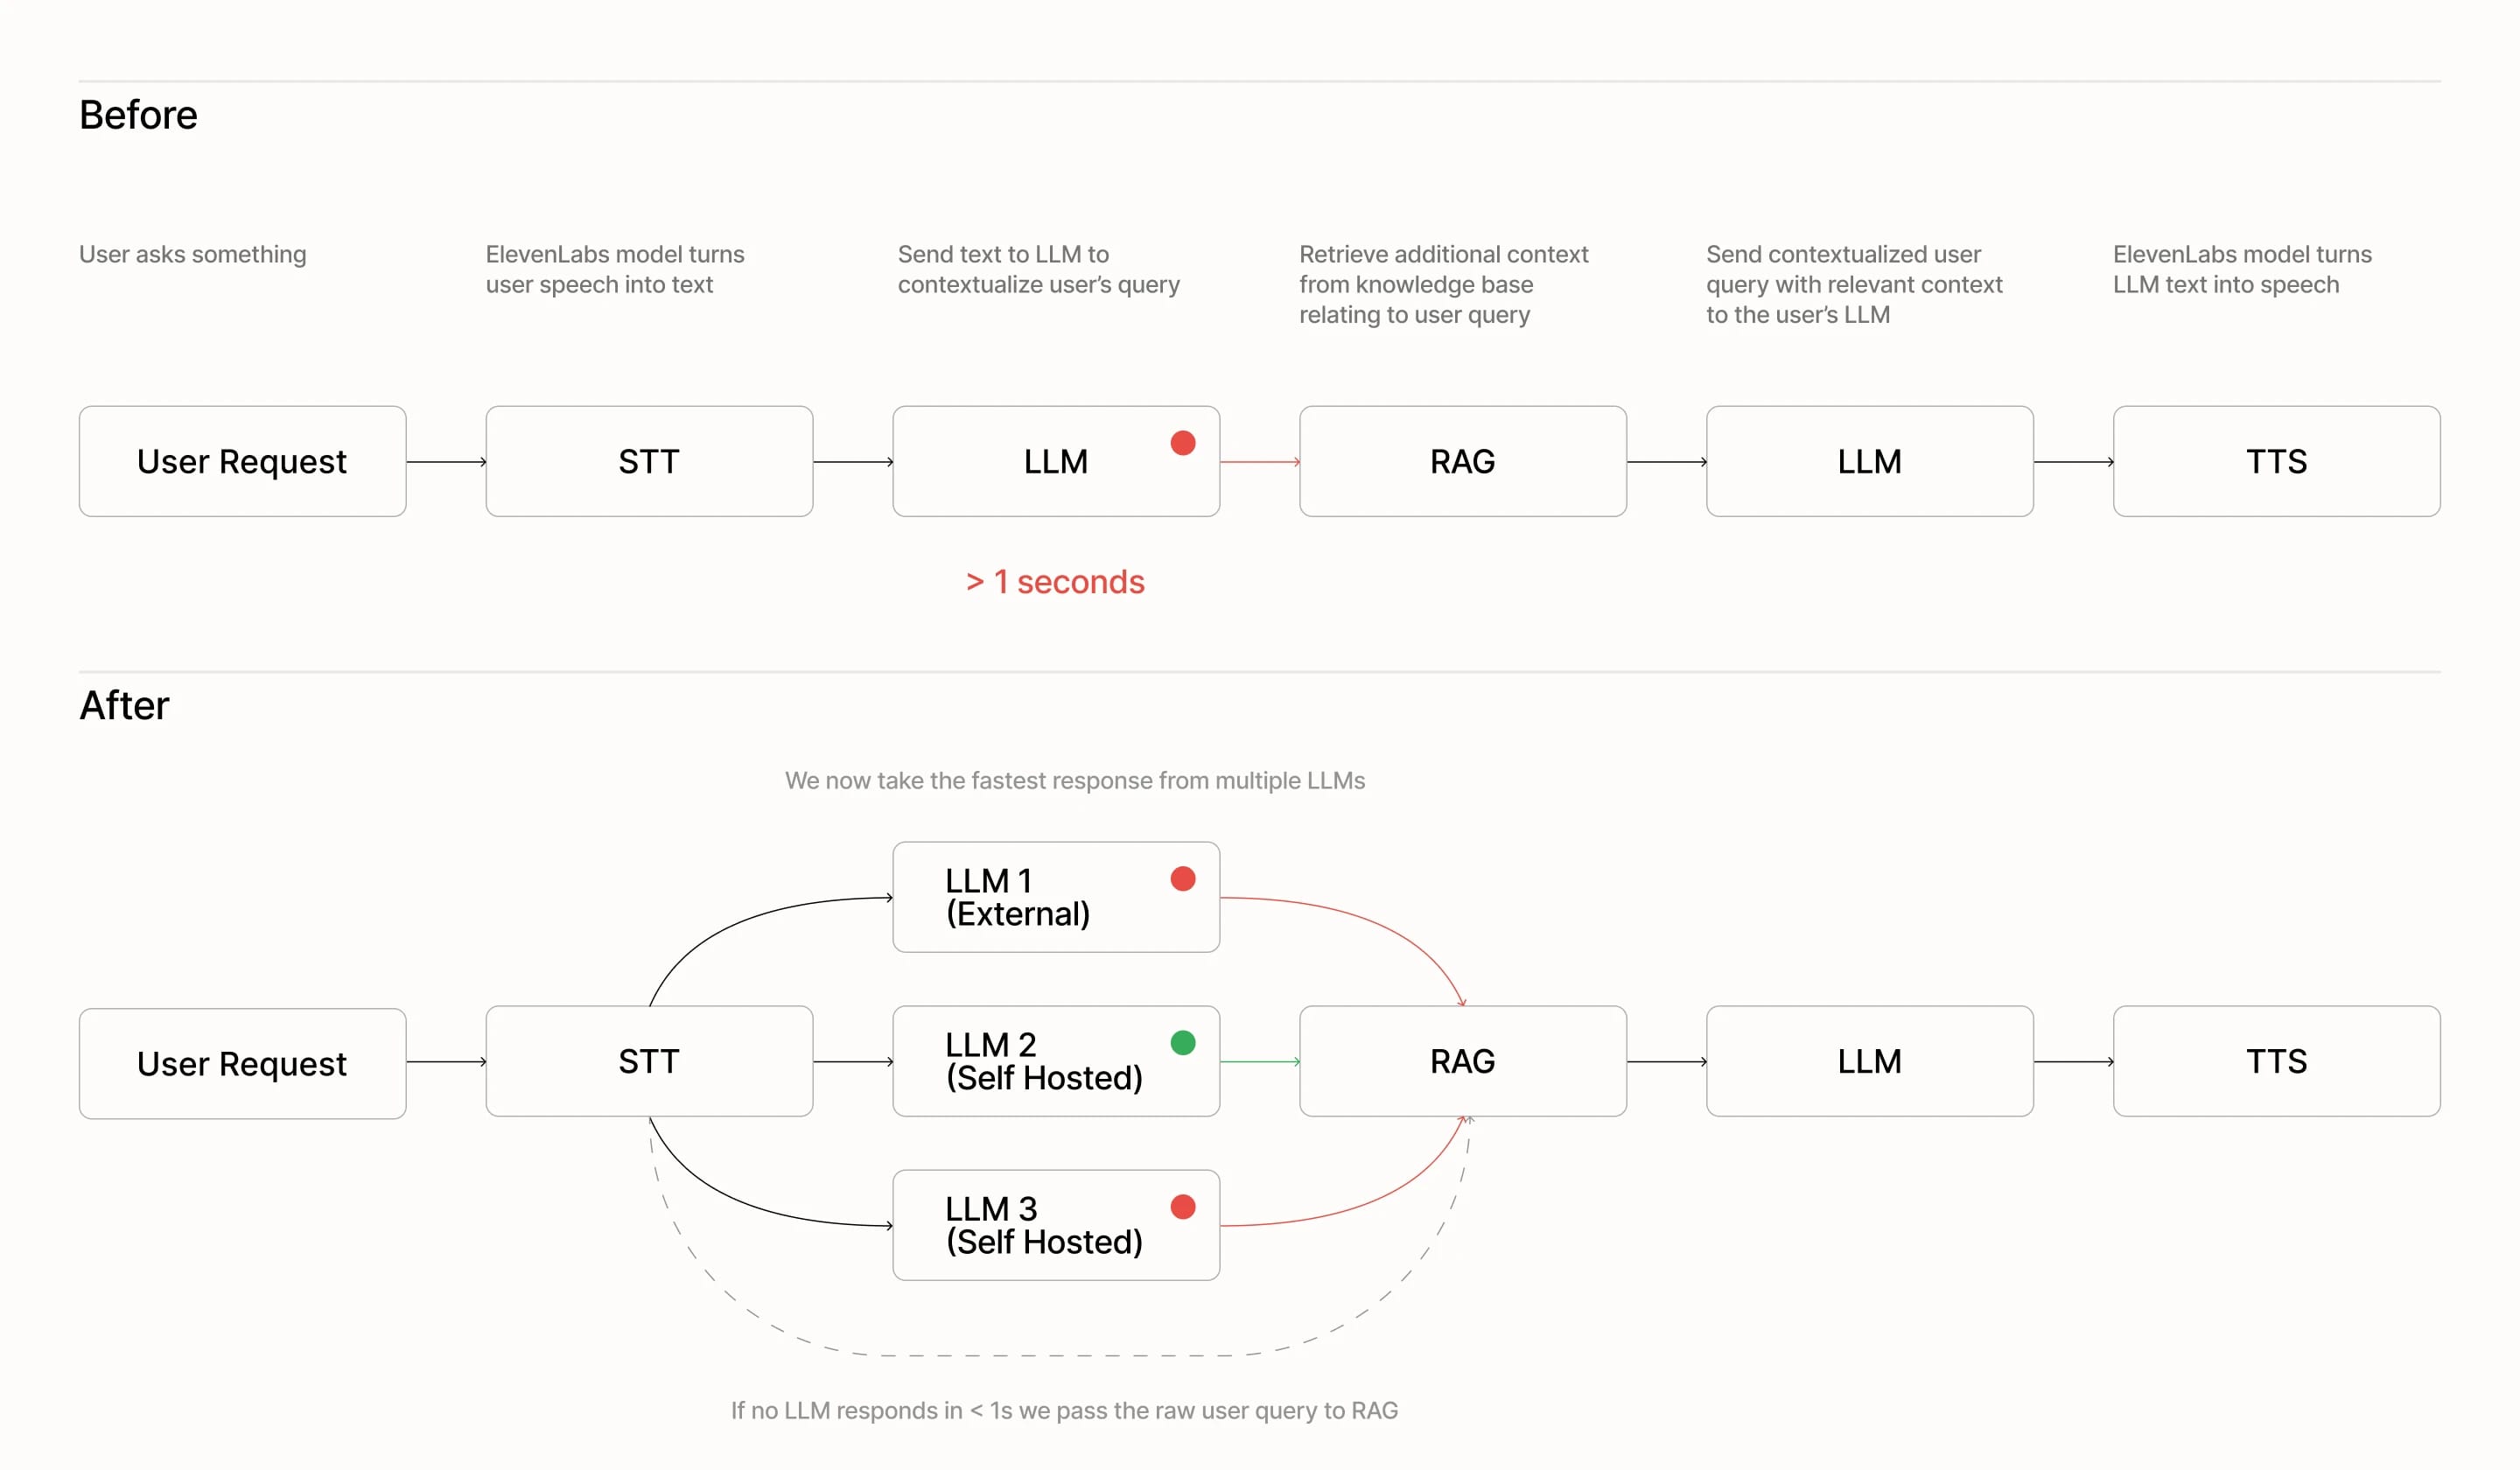
재작성은 “그 제한”처럼 모호한 참조를 검색 시스템이 사용할 수 있는 독립적인 쿼리로 바꿔, 최종 응답의 컨텍스트와 정확도를 향상합니다. 하지만 외부 호스팅 LLM 하나에 의존하면서 해당 모델의 속도와 가용성에 크게 좌우됐습니다. 이 단계만으로도 전체 RAG 지연 시간의 80% 이상을 차지했습니다.
모델 레이싱으로 해결한 방법
쿼리 재작성이 경쟁 방식으로 실행되도록 재설계했습니다:
- 여러 모델을 병렬로 실행. 각 쿼리는 자체 호스팅 Qwen 3-4B 및 3-30B-A3B 모델을 포함한 여러 모델에 동시에 전송됩니다. 가장 먼저 도착한 유효한 응답이 선택됩니다.
- 대화를 끊김 없이 이어가는 폴백. 1초 안에 응답하는 모델이 없으면 사용자의 원본 메시지로 폴백합니다. 정확도는 다소 낮을 수 있지만, 지연을 방지하고 대화의 연속성을 보장합니다.
성능에 미친 영향
새 아키텍처로 중앙 RAG 지연 시간은 326ms에서 155ms로 절반 이상 줄었습니다. RAG를 외부 도구로 선택적으로 호출하는 많은 시스템과 달리, ElevenLabs는 모든 쿼리에서 RAG를 실행합니다. 중앙 지연 시간이 155ms로 낮아지면서 이에 따른 오버헤드는 거의 무시할 수 있는 수준입니다.
변경 전후 지연 시간:
- 중앙값: 326ms → 155ms
- p75: 436ms → 250ms
- p95: 629ms → 426ms
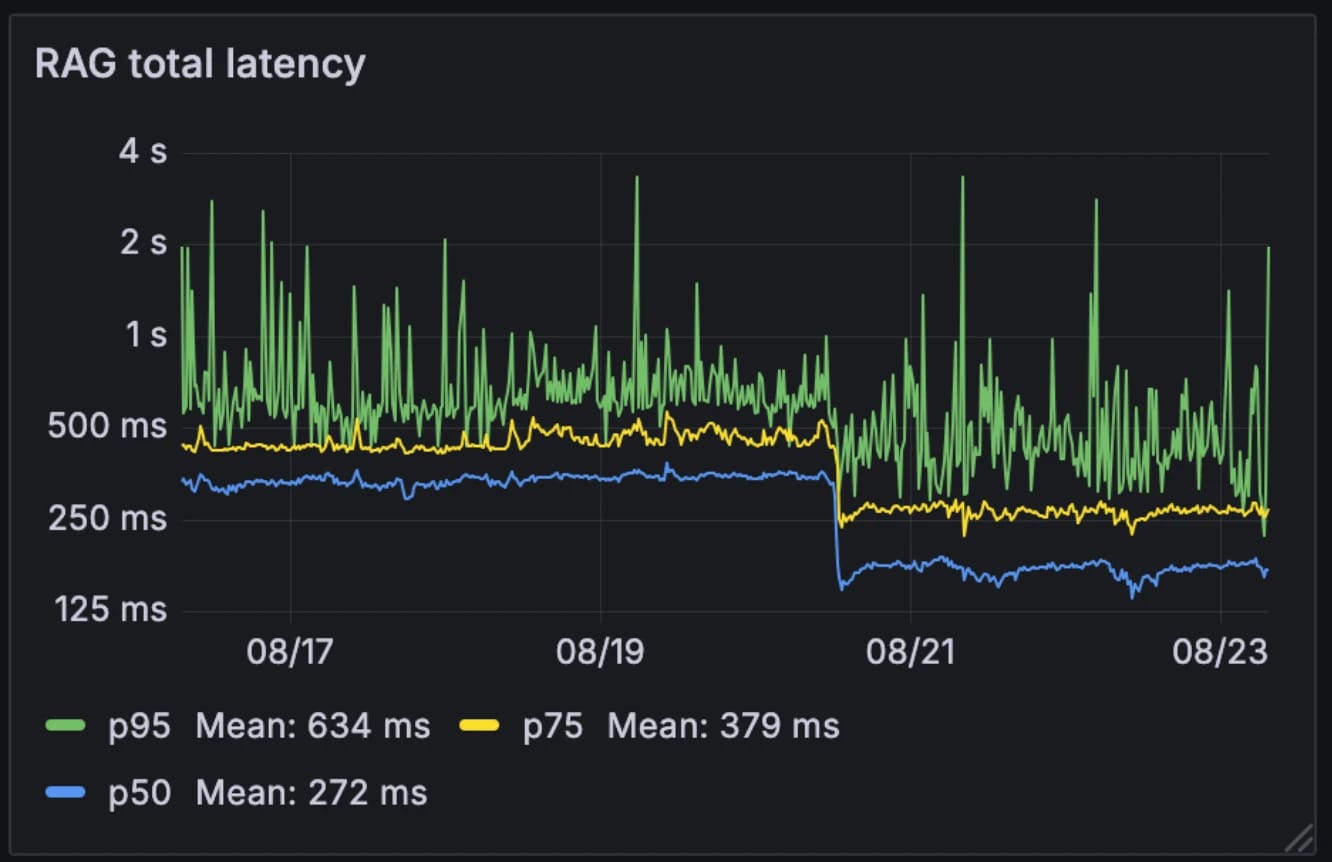
이 아키텍처는 모델별 성능 변동에 대한 시스템의 복원력도 높였습니다. 외부 호스팅 모델은 수요가 몰리는 시간대에 느려질 수 있지만, 내부 모델은 비교적 일관된 성능을 유지합니다. 모델을 경쟁시키면 이런 변동성이 완화되어 예측하기 어려운 개별 모델 성능이 더 안정적인 시스템 동작으로 바뀝니다.
예를 들어 지난달 LLM 제공업체 중 한 곳에서 장애가 발생했을 때도, 자체 호스팅 모델에서 대화는 끊김 없이 이어졌습니다. 이 인프라는 이미 다른 서비스에도 운영하고 있으므로 추가 컴퓨팅 비용은 거의 무시할 수 있는 수준입니다.
중요한 이유
200ms 미만의 RAG 쿼리 재작성은 대화형 AI 에이전트의 주요 병목을 해소합니다. 그 결과 대규모 엔터프라이즈 지식 베이스에서 작동할 때도 컨텍스트를 이해하면서 실시간으로 응답하는 시스템을 구현할 수 있습니다. 검색 오버헤드가 거의 무시할 수 있는 수준으로 줄어들어, 대화형 AI 에이전트는 성능 저하 없이 확장할 수 있습니다.