이제 누구나 Scribe v2 Medical을 사용할 수 있습니다
- 작성자
- Min Kim
- 게시일
- 최종 업데이트
듣기이 글 오디오로 듣기
임상 오디오는 정확한 음성 인식 성능을 시험하는 가장 어려운 영역 중 하나입니다. 약물명은 길고 드물며 혼동하기 쉽습니다(하이드록시진과 하이드랄라진은 한 음절만 잘못 들어도 구분하기 어렵습니다). 용량, 단위, 해부학 및 병리학 용어가 빠르게 연이어 나와 어휘 밀도가 높습니다. 전사 오류가 환자 차트에 기록될 수 있으므로 그 중요성도 더욱 큽니다.
이러한 이유로 ElevenLabs는 오늘 Scribe v2 Medical, 임상 오디오에 맞춰 미세 조정한 음성 텍스트 변환 모델을 출시합니다. 이제 ElevenAPI에서 정식으로 이용할 수 있습니다. 아래 평가에서 비교한 모델 가운데 일관되게 가장 낮은 수준의 단어 오류율(WER)을 기록했으며, 기본 Scribe v2 모델 대비 임상 오디오의 WER를 약 35% 낮췄습니다.
범용 모델은 일상적인 음성을 처리하는 데 뛰어나지만, 임상 workflow에서 가장 필요한 상황에서는 성능이 저하될 수 있습니다. 누구나 재현할 수 있는 공개 벤치마크를 기반으로, 약물명과 임상 받아쓰기에 초점을 맞춘 Scribe v2 의료 미세 조정 모델을 학습했습니다.
Scribe v2 Medical은 임상 사용 사례에 최적화되었습니다
임상 받아쓰기(MedDictate)
Corti의 MedDictate는 영어, 프랑스어, 독일어로 약물명, 용량 및 단위가 연달아 등장하는 받아쓰기 임상 노트의 전사 성능을 테스트합니다. 평가 결과 Scribe v2 Medical은 테스트한 모델 중 전체 WER가 가장 낮았으며, 기본 Scribe v2보다 WER가 약 35% 낮았습니다.
모델 | 영어 | 프랑스어 | 독일어 | 전체 WER |
Scribe v2 Medical | 3.0% | 8.3% | 7.2% | 4.9% |
OpenAI GPT Transcribe | 3.9% | 7.8% | 9.6% | 5.9% |
Scribe v2(기본) | 5.0% | 10.7% | 11.7% | 7.6% |
Muse Voice Transcribe 1.0 | 4.5% | 11.0% | 13.3% | 7.8% |
Deepgram Nova-3 Medical* | 5.5% | - | - | - |
*영어만 지원(클립 24개) - Deepgram Nova-3 Medical은 프랑스어 또는 독일어를 지원하지 않습니다.
의료 용어(MedTerm)
MedTerm 역시 Corti가 공개한 데이터세트로, 동일한 세 언어로 구성된 600개 샘플의 임상 용어 벤치마크를 포함하며 각 샘플의 의료 용어에 주석이 달려 있습니다. 이 주석을 통해 전체 전사 WER 외에도 두 가지 차원에서 모델을 평가할 수 있습니다. 용어 재현율은 주석 처리된 의료 용어가 전사본에 정확히 나타난 비율입니다(높을수록 좋음). 용어 WER는 주변의 일반적인 음성을 제외하고 해당 용어만을 대상으로 한 오류율입니다(낮을수록 좋음).
Scribe v2 Medical은 두 지표 모두에서 테스트한 모든 모델을 앞섰으며, 세 언어 모두에서 다른 모든 제공업체보다 높은 성능을 보였습니다:
모델 | 용어 재현율 ↑ | 용어 WER ↓ |
Scribe v2 Medical | 77.7% | 10.4% |
Scribe v2(기본) | 77.1% | 10.7% |
OpenAI GPT Transcribe | 74.0% | 12.3% |
Muse Voice Transcribe 1.0 | 73.4% | 12.9% |
Deepgram Nova-3 Medical* | 72.5% | 13.6% |
Eka Medical ASR 벤치마크
Eka Medical ASR 벤치마크에는 개별 약물명 및 질환명, 임상 문장, 의료진과 환자의 대화에 걸친 3,619개의 영어 임상 오디오 샘플이 포함되어 있으며, 용어별 주석과 데이터세트 카드에 공개된 리더보드가 제공됩니다.
공개 데이터세트에는 Gemini 2.5 Flash 및 GPT-4o 같은 이전 모델이 포함되어 있으므로, 최신 모델을 대상으로 평가를 진행했습니다. SemWER(의미 WER)는 형식과 관계없이 모델이 올바른 내용을 들었는지 평가합니다("mg"와 "milligrams"는 같은 답변으로 간주). kwWER(키워드 WER)는 주석 처리된 의료 키워드에만 동일한 평가 방식을 적용합니다.
모델 | semWER | kwWER |
Scribe v2 Medical | 6.50% | 6.02% |
Scribe v2(기본) | 7.35% | 7.04% |
Deepgram Nova-3 Medical | 7.79% | 7.65% |
Muse Voice Transcribe 1.0 | 8.85% | 8.99% |
OpenAI GPT Transcribe | 13.90% | 13.20% |
Eka는 각 샘플의 의료 용어에 주석을 달아, 의료 용어만을 대상으로 Scribe v2 Medical의 기본 모델 대비 성능 향상을 더 세밀하게 평가할 수 있습니다. Scribe v2 Medical은 기본 모델보다 오류가 15% 적었으며(9.5% 대 11.1%), 용어가 완전한 임상 문장 안에 등장할 때 향상 폭이 가장 컸습니다(7.5% 대 9.9%).
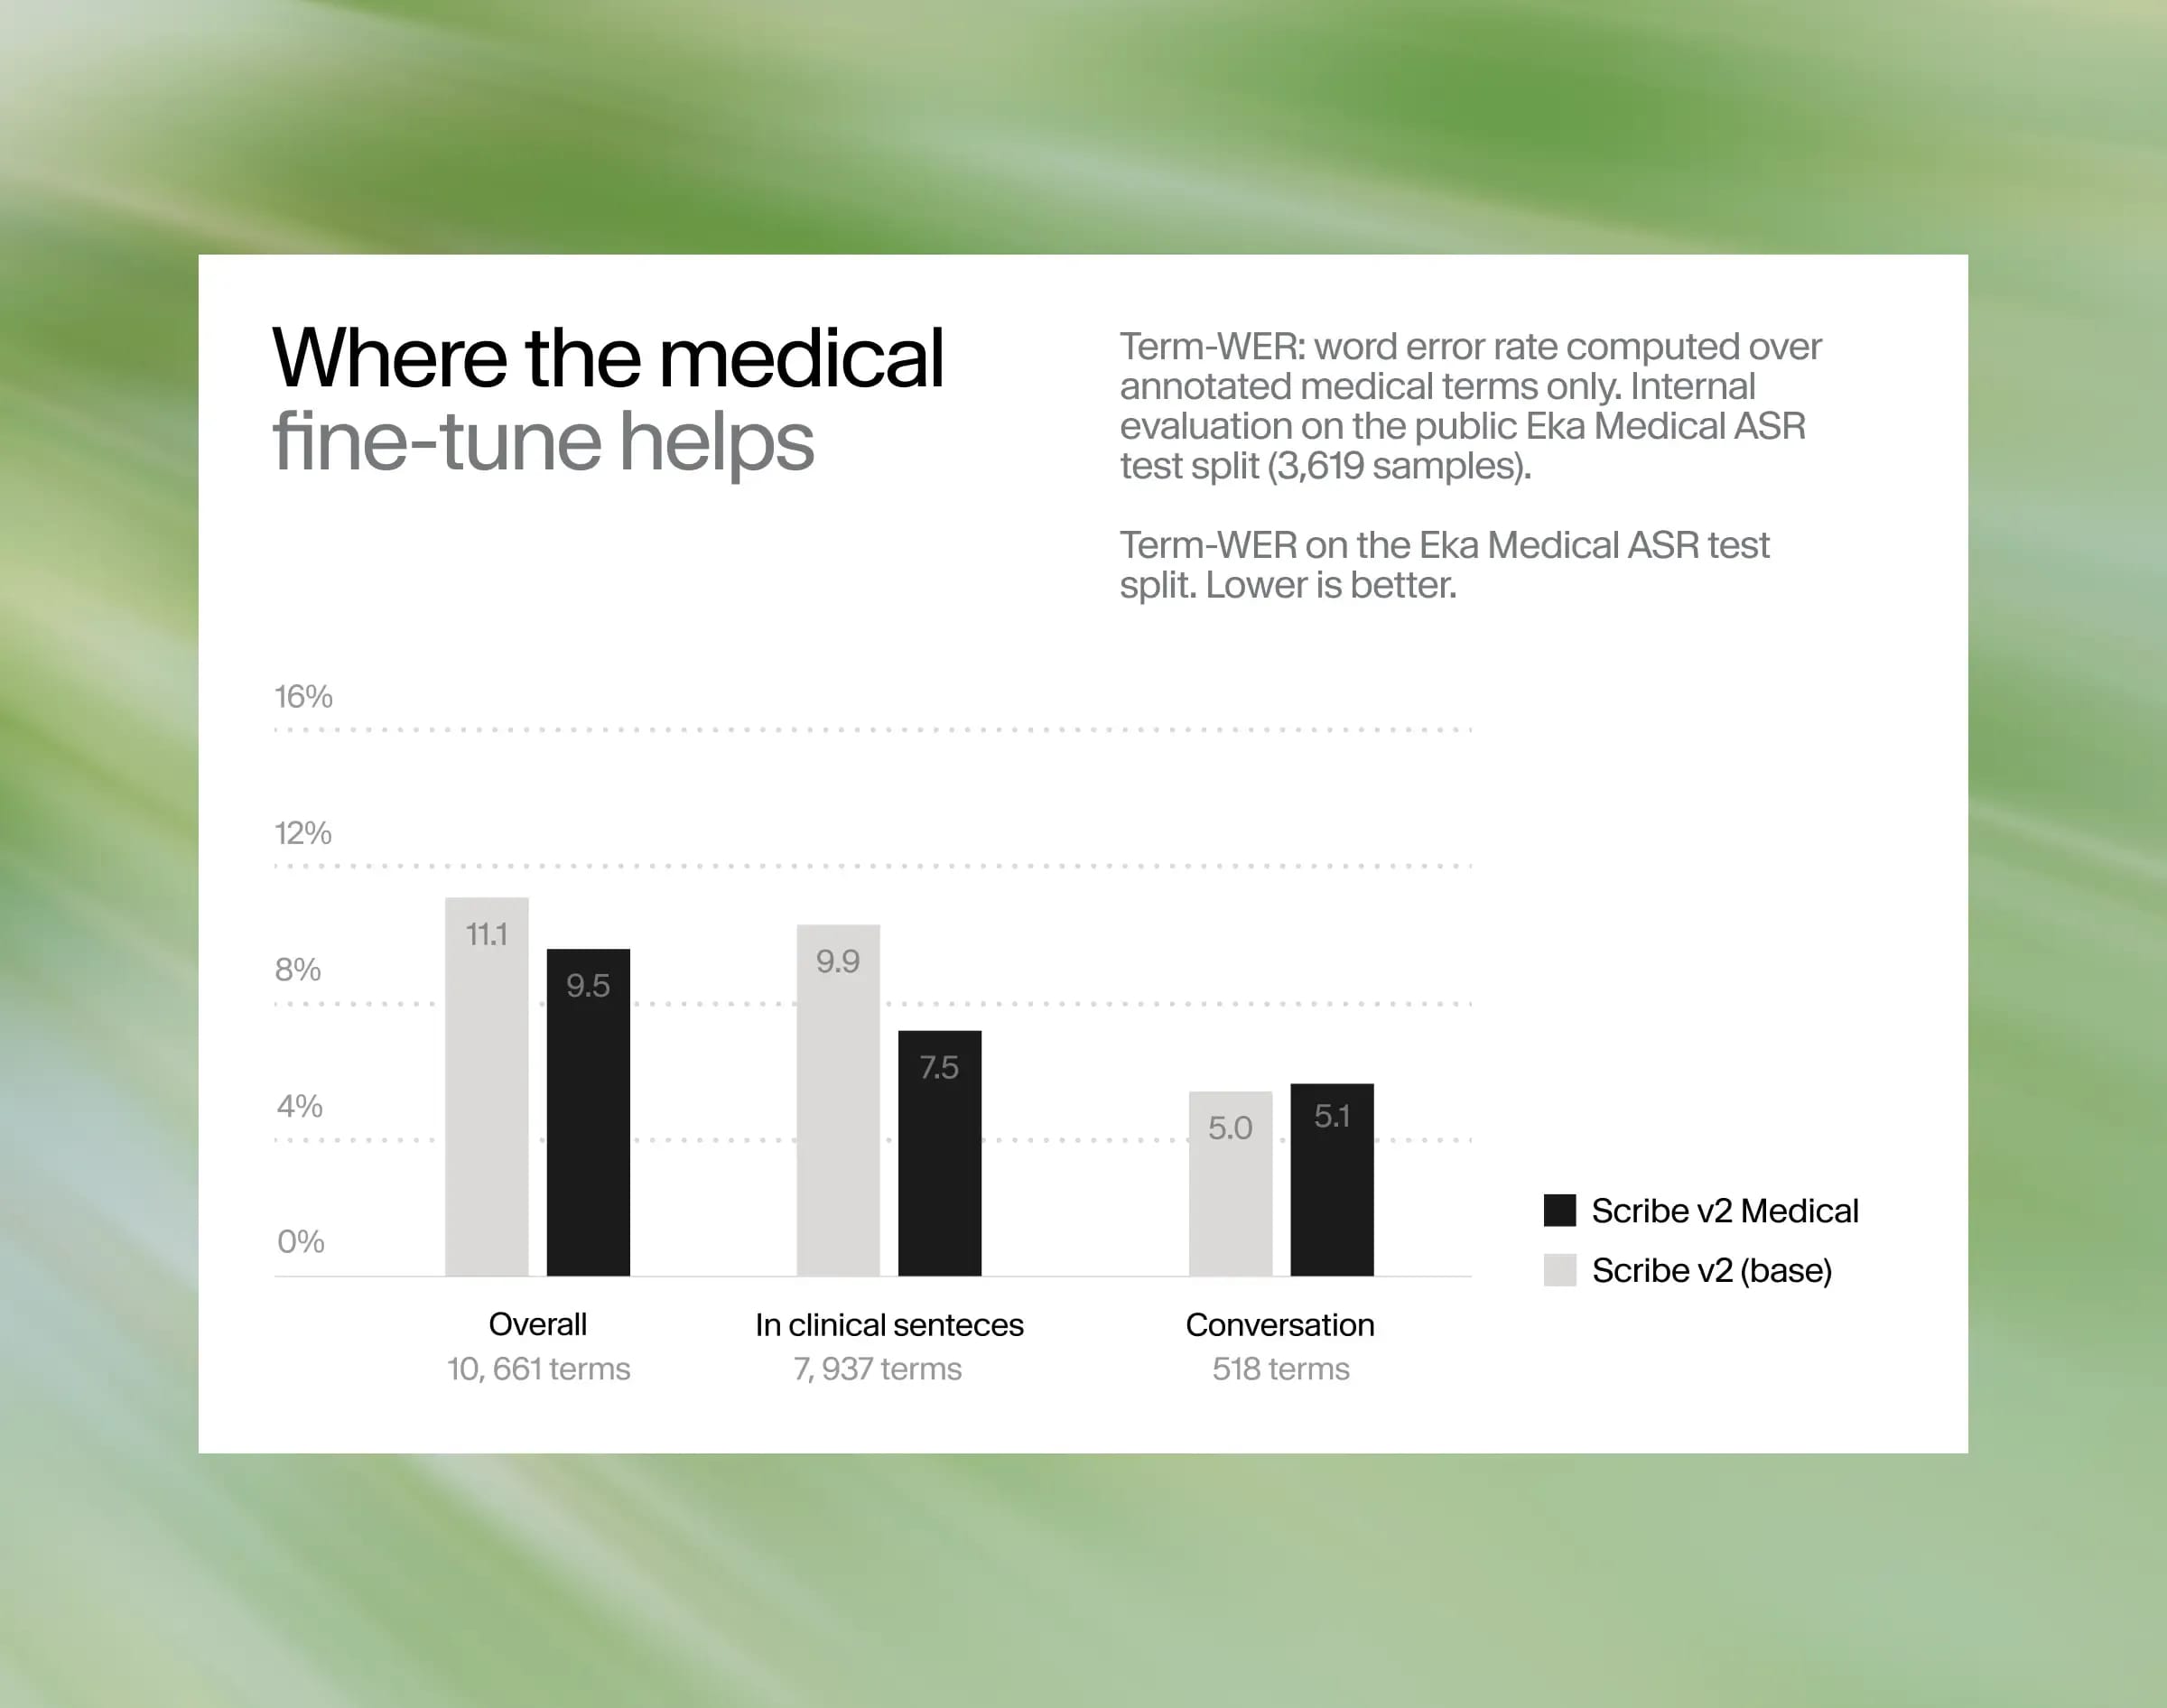
같은 데이터에서 알 수 있는 한 가지 주의점은 주변 맥락 없이 약물명 하나만 발화된 고립된 단일 단어 클립이 Scribe v2 Medical을 포함해 리더보드의 모든 모델에서 여전히 가장 어려운 사례라는 점입니다. 고립된 용어에서는 14.3% WER를 기록했지만, 해당 용어가 문장에 나타날 때는 7.5%였습니다. 맥락이 전혀 없으면 한 음절을 잘못 들은 것만으로도 인상적인 오류가 발생할 수 있습니다:
- etodolac(NSAID) → "It'll do the luck"
- levomilnacipran(항우울제) → "Leave me alone now, Sephora."
- methdilazine(항히스타민제) → "Let's play our scene."
이러한 오류를 줄이는 한 가지 방법은 키워드 프롬프팅으로, 약물명이나 의료 문구를 강조하여 모델이 이를 정확하게 전사하도록 유도할 수 있습니다.
프로덕션 환경의 고객
고객들은 이미 프로덕션 환경에서 Scribe v2 Medical을 사용하며 임상 오디오 성능 향상을 확인하고 있습니다.
CareCo의 CEO 겸 창립자 Mendel Erlenwein은 "Deepgram에서 ElevenLabs Scribe v2 Medical로 전환한 이후 임상 용어의 정확도가 훨씬 높아졌고, 팀의 업무 방식도 달라졌습니다. 코디네이터가 전사본을 신뢰하면 메모를 수정하는 시간은 줄고 환자와 통화하는 시간은 늘어납니다. 환자들은 복잡한 치료 요법을 따르고 있으므로, 케어 팀이 읽는 기록은 정확해야 합니다"라고 말했습니다.
일반 음성에서도 뛰어난 성능
팀은 의료 미세 조정이 다른 영역의 성능을 저하시키지 않는다는 점도 검증했습니다. Common Voice에서 추출한 일상적인 비의료 음성 샘플 6,000개에서 Scribe v2 Medical은 반올림 기준으로 기본 Scribe v2와 동일한 성능을 기록했으며, 두 경우 모두 WER는 5.3%였습니다. 즉, v2 Medical을 사용하면 이 벤치마크에서 정확도를 포기하지 않고도 전문 의료 모델의 이점을 누릴 수 있습니다.
보호 대상 건강 정보를 위해 설계
Scribe v2 Medical은 비즈니스 제휴 계약을 체결하고 Zero Retention Mode(ZRM)를 활성화한 엔터프라이즈 고객이 HIPAA 적격 서비스로 이용할 수 있습니다.
음성 텍스트 변환 API 요청에 ZRM을 활성화하면 각 요청이 완료된 직후 오디오 입력과 텍스트 출력이 삭제됩니다. ElevenLabs는 어느 것도 보관하지 않으며, 애플리케이션은 전체 API 응답을 받고 전사본 보관 방식을 제어합니다.
시작하기
Scribe v2 Medical은 음성 텍스트 변환 API에서 사용할 수 있습니다. 새 모델 ID를 전달하기만 하면 됩니다: scribe_v2_medical
이 모델은 배치 음성 텍스트 변환 엔드포인트에서 실행됩니다.