最も高精度なスピーチtoテキストモデル、Scribe v3とv3 Liveを発表
- 執筆者
- Min Kim
- 公開日
聴くこの記事を聴く
オーディオを基盤とするプロダクトは、会議メモ、音声エージェント、吹き替え、臨床文書、数十年分のコンテンツに及ぶ放送アーカイブなど、すべて文字起こしから始まります。最初から正確に文字起こしすることが重要です。誤りは後続の工程へ引き継がれ、修正コストがはるかに高くなるためです。
しかし、現実のオーディオは複雑です。会議で複数人が同時に話したり、にぎやかな通りにいる顧客が文の途中で言葉を止めたり、サポート通話で双方が母語以外の言語を話したりすることがあります。
本日ElevenLabsは、まさにこうした状況に対応する2つの新しいスピーチtoテキストモデルを発表します。
- 録音済みオーディオ向けのScribe v3は、102言語においてScribe v2より単語の誤りを27%削減し、テストしたすべてのモデルの中で最も高精度な話者ラベルを実現しました。
- Scribe v3 Liveはリアルタイムオーディオ向けの低レイテンシーモデルで、Scribe v2 Realtimeよりもエラーを43%削減します。また、話者ダイアライゼーション(誰が何を話したかの識別)に初めて対応し、発話終了検出も改善されています。
Scribe v3 Liveは、本日よりElevenAgentsで利用できます。両モデルはElevenAPIでも利用でき、Scribe v2からの切り替えはモデルIDを1行変更するだけです。
Scribe v3を形作ったフィードバック
Scribeは、会議メモアプリ、コンタクトセンター、臨床文書ツール、音声エージェントで、数億時間に及ぶ文字起こしを支えてきました。用途を問わず、開発チームから繰り返し寄せられた要望は、同じ5つでした。
会議・メモ作成ツールのチームは、短いやり取りや3人以上の会話で、より正確な話者分離を求めていました。音声エージェントのチームからは、発信者が文の途中で間を置いたり、数字を読み上げるために話す速度を落としたりすると、無音タイマーが発話を途中で切ってしまうという声がありました。ライブプロダクトの開発チームは、リアルタイム処理の精度がバッチ処理より明らかに低いため、速度と引き換えに精度を妥協していました。インドの顧客は、発信者が文の途中でヒンディー語と英語を切り替えても、ヒンディー語で英語と同等の精度を求めていました。また、「123」のような数字表記から、プロダクトカタログや医薬品名のリストにも対応できる長い重要用語リストまで、出力をより細かく制御したいという要望も多く寄せられました。
話者ラベル、ターン検出、出力の詳細な制御
大人数の会話でも高精度な話者分離
会議の文字起こしでは、正しい単語を記録するのと同じくらい、話者を正しく識別することが重要です。既存モデルの多くが苦手とする3人以上の録音で、Scribe v3はScribe v2より話者分離の誤りを17%削減しました。Scribe v3 Liveは、リアルタイム文字起こしで初めて話者分離に対応し、テストした中で次に高精度だったリアルタイムモデルよりも話者分離の誤りを39%削減しています。
会話の流れを理解するターン検出
自然な会話を実現するには、音声エージェントが話者の発話終了を正確に予測する必要があります。従来のターンテイキングシステムは、無音時間をもとに発話終了を判断します。しかし、無音だけを基準にするとトレードオフが生じます。しきい値を短くすると文の途中で間を置いた人の発話を遮る可能性があり、長くするとエージェントの反応が遅く感じられます。Scribe v3 Liveは、オーディオだけでなく会話の文脈も利用するため、数字を読み上げている途中で発信者が間を置いても、発話を遮りません。これはElevenAgentsですでに使用されているターン検出と同じもので、ElevenAPIでも利用できるようになりました。
言語、用語、書式をより細かく制御
Scribe v3は、録音に含まれる可能性のある言語についてのヒントを推測でき、数字を数値と単語のどちらで出力するかも選べます。重要用語プロンプトには、ブランド名、略語、専門用語など、登場するとわかっている用語を最大1,000件指定できます。また、文字起こし編集では「すべての日付をYYYY-MM-DD形式で記述する」のように、平易な英語で記述した書式ルールを適用できます。
Scribe v3 Liveには、文の途中で言語が切り替わる会話に対応する多言語モードが追加されました。リストでは収まりきらない語彙向けに、重要用語ライブラリも追加されています。重要用語プロンプトが登場するとわかっている用語を対象とするのに対し、重要用語ライブラリには登場する可能性がある用語を数千件登録でき、モデルは一致する可能性が高い語を聞いた場合にのみ参照します。
Scribe v3の性能
ElevenLabsは、同一のデータセットを使ってScribe v3とScribe v3 LiveをScribe v2、Scribe v2 Realtime、その他の主要なスピーチtoテキストモデルと比較評価しました。多言語の精度は、102言語の短く明瞭な読み上げ音声をテストするFLEURSベンチマークの社内版で測定しました。FLEURSの各クリップには話者が1人しかいないため、話者分離は測定できません。そこで、16言語の実際の会議、エージェントとの通話、ボイスメモから独自のデータセットも構築しました。このデータセットは近日中にオープンソース化する予定です。
話者分離
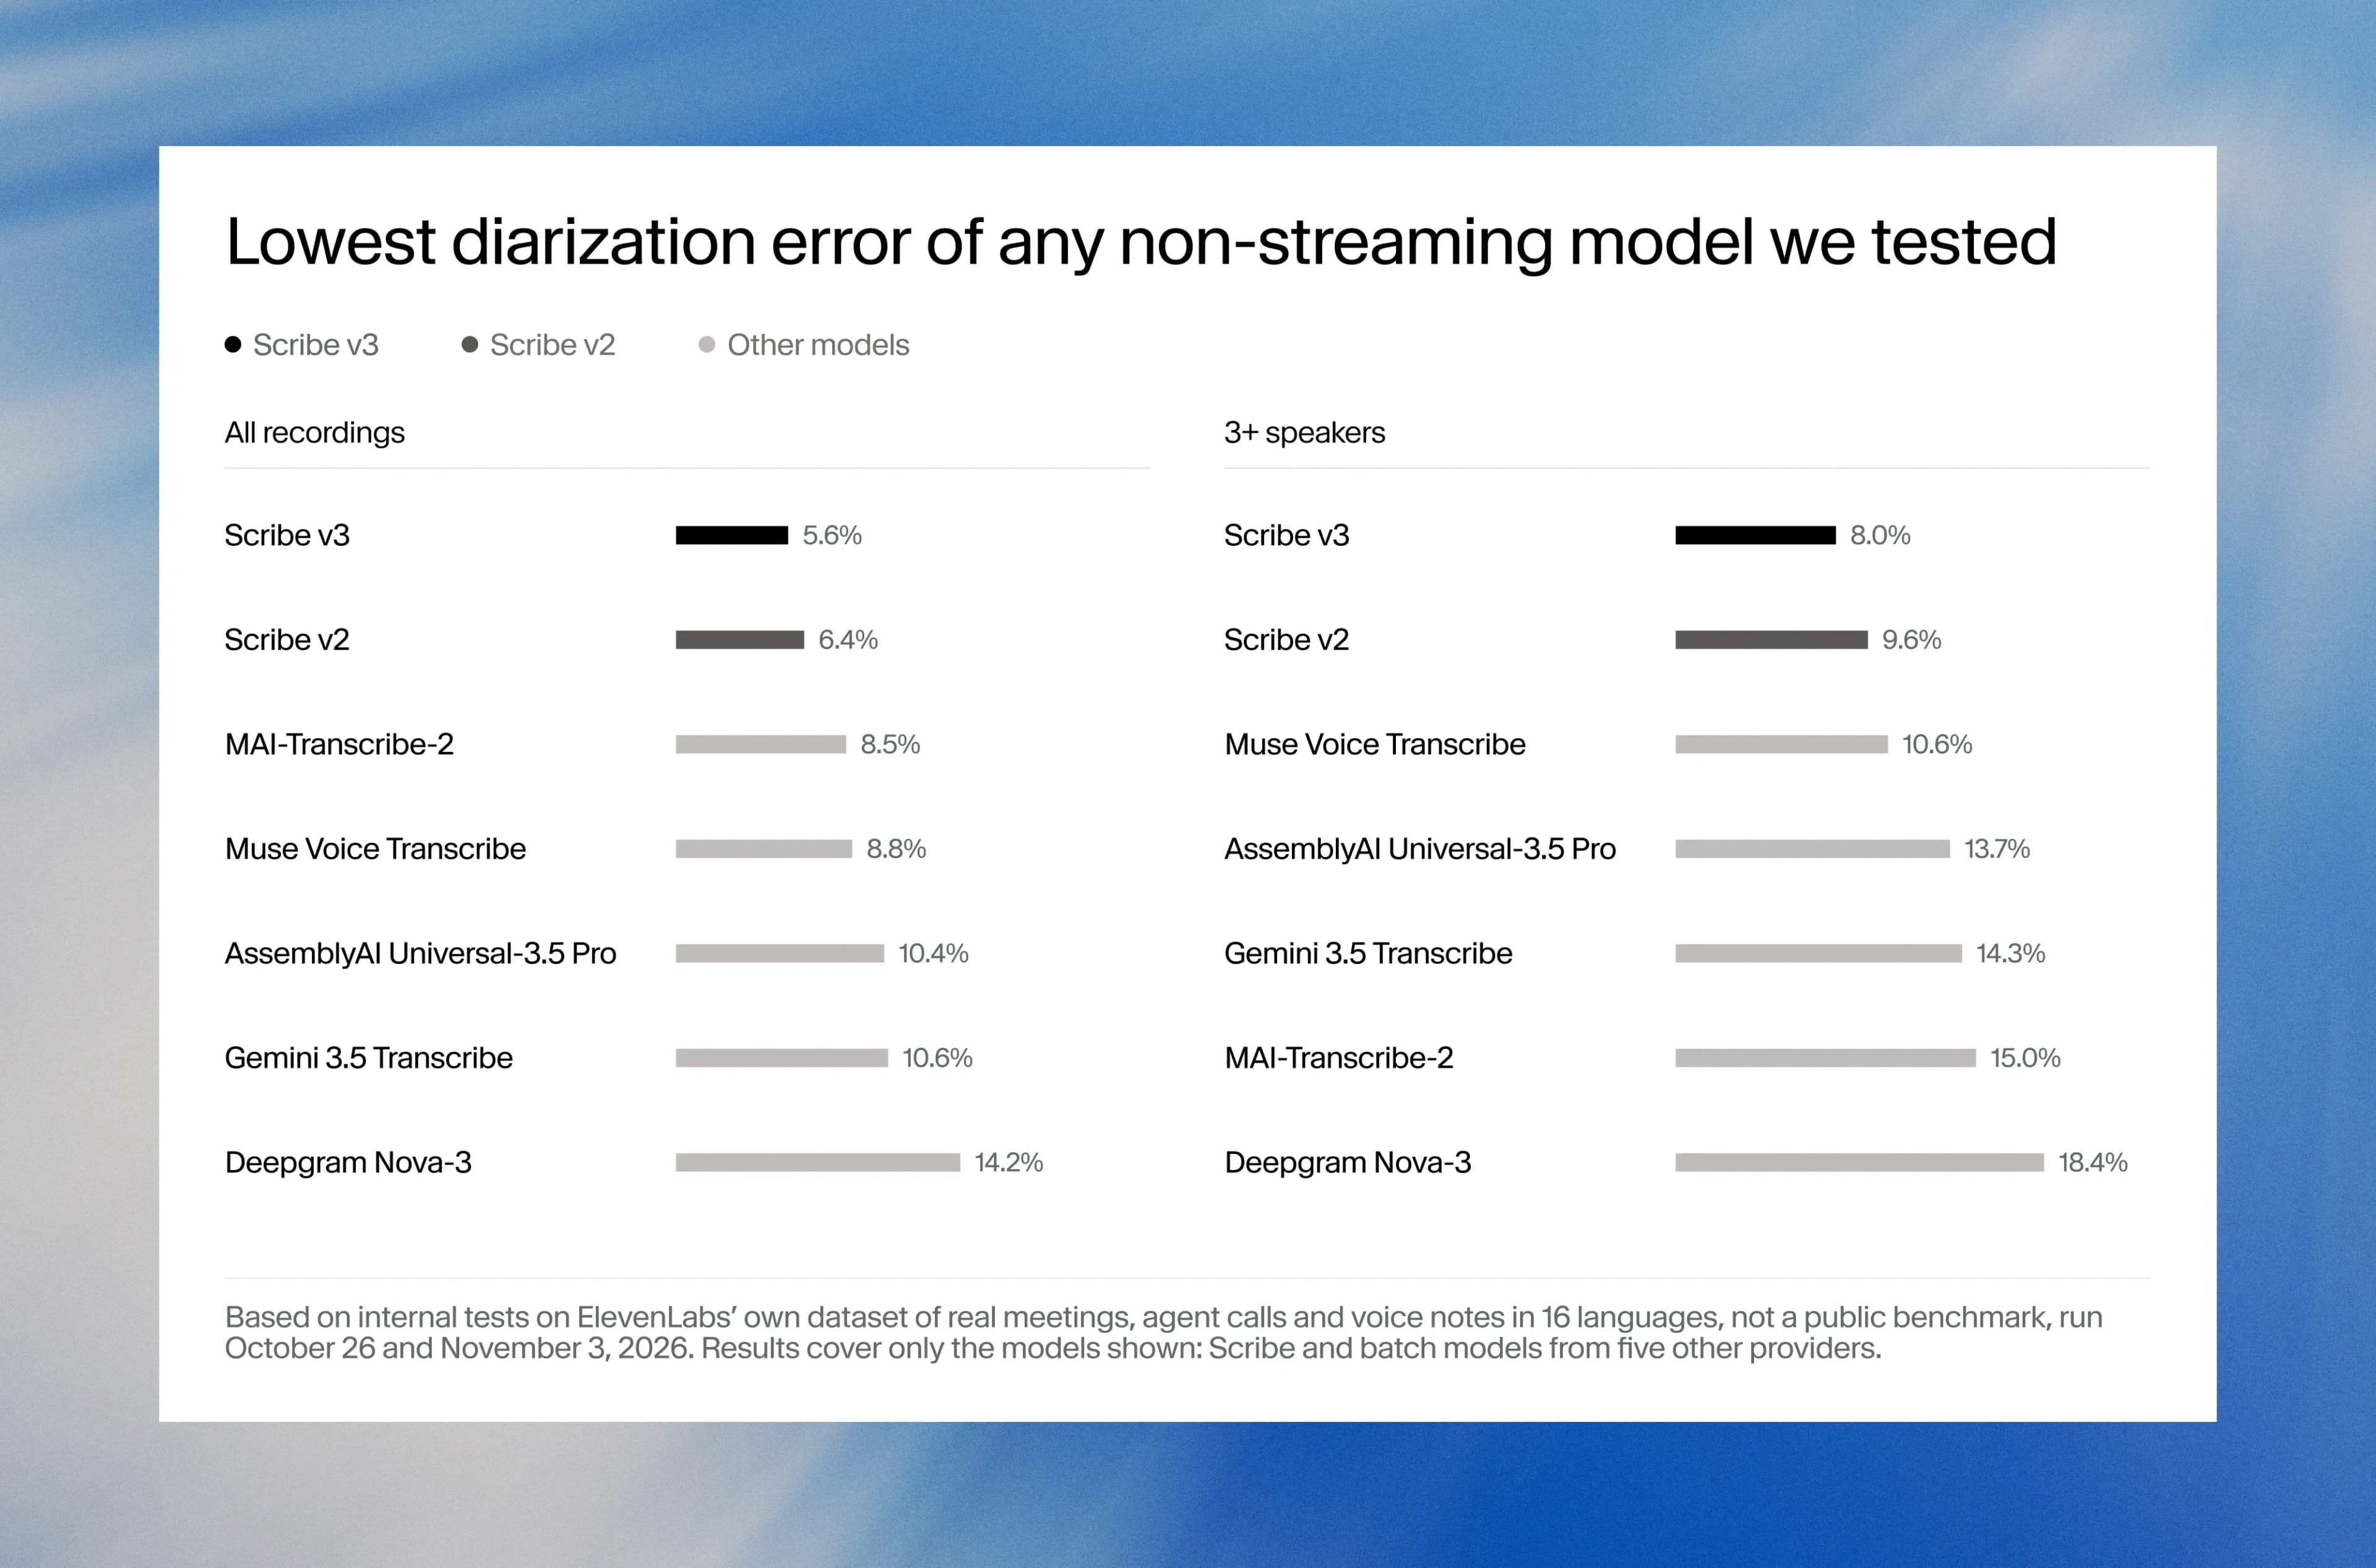
Scribe v3は、テストしたすべてのモデルの中で話者分離の誤りが最も少なく、Scribe v2と比べて全体では12%、3人以上の録音では17%削減しました。
多言語文字起こしの精度
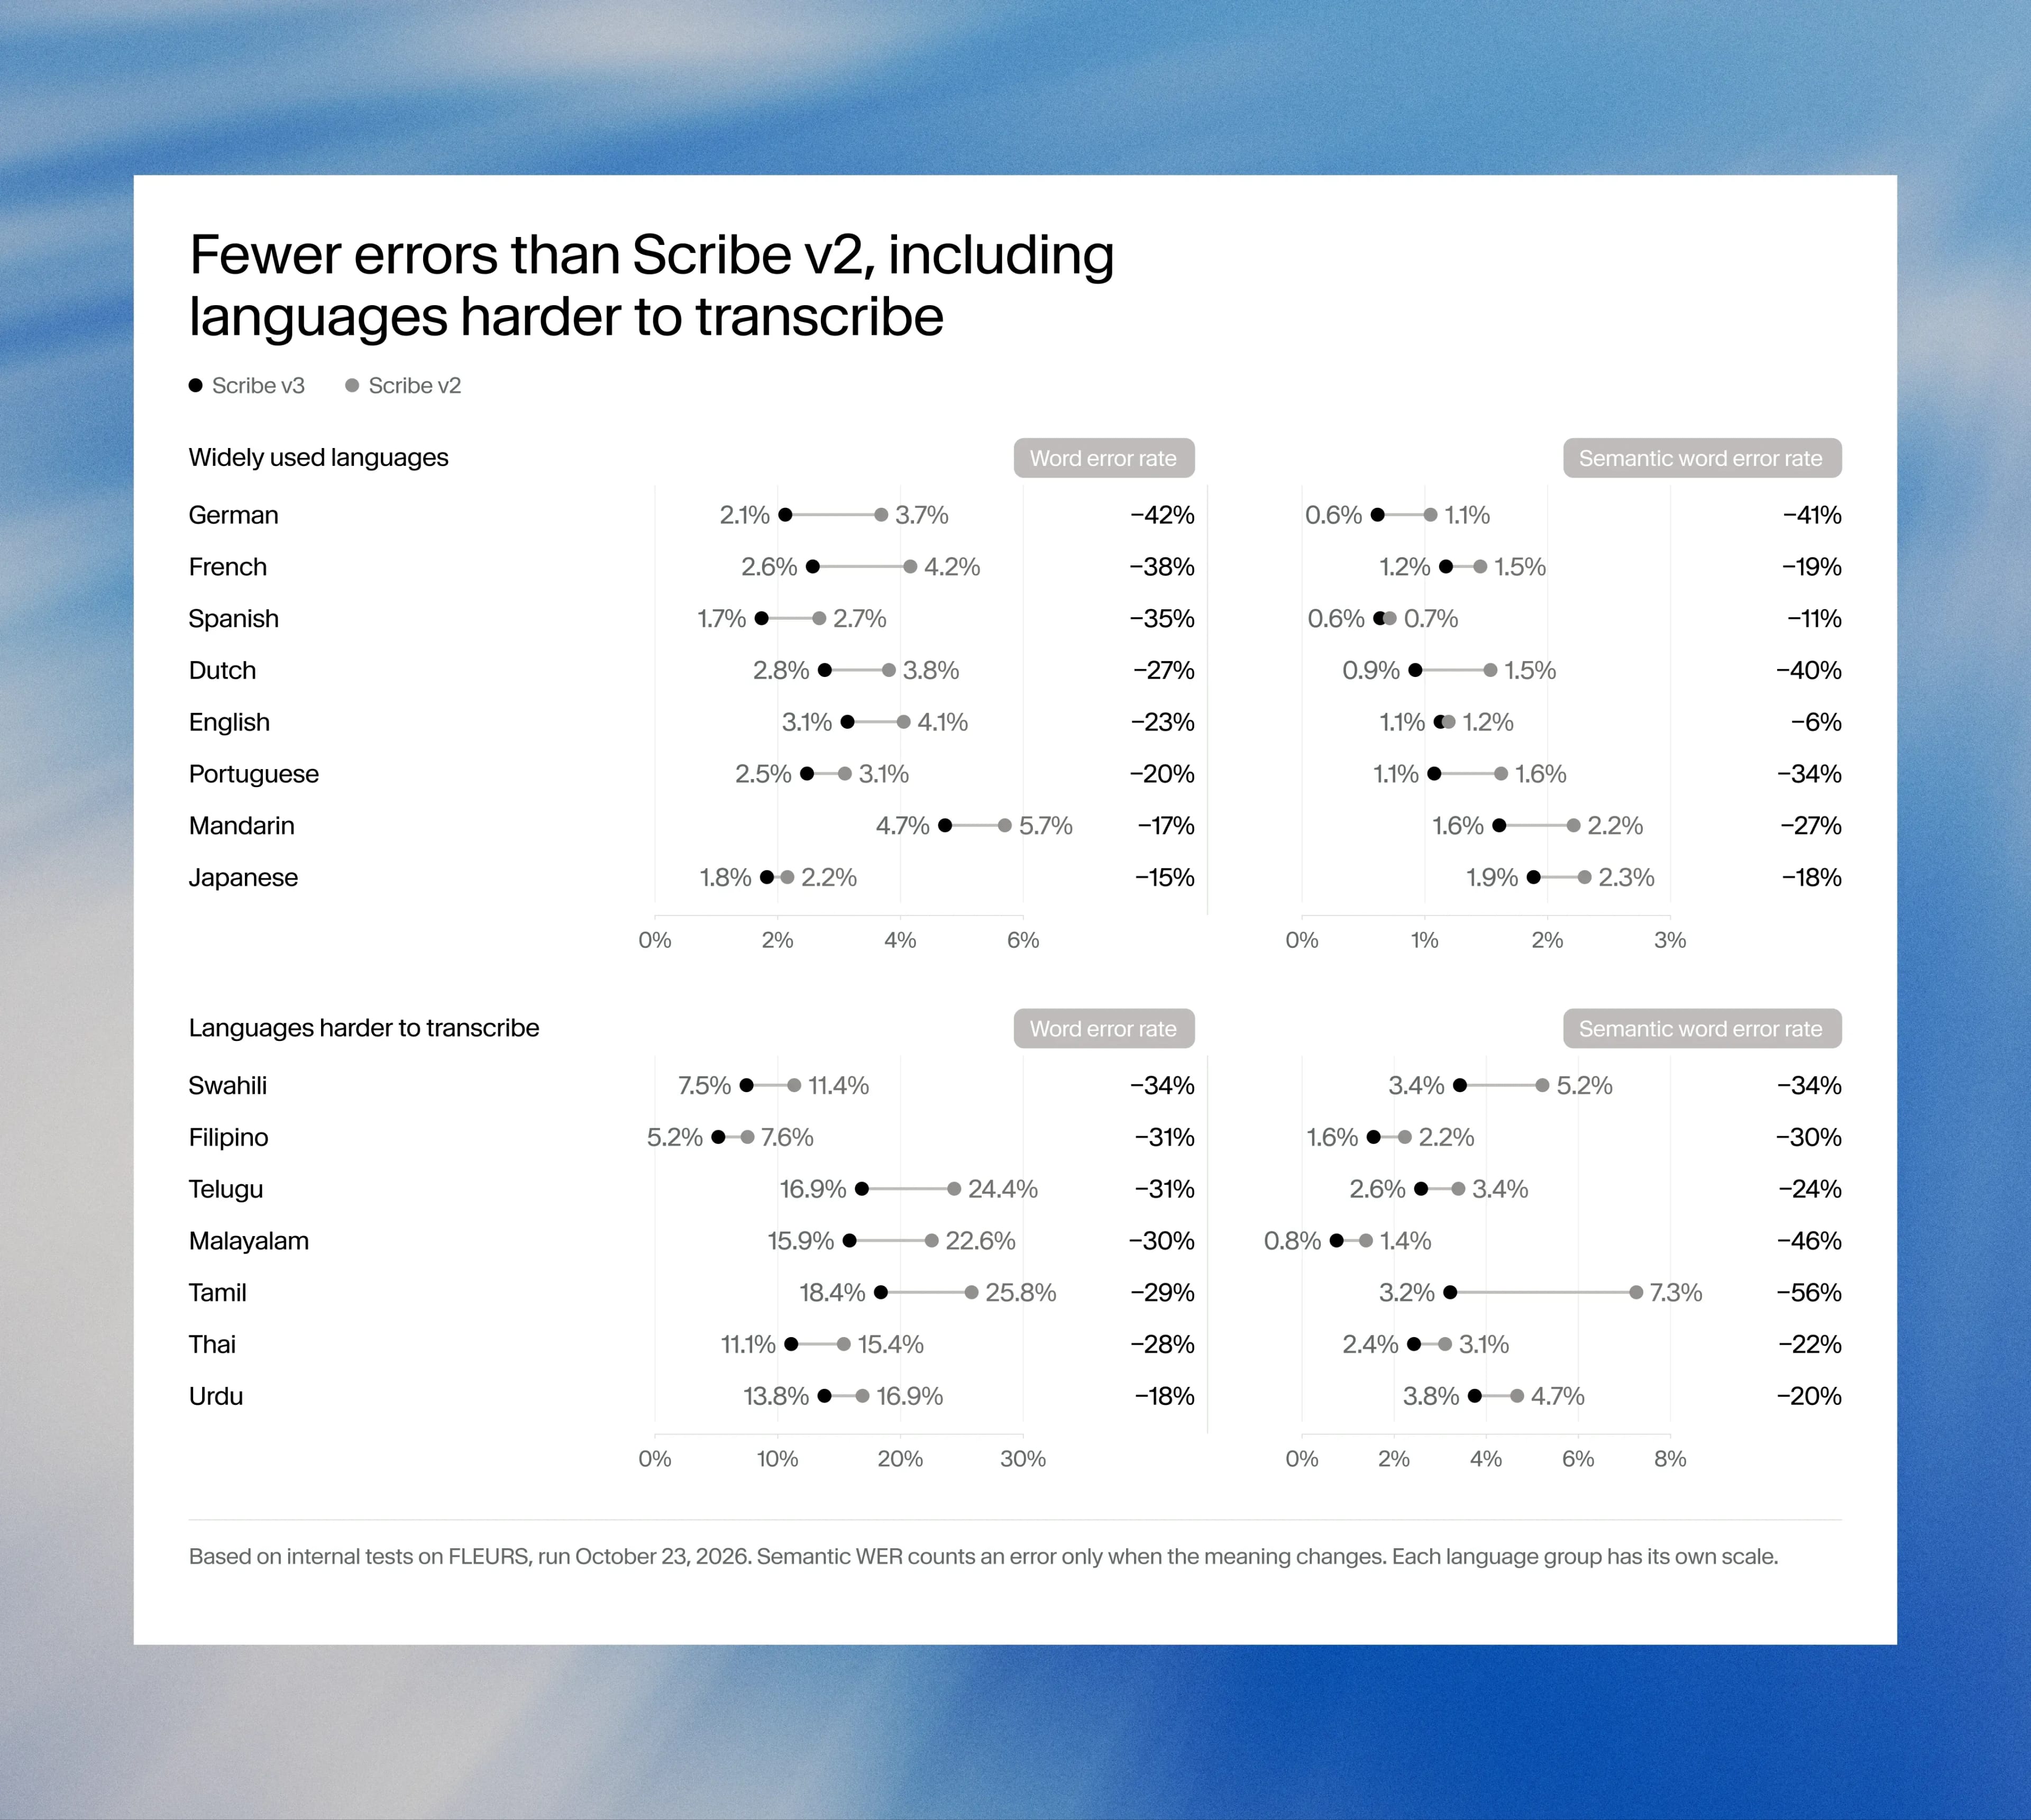
単語誤り率(WER)に加え、文字起こしの意味が変わった場合のみ誤りとして数えるセマンティックWERも報告します。
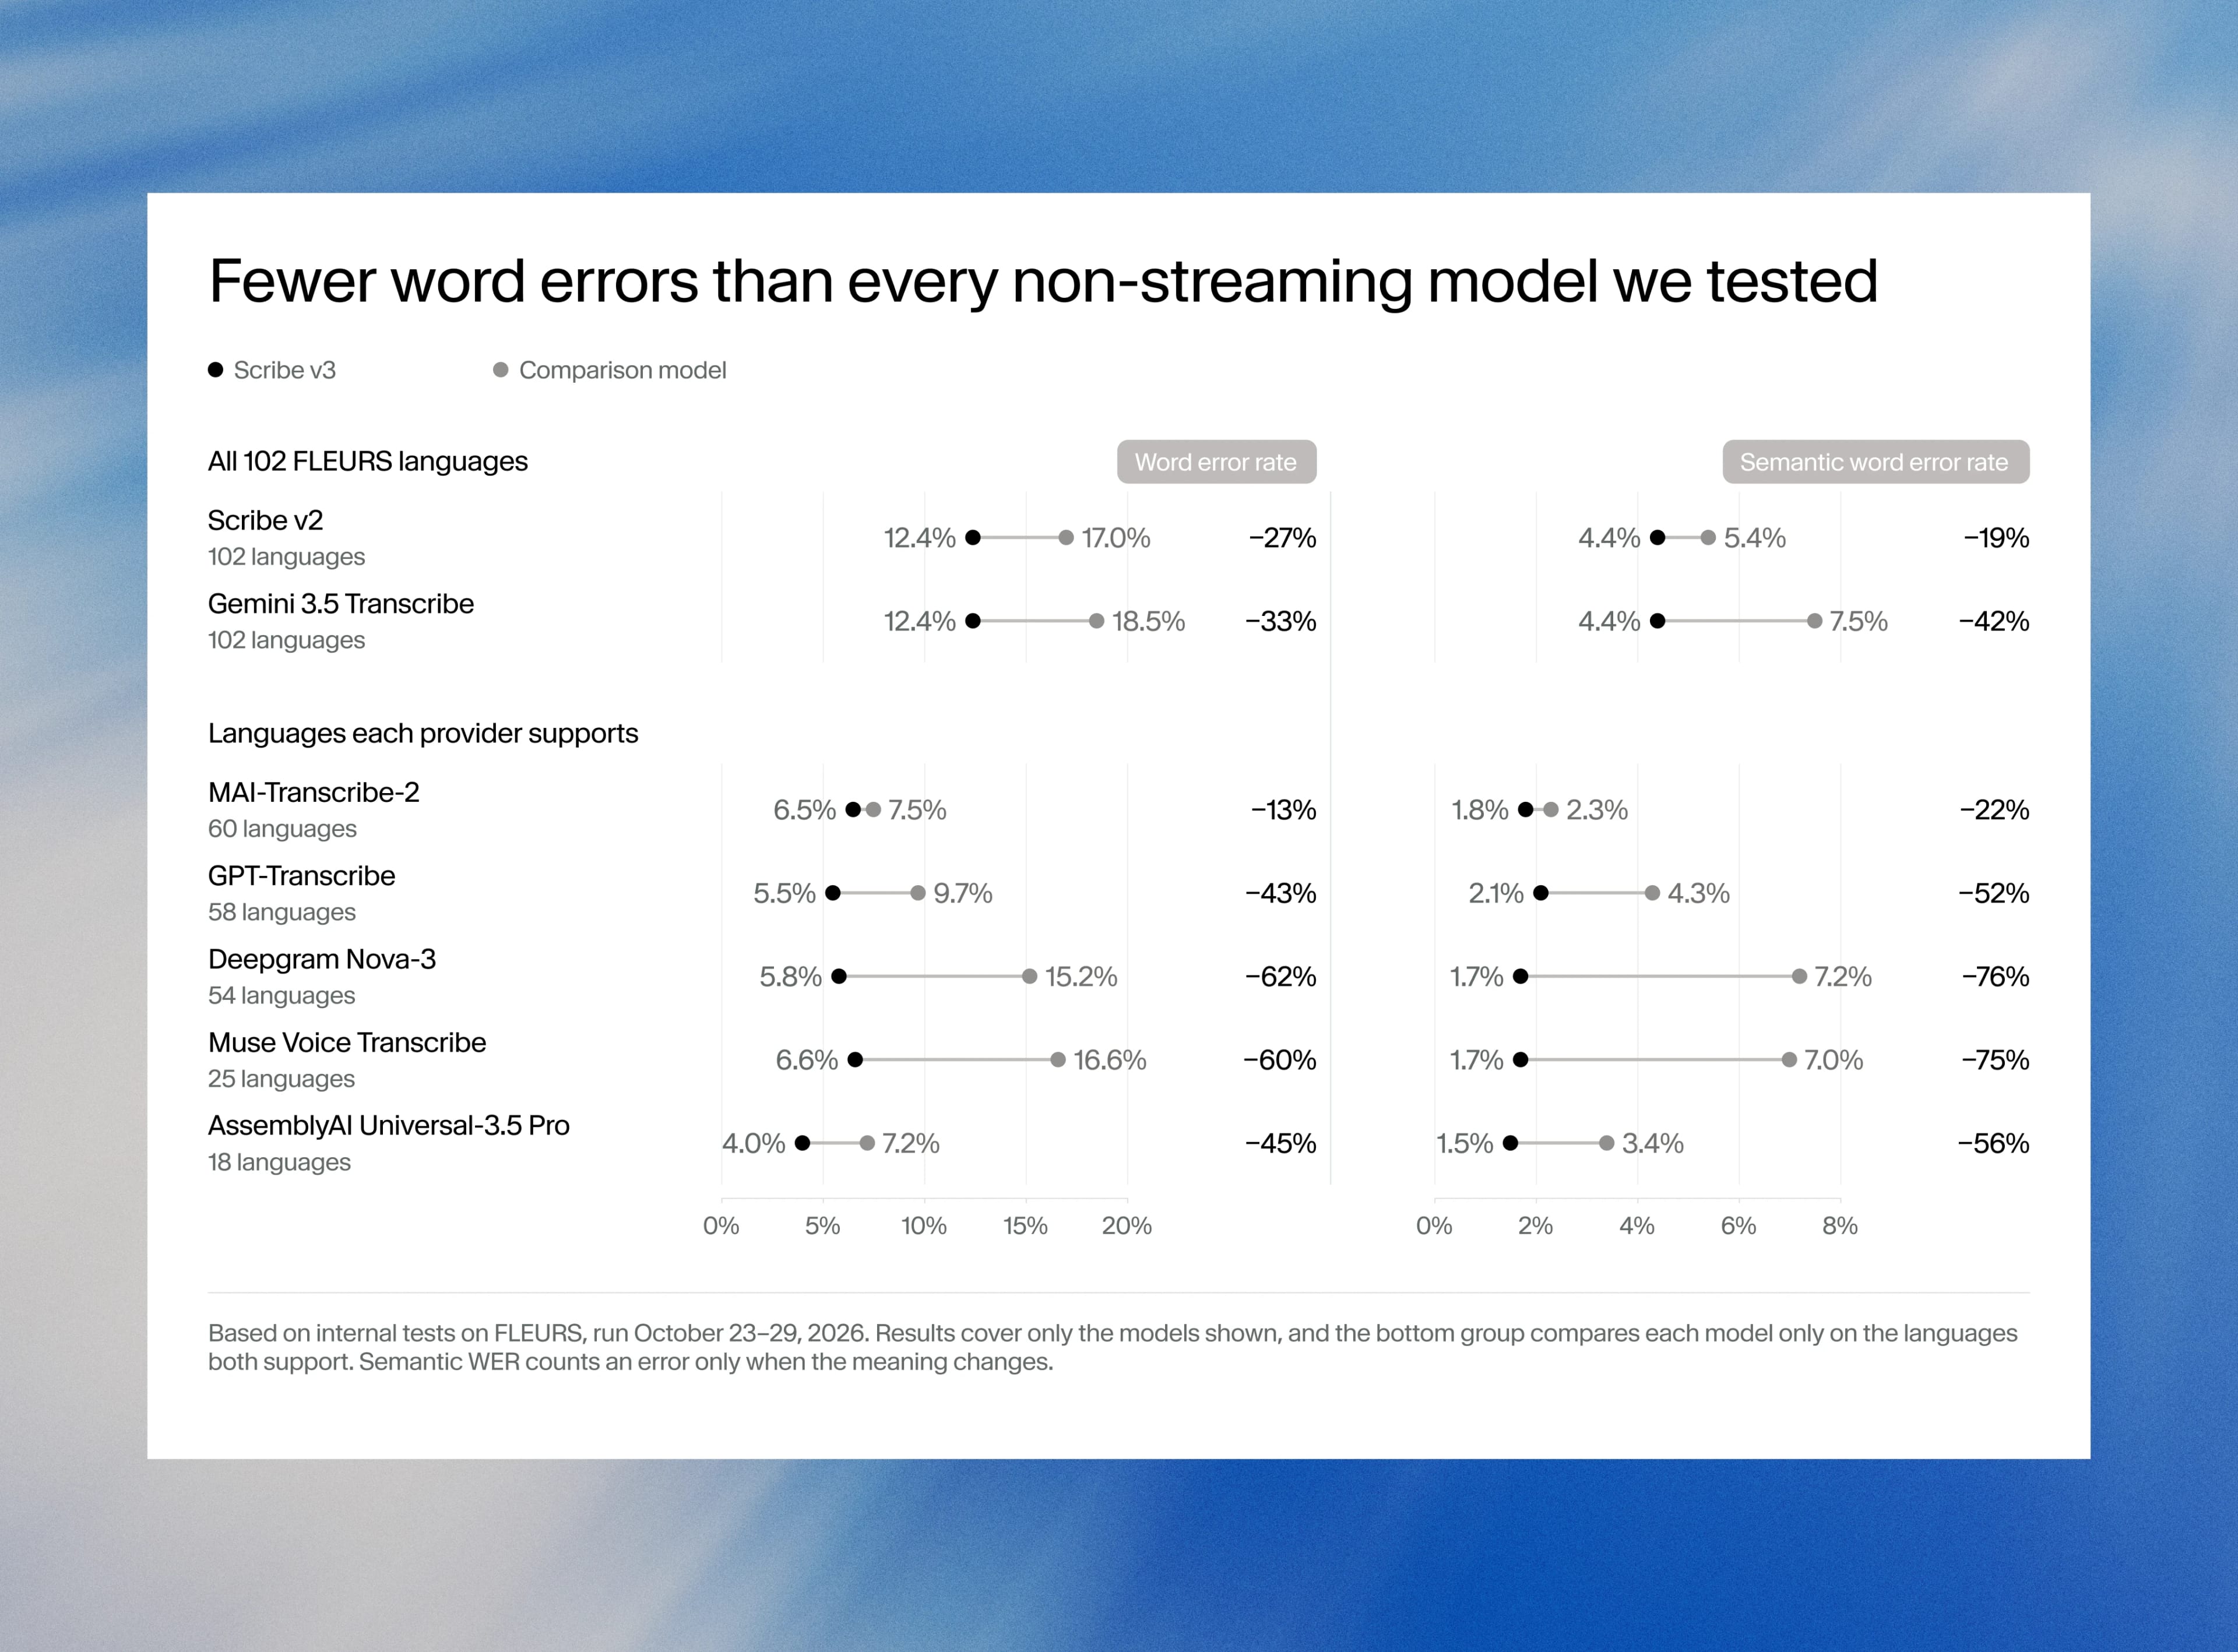
FLEURSの102言語全体で、Scribe v3はScribe v2よりWERを27%削減し、テストしたすべての言語で精度が向上しました。文字起こしが比較的容易な言語では、ドイツ語が42%、スペイン語が35%、英語が23%向上しました。文字起こしが難しい言語では改善幅がさらに大きく、スワヒリ語は34%、タミル語は29%、タイ語は28%低下しました。
また、両モデルが対応する言語ごとに比較した結果、Scribe v3はテストしたほかのすべてのバッチ(非ストリーミング)モデルよりも単語の誤りが少なくなりました。
リアルタイムの話者分離
16言語の実環境データセットのうち英語部分では、Scribe v3 Liveの話者分離誤り率は3.1%でした。テストしたほかのリアルタイムモデルは5.9~7.3%でした。
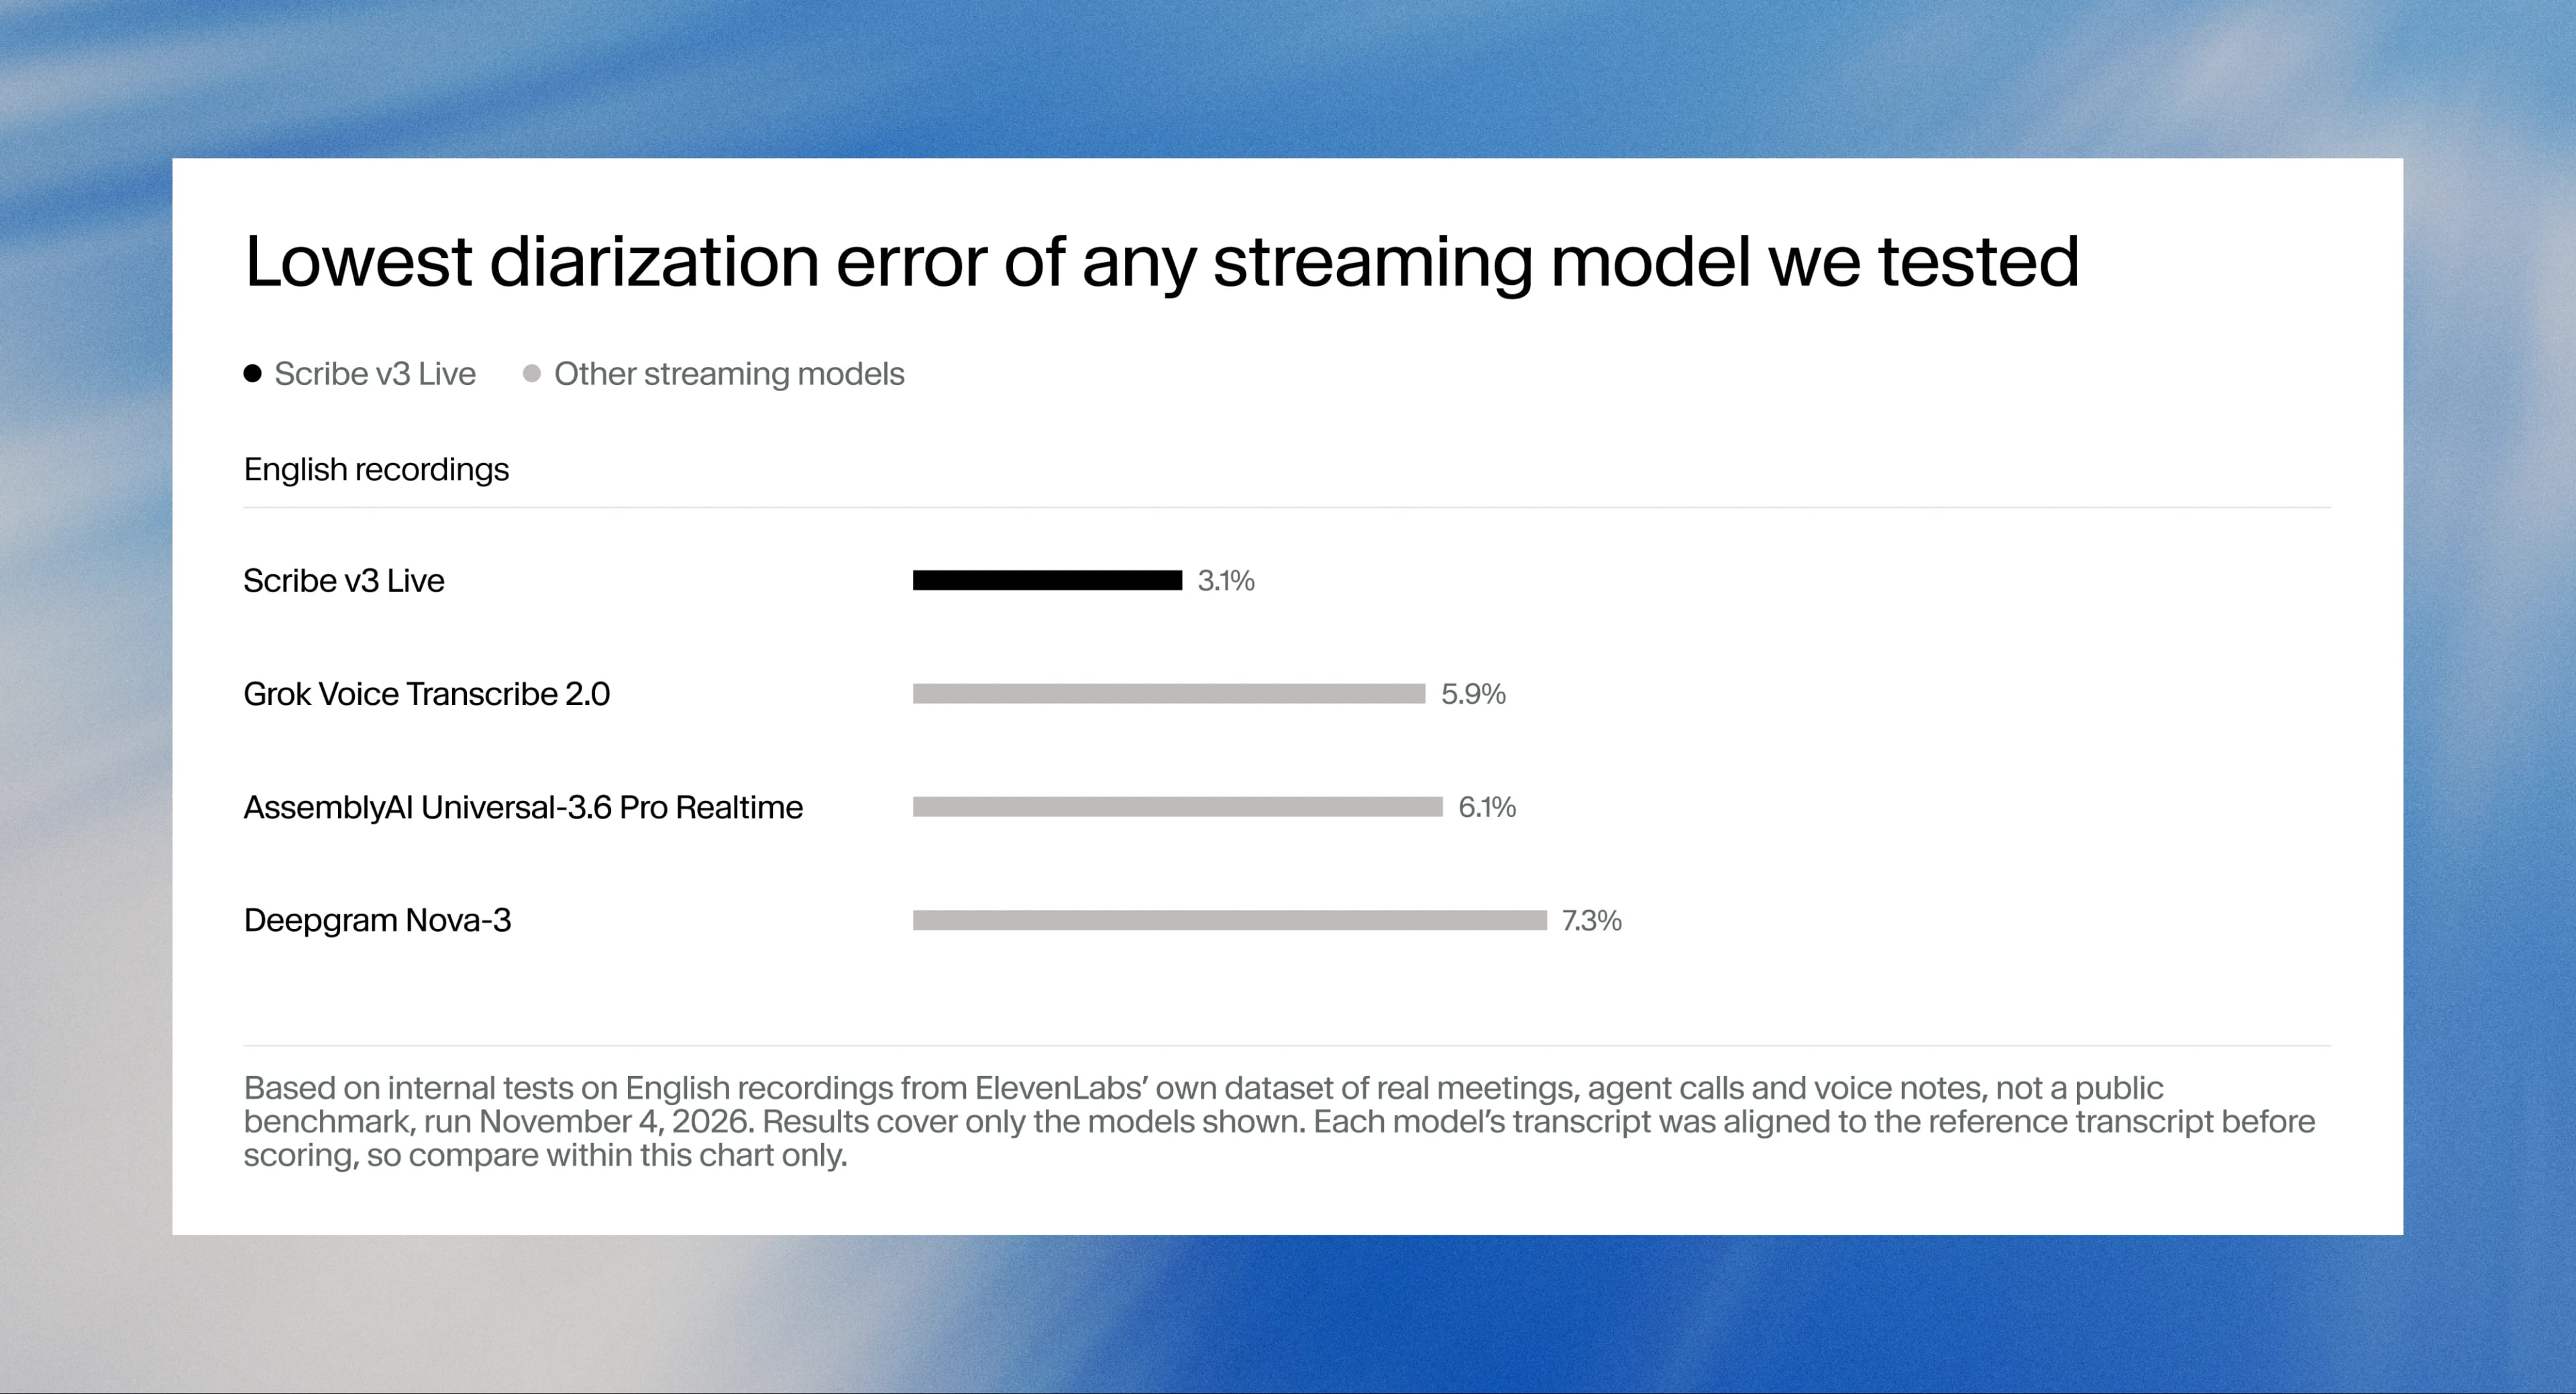
標準的な話者分離スコアには、単語の欠落などの文字起こしミスも含まれます。また、リアルタイムモデルはバッチモデルよりも多くの単語を取りこぼします。各単語が正しい話者に割り当てられたかどうかだけを測定するため、スコアを算出する前に各モデルの文字起こしを正解データとアラインメントしました。この処理によってすべてのモデルの誤り率が下がるため、ここでの結果を上記のバッチ話者分離の結果と直接比較することはできません。
リアルタイムの多言語精度
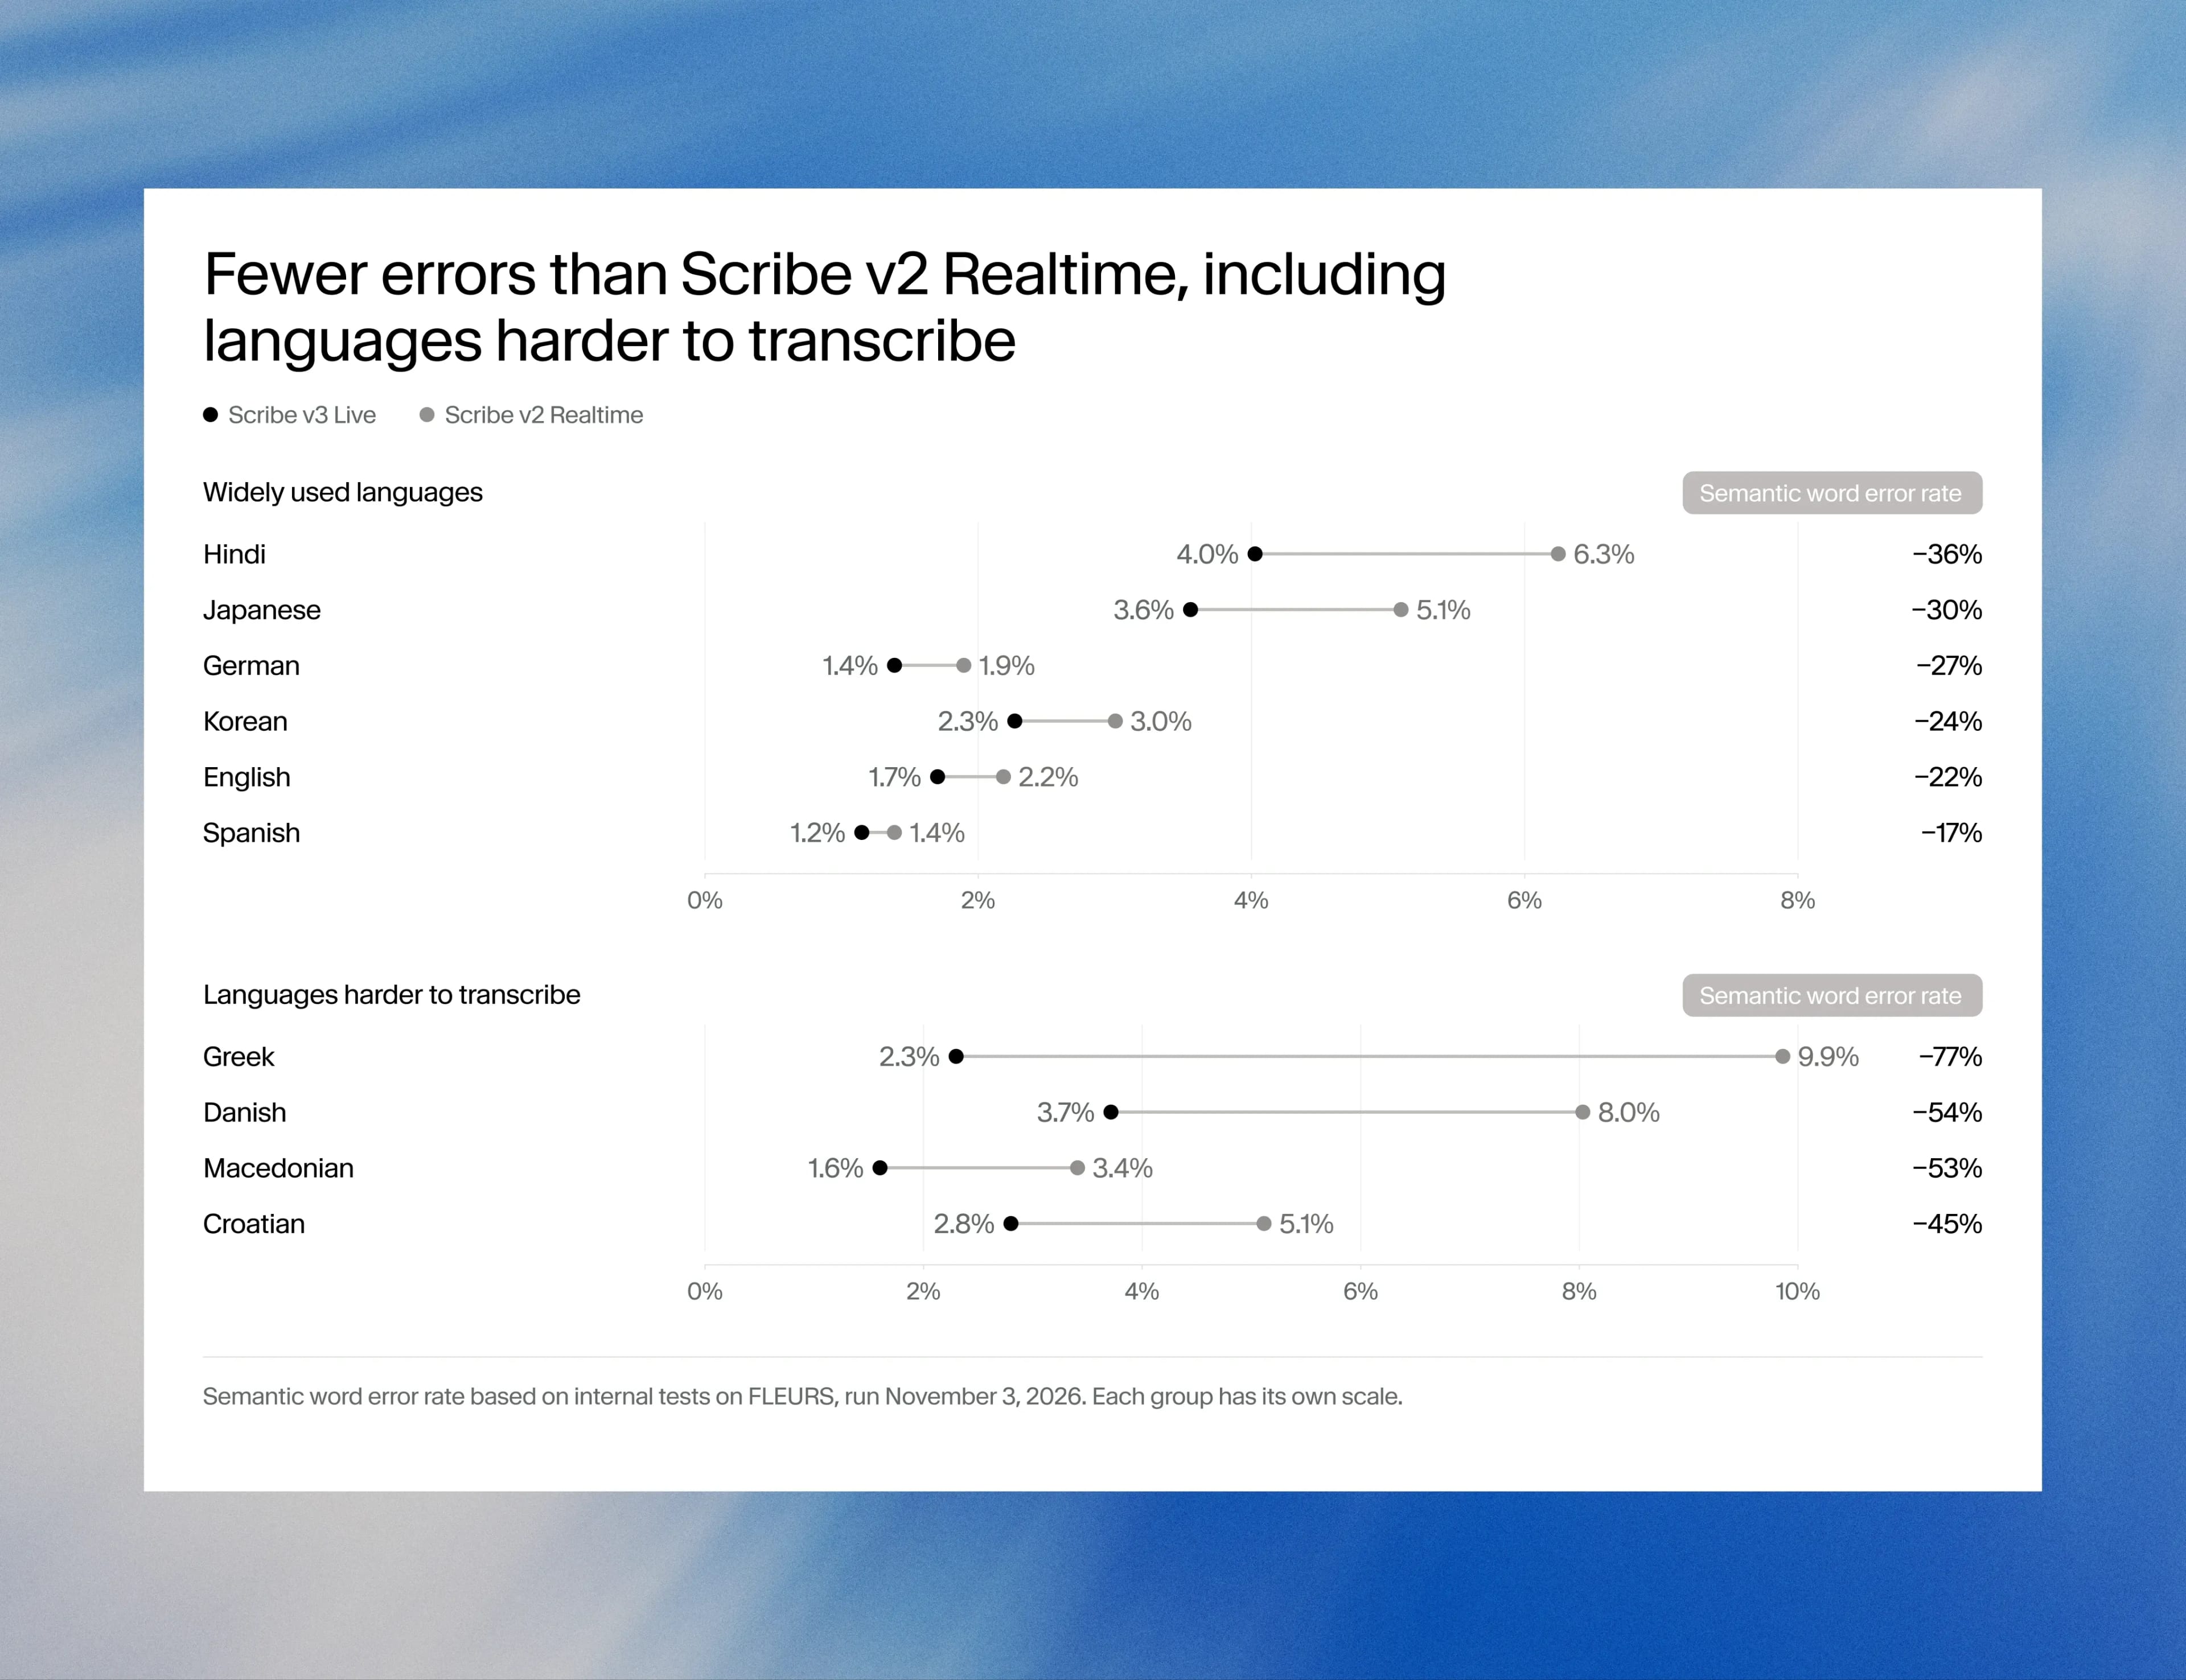
リアルタイムモデルでは、セマンティックWERを主な指標としています。ストリーミングモデルは文全体を聞き終える前にテキストを生成し、各プロバイダーによって数字、句読点、大文字・小文字の処理方法が異なります。標準WERは、意味が同じでもこうした違いを誤りとして数えるため、セマンティックWERのほうがより公平に比較できます。
102言語全体で、Scribe v3 LiveはScribe v2 Realtimeと比べてセマンティックWERを43%、WERを31%削減しました。すべての言語で精度が向上し、テストしたほかのすべてのリアルタイムモデルよりも誤り率が低くなっています。
特に、リアルタイム文字起こしの精度が遅れていた言語で大きく改善しました。ギリシャ語は77%、デンマーク語は54%、クロアチア語は45%、ヒンディー語は36%向上しています。
評価方法について:平均を求める前に各言語を個別に採点しているため、102言語すべてが同じ比重で評価されています。公表されている結果の多くは、すべてのクリップをまとめて1つのスコアを算出しており、数値が低くなる傾向があります。そのため、異なる方法で測定された結果を直接比較することはできません。
数ポイントの精度向上がもたらす価値
モデルの発表には、今回も含めてパーセンテージが付きものです。しかし、数ポイントの差が実際の場面で何を意味するのかは、数字だけではわかりにくいものです。1分あたり150語の1時間の会議では、約9,000語が話されます。単語誤り率4%と2%の差は180語の誤りに相当し、誰かが話している1分ごとに3語間違う計算です。話者分離の誤りは単語数ではなく時間で測定するため、同じ会議では1ポイントごとに36秒分の発話が誤った話者名に割り当てられます。
誤りが及ぼす影響は、発生する場所によって異なります。ポッドキャストの文字起こしなら単語の誤りは単なるタイプミスですが、決算説明会で「15」を「50」と聞き間違えれば、アナリストのモデルにも誤った数値が入力されます。また、誤りは人名、数字、略語、専門用語に集中する傾向があります。これらは、要約やエージェントが特に正確に認識しなければならない単語です。
ElevenAgentsで最初から正確に認識
この影響を最も強く受けるのが音声エージェントです。数字を1桁聞き間違えるだけで、通話開始時の確認に失敗することがあるためです。オランダで200万件を超える家庭や企業にエネルギーを供給するEnecoは、ElevenAgents上で音声エージェントを運用しており、リリースに先立ってScribe v3 Liveをテストしました。実際の顧客との通話では、オランダの郵便番号を初回で正しく認識する割合が40%、番地では15%向上しました。
Enecoのシニアプロダクトマネージャー、Ruud Huigsloot氏は次のように述べています。「ElevenLabsはEnecoにとって真のパートナーです。ElevenLabsのフォワードデプロイドエンジニアと協力し、音声エージェントのさらなる改善に取り組んでいます。これほど早い段階で大きな成果が得られたことをうれしく思います。今後も協力を続けていけることを楽しみにしています」
エンタープライズ向けに設計
Scribe v3とScribe v3 Liveはデフォルトでは米国で稼働し、データレジデンシー要件を持つエンタープライズ顧客向けには、EU、インド、シンガポールの分離された環境でも提供しています。ゼロリテンションモードでは、リクエストの完了直後にオーディオとテキストが削除されます。両モデルはSOC2、ISO 27001、PCI DSSレベル1プログラムの対象であり、Business Associate Agreementの締結によりHIPAAにも対応できます。プライベート環境への導入も可能です。
今すぐ始める
Scribe v3 LiveはElevenAgentsで利用でき、ElevenLabsアプリではv3とv3 Liveの両方がデフォルトモデルになっています。登録してお試しください。
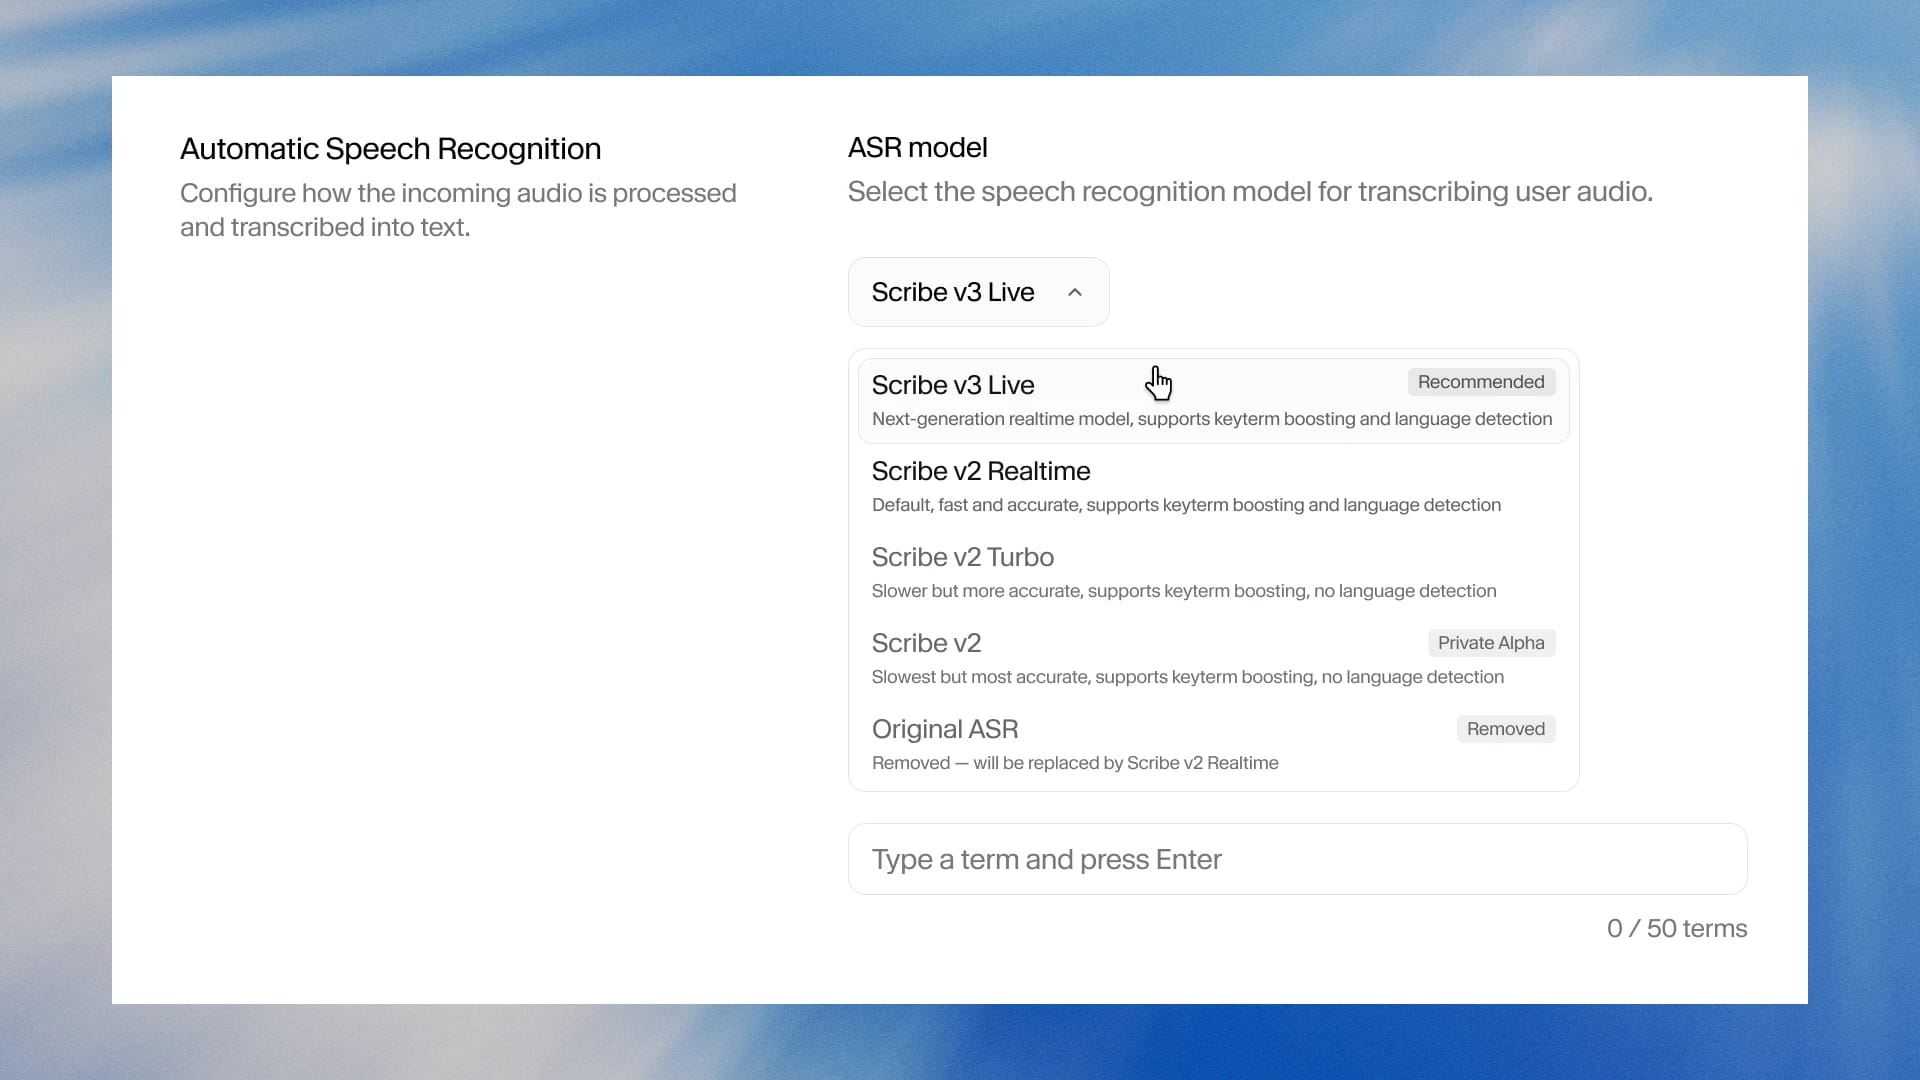
両モデルは、本日よりElevenAPIでも利用できます。既存のインテグレーションは、モデルIDをscribe_v3またはscribe_v3_liveに変更するだけでアップグレードできます。
医療チーム向けには、ElevenAgentsで医療会話に最適化したScribe v3 Liveも提供します。