Eleven Realtimeのご紹介:自然な音声エージェントをより簡単に構築
- 執筆者
- Min Kim
- 公開日
- 最終更新日
聴くこの記事を聴く
自然に話す音声エージェントを構築するには、現在、多くの判断が必要です。音声認識、音声活動検出、ターンテイキング、基盤となるLLM、テキスト読み上げなど、個々のコンポーネントを選択しなければなりません。このスタックの構築自体が一つのプロジェクトであり、すべてのコンポーネントを連携させて適切に動作させるには、さらにテストとチューニングが必要です。
Eleven Realtimeは、こうした障壁を取り除く新しい種類のスピーチtoスピーチモデルです。各モデルは個別のユースケース向けに最適化された、完全な音声エージェントです。どちらも90以上の言語に対応し、ElevenLabsライブラリにある17,000種類以上の音声を使用できます。
本日、以下をリリースします。
- Eleven Realtime v1 Mini:低コストで自然な会話を実現します。AIアシスタント、教師、インタラクティブキャラクターに最適で、ほとんどのユースケースに十分対応できます。
- Eleven Realtime v1 Max:複雑なタスク向けです。プロセスに従って段階的に推論する必要がある、カスタマーサポート、リードの適格性評価、複数ステップのワークフローに最適です。
リアルタイムモデルを開発した理由
自然に話す音声エージェントを構築するために、設定のエキスパートになる必要はありません。エージェントを自然に感じさせ、適切に聞こえるようにするには、応答前に間をどれだけ取るか、ユーザーがエージェントを遮ったときにどう立て直すか、音声・プロンプト・モデルをどう連携させるかといった、繊細な判断が求められます。ElevenAgentsでは、これらすべてを設定で調整できます。
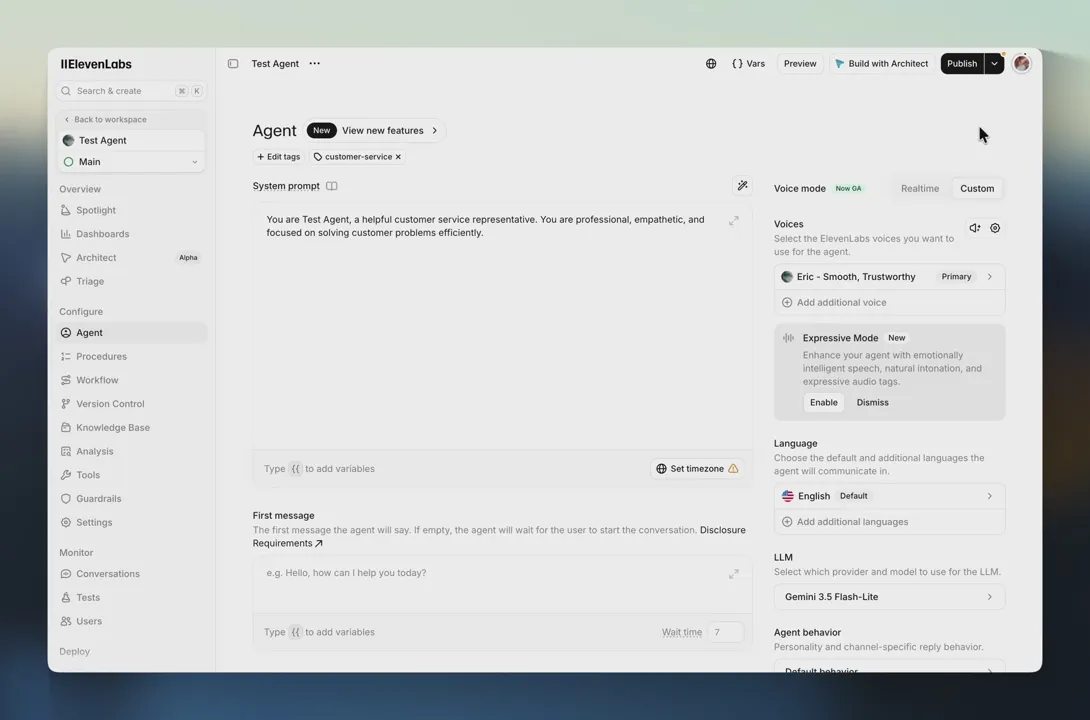
すでにリアルタイムAPIを利用しているデベロッパーにも同じことが言えます。ElevenLabsのAPIはOpenAIのRealtime APIと互換性があるため、既存のコードのエンドポイントとモデル名を変更するだけでEleven Realtimeを試せます。
カスケードアーキテクチャを基盤に構築
Eleven Realtimeは、カスケードアーキテクチャを基盤に、前述のコンポーネントをエンドツーエンドでチューニングして構築されています。音声を入力し、音声を出力し、モデルIDは1つで、融合モデルやデュプレックスモデルと同じリーダーボードで評価できるため、スピーチtoスピーチモデルと呼んでいます。
融合モデルは当初、音声エージェントがどこまで自然に感じられるかの基準を打ち立てました。一方、カスケード型の構成では、引き渡しのたびにレイテンシーが増え、コンポーネント同士を連携させたチューニングは行われていませんでした。Realtimeはこのトレードオフを解消し、これまでプロジェクトごとに必要だったチューニングもすでに完了しています。
カスケード型には、すべてのステップでテキストが生成されるため、本番環境で実用的な利点もあります。エージェントが何を聞き、何を言おうとしたかを確認できるので、聞き間違いと誤った判断を区別できます。このテキストにより、ElevenAgentsはRealtimeエージェントにガードレールとPIIのマスキングを適用できます。
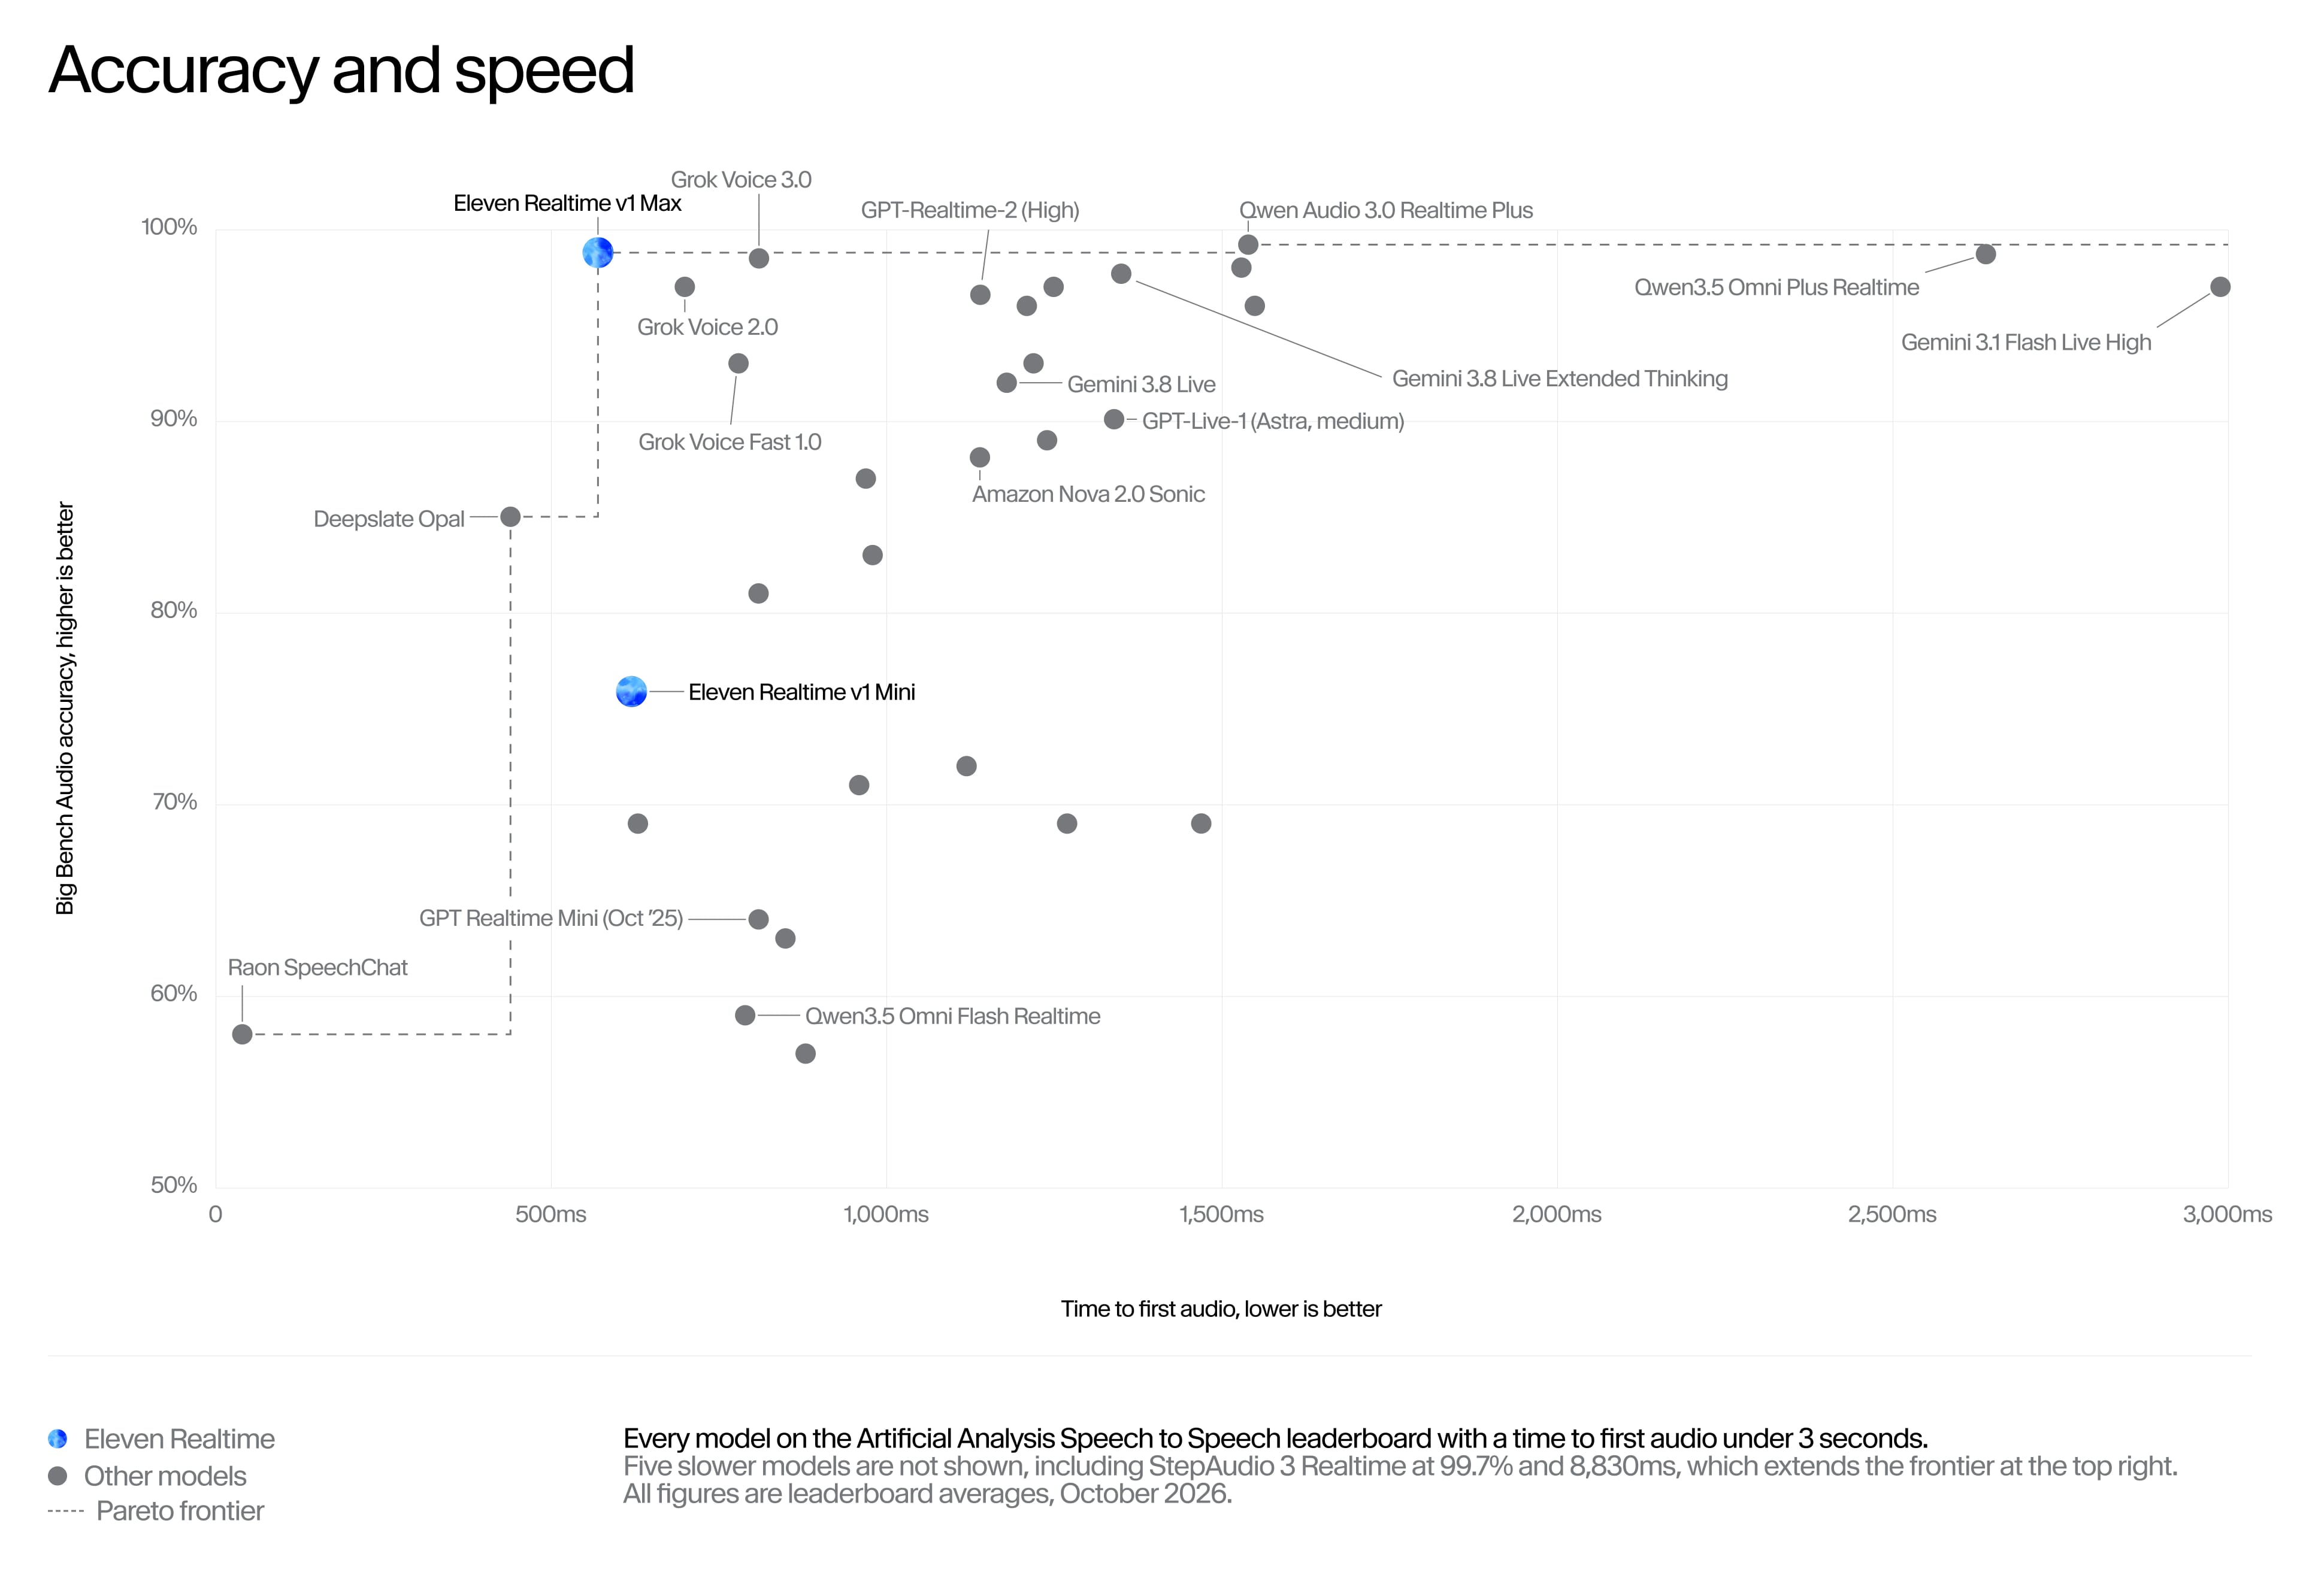
以下のベンチマークは、このトレードオフが本当に解消されたかを検証するものです。会話のダイナミクスでは、両モデルとも融合モデルと同等のスコア帯に位置しています。精度と速度を総合すると、Artificial Analysisのリーダーボードでv1 Maxより高速かつ高精度なモデルはありません。
性能
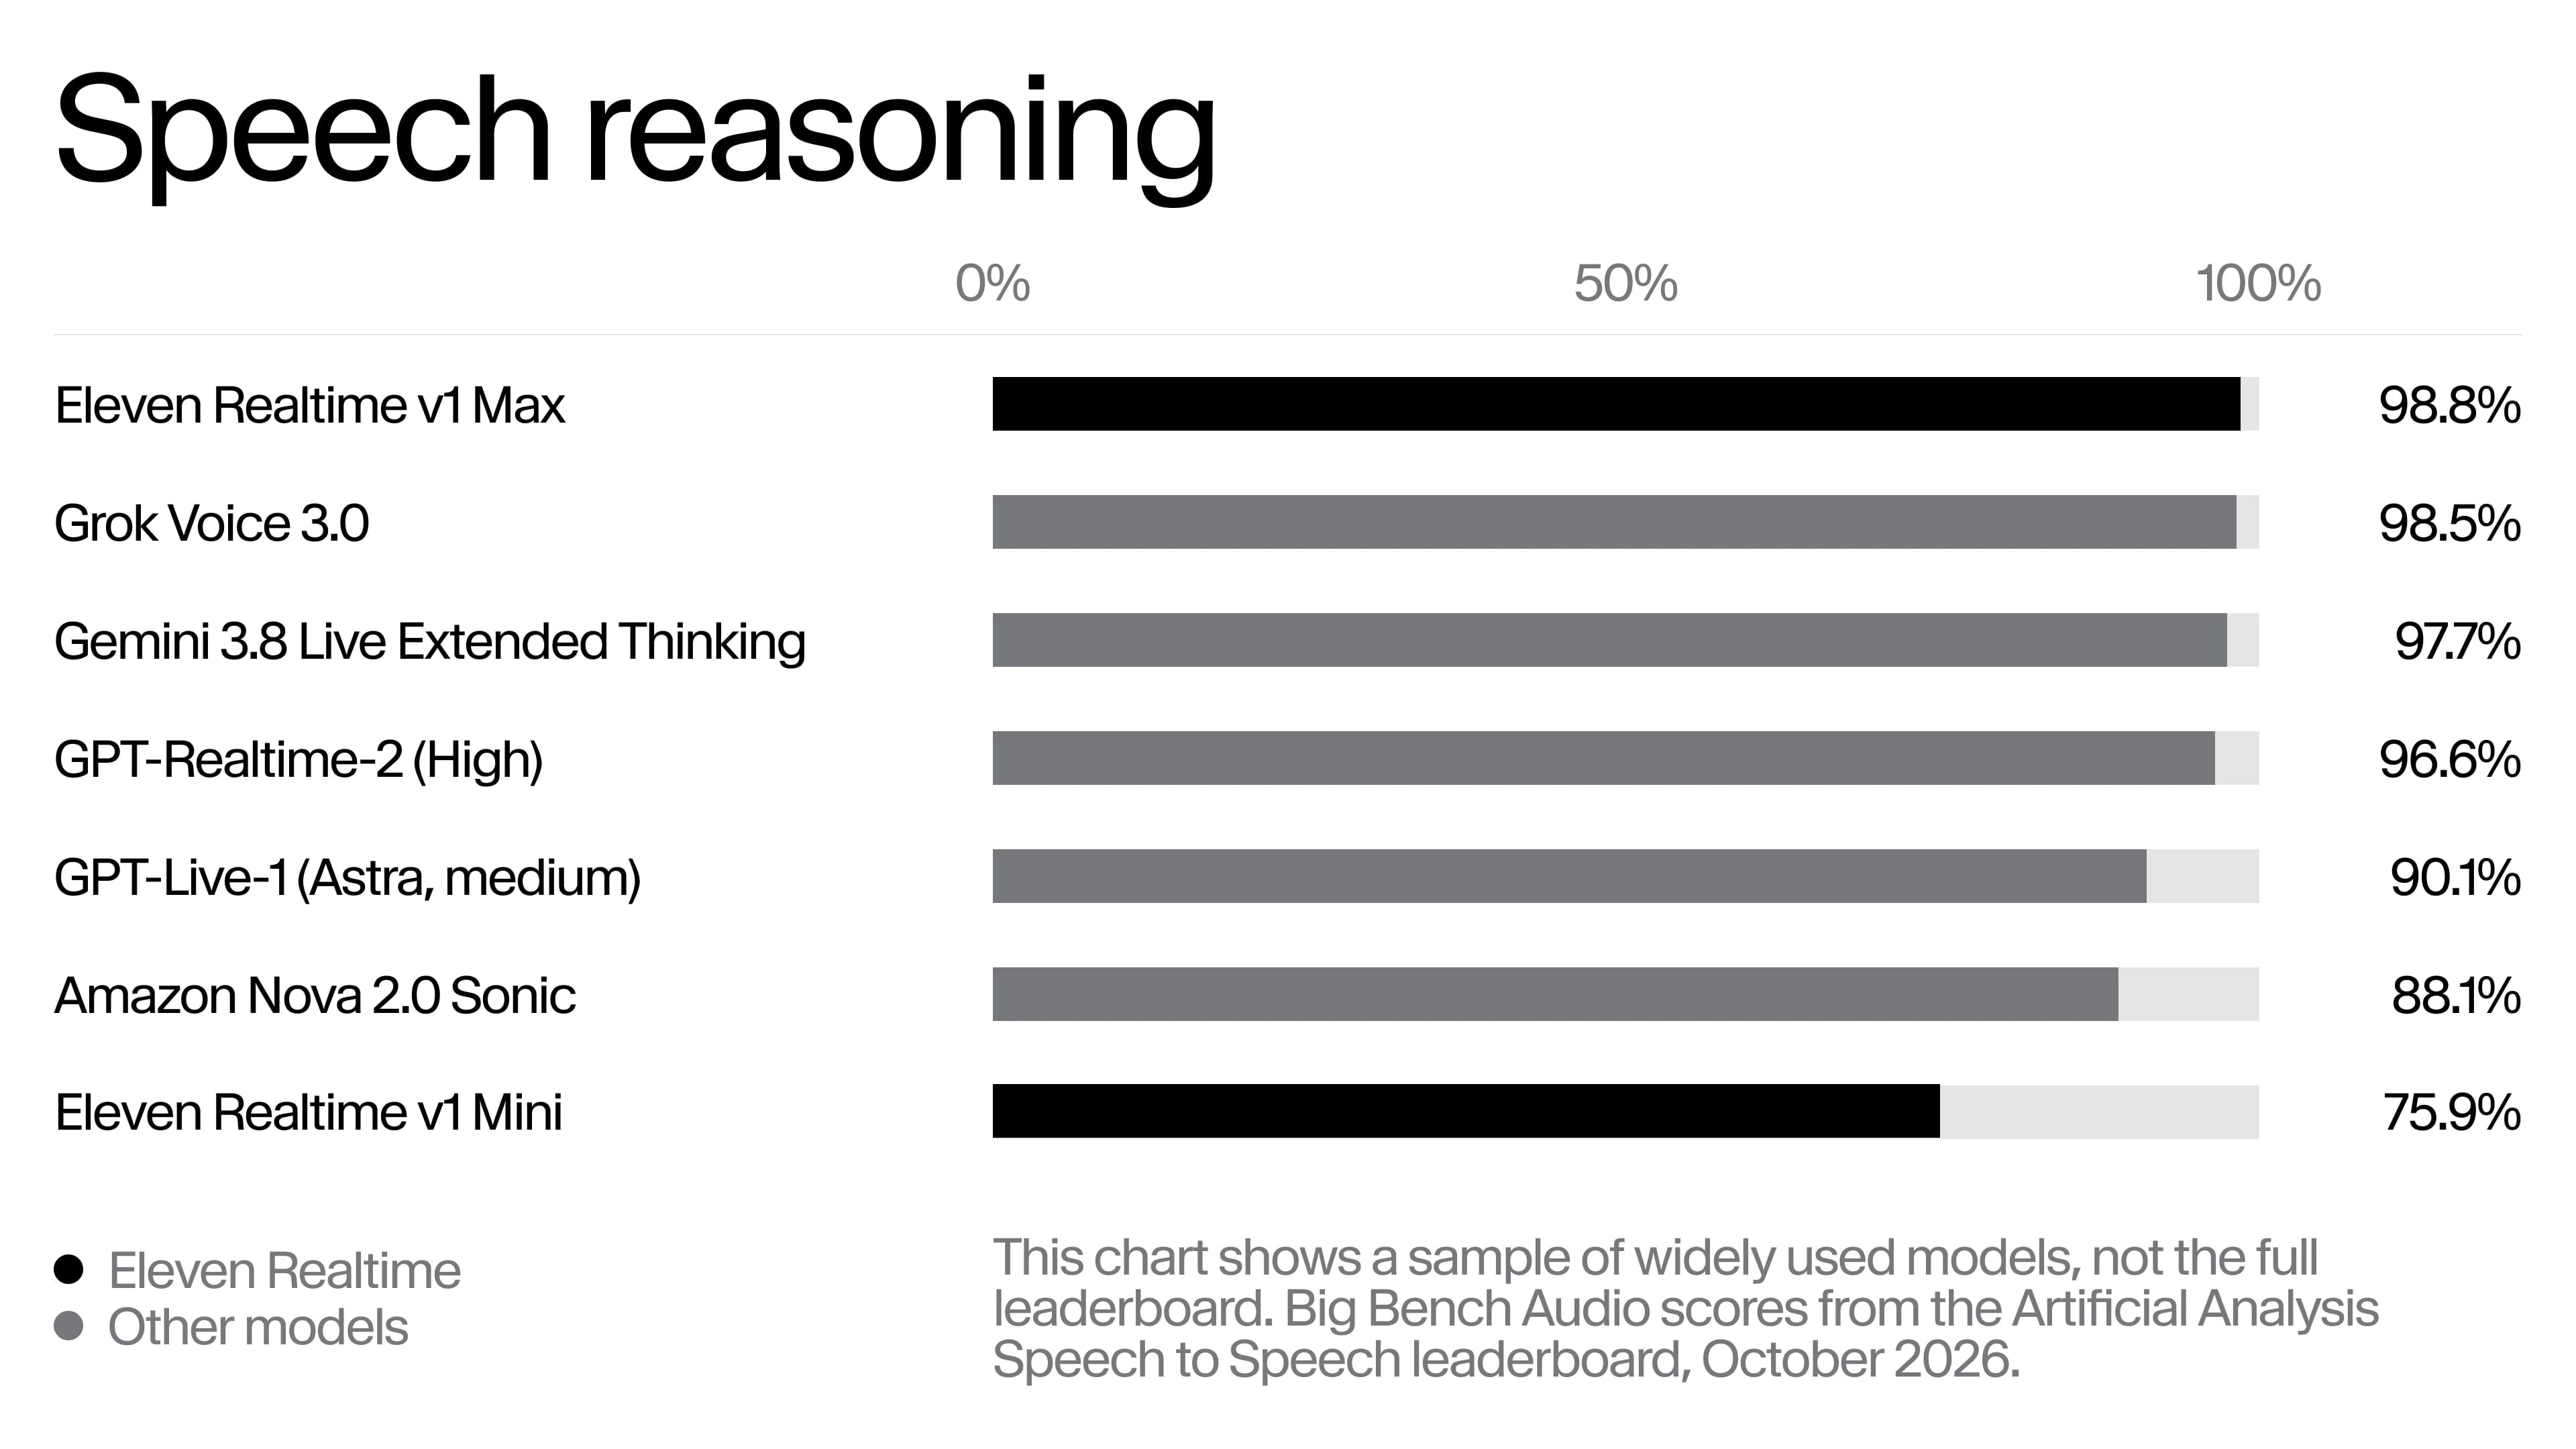
Artificial Analysisは、音声推論のBig Bench Audio、会話のダイナミクスのFull-Duplex-Bench、人間の選好とタスク成功率のSpeech Agent Arenaという、3つの公開ベンチマークで両モデルを独自に評価しました。
音声推論
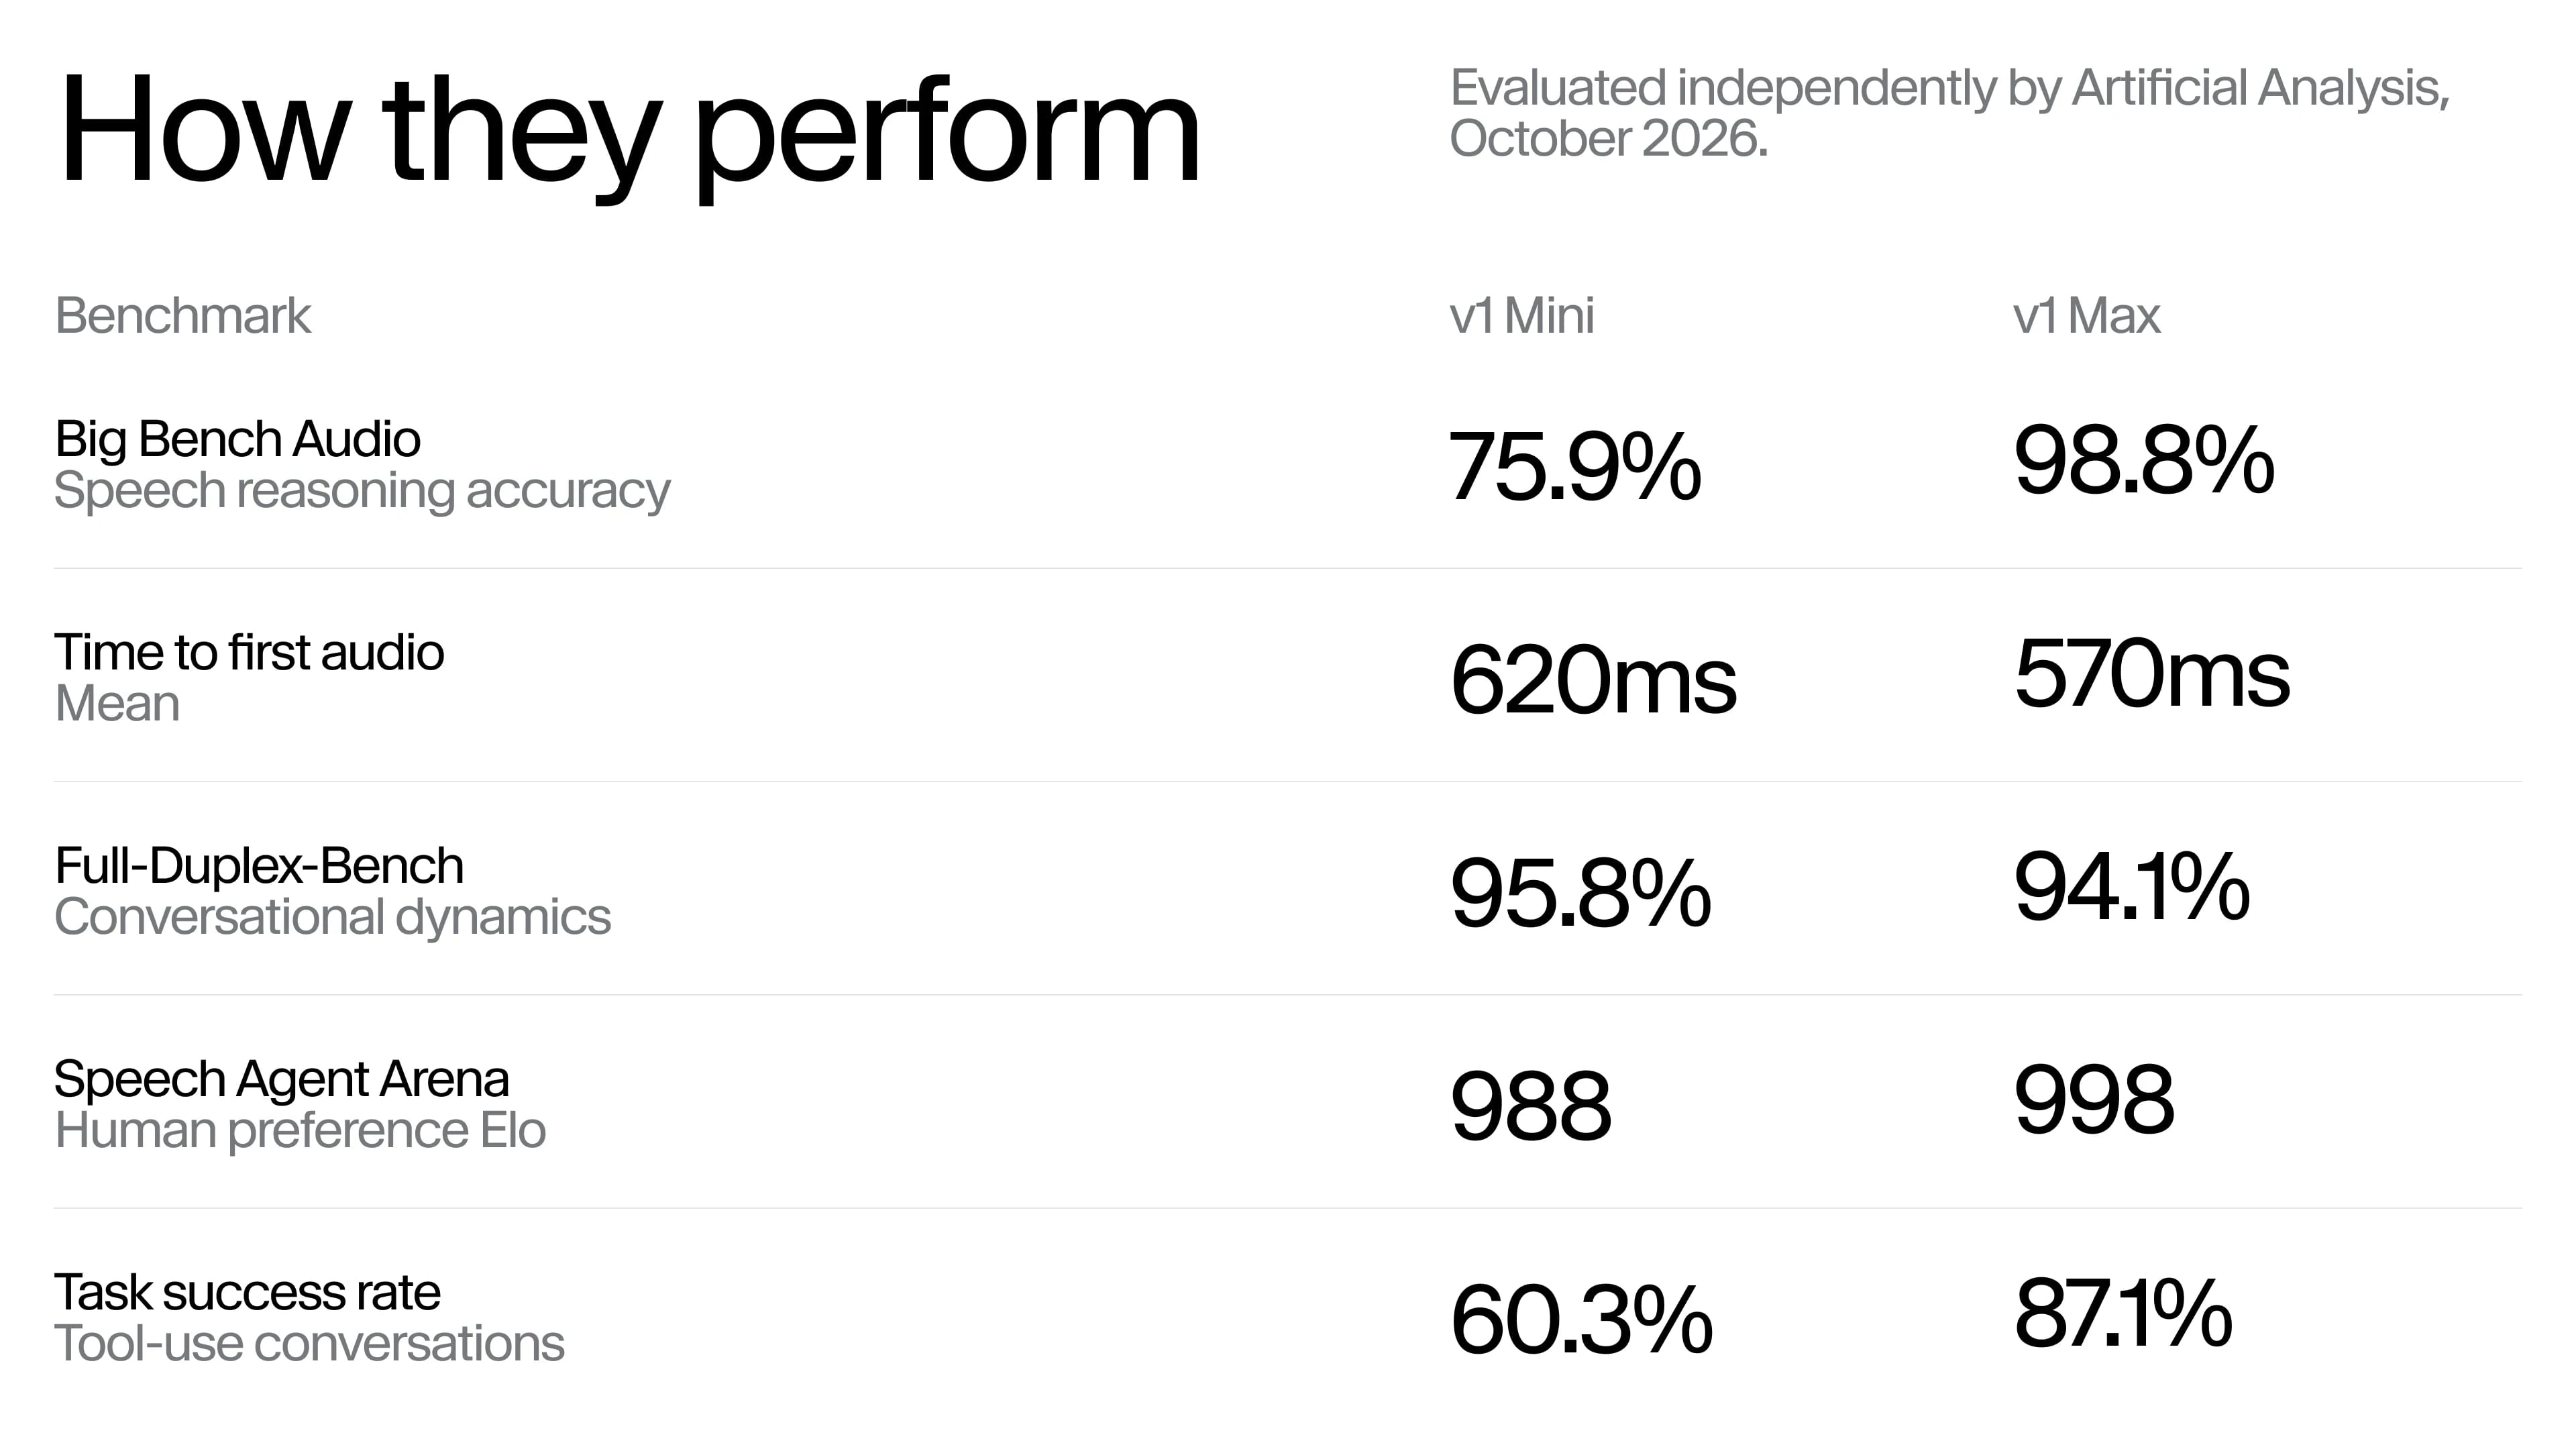
Big Bench Audioでは、音声で1,000問の推論問題を出題し、音声による回答を採点します。Realtime v1 Maxは98.8%の問題に正答し、v1 Miniは75.9%に正答しました。
速度
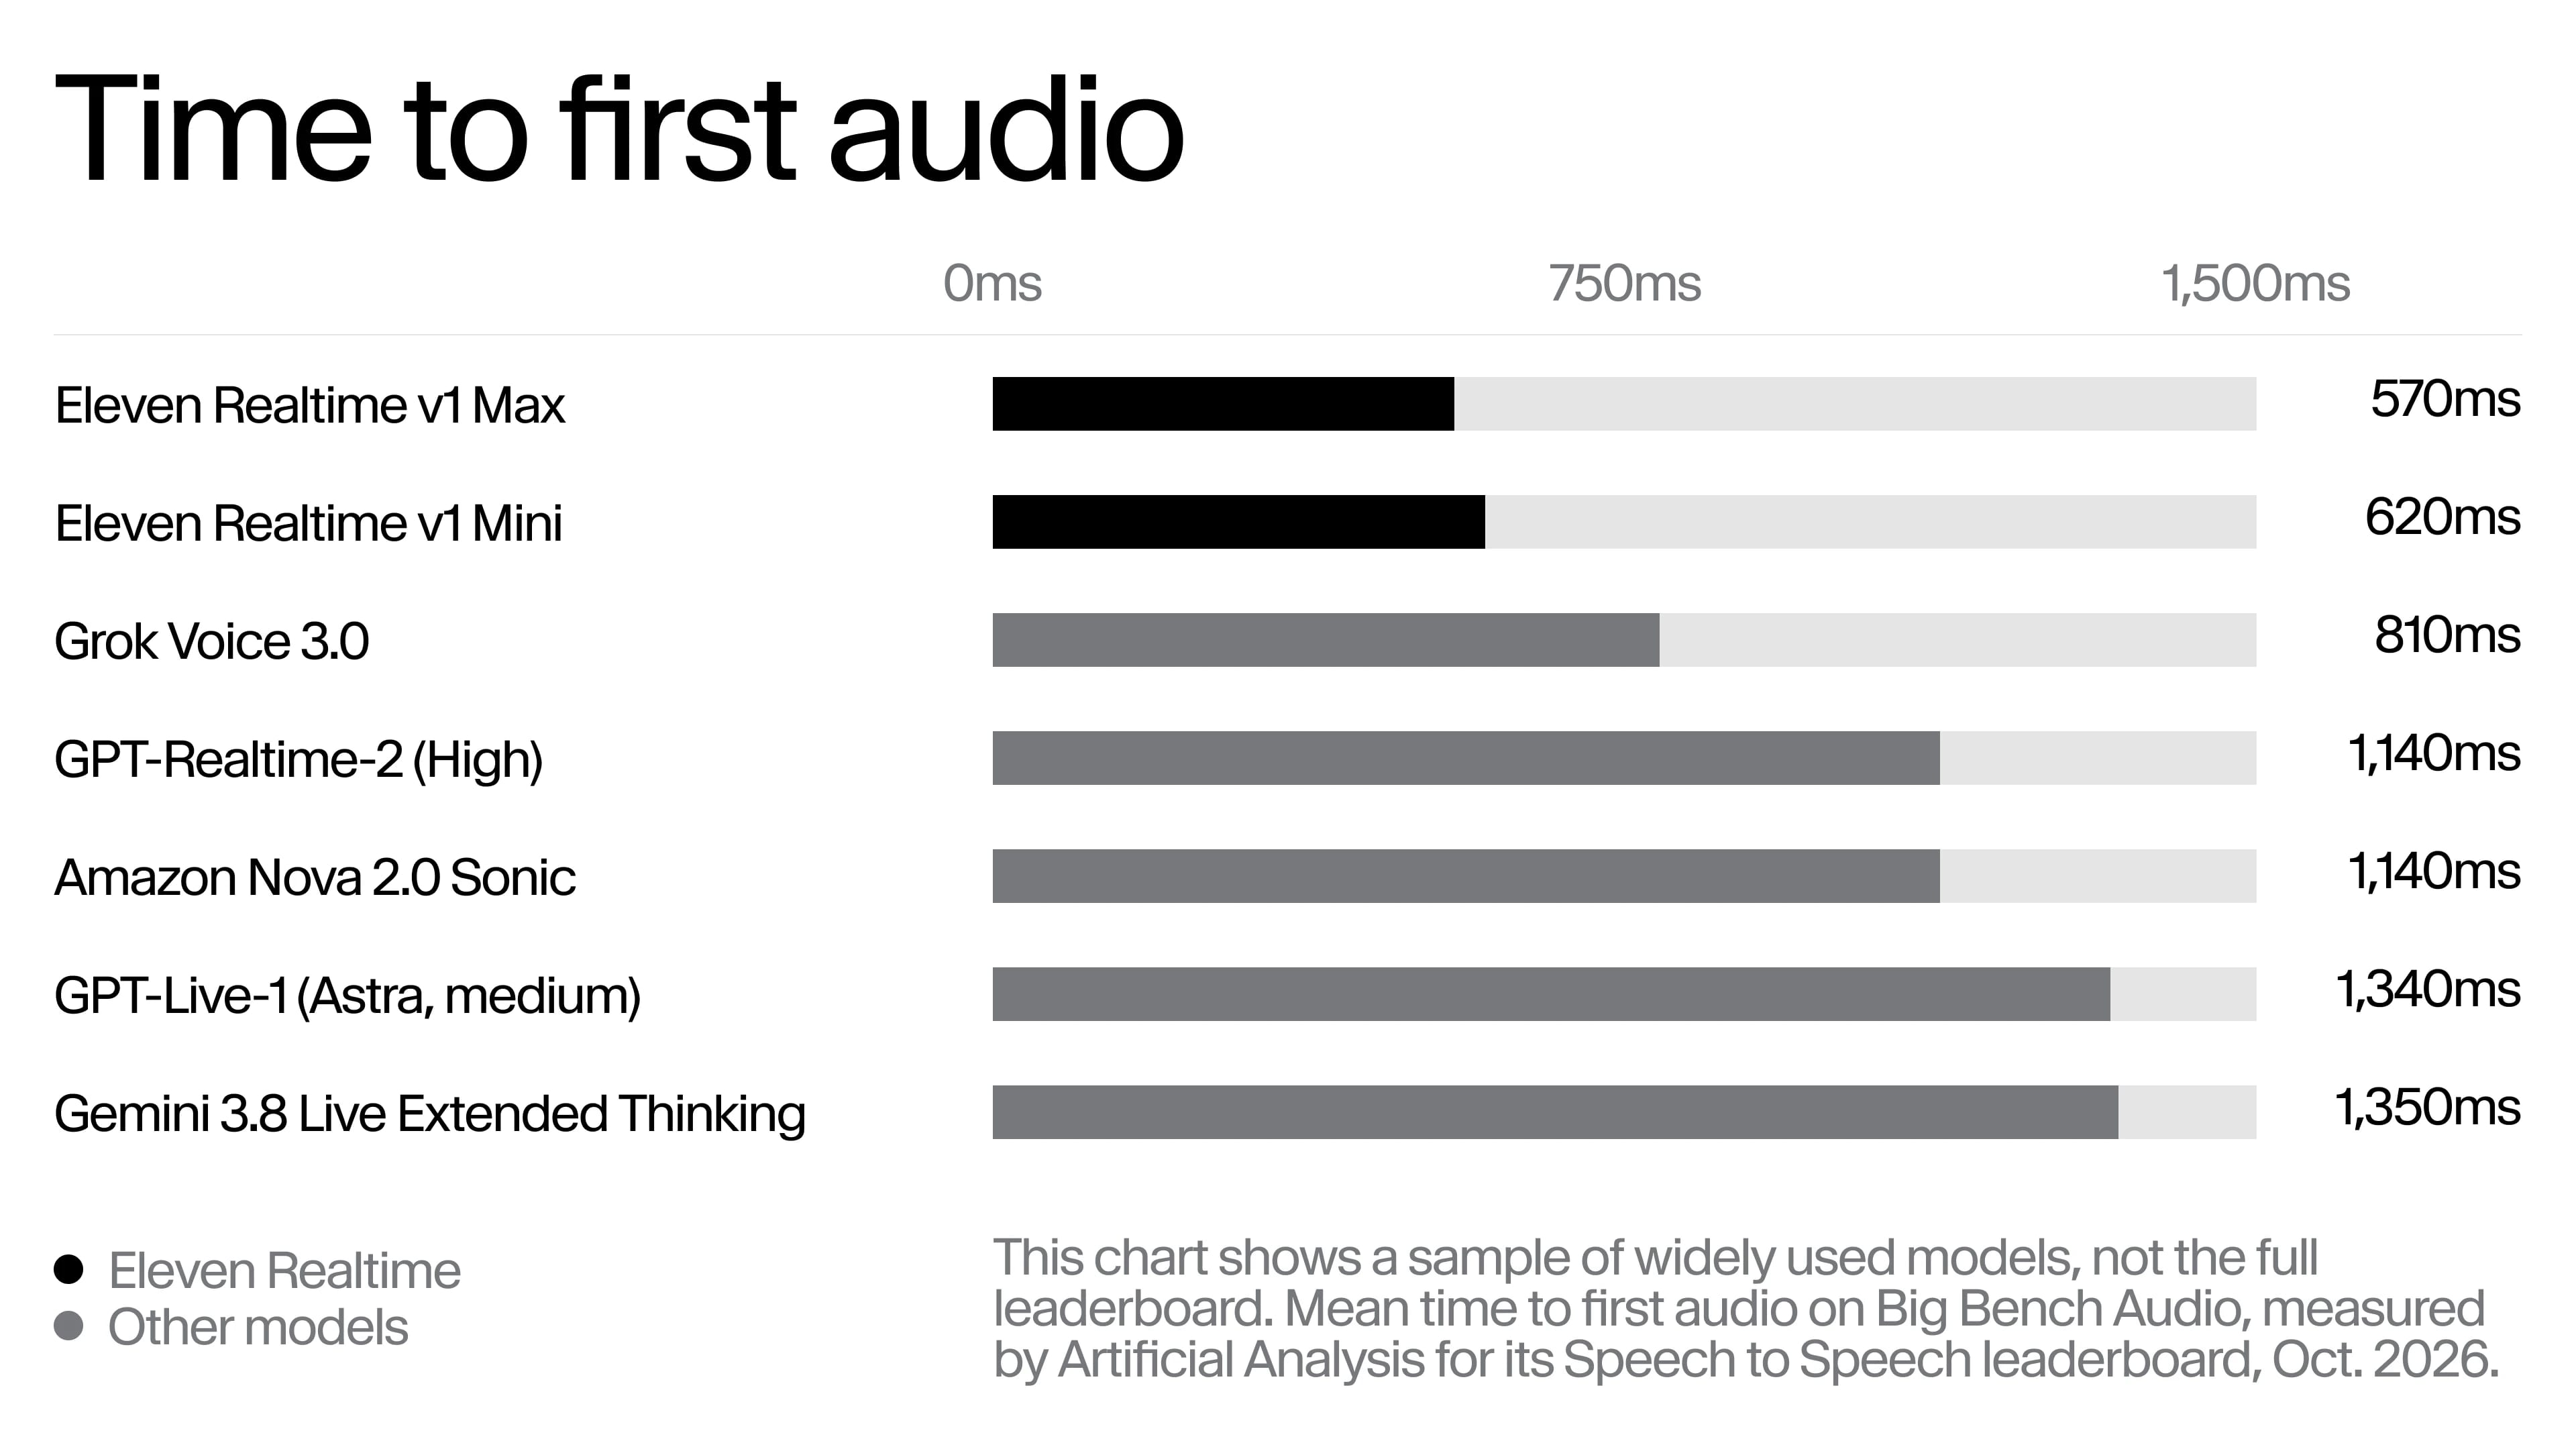
Big Bench Audioでは、音声で1,000問の推論問題を出題し、音声による回答を採点します。v1 Maxは平均0.57秒、v1 Miniは平均0.62秒で発話を開始します。
精度と速度のパレートフロンティア
精度と速度は通常、トレードオフの関係にあると考えられています。Big Bench Audioで最も高いスコアを出すモデルは回答に最も時間がかかり、最速のモデルは精度を大きく犠牲にします。v1 Maxは、この両方の指標で優れています。
会話のダイナミクスと人間の選好
間、ターンテイキング、割り込み、相槌をテストするFull-Duplex-Benchでは、v1 Miniは95.8%、v1 Maxは94.1%を記録しました。人々がライブの会話で2つのモデルをブラインド比較するSpeech Agent Arenaでは、v1 Maxは998、v1 Miniは988を獲得しました。ツール使用タスクでは、v1 Maxの完了率は87.1%、v1 Miniは60.3%でした。そのため、ツール呼び出しが多いユースケースにはMaxをおすすめします。
始める
ElevenAgentsで(推奨)
エージェントを作成するか既存のエージェントを開き、ドロップダウンからRealtimeモデルを選択します。そこから、本番環境でエージェントを運用するためにElevenAgentsが提供するすべての機能を利用できます。電話、Web、WhatsApp、CCaaSチャネル、ワークフロー、ナレッジベース、ガードレール、テスト、モニタリングが含まれます。
詳しくは、ElevenAgentsドキュメントをご覧ください。
Realtime APIを使用する
すでにOpenAIのRealtime APIとインテグレーションしている場合、Eleven Realtimeを試す最速の方法は、コードはそのままに接続先を変更することです。Realtime APIはWebSocket経由で接続し、OpenAI Realtimeの仕様に準拠しているため、OpenAIのSDKをそのまま使用できます。
Realtime APIはWebSocket接続のみに対応しているため、WebRTCインテグレーションはまずWebSocketへ移行する必要があります。また、ElevenAgentsとは別に動作するため、チャネル、ナレッジベース、その他のプラットフォーム機能が必要な場合は、最初からElevenAgentsで構築してください。
移行ガイドでは、手順とOpenAI APIとの違いを説明しています。