
会話型AIの設計:より人間らしいユーザー体験を作る方法
- 公開日
- 最終更新日
会話型AI設計とは、かつては意思決定ツリーを構築することを意味していました。初期のチャットボットやIVRメニューは、厳格に事前定義された分岐に基づいて動作していました。請求に関する用件なら1を押す、「はい」か「いいえ」と答える、そして顧客の質問が想定した経路のいずれかに合うことを願う。このモデルが機能するのは、会話があらかじめ構築した範囲にとどまる場合だけでした。
AIエージェントはこの制約を取り除きました。会話をリアルタイムで推論し、ナレッジベースを参照し、ツールを呼び出し、すでに話された内容を記憶できるため、固定されたスクリプトに縛られることはありません。
しかし、この変化によって会話型AI設計が不要になったわけではありません。むしろ、求められる水準は上がりました。頼りにできる厳格なスクリプトがないため、あらかじめ決められた会話ではなく、自由度の高いリアルタイムの会話でも成り立つよう、エージェントのペルソナ、ワークフロー、意思決定ポイントを十分に定義する必要があります。
このガイドでは、チャットと音声エージェントにおける会話型AI設計の実際の意味、すでに評価対象となっている指標にとって重要な理由、そしてより自然に感じさせるために最適化すべき点を解説します。適切に設計すれば、顧客とつながり、より速く、より良いサービスを提供するAIエージェントを導入できます。
概要
- 会話型AI設計とは、会話が自然に感じられるよう、AIエージェントのコミュニケーションを構造化・最適化することです。
- チャットインターフェースでは気にならない声、レイテンシー、タイミングの問題も、音声会話では機械的な印象につながるため、音声AIでは許容される余地がより小さくなります。
- ElevenAgentsは、音声、ペルソナ、会話フローを制御し、あらゆるチャネルでレイテンシーを最適化できる機能を組み合わせることで、人間らしいAI音声・チャットエージェントを実現します。
会話型AI設計とは?
会話型AI設計は、AIエージェントの振る舞いを設定するUXの実践です。ペルソナから、参照するガードレール、ワークフロー、ナレッジベースまで、あらゆる要素を組み合わせ、会話をプロダクト体験の他の部分と同じように洗練されたものにします。
ただし、その設定はどこでも同じではありません。エージェントは、単一の設定からチャット、音声、SMSなど複数のチャネルで動作できます。それぞれに制約がありますが、最も厳しいのは音声です。音声がエージェントのチャネルの1つである場合、音声を選択・生成し、リアルタイムでペースやターンテイキングを管理し、間が通話切断のように感じられる前に応答を返さなければなりません。多少遅かったり完璧でなかったりしても対話が壊れることがほとんどないチャットとは異なり、これらは省略できません。
チャットエージェントに会話型AI設計を実装する際に考慮すべき点と、音声でさらに必要になる要素を見ていきましょう。
顧客はこれらの要素を一つひとつ意識的に評価しているわけではありません。ただ、何かが不自然に感じられると気づきます。その感覚だけでエージェント全体への信頼が損なわれ、そもそも導入した目的が危うくなります。
優れたユーザー体験に会話型AI設計が重要な理由
ターンテイキング、レイテンシー、ペルソナなど、上で取り上げたあらゆる要素は、顧客がブランドをどう認識するかに影響します。それは、顧客を支持者にも批判者にも変え得る重要な瞬間です。その認識は、チームが評価される指標に直接表れます。
- 満足度と解決率の向上: エージェントが迅速に応答し、不自然に会話を遮らなければ、顧客はやり取りをより高く評価します。
- 離脱の削減: 顧客が会話を離脱する理由は、長い待ち時間だけではありません。通話中の不自然な間や、チャットでの堅苦しくブランドらしくない返信など、期待に沿わない応対も、会話を終えたいという同じ気持ちを引き起こします。
- 解決までの時間短縮: 明確な会話フロー設定と適切に設計されたワークフローにより、行き止まり、同じ質問の繰り返し、「担当者におつなぎします」といった場面を減らせます。
- 人間の担当者へのエスカレーション削減: エージェントが自然に会話フローを処理し、定義されたワークフローに従えば、顧客を混乱させて人を求めさせるのではなく、初回でより多くの問題を解決できます。
たとえば、 eDreams ODIGEOは世界最大級のオンライン旅行プラットフォームです。同社は5つの主要言語でElevenAgentsのAIエージェントを導入し、低レイテンシーの音声合成と、各通話の開始時点におけるより正確な意図認識により、解決速度を2桁改善し、通話転送率を2桁削減しました。このような成果は会話設計以外にも多くの変数に左右されますが、優れた会話型AI設計で何が可能になるかを示しています。
ElevenAgentsにおける会話型AI設計の仕組み
ElevenAgentsでは、エージェントが人間らしく感じられるかを左右するペルソナ、音声、ターンテイキング、ハンドオフ、レイテンシーなどを最適化できます。実際の会話でエージェントが役割を果たせるよう、各要素の設定と最適化の方法を見ていきましょう。
ペルソナと音声の選択
ペルソナは顧客の第一印象を決めます。不一致があると、会話が始まる前から信頼を損ねます。親しみやすい小売ブランドに対して堅すぎるペルソナでは、役立つことを何も言う前から顧客はエージェントを疑い始めます。まずはシステムプロンプトで形作りましょう。ここでは、他の何よりも先にエージェントの役割、人格、ガードレールを定義します。
音声エージェントでは、ペルソナを声でも表現する必要があります。金融に関する通話に対してカジュアルすぎる声は、テキストでペルソナが合わない場合と同じ印象を与えます。そのため、音声選択も同じ仕事の一部になります。まずは以下から始めましょう。
- 音声の選択: ブランド、オーディエンス、話題に合う音声を選びます。アクセント、性別、トーンはいずれも、特定の発信者との信頼を築き、会話の雰囲気を決めるのに役立ちます。
- 多言語サポート: 市場をまたいで1つの音声をデフォルトにするのではなく、サポートする言語ごとに音声を選択します。1つの音声を複数言語に無理に使うと、少なくとも1つの言語では外国語らしく聞こえがちで、築こうとしている信頼を損ねます。
ElevenAgentsでは、ボイスライブラリで11,000以上の音声を利用できます。アクセント、キャラクター、ユースケースで検索できるため、白紙の状態から始めることはほとんどありません。合うものがなければ、短いオーディオサンプルから既存の音声をクローンするか、一からデザインするという2つの選択肢があります。希望する年齢、アクセント、トーン、ペースをテキストプロンプトで指定してください。
会話フローの設定
会話に最も厳密な時間制約があるのは音声です。間が単なる空白にすぎないチャットと違い、通話でリズムが途切れると、すぐに無音や接続切れと受け取られます。このリズムを適切に整えることは、音声エージェントを会話の自然な参加者に感じさせるための最も重要な要素であり、ターンテイキングモデルそのものから始まります。
ElevenLabsのターンテイキングモデルは、話者が単に間を置いているのではなく、実際に話し終えたタイミングを検出するために構築された、研究に裏付けられたシステムです。これにより、固定の遅延に基づいて推測するのではなく、エージェントがいつ応答すべきかを判断できます。
さらに、会話フローを最適化するために調整できる設定を紹介します。
- ターンタイムアウト: 顧客がまだ考えている途中に割り込んだり、話し終えた後に待たせたりしないよう、エージェントが応答前に無音で待機する時間です。
- ソフトタイムアウト: 「少々お待ちください」や「確認します」など、処理中の間をつなぐためにエージェントが使う短いフィラーです。顧客が通話が切れたと思わないようにします。実際の応答時間は異なるため、「1秒お待ちください」のように具体的な時間を約束するフィラーは避けましょう。
- 割り込み: 顧客が話している途中に重ねて話し始めたとき、エージェントが話すのをやめるかどうかです。自然なやり取りのためには有効にしてください。法的免責事項、安全指示など、最後まで完全に聞いてもらう必要がある場合は無効にします。
- ターンの積極性: 顧客が話し終えた後、エージェントがどれだけ早く応答を始めるかです。「積極的」は迅速な応答が最も重要なカスタマーサービスに適しています。「慎重」は電話番号やメールアドレスなどの顧客情報を収集するときに最適で、数字の途中で顧客を遮ることを防ぎます。「標準」は一般的な会話に適したデフォルトです。
ここでの小さな調整が大きな違いを生みます。わずかなタイムアウトの変更でも、注意深いと感じるエージェントと、人の話を遮っているように感じるエージェントを分けることがあります。
ワークフロー、ハンドオフ設計、スクリプト
ワークフローは、ElevenAgentsで会話型AI設計の多くを実践に移す場所です。何がいつ起こるかを定義します。意思決定ポイント、エスカレーション経路、ハンドオフなど、本来はエージェントの即興に任されるすべてを定めます。
ワークフローは、エージェントを洗練させるための他の2つのシステムと連携します。システムプロンプトでは、挨拶やハンドオフといった重要な局面での役割、トーン、発言すること・しないことなど、エージェントの基本的な振る舞いを定義します。プロシージャは、顧客の本人確認や返品手続きの案内など、単一で明確に定義されたタスク向けの、より規定的な選択肢です。顧客の発言に応じて分岐するのではなく、会話がどう進んでも、開始から終了まで決められた順序を段階的に実行します。
エージェント構築を最も簡単に始める方法は、事前構築済みエージェントテンプレートを使うことです。ワークフローとシステムプロンプトの両方の出発点が用意されているため、一から構築するのではなく微調整に集中できます。独自のものにするため、以下の変更から始められます。
- 意思決定マッピング: すべての意思決定ポイントでエージェントが何をするかを正確にマッピングし、会話全体を開始から解決まで定義します。 サブエージェントノードを使うと、フロー内の特定のポイントでシステムプロンプト、モデル、さらには音声まで調整できます。そのため、通話の前半にあるカジュアルな雑談よりも、機密性の高い本人確認ステップに厳格なガードレールを適用できます。
- エスカレーショントリガー: その場でエージェントに判断させるのではなく、人間に引き継ぐための明確なトリガーをワークフローに組み込みます。たとえば、2回試しても問題が解決しない場合、顧客が上司を求めた場合、取引が機密性または高額で人による対応が必要な場合にエスカレーションします。
- ハンドオフのコンテキスト: システムプロンプトで、注文IDやアカウント番号など、転送前にエージェントが収集すべき情報と、ハンドオフを開始する条件を定義します。次に、保存された詳細を転送ツールの設定にマッピングすれば、顧客が人間の担当者に同じことを繰り返すことなく、情報が自動的に引き継がれます。
- スクリプト化した表現: システムプロンプトで、重要な場面の正確な文言を定義します。開始時の挨拶、エラーメッセージ、法的免責事項、エスカレーション時のハンドオフは、その場でエージェントに即興で作らせてはいけません。「現在、その情報にアクセスできません」のように正確な一文を定義するほうが、何か問題が起きたときにエージェントに表現を推測させるよりも信頼性が高くなります。
ワークフロー自体はElevenAgentsで視覚的なグラフとして構築され、各意思決定ポイントとエスカレーショントリガーは、直接確認・編集できるノードとしてマッピングされます。
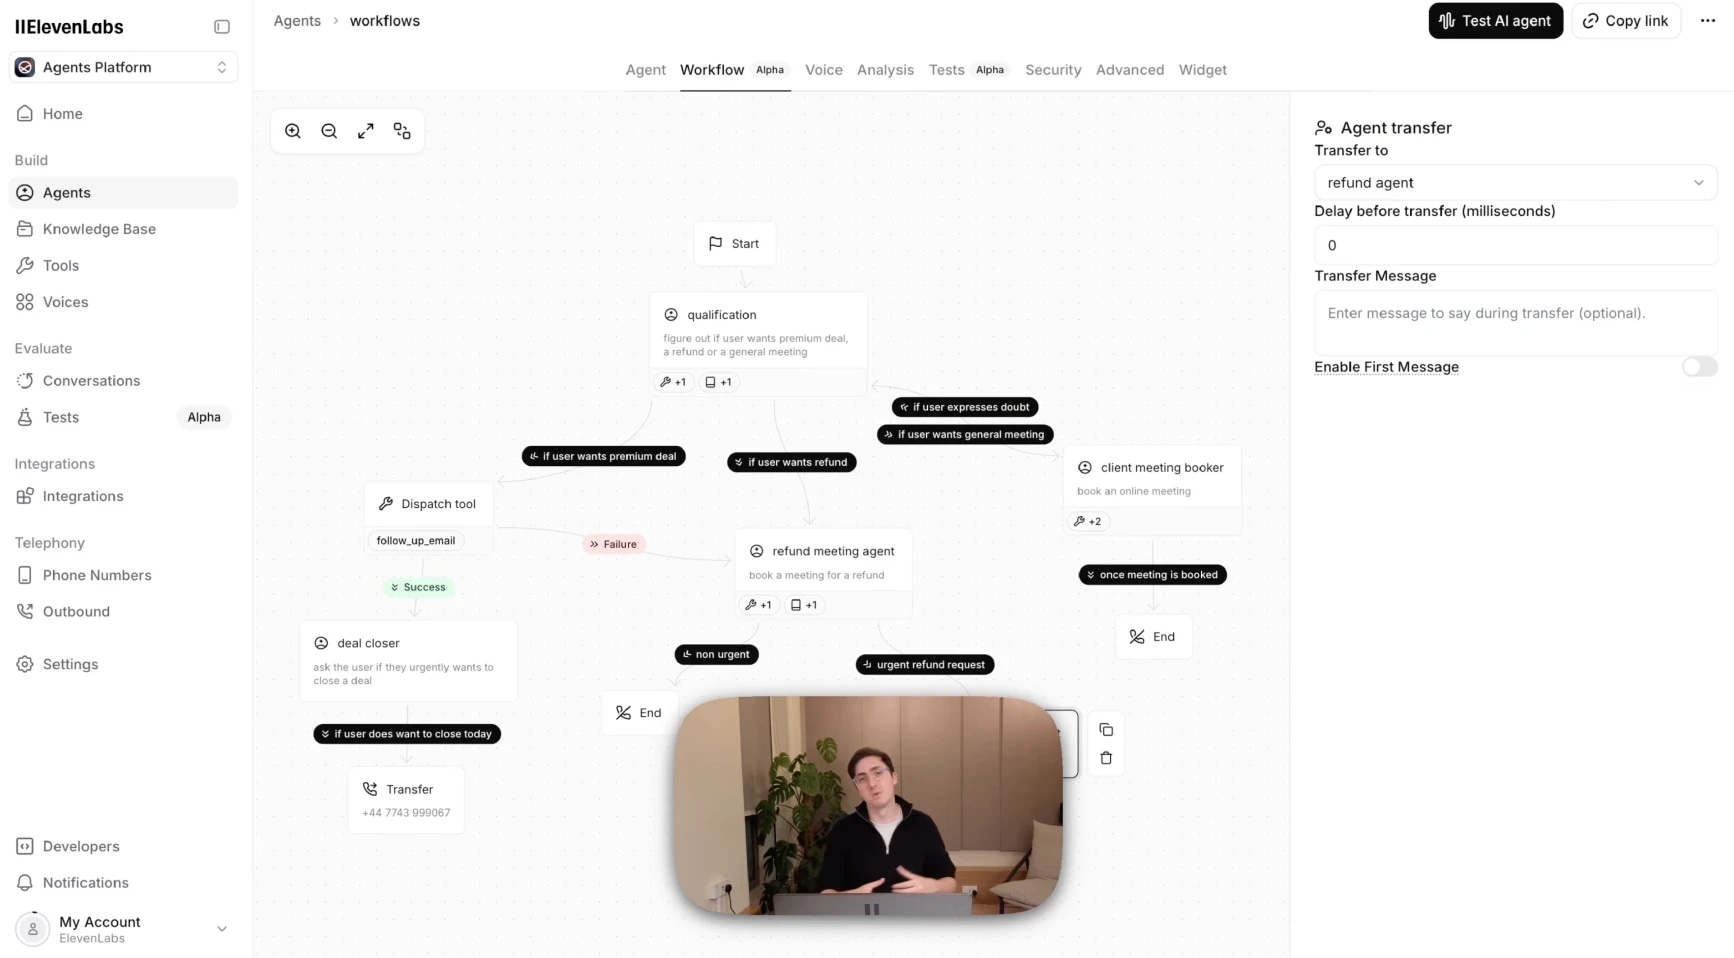
運用開始後は、分析データが実際の会話データを同じグラフ上に重ねて表示するため、顧客がどこで行き詰まったり離脱したりしているかを正確に把握し、推測に頼らず修正できます。
レイテンシーとパフォーマンス
レイテンシーは、やり取りが人間らしく感じられるかを左右する最も大きな要因の1つです。会話の他のすべてが順調でも、遅い応答は、顧客に機械と話していることを最も早く意識させる要因の1つです。
エージェントがチャットと音声のどちらで動作していても、パイプラインの各部分が独自のレイテンシーを加えます。どちらにも当てはまるものもあれば、音声の場合のみ当てはまるものもあります。
- LLM: モデルの選択はすべて、コスト、推論品質、速度のトレードオフであり、適切なバランスは会話によって異なります。FAQや予約確認のようなシンプルで頻度の高いやり取りは、体験を損なうことなく、より高速で軽量なモデルで処理できます。金融アドバイスや複数ステップのトラブルシューティングといった複雑なタスクでは、少し応答が遅くても、より強力な推論モデルに投資する価値が通常はあります。
- ナレッジベースとRAG: ナレッジベースの検索ごとに、エージェントが応答するまでのラウンドトリップが追加されます。そのため、広範囲に検索する必要があるナレッジベースより、無駄がなく焦点を絞ったナレッジベースのほうが高速に応答します。
- インテグレーションとツール呼び出し: Salesforceで注文を検索したり、カレンダーの空き状況を確認したりといった外部ツールの呼び出しには、それぞれラウンドトリップが追加されます。どのツールを呼び出すべきかエージェントが迷わないよう、ツールの説明を明確にし、会話で実際に必要なツールだけを呼び出しましょう。
- 地理的な場所とデータホスティング: ElevenAgentsのリージョンをデータのホスティング先に合わせ、電話ベースの導入ではテレフォニープロバイダー(Twilio、SIPなど)のリージョンにも合わせます。エージェントのリージョンと通話ゲートウェイのリージョンが世界の反対側にある場合、会話が始まる前からその距離がレイテンシーを追加します。
- スピーチtoテキスト(音声のみ): Scribeは、エージェントが推論する前に顧客の発話を文字起こしします。速度より精度を重視して設計されたバッチ版ではなく、ライブ会話にはリアルタイム版(Scribe v2 Realtime)を使用してください。
- ターンテイキング(音声のみ): エージェントがそもそもいつ応答すると判断するかを決める要素で、詳細は上で説明しました。ターン終了の検出をためらうモデルは、残りのパイプラインが始まる前に遅延を追加するため、それ自体がレイテンシー要因であることを覚えておく価値があります。
- テキスト読み上げと音声選択(音声のみ): デフォルト音声、合成音声、Instant Voice Clonesは、Professional Voice Clonesよりも高速に応答します。追加の忠実度がレイテンシーとのトレードオフに見合う場合にのみ、Professional Voice Clonesを使用してください。
レイテンシーについて詳しくは、レイテンシー最適化のベストプラクティスと、パイプライン全体でレイテンシーを測定・報告する方法をご覧ください。
ElevenAgentsで最初のエージェントを設計する
ここで取り上げた要素が、AIエージェントにおける会話型AI設計の実践的な意味です。すべてElevenAgentsにネイティブで搭載され、ノーコードコンソールから設定できるため、質問に正しく答えるだけでなく、実際の会話ができるエージェントを構築できます。
実践的な支援を希望するチーム向けに、ElevenLabsの Forward Deployed Engineersがチームと直接連携し、要件定義、構築、本番対応エージェントのローンチを行い、稼働後もパフォーマンスの微調整を支援します。
自分で構築する場合もサポートを利用する場合も、違いを最も早く確かめる方法は試してみることです。今すぐエージェントを作成するか、営業チームに問い合わせてください。



