Scribe v3 Live Medicalで会話型エージェントが臨床情報を正確に把握
- 公開日
音声エージェントは、通話中に聞き取った内容に基づいて対応します。患者が糖尿病の治療でシタグリプチンを服用していると言えば、エージェントは医師が確認できるよう、その薬を服用薬リストに追加できます。しかし、薬剤名は聞き間違えやすいものです。テストでは、音声モデルがシタグリプチンを抗うつ薬のシタロプラムと文字起こしした例がありました。多くの人にとって、こうした電話は医療チームにつながるための第一歩です。エージェントが役に立つには、内容を正確に聞き取る必要があります。
本日、ElevenLabsは、ライブ通話に医療文字起こしを導入するScribe v3 Live Medicalをリリースします。最新のリアルタイムスピーチtoテキストモデルScribe v3 Liveをベースに、臨床用語に最適化しています。ElevenAgentsで今すぐ利用できます。
ライブ通話に医療文字起こしが必要な理由
ElevenLabsはすでに、口述や診察記録などの録音済みオーディオ向け医療文字起こしを提供しています。しかし、医療チームが構築する仕組みの多くは、予約受付や医療情報案内、電話での受給資格確認、保険請求のフォローアップなど、リアルタイムで動作します。こうした通話では、録音が終わるまで待つことはできません。
薬剤名や用量は日常会話ではほとんど使われないため、一般的なリアルタイムモデルでは間違えやすい言葉です。Scribe v3 Live Medicalは、エージェント向けに開発した初の医療文字起こしモデルで、Scribe v2 Medicalの臨床分野への特化をリアルタイム会話にも広げています。模擬診察の公開データセットPriMock57を使ったテストでは、評価した他のどの医療モデルよりも誤りが少ない結果となりました。
臨床情報が重要な通話
Scribe v3 Live Medicalは、初診受付での服用薬、事前承認の対象となる処置、フォローアップ通話での症状など、臨床情報を扱う患者、加入者、医療提供者との通話向けに設計されています。医療エージェントは、予約変更や診療時間の問い合わせなど、臨床情報をまったく含まない通話にも数多く対応します。Scribe v3 Live Medicalは、臨床情報の精度を高めながら日常会話の精度も維持するため、あらゆる通話で利用できます。
臨床会話のための機能
最大10,000件のカスタム用語を登録
医療チームは独自の用語を最大10,000件追加でき、Scribe v3 Live Medicalは発信者がそのいずれかを話したと判断した場合にのみリストを参照します。地域の医療システムなら全拠点の医療提供者名とクリニック名を、製薬会社なら全製品のブランド名と一般名を登録できる件数です。カスタム用語リストを登録したテストでは、Scribe v3 Live Medicalによる医療用語の誤りが最大48%減少しました。
発信者が話し終えるまで待機
発信者はカードを見ながら、加入者IDや生年月日を数字のまとまりごとに区切り、間を置いて読み上げることがあります。すべての間を発話の終わりとみなすエージェントは、番号の途中で話し始めてしまい、発信者は最初から言い直さなければなりません。Scribe v3 Live Medicalは番号がまだ途中であることを認識し、残りを聞いてから応答します。
言語が切り替わっても患者の発話を追跡
患者や介護者は、たとえば母語で症状を説明しやすくするために、通話の途中で言語を切り替えることがあります。Scribe v3 Live Medicalは90以上の言語に対応し、こうした切り替えにも追従するため、別の言語での発話も欠落せず文字起こしされます。
医療チームから寄せられた評価
すでに各チームがScribe v3 Live Medicalを使ってエージェントを構築しています。
「Eleven v4 TurboとScribe v3 Live Medicalによる対話体験は驚くほど優れています」と、Pfizerのデジタル戦略&イノベーション担当ディレクター、Idin Jafari氏は述べています。「エージェントの音声はリアルで、会話に出てくるブランド名や一般名もより正確に認識します」
患者との通話での精度は、通話後に医療チームが確認する内容にも反映されます。
「ElevenLabsは常に基準を引き上げており、そのおかげでVintage Labsはより速く前進できます。VIAプラットフォームは、大規模な大学病院向けに処置前後の通話を行います。Scribe v3 Live Medicalにより、患者の服用薬、処置、医師の名前をより正確に把握できます」と、Vintage Labs AIの創業者兼COO、Shantanu Ghorai氏は述べています。「ターン検出機能は、患者が生年月日を最後まで言い終えるのを待ってから応答します。また、多言語モードは、発信者がスペイン語に切り替えても追従します。看護師は録音を聞き直さなくても、通話要約を信頼できるようになりました」
Scribe v3 Live Medicalの評価方法
Scribe v3 Live Medicalと、主要プロバイダーが提供する専門医療モデルおよび汎用モデルを含むリアルタイムスピーチtoテキストモデルを、すべて同じ録音データで比較しました。医師と患者の会話に関する2つの公開ベンチマークを使用し、医療会話と日常会話でScribe v3 Live MedicalとScribe v3 Liveを比較したほか、英語、フランス語、ドイツ語の医療用語もテストしました。特記がない限り、結果は英語での評価です。
誤って文字起こしされた単語の割合を示す単語誤り率(WER)と、意味が変わる誤りだけを数える意味的WERを報告します。意味的WERでは「20 mg」と「twenty milligrams」を一致とみなすため、スコアはWERより低くなります。
注:これらの結果は、選定したプロバイダーの各モデルを利用可能な最適構成に設定し、リアルタイムモードで実施したElevenLabsの社内テストに基づきます。利用可能なすべてのモデルを網羅するものではありません。
プライマリケア診察(PriMock57)
PriMock57には、医療従事者と患者役の俳優による模擬プライマリケア診察が57件収録されており、各診察は約9分です。双方の会話に台本はありません。俳優は症状、病歴、現在の服用薬を記載したケースカードを基に演じ、医療従事者は実際の診察と同じように進めました。通話には遠隔医療ソフトウェアを使用し、バックグラウンドノイズのあるオフィス環境で、医療従事者はノートパソコン、患者は携帯電話から参加しました。
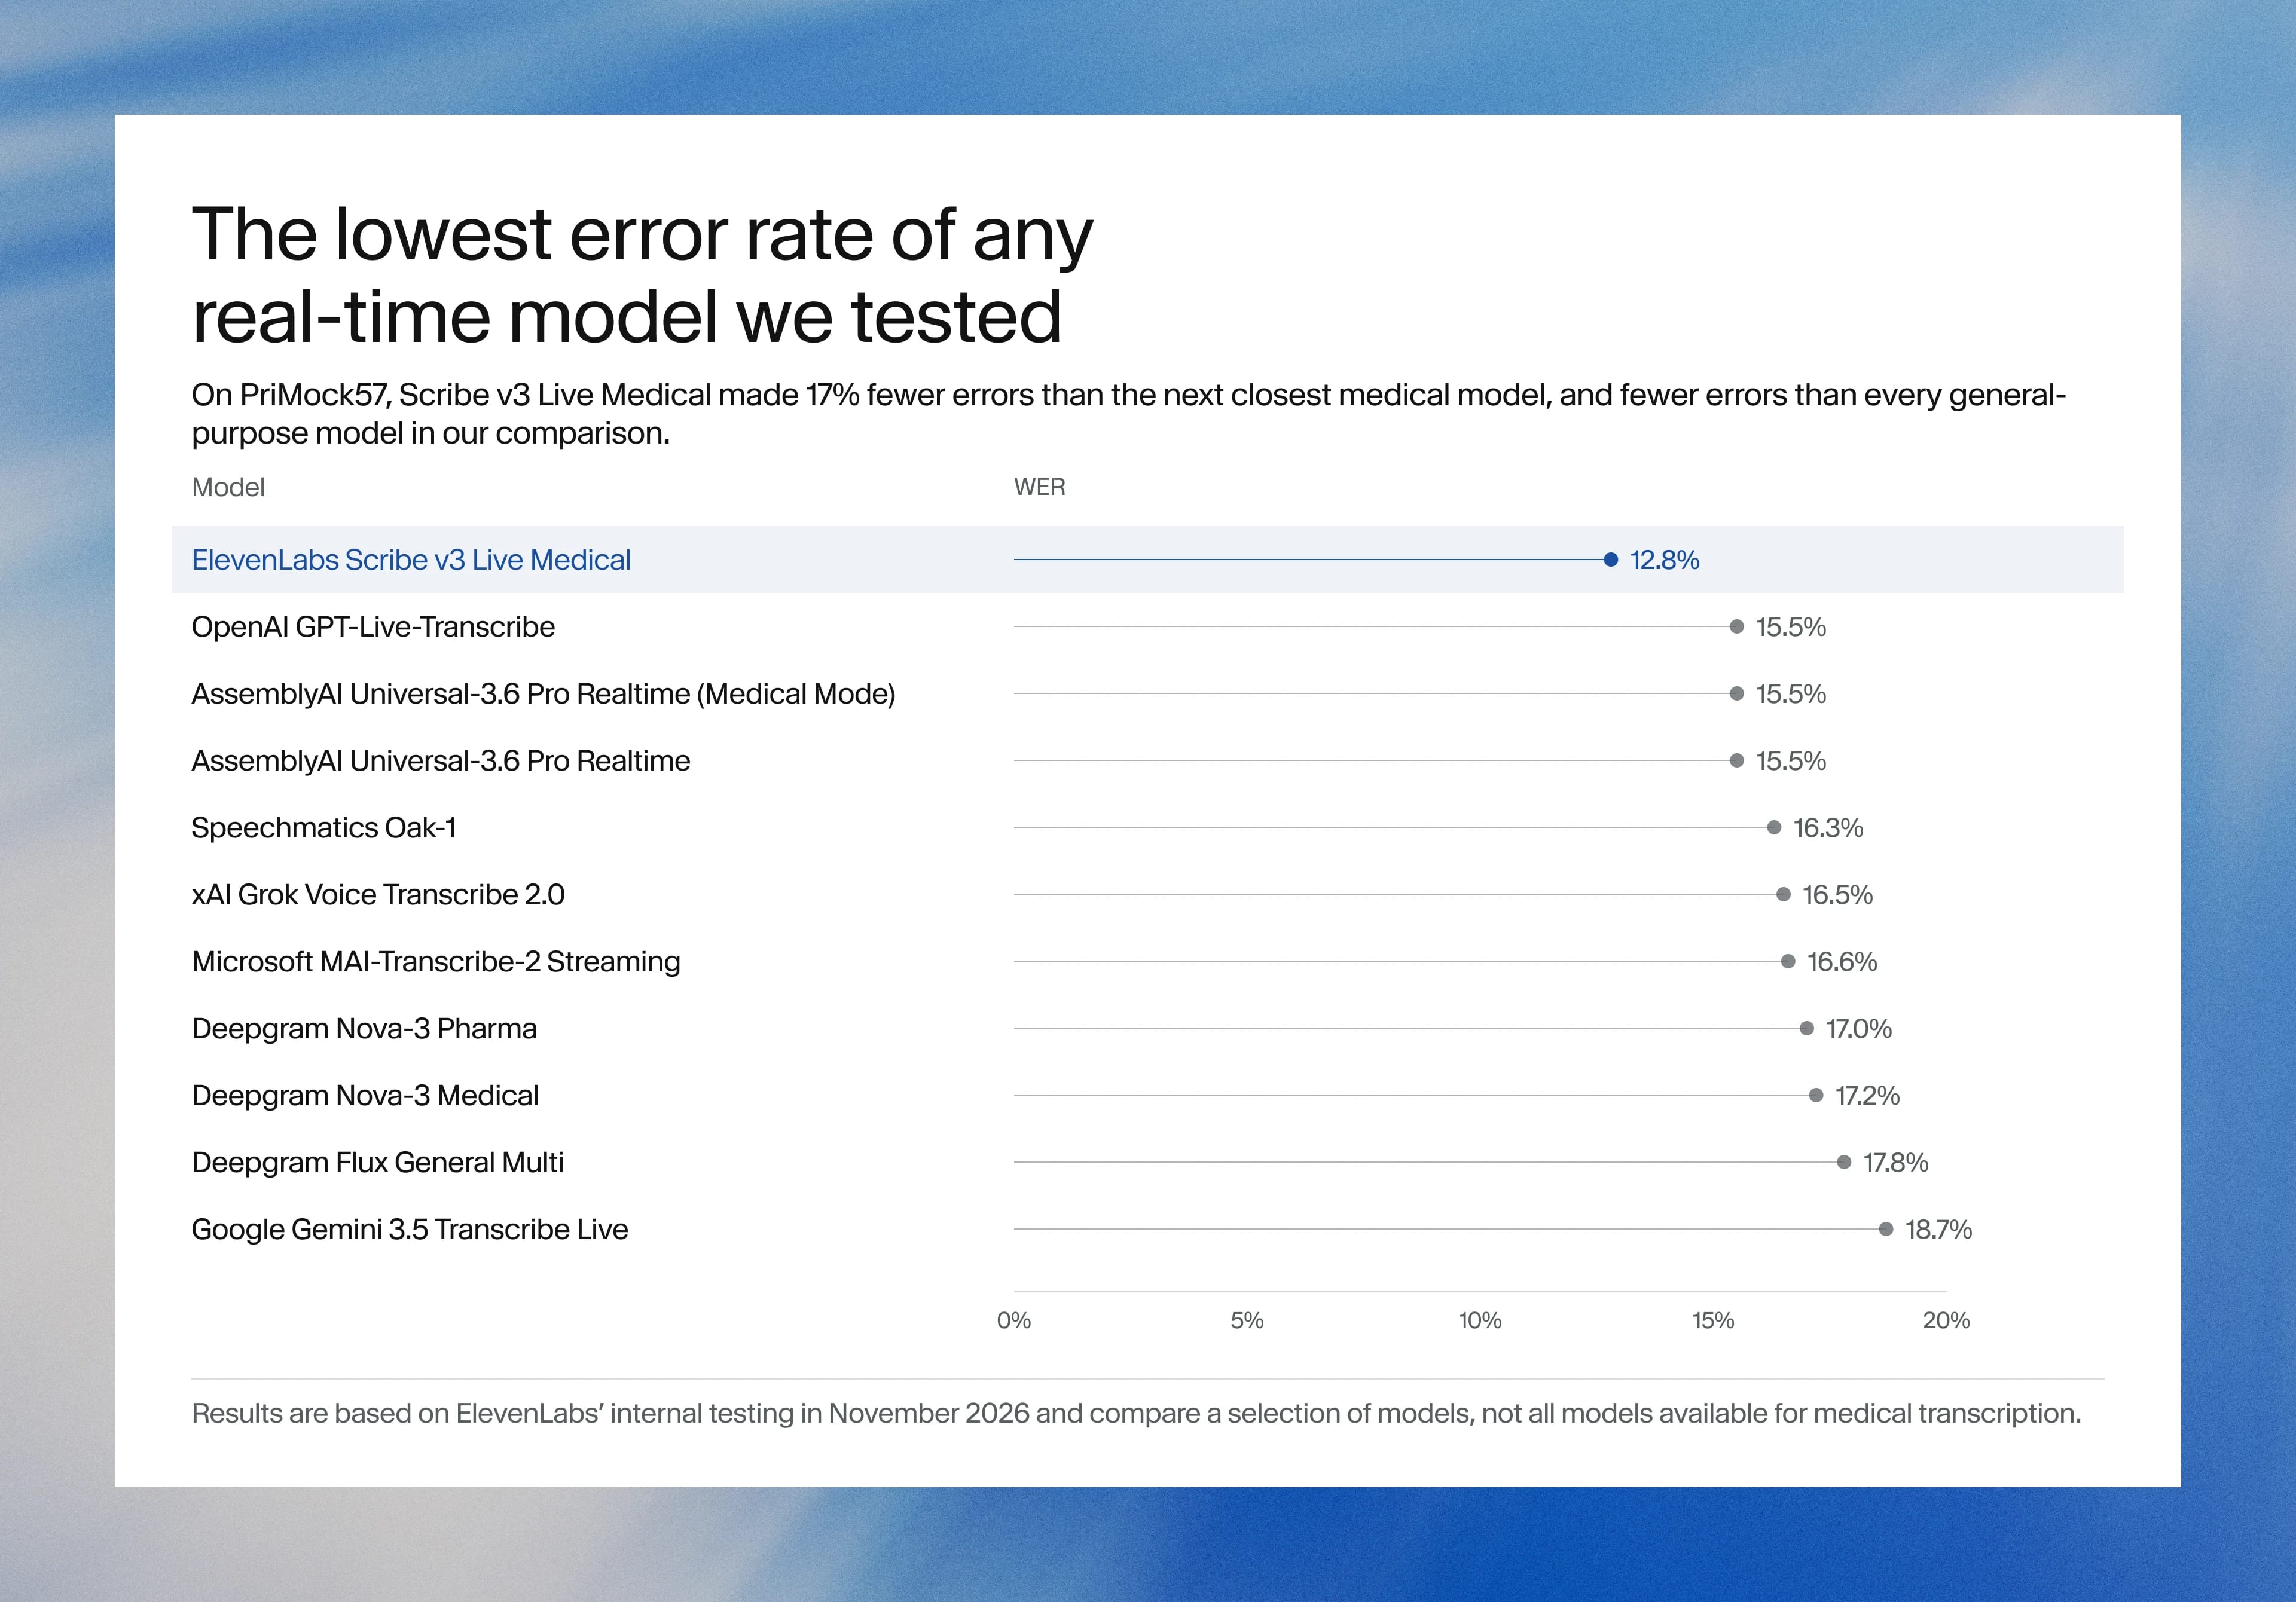
このベンチマークを使用したのは、台本のない双方向の会話、バックグラウンドノイズを含む電話音声、密度の高い臨床情報など、患者との通話の文字起こしを難しくする要素がそろっているためです。Scribe v3 Live MedicalのWERは、テストした医療モデルの中で最も低い12.8%で、次に精度の高いモデルより誤りが17%少ない結果となりました。
患者インタビュー(Fareez OSCE)
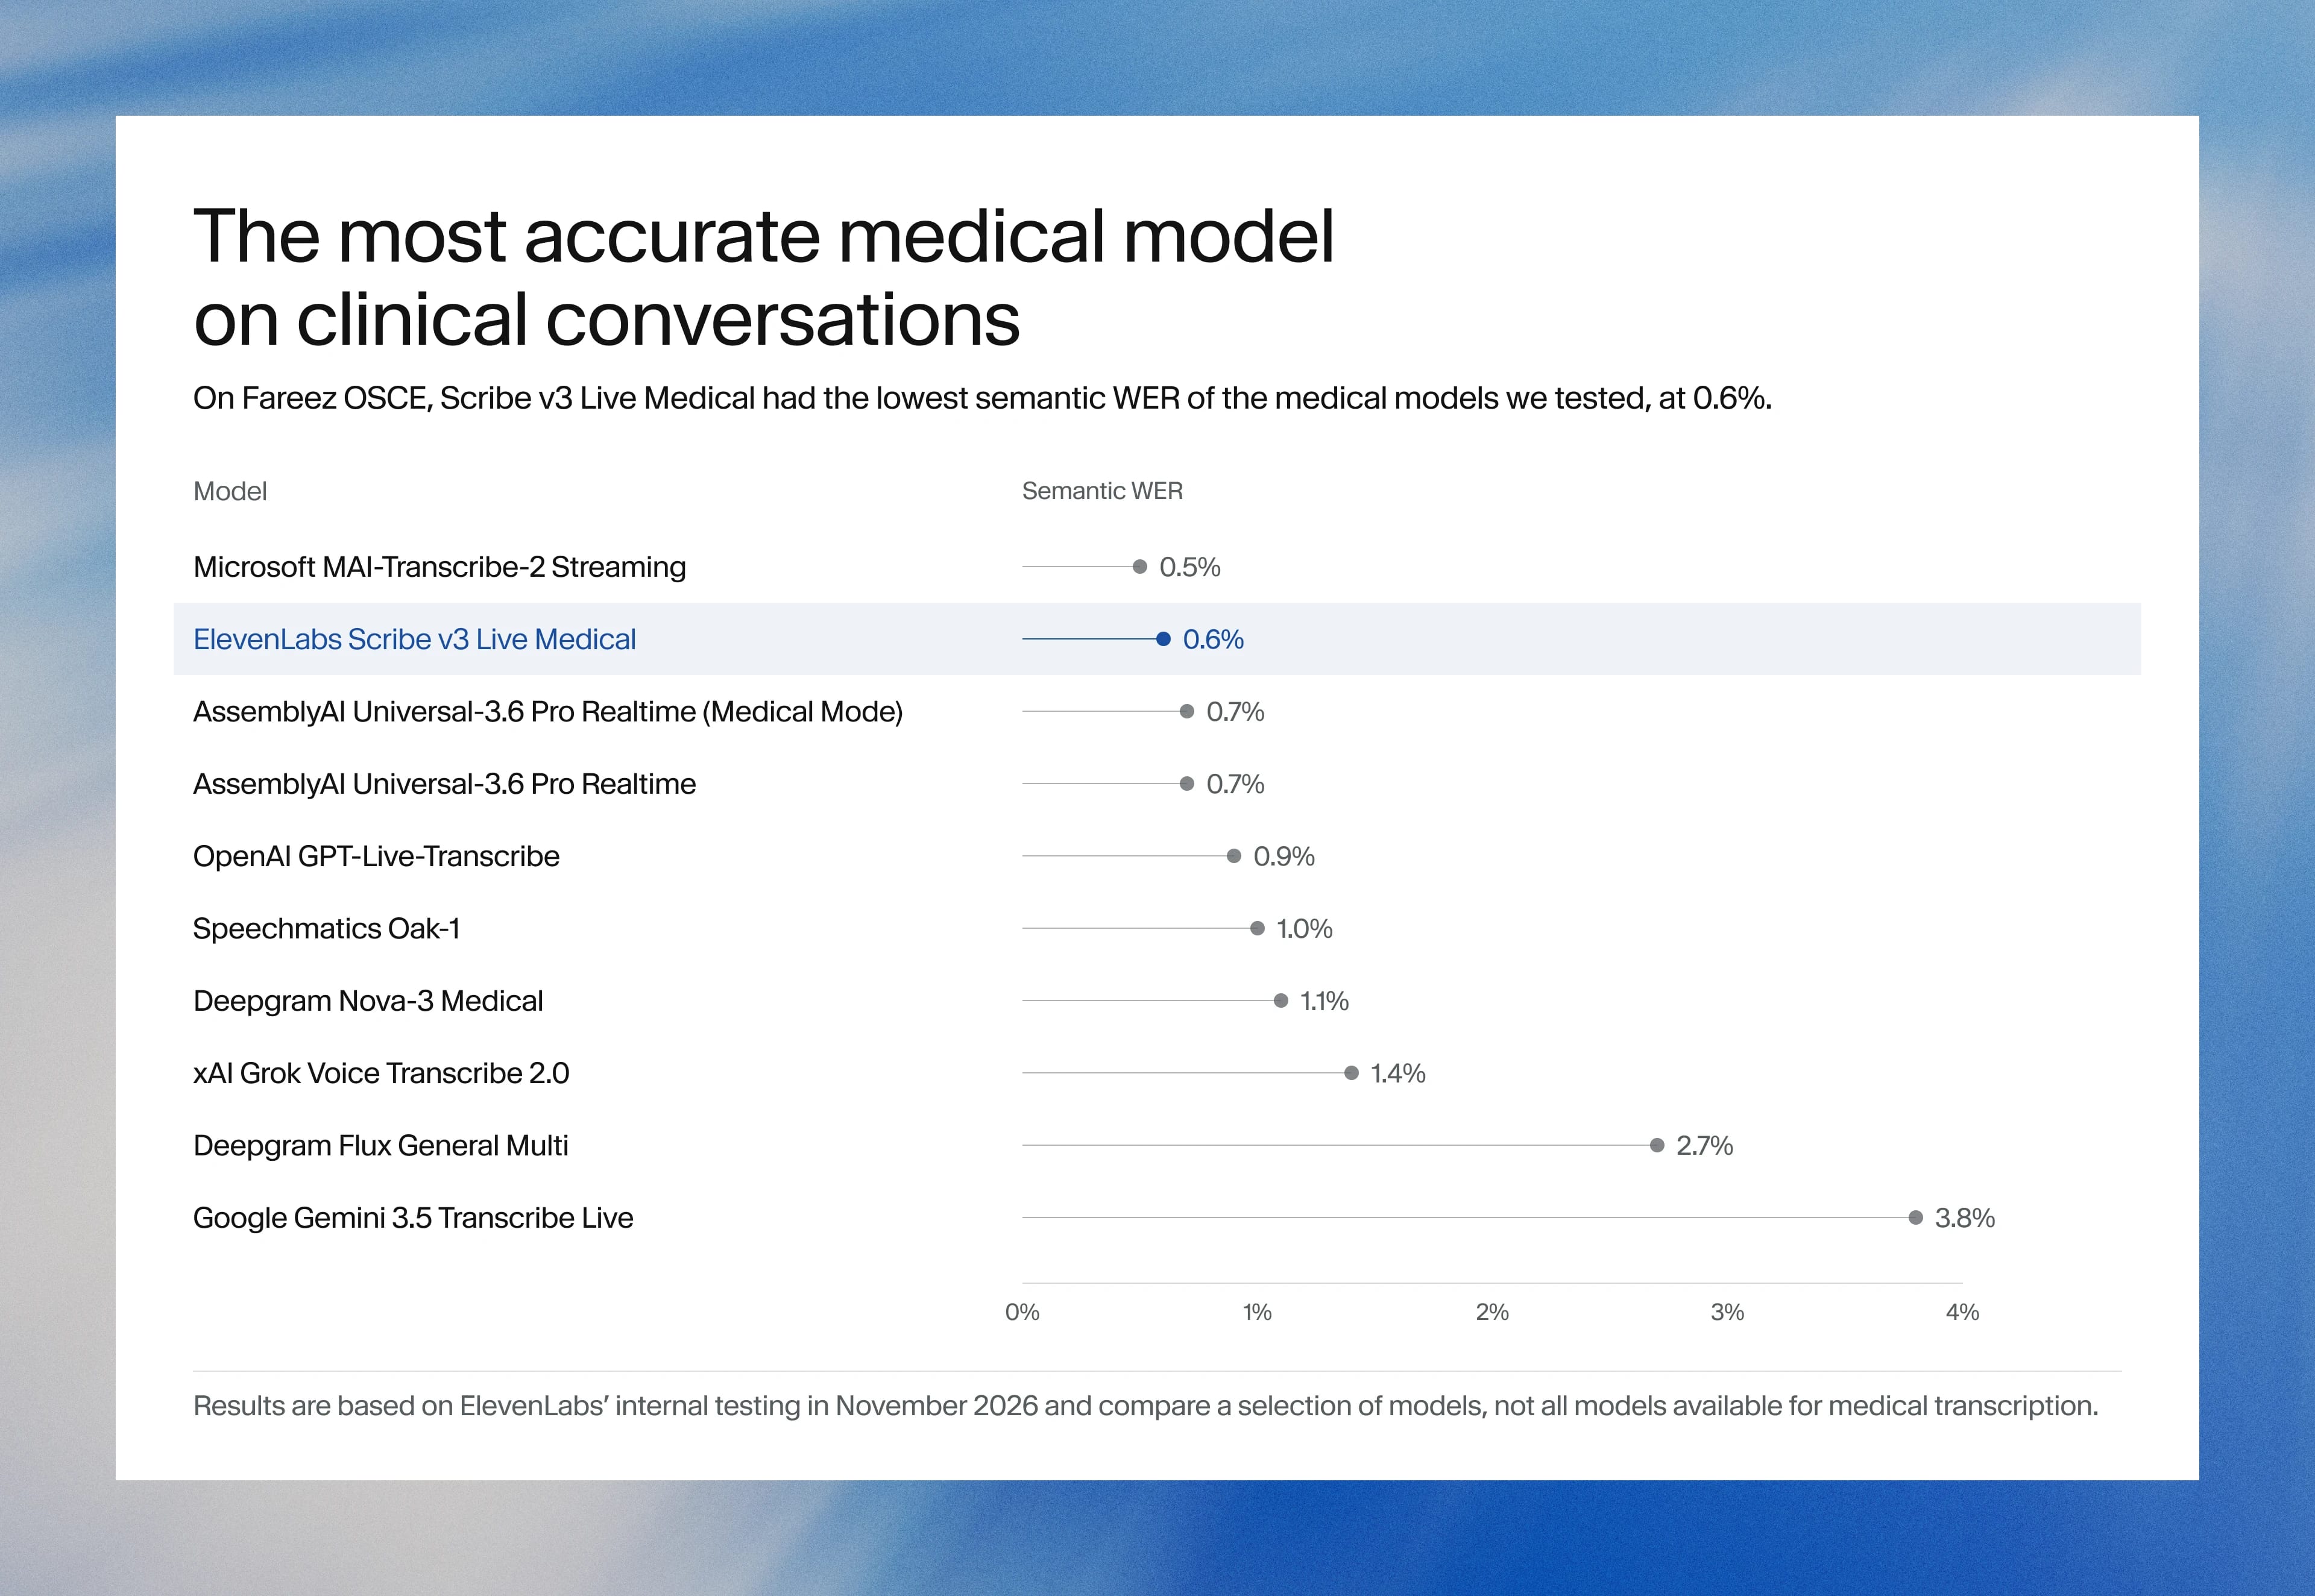
Fareez OSCEは、医学部で臨床技能の評価に使われる客観的臨床能力試験(OSCE)形式で収録された272件の患者インタビューです。各インタビューでは、研修医または上級学年の医学生が患者役の人物に症状や病歴を尋ねます。別のチームが他国で収録したデータのため、話者、録音環境、条件が変わっても同じ結果が得られるかを確認できます。Scribe v3 Live Medicalの意味的WERは、テストした医療モデルの中で最も低い0.6%でした。
Scribe v3 Liveとの比較
Eka Medical ASRには、医師や医学生による3,600件以上の英語録音が収録されており、医療用語とブランド薬剤名に重点を置いています。Eka Medical ASRでは、Scribe v3 Live Medicalの誤りがScribe v3 Liveより4.7%少ない結果となりました(意味的WERは11%対11.54%)。
モデル
Eka Medical ASR(意味的WER)
Scribe v3 Live Medical
11%
Scribe v3 Live
11.54%
日常会話(Common VoiceとFLEURS)
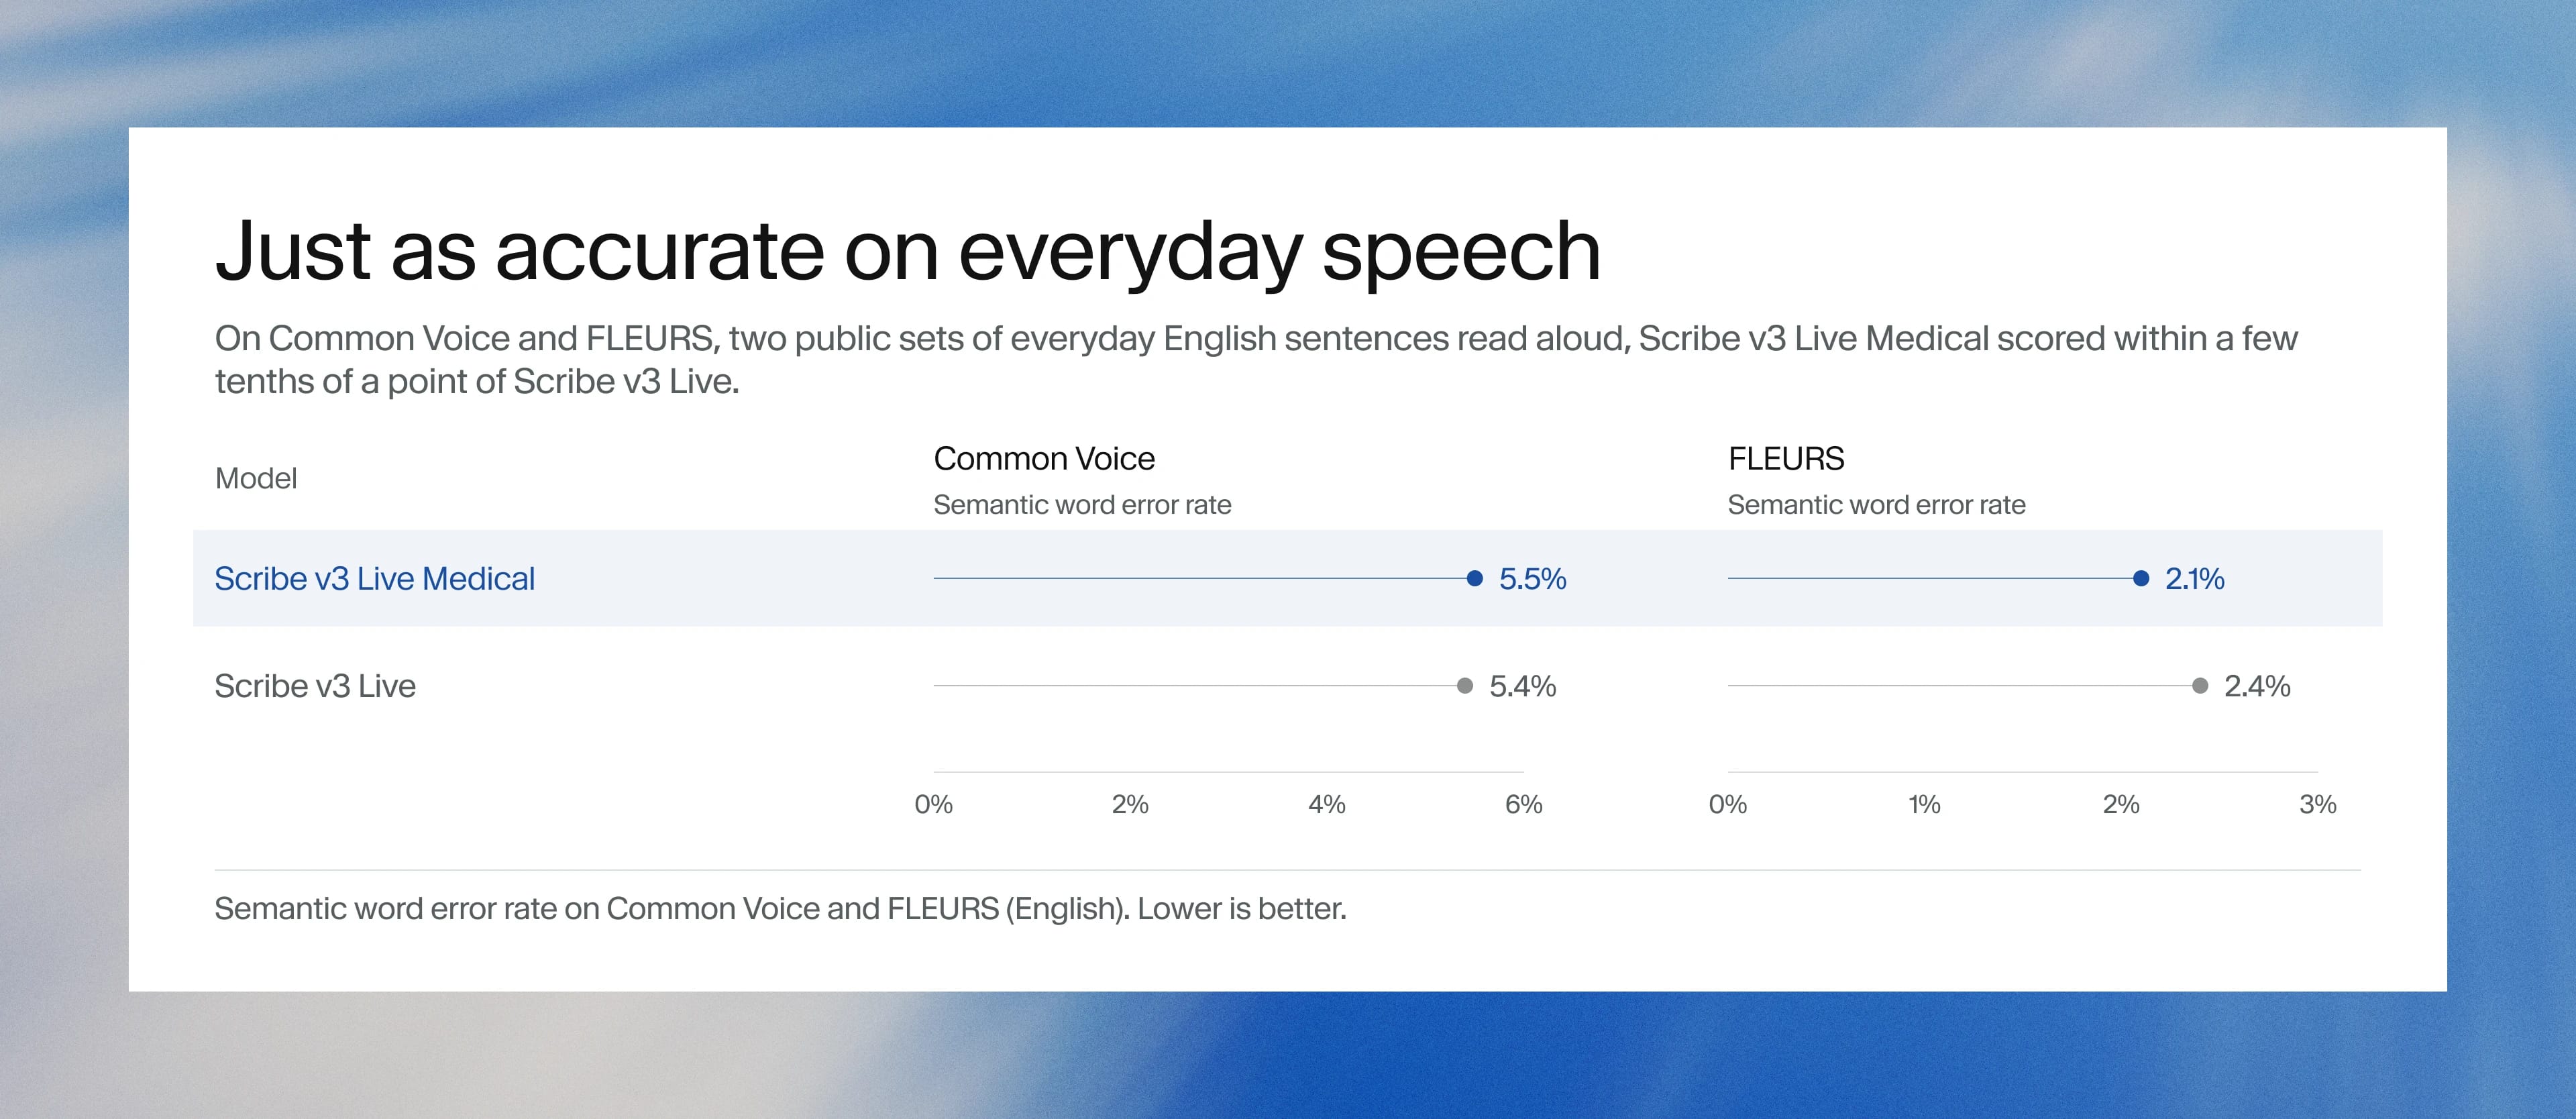
Common Voiceはボランティアが文章を読み上げたMozillaのデータセットで、FLEURSは100以上の言語で短い非臨床文を読み上げたGoogleのデータセットです。Scribe v3 Live Medicalを使用するチームが日常会話で精度を犠牲にしないことを確認するため、両方の英語データセットを評価しました。薬剤名を含む文章でも、その大部分は日常的な言葉で構成されているため、医療モデルには両方を正しく認識する必要があります。
Scribe v3 Live Medicalは、どちらのデータセットでもScribe v3 Liveとほぼ同等の性能を示しました。
言語別の医療精度(MED-Term)
多くの医療チームは、複数の言語を話す患者に対応しています。Cortiが公開しているベンチマークMED-Termは、希少で専門的な医療用語を中心に構成された臨床症例の音声説明を、英語、フランス語、ドイツ語で収録したデータセットです。Scribe v3 Live Medicalが英語以外の臨床用語にどの程度対応できるかを確認するために使用しました。意味的WERは、英語で2.24%、ドイツ語で2.81%、フランス語で3.24%でした。
言語
意味的WER(MED-Term)
英語
2.24%
ドイツ語
2.81%
フランス語
3.24%
ライブ通話での低レイテンシー
ライブ通話では、文字起こしが届くまでエージェントは応答できないため、文字起こしの遅延がそのまま発信者に聞こえる間になります。Scribe v3 Liveは約150ミリ秒で音声を文字起こしし、テストではScribe v3 Live Medicalも同等のレイテンシーを実現しました。臨床分野への特化による、体感できるほどの遅延はありません。
誤りの減少が医療チームにもたらす効果
誤り率は、実際の通話に置き換えると理解しやすくなります。10分間の受付通話では、発信者とエージェントの間で約1,500語が交わされます。上記のPriMock57の誤り率では、Scribe v3 Live Medicalは、テストした次に精度の高い医療モデルより約40語多く正しく認識します。1日1,000件の通話に対応するチームなら、毎日約40,000語多く正確に文字起こしできる計算です。ただし、すべての言葉が同じ重要性を持つわけではありません。「えーと」が抜けても問題はありません。しかし、薬剤名を聞き間違えると再処方依頼に誤った薬が記載され、加入者IDの数字を1つ間違えると受給資格確認が滞ります。どちらも、折り返し電話、スタッフへの転送、患者への聞き直しにつながる可能性があります。
医療情報の保護
医療エージェントは多くの通話で、氏名、生年月日、加入者ID、服用薬、症状などの保護対象保健情報(PHI)を扱います。Scribe v3 Live Medicalは、事業提携契約(BAA)を締結し、ゼロリテンションモードを有効にしているエンタープライズのお客様であれば、HIPAAに準拠して利用できます。
Scribe v3 Live MedicalはElevenAgents上で動作し、SOC 2 Type II、ISO 27001、PCI DSS Level 1などのコンプライアンスプログラムの対象です。患者データはデフォルトで米国内に保存されます。米国外での保存が必要なエンタープライズチームは、EU、インド、シンガポールの分離環境を利用できます。
利用を開始する
Scribe v3 Live Medicalは、ElevenAgentsで今すぐ利用できます。
「設定」>「自動音声認識」に移動し、モデルのドロップダウンから選択してください。
John is on the ElevenAgents growth team, with a focus on the healthcare industry.