AI-röstinfrastruktur: 2026 års stack förklarad
- Skriven av
- Jack Limebear
- Publicerad
LyssnaLyssna på den här artikeln
AI-röstinfrastruktur är uppsättningen modeller, anslutningar, verktyg och tjänster som gör att en AI-agent kan lyssna på ett samtal, avgöra vad den ska göra, agera i andra system och svara högt. Med ledande leverantörer som ElevenLabs sker allt detta på en bråkdel av en sekund.
En röstagent i produktion körs på en stack av lager som omfattar taligenkänning, turordning, en stor språkmodell, orkestrering, verktyg, kunskapshämtning, talsyntes, telefoni och övervakning.
Den här guiden förklarar AI-agentarkitekturen bakom en fungerande röstagent. Varje avsnitt beskriver vad ett lager gör, varför det är viktigt i den bredare infrastrukturen och hur ElevenAgents implementerar det, med Eleven v4 som exempel på röstlager.
Så hänger AI-röstinfrastrukturen ihop
En röstagent omvandlar ljud till text, resonerar utifrån inmatningen, skapar ett svar och omvandlar sedan svaret tillbaka till ljud som kunden hör. Den här kedjan av åtgärder bygger på en robust stack för AI-agentarkitektur.
Här är de viktigaste lagren som bidrar till AI-röstinfrastruktur 2026:
- Taligenkänning: Automatic Speech Recognition-teknik (ASR) omvandlar uppringarens ljud till text för bearbetning.
- Turordning: Turn taking avgör när uppringaren har pratat klart och när agenten ska sluta prata, vilket ger ett smidigare och mer responsivt samtal.
- Språkmodell(er): Tolkar den transkriberade förfrågan och genererar ett svar efter att ha hämtat nödvändig kontext.
- Orkestrering: Ett AI-orkestreringslager dirigerar samtalet mellan prompter, underagenter, verktyg och människor.
- Verktyg och MCP: Ansluter agenten till externa system, som CRM-plattformar eller kontaktcenter, för att utföra uppgifter.
- Kunskap och minne: Ger fakta och kontext om uppringaren via Retrieval Augmented Generation.
- Talsyntes: Använder Text to Speech för att omvandla det textgenererade svaret till ljud.
- Transport och telefoni: Överför ljud mellan agenten och uppringaren.
- Skyddsräcken, testning och övervakning: Håller agenten fokuserad och mätbar.
Tillsammans skapar dessa komponenter samtal i realtid mellan AI-agenter och uppringande kunder.
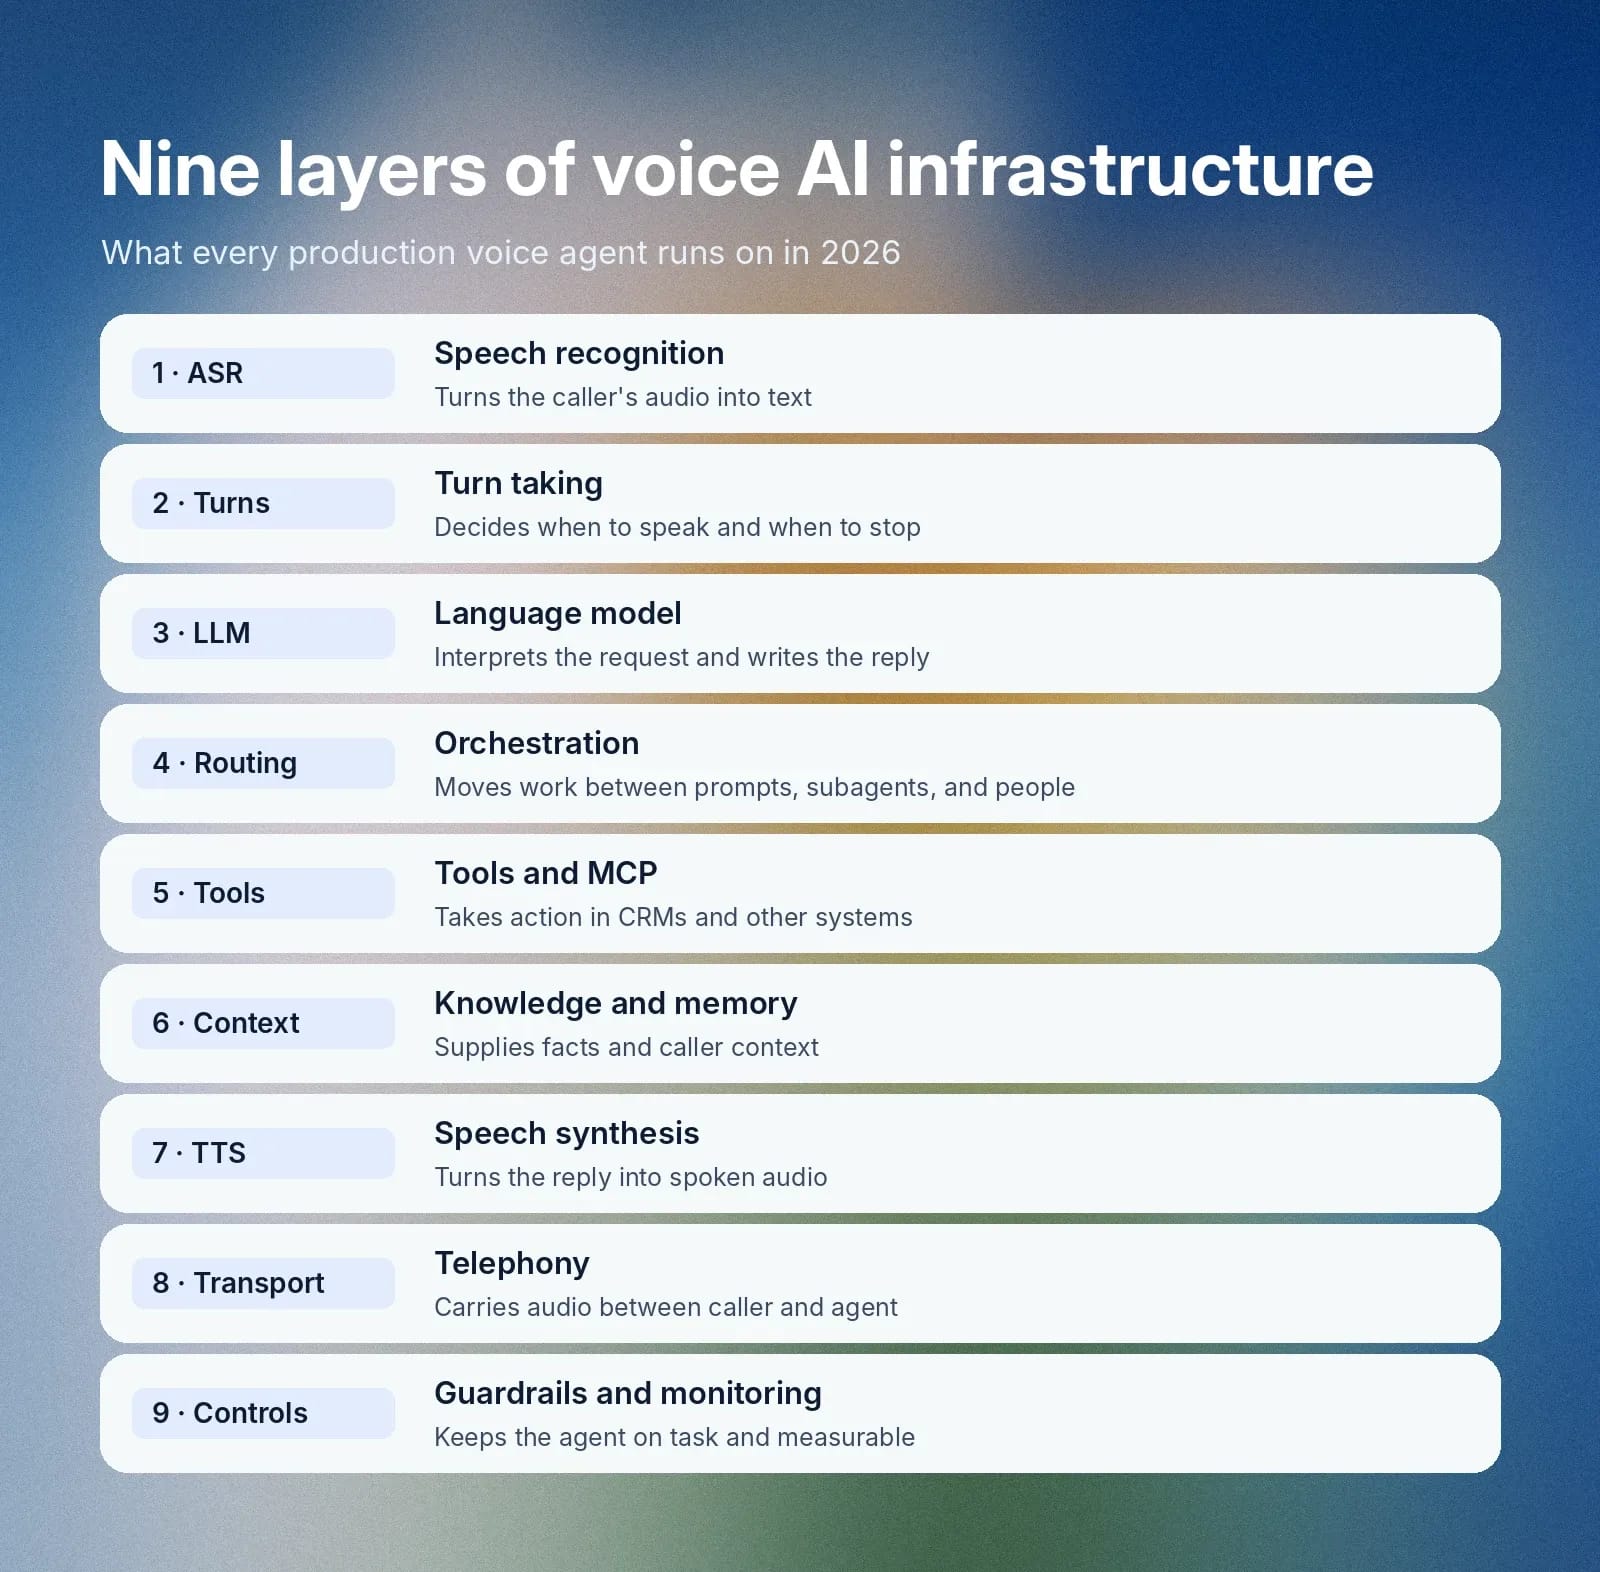
Diagram över AI-röstarkitektur
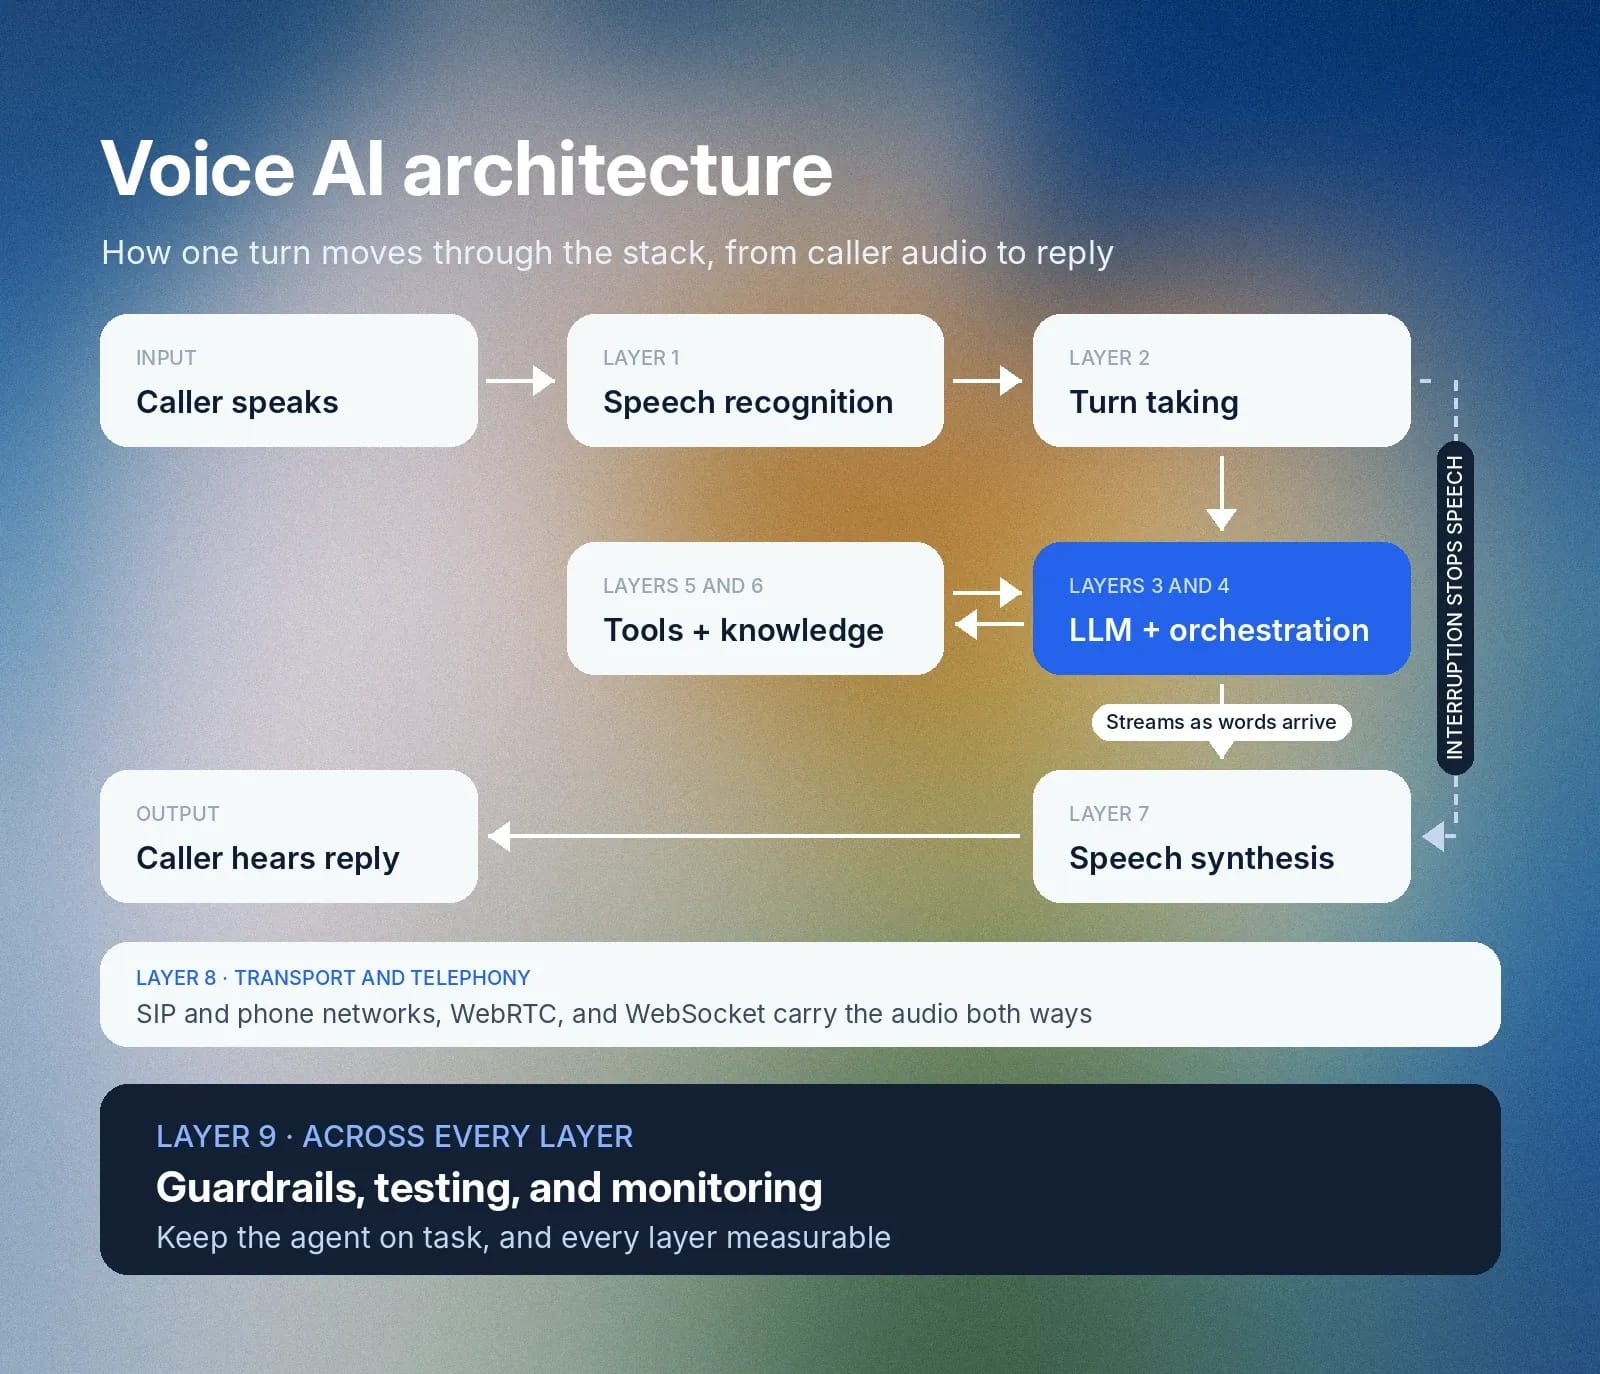
Flödet är inte en rak linje. ElevenAgents börjar prata när den får ”tillräckligt många ord och ett kommatecken” från språkmodellen, vilket innebär att ljudet börjar spelas upp innan hela svaret finns. Verktygsanrop och hämtning körs mitt i en tur. Avbrott kan komma in och hanteras naturligt av agenten medan den genererar tal.
Två sätt att bygga AI-röstarkitektur
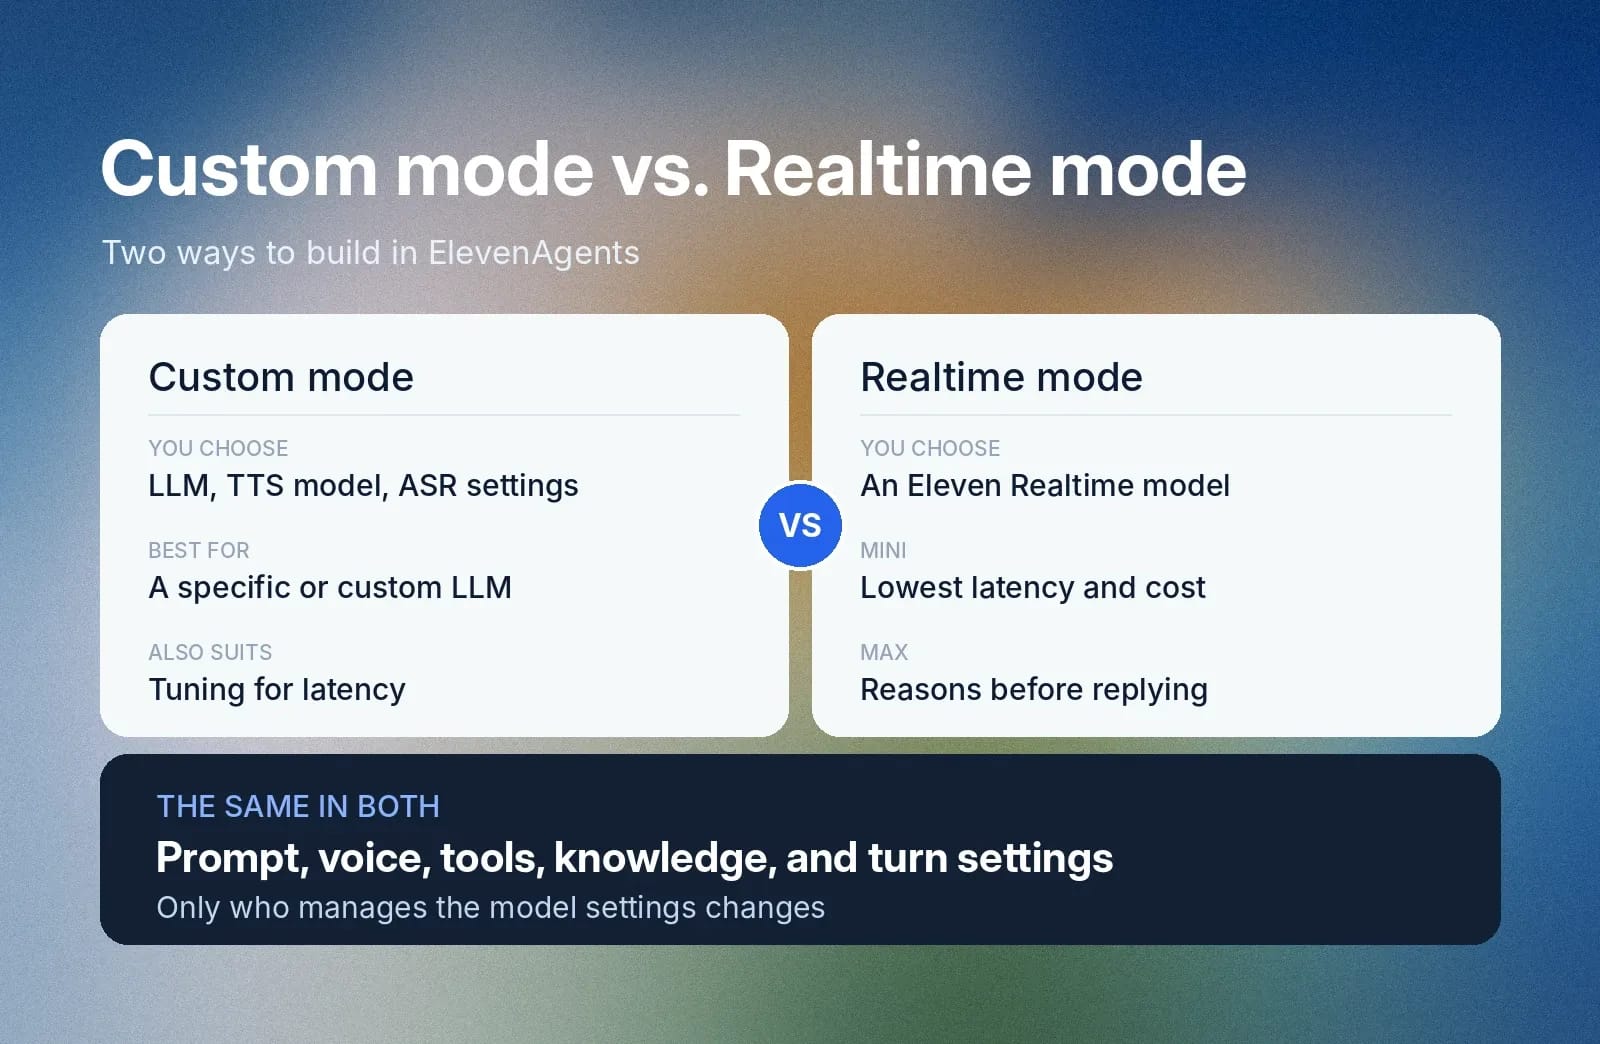
ElevenAgents stöder två röstlägen. I Custom-läget väljer du själv språkmodell, Text to Speech-modell och inställningar för taligenkänning.
I Realtime-läget väljer du en Eleven Realtime-modell, och ElevenLabs hanterar inställningarna åt dig. Eleven Realtime v1 Mini är standard och har lägst latens och kostnad. Eleven Realtime v1 Max resonerar innan den svarar, vilket passar mer komplexa instruktioner och fall där verktyg måste användas i flera steg.
Systemprompten, vald röst, verktyg, ansluten kunskapsbas och turinställningar fungerar på samma sätt i båda lägena. Custom-läget är bäst när du behöver en viss språkmodell, en anpassad LLM eller en specifik TTS-modell (för prestanda eller latensoptimering.)
Taligenkänning: Omvandla ljud till text
Taligenkänning, även kallat ASR eller speech to text, är stackens första lager.
Vad det gör
Modellen transkriberar kontinuerligt uppringarens ljud medan personen talar. Det gör att resten av pipelinen kan börja arbeta innan meningen är slut, vilket minskar latensen. Avancerade modeller hanterar allt från starka accenter och olika talhastigheter till bakgrundsljud.
Varför det är viktigt för AI-röstinfrastruktur
Transkribering är utan tvekan ett av stackens viktigaste lager, eftersom fel här sprids genom resten av stegen. Hör du fel bokningsreferens? Fel kundpost hanteras. Får du namnet på ett läkemedel fel? Potentiellt katastrofalt.
I sitt Trust Framework for Healthcare visar ElevenLabs hur höga insatserna blir med en enda felhörd stavelse: hydroxyzine kontra hydralazine.
Så gör ElevenAgents
ElevenAgents använder Scribe v2 Realtime, som transkriberar tal på cirka 150 ms. ElevenLabs tränade den för bullriga miljöer, olika accenter och identifierare som namn, e-postadresser och ID:n. I det flerspråkiga FLEURS-benchmarktestet för 30 språk rapporterade ElevenLabs den lägsta felfrekvensen för ord bland alla ASR-modeller med låg latens.
Du aktiverar den under Advanced i agentkonfigurationen. I samma vitbok som nämns ovan rapporterar ElevenLabs att Scribe v2 Medical leder alla modeller i det offentliga Eka Medical ASR-benchmarktestet med en felfrekvens för ord på 7,0 % vid publicering.
Korrekt (och snabb) transkribering ger nästa lager den rena indata de behöver utan att lägga till betydande latens.
Turordning: Att veta när man ska prata och när man ska sluta
Turordning är uppsättningen regler som avgör när agenten svarar och när den lyssnar. Förmågan att effektivt förstå turer i samtal och agera på dem är det som skiljer ett samtal från en traditionell IVR-telefonmeny.
Vad det gör
En komponent för turordning bidrar med flera funktioner till AI-röstinfrastrukturen:
- Röstaktivitetsdetektering (VAD): VAD klassificerar inkommande ljud som tal eller tystnad, flera dussin gånger per sekund.
- Identifiering av sluttur: Bedömer om uppringaren har pratat klart med hjälp av ton, rytm och ordkontext.
- Barge-in: Låter uppringaren avbryta, varpå agenten slutar prata så att användaren kan fortsätta.
- Backchannels: Korta bekräftelser som ”ja” som inte tar över turen.
Varför det är viktigt
Ett avbrott på omkring 200 ms är det typiska avbrottet mellan talare i ett mänskligt samtal. En agent som svarar för tidigt avbryter uppringaren, medan en som väntar för länge skapar tystnader som får samtalet att kännas trasigt eller oresponsivt.
Tänk till exempel på en uppringare som säger ”Jag vill boka fredag eftermiddag, men ...” och pausar. En tystnadstimer svarar vid pausen och missar förbehållet. En modell som läser orden och rytmen väntar och låter användaren avsluta: ”Det kan inte vara mellan 15 och 17, eftersom jag är upptagen.”
Den ena agenten misstolkar uppringarens avsikt och bokar mötet vid fel tid. Den andra, med effektiv turordningsförmåga, undviker den angivna tidsperioden.
Så gör ElevenAgents
ElevenAgents kör en egenutvecklad modell för turordning som analyserar ton, rytm och ordkontext i stället för att enbart förlita sig på tystnadstimrar. När en uppringare avbryter når signalen som stoppar agenten fram på under 200 ms.
ElevenLabs mäter en median på cirka 150 ms från begäran till hörbart tal med Eleven v4 Turbo i ElevenAgents.
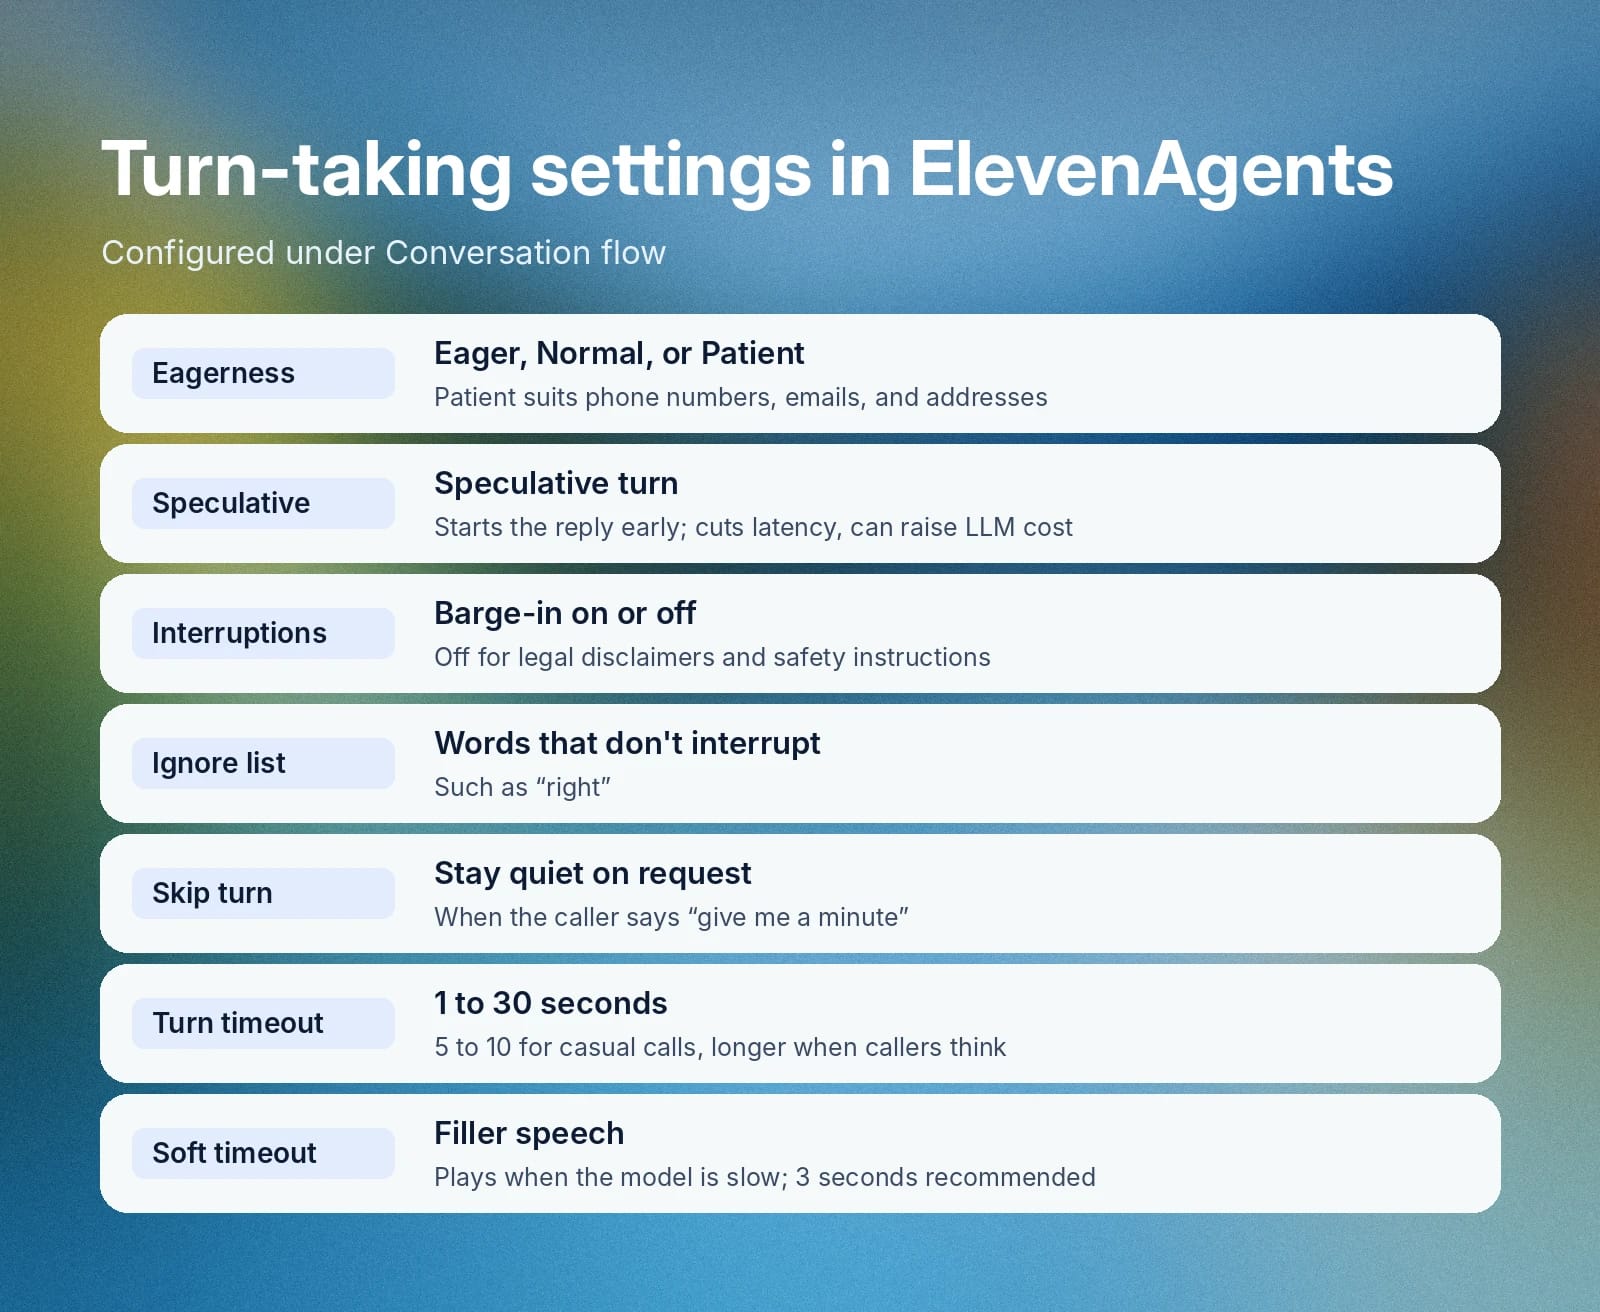
Beteendet kan konfigureras via Conversation flow:
Inställning
Vad den styr
Svarsvillighet
Eager svarar vid första möjliga tillfälle. Normal är det balanserade standardläget. Patient väntar längre och passar telefonnummer, adresser och e-postadresser.
Spekulativ tur
Startar språkmodellens svar innan det bekräftats att uppringaren pratat klart. Det minskar latensen men kan öka LLM-kostnaden.
Avbrott
Stäng av dem när varje ord måste höras, till exempel juridiska friskrivningar och säkerhetsinstruktioner.
Ignoreringslista
Ord som ”precis” som inte ska avbryta agenten.
Verktyg för att hoppa över tur
Håller agenten tyst när uppringaren säger ”ge mig en minut”.
Tidsgräns för tur
Tar en tur efter 1–30 sekunders tystnad. Använd 5–10 sekunder för vardagliga samtal och 10–30 när uppringare behöver tid att tänka.
Mjuk tidsgräns
Spelar utfyllnadstal som ”Hhmmmm ... ja.” när modellen är långsam. Intervallet är 0,5–8 sekunder, och 3 sekunder rekommenderas.
Identifiering av bullrig miljö
En Enterprise-inställning som upptäcker röster i bakgrunden och ber uppringaren att gå till en tystare plats, högst en gång per samtal.
Workflows kan ändra svarsvilligheten mitt i samtalet. Din klient får också händelsen vad_score, en sannolikhet mellan 0 och 1 för att användaren talar.
Väljusterad turordning avgör om uppringare upplever agenten som uppmärksam eller abrupt. Läs vår kompletta guide om turordning för mer om koncepten.
Språkmodellen: Resonera och generera svaret
Den stora språkmodellen (LLM) är resonemangslagret. Den läser transkriberingen, instruktionerna och samtalet hittills, och skriver sedan svaret eller beslutar att anropa ett verktyg.
Vad det gör
En skriptad röstbot känner igen en handfull kommandon. En LLM tolkar förfrågningar som uttrycks på många olika sätt, behåller kontext mellan turer och avgör när den ska hämta information eller lämna över.
Varför det är viktigt
Modeller skiljer sig åt i resonemangsdjup, hastighet och kostnad. I ett röstsamtal i realtid är svarstiden lika viktig som svarskvaliteten, så modellvalet är både ett latens- och kostnadsbeslut.
Så gör ElevenAgents
ElevenAgents ger dig ett gränssnitt för modeller från Google, OpenAI och Anthropic samt öppna modeller som driftas av ElevenLabs. Du kan också ansluta en egen LLM genom att ange en endpoint och lagra autentiseringsuppgifter som hemligheter. ElevenLabs vidarebefordrar kostnader för tredjeparts-LLM:er till leverantörens publicerade pris utan påslag.
Du kan välja modell per underagent. The Enterprise Conversational Agent Playbook, volym 2, rekommenderar att reservera högpresterande modeller för komplexa resonemang och använda billigare modeller med låg latens för uppgifter som avsiktsklassificering och vanliga frågor.
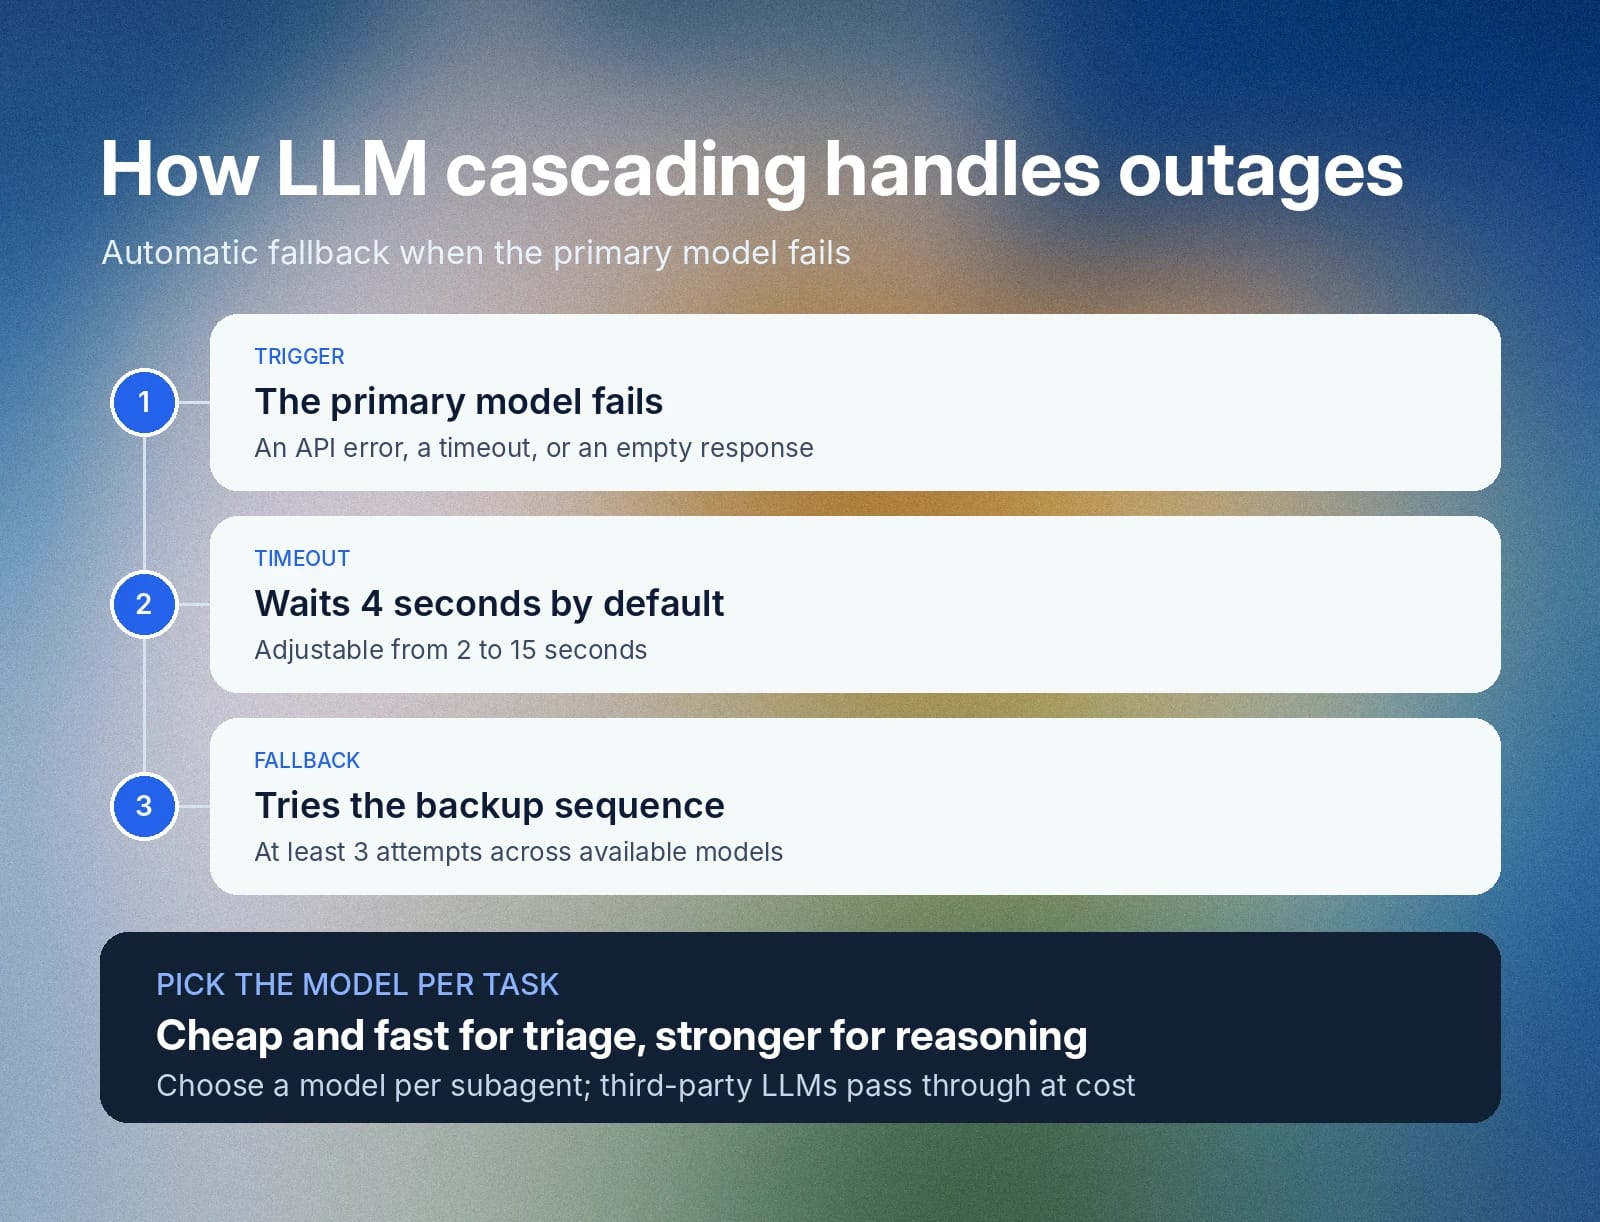
Leverantörer kan få driftstörningar. LLM-kaskadering hanterar dem: om primärmodellen returnerar ett API-fel, får timeout eller skickar ett tomt svar provar ElevenAgents en reservsekvens. Standardtiden från primär till reserv är 4 sekunder, justerbar från 2 till 15 sekunder, och systemet gör minst 3 försök mellan tillgängliga modeller.
En anpassad LLM som används som primärmodell försöker igen minst 3 gånger, om du inte definierar en egen reservordning. Rätt modell för varje uppgift håller agenten både snabb och prisvärd.
Orkestrering: Dirigera arbete mellan agenter och människor
Agentorkestrering samordnar prompter, underagenter, verktyg och människor som deltar i att slutföra en uppgift. Den avgör vad som händer härnäst vid varje punkt i samtalet.
Vad det gör
En agent med en lång prompt blir svår att hantera när ansvarsområdena växer. Orkestrering delar upp arbetet i steg, vart och ett med egna instruktioner, modell och verktyg, och flyttar uppringaren mellan dem.
Varför det är viktigt
Mindre prompter är enklare att testa och billigare att köra, eftersom varje interaktion laddar mindre text. Genom att dela upp ett flöde kan en billig modell hantera triage och vanliga frågor, och bara lämna över till en starkare modell när en förfrågan kräver det.
Så gör ElevenAgents
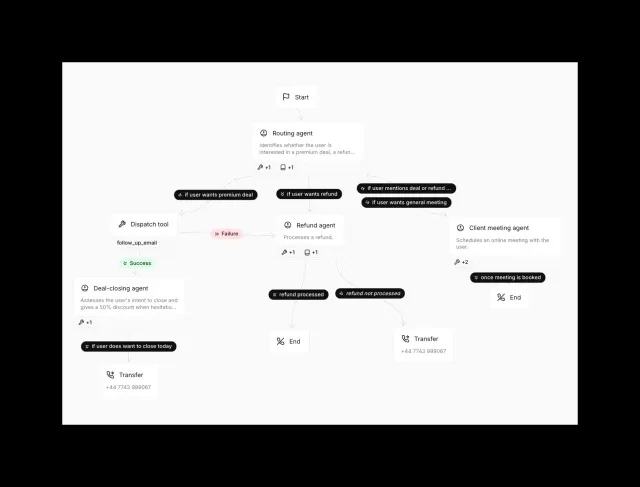
Workflows i ElevenAgents är en visuell byggare för förgrenade samtalsdiagram.
Noderna är:
- Underagent: Ändrar eller åsidosätter basagenten, inklusive prompt, LLM, röst, verktyg och kunskapsbas.
- Say: Säger ett meddelande, antingen ordagrann text eller en rad som genererats av en LLM.
- Dispatch tool: Ett särskilt steg som garanterar ett verktygsanrop, med separata vägar för lyckat och misslyckat resultat.
- Update state: Tilldelar dynamiska variabler medan flödet passerar igenom.
- Agent transfer: Lämnar över samtalet till en annan agent.
- Transfer to number: Flyttar samtalet från AI-agenten till en människa via telefonsystemet.
- End call: Avslutar samtalet.
Kanter mellan noder har villkor i naturligt språk som LLM:en utvärderar i realtid. Ett supportflöde kan börja med en dirigerande underagent på en snabb modell, skicka faktureringsfrågor till en faktureringsunderagent på en starkare modell och avsluta med en Transfer to number-nod när uppringaren ber om en person. Efter lansering visar Workflow-fliken i analysen poster, genomsnittlig tid, avslut och kantfördelning för varje nod.
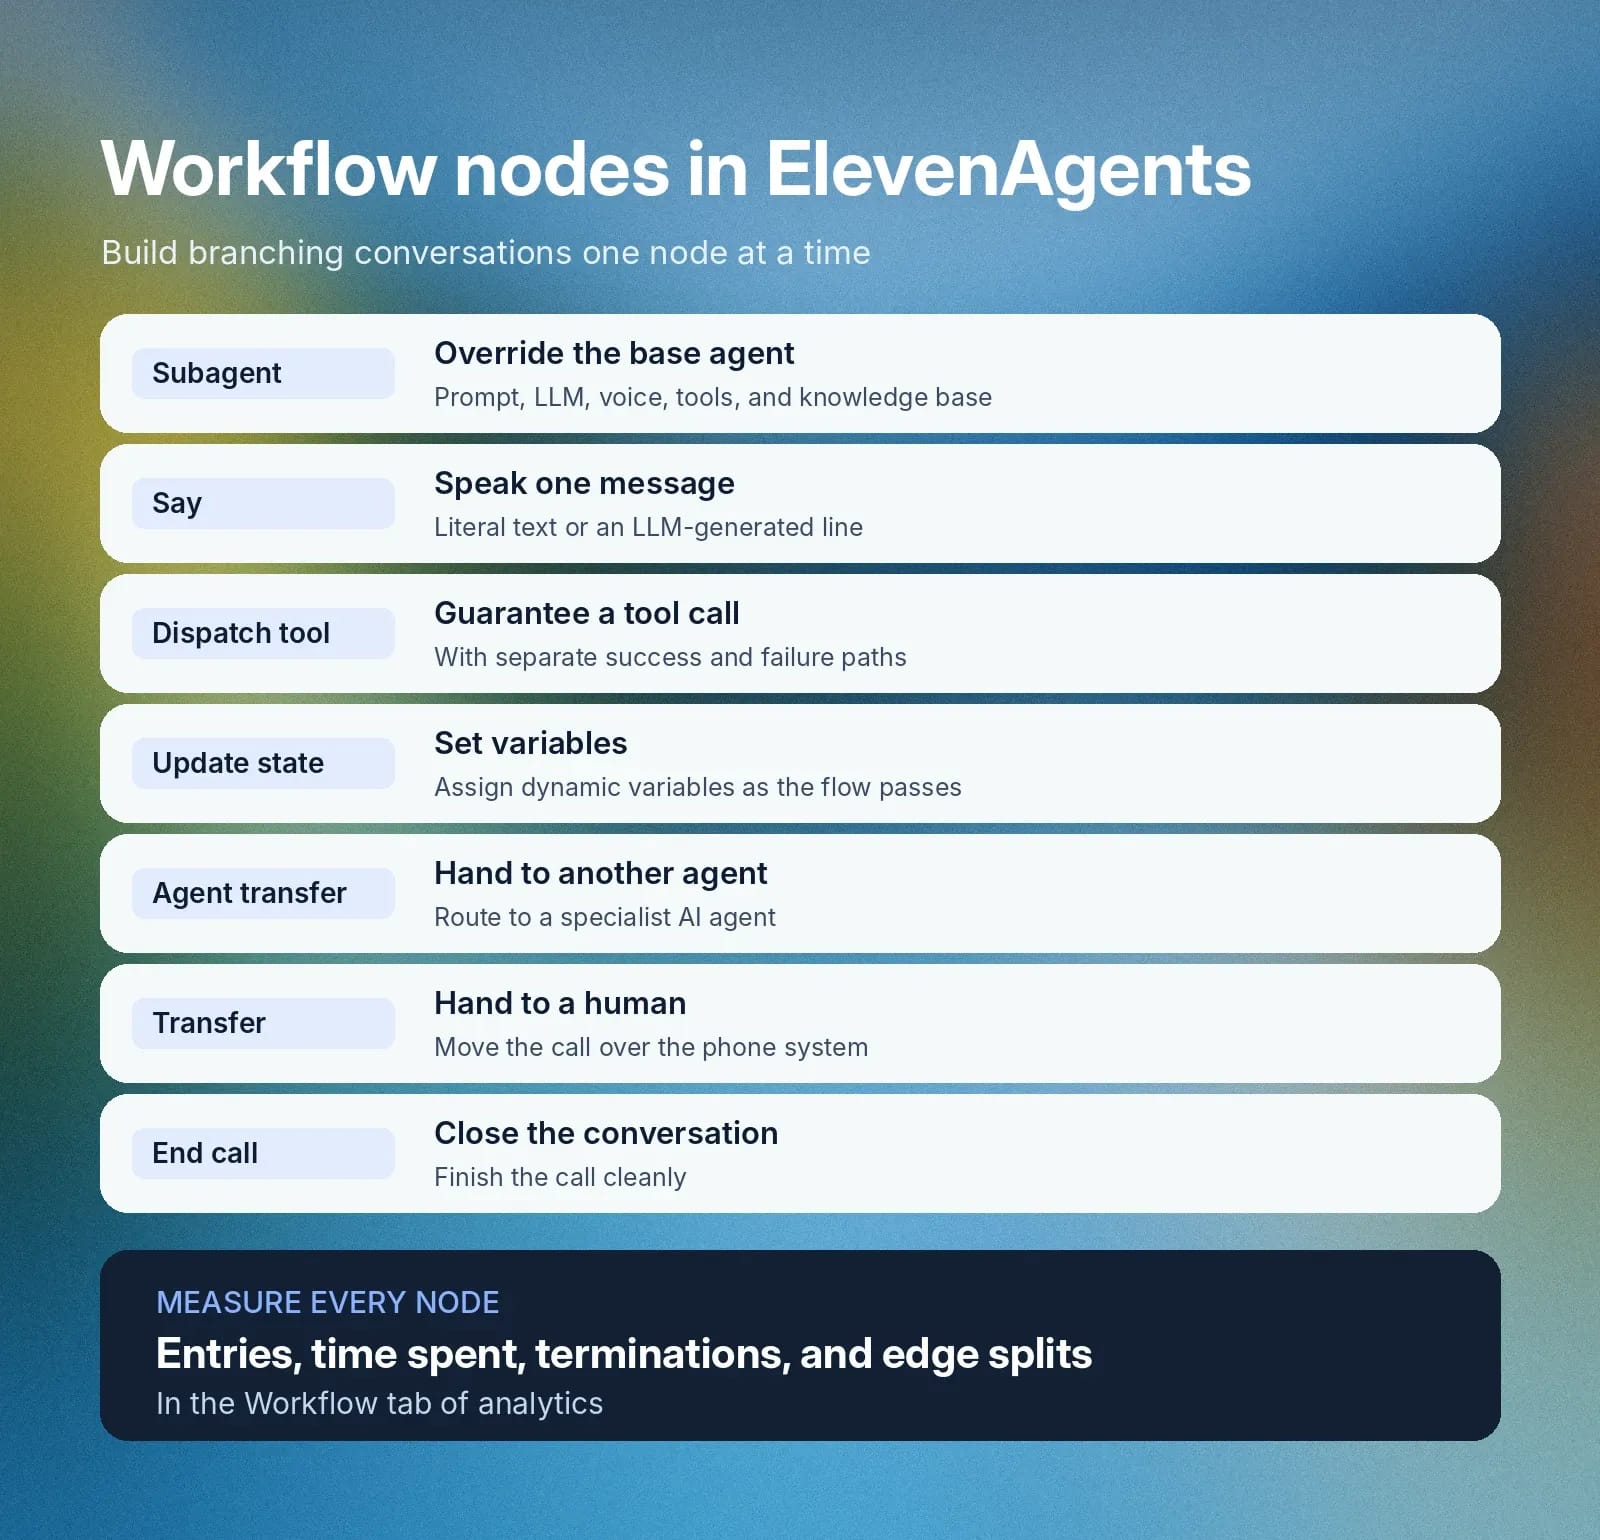
Orkestrering förvandlar en enskild agent till ett system som du kan utforma, mäta och förbättra en nod i taget.
Verktyg och MCP: Låt agenten agera
Funktionsanrop, även kallat verktygsanrop, låter en agent begära åtgärder från extern programvara som du har anslutit till din teknikstack.
Det förvandlar ett gränssnitt för frågesvar till ett agentiskt AI-system som kan slutföra arbete och interagera med andra verktyg åt dig.
Vad det gör
Ta en uppringare som vill flytta morgondagens bokning till fredag. Agenten hämtar bokningen, kontrollerar tillgängligheten på fredag, uppdaterar bokningssystemet och bekräftar ändringen. Varje steg är ett verktygsanrop som utför en åtgärd.
Varför det är viktigt
Det är genom verktyg som samtal ger resultat. Varje verktyg behöver tydliga in- och utdata, och agenten behöver veta om ett anrop lyckades innan den säger det till uppringaren.
Så gör ElevenAgents
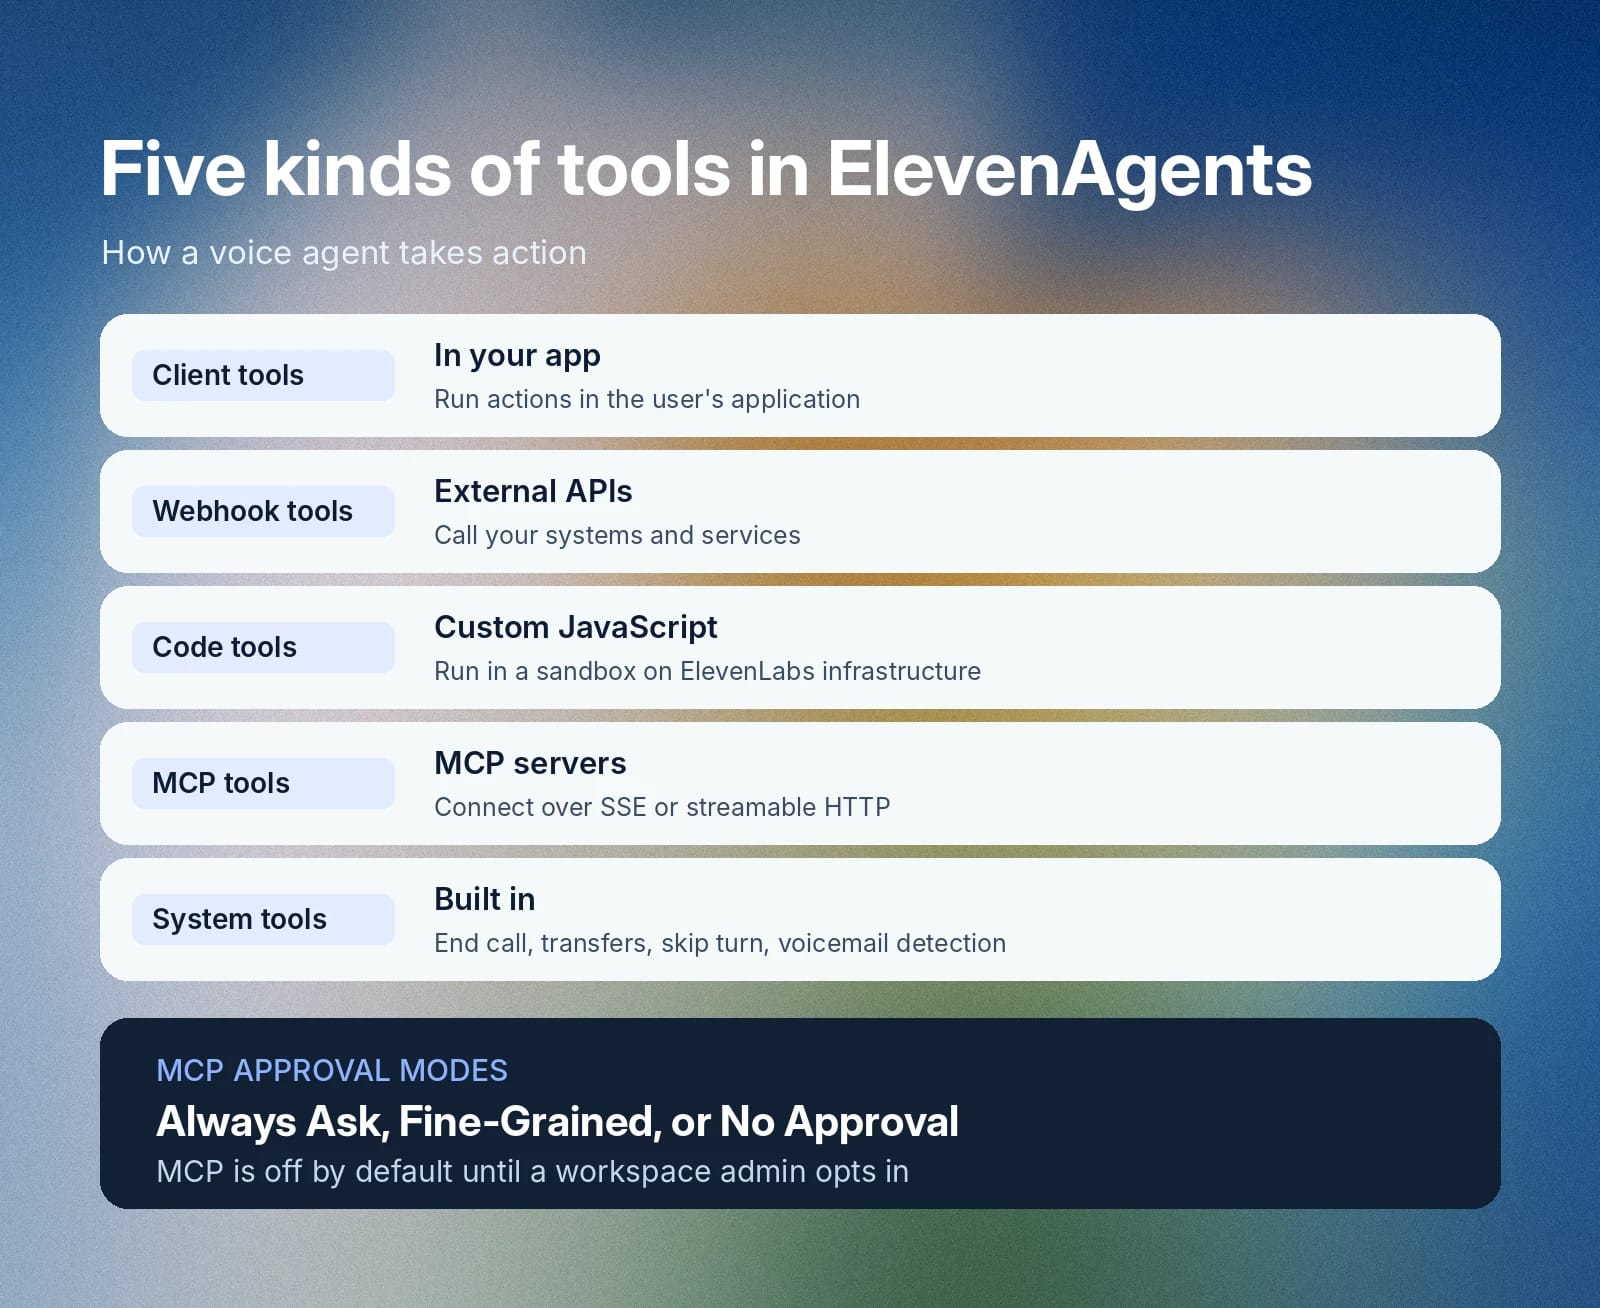
ElevenAgents stöder klientverktyg som körs i användarens applikation, webhookverktyg som anropar externa API:er, kodverktyg som kör anpassad JavaScript i en sandbox på ElevenLabs infrastruktur, MCP-verktyg och inbyggda systemverktyg.
Systemverktygen omfattar avsluta samtal, språkidentifiering, agentöverföring, överföring till nummer, hoppa över tur, spela knappsatsston och röstmeddelandeidentifiering. Du kan lägga till bakgrundsljud medan ett verktyg körs och styra om uppringare kan avbryta under körningen.
Model Context Protocol (MCP) är en öppen standard för hur applikationer ger språkmodeller kontext och verktyg. ElevenAgents ansluter till MCP-servrar via SSE och streambar HTTP. Workspace-administratörer måste först aktivera det, eftersom MCP är inaktiverat som standard för varje workspace. Sedan väljer du ett godkännandeläge för varje server: Always Ask, Fine-Grained Tool Approval eller No Approval.
Klienthändelser som client_tool_call och mcp_tool_call rapporterar verktygsaktivitet, och MCP-händelser rapporterar fyra tillstånd: laddar, väntar på godkännande, lyckades och misslyckades. Tillförlitliga verktyg ger agenten räckvidd i verkligheten, och tydliga godkännanderegler håller räckvidden under kontroll.
Kunskap och minne: Fakta och kontext om uppringaren
Retrieval-augmented generation (RAG) ger agenten fakta från ditt eget innehåll, exempelvis en intern faktadatabas eller en bredare historik över kunder. Minne och personalisering ger kontext om uppringaren, så att agenten kan öka personaliseringen och nyttan för ditt företag.
Vad det gör
En språkmodell har ett träningsstopp och saknar åtkomst till din dokumentation och dina register. RAG söker i en kunskapsbas för varje fråga, hämtar de mest relevanta avsnitten och ger dem till modellen för att tillföra den extra kontext som krävs för ett användbart svar.
Personaliseringsdata berättar för agenten vem som ringer och vad som är relevant för personen.
Varför det är viktigt
Att förankra svar i godkänt innehåll håller dem korrekta. Hämtningshastigheten är också viktig, eftersom varje millisekund som tillkommer är ytterligare en som dina kunder får vänta. Personaliseringsfunktioner gör också att uppringare slipper upprepa information i olika samtal, eftersom agenterna har CRM-posterna till hands vid början av varje ny session.
Så gör ElevenAgents
Du lägger till dokument i kunskapsbasen som filer (PDF, DOCX, TXT, MD, HTML eller EPUB, upp till 20 MB vardera), URL:er eller inklistrad text. Ett dokument använder fullständig kontext när den extraherade texten ryms i prompten, upp till ungefär 300 000 tecken. Större dokument använder RAG. Hämtning kan köras vid varje tur eller vid behov, och standardläget Auto använder RAG när det är aktiverat och dokumentet är indexerat.
ElevenLabs arbetar direkt med hämtningshastighet. I teknikartikeln How we reduced RAG latency dokumenteras en sänkning av medianlatensen för RAG från 326 ms till 155 ms med modeller som driftas internt på infrastruktur som ElevenLabs redan använder.
För kontext om uppringaren använder ElevenAgents dynamiska variabler skrivna som {{ var_name }}, som fyller meddelanden, systemprompter och verktyg. För inkommande samtal via Twilio, SIP-trunk, WhatsApp och SMS kan ElevenAgents hämta startdata från din server innan samtalet börjar. Din server letar upp uppringaren med caller_id och returnerar variablerna, till exempel från ditt CRM, med ett svar på upp till 256 KB. Efter samtalet levererar webhooks efter samtalet utvärderingsresultat och extraherade data till dina externa system.
Tillsammans ger hämtning och personalisering agenten både rätt fakta och rätt kontext om uppringaren.
Talsyntes: Ge agenten en röst
Text to Speech (TTS) omvandlar språkmodellens svar till talat ljud. Det är lagret som uppringaren faktiskt hör.
Vad det gör
Modellen omvandlar text till ljud med naturligt tempo och känslomässig leverans. I ett livesamtal strömmar den ljudet i delar så att uppspelningen startar innan hela svaret har genererats.
Varför det är viktigt
Både latens och leverans påverkar hur uppringare bedömer samtalet. Två siffror är viktiga för realtidsarbete: tiden för att generera ljud och tiden innan uppringaren hör det första ljudet. Namn, läkemedelsnamn och tekniska termer behöver också uttalas korrekt, annars tappar uppringaren förtroendet för agenten.
Så driver Eleven v4 röstlagret
Eleven v4 är ElevenLabs mest känslomässiga Text to Speech-modell hittills, byggd på en helt ny arkitektur. Eleven v4 Turbo är varianten med låg latens för realtidsanvändning, till exempel agenter, och är optimerad tillsammans med ElevenAgents som ett system.
Eleven v4 Turbo
Värde
Medianlatens för inferens
Cirka 100 ms
Mediantid till första tal
Cirka 150 ms
Språk
90+
ElevenLabs mätte latenssiffrorna i september 2026 med WebSocket-streaming, utan nätverkslatens. Eleven v4 placerade sig etta på Artificial Analysis Provider Voice Arena Leaderboard i september 2026*, och omkring 75 % av lyssnarna föredrog den i blindtester**.
* Artificial Analysis, Provider Voice Arena Leaderboard, sep. 2026
** Baserat på jämförande tester av användarpreferenser mot Cartesia Sonic 3.6, Inworld TTS-2, Google Gemini 3.8 Flash-Lite TTS och Google Gemini 3.8 Flash TTS.
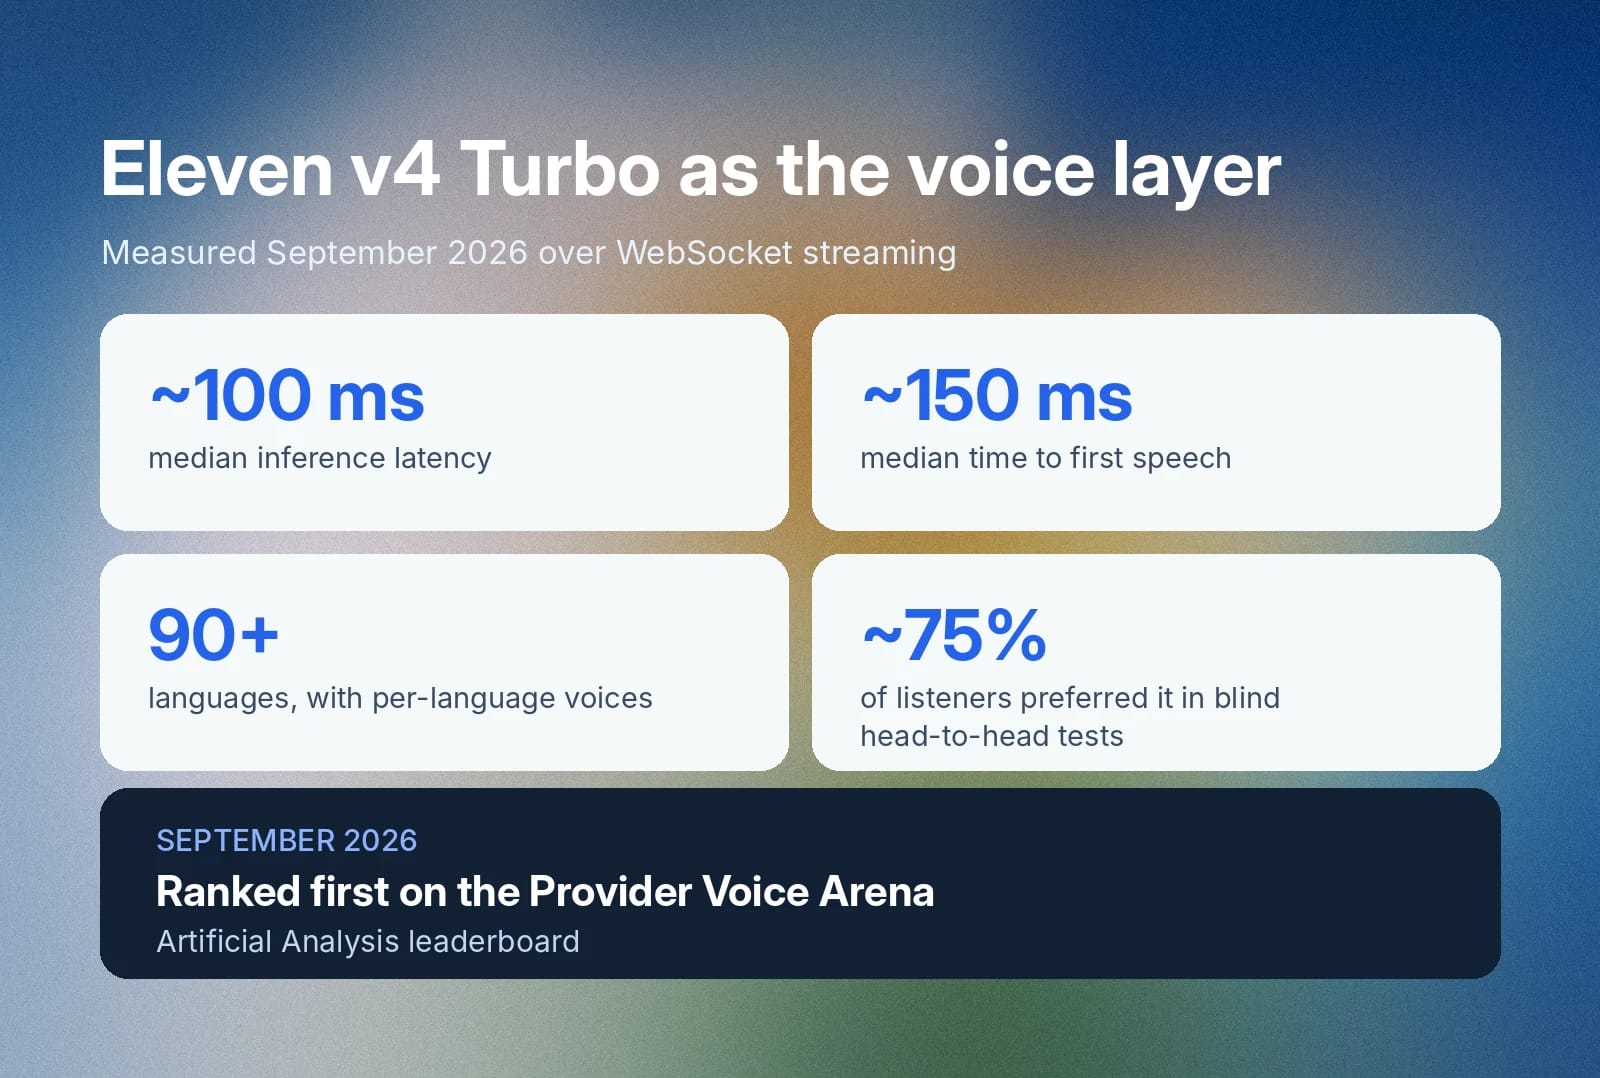
Eleven v4 stöder infogade ljudtaggar som [laughs] för leverans och IPA-stöd för fonem för uttal. I vårdagenter omfattar uttalskontrollen medicinska termer. ElevenAgents lägger till kontroller på agentnivå ovanpå detta. Stöd för flera röster låter en agent växla mellan röster i samtal med flera karaktärer. Hastigheten varierar från 0,7x till 1,2x. Varje ytterligare språk kan använda sin egen röst. Uttalslexikon använder IPA- eller CMU-notation för specifika ord.
Ett snabbt första ljud och en korrekt, uttrycksfull röst får agenten att kännas som en samtalspartner.
Telefoni och transport: Anslut agenten till uppringare
Transportlagret överför ljud mellan uppringaren och agenten. Beroende på vilken telefonikanal du använder varierar de integrationer du behöver i din AI-röstinfrastruktur.
Vad det gör
Telefonsamtal går via ett telefonnät och SIP, medan samtal i webbläsare och appar går via WebRTC eller WebSocket. En widget för webbplatsen paketerar webbläsaranslutningen i ett färdigt gränssnitt.
Varför det är viktigt
Varje kanal har olika konfigurationsbehov och ljudbegränsningar, så bestäm dina kanaler tidigt. En telefonfokuserad driftsättning behöver trunking och nummerhantering. En produktdriftsättning behöver en SDK.
Så gör ElevenAgents
- SIP-trunking: Ansluter ditt telefonsystem direkt till ElevenLabs, för inkommande och utgående samtal. Det fungerar med Twilio, Vonage, Sinch, Infobip, Telnyx och andra standardleverantörer. Signalering körs över TCP på port 5060 eller TLS 1.2 eller senare på port 5061, och ljudet använder G.711 eller G.722. Planera för minst 100 Kbps per samtal. Gränser för samtidiga samtal följer din prenumerationsnivå och uppringare väntar när samtalskö är aktiverad.
- Inbyggd Twilio-integration: Importera ett köpt Twilio-nummer för inkommande och utgående samtal. Verifierade nummerpresentatörer fungerar bara för utgående samtal.
- Batchsamtal: Ladda upp en CSV- eller XLS-lista med mottagare, så blir varje extra kolumn en dynamisk variabel. Du kan köra direkt eller schemalägga en start. Batchar använder det lägsta av 50 % av ditt workspaces samtidighetsgräns eller 70 % av agentens samtidighetsgräns, vilket lämnar kapacitet för inkommande samtal.
- WebRTC och WebSocket: SDK:erna använder som standard WebRTC för röst och WebSocket för samtal med enbart text. Privata agenter autentiseras med en signerad URL eller en samtalstoken som skapas på din server. WebSocket-endpointen är wss://api.elevenlabs.io/v1/convai/conversation.
- SDK:er: Python, JavaScript, React, React Native, Swift, Kotlin och Unity.
- Widget: Lägg till elementet <elevenlabs-convai> på en sida. Det stöder enbart röst, röst plus text och chattlägen, och agenten kan visa snabbsvar och karuseller.
En agent kan hantera telefon, webb, WhatsApp, SMS och e-post, vilket gör att team kan bygga en gång och driftsätta över flera kanaler.
Skyddsräcken: Håll agenten fokuserad
Skyddsräcken är kontroller som håller en agents beteende inom definierade gränser. De fungerar tillsammans med förankring, eftersom ett skyddsräcke begränsar vad en agent säger utan att göra fakta bakom det korrekta. Skyddsräcken körs parallellt med agentsamtal och bidrar till att hålla dina AI-agentsamtal kompatibla och korrekta.
Vad det gör
ElevenAgents tillämpar skyddsräcken på tre nivåer. Systemprompten anger tillåtet och otillåtet beteende, helst under rubriken # Guardrails. Validering av användarindata granskar meddelanden för promptinjektion. Svarsvalidering kontrollerar varje svar före leverans.
Varför det är viktigt
En agent som glider från ämnet eller hittar på en policy urholkar snabbt förtroendet. En kundsupportagent bör hämta återbetalningspolicyn från en godkänd källa innan den svarar, och ett skyddsräcke upprätthåller den gränsen.
Så gör ElevenAgents
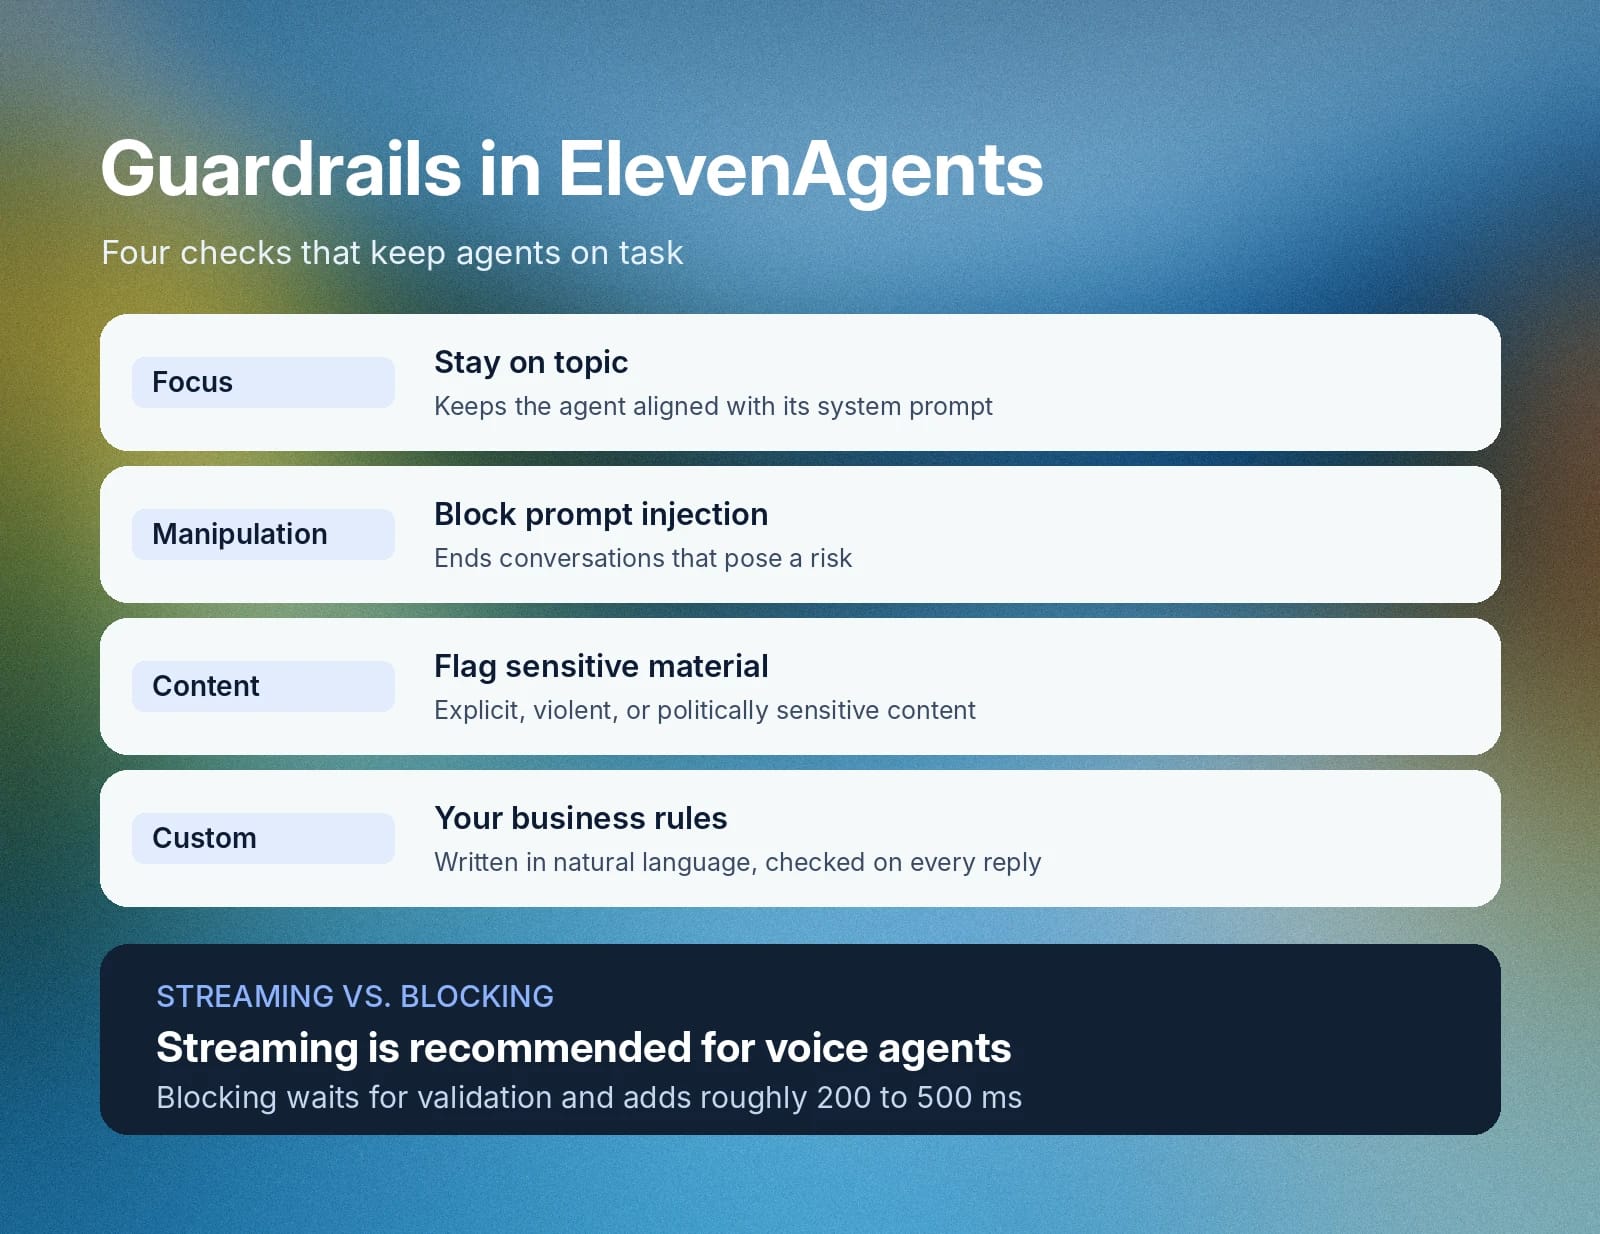
ElevenAgents introducerade Guardrails 2.0 i september 2026. Här är några av de konfigurationer i det nya systemet som hjälper skyddsräcken att fungera effektivt:
- Fokus: Håller agenten till ämnet och i linje med systemprompten.
- Manipulation: Upptäcker promptinjektion och avslutar samtal som utgör en risk.
- Innehåll: Flaggar kategorier som sexuellt explicit, våldsamt eller politiskt känsligt material.
- Anpassat: Affärsregler du skriver i naturligt språk, som utvärderas vid varje svar.
Körningsläge avgör avvägningen för latens. Streamingläget låter svaret börja innan kontrollen är klar, så mindre än 500 ms ljud kan spelas innan en blockering avslutar samtalet, och ElevenLabs rekommenderar det för röstagenter. Blocking-läget väntar på validering och lägger till cirka 200–500 ms.
När ett anpassat skyddsräcke utlöses avslutar åtgärden antingen samtalet eller försöker svaret igen upp till tre gånger med feedback som du skriver. Din klient kan lyssna efter händelsen guardrail_triggered.
Skyddsräcken i lager med en vald latensprofil gör beteendet förutsägbart utan att sakta ned varje svar.
Testning och experiment: Bevisa att agenten fungerar
Testning kontrollerar en agent före lansering. Experiment kontrollerar ändringar mot live-trafik efter lansering.
Vad det gör
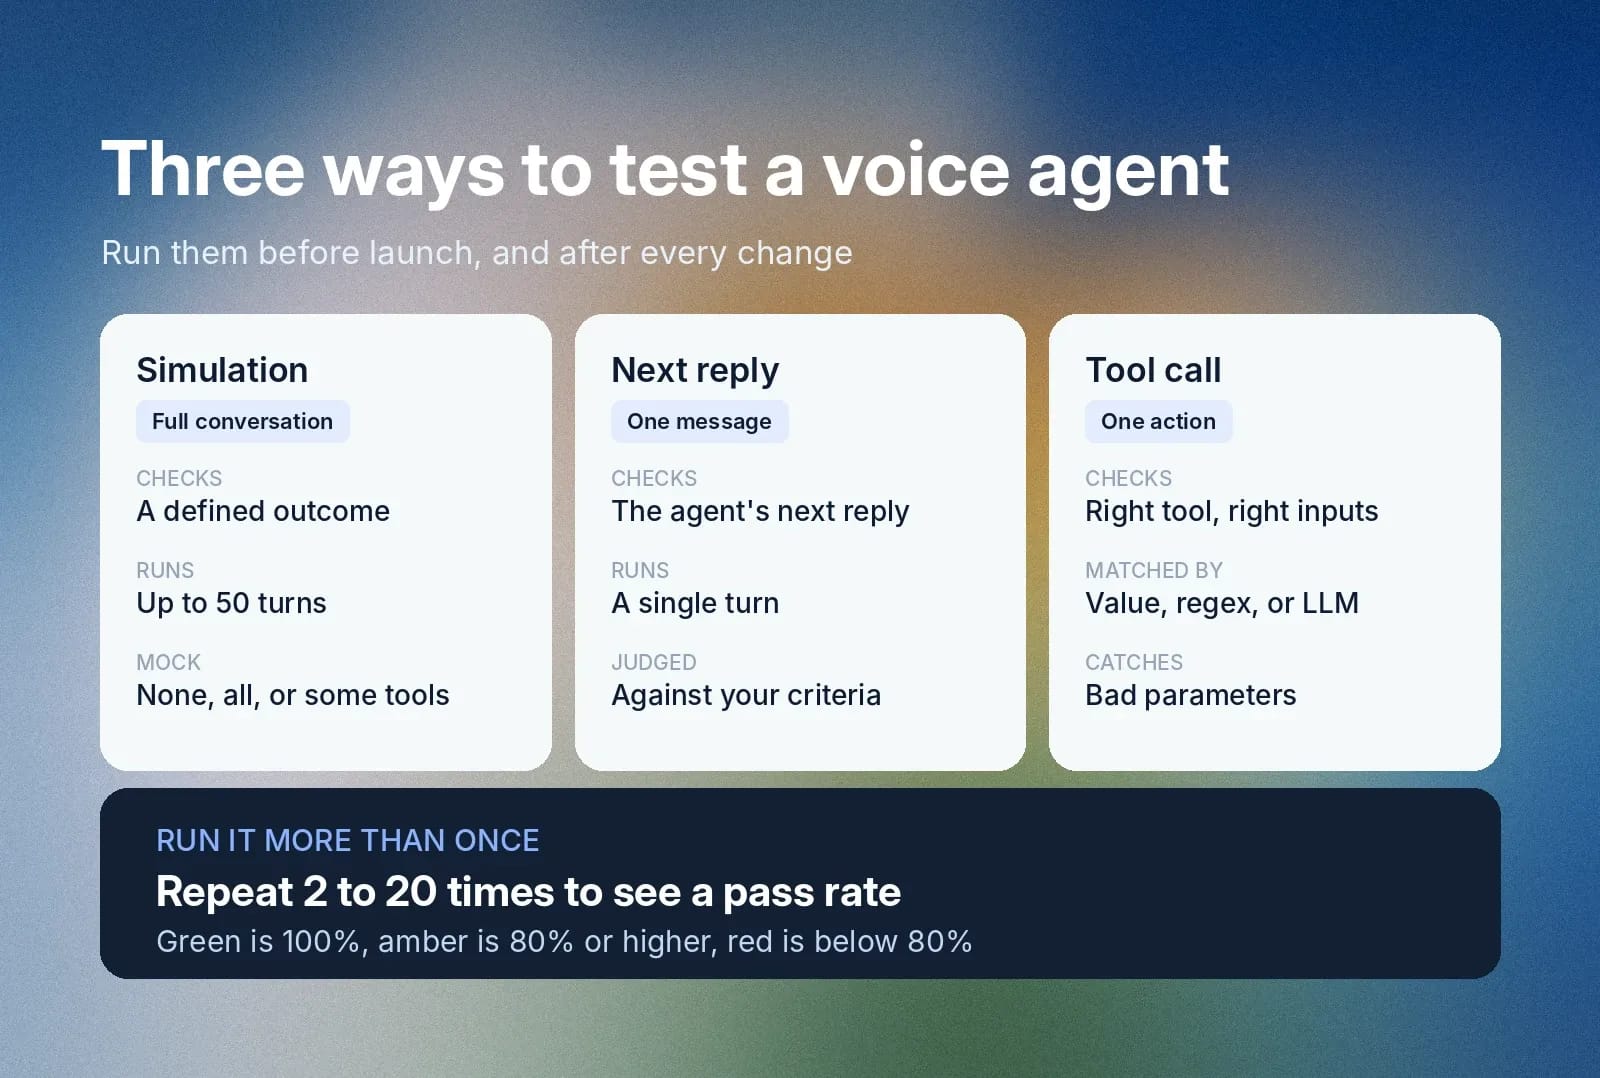
ElevenAgents har tre typer av agenttester. Simulation kör ett helt samtal mot en simulerad användare och kontrollerar om det når ett definierat resultat, med upp till 50 turer (standard är 5). Next Reply-tester bedömer bara agentens nästa meddelande mot dina kriterier. Tool Call-tester verifierar att agenten använder rätt verktyg med rätt parametrar, matchade med exakt värde, regex eller LLM-utvärdering. I simuleringar kan du mocka inga verktyg, alla verktyg eller utvalda verktyg.
Varför det är viktigt
En enskild godkänd körning visar att en agent kan lyckas. Upprepade tester visar hur ofta den kommer att göra det. API:et accepterar repeat_count från 2 till 20, och resultaten visar en godkännandefrekvens. Grönt betyder 100 %, gult betyder 80 % eller mer och rött betyder under 80 %. Fel grupperas efter orsak. Prompter, modeller, workflows och integrationer ändrar alla beteendet, så testningen fortsätter efter lansering.
Så fungerar experiment
Experiment är A/B-tester byggda på agentversionering. Du förgrenar din konfiguration, ändrar en variabel som systemprompt, workflow, röst, verktyg, kunskapsbas eller LLM-inställningar och dirigerar en andel av live-trafiken till varianten. ElevenLabs rekommenderar att börja på 5–10 %.
Dirigeringen är deterministisk per samtals-ID, så en viss användare stannar på samma gren och procentsatserna måste bli 100 % totalt. CARS24, en kund till ElevenLabs, ökade trafiken genom 5 %, 10 %, 20 %, 50 % och 100 %, med två dagars väntan vid varje steg, enligt rapporten.
Tester före lansering och live-experiment förvandlar tillsammans ändringar till uppmätta förbättringar.
Observability: Mät vad som händer i produktion
Observability är förmågan att se vad agenten gjorde, hur den presterade och, om det inträffar, var den misslyckades. En agent som fungerar i ett test kan bete sig annorlunda med riktiga uppringare, vilket gör full observability och granskningsbar dokumentation nödvändig.
Vad det gör
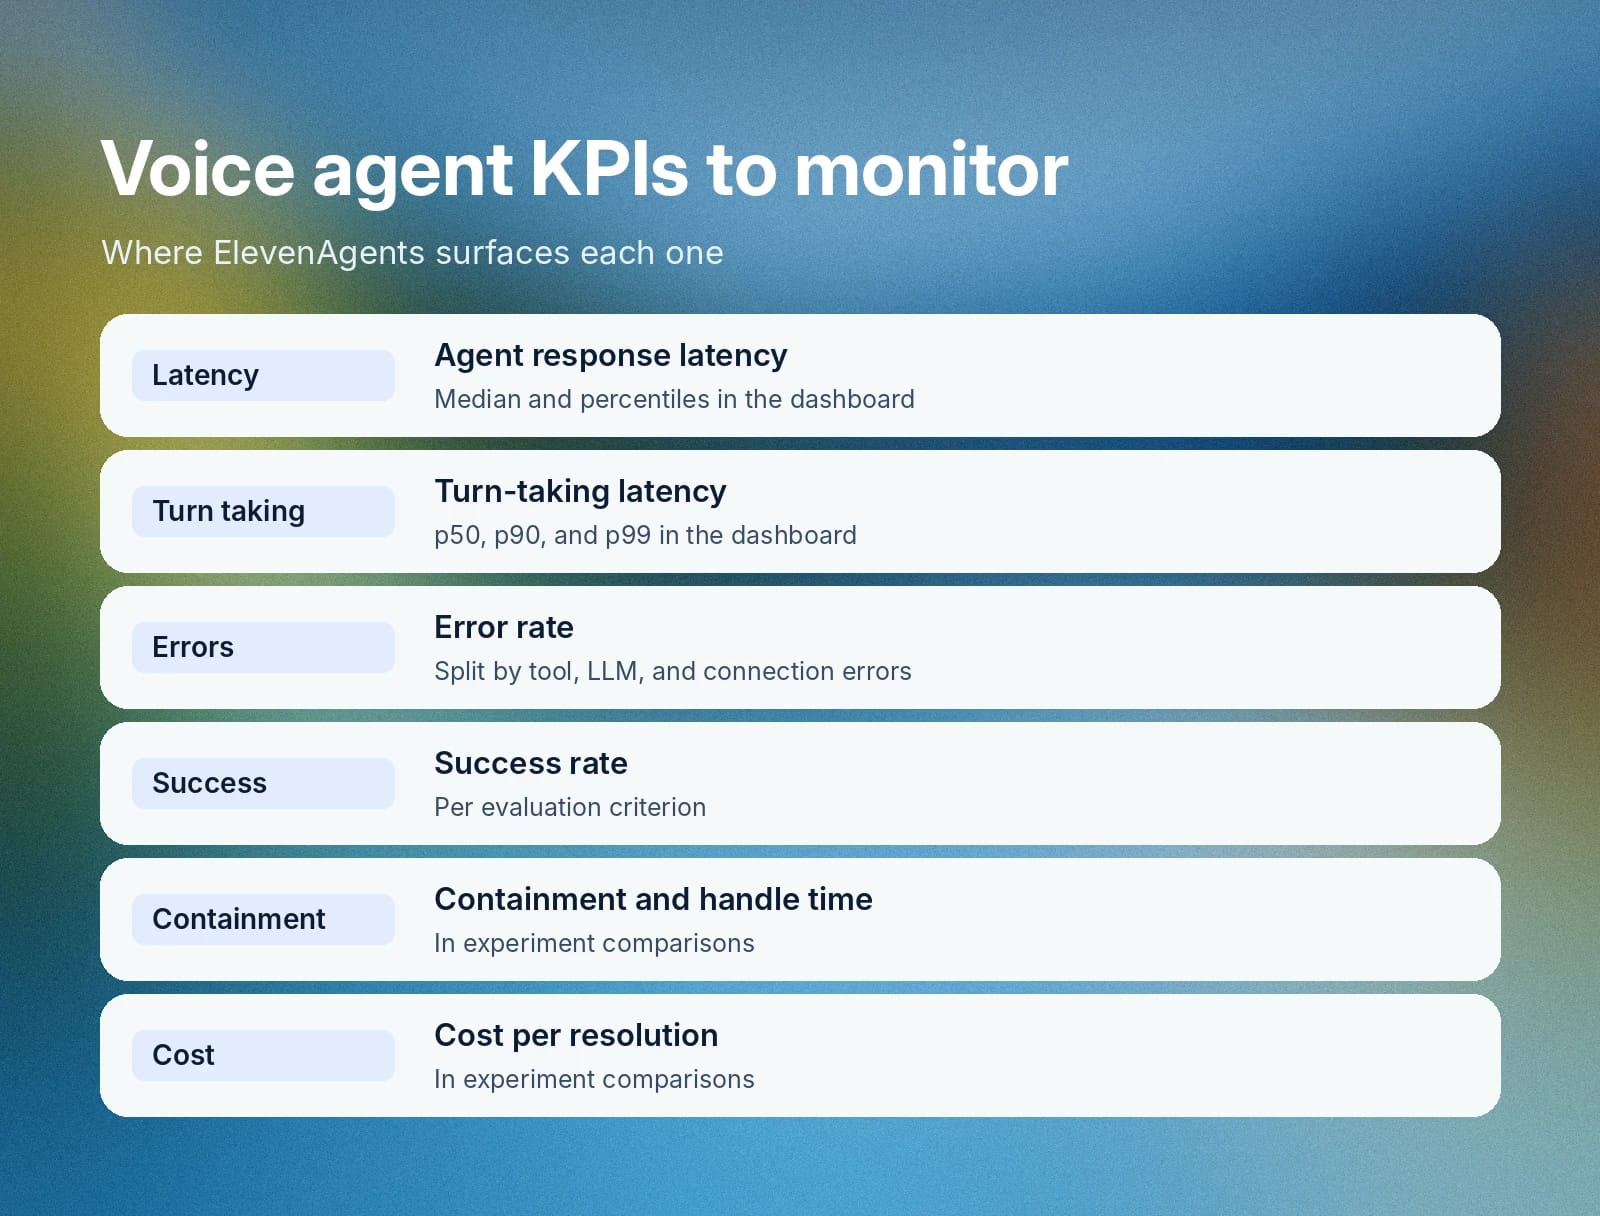
Samtalsanalys betygsätter varje samtal. Framgångsutvärdering tillämpar kriterier som du definierar för måluppfyllelse och kvalitet, och datainsamling extraherar strukturerade fält som kontaktuppgifter och ärendetyp. Analysdashbordet lägger till samtalsvolym, varaktighet, kostnad, felfrekvenser och latens. Aktiva samtal uppdateras i realtid, och varningar utlöses när felfrekvenserna ökar.
Varför det är viktigt
Utan övervakning är ett dåligt samtal en anekdot. Med övervakning kan du se vilken nod, vilket verktyg eller vilken modell som orsakade problemet.
KPI
Vad det berättar
Var ElevenAgents visar det
Agentens svarslatens
Hur länge uppringare väntar på ett svar
Analysdashboard, median och percentiler
Latens för turordning
Hur snabbt agenten tar sin tur
Analysdashboard, p50, p90 och p99
Felfrekvens
Andel samtal med fel
Dashboard, uppdelat efter verktygs-, LLM- och anslutningsfel
Framgångsfrekvens
Måluppfyllelse per kriterium
Utvärderingskriterier, med frekvenser för lyckat, misslyckat och okänt
Andel lösta ärenden och hanteringstid
Samtal som lösts utan människa samt samtalslängd
Experimentjämförelser
Kostnad per lösning
Vad varje löst samtal kostar
Experimentjämförelser
Välj de mätvärden som är mest användbara för den specifika uppgiften du har i åtanke. En supportagent fokuserar på lösning och eskalering, medan en utgående agent främst fokuserar på anslutning och slutförande.
Skalning, tillförlitlighet och överlämning till människa
AI-röstinfrastruktur måste fungera oavsett om du pratar med 5 kunder eller 500 000. Även vid stora volymer måste dessa komponenter hålla och kunna eskalera till människor vid behov.
Vad det gör
Skalning innebär att stödja många samtidiga samtal över taligenkänning, LLM-inferens, talsyntes, integrationer och telefoni. Tillförlitlighet innebär att varje beroende har en definierad väg vid fel. Överlämning innebär en tydlig väg till en människa.
Även om de inte strikt är komponenter i AI-röstinfrastruktur är de alla viktiga delar av vad som i praktiken skapar ett bra system.
Varför det är viktigt
Ett system som hanterar tio testsamtal kan bete sig annorlunda vid tiotusen. Ett bokningsverktyg som får timeout får inte leda till att agenten bekräftar en bokning som aldrig gjordes. En uppringare som ber om en person måste nå en med kontexten intakt, vanligtvis genom varm överföring.
Så gör ElevenAgents
Samtidighetsgränser följer prenumerationsnivån, och samtalskö håller kvar uppringare när en gräns nås. LLM-kaskadering täcker modellavbrott. Transfer-to-number-noder, systemverktyget transfer-to-number och agentöverföring hanterar överlämning, och utvärderingskriterier kan avgöra när eskalering ska ske. Tysta perioder debiteras med 5 % av den vanliga kostnaden per minut.
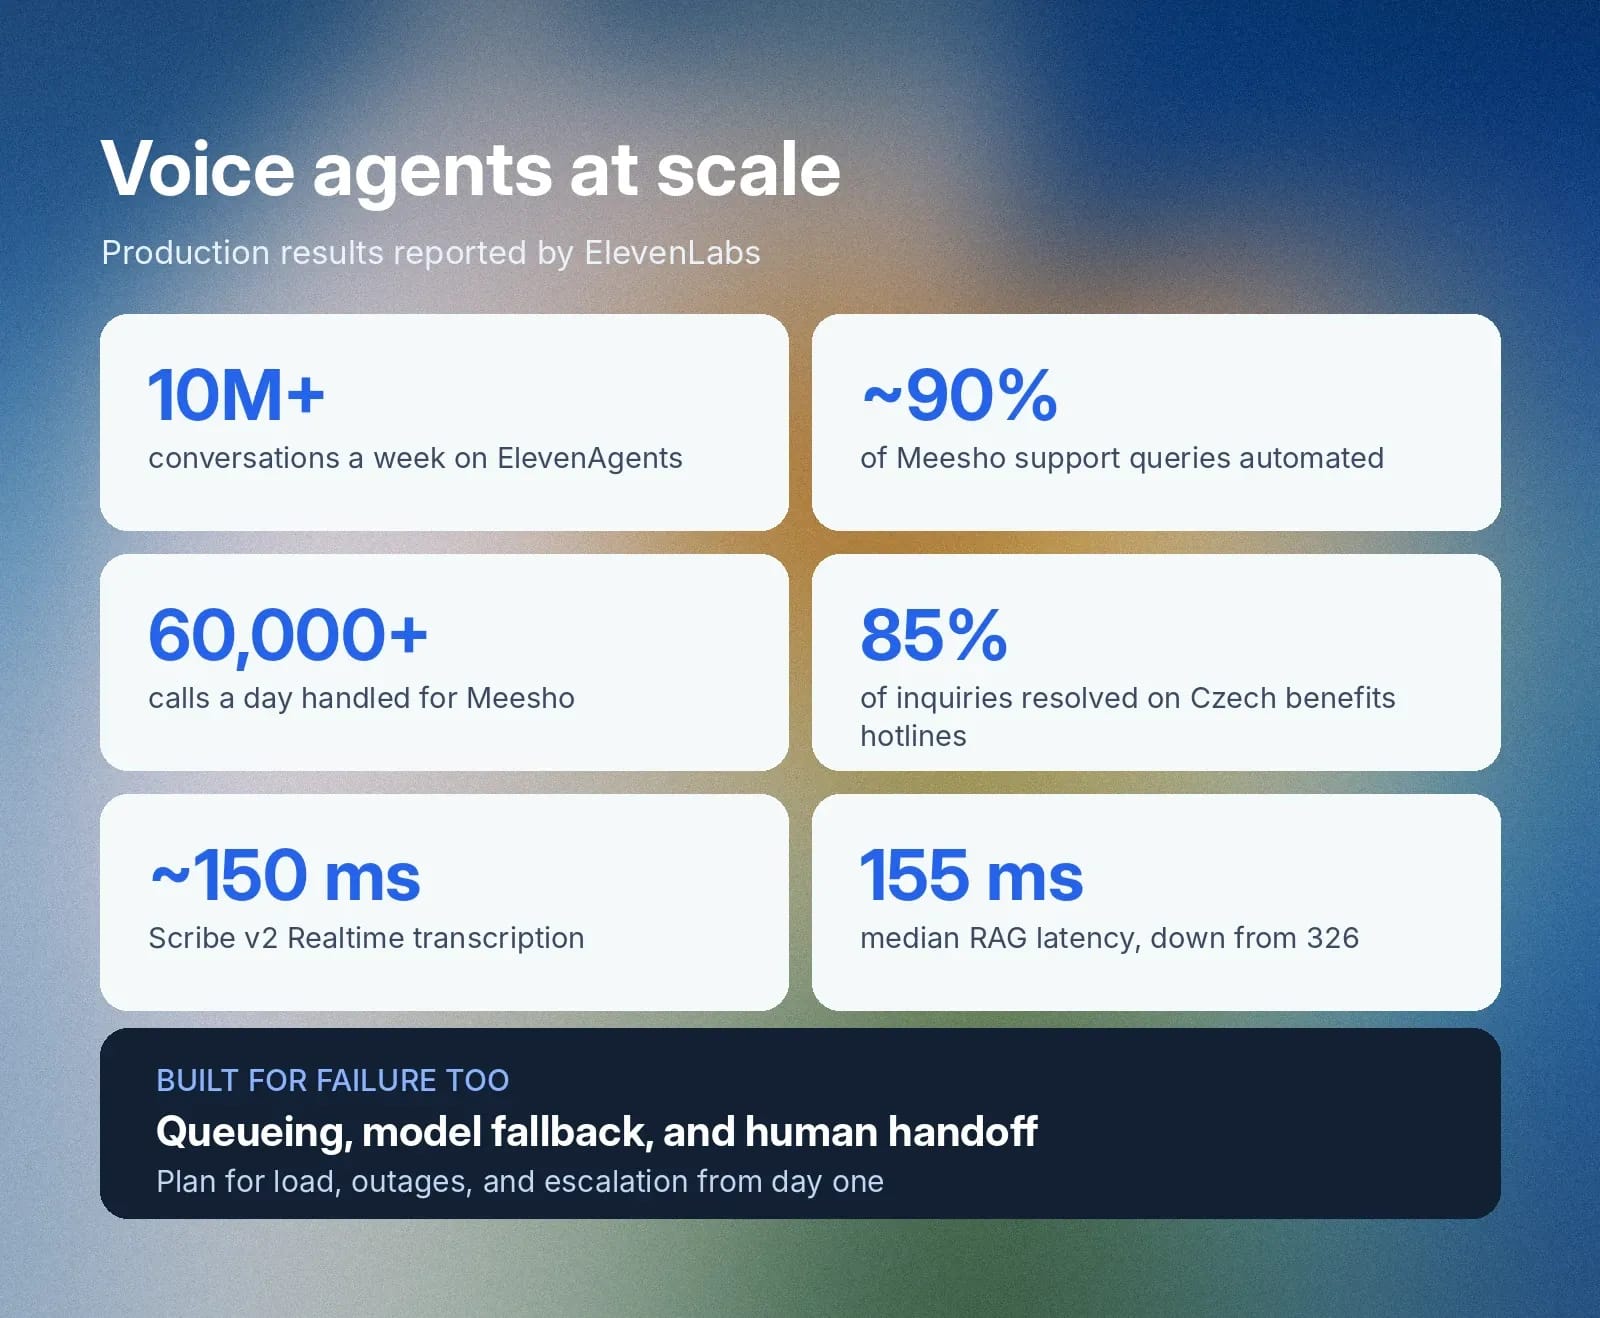
ElevenLabs rapporterar produktionsresultat i stor skala. ElevenAgents driver över 10 miljoner samtal per vecka. Meesho automatiserar omkring 90 % av supportfrågorna i över 60 000 samtal per dag, enligt rapporten Building Enterprise-grade Voice Agents. I Tjeckien hanterar agenter med stöd av ElevenLabs omkring 5 000 samtal per dag på nationella hjälplinjer för förmåner och löser självständigt 85 % av förfrågningarna, enligt rapporten State of Conversational Agents in Government.
Att planera för belastning, fel och överlämning från början är det som skiljer en demo från en driftsättning.
Vad du ska leta efter i produktionsklar AI-röstinfrastruktur 2026
Använd den här checklistan för att utvärdera en AI-röstplattform utifrån dina krav.
- Taligenkänning: korrekta transkriberingar för dina språk, accenter och ljudkvalitet, inklusive namn och identifierare.
- Turordning: konfigurerbart beteende vid sluttur, barge-in och en uppmätt svarstid för avbrott.
- Modellval: valbar LLM per agent eller underagent, möjlighet till anpassad LLM och automatisk reservlösning.
- Orkestrering: workflows i flera steg och dirigering mellan specialiserade agenter.
- Verktyg: webhooks, klientverktyg, MCP-stöd och godkännandekontroller.
- Kunskap: egna dokument med hämtningslatens som du kan mäta.
- Personalisering: data om uppringaren tillgängliga innan det första ordet sägs.
- Röst: kort tid till första talet och kontroll över uttal och uttryck.
- Kanaler: telefon, webb, mobil och meddelanden, med SDK:er och ett API.
- Skyddsräcken: konfigurerbara beteendegränser med en känd latenskostnad.
- Testning: simulerade samtal, kontroller av verktygsanrop och upprepade körningar.
- Experiment och analys: A/B-tester, percentillatens och feluppdelningar.
- Skalning och överlämning: dokumenterad samtidighet, köhantering och eskalering till människor.
Ledande system för AI-röstagenter, som ElevenAgents, erbjuder alla dessa komponenter på en plattform.
Kom igång i dag genom att kontakta teamet eller bygg egna AI-agentsystem genom att skapa ett konto.
Vanliga frågor om AI-röstinfrastruktur

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.