Vad är automatisk taligenkänning (ASR)?
- Skriven av
- Jack Limebear
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
År 1952 kunde världens mest avancerade taligenkänningssystem förstå exakt 9 ord.
Spolar vi fram omkring 75 år transkriberar automatisk taligenkänning (ASR) dussintals språk i realtid och driver allt från röstassistenterna i din telefon till undertexter som visas i direktsända videor.
Den här guiden utforskar tekniken som överbryggade klyftan mellan versionen från 1952 och dagens versioner: vad ASR är, hur det omvandlar tal till text och hur ASR fortfarande utvecklas.
Sammanfattning:
- ASR står för automatisk taligenkänning, tekniken som omvandlar talat ljud till skriven text.
- Den tidigaste formen av ASR kom 1952, medan system för djupinlärning nådde mänskliga riktmärken i slutet av 2010-talet.
- Modern ASR använder neurala nätverk som tränas heltäckande på miljontals timmar av ljud.
- Ordfelfrekvens (WER) är standardmåttet för noggrannhet, men latens, kvaliteten på talardiarisering och kontextförståelse spelar också roll för ASR i produktion.
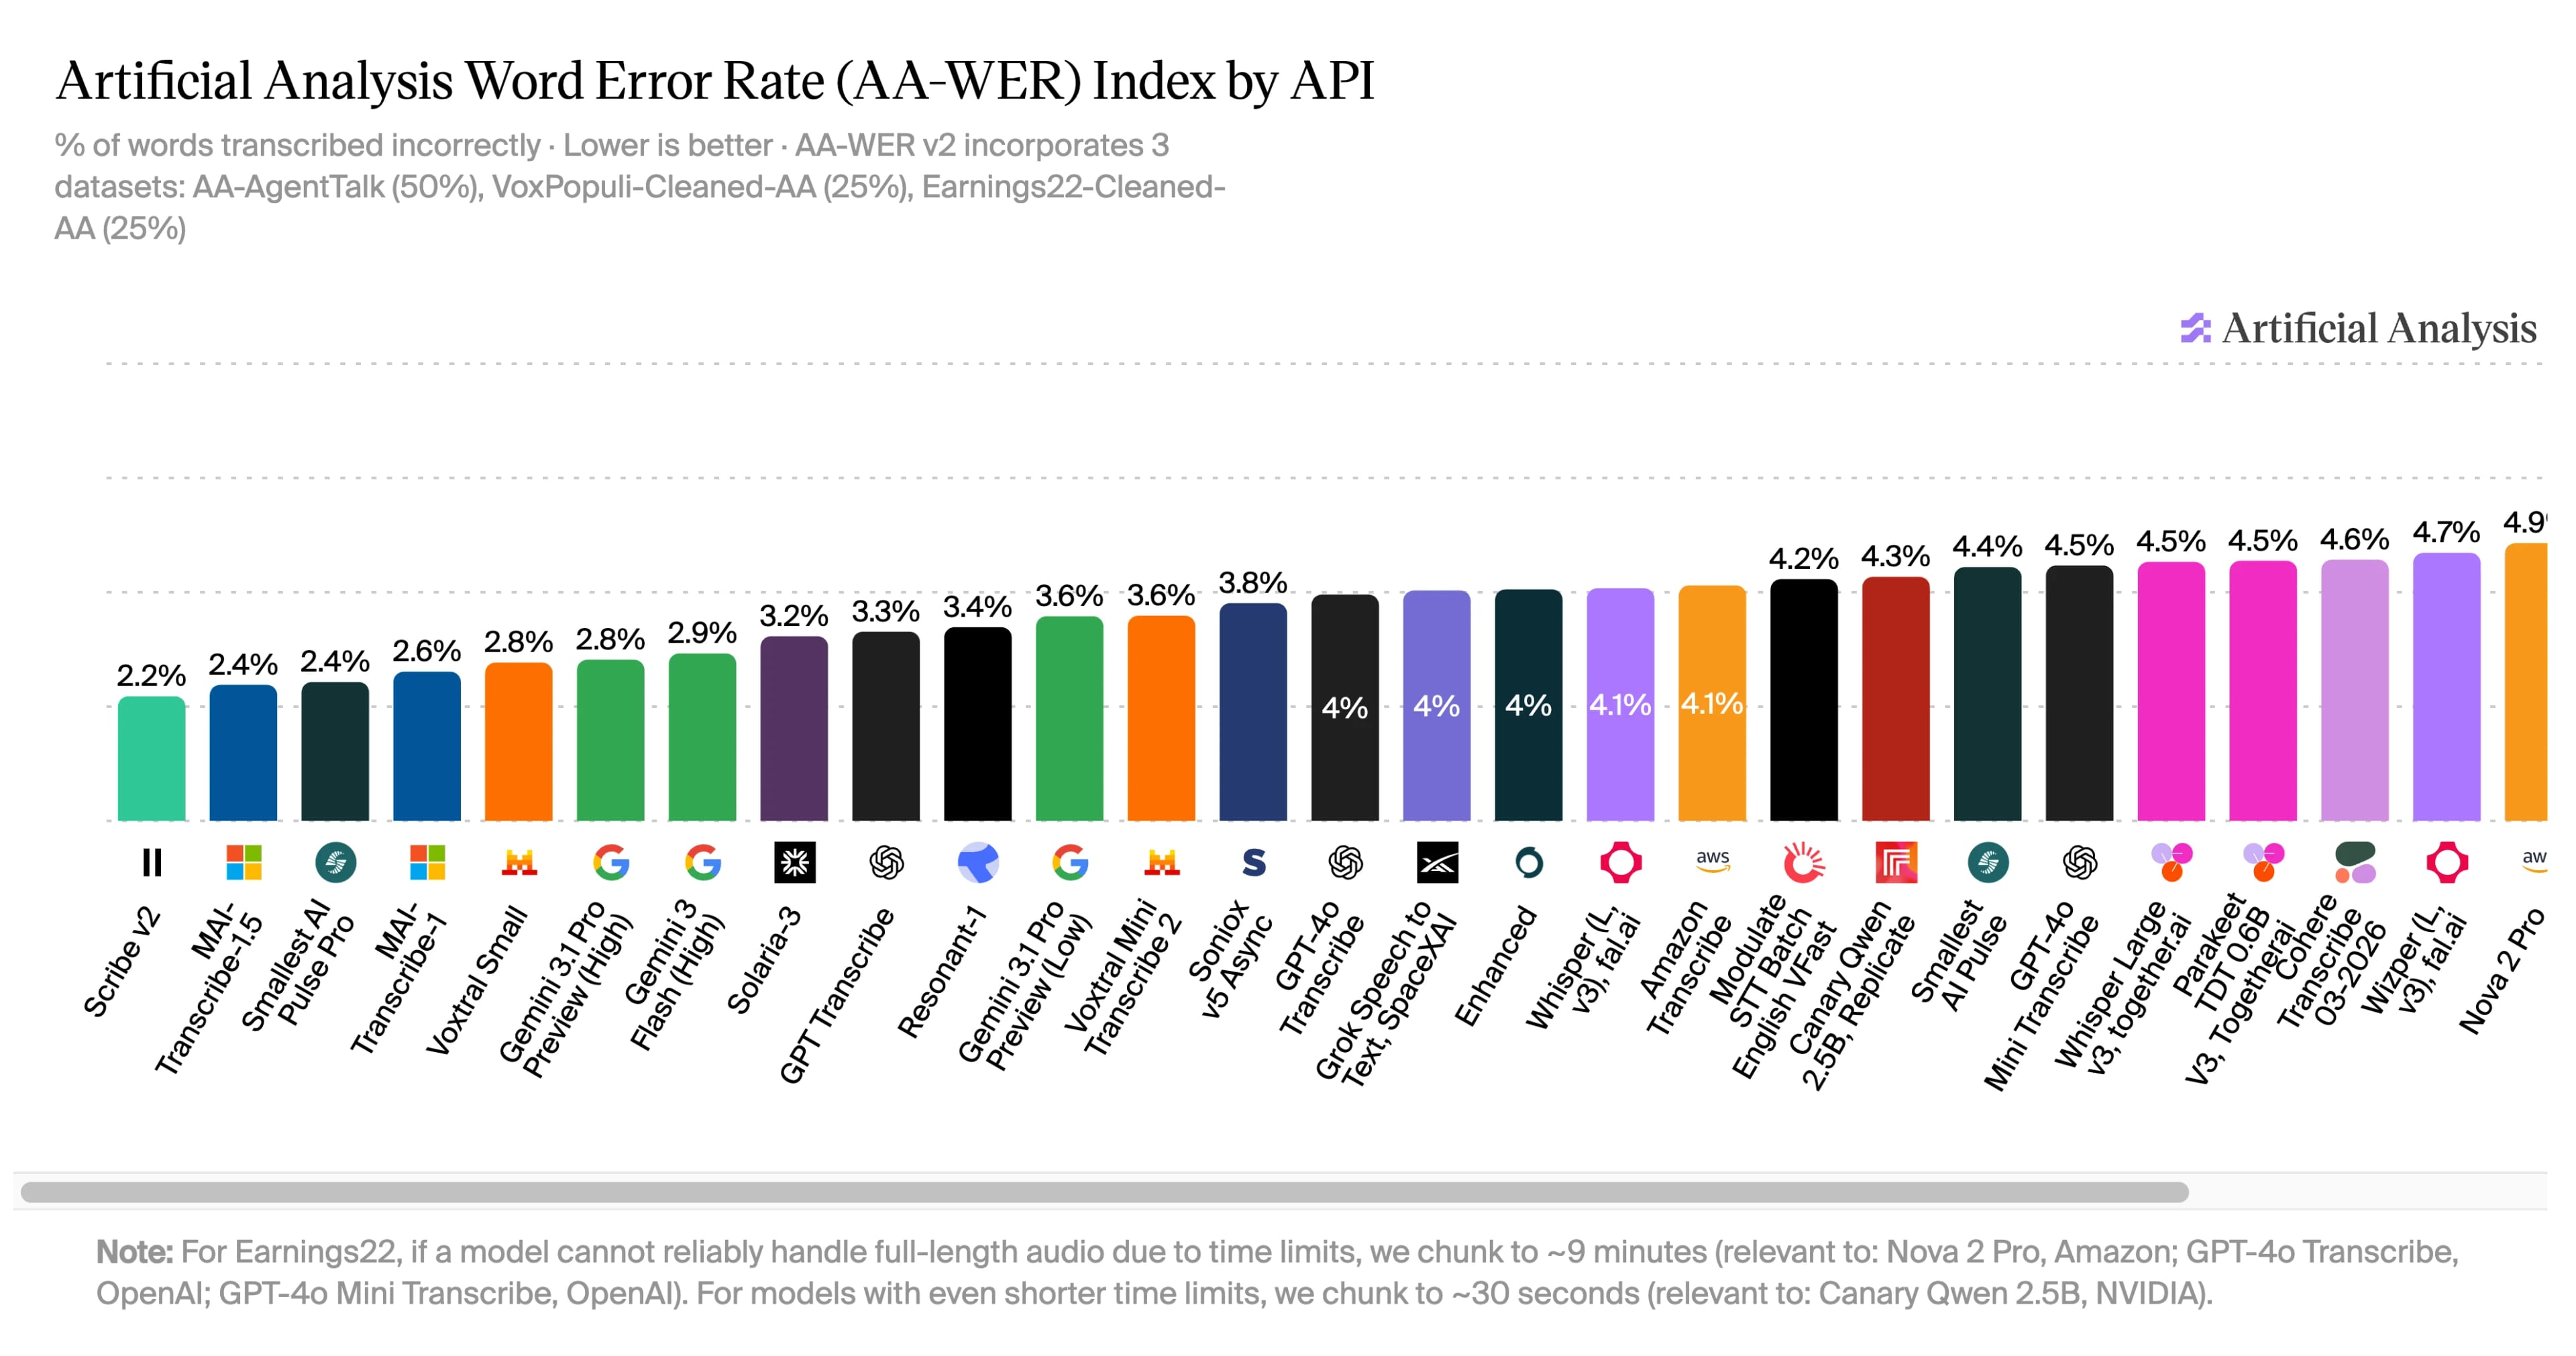
- ElevenAPI ger utvecklare ASR i produktionsklass, oberoende utvärderad av Artificial Analysis till en ordfelfrekvens på 2,2 %, den lägsta i deras index (juli 2026).
Vad är automatisk taligenkänning (ASR)?
Automatisk taligenkänning, ofta enbart kallad ASR, är programvara som lyssnar på mänskligt tal och omvandlar det till korrekt, maskinläsbar text. Det kallas också ofta tal till text och taligenkänning, eller ibland datorbaserad taligenkänning.
ASR har blivit så vanligt att du kanske använder det varje dag utan att ens tänka på det. Varje gång du dikterar ett meddelande, ställer en fråga till en röstassistent, läser undertexter i en direktsänd video eller navigerar genom ett interaktivt talsvarssystem använder du ASR.
Även om tal till text och ASR ofta används som synonymer och ligger nära varandra, är de inte exakt samma sak. ASR är tekniken som identifierar vad som sägs, medan STT är tillämpningen av tekniken som verktyg. Programvara för röstigenkänning bygger ovanpå ASR och identifierar vem som sa ett visst ord, vilket är grunden för talardiarisering-funktioner.
Det är små skillnader, men de är värda att förstå om du vill integrera system för ASR/STT/röstigenkänning i dina appar eller på din webbplats.
En kort historia om automatisk taligenkänning
Tekniken för automatisk taligenkänning är mycket äldre än de flesta tror, med tidiga versioner från 1950-talet. Under de över 70 år som gått sedan starten har ASR utvecklats genom flera viktiga steg som till stor del lagt grunden för förbättringarna.
Här är de viktigaste epokerna inom ASR-tekniken:
- 1952 och den första ASR-lösningen: År 1952 byggde Bell Laboratories Automatic Digit Recognizer, känd som AUDREY, för att förstå siffrorna ett till nio. Verktyget var bara omkring 90 % korrekt och fungerade bara när uppfinnaren använde det, vilket gjorde det mycket begränsat. Trots att det var långt ifrån dagens möjligheter var det imponerande att över huvud taget kunna känna igen 1–9.
- 1960- och 70-talen och ett växande ASR-ordförråd: Under de följande decennierna kunde laboratorier över hela världen, bland annat hos IBM, University College London och NEC i Japan, skapa modeller liknande AUDREY i olika sammanhang. Raj Reddy, en indisk doktorand vid Stanford, byggde en vokaligenkännare för sitt doktorandprojekt och lade grunden för kontinuerlig taligenkänning utan pauser mellan varje ord. DARPA (Defense Advanced Research Projects Agency) finansierade forskning under perioden som ledde till Beam Search, en metod för meningskonstruktion och avkodning som var avgörande för att känna igen över 1 000 ord redan 1976.
- 1980-talet till början av 2010-talet och statistiska framsteg: År 1987 kombinerade en av Raj Reddys doktorander, som då arbetade som professor, dolda Markovmodeller med Beam Search. Det möjliggjorde ASR-system som inte behövde tränas på en specifik talare. Genombrottet minskade träningstiden för taligenkänningssystem drastiskt. Dragon Systems lanserade 1997 den första kommersiellt tillgängliga ASR-lösningen, NaturallySpeaking Preferred. Den kunde känna igen 100 ord per minut och sålde bra.
- Den moderna eran och djupinlärning: På 2010-talet visade forskare att ett enda neuralt nätverk, tränat heltäckande på ljud och transkriptioner, överträffade en helt statistisk pipeline. Med djupa neurala nätverk kunde ASR nå prestanda nära mänsklig nivå, med en felfrekvens på mellan 5 % och 10 %. Under denna tid kom röstbaserade assistenter som Alexa och Siri ut på marknaden.
Sedan dess har ASR bara blivit mer korrekt och fått större användning. I juli 2026 identifierade Artificial Analysis oberoende forskning ElevenLabs Scribe v2 som branschledande med en ordfelfrekvens (WER) på bara 2,2 %.
Hur fungerar ASR? Grunderna i tal till text-teknik
ASR fungerar genom att fånga ett ljudprov, omvandla det till en numerisk representation och sedan använda en tränad modell för att förutsäga den mest sannolika ordföljden som siffrorna representerar. Modern ASR gör detta i realtid och slutför hela processen från början till slut på under en sekund.
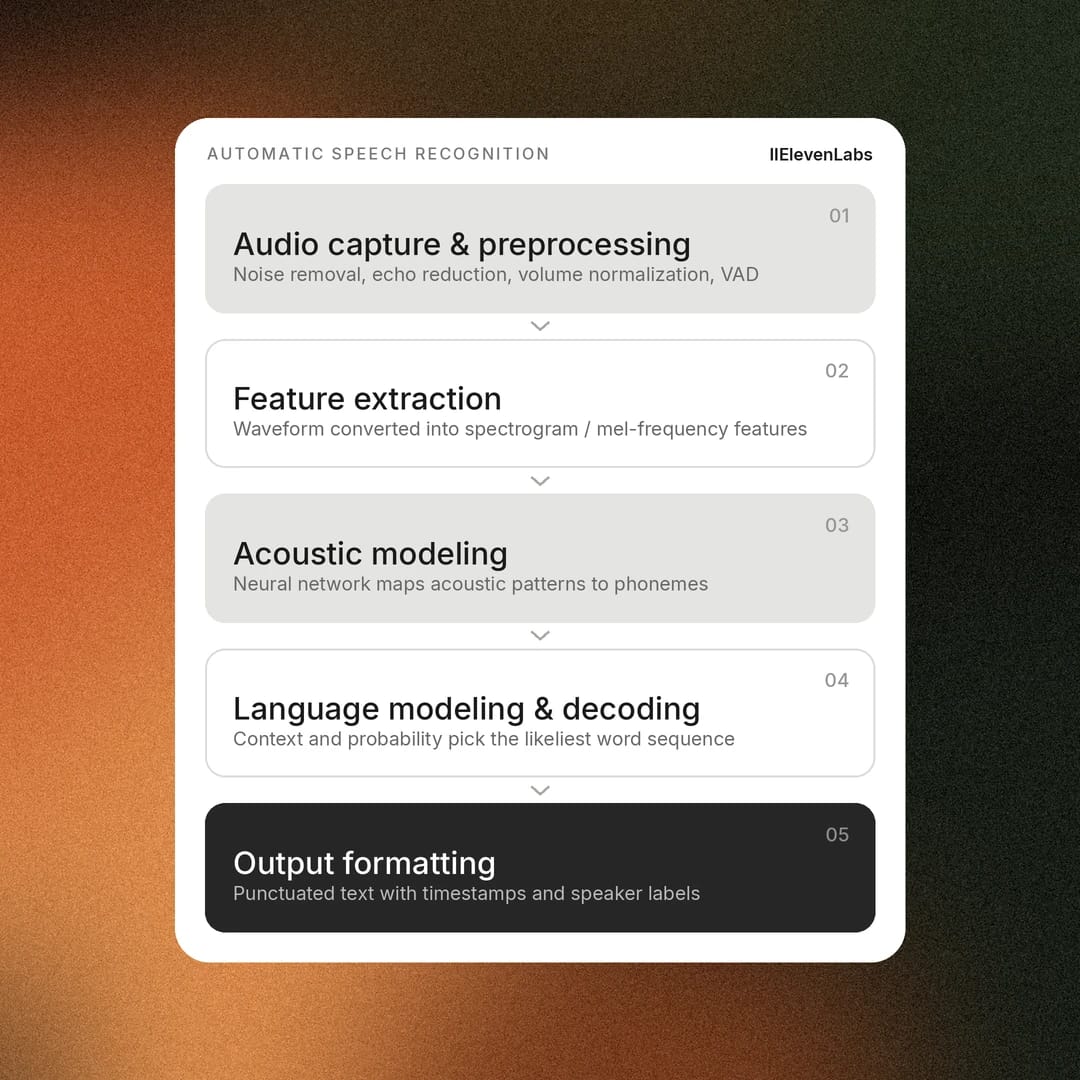
En ASR-pipeline har fem huvudsakliga steg:
- Ljudinsamling och förbehandling: Systemet spelar in ljudsignalen, tar bort bakgrundsljud, minskar eko och normaliserar volymnivåer för bättre konsekvens. Beroende på modell kan det använda röstaktivitetsdetektering (VAD) för att skilja tal från tystnad eller bakgrundsljud innan transkriberingen börjar.
- Funktionsutvinning: Ljudet omvandlas till en numerisk representation, vanligtvis ett spektrogram eller mel-frekvensfunktioner, som tydligt visar de frekvenser och mönster som mänskligt tal innehåller. Steget omvandlar i praktiken en rå ljudvåg till data som en maskininlärningsmodell kan bearbeta effektivt.
- Akustisk modellering: Ett neuralt nätverk analyserar funktionerna från föregående steg och förutspår fonem eller andra talenheter genom att lära sig sambandet mellan akustiska mönster och talat språk. Moderna heltäckande modeller utför ofta detta steg tillsammans med språkförståelse, i stället för som ett helt separat steg.
- Språkmodellering och avkodning: Systemet väger sedan vilka ordföljder som är mest sannolika utifrån regler som grammatik, kontext och matematisk sannolikhet. De två sistnämnda är avgörande här, eftersom IPA-transkriberingen (International Phonetic Alphabet) av två meningar kan vara liknande medan deras sammanhang är helt olika. Till exempel kan ”Recognize Speech” och ”Wreck a nice peach” låta likadant, men ha helt olika betydelser. Kontexten hjälper systemet att avgöra vad som är rätt om precisionen inte räcker för att avgöra det säkert.
- Formatering av utdata: När systemet har avgjort vad talet innehåller transkriberas den slutliga texten, med skiljetecken och versaler. Ytterligare metadata, som tidsstämplar på ordnivå och talaretiketter, ger mer detaljerade transkriptioner.
Genom dessa huvudsteg omvandlar modellen inkommande ljuddata till en skriven transkription.
Traditionella hybridsystem jämfört med heltäckande ASR med djupinlärning
Även om pipelinen ovan beskriver hur ASR fungerar, finns det två tekniska vägar för mitten av den pipelinen.
Äldre system kedjar ihop flera komponenter: en lexikonmodell som kodar hur ord uttalas, en akustisk modell som kopplar ljud till fonem och en språkmodell som förutsäger sannolika ordföljder. Varje komponent kräver mänsklig expertis, från lingvister som skapar uttalsordböcker för hand till annoterare som anpassar varje ord till dess exakta position i ljudet.
Heltäckande djupinlärning samlar alla dessa komponenter i ett enda neuralt nätverk. Nätverket kopplar ljud direkt till text och lär sig implicit uttal, akustik och språkets sannolikhetsstatistik från miljontals timmar av parade ljudfiler och transkriptioner.
Låt oss gå igenom skillnaderna mellan traditionella och moderna metoder för ASR-teknik.
Så mäts ASR-noggrannhet: riktmärken för ordfelfrekvens (WER)
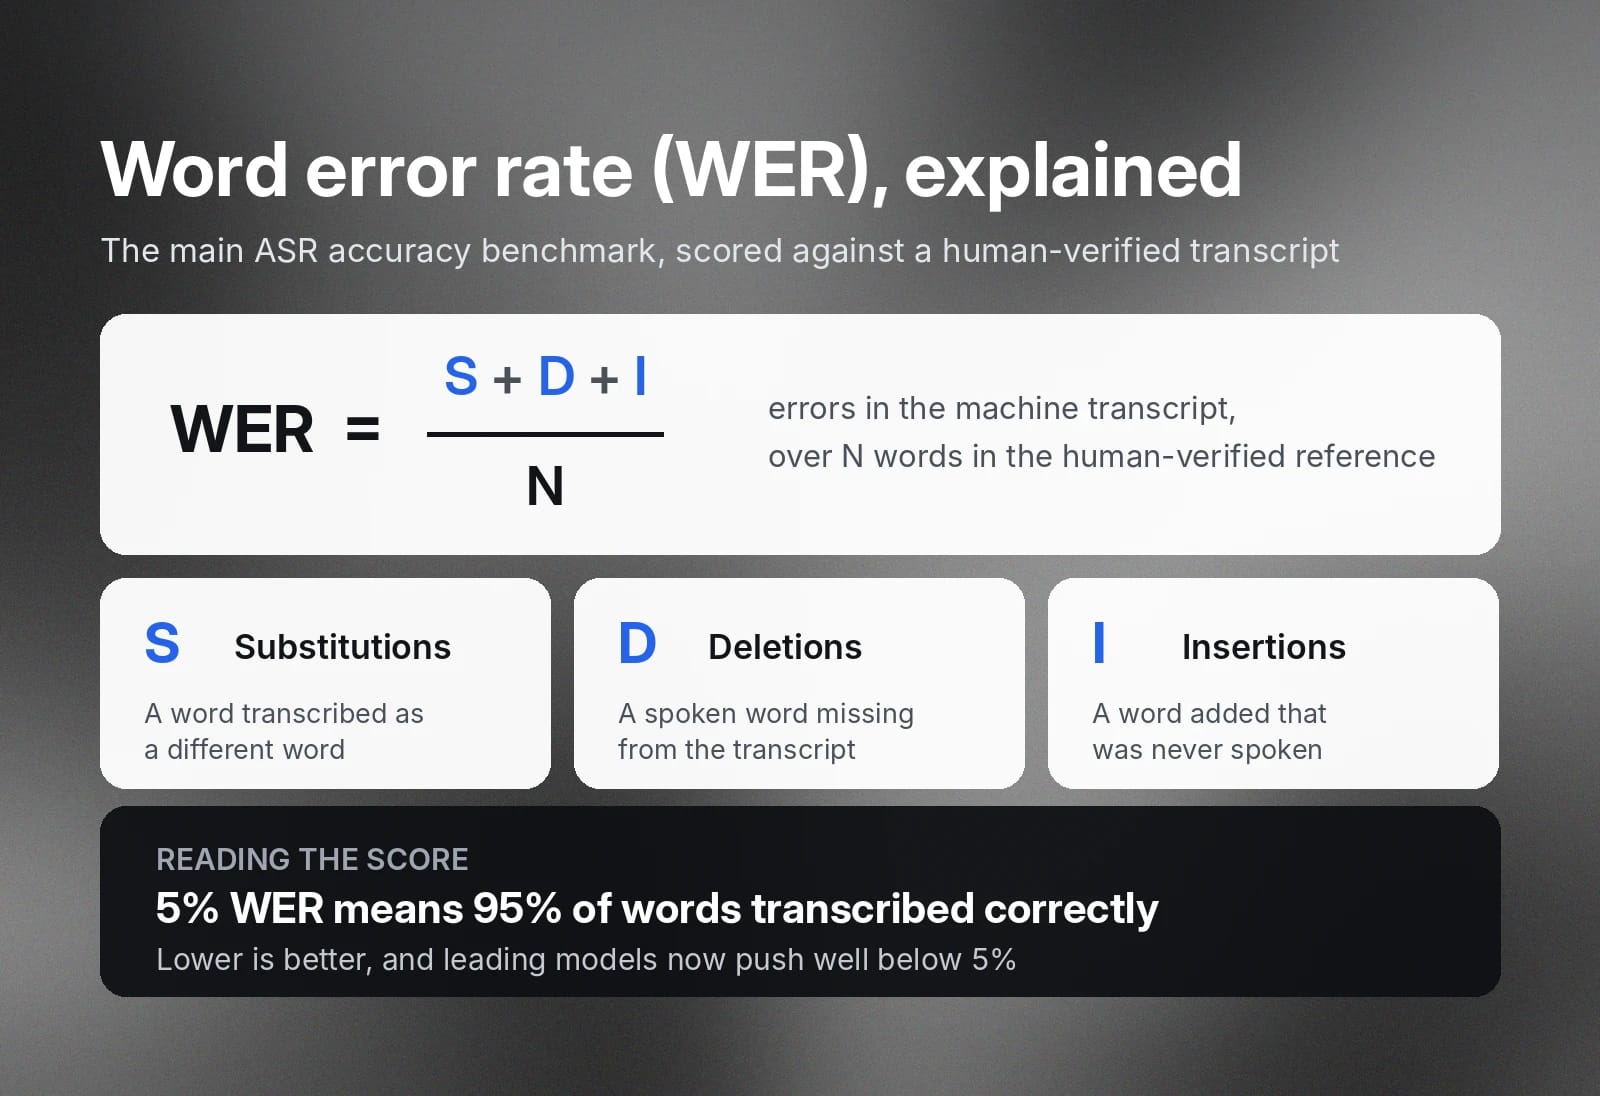
För alla arbetsflöden med tal till text och ASR är ordfelfrekvens (WER) det främsta måttet på noggrannhet som företag använder. Det jämför en maskintranskription som skapats med ASR med en mänskligt verifierad version. Tre huvudtyper av fel räknas här: ersättningar, utelämningar och infogningar.
Formeln för WER dividerar det totala antalet fel med antalet ord i referenstranskriptionen. En WER på 5 % innebär att systemet kunde transkribera 95 % av texten korrekt, och de flesta ledande modeller ligger nu långt under 5 % på väg mot perfektion.
WER är ett användbart riktmärke, men även andra faktorer bör vägas in när du bedömer hur effektivt ett ASR-verktyg är:
- Formateringsnoggrannhet: Kan systemet formatera ovanliga strängar korrekt? Visas exempelvis ett belopp som $1,225 på det sättet, eller skrivs det ut som ”ettusen tvåhundratjugofem dollar”?
- Latens: Noggrannhet är viktigt, men om det tar flera minuter att skapa en enkel transkription blir verktyget oanvändbart. Även om det är mycket korrekt måste det balanseras med låg latens för att vara användbart.
- Robusthet: Inte ens användningsfall med starka accenter eller bullriga miljöer bör försämra modellens noggrannhet avsevärt.
- Kvalitet på diarisering: Användningsfall med flera talare är beroende av att varje ord tillskrivs rätt talare. Att kunna identifiera olika talare och märka dem korrekt bidrar till ASR, särskilt i branscher med många talare, som rättssalar.
Läs vår omfattande guide om ordfelfrekvens för mer information.
Viktiga fördelar med ASR för moderna företag
Den globala marknaden för tal- och röstigenkänning förväntas växa till över 23,11 miljarder dollar till 2030. Marknadens årliga tillväxttakt på 19,1 % visar hur utbredd tekniken har blivit i kommersiella enheter. Varje modern mobiltelefon har ett diktationstangentbord och en röstassistent, de flesta nya bilar svarar på röstkommandon och smarta högtalare eller assistenter finns nu i hem världen över.
Röstinteraktion med teknik är nu ett självklart alternativ för kunder. För företag erbjuder ASR allt från transkribering av kundsamtal till stöd för röstagenter, integrerat i processer för att öka produktiviteten.
Här är några av de främsta fördelarna med ASR för moderna företag:
- Snabbare inmatning och dokumentation: Redan för över 10 år sedan publicerade Stanford en studie som visade att taligenkänningsteknik var nästan tre gånger snabbare än att skriva på tangentbord, samtidigt som felfrekvensen var lägre. För de allra flesta möjliggör ASR snabbare dokumentation i transkriberingsarbetsflöden och röstbaserade anteckningar.
- Lägre driftskostnader: I många användningsfall som tidigare krävde timmar av manuella anteckningar minskar ASR-teknik kostnaden för högkvalitativ transkribering kraftigt. Rättsfall, kontaktcenter, vårdkliniker och affärsmöten kan nu använda korrekta ASR-system som skapar detaljerade anteckningar och fullständiga diariserade transkriptioner av samtal.
- Bättre tillgänglighet: Världshälsoorganisationen förutspår att 2,5 miljarder människor kommer att leva med någon form av hörselnedsättning år 2050. Realtidstextning från avancerade ASR-verktyg kan göra digitala möten och medier tillgängliga för användare.
- Sökbar röstdata: När du automatiskt transkriberar tal med ASR loggas varje interaktion mellan kund och företag fullständigt. Varje säljsamtal, supportärende, prospektsamtal eller möte blir text som går att söka i och granska. Särskilt i AI-eran kan det hjälpa till att bygga omfattande kunskapsbaser att lyfta fram kontext i ett maskinläsbart format. Det håller information synlig, både för funktionalitet och regelefterlevnad.
- Kundupplevelser dygnet runt: ASR tillhandahåller en av grundteknikerna för röstagenter, vilket möjliggör automatiserad support som löser kundsamtal dygnet runt, året om.
Automatisk taligenkänning är så vanlig i teknik eftersom den ger så många fördelar och stöder så omfattande användningsfall. Oavsett om du arbetar inom vården eller vill transkribera kundsamtal för sentimentanalys är ASR en grundteknik som du kommer att använda.
Vanliga ASR-tillämpningar i olika branscher
Automatisk taligenkänning är en central teknik i otaliga arbetsflöden och produkter. Den är så vanlig att användare ofta inte ens tänker på hur den är inbyggd i tekniken de använder.
Här är en snabb översikt över några vanliga ASR-användningsfall världen över.
Kundtjänst och kontaktcenter
Kontaktcenter var tidiga användare av ASR och använde tekniken för att transkribera samtal för kvalitetssäkring och regelefterlevnad. I dag kan ASR köras i realtid för att ge förslag till handläggare mitt i samtal och omvandla tusentals kundinteraktioner till data som team kan analysera.
Media och underhållning
TV-bolag och streamingplattformar kan använda ASR för att skapa undertexter och bildtexter för mänskliga samtal i en skala som mänskliga transkriberare aldrig skulle kunna matcha. Det möjliggör realtidstranskribering och gör samtidigt video- och ljudbibliotek helt sökbara.
Sjukvård
Klinisk personal lägger en förvånansvärt stor del av dagen på dokumentation och journalföring. ASR hjälper dem att få tillbaka den tiden genom att ge läkare en medicinsk STT-plattform där de kan diktera sina anteckningar i realtid.
Virtuella möten
Mötesplattformar erbjuder ofta någon form av digitala anteckningar som transkriberar samtal medan de pågår, så att ingen behöver välja mellan att delta och att anteckna. Tjänster som Google Meet skickar till och med transkriptionerna med åtgärdspunkter markerade efter varje möte, vilket skapar ett sökbart informationsindex.
Juridik och regelefterlevnad
I juridiska sammanhang är det ett centralt krav i domstol att exakt dokumentera vad som sades och av vem. Advokatbyråer använder ASR-plattformar för att transkribera sina möten, förhör, klientsamtal och domstolsförhandlingar med exakta tidsstämplar för framtida referens.
Utbildning
Universitetslärare kan tillhandahålla en inspelad transkription av sina föreläsningar för att hjälpa studenter att bygga upp dokumentation över kurserna de deltagit i. När det gäller att förstå och memorera information får studenter en omfattande resurs att utgå från.
Var ASR passar in i en pipeline för röstagenter
ASR är en standarddel i många tekniska lösningar. Inom röstagentteknik är det det första av tre bredare steg som körs i en kontinuerlig loop.
- Lyssna (ASR): Agenten fångar inkommande ljudströmmar och omvandlar tal till text i realtid. Modern ASR bearbetar kontinuerligt ljud när det kommer in, filtrerar bort bakgrundsljud, hanterar avbrott, skapar partiella transkriptioner och identifierar när varje person talar.
- Tänk (språkmodell): En stor språkmodell tolkar transkriptionen, förstår användarens avsikt, hämtar information från anslutna verktyg och kunskapsbaser, upprätthåller en samtalskontext och avgör det lämpligaste svaret eller åtgärden.
- Tala (tal till text): En Text to Speech-modell omvandlar det genererade LLM-svaret till naturligt, uttrycksfullt ljud. Moderna TTS-system kan sedan justera tempo, intonation, känsla och betoning när de strömmar ljud tillbaka till uppringaren medan det genereras, i stället för att vänta på hela svaret.
Konversationslatens byggs på i vart och ett av dessa steg. Strömmande ASR börjar mata ut ord så snart de uttalas, i stället för att vänta på att ett yttrande ska bli klart, för att minska latensen. ElevenAgents använder detta som standard för röstagenter i realtid och bidrar till en effektiv agentupplevelse.
Utmaningar inom ASR och hur tekniken utvecklas
ASR-tekniken har kommit långt sedan starten 1952, men det finns fortfarande flera utmaningar som kan minska noggrannheten.
Här är några av problemen som ASR-verktyg fortfarande stöter på:
- Accenter och dialekter: Tillgänglig träningsdata koncentreras vanligtvis till ett fåtal språk och accenter, vilket gör mindre vanliga accenter eller språk som talas av färre personer mer utmanande för ASR-verktyg. Lösningen är rika och varierade träningsdataset.
- Bakgrundsljud och överlappande talare: Miljöer med varierande volym eller högt bakgrundsljud gör det svårare att urskilja enskilda ord i en inspelning. Överlappande talare kan ha samma effekt och minska noggrannheten i en ASR-transkription.
- Domänspecifikt ordförråd: Områden med specifik jargong eller förkortningar behöver ordböcker och referenser på domännivå för att förbättra noggrannheten. Medicin och juridik är två områden där ASR-verktyg behöver extra stöd eller specialiserad träning.
- Integritet och säkerhet: I många jurisdiktioner räknas röstdata som personuppgifter. Företag behöver tydliga lagringspolicyer och skyddsräcken för att hantera röstdata på ett säkert sätt och följa bredare regelverk.
En bredare faktor att överväga när du arbetar med ASR-teknik är avvägningen mellan latens och noggrannhet. Vissa användningsfall behöver balansera de två, medan områden som medicin sannolikt prioriterar noggrannhet framför allt annat.
Kom igång med ElevenAPI för ASR-integration i produktionsklass
ElevenAPI ger din produkt automatisk taligenkänning i produktionsklass genom Scribe v2, ElevenLabs modell för Speech to Text. Scribe v2 erbjuder tidsstämplar på ordnivå, talardiarisering, taggning av ljudhändelser samt den noggrannhet och tillförlitlighet som behövs för realtidsapplikationer.
Utforska sidan ElevenLabs Speech to Text för mer information eller skapa ett kostnadsfritt konto för att få igång ett API på några minuter.
Vanliga frågor om ASR

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.