
Hur fungerar ljudtranskribering med tidsstämplar och händelsetaggning?
- Skriven av
- Jack Limebear
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
En inbyggd transkriptionsmodell på ordnivå tar en ljudinspelning eller realtidsström som indata och ger ut en strukturerad array med taggade tokenobjekt med tidsstämplar som representerar tal och andra ljud. Varje token är en av tre typer: word, spacing eller audio_event. Ljudhändelser kan vara skratt, applåder eller andra bakgrundsljud.
I den här artikeln utforskar vi hur ljudtranskribering med tidsstämplar fungerar och varför den är en mer flexibel och kraftfull form av transkribering än traditionell transkribering som bygger på forcerad justering.
Sammanfattning
- Transkribering på ordnivå ger direkt strukturerade arrayer av taldata och icke-verbala ljudhändelser med tidsstämplar.
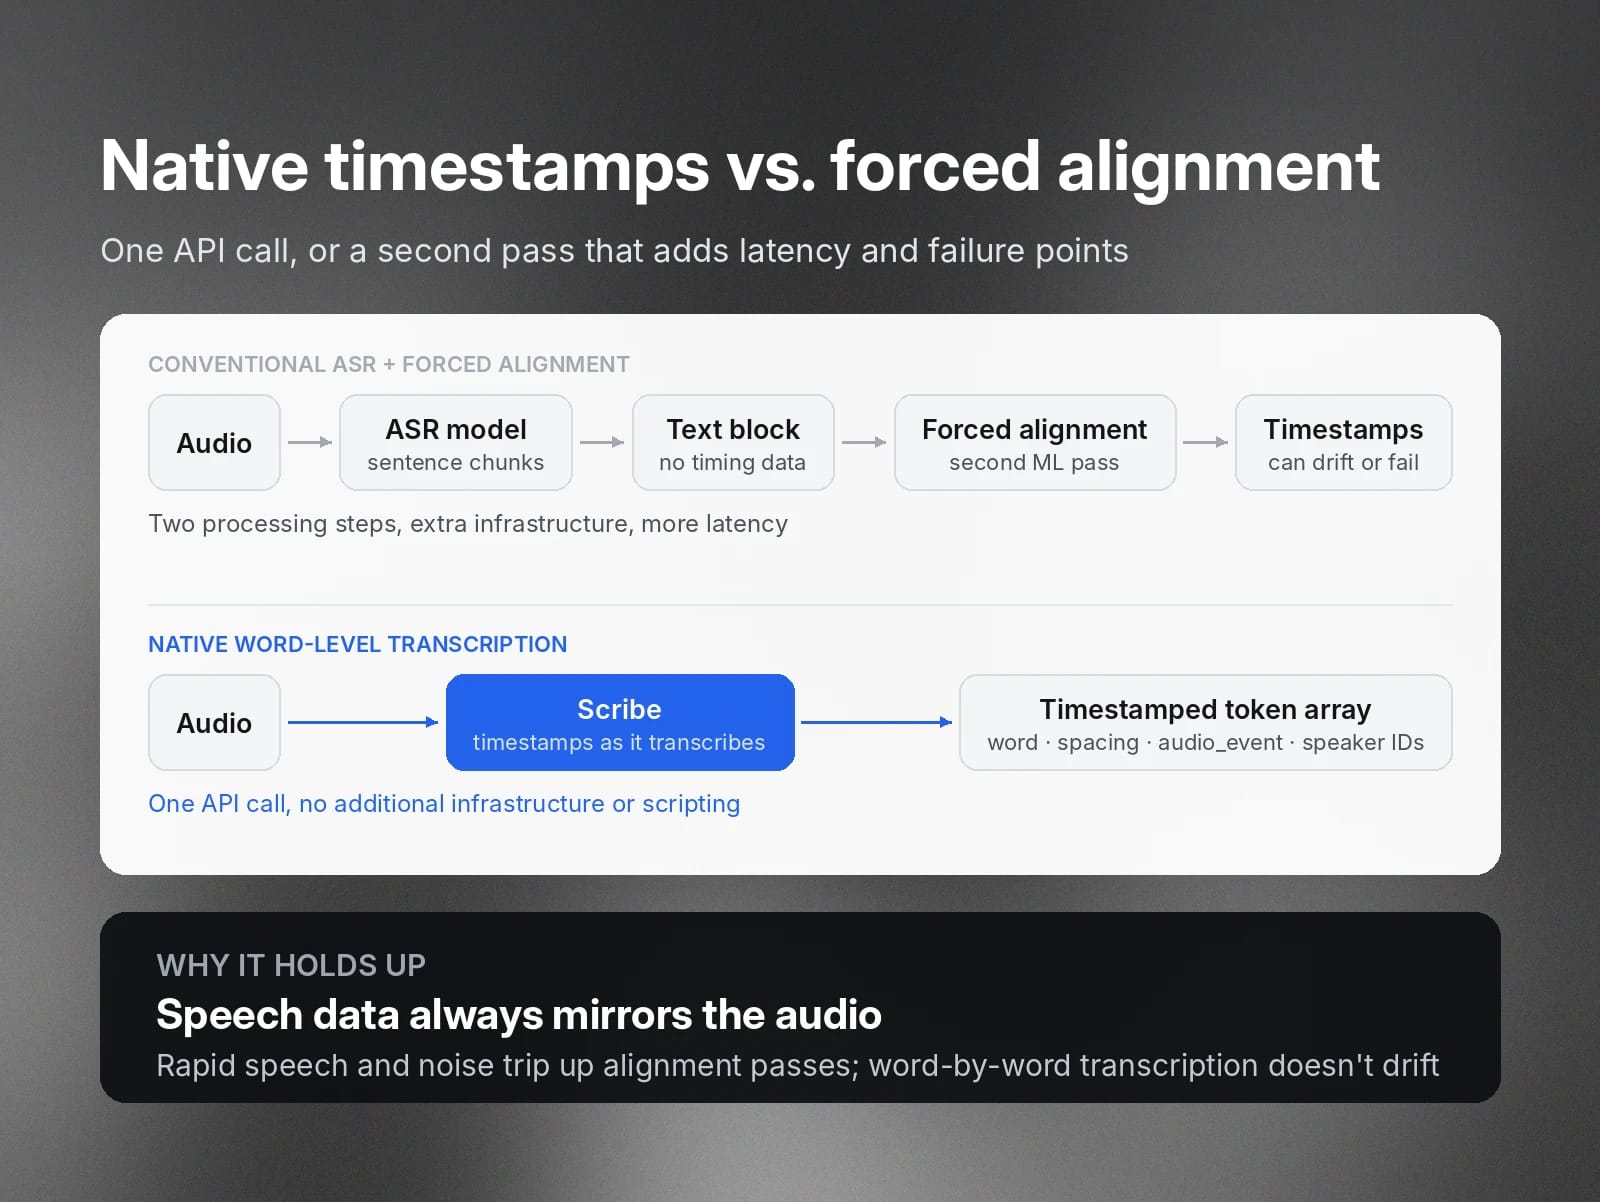
- Detta skiljer sig från traditionella modeller för automatisk taligenkänning, som ger ut hela textblock. För att tidsstämpla dem mot råljudet behöver du utföra en andra process för forcerad justering, vilket tar längre tid och kräver mer beräkningskapacitet.
- Händelsetaggar hjälper dig att fånga icke-verbalt innehåll, som skratt eller applåder. Eftersom datan är sökbar kan du använda den för att hitta höjdpunkter eller virala ögonblick baserat på publikens reaktioner.
- Du kan skicka den strukturerade utdata till applikationer för en rad användningsområden, bland annat mycket exakt textning, sökbara ljudarkiv och automatiskt klippta utdrag för sociala medier.
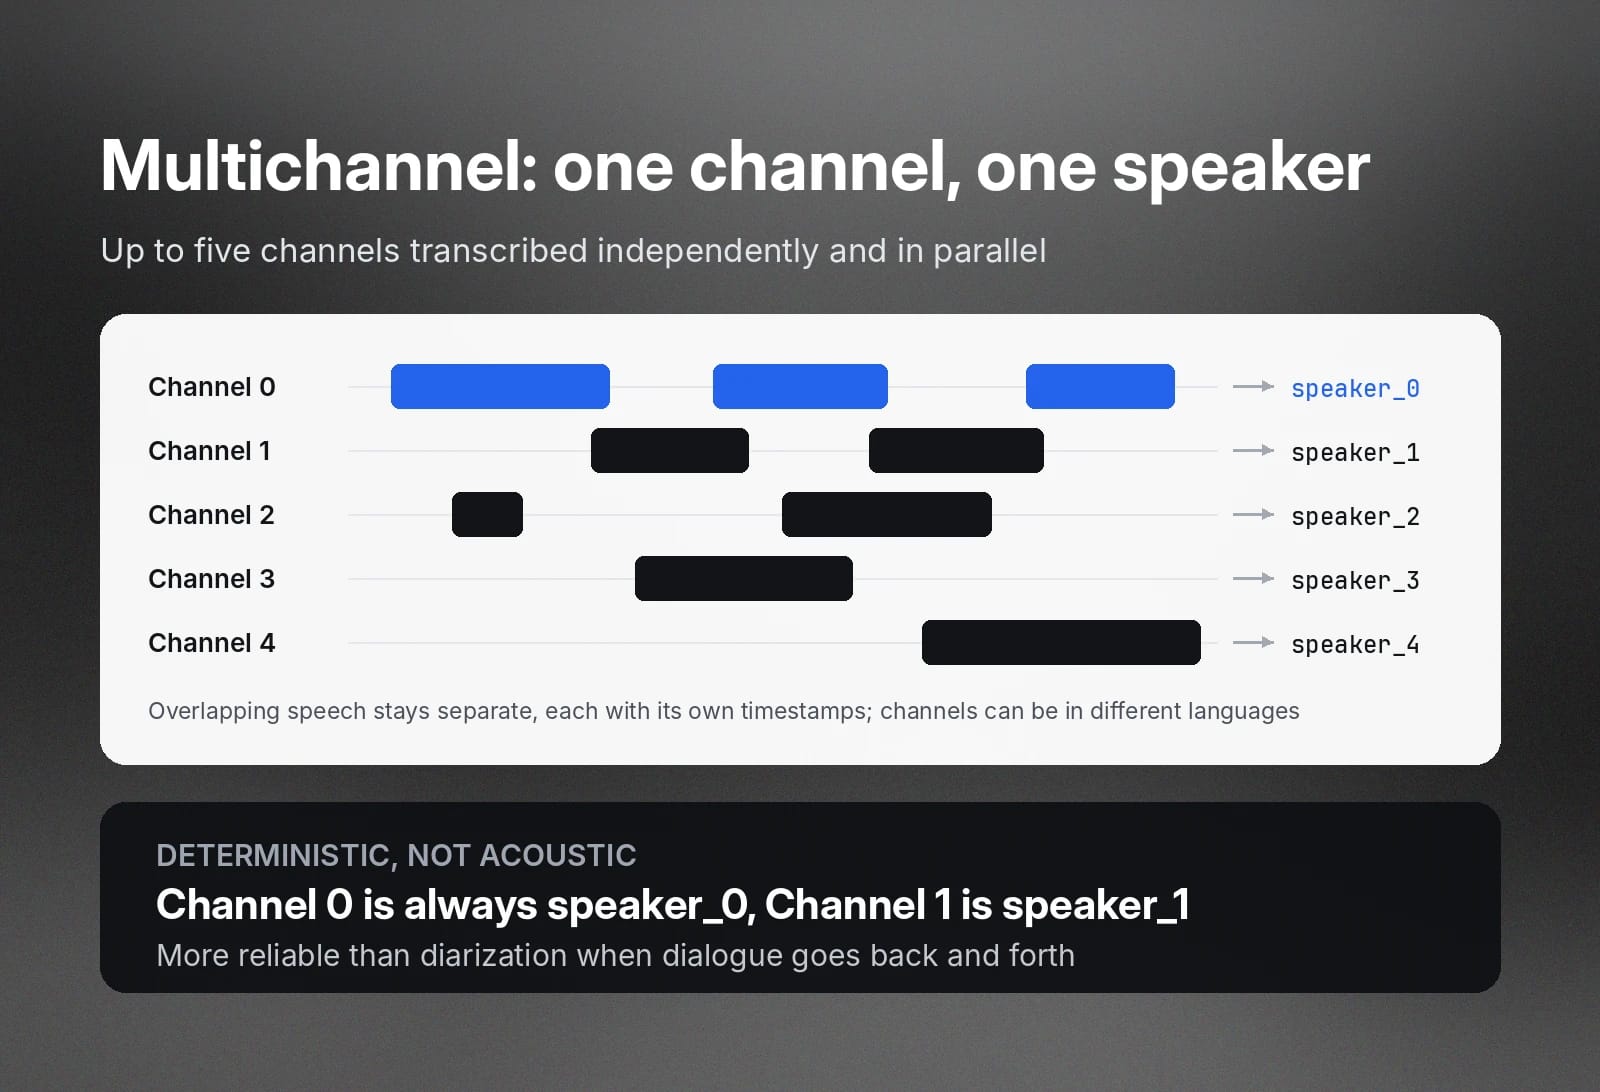
- Scribes transkribering på ordnivå stöder upp till fem kanaler, som transkriberas oberoende av varandra.
Vad är ljudtranskribering med tidsstämplar och händelsetaggar?
Transkribering med tidsstämplar är en form av automatisk taligenkänning (ASR) som spårar exakta start- och sluttider för ord och andra ljudhändelser, som applåder, medan den transkriberar. Resultatet är helt strukturerad, navigerbar data.
Traditionell ASR-transkribering tolkar ljud som stora block av läsbar text. Den ger dig undertexter och ett transkript för mänskliga läsare, men är inte särskilt användbar som data.
Om du vill strukturera den med tidsstämplar måste du köra den genom en sekundär maskininlärningstjänst för att koppla texten till ljudet. Du kan till slut skapa liknande utdata, men det kräver flera bearbetningssteg i stället för att komma direkt från API:et, vilket innebär viss fördröjning och extra beräkningskostnad.
Navigering i ljud
Den viktigaste fördelen med transkribering med tidsstämplar och händelsetaggar är att den kan läsas av både människor och maskiner. Det har flera viktiga användningsområden för företag:
- Granskning av efterlevnad: Du kan söka i en transkribering efter nyckelord och få exakta tidsstämplar för varje omnämnande av känsliga data.
- Videoproduktion och redigering: Program för videoproduktion kan synkronisera undertexter med det som sägs på skärmen, på millisekunden. De kan också märka upp publikreaktioner på rätt sätt.
- Sökbara arkiv: Team inom bland annat PR, försäljning och utbildning kan transkribera stora mängder kundintervjuer, tal på mässor, webbinarier eller öppna möten till omfattande, sökbara arkiv.
- Marknadsanalys och kundsentiment: Händelsetaggning kan märka upp publikreaktioner som annars kan gå förlorade i grundläggande texttranskribering.
Vilka är fördelarna med inbyggda tidsstämplar på ordnivå?
Vanliga speech to text-modeller bearbetar tal i segment, vanligtvis hela meningar eller stycken. Om du vill ha tidsstämplar ord för ord behöver du bygga ytterligare ett bearbetningslager som utför så kallad forcerad justering i en andra omgång. Det kräver mer infrastruktur, ger fördröjning och skapar fler möjliga felpunkter. Exempelvis kan tidsstämplarna glida eller processen misslyckas helt vid snabbt tal eller tal som överröstas av högt bakgrundsljud.
Transkribering med tidsstämplar, som Scribe kan utföra, löser detta genom att transkribera på en mer detaljerad nivå, ord för ord. Det sker i ett enda API-anrop. Ingen extra infrastruktur eller skriptning krävs. Modellen beräknar tidsstämplar medan den transkriberar, så taldatan motsvarar alltid ljudet exakt.
Hur fungerar transkribering med tidsstämplar och händelsetaggar?
Vi använder Scribe som exempel.
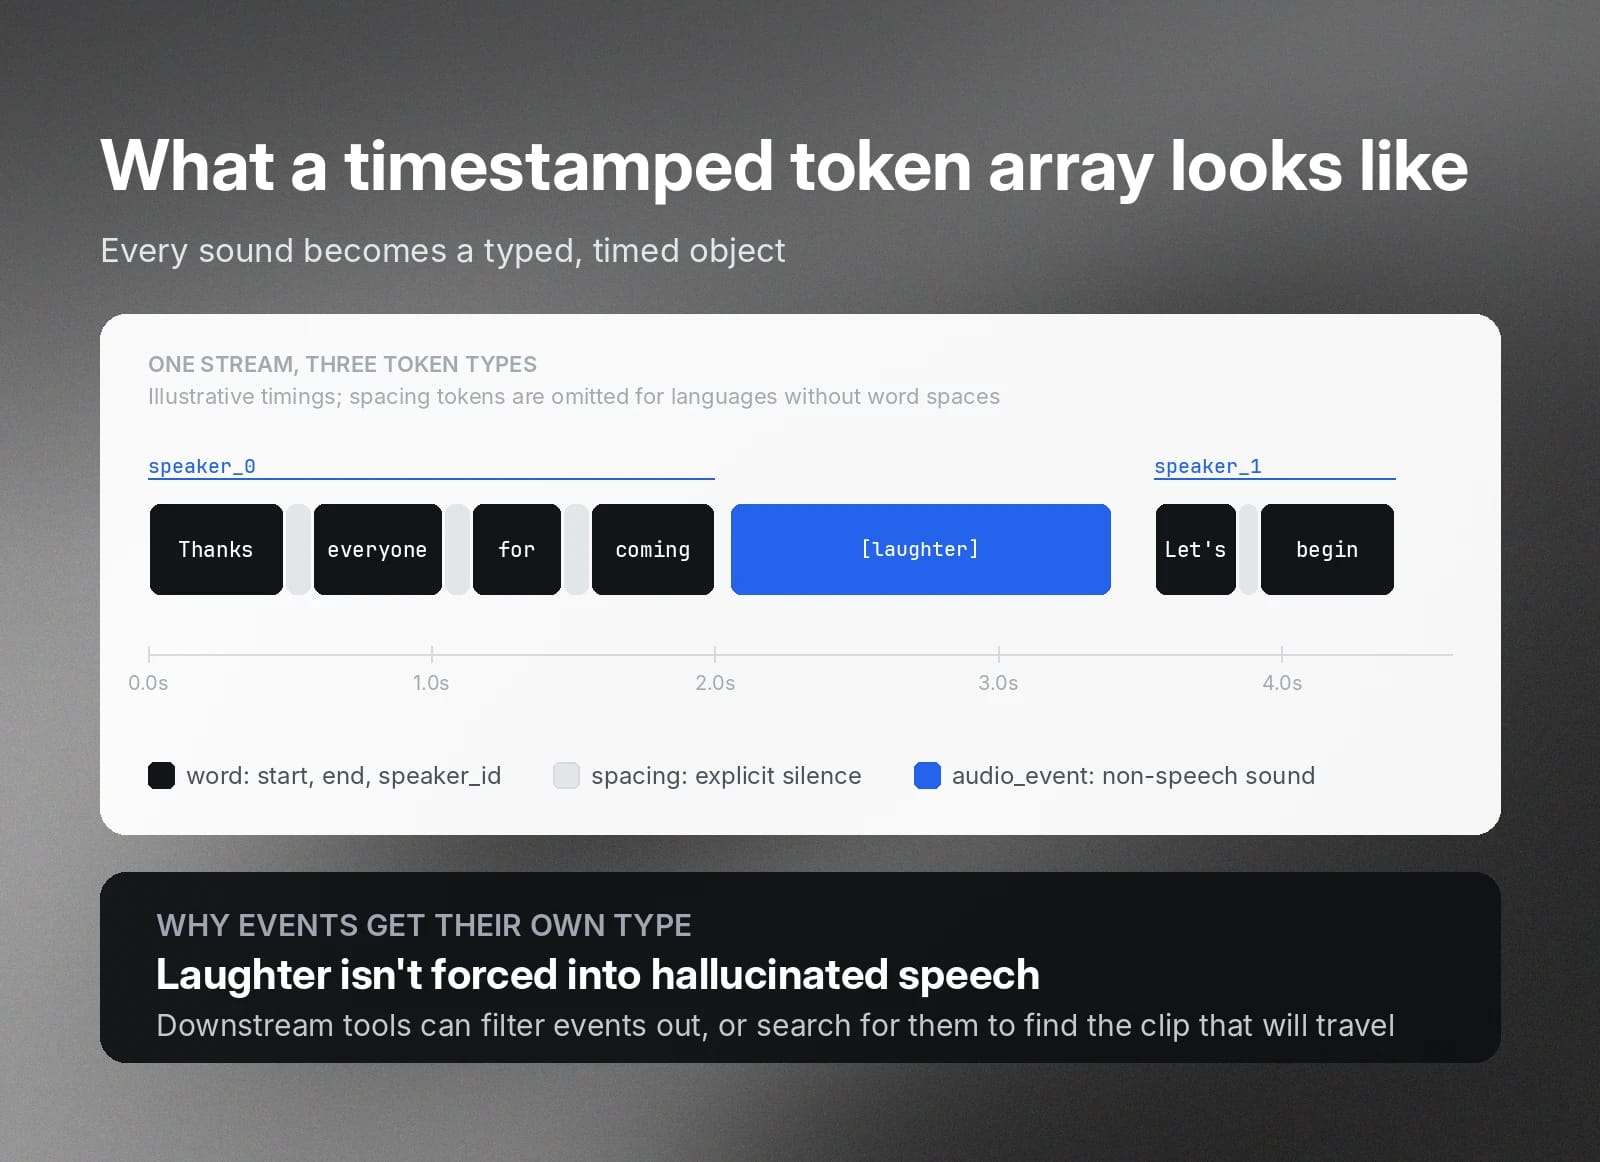
En inbyggd transkriptionsmodell på ordnivå omvandlar talljuden i ett ljudflöde till en strukturerad array med tokenobjekt. Den märker varje token som en av tre typer: word, spacing eller audio_event.
- word: Ett igenkänt, enskilt talat ord med angivna start- och sluttider samt taggen speaker_id.
- spacing: Explicit taggad tystnad eller pauser mitt i talet. Användbart för att hjälpa textningstjänster att hålla rätt tempo. Används inte för identifierade språk som saknar mellanrum mellan ord, exempelvis japanska, mandarin, thailändska, lao, burmesiska och kantonesiska.
- audio_event: Betydelsefulla icke-verbala ljud, som skratt eller applåder. Modellen strukturerar dessa som en separat händelsetyp och tvingar inte in ljudet i hallucinerat tal.
Parametrar för realtidsströmning
Transkriptionsmodeller på ordnivå kan också innehålla specialfunktioner som stöder direktljudtranskribering via WebSocket. Till exempel:
- include_timestamps=true: Den här parametern gör att anslutningen inkluderar tidsstämplar på ordnivå i JSON-meddelandena committed_transcript_with_timestamps som skickas i slutet av varje slutfört ljudsegment, så att du får tidsstämplar medan strömmen fortfarande körs. Taggar för ljudhändelser inkluderas bara om tag_audio_events också är aktiverad.
- include_language_detection=true: Den här parametern instruerar anslutningen att märka upp olika upptäckta talspråk tillsammans med modellens konfidenspoäng för identifieringen. Det hjälper dig att köra textning på flera språk live.
Hur taggar en Speech to Text-modell händelser utan tal?
Scribe taggar ljudhändelser när du har aktiverat parametern tag_audio_events. Då taggar modellen och tidsstämplar specifika start- och sluttider precis som för ord. Den kan tagga flera olika reaktioner, oftast skratt och applåder, men även andra omgivningsljud som kan vara relevanta i sammanhanget, till exempel fotsteg eller bakgrundsmusik.
Det gör omedelbart transkript och textning mer innehållsrika genom att lägga till viktig kontext. Sarkasm kan vara svårare för en läsare att uppfatta i enkel, platt text. En [laughter]-tagg berikar transkriptet och gör det mer känslomässigt uttrycksfullt.
Bättre analys
Händelsetaggning gör också efterföljande analys renare, eftersom verktygen inte behöver tolka ett enda block av ostrukturerad text. Inbyggd transkribering på ordnivå separerar ljudhändelser som strukturerad data, så att dina verktyg kan filtrera bort dem vid behov och arbeta med enbart verbalt innehåll.
Eftersom spacing-token gör pauser synliga kan du analysera dem. Det kan vara värdefullt för sentimentanalys och QA-användning, till exempel för att mäta hur länge en kundtjänstmedarbetare var tyst under ett samtal.
Enklare sökning efter tidsstämplar
Du kan också söka specifikt efter dem. Om du gör sentimentanalys av en intervju om produkttestning kan du plocka ut betydelsefulla känslomässiga reaktioner. Eller om du driver ett konto på sociala medier kan du snabbt söka efter skratt i ett timslångt tal för att hitta de klipp som du tror har störst chans att bli virala.
Vilka praktiska användningsområden finns för strukturerade transkript med tidsstämplar?
Att få strukturerad data direkt i transkriberingar har flera viktiga användningsområden.
Generering av bildtexter och undertexter
Du kan exportera transkript med tidsstämplar direkt till produktionsformat för textning, inklusive SRT och VTT, utan mellanliggande bearbetning. Ditt videoredigeringsverktyg kan använda ordens tidsangivelser för att markera ord i undertexterna när de sägs.
Transkriptionsmodellen kan enkelt tolka snabbt tal eftersom den bearbetar det ord för ord. Där en traditionell modell kan få problem med snabbt tal eller överlappande röster, kan en modell på ordnivå som Scribe ge en ren, strukturerad transkribering.
Sökning i ljud och video
Traditionell transkribering låter dig matcha nyckelord i textblocket, men utan forcerad justering kan du inte hoppa till ögonblicket då en fras sades. En nyckelordssökning i en transkribering på ordnivå är fullt indexerad och tar dig direkt till den sekund då frasen sades i ljudet. Det förvandlar i praktiken ditt ljudarkiv till en helt sökbar referenskatalog. Funktionen är särskilt användbar för att hantera stora mediebibliotek, podcastnätverk och företagsarkiv.
Granskning av efterlevnad och risk
Ofta vill du spela in ljud som innehåller känslig information, till exempel kundtjänstsamtal för QA. Det är också de samtal som troligast innehåller känsliga eller reglerade personuppgifter.
För att följa reglerna och samtidigt ha ljuddata för analys behöver du kunna maskera känsliga data från transkript i realtid. Inbyggda tidsstämplar på ordnivå gör att du kan använda funktioner som ElevenLabs Entity Detection, som flaggar känsliga entiteter, till exempel kreditkortsnummer eller namn, och returnerar deras förskjutningar och tidsstämplar så att du kan dölja dem i transkripten medan de strömmas in.
Du kan till exempel upptäcka och maskera ett kreditkortsnummer, moderns flicknamn, födelsedatum och kundens namn när de sägs i ett samtal för identitetsverifiering.
Automatiserad klippning för sociala medier
Du kan även automatisera nyckelordssökningar programmatiskt för att hitta höjdpunkter i längre innehåll. Du kan till exempel lyfta viktiga ögonblick från ett kampanjtal eller ett företagsseminarium. Det hjälper dig att förvandla aktuellt innehåll till professionellt redigerade höjdpunkter för YouTube, LinkedIn eller TikTok.
Tidsangivelser för flera kanaler och talare
Scribe kan transkribera upp till fem kanaler oberoende och parallellt. Varje kanal får ett tilldelat talar-ID och tidsstämplar. Detta är mer tillförlitligt än vanlig akustisk talarseparering, som ofta har svårt med dialoger fram och tillbaka. För flerkanalsinspelningar är Scribes talartilldelning helt deterministisk. Det betyder att kanal 0 mappas till speaker_0, kanal 1 till speaker_1 och så vidare.
Scribe kan känna igen talare som försöker prata samtidigt och ändå skapa oberoende tidsstämplar för deras tal. De kan också tala olika språk.
Exportera tidsstämplad data i det format du behöver
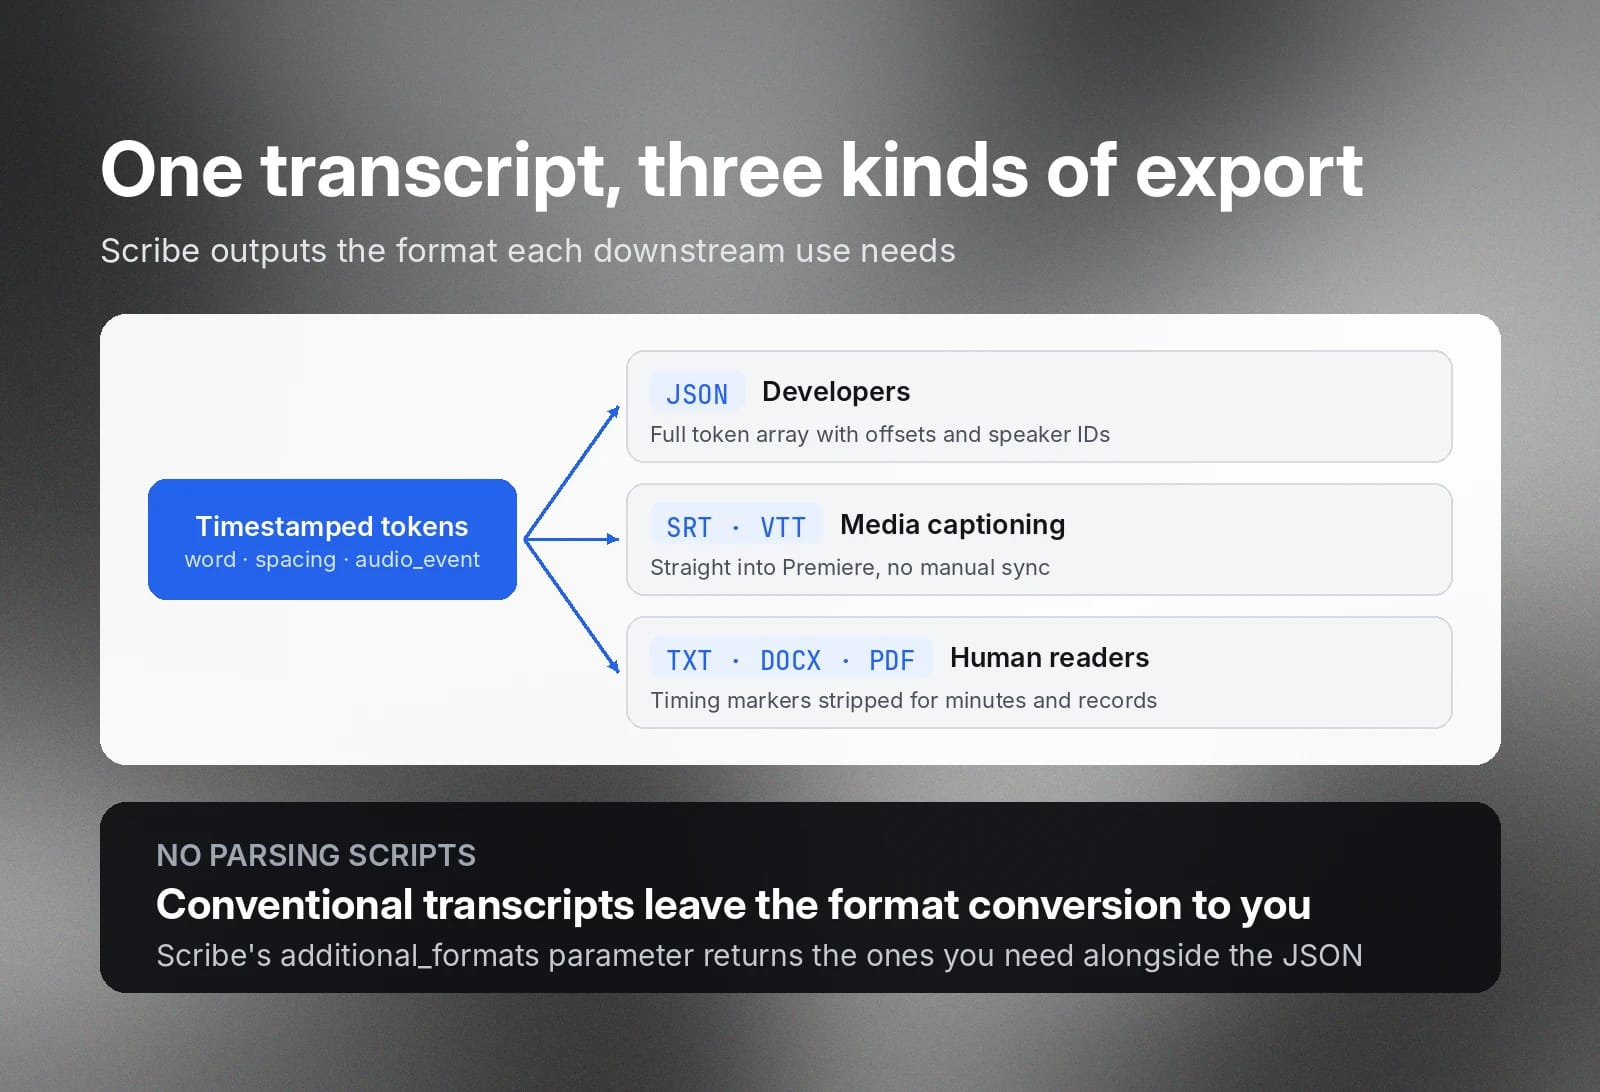
Om du vill distribuera traditionella transkriberingar i flera format behöver du troligen skriva tolkningsskripten själv. Scribe kan exportera transkriberingar i flera format, beroende på hur du ska använda dem. Du hittar fullständiga schemadefinitioner i ElevenLabs Create Transcript API-referens.
Strukturerad data för utvecklare: JSON
Scribe stöder export till JSON för utvecklare som vill ha data i ett schema som kan skickas till efterföljande applikationer. Utvecklare kan till exempel använda JSON-datan för att skapa interaktiva medier eller en databas för semantisk sökning i organisationen. Hela arrayen med token av typen word, spacing och audio_event exporteras med start- och slutförskjutningar samt talar-ID:n.
Medietextning: SRT och VTT
Scribe kan ge ut SRT- och VTT-transkript som du kan mata direkt till Adobe Premiere eller andra produktionsapplikationer utan manuell synkronisering.
Läsbart för människor: TXT, DOCX och PDF
Scribe kan också ge ut transkript i läsvänliga format. I dessa format tar Scribe bort tidsmarkörer på låg nivå för att göra texten mer lättläst och lämplig för juridisk dokumentation eller revisionsdokumentation. Det är till exempel användbart när du behöver distribuera protokoll från styrelsemöten effektivt direkt efter ett möte, publicera podcasttranskript för SEO eller arkivera juridiska dokument.
Börja använda ElevenLabs transkriberingar med tidsstämplar och händelsetaggar
Inbyggd transkribering på ordnivå ger dig snabbt och effektivt den strukturerade data du behöver för dina workflows.
Kom igång i dag med att transkribera ditt ljud med Scribe i ElevenAPI eller läs mer om transkribering på ordnivå.
Vanliga frågor om tidsstämplar och transkribering med händelsetaggar

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.


