
Vad är talardiarisering? Så fungerar det och vanliga användningsområden
- Skriven av
- Jack Limebear
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
Talardiarisering tar en ljudström med ett okänt antal talare och skapar en tidslinje med märkta segment: talare A från 0:00 till 0:42, talare B från 0:42 till 1:15 och talare A igen från 1:15 och framåt. Systemet vet inte vilka talarna är, men det vet att de är olika personer och håller deras etiketter konsekventa genom hela inspelningen.
Det här är processen som gör ljud med flera talare användbart. Mötesanteckningar, kontaktcenter-analys, intervjutranskribering, poddredigering och juridiska handlingar kräver alla att man inte bara vet vad som sades, utan också vem som sa det.
I den här guiden förklarar vi hur diariseringsprocessen fungerar, hur den skiljer sig från närliggande tekniker som segmentering och identifiering, vilka open source-verktyg som hanterar den och hur du mäter om ett diariseringssystem fungerar bra.
Sammanfattning
- Talardiarisering delar upp en ljudinspelning utifrån vem som talar och skapar märkta talsekvenser utan att identifiera någon med namn.
- Talardiarisering skiljer sig från talarsegmentering, som hittar när talaren byts, och talaridentifiering, som kopplar röster till riktiga namn.
- Diariseringens prestanda mäts med diarization error rate (DER) för övergripande noggrannhet och Jaccard error rate (JER) för att kontrollera att noggrannheten håller för varje talare.
Vad är talardiarisering och hur fungerar det?
Talardiarisering är processen att dela upp en ljudström i segment utifrån vem som talar. En transkription med talardiarisering märker varje ljudsegment med en talaridentitet. Enkelt uttryckt besvarar den frågan ”Vem sa vad när?”
En rå transkription av ett möte ger dig orden, medan en diariserad transkription visar att talare 1 ställde frågan, talare 2 svarade på den och talare 3 avbröt halvvägs.
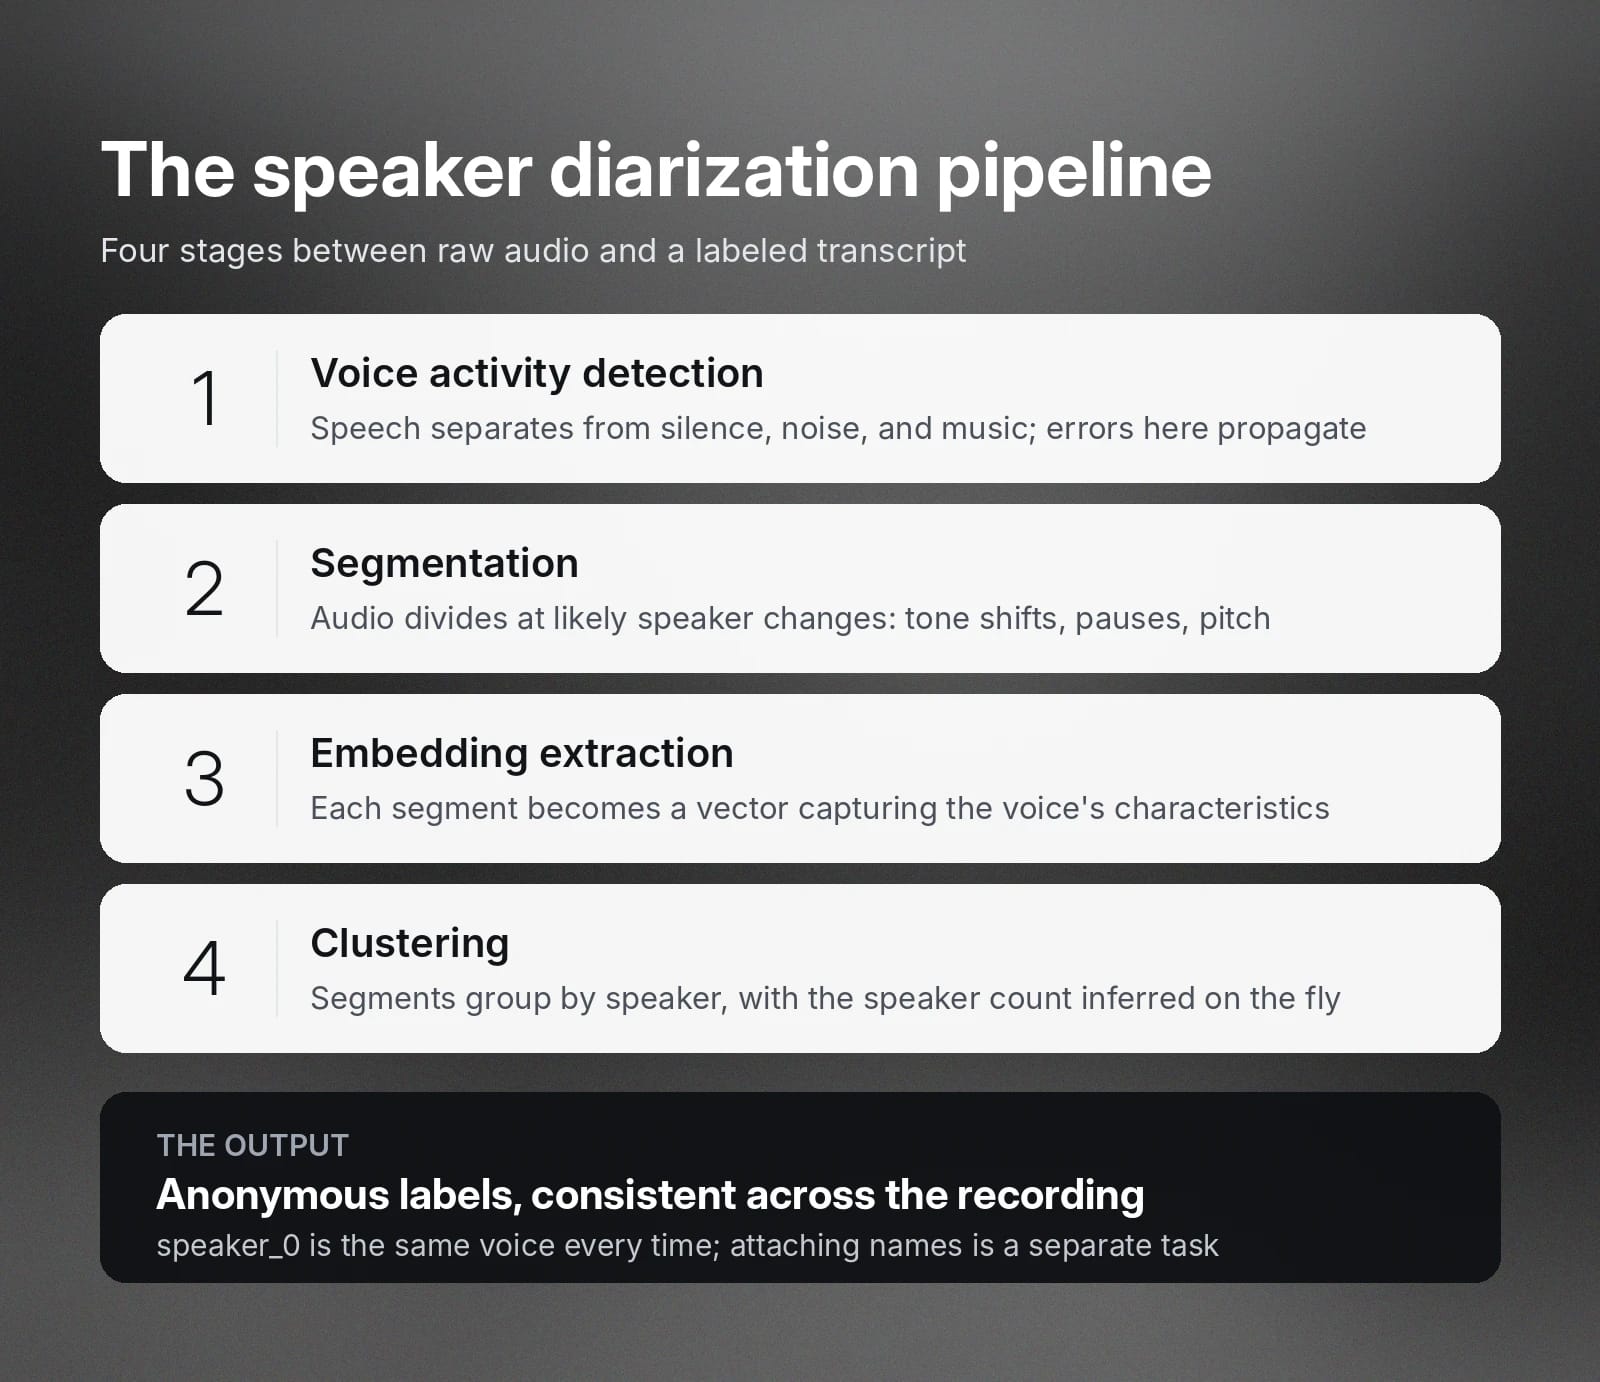
De flesta system för talardiarisering följer en pipeline med fyra steg:
Låt oss gå igenom stegen mer i detalj.
Talaktivitetsdetektering (VAD)
Talaktivitetsdetektering skiljer tal från allt annat: tystnad, bakgrundsbrus, musik, eller tangentbordsklick. Bara ljudsegment som innehåller faktiskt tal går vidare till nästa steg.
Eventuella fel i det här steget fortplantar sig genom resten av stegen.
Segmentering
Segmenten som innehåller tal delas sedan vid punkter där talaren sannolikt byts, till exempel vid en förändring i röstläge, en paus mellan turer eller ett ändrat tonhöjdsmönster. De flesta system upptäcker dessa brytpunkter direkt genom att jämföra de akustiska egenskaperna på båda sidor om en möjlig gräns.
Vissa segmenteringsverktyg delar ljudet i korta, enhetliga fönster, till exempel tvåsekunderssegment, och förlitar sig sedan på klustringssteget för att slå ihop angränsande fönster som tillhör samma talare.
Extrahering av inbäddningar
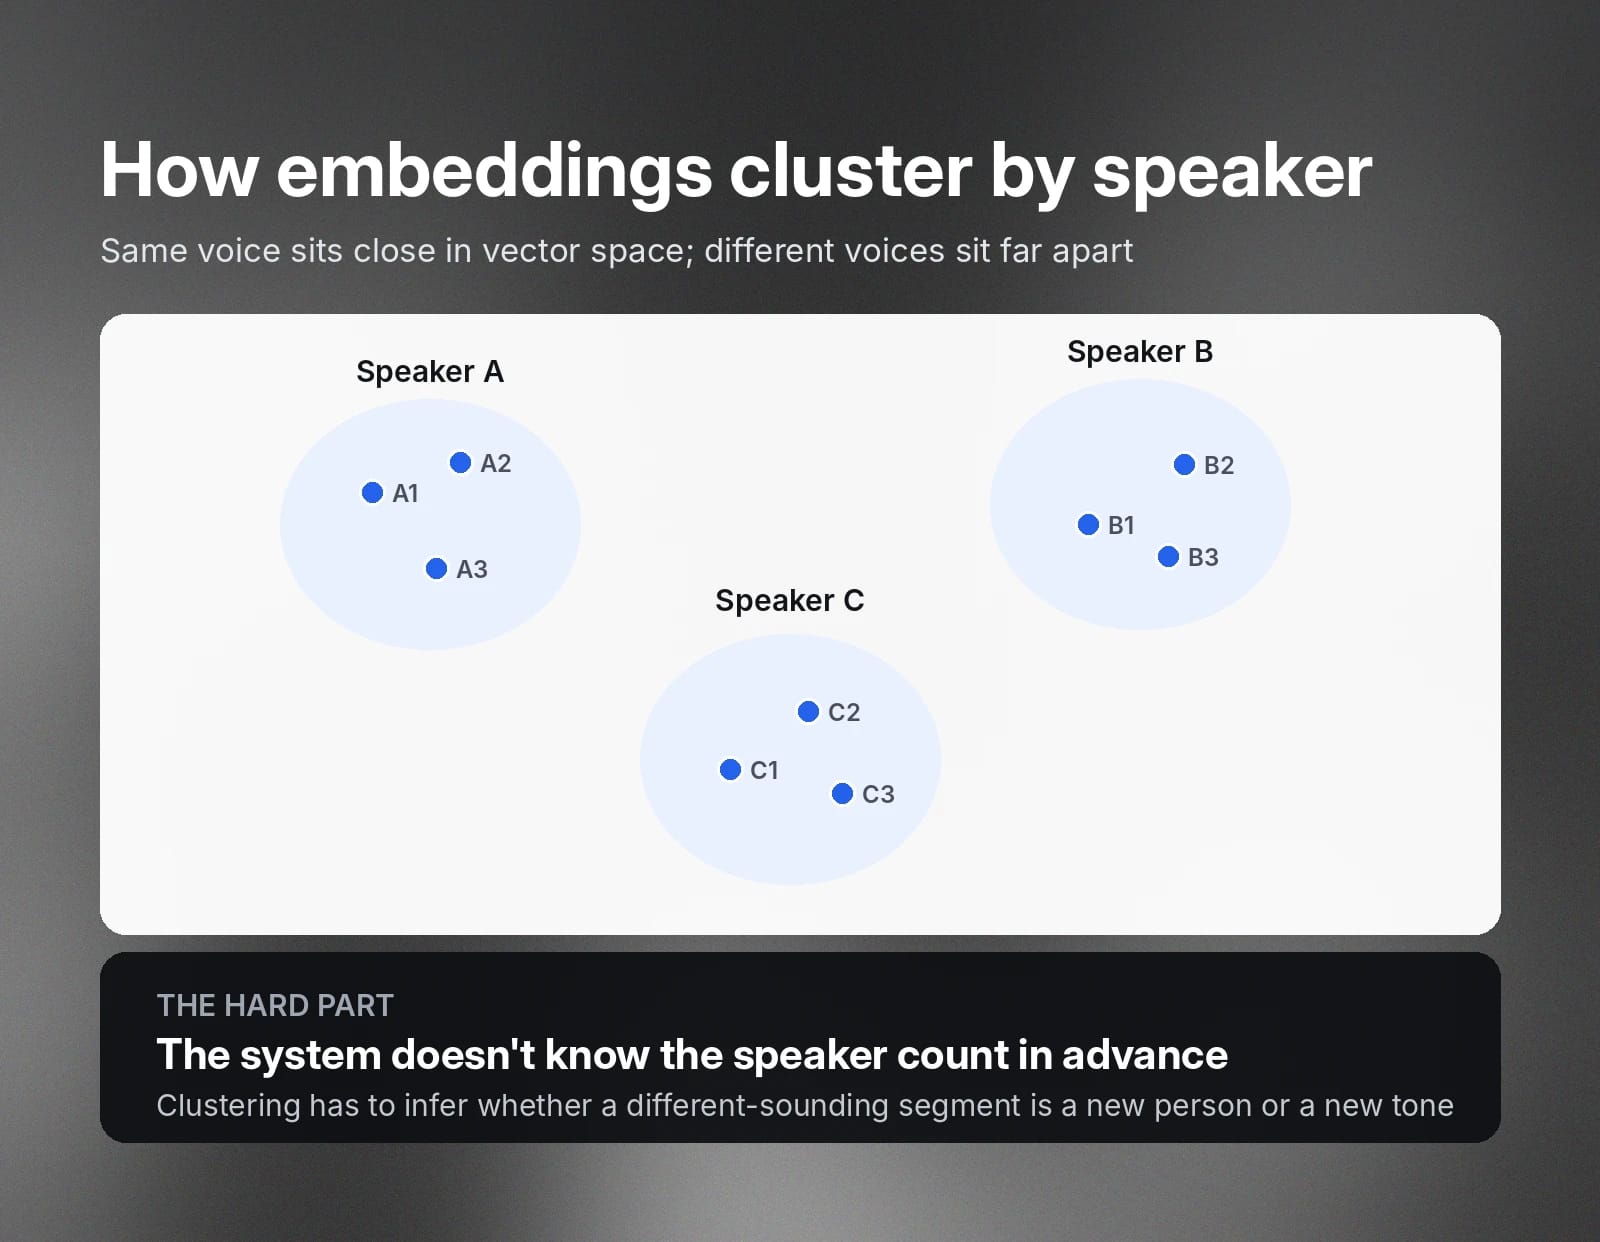
Varje talsegment omvandlas till en talarinbäddning, alltså en numerisk vektor som fångar röstegenskaperna hos den som talar i segmentet. Inbäddningar från samma talare hamnar nära varandra i vektorrummet, medan inbäddningar från olika talare ligger längre ifrån varandra.
Klustering
Inbäddningarna grupperas sedan så att segment från samma talare får samma etikett. Systemet känner vanligtvis inte till antalet talare i förväg, så klustringsalgoritmen måste härleda det och avgöra om ett segment som låter lite annorlunda kommer från en ny talare eller från samma person med en annan ton.
Resultatet är en uppsättning talaretiketter kopplade till tidsintervall, vanligtvis tillsammans med en transkription. En diariserad transkription från ett samtal mellan två personer kan till exempel se ut så här:
- [speaker_0] Tack för att du ringer. Hur kan jag hjälpa dig?
- [speaker_1] Hej, jag ringer angående min faktura från förra månaden.
- [speaker_0] Absolut, jag tar fram den.
Etiketterna är anonyma och internt konsekventa. Speaker_0 är samma röst varje gång den förekommer, men systemet vet inte att speaker_0 heter Fergal. Att koppla till verkliga identiteter är en annan uppgift, som vi går igenom nedan.
Viktiga skillnader mellan talarsegmentering och talaridentifiering
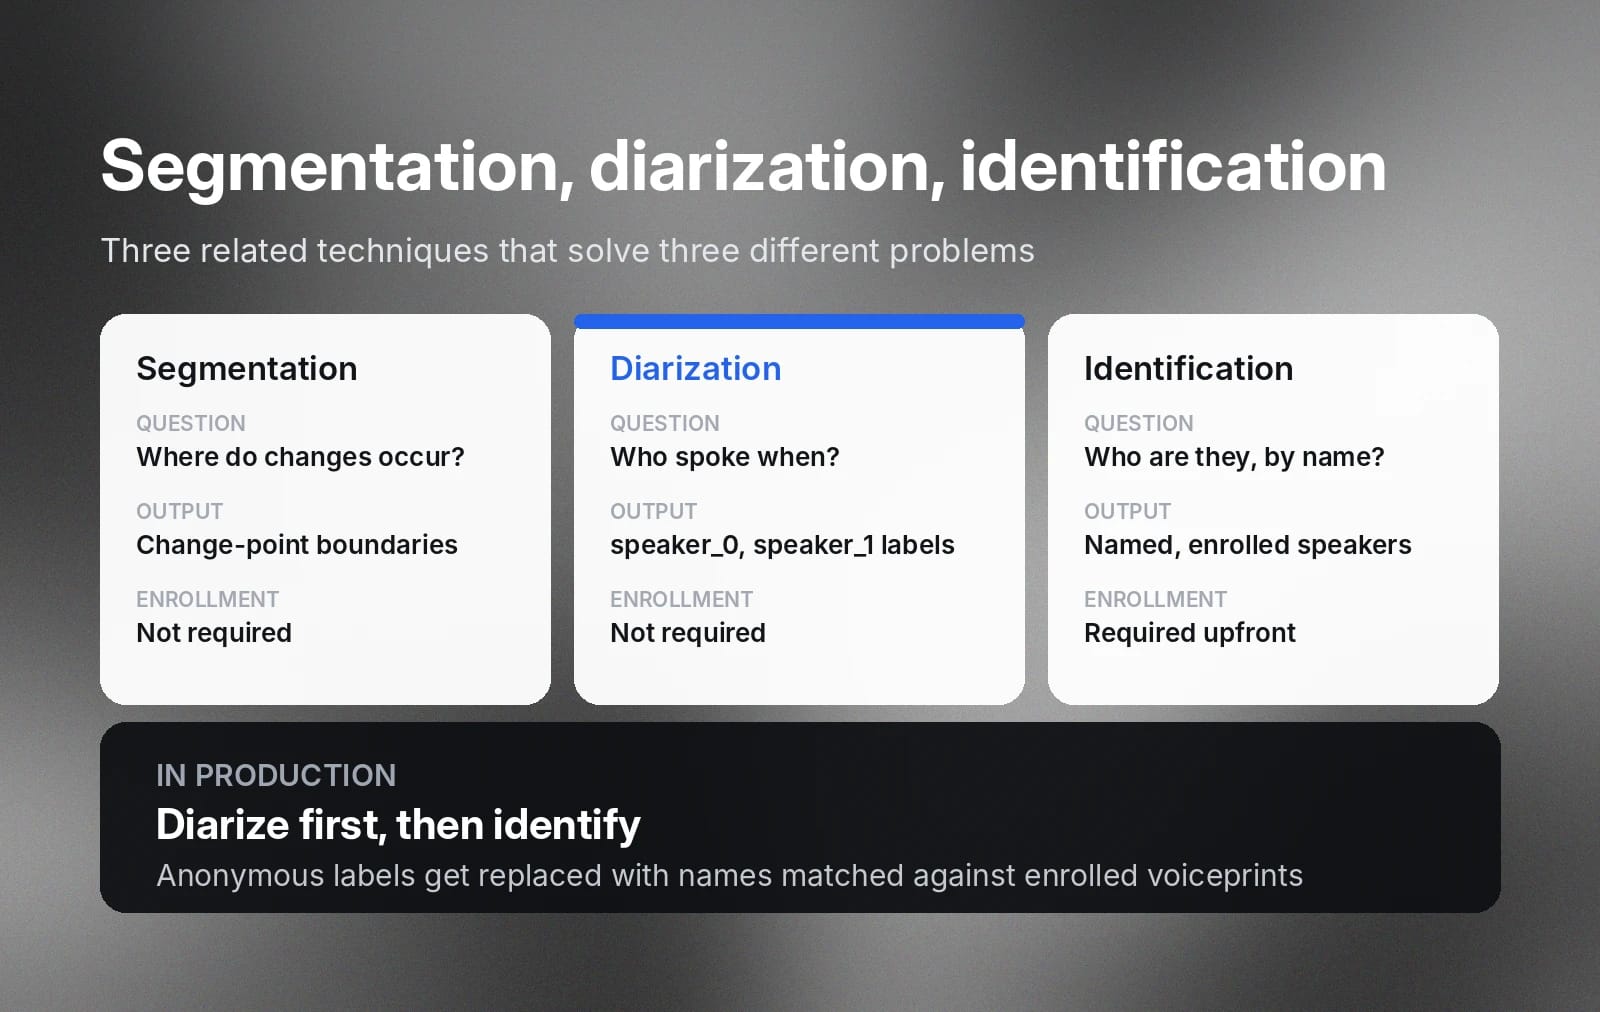
Talarsegmentering och talaridentifiering överlappar båda nära med diariseringsprocessen, vilket innebär att de tre ofta blandas ihop.
De löser alla ett lite annorlunda problem, så det är viktigt att förstå skillnaden när du utvärderar verktyg.
Som vi förklarade tidigare är talarsegmentering ett steg i diariseringsprocessen som sker tidigt i pipelinen. Den hittar gränserna där talaren byts från en röst till en annan, utan att tilldela etiketter. Segmentering berättar att en förändring skedde vid 0:42. Diarisering bygger vidare på detta genom att gruppera de resulterande segmenten och skapa ett helt märkt resultat, så att du vet att rösten vid 1:15 är densamma som talade i början av inspelningen.
Talaridentifiering är en separat funktion utanför diariseringsprocessen, men kombineras ofta med den. Identifiering avgör vilka talarna faktiskt är. Ett identifieringssystem jämför röster med registrerade röstprofiler och använder en referens med kända talare för att återge identiteter. Efter identifieringen blir speaker_0 och speaker_1 ”Fergal” och ”Eric”.
Många produkter kombinerar dessa verktyg för att skapa en mer komplett slutlig transkription. Ett mötesverktyg kan göra detta automatiskt, eventuellt genom att hämta namn som någon har angett i Teams eller Meet, så att varje deltagares bidrag tillskrivs med namn utan manuell granskning.
Populära open source-verktyg och bibliotek för talardiarisering
Open source-verktyg för talardiarisering är värda att överväga när du behöver kontroll, flexibilitet eller lokal driftsättning. Det bästa valet beror på vilken typ av ljud du hanterar – telefonsamtal, möten, poddar eller sändningar – dina latenskrav och hur mycket utvecklingstid du kan investera.
Här är några av de populäraste alternativen.
Pyannote.audio
Pyannote.audio är ett PyTorch-baserat verktygspaket som är byggt specifikt för talardiarisering och ett av de mest använda open source-alternativen. Det erbjuder förtränade pipelines som täcker hela diariseringsstacken, inklusive VAD, segmentering, inbäddningar och klustring, samt byggstenar för att träna eller finjustera modeller på dina egna data.
Dess förtränade modeller distribueras via Hugging Face och används ofta som diariseringslager i större transkriberingsprojekt.
WhisperX
WhisperX kombinerar OpenAI:s Whisper ASR med diariseringsprocess och forcerad justering. Whisper på egen hand ger bra transkriptioner, men tilldelar inga talaretiketter och dess tidsstämplar är bara ungefärliga. WhisperX lägger till justering av tidsstämplar på ordnivå och integrerar pyannote-baserad diariseringsprocess, vilket ger transkriptioner där varje ord har både en korrekt tidsstämpel och en talaretikett.
NVIDIA NeMo
NVIDIA NeMo inkluderar diariseringsprocess som en del av sitt bredare ramverk för Conversational AI. Det erbjuder träningsbara modeller för diariseringsprocess, inklusive end-to-end-metoder som hanterar överlappande tal, och är utformat för team som bygger skräddarsydda talsystem i stor skala på GPU-infrastruktur.
Var och en av dessa verktyg kräver att du hanterar infrastrukturen för diariseringsprocessen, inklusive modelldistribution, skalning, övervakning och uppdateringar. För team som inte vill ha den operativa belastningen erbjuder hanterade API:er för talardiarisering ett enklare alternativ. De kan antingen integreras med befintliga workflows eller hantera hela diariseringspipelinen, vilket gör dem väl lämpade för produktionsanvändning, till exempel analys av kundtjänst, mötestranskribering och poddbearbetning.
Realtidsdiarisering: utmaningar och användningsområden
Realtidsdiarisering är betydligt svårare än diariseringsprocessen för en färdig inspelning, eftersom systemet måste fatta beslut med ofullständig kontext.
Ett offlinesystem ser hela inspelningen innan det fattar några beslut. Det kan jämföra en röst vid minut 2 med en röst vid minut 40 och tryggt avgöra att det är samma talare, eftersom båda tillfällena är tillgängliga samtidigt. Ett realtidssystem har aldrig den möjligheten, eftersom det måste märka tal i samma ögonblick som det kommer in, utan åtkomst till vad som sägs härnäst och med liten eller ingen möjlighet att ändra ett beslut när det väl har fattats.
Den saknade framtida kontexten gör tre specifika problem mycket svårare att lösa i realtid:
- Latens kontra noggrannhet: Utan möjlighet att se hela konversationen fram och tillbaka sker kortare svarstidsbudgetar direkt på bekostnad av noggrannheten.
- Överlappande tal: När personer pratar i mun på varandra skulle ett system som kan bearbeta ljudet igen kunna reda ut det. Ett realtidssystem måste tvinga in det under en enda etikett eller använda specialiserade modeller som hanterar överlappning direkt.
- Korta yttranden: Ett snabbt ”ja” eller ”kör på” ger knappt systemet tillräckligt med röst att arbeta med och utan omgivande kontext måste det ändå direkt välja en etikett.
Trots svårigheten kan vissa tillämpningar inte vänta på att en inspelning ska bli klar. Liveundertextning för möten och sändningar behöver talaretiketter medan personerna talar. Kontaktcenterprogramvara som ger vägledning till agenter under samtalet måste i realtid veta vilka ord kunden använder. Röstassistenter som hanterar samtal med flera deltagare måste utan fördröjning hålla reda på vem som frågar vad. I varje fall är ett system som är lite mindre korrekt men omedelbart bättre än ett som är mer korrekt men fördröjt.
För arbetsbelastningar som inte verkligen kräver realtidsetiketter, som analys, efterlevnadsgranskning och transkriptgenerering, är batchdiarisering fortfarande det bättre valet eftersom den är betydligt mer exakt.
Så utvärderar du talardiariseringens prestanda
Två mått är viktigast när du mäter noggrannheten i diariseringsprocessen: diarization error rate (DER), som fångar den övergripande noggrannheten, och Jaccard error rate (JER), som kontrollerar om noggrannheten håller för varje talare.
DER beräknar specifikt den andel av den totala taltiden som har tillskrivits felaktigt. Det omfattar tre typer av fel:
- Falskt larm för tal: Systemet märkte ett segment som tal när ingen talade.
- Missat tal: Någon talade, men systemet märkte det som tystnad.
- Talarförväxling: Tal upptäcktes men tillskrevs fel talare.
DER = (falskt larm + missat tal + talarförväxling) / total tallängd
Ett DER på 10 % innebär att felen motsvarar en tiondel av den totala taltiden, fördelat på dessa tre typer. Lägre är bättre, och resultat är bara jämförbara när de mäts på samma data under samma förhållanden. DER varierar kraftigt beroende på ljudkvalitet, antal talare och hur mycket överlappning inspelningen innehåller.
Jaccard error rate (JER) mäter diariseringsnoggrannheten för varje talare separat och räknar sedan ut genomsnittet för alla talare. För varje referenstalare matchar utvärderaren systemets närmaste talaretikett och jämför tiden då de överlappar korrekt med den totala tid som tilldelats någon av talarna.
Föreställ dig till exempel ett 60 minuter långt möte där talare A talar i 50 minuter och talare B i 10. Ett diariseringssystem märker 48 av talare A:s 50 minuter korrekt, men bara 4 av talare B:s 10 minuter korrekt. Det övergripande DER-värdet kan ändå se relativt bra ut eftersom talare A står för större delen av mötet. JER gör att talare B:s svaga resultat väger lika tungt, eftersom det utvärderar talare A och talare B oberoende av varandra innan deras resultat beräknas som ett genomsnitt.
JER_speaker = 1 - (correct_overlap / (ref_time + sys_time - correct_overlap))
Det slutliga JER-värdet är genomsnittet av dessa felsatser per talare:
JER = (1 / N) * Σ[JER_speaker_i] där i = 1..N
Genom att följa både DER och JER får du en mer komplett bild av hur exakt diariseringsprocessen är: DER för övergripande noggrannhet och JER för om den noggrannheten håller för varje deltagare, även personer som talar mer sällan.
Testning på ljud som representerar produktionen
När du utvärderar ett system för talardiarisering ska du beräkna både DER och JER på ljud som motsvarar dina faktiska driftsförhållanden: ditt typiska antal talare, din ljudkvalitet och mängden överlappande tal.
Publicerade benchmarkresultat kan mätas på rena, kontrollerade dataset som studioinspelningar, vilka sällan motsvarar hur verkliga samtalsinspelningar eller livemöten låter. Ett system som presterar bra i benchmarktester kan ändå prestera betydligt sämre på brusigt, överlappande ljud från verkligheten. Testa på dina egna data innan du väljer en produkt för talardiarisering.
Kom i gång med ElevenAPI för talardiarisering
Om du är redo att bygga en transkriberingsfunktion med stöd för flera talare, Scribe v2 från ElevenLabs gör talardiarisering tillgänglig via ett enda Speech to Text-API. Skicka ljud till endpointen med diarize=true, så märker JSON-svaret varje ord med ett talar-ID, för upp till 32 talare, på över 90 språk och i filer på upp till 10 timmar.
Två alternativ utökar standardresultatet från diariseringsprocessen. För samtalsinspelningar märker detect_speaker_roles=true talare som agent och kund i stället för med anonyma nummer. Om din workspace har registrerade talarprofiler kan use_speaker_library=true matcha upptäckta talare med registrerade röster och föra samman diariseringsprocess och identifiering i en enda begäran.
En parameter för diariseringsgränsvärde låter dig justera avvägningen mellan att dela upp talare för mycket och att slå ihop dem. Och när talarna redan är isolerade på separata ljudkanaler, till exempel i stereoinspelningar av samtal, flerkanalstranskribering tilldelar talare per kanal och hoppar helt över diariseringsprocessen.
Guiden Kom i gång med Speech to Text går igenom den första integreringen steg för steg. För reglerade driftsättningar uppfyller plattformen SOC 2, ISO 27001, PCI DSS L1 och HIPAA, med EU-datalagring och ett läge utan datalagring.
Redo att bygga in talardiarisering i dina system? Börja med att hämta din API-nyckel eller titta på ElevenLabs Docs för att läsa mer.
Vanliga frågor

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.


