Kaskad- vs Fuserade modeller: Hur arkitekturen avgör om din röstagent är redo för företag
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
De flesta tror att röstassistenter byggs med antingen en kaskadbaserad eller sammansmält arkitektur. I praktiken utformas assistenter längs ett spektrum mellan de två, och vanligtvis används fem arkitekturer beroende på tillämpningen.
Assistentens arkitektur avgör hur tillförlitligt den fungerar i produktion, hur väl den kan anpassas till specifika verksamhetskrav och hur naturligt den låter i samtal. En fusionsbaserad arkitektur som OpenAI:s Realtime-modell kan låta imponerande verklighetstrogen i korta utbyten. Men när team behöver upprätthålla skyddsräcken för regelefterlevnad, felsöka ett misslyckat svar eller byta till en kraftfullare LLM när en lanseras nästa månad, erbjuder ett enda sammansmält nätverk få möjligheter.
På ElevenLabs använder vi en avancerad kaskadbaserad arkitektur. Vi använder specialiserade komponenter för taligenkänning, resonemang och talgenerering för hög intelligens och tillförlitlighet. Vi lägger till kontextuell prosodi, optimering för låg latens och intelligent turordning så att samtalen flyter naturligt. Vi har byggt den så här eftersom företagen och myndigheterna vi arbetar med behöver assistenter som både låter realistiska och går att lita på i produktion med komplexa uppgifter.
I den här artikeln går vi igenom de fem huvudsakliga arkitekturerna, vad de passar för, var deras begränsningar finns och hur vi ser på grunden för assistenter som används i kritiska arbetsflöden.
Vad team utvärderar när de väljer arkitektur
Frågorna som team brukar ställa delas vanligtvis in i tre kategorier.
Kan den hantera komplexa uppgifter?
- Resonemang och modellflexibilitet: Kan du välja de bästa modellerna för ditt användningsfall, inklusive de mest kraftfulla tillgängliga LLM:erna, och uppgradera när bättre alternativ blir tillgängliga?
- Agentlogik: Kan du definiera och styra de samtalsflöden, beslutsregler och eskaleringsvägar som din assistent följer?
- Användning av verktyg: Kan arkitekturen stödja verktygsanrop i flera steg och integreringar med externa system?
Låter och känns den mänsklig?
- Prosodi: Ger assistenten naturlig rytm, intonation och känslomässig ton?
- Latens: Är svaren tillräckligt snabba för att kännas som ett samtal?
- Turordning: Vet assistenten när den ska prata, pausa eller lämna över ordet?
Kan jag lita på den i produktion?
- Tillförlitlighet: Fungerar assistenten förutsägbart och konsekvent, eller förändras den över tid?
- Skyddsräcken: Kan arkitekturen skydda mot oavsiktliga svar eller antagonistiska användare?
- Transparens: Ger arkitekturen mellanliggande resultat, eller är den en svart låda?
Avvägningarna mellan kaskadbaserade och sammansmälta arkitekturer
Kaskadbaserade arkitekturer byggs genom att kedja samman specialiserade komponenter: Speech to Text (STT), en stor språkmodell och Text to Speech (TTS). Varje steg kan optimeras, testas och uppgraderas oberoende av de andra.
Kaskadbaserad arkitektur
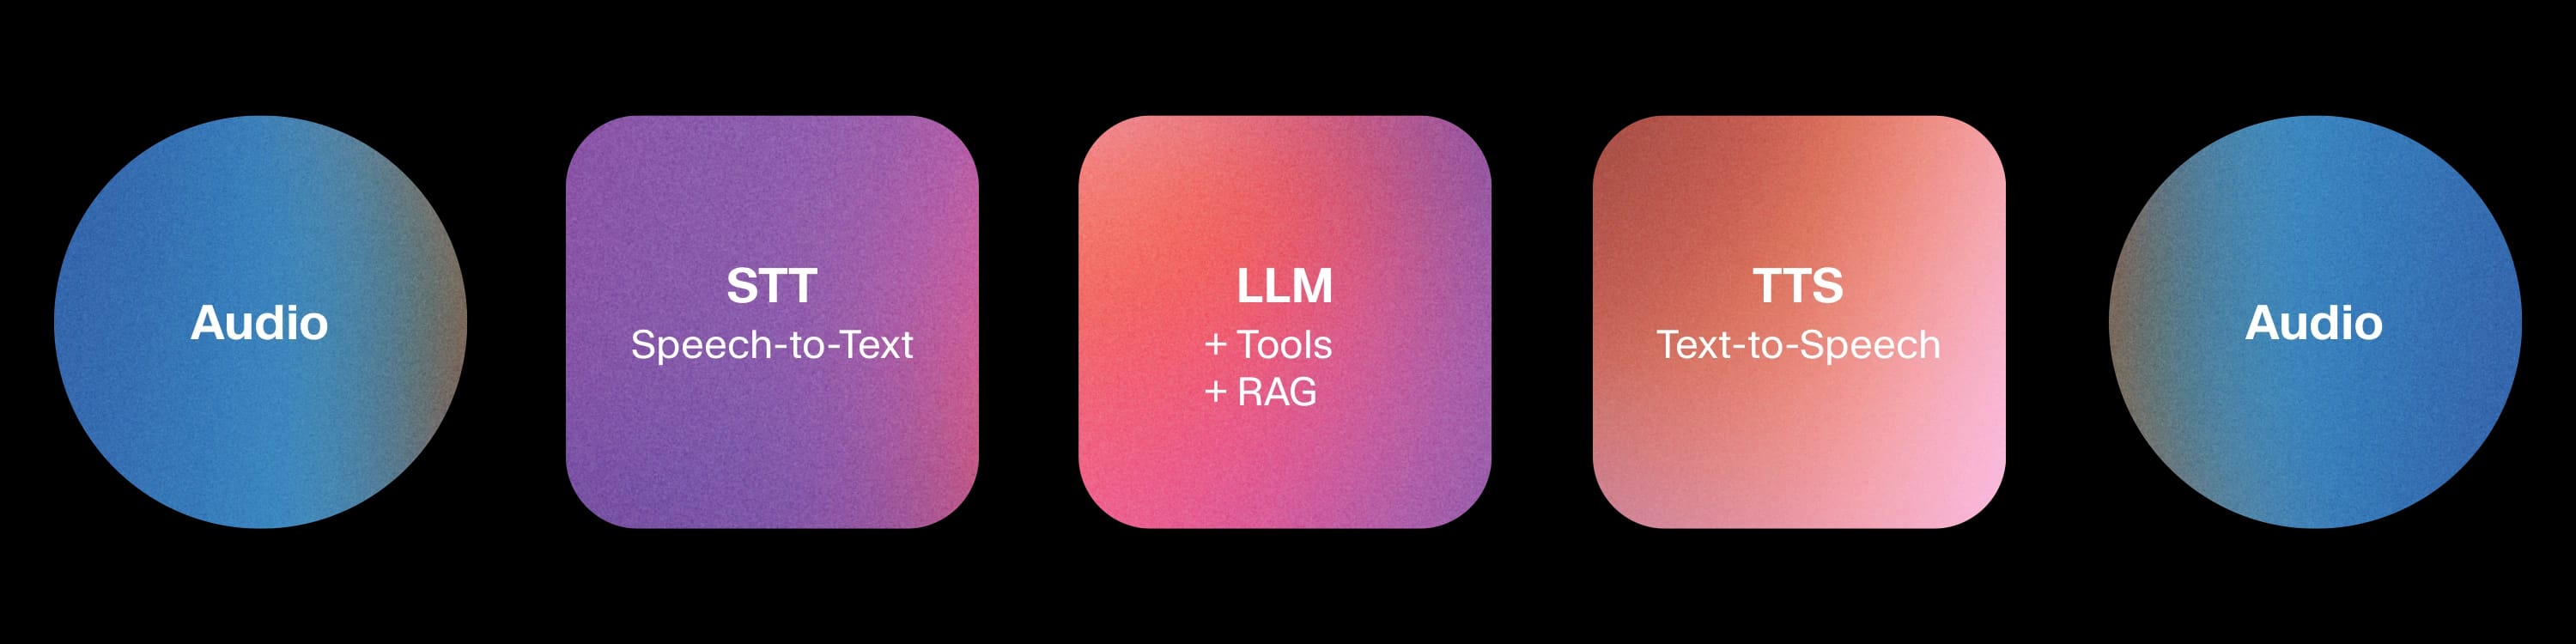
Den modulariteten är det som gör kaskadbaserade arkitekturer till grunden för de flesta assistenter på företagsnivå. Varje steg ger inspekterbara resultat: läsbar text mellan STT och LLM:en samt mellan LLM:en och TTS. Skyddsräcken kan upprätthållas i textlagret, den senaste frontier-LLM:en kan integreras utan att ändra talmodellerna och när något misslyckas går det oftast att identifiera källan till felet.
Den långvariga kritiken mot kaskadbaserade arkitekturer är att de förlorar prosodiska signaler. Tal reduceras till text, och intonation, rytm och känslor måste återskapas i utmatningen. Dessa signaler kan delvis återvinnas genom explicit modellering, men fångas inte lika naturligt som i sammansmälta metoder. Andra aspekter, som latens och turordning, kan vanligtvis optimeras till jämförbara prestandanivåer i båda metoderna.
Sammansmält modell
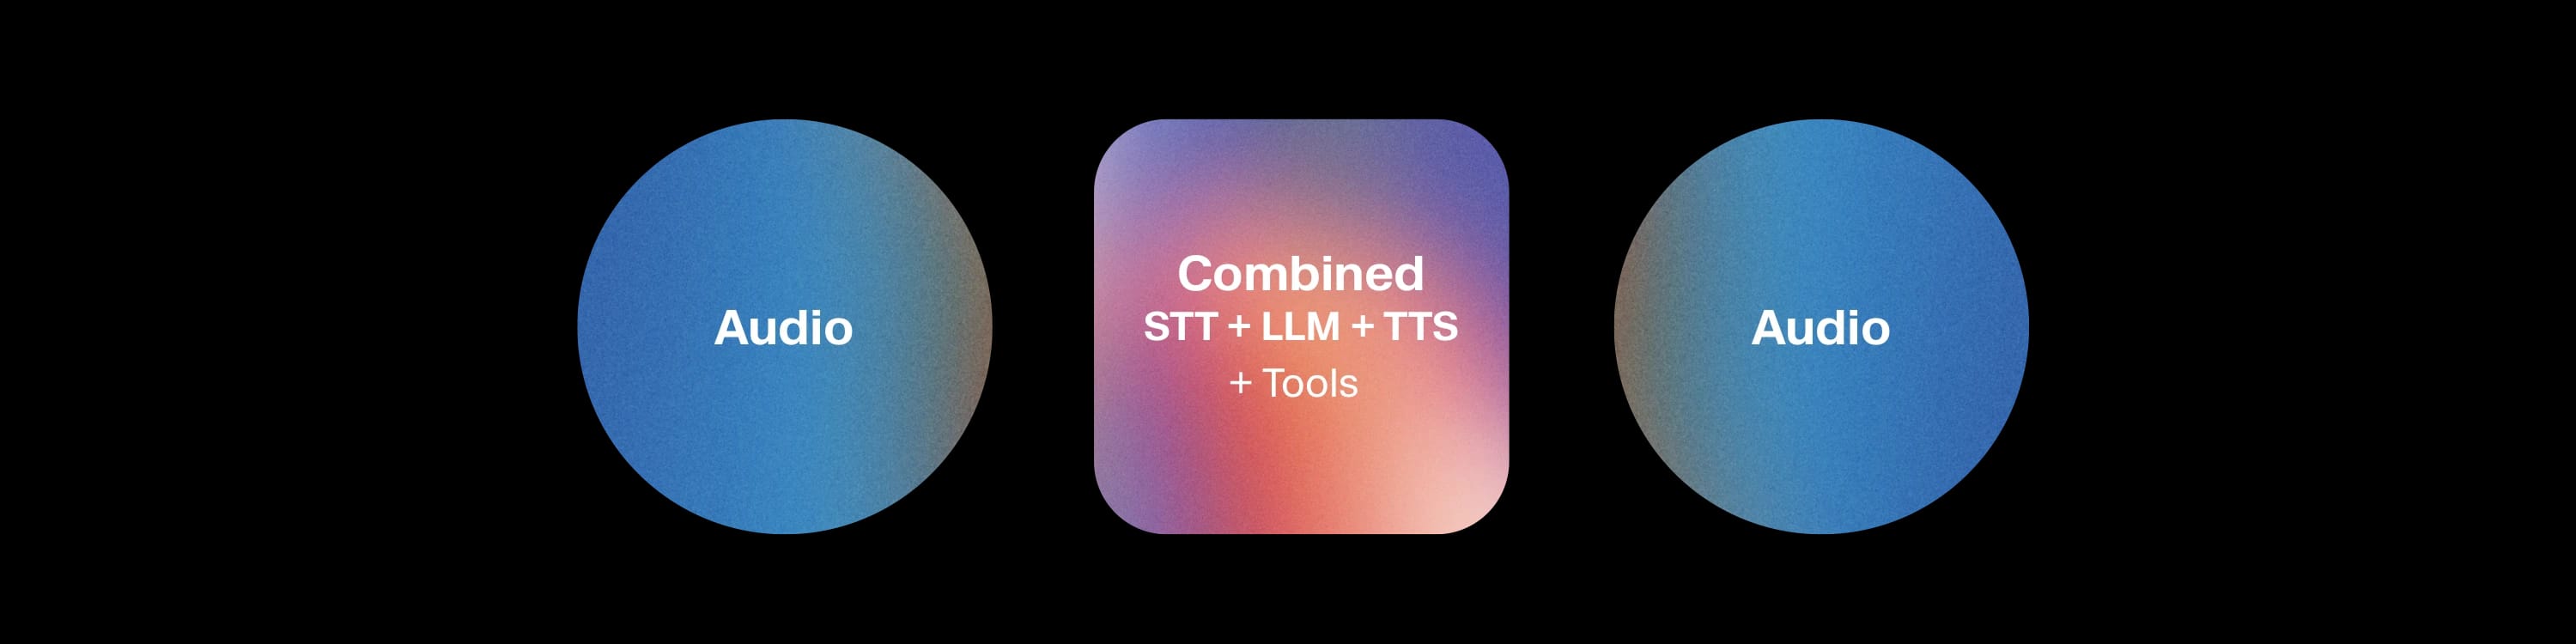
Sammansmälta arkitekturer har ett fundamentalt annorlunda angreppssätt. Igenkänning, resonemang och generering sker alla inom ett enda multimodalt nätverk. Ljud kommer in och ljud kommer ut, utan något inspekterbart lager däremellan.
Avsaknaden av mellanliggande steg är både lockelsen och begränsningen. En sammansmält arkitektur kan bevara prosodiska signaler naturligt, eftersom tal aldrig delas upp i text. Däremot är möjligheten begränsad att upprätthålla skyddsräcken, byta enskilda komponenter eller granska mellanliggande resultat vid felsökning. Det finns även begränsningar i att finjustera STT för branschspecifik terminologi eller integrera en annan LLM för bättre resonemang och verktygsanrop. Systemet är ett enda nätverk och team är begränsade till de resonemangsförmågor det levereras med, vilket i dag innebär lättviktigare kärnor som inte kan matcha frontier-LLM:er i komplexa uppgifter.
De fem arkitekturerna
1. Grundläggande kaskad
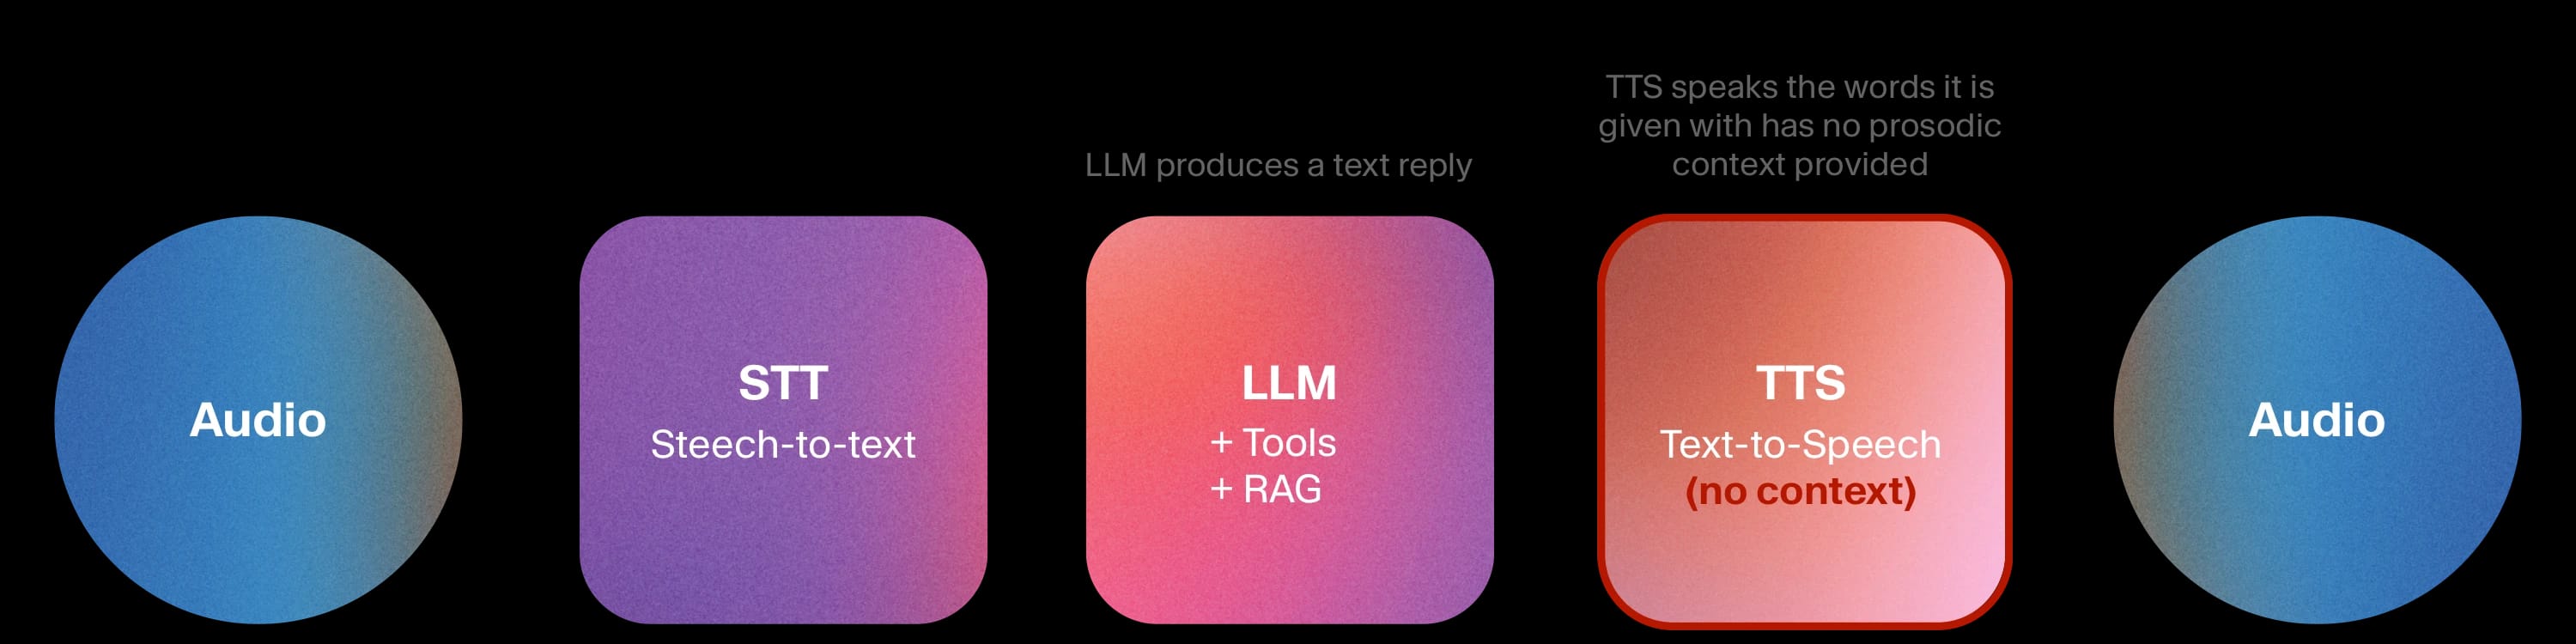
Ljud transkriberas, LLM:en genererar ett textsvar och TTS läser upp det. Varje steg arbetar med vanlig text, så du kan se, testa och styra allt.
Fördelarna ur ett tillitsperspektiv är tydliga: skyddsräcken i textlagret, deterministiska samtalsflöden och kompletta granskningsspår. Eftersom LLM:en är en fristående komponent kan du para ihop assistenten med den frontier-modell som har starkast förmåga till resonemang eller verktygsanrop, och uppgradera så fort en bättre modell lanseras. Svagheten är samtalskvaliteten: utan kontextuell TTS låter assistenten funktionell men platt. Den saknar känslomässig anpassning och prosodisk variation, vilket fungerar för att läsa upp kontosaldon men inte räcker för att hantera en frustrerad kund.
Exempel på användningsfall:
- IVR-ersättningar inom telekom och samhällsservice
- Hantering av vanliga frågor vid introduktion till SaaS
- Utgående aviseringar som mötesbekräftelser, påminnelser om recept och leveransmeddelanden, där konsekvens är viktigare än värme
2. Avancerad kaskad
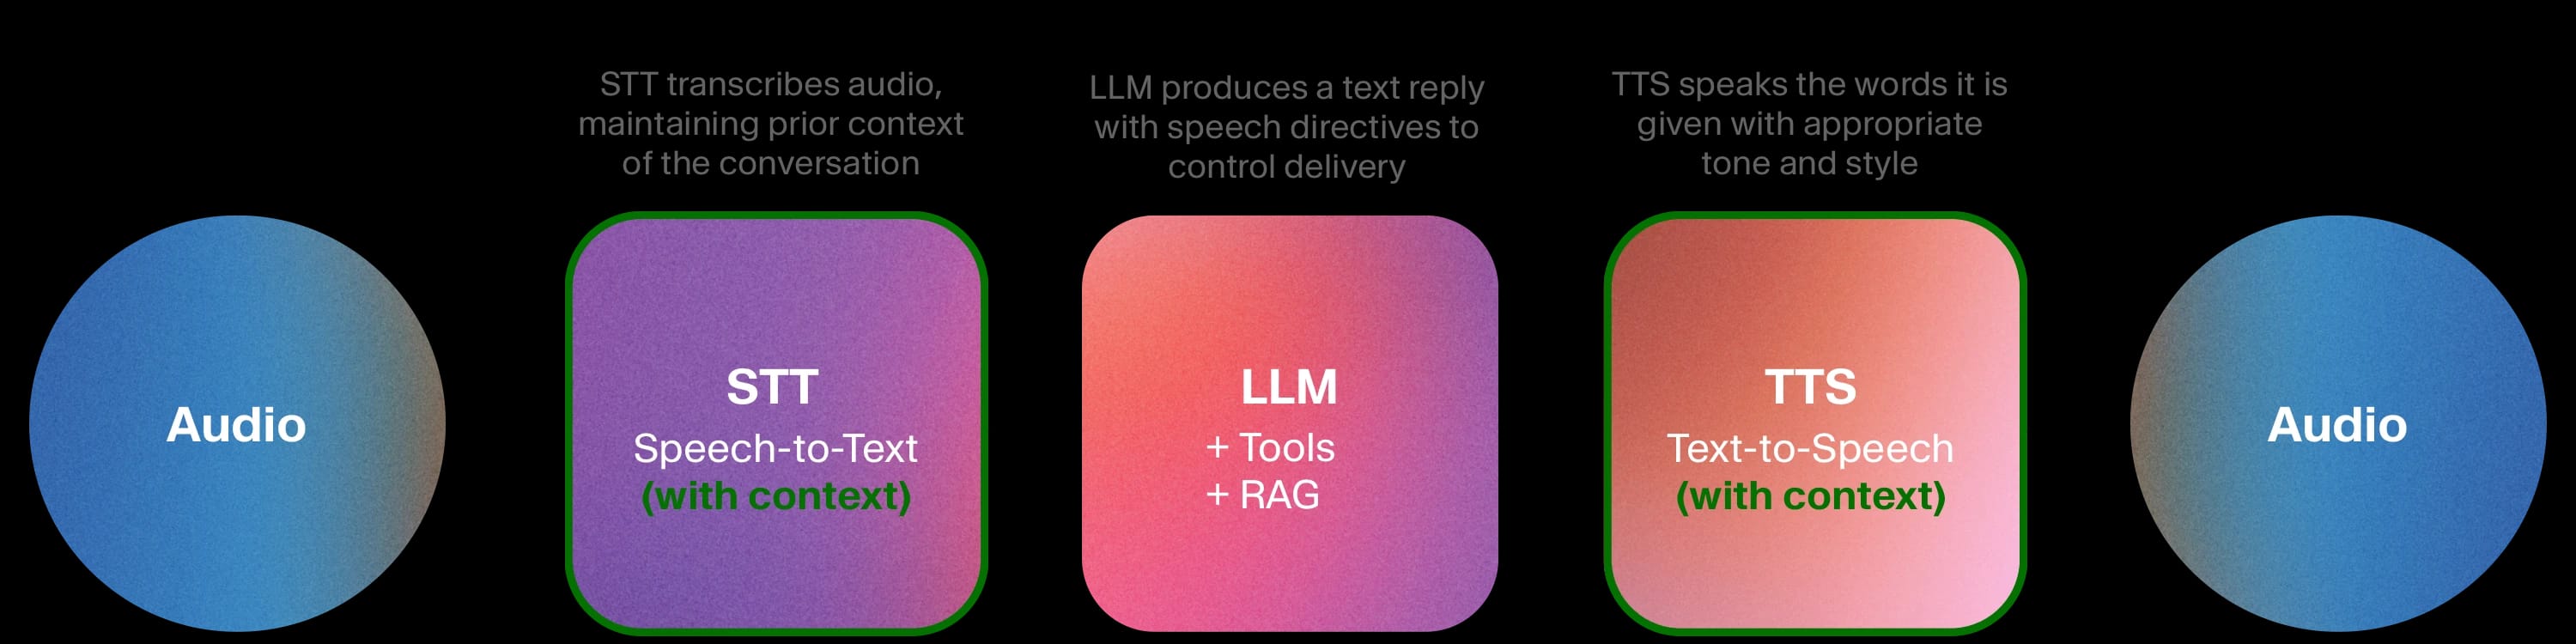
Samma modulära arkitektur, men nu arbetar flera komponenter med mer kontext. Det är vad vi har byggt med Expressive Mode i ElevenAgents.
Modellen Scribe v2 Realtime för STT ger snabb och korrekt transkribering baserad på samtalets tidigare kontext. Utifrån texten instruerar LLM:en TTS om hur talet ska levereras – inte bara vad som ska sägas – till exempel ”lugnande”, ”med betoning” eller ”med brådska”, och anpassar tonen dynamiskt genom samtalet. Systemet för turordning använder samma signaler, så att assistenten kan avgöra när den ska svara och när den ska lämna över ordet. Talmodellerna är samlokaliserade i en enda stack utan nätverkshopp mellan komponenterna, vilket håller latensen låg.
Arkitekturen behåller allt från den grundläggande kaskaden: full transparens, skyddsräcken i textlagret, utbytbara komponenter, domänanpassning och tillgång till de starkaste tillgängliga modellerna för verktygsanrop och resonemang. Den ger avsevärt bättre prosodi, latens och turordning. Team kan integrera en ny frontier-LLM samma vecka som den lanseras, eller finjustera STT för sjukvården för medicinsk terminologi, utan att bygga om någon annan komponent.
Exempel på användningsfall:
- Kundtjänst för finansiella tjänster, där ett empatiskt bemötande i samtal om en bestridd debitering kombineras med strikta skyddsräcken för regelefterlevnad och fullständig loggning av interaktioner
- Receptionister inom sjukvården som prioriterar patientsamtal med rätt känsla av brådska, HIPAA-kompatibla flöden och domänanpassad taligenkänning för medicinsk terminologi
- Säljassistenter som behåller en varm och övertygande ton samtidigt som de följer en strukturerad handlingsplan och skickar uppdateringar till CRM-systemet
3. Hybrid av kaskad och fusion
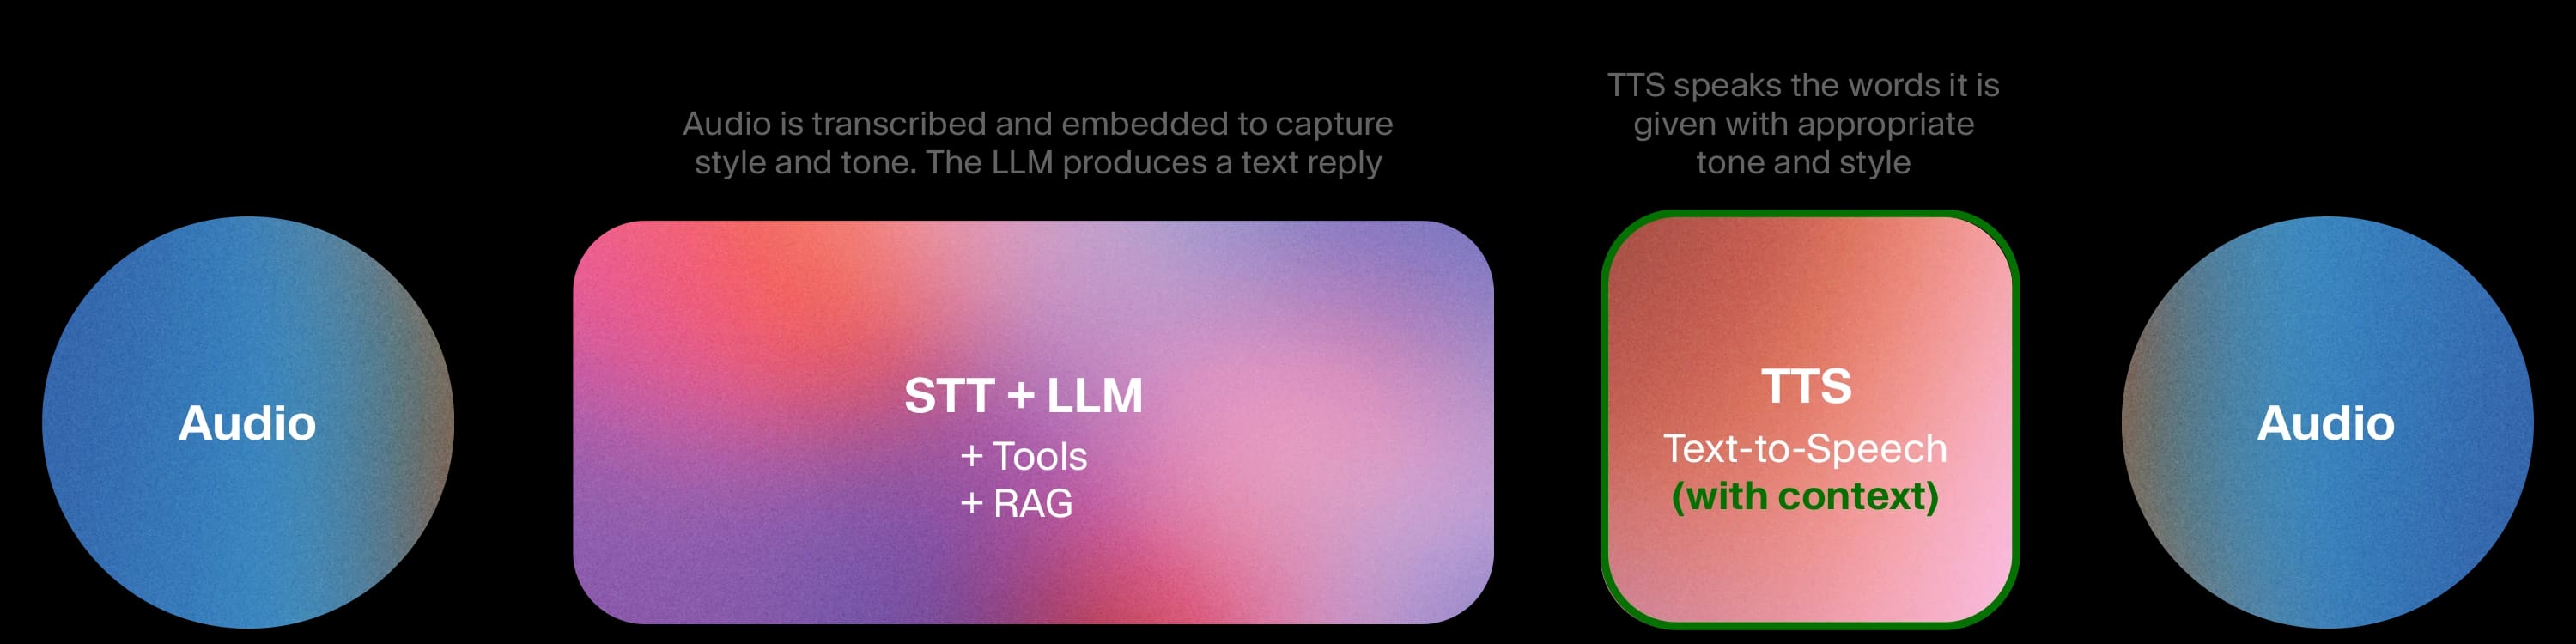
Vissa arkitekturer matar in akustiska egenskaper (uttal, känslor, ton) från talet direkt i LLM:en som inbäddningar, i stället för att först omvandla dem till text. TTS förblir modulär.
Det ger LLM:en rikare information om hur något sades, inte bara vad som sades, vilket är värdefullt för vissa tillämpningar. Det sammansmälta ASR+LLM-blocket är svårare att granska än en tydlig textöverlämning, eftersom den mellanliggande representationen är en inbäddning och inte något som en människa kan läsa. LLM:en är dessutom inte längre lätt att byta ut, vilket begränsar dina möjligheter till resonemang och verktygsanrop till den modell som det sammansmälta blocket byggdes kring.
Exempel på användningsfall:
- Språkinlärning och uttalscoachning, där det är lika viktigt att höra hur en elev talar som vad eleven säger
- Support där tonen är viktig och komplexiteten låg, där det är viktigt att upptäcka frustration men uppgiften i sig är enkel.
4. Sekventiell fusion
En enda multimodal modell hanterar igenkänning, resonemang och generering i ett pass, en tur i taget.
Prosodin kan vara stark. Eftersom tal aldrig delas upp i text bevarar modellen naturligt tempo, intonation och känslomässiga signaler. Korta samtal kan låta anmärkningsvärt flytande.
Men utan ett textlager är möjligheten begränsad att upprätthålla skyddsräcken, det finns få mellanliggande resultat för felsökning och begränsad flexibilitet att byta till en bättre LLM eller finjustera STT för din domän. Resonemangskärnorna tenderar att vara lättviktigare än frontier-LLM:er, vilket försämrar komplexa verktygsanrop och uppgifter i flera steg. När uppgiften kräver att ett komplext problem löses räcker inte prosodi i sig.
Exempel på användningsfall:
- Personliga följeslagare, chattbotar för underhållning och tillämpningar där uttrycksfullhet driver engagemang och kraven på regelefterlevnad är små.
5. Duplexfusion
Indata och utdata bearbetas samtidigt, där modellen lyssnar och talar på samma gång. Det kan få korta utbyten att kännas slående naturliga, med verkligt överlappande tal och flytande turövergångar.
Det är också den svåraste arkitekturen att styra, skyddsräcken är mycket svåra att upprätthålla och överhörning ger oförutsägbara fel. Det är extremt svårt att granska, logga eller felsöka, och systemet är i stort sett slutet med få möjligheter att byta komponenter, domänanpassa eller anpassa det. Resonemang och verktygsanvändning är ännu mer begränsade än i sekventiellt sammansmälta modeller, eftersom den samtidiga bearbetningen lämnar mindre kapacitet för komplex logik. Och samma samtidiga bearbetning som får korta utbyten att låta naturliga gör längre samtal instabila.
Exempel på användningsfall:
- Experimentella appar med personliga följeslagare, sociala röstplattformar och forskningsdemon där oförutsägbart beteende är acceptabelt.
Välj rätt arkitektur för ditt användningsfall
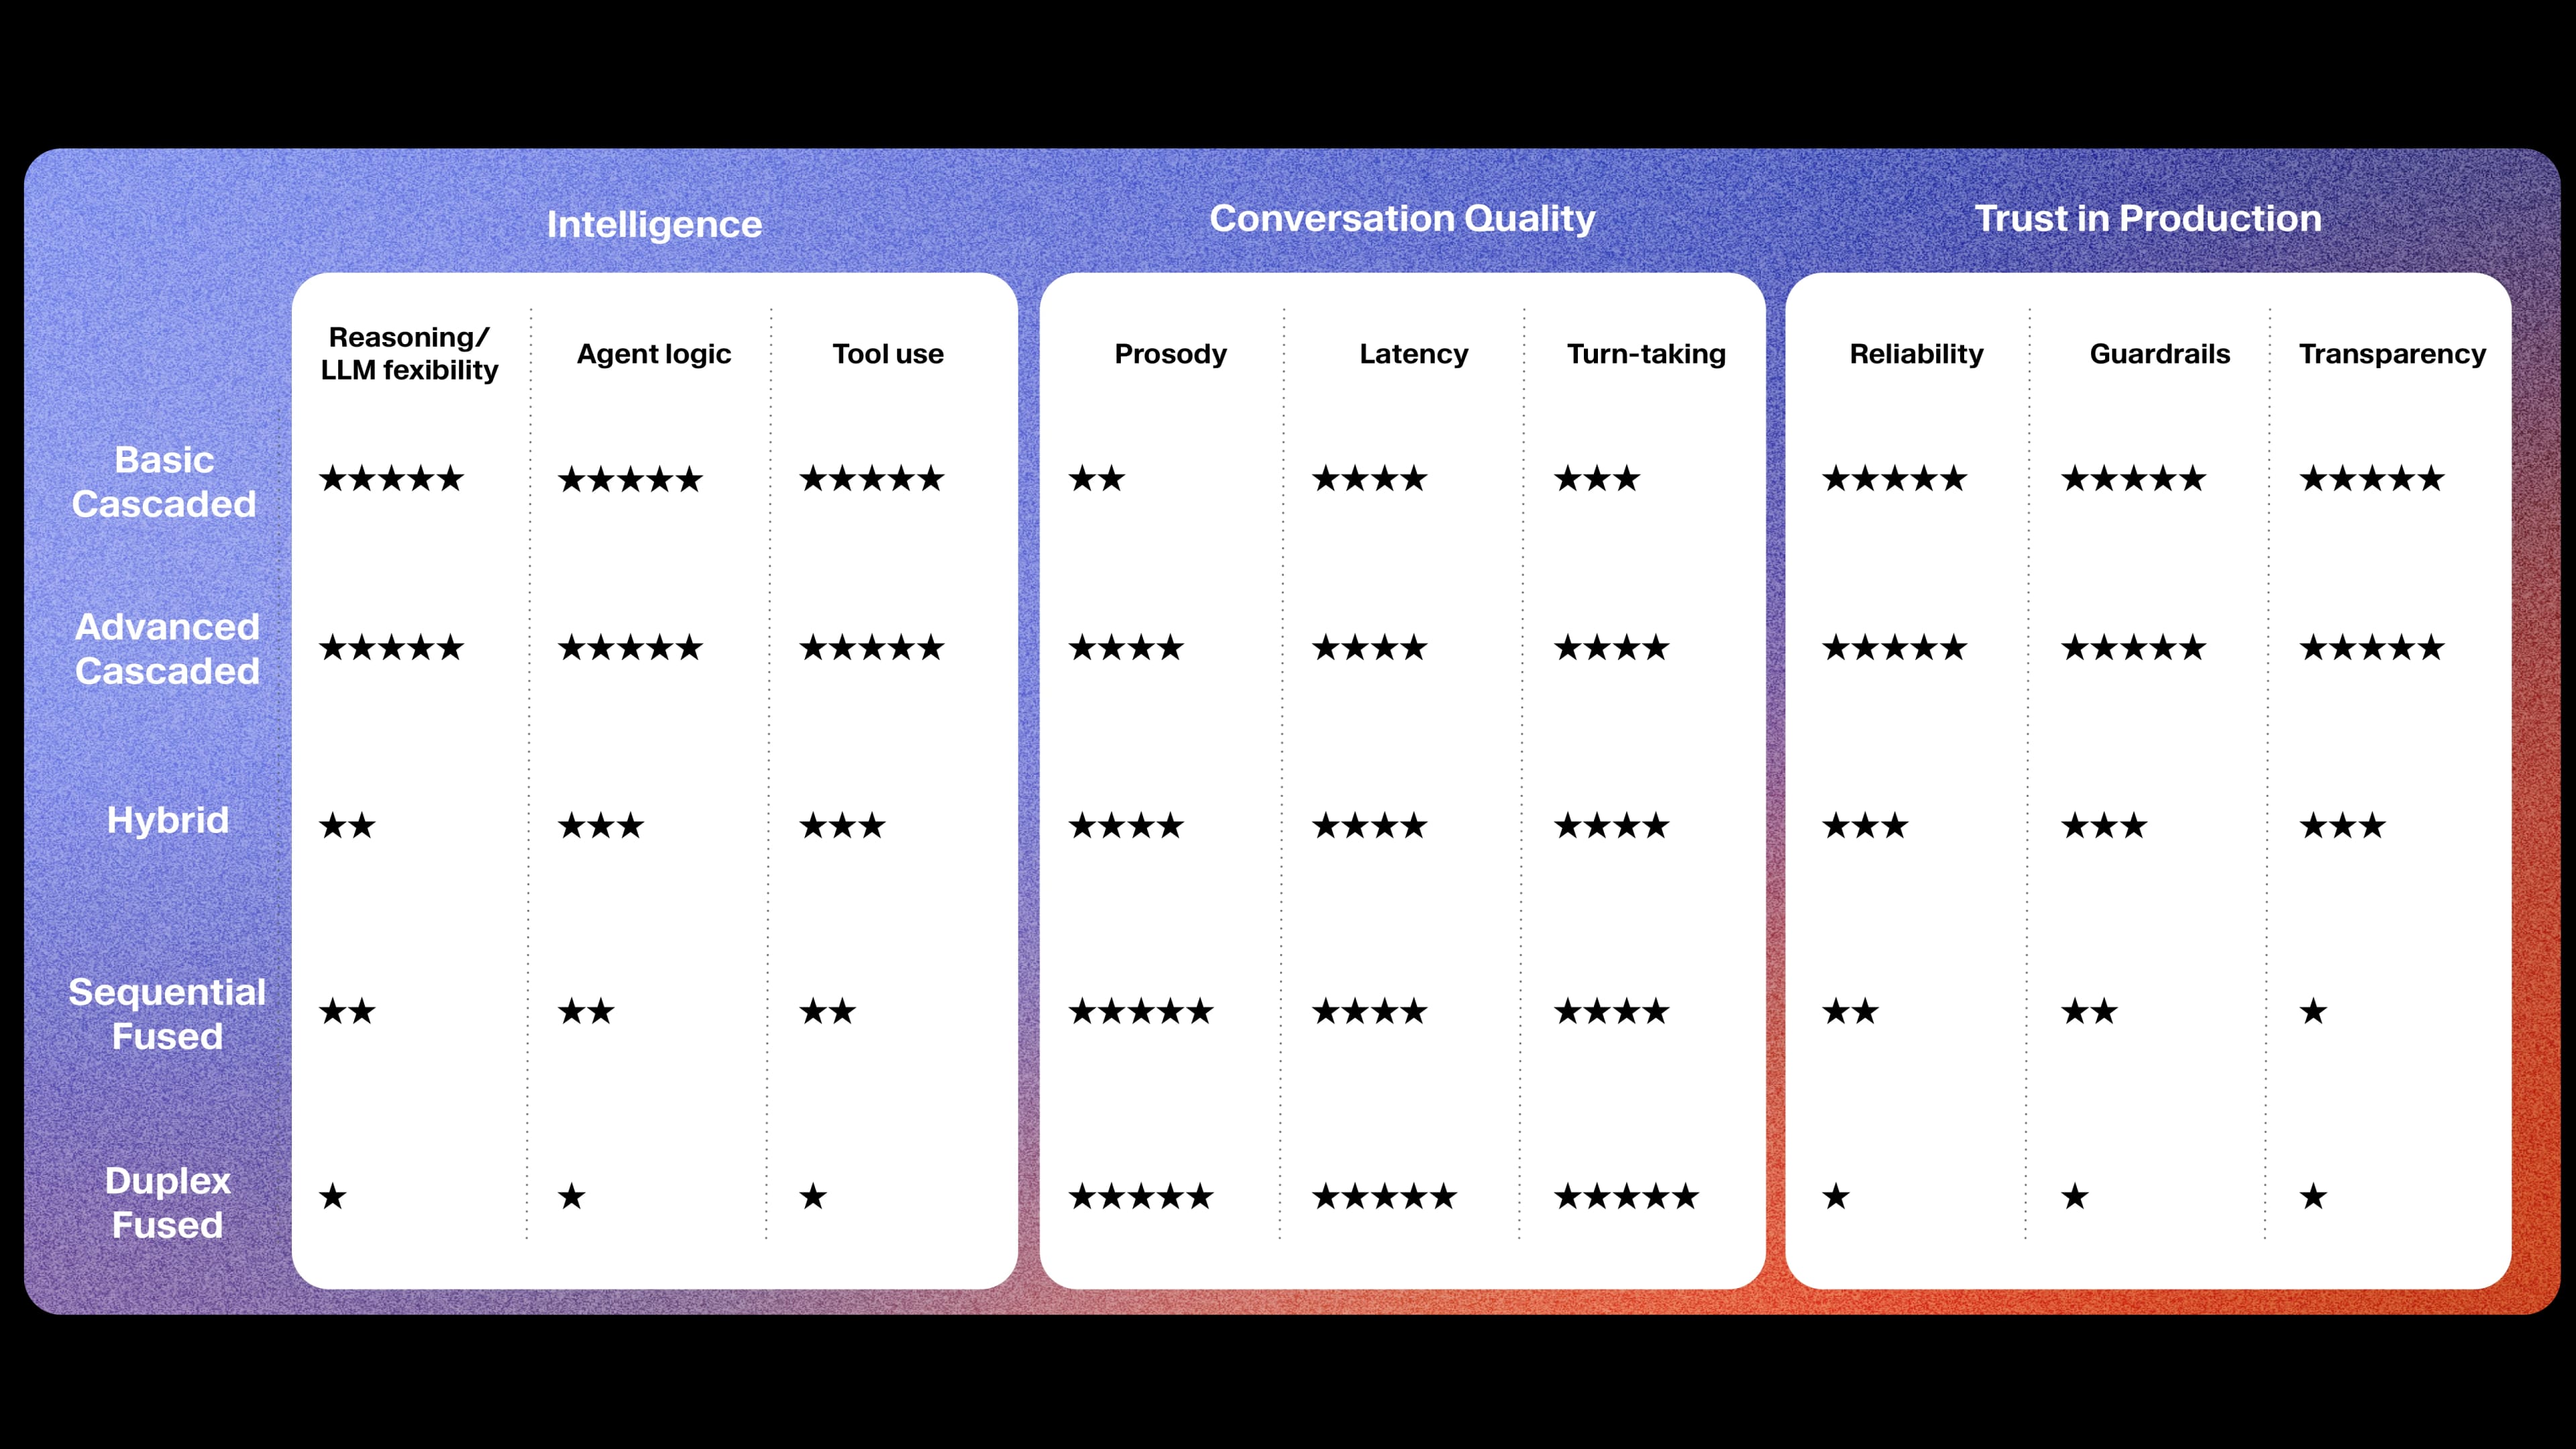
Rätt arkitektur beror på vad en viss tillämpning kräver. Om du bygger en upplevelse där naturligt tal är den främsta funktionen har sammansmälta arkitekturer verkliga styrkor, om du är villig att kompromissa med avancerat resonemang, skyddsräcken och transparens. Sammansmälta modeller leder inom prosodi, men avancerade kaskadsystem kommer närmare varje kvartal, medan sammansmälta modeller inte har gjort några betydande framsteg inom komplext resonemang eller tillit på grund av begränsningar i arkitekturen.
För de flesta företag och myndigheter är den bästa arkitekturen en som både låter bra och är kapabel, anpassningsbar, tillförlitlig och redo att användas i stor skala. Därför valde vi att bygga ElevenAgents med en avancerad kaskadbaserad arkitektur och investeringar i Expressive Mode samt marknadsledande, samoptimerade modeller för Speech to Text och Text to Speech. Det gör att team kan bygga assistenter med hög intelligens, tillförlitlighet och kontroll, i kombination med naturligt, människoliknande tal.
När AI-assistenter fortsätter att spridas inom kundtjänst, utbildning, personliga assistenter och mycket mer kommer de som lyckas att byggas på arkitekturer som är anpassade till deras specifika tillämpningar.