

Speech to Text API
Transkribera tal med ElevenLabs Scribe v3
Vår mest träffsäkra Speech to Text-modell. Transkribera möten, samtal och intervjuer med talaretiketter och kontroll över de ord som är viktiga.
- Lovable
- Veed model
- Synthesia
- Stripe
- Perplexity
- Twilio
Mest träffsäkra Speech to Text API för batchjobb
Skapa undertexter, textremsor och redigerbara transkriptioner för poddar, videor, intervjuer och annat inspelat material – allt med branschledande noggrannhet via API.
Oöverträffad transkriberingsnoggrannhet
Scribe v3 gör 27 % färre ordfel än Scribe v2 på 102 språk, och färre än alla andra batchmodeller vi testade.
Utformad för alla scenarier
Transkribering som fungerar i bullriga miljöer, med bakgrundsmusik, starka accenter och ljud av låg kvalitet.
Detaljerad kontroll över tidpunkter, talare och händelser som inte är tal.
ElevenLabs Transcription API kan upptäcka skratt, känslor och ljudeffekter. Använd nyckelordspromptning för att styra transkriberingen med domänspecifika termer.
Transkribera ljud och video
Rena, redigerbara transkriptioner

Nyckelordspromptning

Dynamisk ljudtaggning
Fånga händelser som inte är tal, såsom skratt, applåder, musik och bakgrundsljud. Transkriptionerna innehåller hela ljudets sammanhang, inte bara orden.
Smart talardiarisering
Identifiera och märk automatiskt upp till 32 talare. Tydlig information om vem som sa vad, organiserad i lättlästa transkriptioner.
Entitetsidentifiering
Identifiera och tagga automatiskt 56 entitetstyper, inklusive namn, datum, platser och organisationer, i dina transkriptioner.
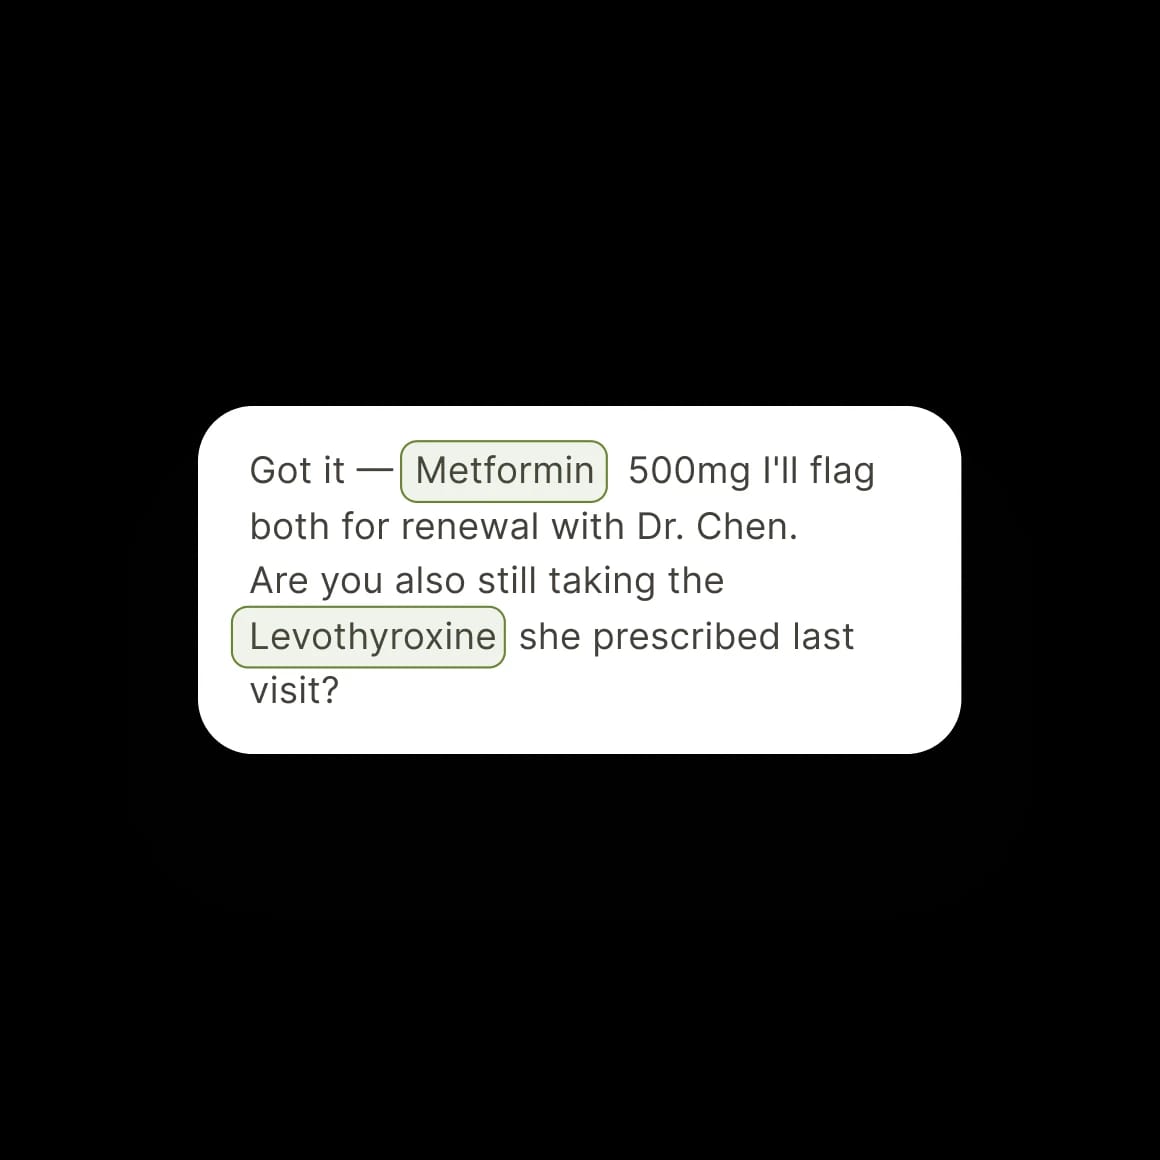
Transkribera kliniskt ljud med Scribe v2 Medical
En Speech to Text-modell optimerad för medicinsk transkribering och kliniska arbetsflöden, med förbättrad igenkänning av läkemedelsnamn samt anatomiska och patologiska termer.
Transkribera kliniskt tal
Omvandla samtal mellan vårdpersonal och patienter, läkares diktat och patientintag till exakt text, redo att granskas av vårdpersonal och användas i anteckningar, kodning och efterföljande dokumentationsflöden.
Färre fel i medicinska termer
I term-WER gör Scribe v2 Medical 15 % färre fel än Scribe v2 i Eka Medical ASR-testuppdelningen, med förbättrad medicinsk taligenkänning för kliniskt ordförråd.
Scribe v3
Högsta noggrannhet, utformad för batcharbetsbelastningar.
- 27 % färre fel än Scribe v2
- Lägsta talarsepareringsfel vi har testat
- Talformatering och språktips
- Entitetsidentifiering och nyckelordsstyrning
- Stöd för över 90 språk
Scribe v3 Live
Lägst latens, för arbetsbelastningar i realtid.
- Latens under 150 ms
- 43 % färre fel än v2 Realtime
- Nyckelordsbibliotek och flerspråkigt läge
- Förbättrad turdetektering
- Stöd för över 90 språk
Scribe v2 Medical
Medicinsk finjustering för klinisk transkribering.
- Anpassning för medicinskt ordförråd
- Transkribering på över 90 språk
- Samma resultat som Scribe v2 för vardagligt tal
- Förbättrad igenkänning av läkemedelsnamn
- HIPAA-kompatibel för företagskunder
Transkribera tal på över 90 språk och med många olika accenter
Exceptionell noggrannhet för accenter, dialekter och olika inspelningsförhållanden.
Ändra languageCode för att förhandsgranska språk
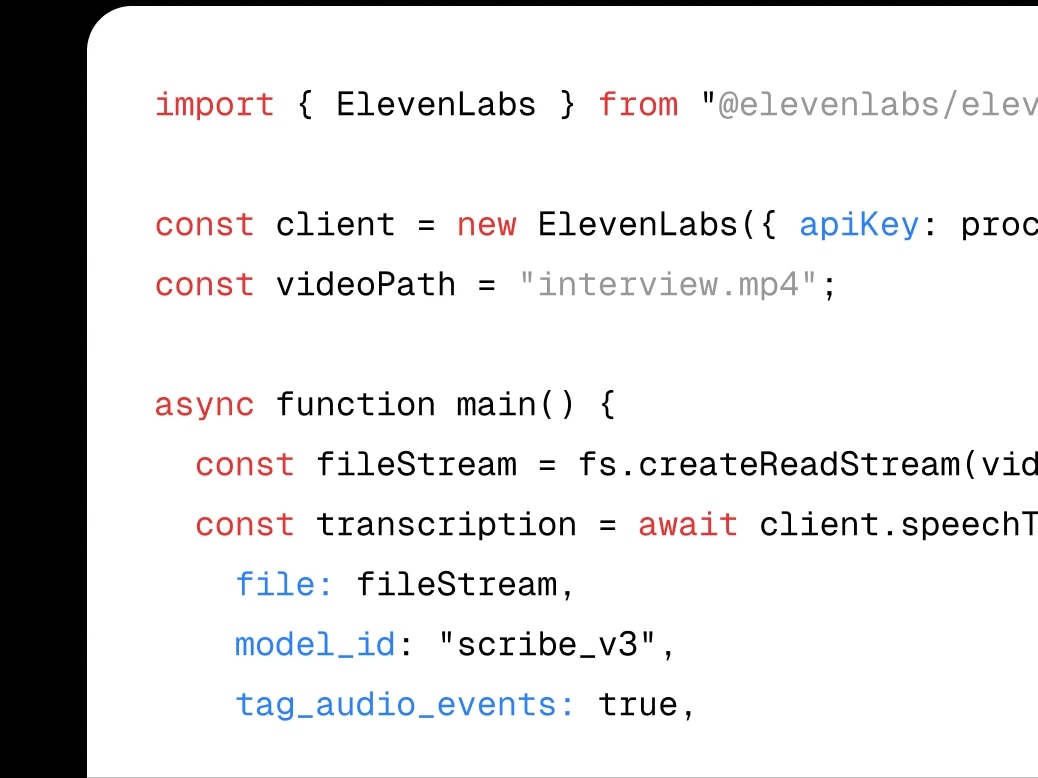
import { ElevenLabsClient } from "@elevenlabs/elevenlabs-js";
const elevenlabs = new ElevenLabsClient({
apiKey: "<your_api_key>"
});
const response = await fetch(
"https://storage.googleapis.com/eleven-public-cdn/audio/marketing/nicole.mp3"
);
const audioBlob = new Blob([await response.arrayBuffer()], { type: "audio/mp3" });
const transcription = await elevenlabs
.speechToText.convert({
file: audioBlob,
modelId: "scribe_v3",
tagAudioEvents: true,
languageCode: , // Välj språk
diarize: true
});
console.log(transcription);


Driver världens ledande företag och varumärken
“Från dubbning av Reels på lokala språk till att skapa musik och karaktärsröster i Horizon – ElevenLabs plattform gör det möjligt för kreatörer, företag och organisationer världen över att arbeta med röst, musik och ljud i stor skala.”

“Scribes oöverträffade noggrannhet på så många språk gör att Fieldy kan förstå varje dagligt samtal och enkelt skala över kontinenter. Fieldy har ökat användarretentionen med 50 % efter bytet till ElevenLabs Scribe.”

“ElevenLabs gjorde det enkelt för oss att snabbt lägga till kraftfulla text-till-tal-funktioner i vårt SDK, så att Agents kan svara i realtid med uttrycksfulla röster på användarnas frågor eller ge återkoppling på det de ser.”
“Twilio har integrerat ElevenLabs generativa AI-röstteknik i sin CPaaS och förbättrat ConversationRelay. Integrationen gör det möjligt för företag och utvecklare att skapa konversationsbaserade AI-röstinteraktioner som låter mänskliga, känns uttrycksfulla och svarar i realtid direkt från Twilios CPaaS-plattform. Vi på ElevenLabs är glada över att Twilio har valt ElevenLabs för att förbättra ConversationRelay med de mest uttrycksfulla och mänskligt klingande rösterna som finns. ”

API:er byggda för produktion

Data krypteras under överföring och lagring, med stöd för efterlevnad av SOC 2, HIPAA och GDPR. Lägena EU Data Residency och Zero Retention finns tillgängliga för striktare datakontroll.
Data krypteras under överföring och lagring, med stöd för efterlevnad av SOC 2, HIPAA och GDPR. Lägena EU Data Residency och Zero Retention finns tillgängliga för striktare datakontroll.
Officiella SDK:er för Python och TypeScript med typsäkerhet, stöd för strömning och tydliga exempel.
Vårt team ser till att lanseringen går smidigt och att din verksamhet fungerar tillförlitligt, med konsekvent prestanda och trygghet.
