
Så fungerar ElevenAgents orkestreringsmotor
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
ElevenAgents drivs av en orkestreringsmotor med låg latens, byggd för samtal i realtid, och tillför mindre än 100 ms overhead. Arkitekturen kombinerar det bästa från ElevenLabs forskning med banbrytande LLM:er från ledande leverantörer som OpenAI, Google och Anthropic, samt utvalda modeller med öppen källkod som driftas av ElevenLabs. Genom att använda flera modeller i olika steg av svarspipelinen ser agenten till att samtalen både är mycket responsiva och medvetna om sitt sammanhang. Genom att dynamiskt använda varje modells styrkor tillsammans uppnår vi tillförlitlig, skalbar prestanda för en rad företagsuppgifter och samtalsscenarier, samtidigt som vi optimerar balansen mellan intelligens, hastighet och kostnad.
I den här artikeln förklarar vi hur dessa modeller samarbetar för att leverera de grundläggande funktioner som agenter behöver för att fungera i komplexa miljöer, och mer specifikt vilken modell som ser vilka token och när. Kärnan i detta är hanteringen av samtalshistoriken i olika delar av interaktionen. Vi går igenom hur och var samtalshistoriken delas för att förtydliga dess roll i orkestreringen för både fristående och arbetsflöden med flera agenter.
Fristående agent
Vi börjar med att utforska den fristående agenten och dess centrala komponenter. Det är rimligt att se en agent med grundläggande nytta som en agent med en systemprompt, åtkomst till ett antal verktyg och en kunskapsbas. Kunder bör välja fristående agenter framför arbetsflöden när användningsfallet har ett begränsat behov av att kontrollera en strikt följd av steg, eller när det är viktigt att undvika kunskapssilor mellan agenterna. Kunskapssilor uppstår när vissa verktyg, dokument eller historiskt sammanhang är tillgängliga för vissa underagenter, men inte för andra. De är en naturlig del av arbetsflöden med flera agenter och innebär en avvägning mellan flexibilitet och determinism.
För fristående agenter i ElevenLabs är det viktigt att förstå hur de:
- Skapar effektiva genereringsförfrågningar
- Hämtar och införlivar relevanta dokument
- Genererar och kör verktygsanrop som informerar agentens svar
- Levererar resultat för utvärdering och datainsamling
Skapa samtalskontext
Ett samtal mellan en kund och en ElevenLabs-agent består av en serie turer, där varje tur omfattar ett utbyte av meddelanden mellan båda parter. Denna växlande lista av agent- och användarmeddelanden utgör utgångspunkten för att bygga vår samtalskontext. Under varje tur får den underliggande LLM:en genereringsförfrågningar som innehåller en serie växlande agent- och användarmeddelanden, med ett meddelande mer än i föregående tur. Serien av meddelanden inleds naturligtvis med ett enda systemmeddelande som motsvarar agentens systemprompt.
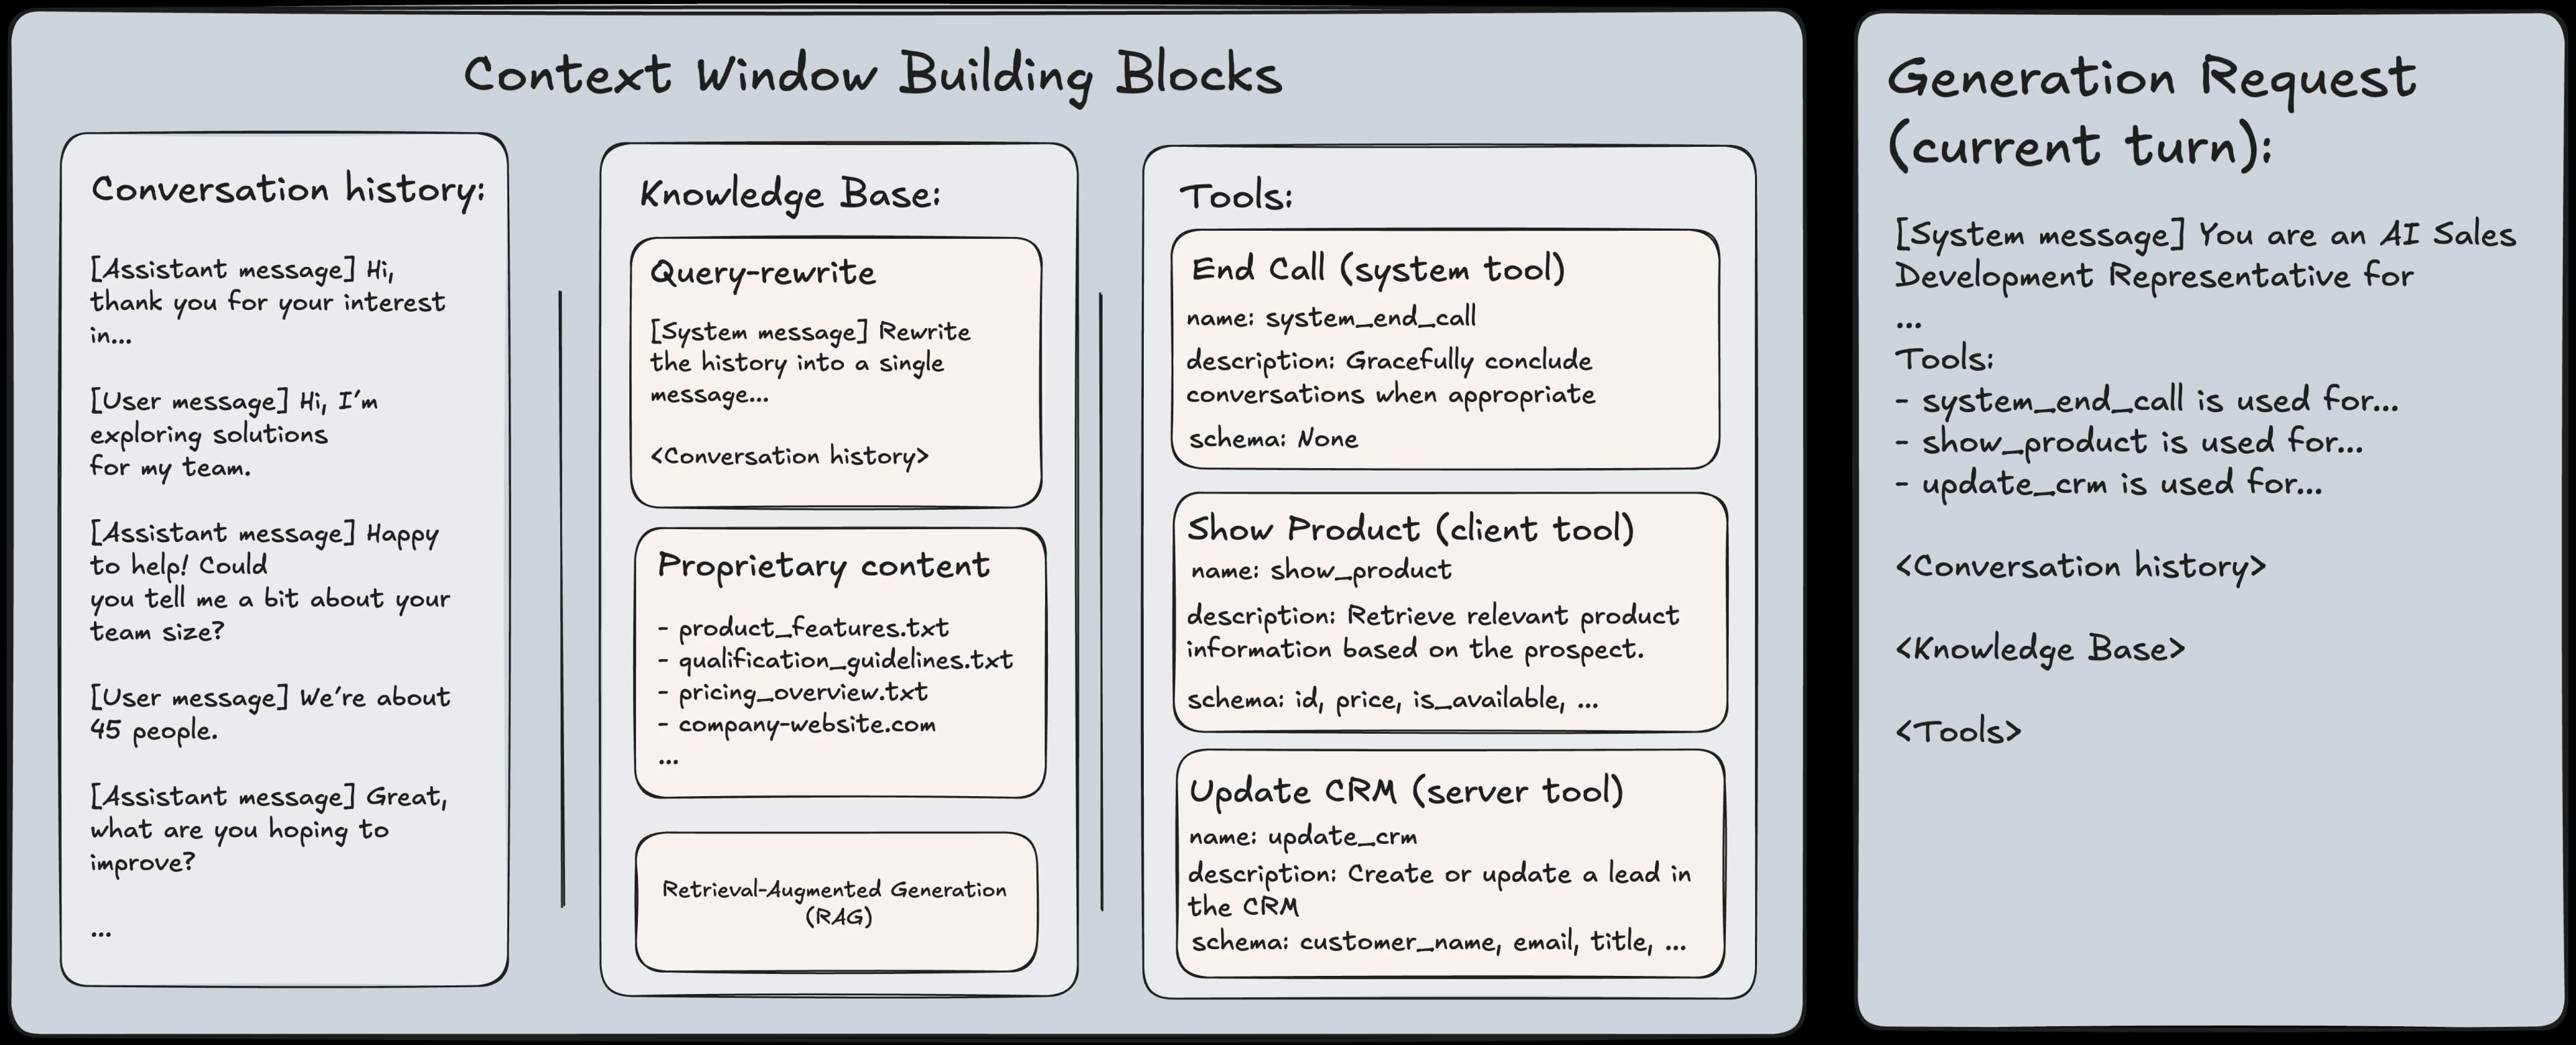
ElevenLabs orkestrerare minskar den upplevda LLM-latensen genom att förutse när en användare har slutat prata. I vissa fall kan detta leda till flera LLM-genereringsförfrågningar med samma samtalskontext under en och samma tur. Samtidigt som orkestreringen optimerar hur snabbt agenter svarar, beror svarskvaliteten lika mycket på hur kunskap nås. När kunder utvecklas börjar de vanligtvis förankra sina agenters svar i en kombination av egen dokumentation och offentligt innehåll. I flera år har retrieval-augmented generation (RAG) varit standardmetoden för att uppnå detta. ElevenAgents kunskapsbaser bygger vidare på RAG med en optimerad arkitektur med flera modeller, som vi har beskrivit i ett tidigare inlägg. Det möjliggör tillförlitlig dokumenthämtning även när användarens senaste inmatning är en följdfråga, en bekräftelse på ett förtydligande eller på annat sätt saknar en uttrycklig fråga.
Hämtning är dock bara ett sätt för agenter att interagera med externa system.
Utföra åtgärder och hämta information med verktyg
ElevenLabs agenter kan utföra verkliga åtgärder och hämta aktuell information mitt i ett samtal genom ett flexibelt verktygssystem. Den möjligheten medför en viktig designaspekt: varje aktiverat verktyg ökar storleken på den serialiserade prompten, eftersom dess namn, beskrivning och parameterschema inkluderas tillsammans med systemprompten och samtalshistoriken. När fler verktyg läggs till ökar också den resonemangsbelastning som modellen får för att anropa rätt följd av verktyg. I Agent Builder beskriver verktygets beskrivning vad verktyget gör och vilka fält det returnerar. Det är den information språkmodellen använder för att förstå sammanhanget kring användningen. När detta har definierats hör de specifika villkoren för att anropa verktyget hemma i agentens systemprompt. Exempel:
- Verktygsbeskrivning för lookup_order: ”Hämtar information om en kunds beställning med hjälp av beställnings-ID. Returnerar orderstatus, köpta artiklar, leveransadress och spårningsnummer.”
- Instruktion i systemprompten: ”När kundens identitet har verifierats, anropa verktyget lookup_order för att hämta information om beställningen.”
Denna ansvarsfördelning gör att verktygsdefinitioner kan återanvändas mellan agenter, samtidigt som varje agents systemprompt kan styra exakt när ett verktyg anropas. För att hjälpa kunder att utforma dessa systemprompter effektivt ger vi mer ingående vägledning i vår Prompting Guide. Inom detta ramverk kan främst följande typer av verktyg definieras:
- Webhook-verktyg som anropar externa API:er.
- Klientverktyg som skickar verktygsförfrågningar som händelser via samtalets websocket.
- Systemverktyg för inbyggda åtgärder, till exempel samtalsöverföringar.
- MCP-verktyg som ansluter till Model Context Protocol-servrar.
När en agent bestämmer sig för att använda ett verktyg hämtar den nödvändiga uppgifter från samtalet och skickar en begäran om att köra det. När verktyget returnerar ett resultat läggs resultatet till i samtalet, så att modellen naturligt kan hänvisa till det i sitt nästa svar. Vid behov kan verktygets utdata även uppdatera agentens lagrade information som en dynamisk variabel. Den lagrade informationen sparas som enkla nyckel/värde-par, som extraheras från verktygets svar med fördefinierade mappningar. När de har angetts kan dessa variabler återkopplas till agenten via systemprompten, framtida verktygsparametrar och villkor i arbetsflödet. Denna återkopplingsloop ger agenter ett slags arbetsminne som utvecklas medan de interagerar.
Detta beskriver hur verktyg integreras i agentens resonemang, men även tidpunkten för körningen kan konfigureras. Verktyg kan köras i ett av tre körlägen, vart och ett anpassat för olika samtalsbehov. I Immediate Mode körs verktyget så snart LLM:en begär det. Detta är standard för snabba uppslag där användare förväntar sig ett nästan omedelbart svar, till exempel när de kontrollerar orderstatus. I kombination med tal före verktygsanropet genererar agenten först en kort bekräftelse, som ”Låt mig kontrollera det åt dig”, och skickar den till användaren medan verktyget körs parallellt, vilket minimerar tystnad. För långsammare verktyg förlänger plattformen automatiskt dessa utfyllnadsmeddelanden så att de motsvarar den förväntade väntetiden. Post-Tool Speech Mode fördröjer däremot körningen tills agenten har talat klart. Detta är avgörande för åtgärder med verkliga konsekvenser, exempelvis att överföra ett samtal, avsluta en session eller skicka in en betalning. Användaren hör hela sammanhanget, som ”Jag kopplar dig till faktureringen nu”, och kan avbryta innan åtgärden utförs. Async Mode kör verktyget helt i bakgrunden utan att pausa samtalet. Läget passar bäst för fire-and-forget-åtgärder som att skicka e-post, utlösa ett externt workflow eller logga data, där agenten inte behöver hänvisa till resultatet i sitt svar.
När körning och orkestrering är på plats är nästa steg att förstå hur prestandan mäts.
Mäta prestanda
När ett samtal med en agent har avslutats kan kunder vilja extrahera viss information från samtalet för vidare analys och lagring, eller avgöra om ett samtal lyckades. Det är här Datainsamling och Utvärderingskriterier kommer in i bilden. Datainsamling gör att du kan extrahera strukturerad information från en samtalstranskription för efterföljande analys och aggregering. Kunder exporterar ofta dessa resultat till sin dataplattform för rapportering eller arbetsflöden för databerikning. En Sales Development Agent kan till exempel automatiskt extrahera uppgifter om en potentiell kund från ett samtal för att skapa eller uppdatera en lead i systemet för kundrelationshantering (CRM). Utvärderingskriterier avgör däremot om ett samtal anses vara framgångsrikt. Om alla konfigurerade kriterier uppfylls markeras samtalet som framgångsrikt; annars flaggas det som ett misslyckande. Det säkerställer att samtal konsekvent uppfyller definierade standarder för kvalitet och integritet, samtidigt som det ger snabb återkoppling. När ett samtal avslutas och webhooken efter samtalet utlöses bearbetar agenten den färdiga transkriptionen, inklusive eventuella verktygskörningar och metadata, med en LLM tillsammans med alla konfigurerade datainsamlingspunkter och utvärderingskriterier. Modellen använder denna kombinerade prompt för att avgöra om varje utvärderingskriterium är uppfyllt och för att extrahera de angivna datapunkterna för vidare analys. Eftersom LLM:en tolkar dessa konfigurationer direkt som en del av sin indataprompt är det viktigt att formatera dem tydligt och konsekvent, så att modellen kan förstå och tillämpa dem korrekt. Därför rekommenderar vi följande bästa praxis för att skriva beskrivningar för utvärderingskriterier och datainsamling.
Utvärderingskriterier
- Ett tydligt mål per kriterium: en mening eller kort punkt är bättre än flera mål i ett och samma kriterium.
- Observerbart och baserat på transkriptionen: formulera målet så att framgång/misslyckande kan avgöras utifrån transkriptionen (vad som sades, vad agenten gjorde, vad användaren frågade). Undvik mål som kräver extern kontext som LLM:en saknar.
- Tydliga utfall för framgång/misslyckande/okänt: LLM:en har redan kontexten att målet måste vara uppfyllt för att markeras som framgångsrikt, inte vara uppfyllt för att markeras som misslyckat, och inte kunna avgöras utifrån transkriptionen för att markeras som okänt. Målet bör därför skrivas så att ”uppfyllt” respektive ”inte uppfyllt” är tydligt definierade. Om det är tvetydigt kan modellen ha en tendens att välja okända eller felaktiga klassificeringar
- Håll det kortfattat: ibland kan många utvärderingskriterier skickas tillsammans. Långa utvärderingskriterier kan därför tillföra brus och potentiellt orsaka hallucinationer
- Språket spelar roll: LLM:ens motivering till huruvida ett utvärderingskriterium uppfylldes eller inte ges på samma språk som kriteriebeskrivningen, så det är viktigt att ha i åtanke
Datainsamling
- Beskriv exakt vad som ska extraheras: beskrivningen är LLM:ens främsta signal. Ange vad fältet betyder, i vilken situation det ska anges och vad som ska göras när det är oklart (t.ex. ”Lämna null om kunden aldrig angav ett önskat datum”).
- Matcha den förväntade typen: värdet som LLM:en tillhandahåller matchar alltid den datatyp som tilldelats datainsamlingspunkten (t.ex. boolean, string, integer osv.). Beskrivningen ska därför stämma överens med den. Du kan till exempel använda ”Extrahera antalet begärda artiklar” för integer och ”Ja/nej om kunden godkände erbjudandet” för boolean.
- Använd enum när det går: om mängden värden är fast för typen string, använd enum i schemat. Det begränsar modellen och minskar ogiltiga utdata.
- Ett extraktionsmål per objekt: samla inte flera orelaterade fakta i ett objekts beskrivning. Dela upp dem i separata objekt så att varje anrop har ett enda, tydligt extraktionsmål.
- Håll beskrivningarna korta: Beskrivningar kan bestå av några meningar; långa stycken behövs inte. Transkriptionen finns redan i användarmeddelandet, så schemat plus en kort beskrivning räcker.
För närvarande är LLM:en som används för detta utvärderings- och extraktionssteg låst till en modell med låg latens för att säkerställa snabb bearbetning. Inom en snar framtid förväntar vi oss att införa alternativ som ger kunder större flexibilitet.
Härnäst tittar vi på användningsfall som kräver strukturerad orkestrering, determinism eller specialisering mellan flera samtalsroller, där kunder i stället kan använda Workflows.
Workflows
Workflows erbjuder ett visuellt gränssnitt för att utforma komplexa samtalsflöden. Det skapar i slutänden det logiska objekt som orkestreraren använder för att hantera flera underagenter, verktyg och överföringar under en fristående agents identifierare. Workflows introducerar ytterligare komponenter att ta hänsyn till utöver dem som redan beskrivits för fristående agenter, inklusive hur:
- Systemprompter och underagenters samtalsmål samspelar.
- Förflyttning genom olika övergångspunkter i grafen avgörs.
Specialiserade samtalsmål
Workflows återanvänder funktionalitet från fristående agenter för att säkerställa ett konsekvent beteende genom hela interaktionen. Det omfattar delade element som bas-systemprompten, centrala verktyg och globala kunskapsbaser som alltid ska vara tillgängliga, oavsett vilken del av arbetsflödet som är aktiv. Den övergripande systemprompten ansvarar vanligtvis för att definiera global samtalskontext, förväntad ton, säkerhetsbegränsningar och eventuella varumärkes- eller produktövergripande instruktioner.
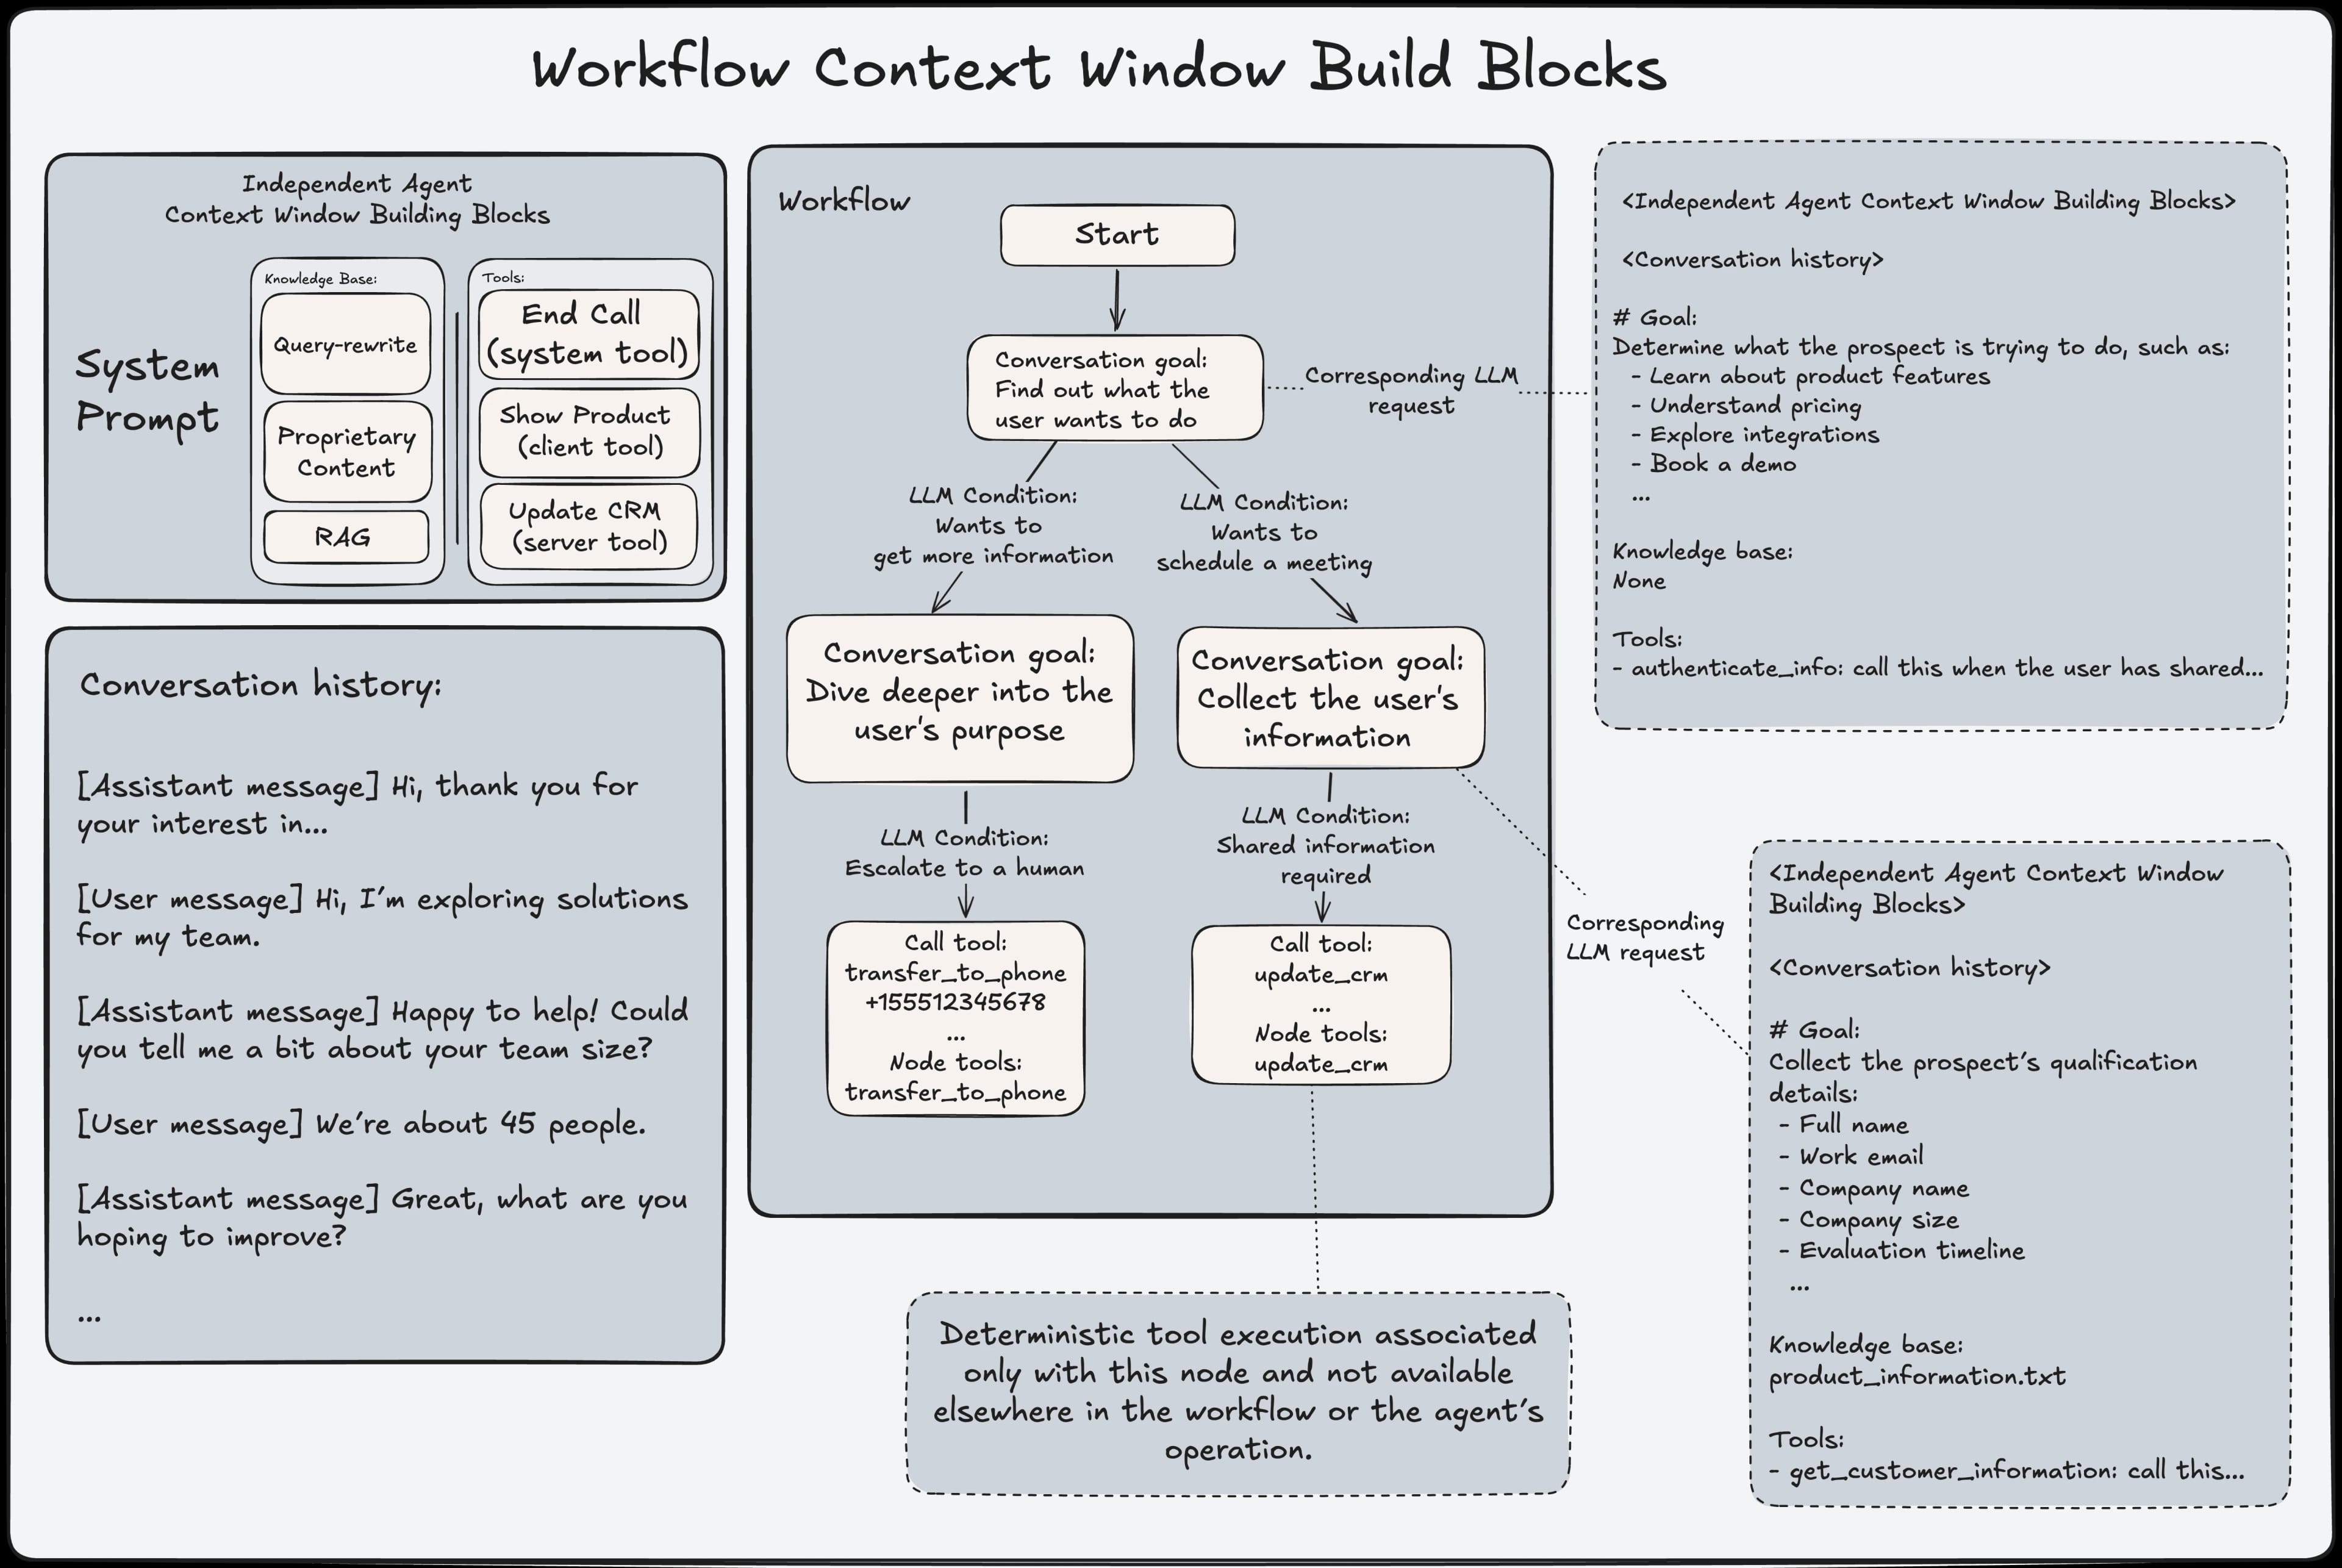
Utöver denna gemensamma grund introducerar Workflows specialiserade underagenter som arbetar i en riktad graf. Varje underagent tilldelas ett snävt avgränsat mål och utökar baskonfigurationen med ytterligare promptinstruktioner, verktyg och kunskapskällor som endast är relevanta för dess roll. I stället för att omdefiniera hela samtalskonfigurationen lägger underagenterna sitt syfte ovanpå basagenten genom promptkomposition och selektiv utökning av kontexten. Samtalshistoriken bevaras mellan övergångar mellan underagenter för att upprätthålla kontinuitet, men varje underagent arbetar med en avsiktligt begränsad vy av systemet. Kunskapsbaser och verktyg exponeras selektivt, vilket skapar tydliga silor som förhindrar läckage mellan ansvarsområden. För att förstärka denna isolering byggs orkestrerarobjektet om vid varje övergång, som om det vore en fristående agent. Det säkerställer att den aktiva underagentens promptstatus, konfiguration och tillgängliga funktioner förblir helt deterministiska. Designen gör att Workflows kan bevara global konsekvens samtidigt som lokal specialisering stöds, vilket ger förutsägbart beteende, tydlig ansvarsfördelning och exakt kontroll över hur kontext, kunskap och åtgärder tillämpas i varje steg av en interaktion.
En av de viktigaste mekanismerna som möjliggör denna kontroll är hur övergångar mellan underagenter styrs.
Styra övergångar i arbetsflöden med LLM-villkor
Workflows går framåt genom att följa en riktad graf av underagenter, där övergångar mellan noder styrs av uttryckliga villkor. Dessa villkor avgör när kontrollen ska flyttas från en underagent till en annan och gör att arbetsflöden kan reagera på användarinmatning, verktygsresultat och dynamiska variabler. Grafvillkor kan vara antingen deterministiska eller LLM-utvärderade. Deterministiska villkor, såsom ovillkorliga övergångar, kontroller baserade på uttryck för dynamiska variabler eller villkor för verktygsresultat, ger starka garantier för kontrollflödet och passar väl för att upprätthålla strikt progression genom ett arbetsflöde. LLM-baserade villkor möjliggör däremot semantisk utvärdering av kriterier i naturligt språk, till exempel att upptäcka användarens avsikt eller identifiera när specifik information har lämnats.
Det är viktigt att LLM-villkor utvärderas utanför den aktiva agentens systemprompt och inte påverkar agentens genereringsbeteende. I stället utvärderas de parallellt av orkestreraren mot samtalets aktuella tillstånd. Denna separation säkerställer att övergångslogiken inte förorenar agentens prompt eller påverkar hur svar genereras, samtidigt som arbetsflöden kan använda LLM-resonemang för flexibel förflyttning genom grafen. Genom att kombinera deterministiska och LLM-utvärderade villkor kan arbetsflöden uppnå både förutsägbarhet och anpassningsbarhet: deterministiska övergångar där korrekthet är kritisk och LLM-baserade övergångar där semantisk tolkning krävs.
När ett samtal går vidare till ett nytt steg aktiverar systemet en version av agenten som är anpassad specifikt för det steget. Varje steg arbetar med egna fokuserade instruktioner och har bara åtkomst till den kunskap och de verktyg som är relevanta för ansvarsområdet. Ett steg för återbetalningar kan till exempel hänvisa till återbetalningspolicyer utan att ärva orelaterad kontext från onboarding eller triage. Förflyttningen mellan steg styrs av uttryckliga övergångsvillkor. Dessa villkor avgör när ansvaret ska flyttas och gör att routningsbeslut kan fattas naturligt i takt med att samtalet utvecklas. För att bevara kontinuiteten är användarens upplevelse sömlös mellan övergångarna, där varje steg ärver relevant samtalskontext utan att mekaniken bakom överlämningen exponeras. Skyddsåtgärder övervakar också övergångar för att förhindra improduktiva routningscykler och säkerställer att arbetsflödet förblir stabilt och målinriktat.
Säkerhet och skydd
För fall som kräver utökade kontroller för säkerhet och skydd kan kunder använda ytterligare delar av orkestreraren.
Skyddsräcken
ElevenLabs Agents implementerar säkerhetsskydd genom ett konfigurerbart system för moderering och anpassning som utvärderar användar- och agentmeddelanden i realtid. Inkommande innehåll klassificeras i flera riskkategorier, bland annat sexuellt innehåll, våld, trakasserier, hat och självskadebeteende, var och en med tröskelvärden som kan konfigureras oberoende av varandra. När ett skyddsräcke utlöses avslutas samtalet omedelbart och klienten får ett tydligt felmeddelande. Detta säkerställer att osäkra interaktioner blockeras tidigt och konsekvent, utan att enbart förlita sig på åtgärder i prompten. Skyddsräcken fungerar utanför agentens promptlogik och ger ett tillförlitligt efterlevnadslager som inte kan kringgås av modellbeteende eller användarinmatning. Metoden gör att kunder kan justera säkerhetskänsligheten utifrån sitt område och samtidigt behålla deterministisk tillämpning vid körning.
Kompatibel datahantering
Talare kan ibland dela känslig information med en agent som omfattas av strikta krav på lagring och behandling, till exempel medicinska data som kräver HIPAA-kompatibel hantering. För att stödja dessa användningsfall erbjuder vi Zero Retention Mode (ZRM) på agent- eller Workspace-nivå. När det är aktiverat behandlas all samtalsdata endast i minnet och skrivs aldrig till permanent lagring. När samtalet och bearbetningen är klara behåller ElevenLabs ingen information. Därför är transkriptioner, ljudinspelningar och analysresultat inte tillgängliga i Agents Dashboard, och denna policy gäller både kundriktade system och interna loggar. Även om data inte behålls behandlas den under samtalet, och alla konfigurerade webhooks efter samtalet får resultaten. Kunder kan därmed lagra transkriptioner eller analysresultat i sina egna system vid behov.
När ZRM är aktivt säkerställer vi också att underleverantörer inte behåller data genom att begränsa tillgängliga LLM:er till leverantörer med avtalsmässiga åtaganden som förbjuder träning på eller lagring av kunddata. För närvarande omfattar detta modeller från Google Gemini och Anthropic Claude. Kunder som vill använda en annan LLM med ZRM kan göra det genom att ingå ett eget avtal med leverantören och konfigurera den som en anpassad LLM med API-nycklar som omfattas av avtalet. Eftersom detta utökar datahanteringen bortom vår vanliga förtroendegräns måste vårt Safety-team granska och godkänna användningsfallet manuellt innan det aktiveras. ZRM säkerställer att ElevenLabs och dess underleverantörer inte behåller samtalsdata, men kunder ansvarar fortfarande för att externa verktyg eller webhooks som används av deras agent uppfyller tillämpliga krav på datalagring och regelefterlevnad.
Framåt
I det här inlägget har vi utforskat hur ElevenLabs Agents hanterar samtalskontext, verktyg, utvärdering och strukturerade arbetsflöden för att ge tillförlitliga upplevelser i realtid i stor skala. I takt med att kunder driftsätter agenter i allt mer komplexa miljöer fortsätter vi att utöka flexibiliteten i vår orkestreringsmotor, från konfigurerbara utvärderingsmodeller och mer omfattande övergångskontroller till djupare insyn i promptkomposition och tokenanvändning mellan olika steg.
Vårt Forward Deployed Engineering-team samarbetar nära med kunder för att säkerställa att dessa funktioner utvecklas i takt med driftsättningar i verkligheten. Nästa generation av Agents kommer att erbjuda ännu större transparens, determinism och anpassningsbarhet utan att kompromissa med den låga latens som gör samtal i realtid möjliga.


