Transkribering i realtid jämfört med batchtranskribering: viktiga skillnader
- Skriven av
- Jack Limebear
- Publicerad
LyssnaLyssna på den här artikeln
Du har två alternativ när du väljer en AI-driven transkriberingsmodell: transkribering i realtid eller batchtranskribering. Båda alternativen omvandlar tal till text, men de fungerar på olika sätt.
Transkribering i realtid bearbetar ljud medan det spelas upp, medan batchtranskribering bearbetar en hel ljudinspelning efter att den har avslutats. Transkribering i realtid ger omedelbara resultat, men batchtranskribering är ofta mer exakt.
I den här guiden jämför vi transkribering i realtid med batchtranskribering för att hjälpa dig välja rätt modell för ditt nästa projekt. Vi går igenom hur varje modell fungerar, dess för- och nackdelar samt vanliga användningsområden.
Sammanfattning
- Transkribering i realtid bearbetar ljud medan det spelas upp.
- Batchtranskribering bearbetar en hel ljudfil på en gång.
- Transkribering i realtid går snabbare, men batchtranskribering är mer exakt eftersom modellen har dubbelriktad kontext från hela ljudfilen.
- Transkribering i realtid passar bäst för tillämpningar som live-röstagenter, videoundertexter i realtid eller mötesanteckningar, där snabbhet är viktigare än exakthet.
- Batchtranskribering är mer exakt och mer kostnadseffektiv för att transkribera stora mängder ljud efter att det har spelats in.
Vad är transkribering i realtid inom STT?
Transkribering i realtid är när en tal-till-text-modell (STT) omvandlar ljud till skriven text medan det spelas upp. Detta kallas ibland även strömmande transkribering.
Vid transkribering i realtid bearbetar STT-modellen ljudet i små delar. Den skrivna texten blir tillgänglig bara millisekunder efter att orden har sagts. Allteftersom samtalet fortsätter samlar STT-modellen in mer data och kontext och använder informationen för att förbättra transkriptionen.
Den här typen av transkribering fungerar bäst i situationer där snabbhet är viktigare än exakthet. Modellerna kan till exempel göra ljud- och videoströmmar mer tillgängliga med undertexter i realtid. Ett annat vanligt användningsområde är plattformar för anteckningar i realtid.
Vad är batchtranskribering inom STT?
Batchtranskribering omvandlar en hel ljudinspelning från tal till text på en gång, efter att inspelningen är klar. Processen kan ta allt från några sekunder till över 10 minuter, beroende på inspelningens längd och komplexitet.
Batchtranskriberingsmodeller använder kontext från hela inspelningen medan de arbetar. Fullständig kontext hjälper modellen att tolka avsnitt med komplext språk, bakgrundsljud eller avbrott korrekt. Batchtranskriberingsmodeller lägger också till interpunktion och formatering, vilket vissa realtidsmodeller kan ha svårt med.
Batchtranskribering fungerar bäst i situationer där exakthet är högsta prioritet. Många organisationer använder batchmodeller för att transkribera långa intervjuer, möten eller poddar till sina arkiv.
Så formar batch- och strömmande arkitekturer transkribering
Vid en jämförelse mellan batch- och strömbearbetning för transkribering använder modellerna helt olika processer, vilket påverkar slutresultatet.
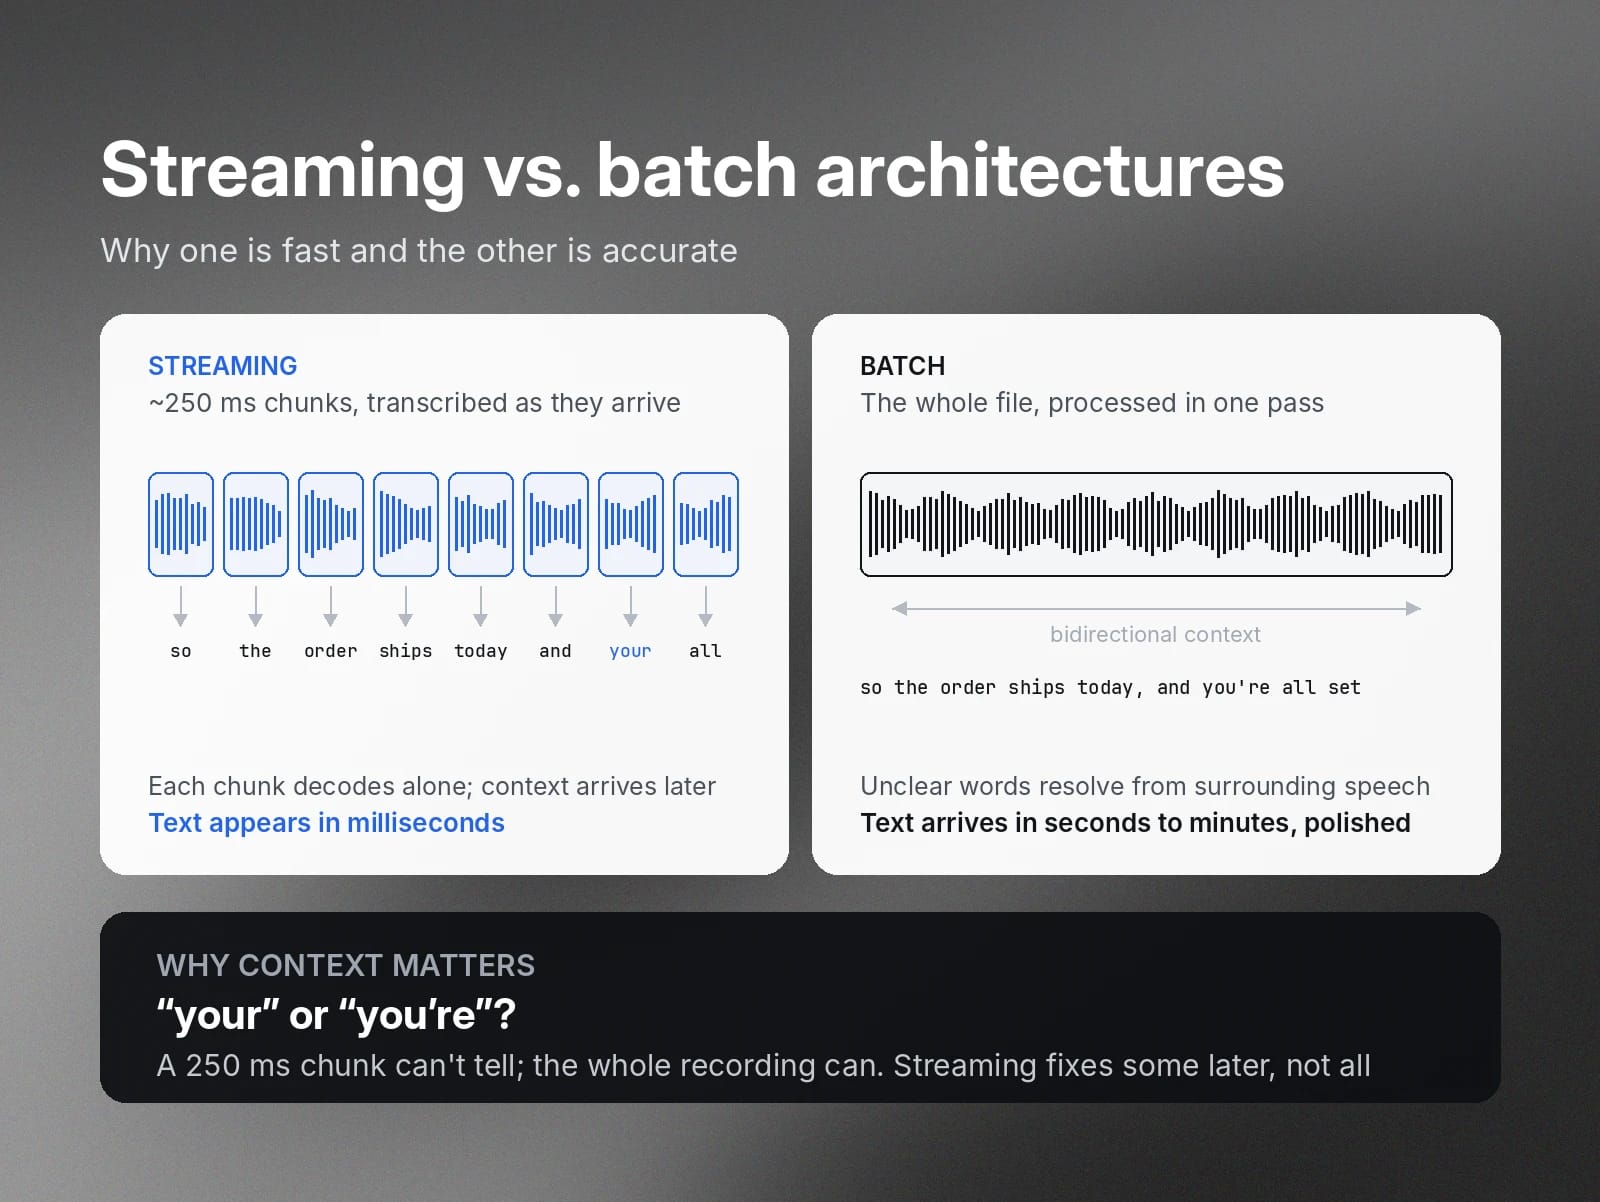
Strömmande transkriberingsmodeller delar upp ljudet i delar och transkriberar varje del medan den spelas upp. Delarna är mycket små, vanligtvis omkring 250 millisekunder eller mindre. Genom att bearbeta ljud i det här formatet kan transkriberingsmodellen arbeta snabbt, så att texten visas bara sekunder efter ljudet.
Eftersom dessa ljuddelar är så små har Speech to Text-modellen inte hela samtalets kontext, vilket kan leda till misstag. Modellen kan till exempel tolka ”din” i stället för ”ditt”.
En transkriberingsmodell i realtid rättar till vissa av dessa misstag när samtalet fortsätter och kontexten blir tydligare. Det finns dock oftast inte tillräckligt med tid eller kontext för att rätta alla fel, så den slutliga transkriptionen är inte alltid 100 % korrekt.
Batchtranskriberingsmodeller bearbetar däremot hela ljudfilen på en gång. Det innebär att transkriberingsmodellen har dubbelriktad kontext för samtalet, som den använder för att reda ut otydliga ord eller fraser. När något är oklart i ljudfilen analyserar modellen orden före och efter för att avgöra vad som sades och transkribera det korrekt.
Den extra kontexten innebär att batchtranskriberingsmodeller är långsammare än modeller för transkribering i realtid. Slutresultatet blir däremot betydligt mer exakt och välbearbetat.
Viktiga egenskaper hos modeller för transkribering i realtid och batchtranskribering: fördröjning, exakthet och kostnad
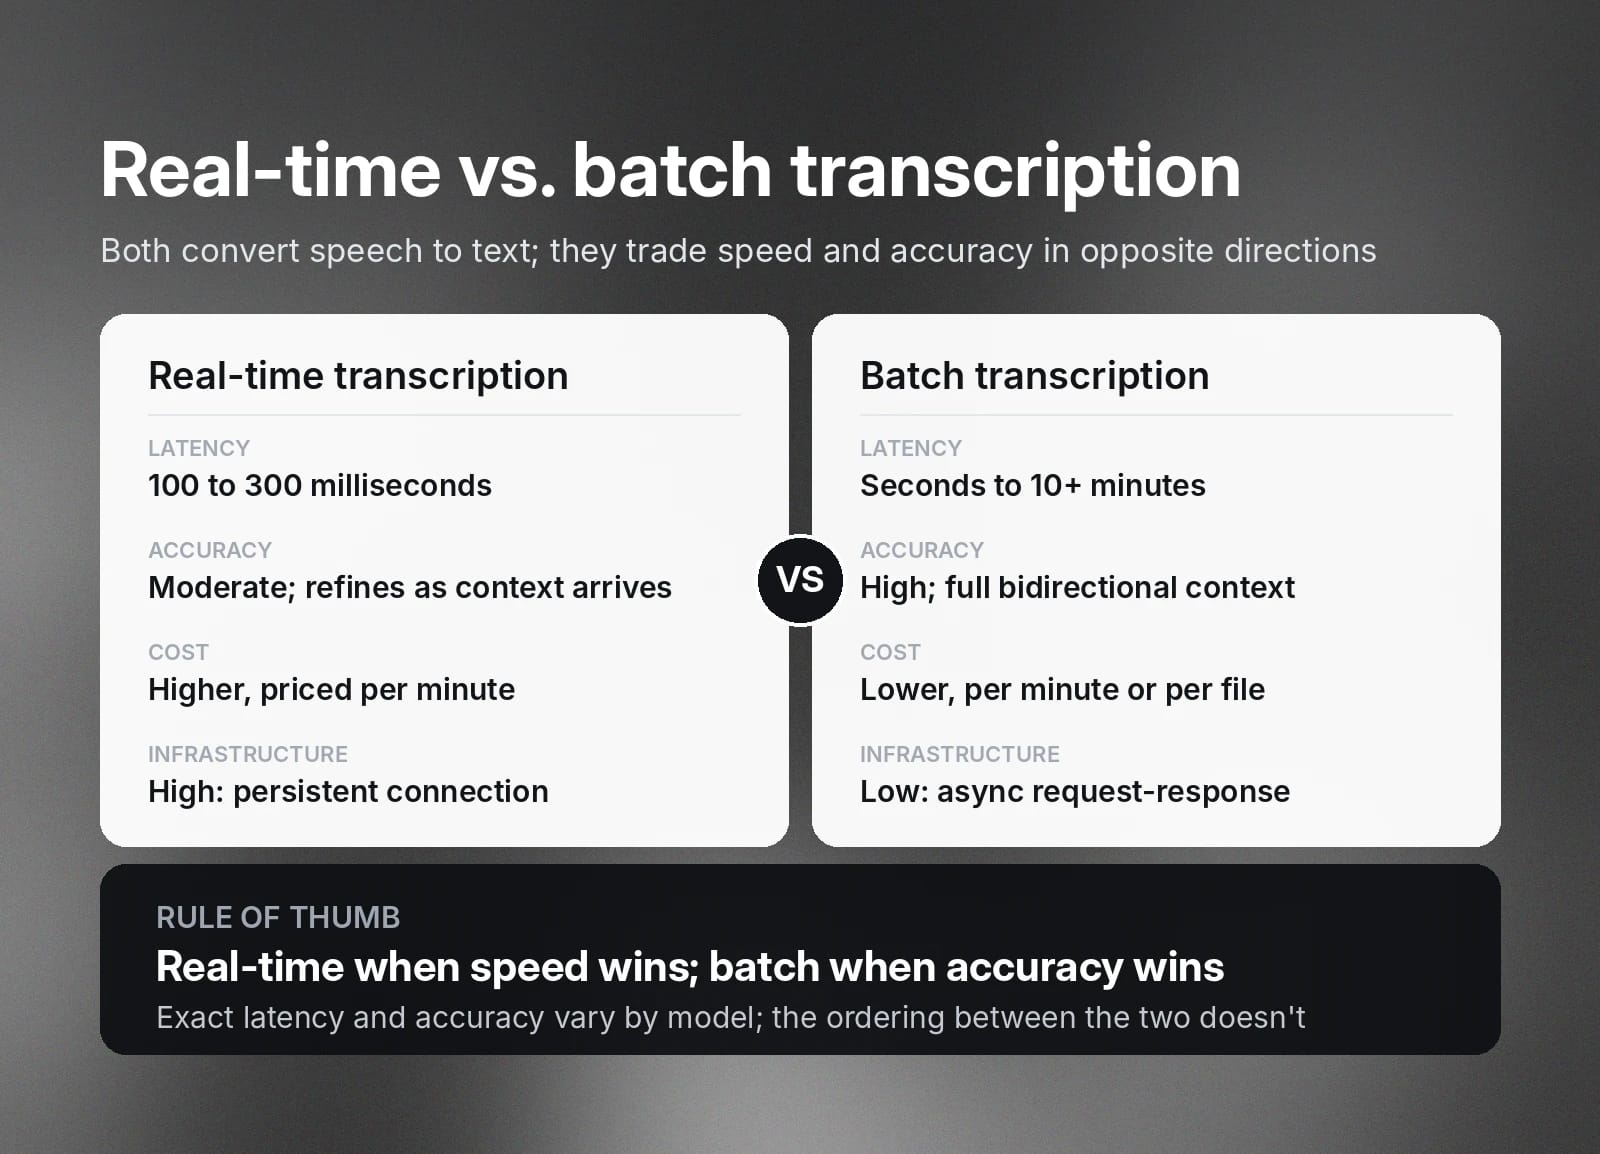
Både realtids- och batchmodeller fungerar effektivt för transkribering – allt beror på vilken typ av projekt du arbetar med. Vissa projekt kräver omedelbara resultat, medan andra behöver hög exakthet.
Här är faktorerna du bör överväga när du väljer mellan transkribering i realtid och batchtranskribering:
Transkribering i realtid | Batchtranskribering | |
Fördröjning | 100 till 300 millisekunder | Från sekunder till över 10 minuter, beroende på filens längd |
Exakthet | Måttlig | Hög |
Kostnad | Hög, prissätts per minut | Måttlig, prissätts per minut eller fil |
Infrastrukturens komplexitet | Hög, kräver stabil anslutning och lastbalansering | Låg, använder en asynkron struktur för begäran och svar |
Exakta nivåer av fördröjning och exakthet varierar beroende på vilken transkriberingsmodell du använder. Transkribering i realtid är dock konsekvent snabbare, medan batchtranskribering är mer exakt.
Transkribering i realtid kostar mer än batchtranskribering eftersom den kräver mer komplex infrastruktur och medför högre driftkostnader. Realtidsmodeller kräver en stabil anslutning för att behålla sin hastighet, och de tar längre tid att konfigurera och underhålla än batchmodeller.
Realtidsmodeller är värda investeringen för tillgänglighet under livesamtal. Batchtranskribering sparar däremot pengar och konfigurationstid för projekt där snabbhet inte är en prioritet.
Jämförelse av API:er för realtids- och batchtranskribering: välj rätt alternativ för ditt projekt
Innan du startar ett nytt transkriberingsprojekt behöver du utvärdera för- och nackdelarna med batch- och realtidsmodeller för att se vilken som passar dina mål bäst. Så här ser beslutsprocessen ut i tre verkliga scenarier.
Live-röstagent: Transkribering i realtid
Live-Conversational AI-modeller kräver nästintill omedelbar transkribering för tillgänglighet, särskilt när de hanterar komplexa operativa utmaningar eller kundtjänstärenden.
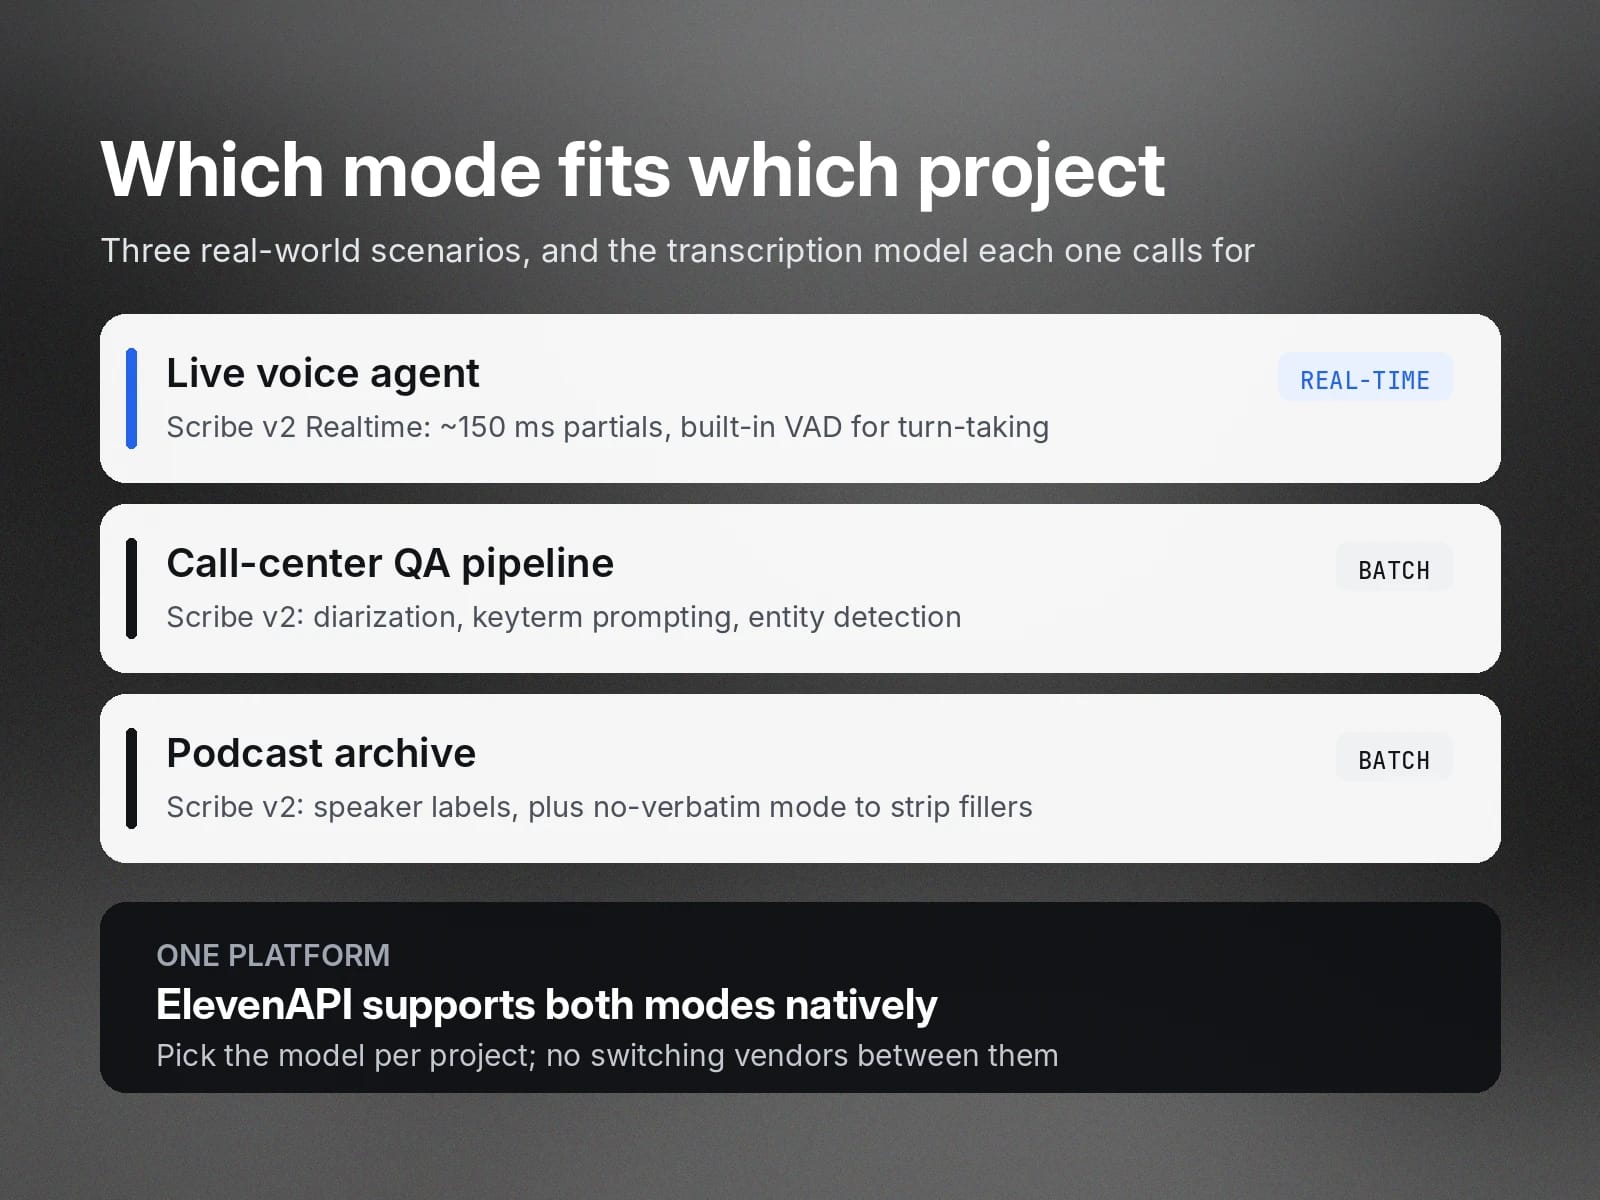
En realtidsmodell som Scribe v2 Realtime ger den låga fördröjning som krävs för smidiga, naturliga samtal. Scribe v2 Realtime levererar partiella transkriptioner på ungefär 150 millisekunder.
Transkriberingsmodeller för live-röstagenter kräver också korrekt turordning i samtalet. Det innebär att de måste kunna identifiera när en användare har börjat eller slutat tala och svara direkt. Effektiv turordning och hantering av avbrott hjälper till att förhindra att transkriptionen hamnar efter samtalet.
Realtidsmodeller för transkribering prioriterar korrekt turordning för snabba resultat. Scribe v2 Realtime har till exempel inbyggd Voice Activity Detection, så den segmenterar automatiskt transkriptionen när den upptäcker tystnad mellan talare.
QA-pipeline för callcenter: Batchtranskribering
Exakthet är avgörande vid kvalitetssäkring, så en batchtranskriberingsmodell som Scribe v2 är det mest rimliga valet i det här scenariot.
Transkriptioner från callcenter innehåller ofta unika namn och branschspecifika detaljer. Om de inte transkriberas korrekt är det svårt för analytiker att avgöra om ett samtal verkligen var framgångsrikt. Eftersom batchmodeller bearbetar hela inspelningen på en gång har de den kontext som krävs för korrekt transkribering och formatering.
Scribe v2 har flera funktioner som ökar transkriberingens exakthet. Talarseparering säkerställer att agenter och kunder alltid märks upp korrekt, även när de talar i mun på varandra. Nyckelordsstyrning ger modellen varumärkesnamn och branschtermer i förväg så att de transkriberas korrekt.
Transkriptioner från callcenter kan också innehålla känslig information som behöver maskeras, till exempel personnummer och kreditkortsnummer. Scribe v2 har entitetsidentifiering som hittar och tidsstämplar dessa känsliga uppgifter så att du kan ta bort dem.
Podcastarkiv: Batchtranskribering
När du bygger ett podcastarkiv behöver du välbearbetade transkriptioner som ditt team och din publik kan använda som referens när som helst. Exakthet och tydlig formatering är avgörande här, vilket gör batchtranskribering till rätt val.
Med batchtranskribering får du korrekt transkribering med talarmärkning och talarseparering för alla dina podcastfiler. Scribe v2 har också ordagrannhetsläge av, som automatiskt tar bort utfyllnadsord, stamning och upprepningar. Det innebär att du lägger mindre tid på manuell redigering och kan bygga ditt podcastarkiv snabbare.
ElevenAPI har inbyggt stöd för både realtids- och batchlägen. Om du kör flera transkriberingsprojekt samtidigt kan du använda ElevenAPI för att hantera dem alla på samma plattform. Välj bara rätt modell för varje projekt, utan besväret med att växla fram och tillbaka mellan tjänsteleverantörer.
Hybrida transkriberingsmodeller: kopplar samman realtid och batch
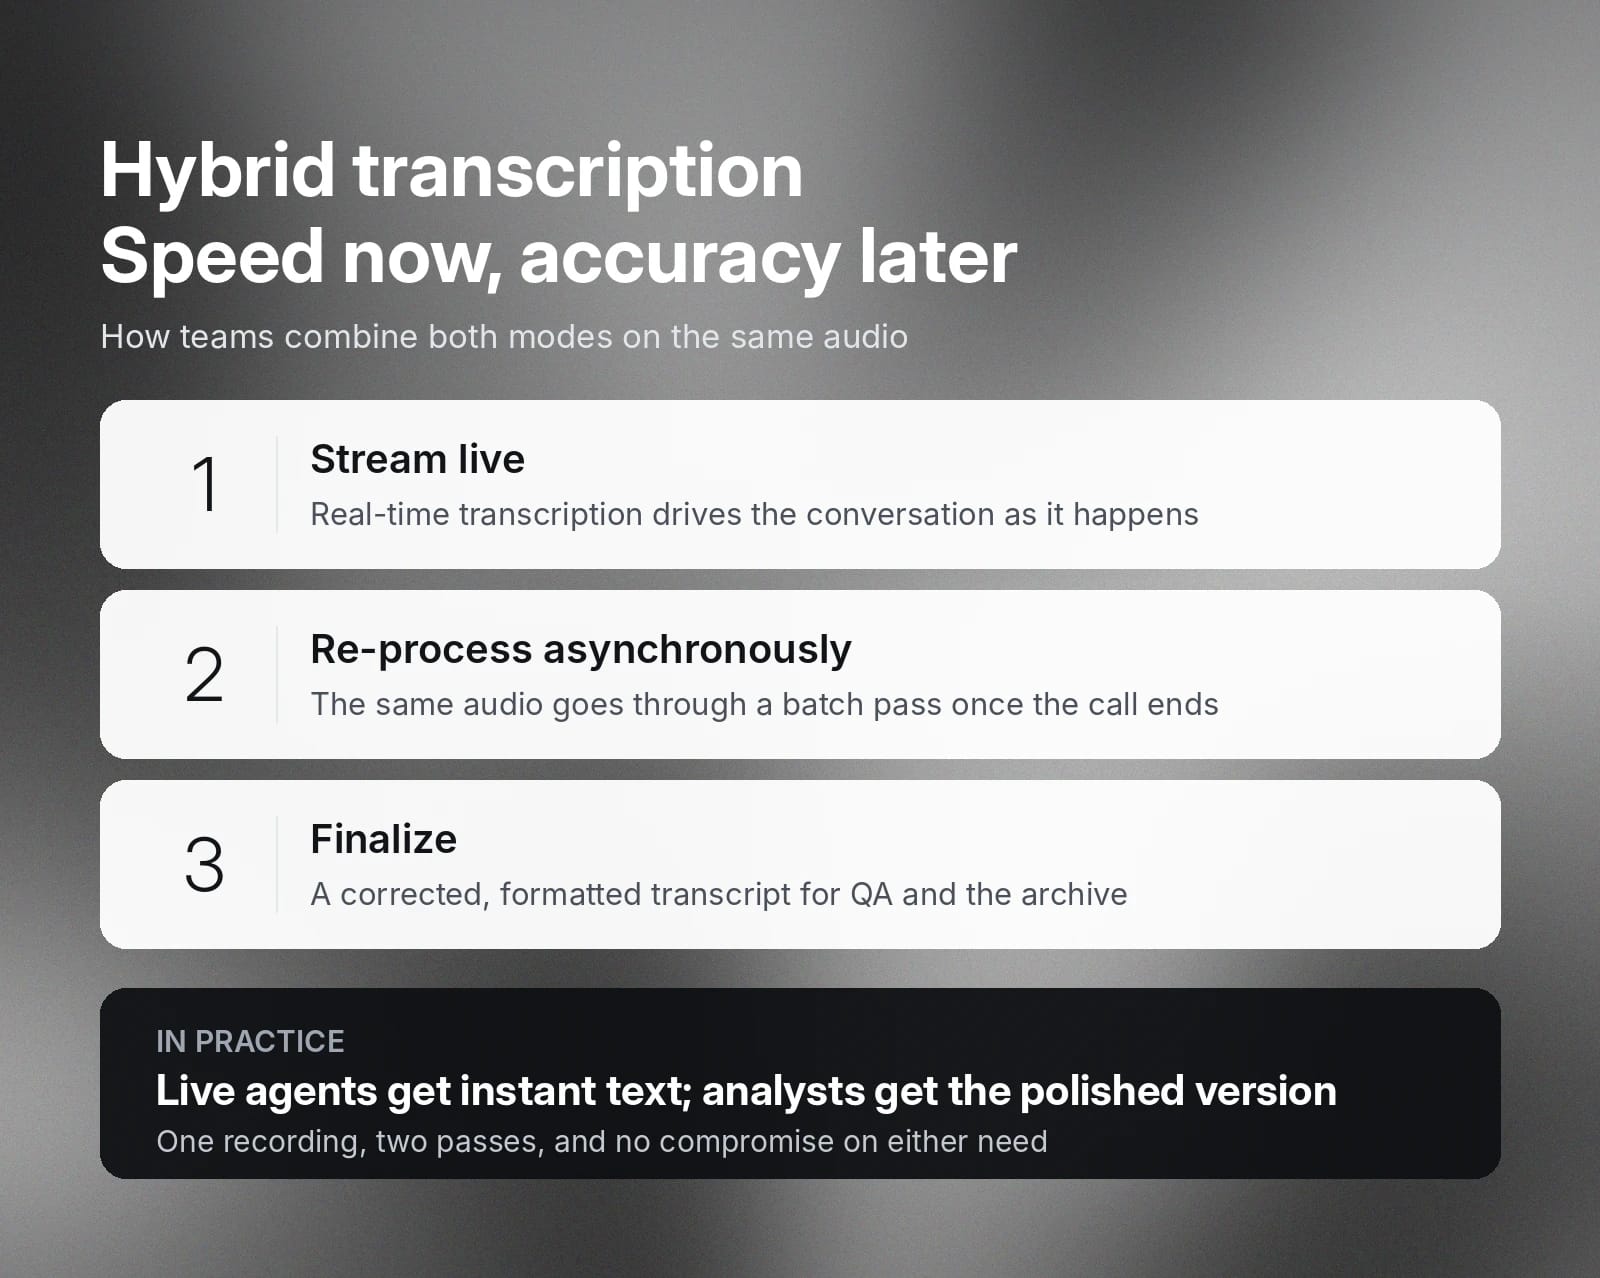
Hybrida transkriberingsarkitekturer kombinerar realtids- och batchmodeller för en balans mellan snabbhet och exakthet.
Ett kundtjänstteam kan till exempel använda en hybridmodell för att få omedelbara resultat under livesamtal och sedan bearbeta transkriptionen för kvalitetssäkring och arkivering. Live-agenter använder transkribering i realtid och skickar sedan den första transkriptionen till en batchmodell för asynkron ombearbetning.
Så här fungerar flödet:
Kom i gång med ElevenAPI för flexibla transkriberingslösningar
ElevenAPI erbjuder både realtids- och batchmodeller för snabb och korrekt transkribering på över 90 språk. ElevenAPI:s branschledande transkriberingsmodeller ger korrekta resultat även med ljud av låg kvalitet, bakgrundsljud eller starka accenter.
ElevenAPI erbjuder både realtids- och batchmodeller för snabb och korrekt transkribering med stöd för över 90 språk. Scribe v2 ger branschledande transkriberingsexakthet, och Scribe v2 Realtime ger exceptionell exakthet för användningsområden i realtid. Båda levererar tillförlitliga resultat även med ljud av låg kvalitet, bakgrundsljud eller starka accenter.
Båda modellerna finns på samma smidiga plattform och hjälper dig att bygga en transkriberingsarkitektur som passar dina behov. Utforska ElevenLabs Speech to Text API för att se det i praktiken, eller skapa en API-nyckel för att komma i gång.



