
Interaktionsmodeller: Bygga naturlig dialog mellan människa och AI
- Skriven av
- Jack Limebear
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
Alla som har försökt avbryta en AI-röstagent mitt i en mening vet hur det känns när ett system inte är byggt för mänskliga samtal. Rytmen är fel, rösten är frikopplad från innehållet, och även när informationen stämmer känns interaktionen märklig: inte som att prata med en kunnig person, utan som att navigera i programvara som råkar använda ord.
Orsaken till att det känns onaturligt är strukturell. Många AI-röstsystem är byggda för att hantera turer snarare än samtalets verkliga flöde. De lyssnar, bearbetar och svarar på ett utbyte i taget. Det fungerar för enkla demonstrationer, men fallerar när samtalet blir känslomässigt och oförutsägbart.
Interaktionsmodeller är AI-system utformade för att kommunicera via ljud och text i realtid. De uppfattar inte bara vad som sägs, utan också när det sägs och vilken känslomässig respons situationen kräver. Den här artikeln förklarar vad som skiljer en interaktionsmodell från andra modeller, varför det spelar roll för företag som använder röst-AI och hur ElevenLabs bygger mot detta.
Sammanfattning
- De flesta röst-AI-system fungerar dåligt i riktiga samtal eftersom de inte kan hantera avbrott, tystnad eller sammanhang som följer med mellan turerna.
- ElevenLabs interaktionsstack är utformad för att hantera avbrott, pauser och överlappande tal utan att förlora sammanhanget eller bryta samtalsflödet.
- ElevenLabs bygger mot verkliga interaktionsmodeller med en avancerad kaskadarkitektur samt egenutvecklad Speech to Text (STT) och Text to Speech (TTS), och en stack optimerad för låg latens och naturliga samtal som flyter fram och tillbaka.
Varför det mesta av kommunikationen mellan människa och röst-AI inte känns naturlig
De flesta röst-AI-system behandlar ett samtal som en serie separata inmatningar och utdata: systemet väntar på ett talblock, omvandlar det till text, bearbetar texten och svarar. Det fungerar för kommando-och-svar-interaktioner, men ett riktigt samtal är inte en ren följd av textutbyten. Det är ett ständigt fram och tillbaka, fyllt av pauser och inpass.
När flödet mellan turerna och sammanhanget som följer med mellan dem försvinner uppstår tre specifika problem:
- Det avbryter dig eller får dig att vänta: Systemet kan inte skilja en tankepaus från en avslutad tur, så det avbryter antingen medan du fortfarande pratar eller är tyst när du har slutat. Samla tankarna mitt i en mening och du blir avbruten; avsluta din poäng och du får vänta genom en stunds död tystnad.
- Det kan inte reagera när det väl har börjat prata: I samma stund som systemet börjar svara slutar det lyssna. Om du avbryter för att styra om fortsätter det att ge svaret på en fråga som du redan har gått vidare från, eftersom det inte kan registrera att något har förändrats.
- Det glömmer under tiden: Varje tur bearbetas isolerat, så sammanhang från fem utbyten tidigare följer inte med. Du får upprepa dig, eller så svarar systemet som om samtalet precis har börjat.
Resultatet är ett samtal som kan vara funktionellt korrekt men ändå kännas fel.
Vad interaktionsmodeller kan göra som traditionell röst-AI inte kan
Traditionell röst-AI hanterar en tur i taget, medan en interaktionsmodell hanterar hela samtalet och samtidigt uppmärksammar både vad som sägs och vad som behöver hända härnäst. Den avgörande skillnaden är att en interaktionsmodell svarar utifrån samtalets faktiska läge.
Interaktionsmodeller har:
- Respons i realtid: Systemet är utformat för att svara i samtalstempo, med en hel cykel som beroende på konfiguration kan ta mindre än en sekund.
- Naturlig hantering av avbrott, tystnad och överlappning: Det skiljer mellan en tankepaus och en avslutad tur, så att det inte avbryter personer eller lämnar död tystnad. Och när kunden pratar samtidigt för att styra om hanterar det överlappningen utan att förlora sammanhanget eller få samtalet att falla samman.
- Kontinuitet genom hela utbytet: I stället för att återställa sammanhanget vid varje tur tar systemet med sig samtalshistoriken, så att det som sägs i tur 10 återspeglar allt som har hänt sedan tur ett.
- Anpassad leverans: Rösten kan programmeras att skifta (lugnare, mer direkt, mer lugnande) beroende på vilken uppgift den utför.
- Parallell uppgiftskörning: Systemet hämtar information, gör verktygsanrop och fortsätter prata samtidigt, i stället för att bli tyst medan det letar upp något.
Testet för en interaktionsmodell är ett samtal som går dåligt. I inspelningen nedan ringer en kund om ett inställt flyg. Personen är stressad och behöver snabbt få problemet löst.
Agenten uppfattar genast kundens brådska och frustration utifrån orden som används. Den anpassar sin ton, hanterar avbrottet utan att tappa tråden och använder sina anslutna verktyg för att erbjuda verkliga lösningar på det inställda flyget. Till slut får kunden en lösning utan att behöva en mänsklig agent.
Jämför detta med de vanliga turbaserade agenter som används i dag. De här systemen skulle vänta vid varje paus, svara från ett neutralt utgångsläge och helt missa kundens frustration. Efter några utbyten som inte bemöter vad den som ringer faktiskt känner skulle samtalet troligen behöva lämnas över till en människa, vilket gör kunden ännu mer frustrerad än från början.
Så bygger ElevenLabs mot interaktionsmodeller
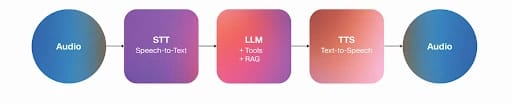
Vår samtalspipeline använder en avancerad kaskadarkitektur i stället för en sammanslagen arkitektur, så i stället för att en modell hanterar allt är varje steg en egen specialiserad komponent.
Fördelen med den här metoden är att vi kan optimera varje steg i pipelinen var för sig och byta till en bättre modell för valfri komponent utan att behöva bygga om hela systemet. Eftersom vi utvecklar komponenterna själva optimeras de också tillsammans för att överföra rik kontext mellan varandra. Det gör att pipelinen fortfarande fungerar som ett sammanhängande samtal, snarare än som en kedja av separata verktyg.
Struktur för kaskadmodell
Struktur för sammanslagen modell
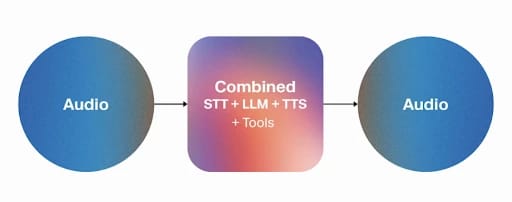
Bilder: Kaskadmodeller jämfört med sammanslagna modeller
Här är tekniken som för närvarande ingår i pipelinen:
- Scribe v2 Realtime: Vår egenutvecklade STT-modell transkriberar tal på omkring 150 ms på över 90 språk och klarar bakgrundsljud, accenter, avbrott och icke-verbala händelser som skratt och pauser. Den är även byggd för att hantera branschspecifik vokabulär, från medicinska termer till finansiell jargong.
- Spekulativ turhantering: Det här systemet avgör när det ska prata, pausa eller vänta genom att läsa av samtalsflödet i stället för att förlita sig på en fast tröskel för tystnad. Förbättringar av vår röstaktivitetsdetekteringsmodell hjälper den att bättre filtrera bakgrundstal och korta svar, vilket gör turhanteringen mer naturlig.
- Eleven v3 Conversational: En av våra mest uttrycksfulla TTS-modeller, utformad för direkta dialoger fram och tillbaka. Den för vidare samtalets känsloläge mellan turerna, så att agentens sätt att uttrycka sig i tur 10 speglar allt som har hänt tidigare.
- Expressive Mode: Byggt på Eleven v3 Conversational och systemet för turhantering styr Expressive Mode hur agenten låter i stunden. Det dämpar situationen när kunder är frustrerade, lugnar när de är förvirrade och är direkt när tydlighet behövs. Det läser också uttryckstaggar, så modellen kan agera på signaler som [laughs], [whispers] eller [sighs] för att forma specifika delar av leveransen.
- Flash v2.5: Vår TTS-modell med låg latens stöder 32 språk och genererar tal på under 75 ms. När latens är högsta prioritet håller den svarstiden inom intervallet för naturlig mänsklig rytm.
- Speech Engine: Det sammanbindande lagret som håller ihop stacken och kopplar din server till vår ElevenAPI via WebSocket, med en anslutning per samtal. Vi hanterar STT och TTS medan din server kör LLM:en, så tekniska team kan använda sin egen modell och behålla samtalslogiken i sin egen infrastruktur.
Dessa modeller förbättras hela tiden och nya versioner släpps regelbundet. Varje ny version minskar skillnaden mellan att prata med programvara och att prata med en person, med snabbare svar, skarpare känsloigenkänning, fler språk och smidigare leverans.
Prata medan systemet tänker
Alla delar av en interaktionsmodell behöver inte köras i en strikt följd. ElevenAgents kan fortsätta arbeta i bakgrunden medan samtalet pågår, i stället för att automatiskt bli tyst mellan en fråga och ett svar.
Några centrala system samverkar för att möjliggöra prat och tänkande samtidigt:
- Parallella verktygsanrop: Agenten kan söka i en databas, köra ett verktyg eller kontrollera orderstatus medan den fortfarande pratar, så att hämtning aldrig känns som en död paus i samtalet.
- Mjuk timeout: Om en LLM tar längre tid än väntat på sig att generera ett svar säger agenten en kort utfyllnadsfras som ”Låt mig tänka” eller ”hmmm” i stället för att lämna en obekväm tystnad. Mjuk timeout hjälper till att bevara ett naturligt samtalsflöde och minskar risken för avbrott.
- Termer som ignorerar avbrott: I stället för att använda en fast tröskel för tystnad försöker systemet tolka innebörden i det som sägs för att förstå när en tur faktiskt är avslutad. På samma sätt kan korta bekräftelser som ”okej” eller ”mm-hmm” konfigureras att passera utan att utlösa ett fullständigt avbrott, vilket innebär att agenten inte tappar tråden varje gång den som ringer gör ett inpass.
Tillsammans ser dessa system till att agenten inte känns som om den buffrar eller laddar ett svar. De bildar en effektiv samtalsmotor som fyller mellanrummen naturligt på samma sätt som en person skulle göra, samtidigt som den bearbetar information och samlar tankarna i bakgrunden.
Så fungerar ett samtal med ElevenLabs i praktiken
Komponenterna ovan körs inte efter varandra i en prydlig rad. De överlappar. Så här skulle en agent från ElevenLabs hantera en person som mitt i ett supportsamtal frågar: ”Har min order skickats ännu, eller behandlas den fortfarande?”
- Den som ringer pratar: Ljud strömmas till ElevenLabs via WebSocket-anslutningen, och Scribe börjar transkribera i realtid, omkring 150 ms efter rösten.
- Systemet läser av flödet: Medan Scribe fortfarande transkriberar bedömer den spekulativa turhanteringen redan om den som ringer har avslutat sin mening eller fortfarande tänker. Det avslutande ”eller behandlas den fortfarande?” tolkas som en överlämning snarare än en paus, så det utlöser nästa steg i stället för att vänta i tystnad.
- LLM:en sammanställer sammanhang och svarar: Den transkriberade frågan skickas till LLM:en tillsammans med samtalshistoriken, orderuppgifterna som hämtas från företagets egna system via RAG, verktygsresultat från tidigare i samtalet och systemprompten. Den resonerar utifrån allt detta och genererar ett svar baserat på uppringarens beställning.
- TTS-modellen syntetiserar svaret: Texten blir naturligt ljudande ljud. Om Expressive Mode är aktivt innehåller svaret leveranssignaler som passar situationen, så att en rutinmässig uppdatering låter enkel och avspänd snarare än platt. När latens är högsta prioritet hanterar Flash syntesen på under 75 ms.
- Svaret strömmas tillbaka: Ljudet börjar spelas upp innan syntesen är klar, så den som ringer hör början av svaret medan resten fortfarande genereras.
- Cykeln upprepas: Varje ny tur för samtalets ton, sammanhang och historik vidare.
Genom denna snabba process känns samtalet naturligt. Den som ringer slutar anpassa sig till maskinen: personen saktar inte ner, uttalar inte övertydligt och väntar inte på en ton. Personen pratar bara, på samma sätt som med en annan människa.
Driftsätt naturligt låtande röstagenter i hela verksamheten
Allt som beskrivs här används redan i produktion. Från den kaskadkopplade arkitekturen till pipelinen med svarstider under en sekund, företag över hela världen redan ElevenAgents för att hantera riktiga kundsamtal i stor skala.
Det omfattar reglerade miljöer med höga insatser, eftersom vår agentarkitektur stöder skyddsräcken, granskningsloggar och efterlevnadskontroller. ElevenLabs är certifierat för SOC 2 Type II, ISO 27001, HIPAA och PCI DSS Level 1, med Zero Retention Mode och regional datalagring för team som behöver hålla data inom en specifik gräns.
Redo att sätta en agent i arbete? Du kan skapa en agent och börja bygga i konsolen, eller prata med vårt säljteam om en driftsättning anpassad till din miljö.
Vanliga frågor om interaktionsmodeller

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.


