Vad är Audio Tags? Den kompletta guiden till emotionell TTS
- Skriven av
- Jack Limebear
- Publicerad
- Senast uppdaterad
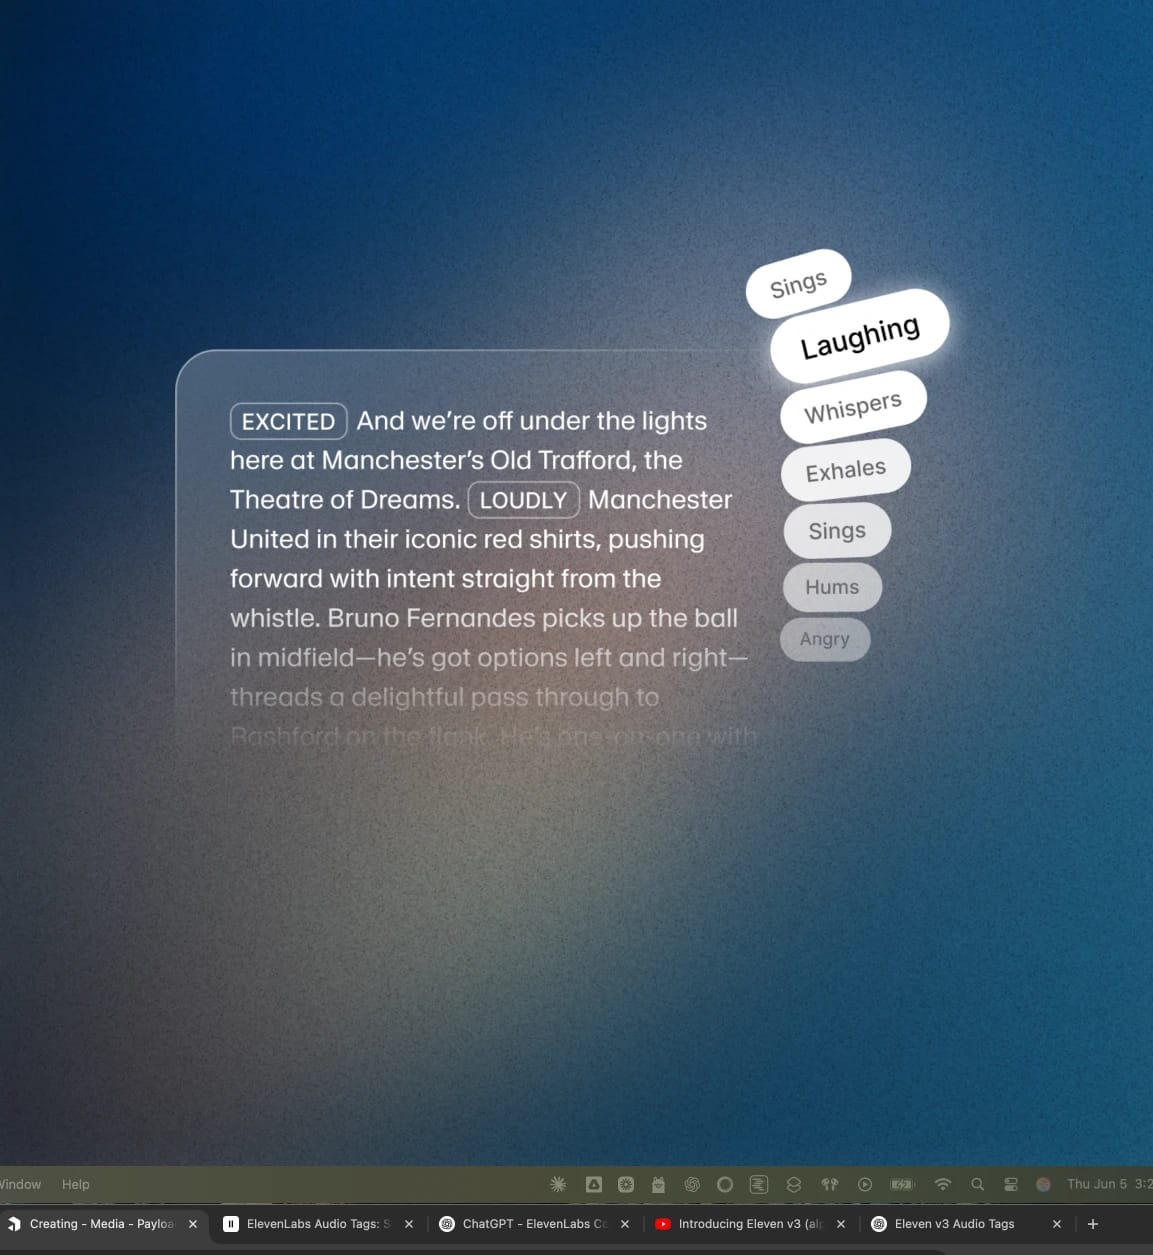
Audio Tags är signaler inom hakparenteser på naturligt språk, som [laughs], [gasps], [excited] och [worried], vilka Eleven v3 och Eleven v4 tolkar som instruktioner för framförandet snarare än ord som ska sägas. När du skriver ett manus för en Text to Speech-modell får du detaljerad kontroll över textens känslomässiga framförande genom att lägga in dessa Audio Tags.
Eleven v3 blev offentligt tillgänglig i mars 2026. Före v3 innebar det att få fram ett specifikt känslomässigt framförande från en Text to Speech-modell att återskapa innehåll och hoppas på det bästa. Audio Tags tar bort gissningsarbetet och ger dig full kontroll över ett känslomässigt Text to Speech-framförande. Eleven v4 tar det ännu längre och ger dig detaljerad känslomässig kontroll.
I den här guiden går vi igenom vad Audio Tags är, hur de fungerar, alla tillgängliga taggkategorier och hur de jämförs med SSML (Speech Synthesis Markup Language). Vi tar också upp vanliga användningsområden, med länkar till en egen detaljerad guide för varje område.
Sammanfattning
- Audio Tags är signaler inom hakparenteser, som [shouts] eller [excited], som styr känsla, tempo, leverans och ton i TTS i Eleven v3 och Eleven v4.
- Eleven v3 och Eleven v4 har inte stöd för SSML, utan ersätter det med Audio Tags för en mer naturlig skrivupplevelse.
- Taggarna täcker flera kategorier, till exempel känslor, leverans och tempo, mänskliga reaktioner, accenter och ljudeffekter.
- Interpunktion och versaler i texten låter dig forma tempot i ett AI-röstframförande.
- Du kan använda Audio Tags i ElevenLabs via användargränssnittet eller API:et.
Hur fungerar Audio Tags?
Audio Tags placeras direkt i ditt transkript och omsluts av hakparenteser. När du vill ändra framförandet, exempelvis från normalt till [worried], behöver du bara lägga till en audiotagg.
Du kan också använda fler än en tagg i samma mening och kombinera taggar för ett mer nyanserat framförande, till exempel [tired] Det har varit en lång dag… [upset] Hur många fler dagar orkar jag?
Arkitekturen bakom Eleven v4 gör att modellen kan läsa kontext på en djupare nivå än tidigare modeller. Den kan följa känslomässiga signaler, tonskiften, talarbyten och ledtrådar i sammanhanget utan någon separat parameter eller inställning. Berätta bara för modellen vad ögonblicket kräver, så framför den repliken precis som du planerat.
Eleven v4 hanterar också dialoger mellan flera talare som känns spontana, inklusive avbrott, humörskiften och det naturliga samspelet i verkliga samtal – allt enbart utifrån taggar och manusets struktur.
Audio Tags jämfört med SSML
Om du har arbetat med andra TTS-system har du troligen stött på Speech Synthesis Markup Language. Plattformar som Amazon Polly och Microsoft Azure Speech använder SSML-taggar som <break> eller <emphasis> för att ge ett TTS-manus ytterligare kontext.
Eleven v4 har inte stöd för SSML:s break-taggar eller resten av SSML-tagguppsättningen. I stället tar Audio Tags, interpunktion och själva textstrukturen över den rollen, samtidigt som du får detaljerad kontroll över framförandet.
Du kan använda tabellen nedan för att koppla vanliga SSML-taggar till motsvarigheten i Eleven v4.
Ur skribentens perspektiv kräver det mycket mindre arbete att lägga till [whispers] i en replik än att konfigurera en prosodi-hastighet.
Kategorierna av Audio Tags i v3: Styr framförandet med Audio Tags
Du kan placera Audio Tags var som helst i manuset för att forma framförandet i realtid. Du kan också använda kombinationer av taggar i ett manus eller till och med i en mening.
Taggarna delas in i följande huvudkategorier.
Känslor
De här taggarna kan hjälpa dig att ange röstens känslomässiga ton, oavsett om den är dyster, intensiv eller uppåt. Du kan till exempel använda en eller en kombination av [sad], [angry], [happily] och [sorrowful].
Leverans och tempo
De här handlar mer om ton och framförande. Du kan använda dem för att justera volym och energi i scener som kräver återhållsamhet eller kraft. Exempel är taggar som [whispers], [shouts] och [softly].
Mänskliga reaktioner
Verkligt naturligt tal innehåller reaktioner. Du kan till exempel öka realismen genom att väva in naturliga, oplanerade ögonblick i talet. Taggar som [laughs], [clears throat] och [sighs] hjälper alla till att skapa en TTS-modell som kan förmedla mänskliga känslor.
Andra exempel på kategorier av audiotaggar är:
- Accenter och karaktärsröster: Accenttaggar förflyttar rösten till en specifik region eller persona utan att du behöver byta modell, till exempel [French accent], [British accent] eller [pirate voice]. Använd dem för att förvandla en enskild röst till en flexibel ensemble i stället för ett fast framförande.
- Ljudeffekter: Taggar för ljudeffekter lägger till ljud utan tal direkt i genereringen, till exempel [gunshot], [explosion] och [clapping]. De fungerar bra för uppslukande ljud, spel och dramatiserad berättarröst där scenen behöver mer än bara en röst. Du kan också använda ElevenCreative AI-ljudeffektgenerator.
Taggar ger dig hög kontroll, men du kan också använda interpunktion för att forma rytm och betoning. Lägg till exempel till en ellips för en naturlig paus eller använd kommatecken för att skapa naturliga andningsmönster. Prova att skriva ett ord med enbart versaler för att betona det: ”Jag vill ha det NU.”
Vad kan du göra med Audio Tags?
Audio Tags gör manusens känslomässiga komplexitet lättillgänglig på ett intuitivt sätt. Skriv naturligt och lägg till taggar efter hand.
Här är en snabb översikt över några användningsområden för känslomässig TTS med Audio Tags.
Situationsmedvetenhet i AI-ljud
Taggar som [whisper] eller [shouting] låter Eleven v4 reagera på situationen. Du kan bygga in dynamisk situationsmedvetenhet i manuset, från att tona ned en varning till att hålla en utdragen paus för att skapa spänning.
Läs vår guide om situationsmedvetenhet i AI-ljud för en fullständig genomgång.
Styr karaktärers framförande i tal
När du bygger ett manus med flera karaktärer vill du tydligt visa hur varje röst skiljer sig åt. Från att finjustera deras personlighet med [sarcastically] till att definiera hur de talar med [British accent] kan du fånga hela känsloregistret med vår TTS-motor.
Läs mer om att styra karaktärers framförande i AI-tal.
Uttryck känslomässig kontext i tal
Med Audio Tags kan du forma det känslomässiga framförandet av en replik medan den utvecklas. Du kan bygga upp känslor genom ett tal och nå ett crescendo precis när du föreställer dig att karaktären når sin fulla potential. Taggar som [awe], [booming] och [big laugh] hjälper dig att bygga in ett helt känsloregister i din AI-rösts framförande.
Läs mer om hur du använder känslomässig kontext i AI-tal.
Ge dialog mellan flera karaktärer liv
När du skapar dialogframföranden med flera karaktärer kan du börja varje replik med en audiotagg för att bygga rika karaktärsdiskussioner.
Ta följande som exempel: Tom: [coughing] [beginning to speak] förlåt, jag är lite sjuk i dag— Emma: [interrupting] —Sjuk? Du vet hur mycket jag hatar hosta, Tom! Tom: [surprised] Det är bara lite hosta, inget allvarligt. Hur skulle du känna om— Emma: [overlapping] [annoyed] —Jag tycker att du behöver gå hem.
Se vad mer du kan göra med dialog mellan flera karaktärer i Eleven v3.
Exakt kontroll över leveransen i AI-tal
Du kan styra talets tempo i Eleven v3 och Eleven v4 med Audio Tags eller genom interpunktion. Taggar som [pause], [rushed] eller [drawn out] låter dig aktivt forma repliken med precision. Du kan också lägga till ellipser, punkter och utropstecken för att naturligt bygga in känslor i ditt TTS-framförande.
Vi har skrivit en djupgående guide om exakt kontroll över leveransen i Eleven v3.
Känslomässig TTS är tillgänglig via API:et
Audio Tags fungerar på samma sätt via Text to Speech API som i ElevenLabs användargränssnitt. Skriv taggen direkt i manustexten, så returnerar API:et det taggade framförandet i det genererade ljudet – från ljudboksflöden till voice-overs för annonser.
Läs mer om Eleven v4 eller kontakta säljteamet för att komma i gång i dag.
Vanliga frågor om Audio Tags och känslomässig TTS

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.