Möt Flash
- Publicerad
LyssnaLyssna på den här artikeln
Möt Flash. Vår senaste modell som genererar tal på 75 ms + applikations- och nätverkslatens.
Flash är vår rekommenderade modell för röstassistenter för konversationer med låg latens. Du kan använda Flash redan i dag på vår Conversational AI-plattform.
Du kan också bygga direkt via API:t med modell-id:t ”eleven_flash_v2” och ”eleven_flash_v2_5”: https://elevenlabs.io/docs/api-reference/text-to-speech/convert
Flash v2 finns endast på engelska och Flash v2.5 har stöd för 32 språk. Båda kostar 1 kredit per 2 tecken
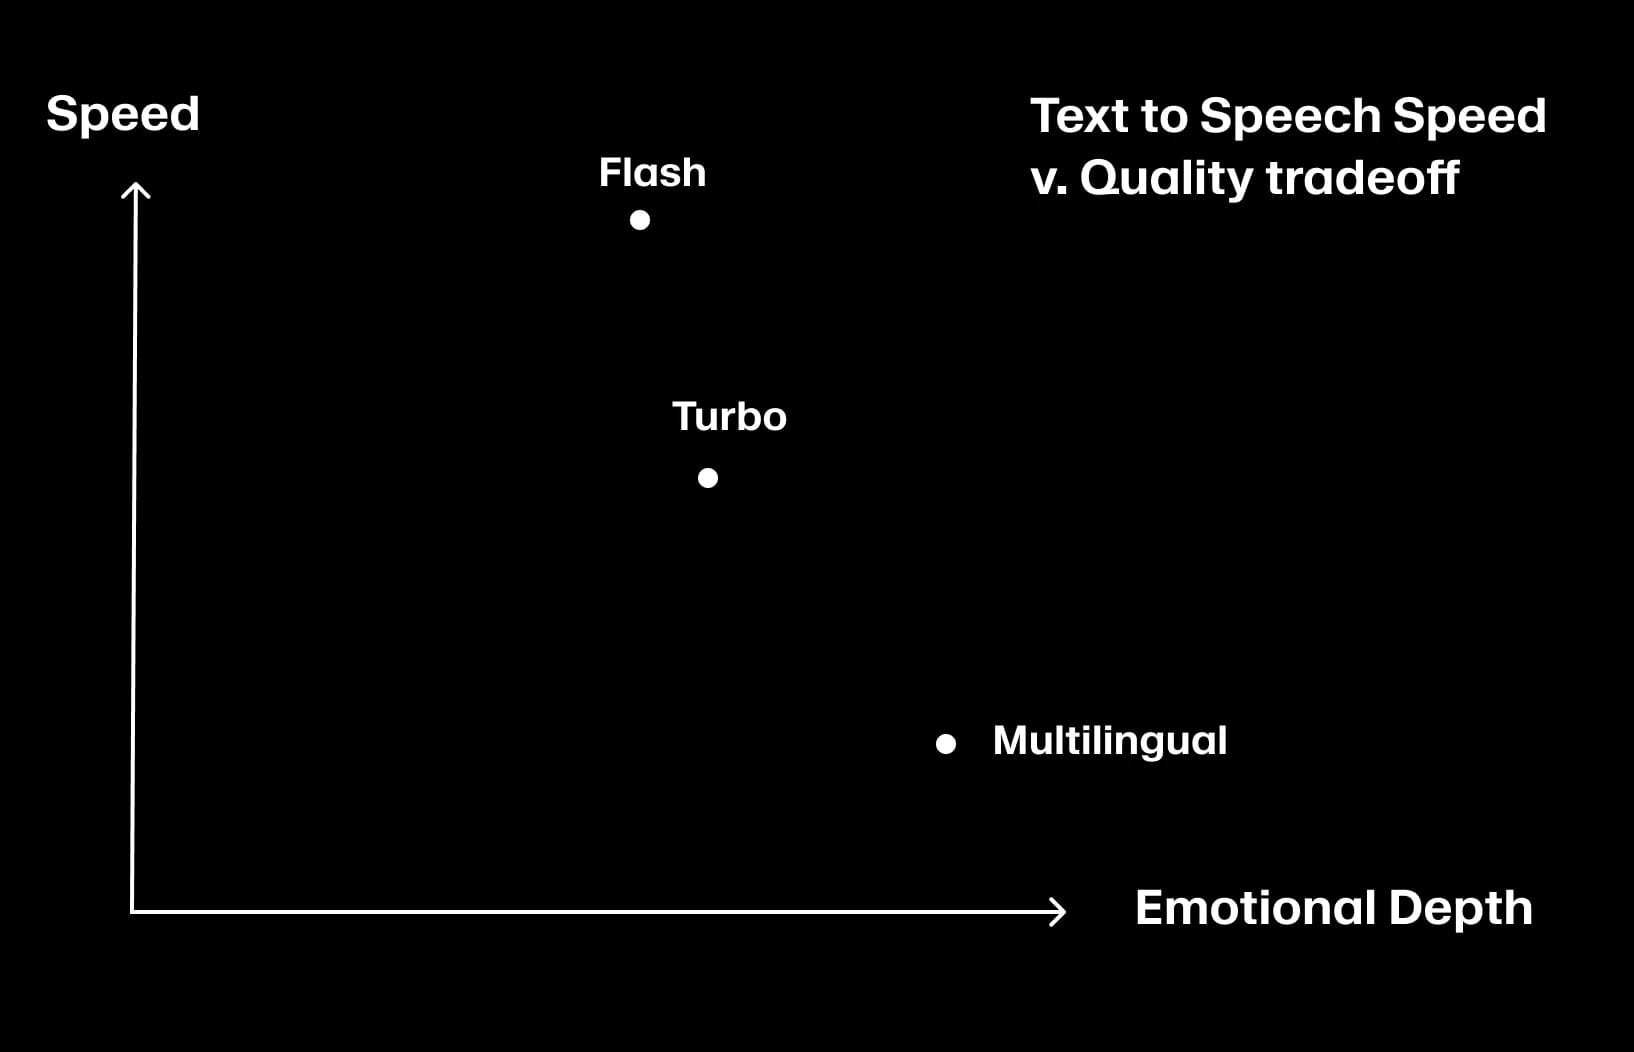
Den har något lägre kvalitet och känslomässigt djup än Turbo-modellerna, men betydligt lägre latens. I blindtester som genomfördes av våra mänskliga bedömare fick Eleven Flash konsekvent högre resultat än jämförbara modeller med ultralåg latens, vilket gör den till den snabbaste modellen i sitt slag med den här kvalitetsnivån.
Se vår guide om modeller för att hitta den som passar bäst för ditt användningsområde: https://elevenlabs.io/docs/developer-guides/models
Vi ser fram emot att se alla människoliknande konversationer med låg latens som Flash kommer att möjliggöra.