Vi presenterar Eleven v4, vår mest uttrycksfulla modell
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
En textrad kan förändras avsevärt beroende på hur den sägs. ”Jag behöver att du håller dig lugn” bör låta olika beroende på vem som säger det – oavsett om det är en läkare som säger det varsamt till en rädd patient eller en karaktär i ett spel som ropar till sin grupp innan de kastar sig in i strid.
I dag lanserar vi Eleven v4, vår mest emotionella text-till-tal-modell hittills, och dess variant med låg latens, Eleven v4 Turbo.
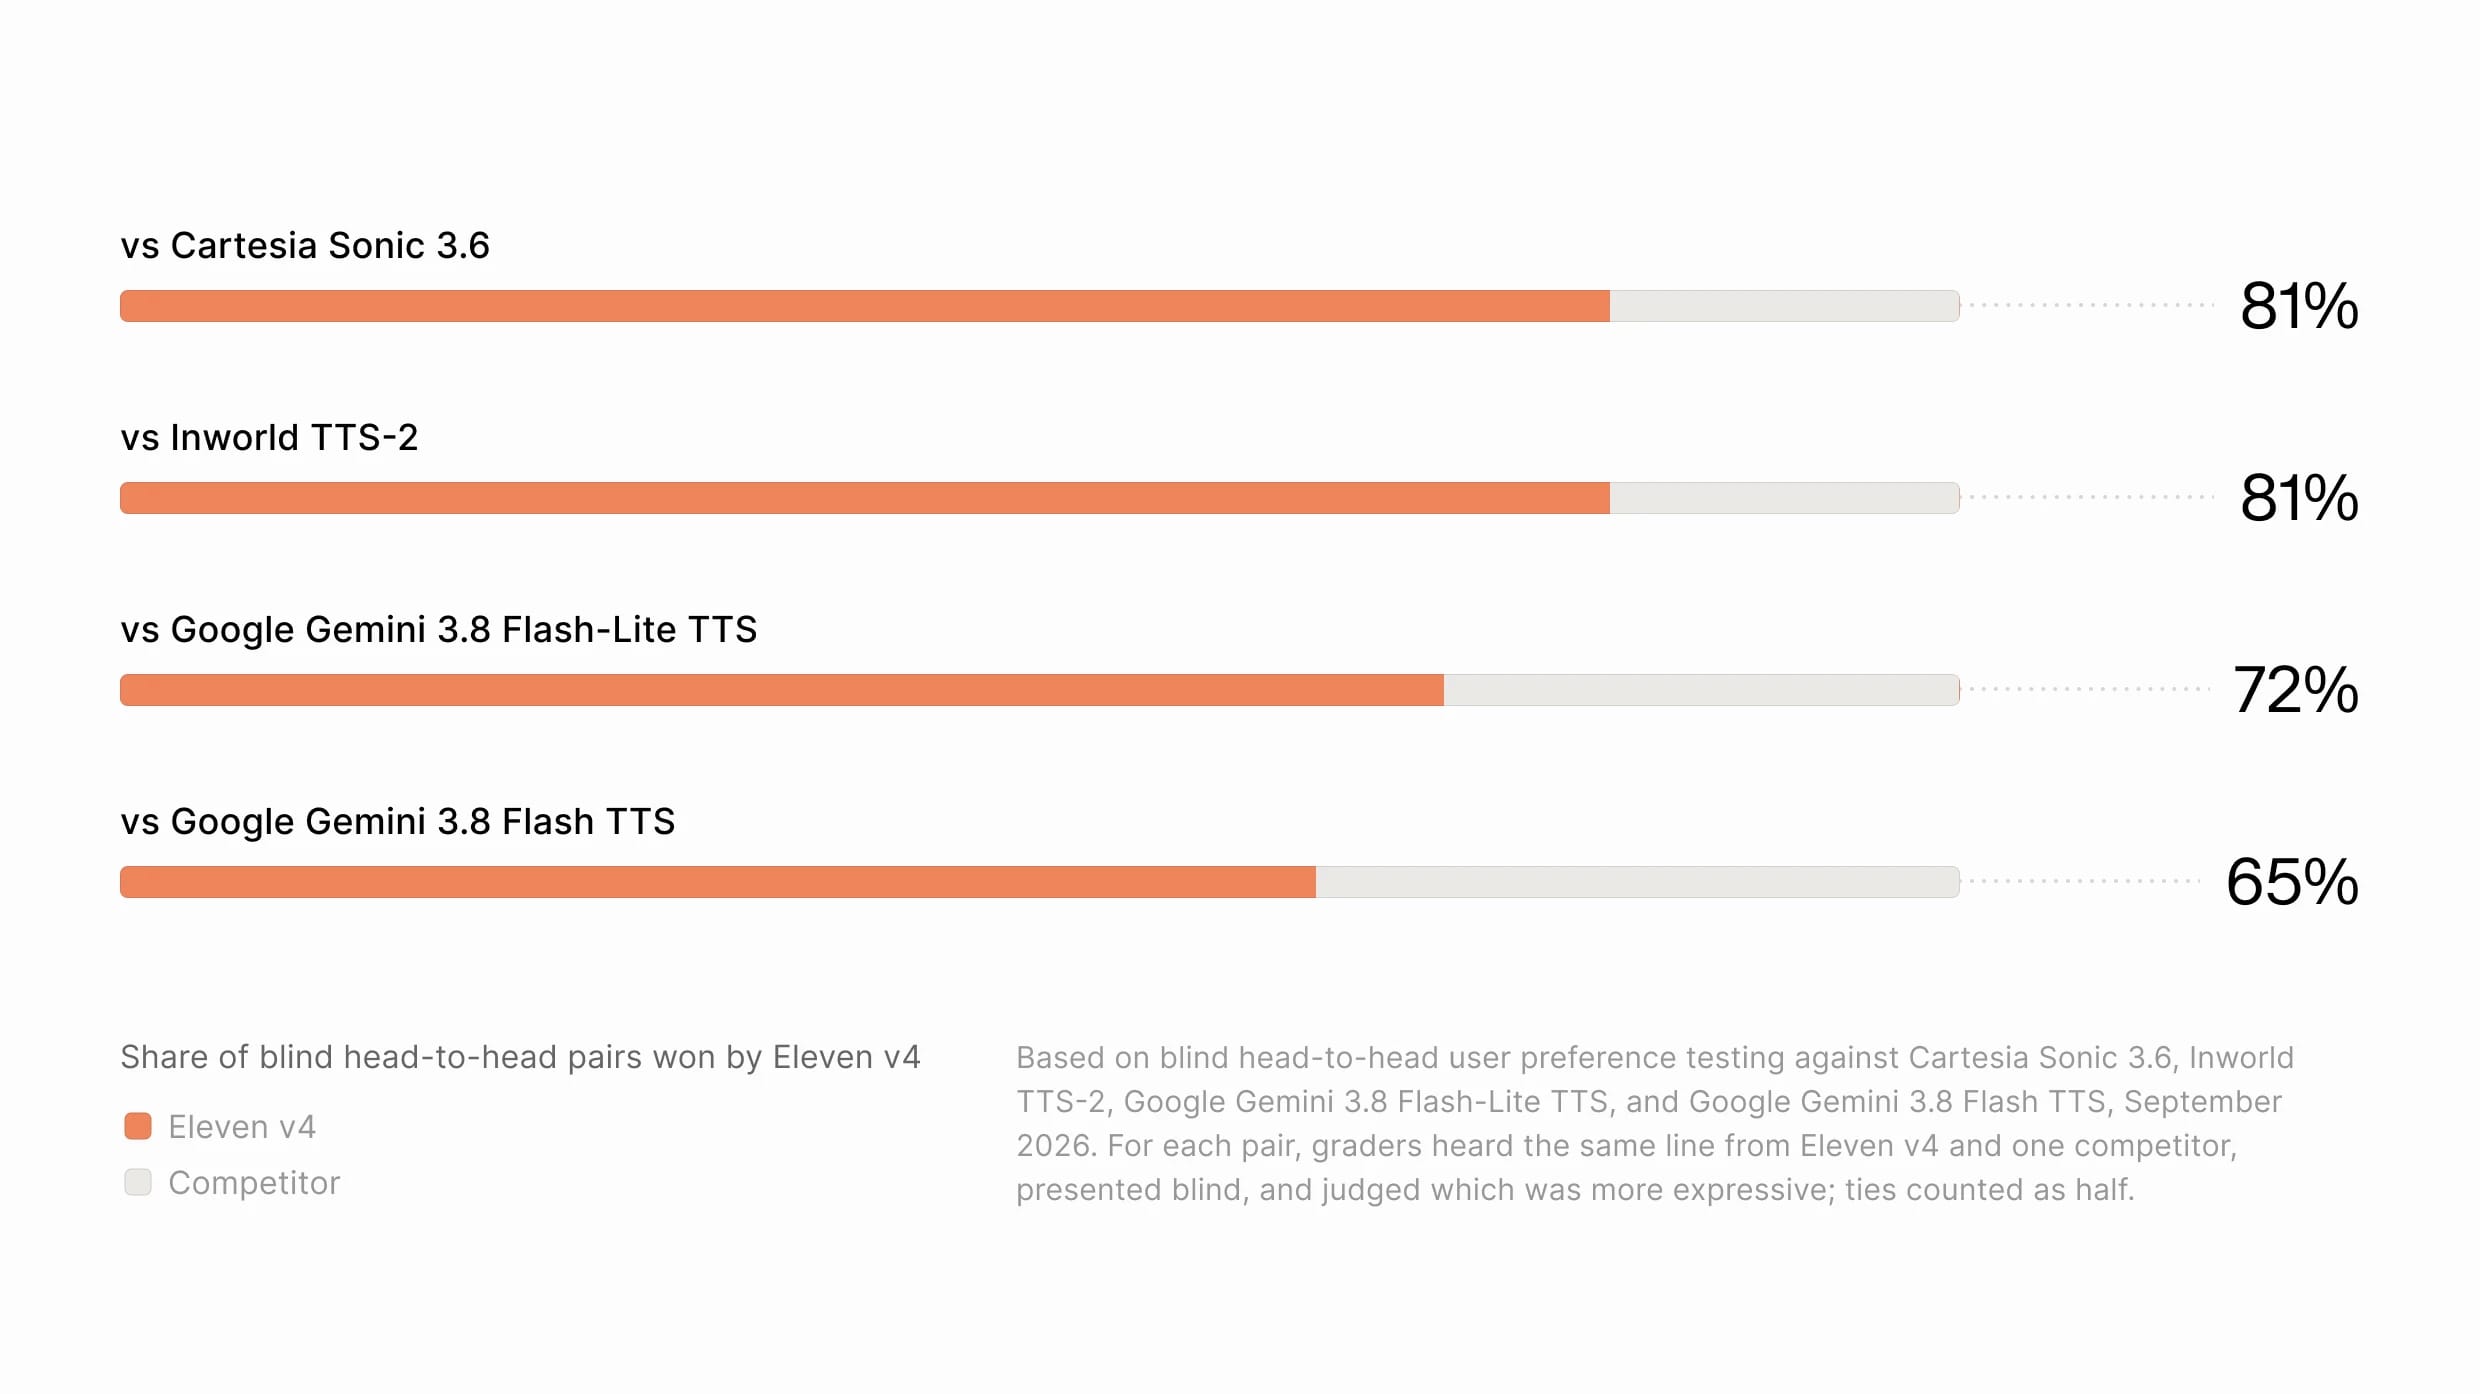
Rankad etta av Artificial Analysis1, och föredragen av cirka 75 % av lyssnarna i blinda jämförande tester mot konkurrerande modeller2, har Eleven v4 utformats för att tolka tonfall, tempo, känslor, karaktär och sammanhang. Den genererar tal som kan låta dramatiskt, ömt, brådskande, komiskt eller samtalsmässigt, samtidigt som talarens identitet bevaras. Mer naturlig dynamik mellan flera talare gör att samtal känns följsamma, i stället för som separata repliker som satts ihop. Talarna reagerar på samtalets sammanhang och skapar mer naturlig dialog och karaktärsinteraktioner.
En ny arkitektur byggd för prestanda
Eleven v4 bygger på en helt ny arkitektur och är vår mest emotionella Text to Speech-modell, rankad etta av Artificial Analysis1. Eleven v4 Turbo använder samma teknik för användningsfall med låg latens, som agenter. Med en medianlatens för inferens på cirka 100 ms kan den svara snabbare än den genomsnittliga pausen mellan två personer som pratar.
Båda modellerna kan generera tal som känns emotionellt snarare än mekaniskt. Ljudåtergivningen är också bättre över hela linjen, med renare och mer naturligt ljudande resultat.
Tidigare generationer av text-till-tal-modeller kan läsa upp text, men Eleven v4 ger talet ett känslomässigt djup som känns betydligt mer naturligt. Modellen kan tolka avsett tonfall, hur talet bör tempoläggas, textens karaktär och sammanhanget i texten för att leverera känslomässigt träffsäkert tal.
Användare har också detaljerad kontroll över resultaten och kan beskriva hur en replik ska framföras med naturligt språk. De kan även lägga till specifika instruktioner om hur vissa fraser ska sägas, vilka känslor de ska förmedla och till och med ljudeffekter, med hjälp av infogade taggar som [laughs], [said angrily in French accent], [light rain] eller [phone buzzing]. Eleven v4 följer dessa ljudtaggar och instruktioner mer exakt än tidigare modeller, så framförandet du beskriver är det du får. Det gör det enklare att regissera berättarröst, utveckla karaktärer eller deras dialog och i andra situationer där framförandet spelar roll.
I ElevenLabs utvecklardokumentation finns den fullständiga taggsyntaxen och information om hur du använder dessa taggar via API:t. Stödet för fonem i det internationella fonetiska alfabetet (IPA) har också förbättrats avsevärt, så anpassade uttal fungerar mer tillförlitligt.
Eleven v4 ger också förbättringar i konsekvens och dynamiska samtal mellan flera talare. Med en ny metod för att fånga talarnas identitet bevarar Eleven v4 varje rösts unika egenskaper. Den kan hålla talet konsekvent genom agentsamtal, ljudböcker eller annonser. Eftersom modellen förstår sammanhanget i en hel scen skapar den naturlig dialog där talarna reagerar på det som just sagts, i stället för att sy ihop fristående repliker.
En Turbo-modell för användningsfall med låg latens
Röstmodeller av hög kvalitet har ofta varit långsammare med att generera tal, vilket har inneburit att användare har behövt välja mellan snabba eller uttrycksfulla röstagenter. Många har valt kompetenta men monotona agenter som kan uppfattas som robotaktiga av en stressad kund som bara vill lösa sitt problem.
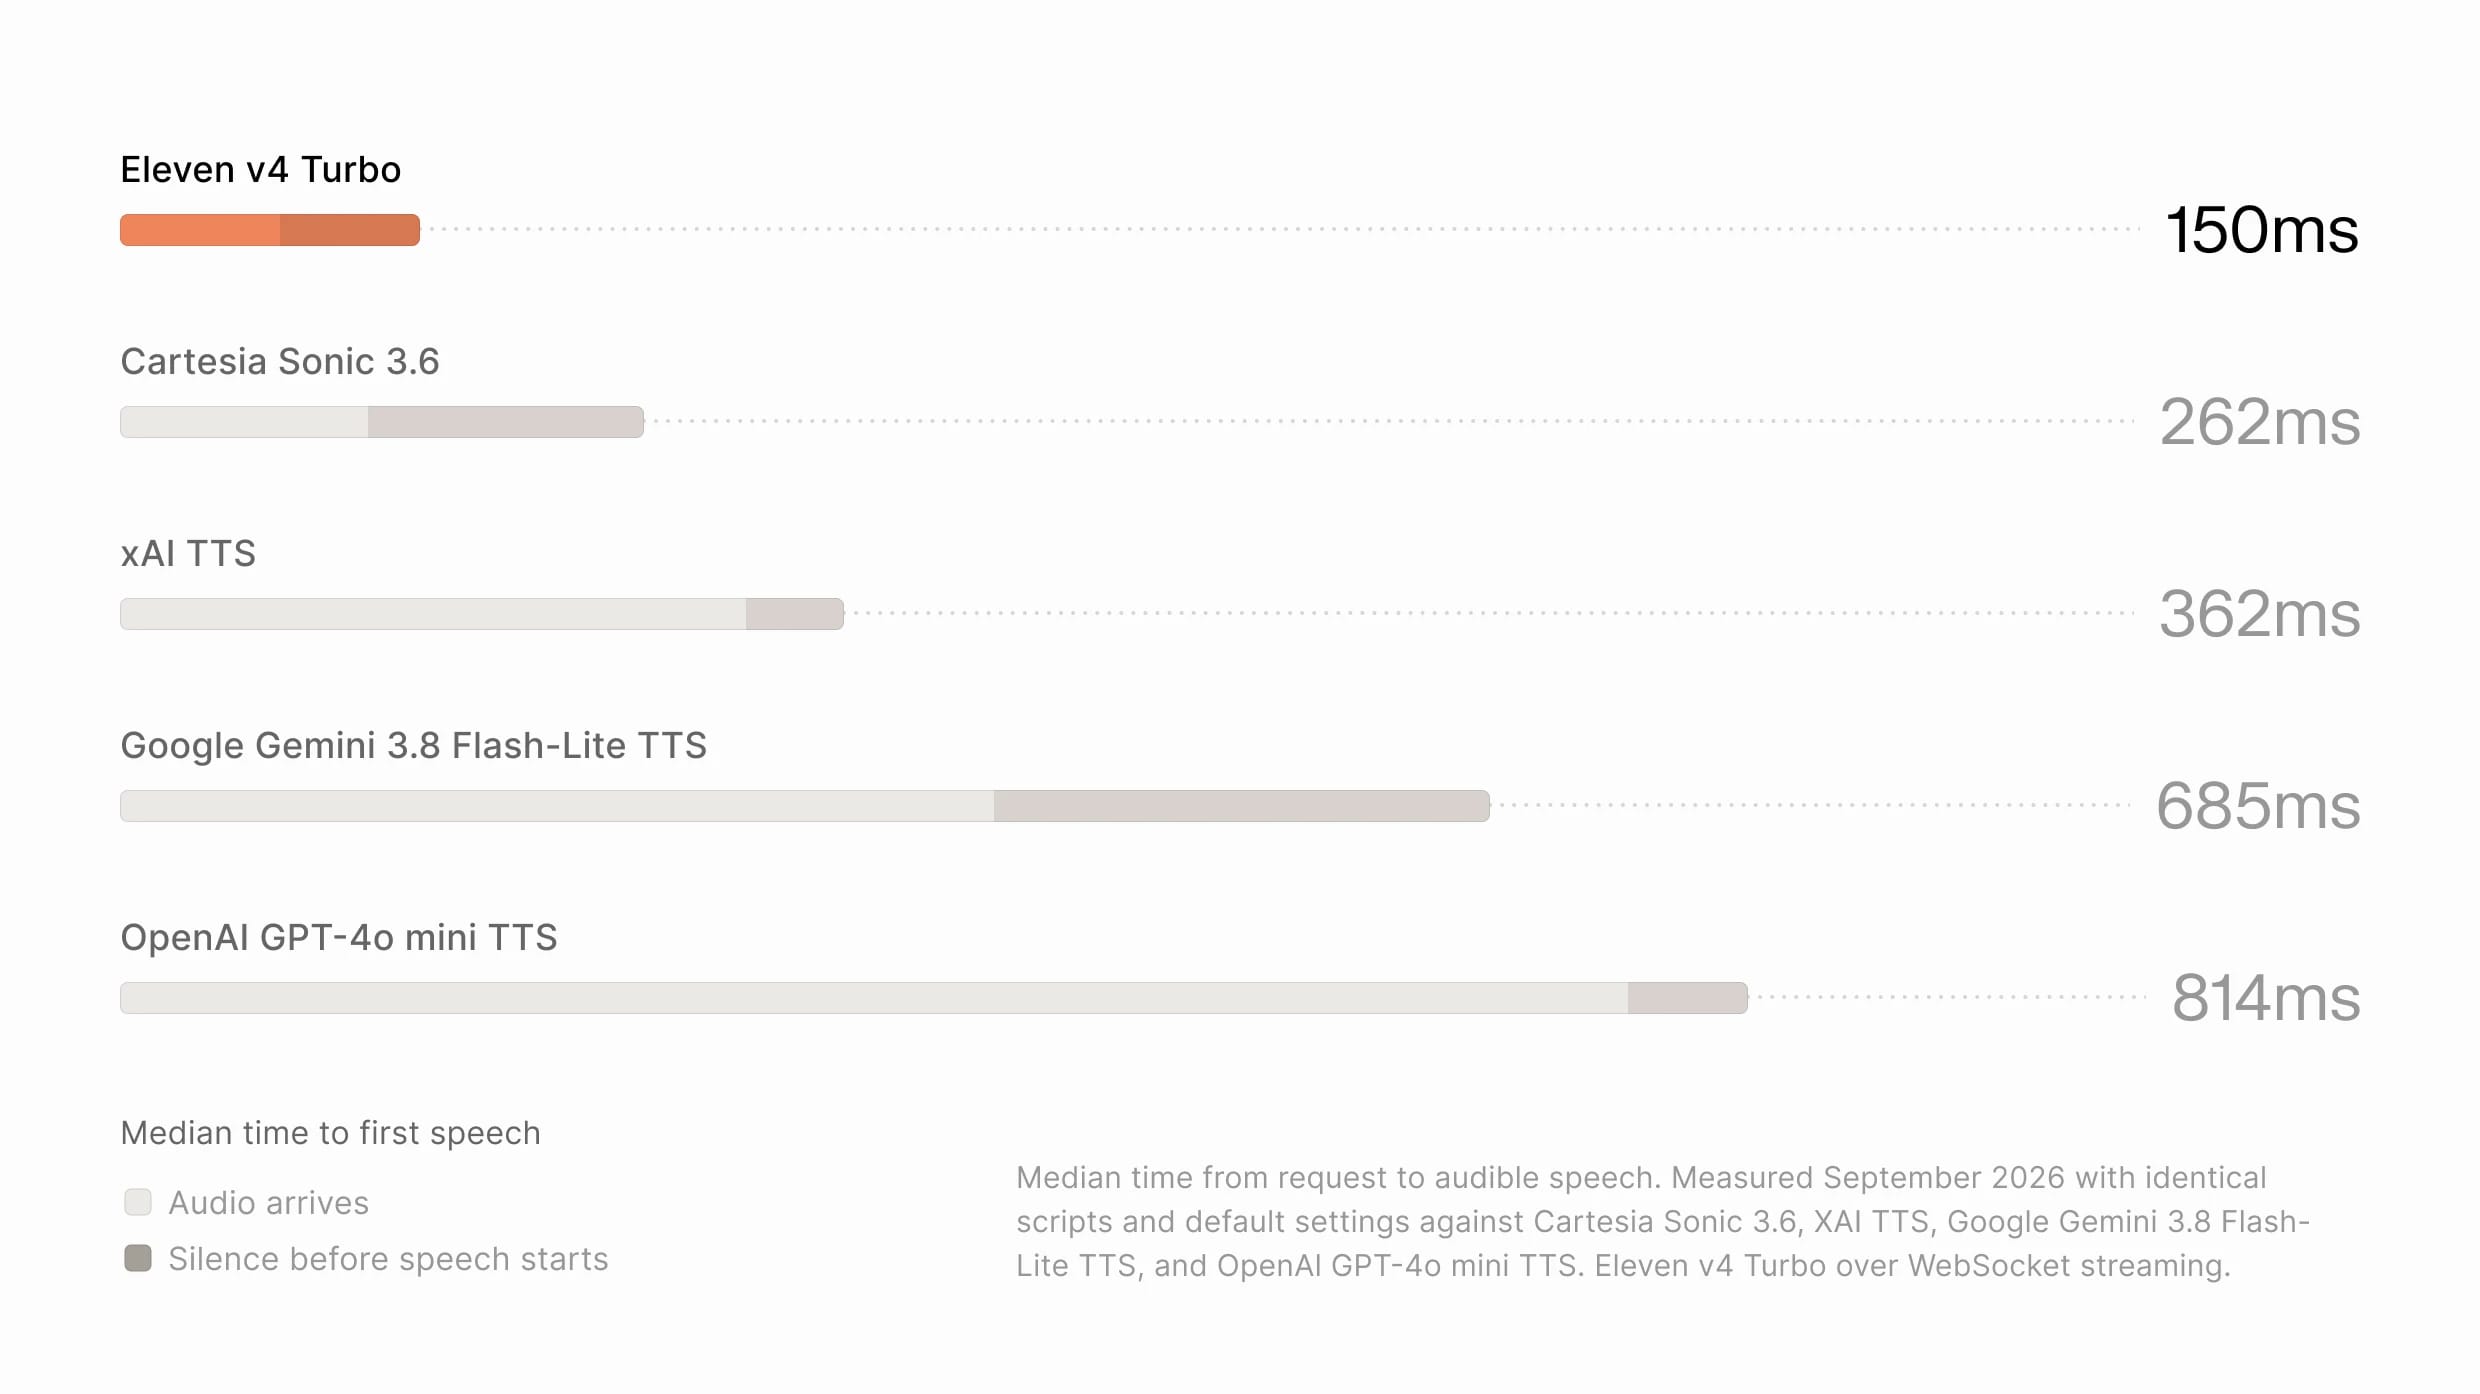
Eleven v4 Turbo kombinerar hastighet och känsla med en mediantid till första ljud på cirka 150 ms3, vilket gör det möjligt att använda kraftfulla agenter i otaliga branscher – från varma, lugnande agenter som kan uttala medicinska termer korrekt inom vården till snabbt pratande agenter som använder slang för att underhålla spelare inom gaming.
Modellen Eleven v4 Turbo är byggd för att fungera med ElevenLabs plattform för konversationsagenter, ElevenAgents. Andra verktyg för att bygga agenter sätter ihop modeller och programvara från olika leverantörer, vilket innebär att användare saknar möjlighet att förfina eller förbättra modellresultaten för sina enskilda användningsfall. ElevenLabs forsknings- och teknikteam har optimerat Eleven v4 Turbo och ElevenAgents tillsammans som ett enda system, vilket ger mer uttrycksfulla, tillförlitliga agenter med låg latens.
En röst, otaliga språk
Hur vi kommunicerar varierar beroende på sammanhang, plats och till och med tid på dygnet. Att skapa uttrycksfullt tal som speglar detta på olika språk är fortfarande en av de svåraste utmaningarna inom ljud-AI.
Eleven v4 är ett steg framåt inom alla dessa områden, och förbättringarna sträcker sig längre än bara modellens uttal av fraser. Eleven v4 fångar rytm, känslor och framförande bättre på olika språk, vilket hjälper kreatörer att skapa tal som känns naturligt för språket och sammanhanget. Hur du skulle tala med en äldre främling i Japan skiljer sig till exempel mycket från hur du skulle tala med samma person i Italien.
Både Eleven v4 och Eleven v4 Turbo stöder fler än 90 språk. Nu kan en röst som spelats in på ett språk även tala alla andra flytande, med en modersmålstalares accent samtidigt som den ursprungliga identiteten bevaras. Accenttroheten är märkbart starkare än tidigare, så rösten glider inte längre tillbaka mot sin ursprungsaccent under en generering.
Katalanska
Spanska
För dubbning och lokalisering innebär det att varumärkets röst som du har valt – oavsett om det är en känd skådespelare som du arbetar med eller ett tonfall som passar företagets stil bäst – kommer att låta bra på alla språk som stöds av Eleven v4.
Mer autentisk och konsekvent röstkloning
Voice Cloning är mer autentisk, kraftfull och konsekvent i Eleven v4 och Eleven v4 Turbo, med avsevärt bättre likhet med den ursprungliga källrösten. Instant Voice Clones kan nu fånga röster med hög återgivningstrohet med bara 10 sekunders ljud.
Riktig röst
Eleven v4
Eleven v4 bevarar också talaridentiteten mer tillförlitligt mellan genereringar, dialog, berättarröst och omgenererade repliker. Det innebär att karaktärer, berättare och klonade röster förblir konsekventa genom hela produktionen i längre projekt. Eleven v4 har också stöd för Professional Voice Clones (PVC), för användningsfall som kräver röstkloning med högsta möjliga återgivningstrohet.
Begärandekedjning – att länka samman genereringar för längre innehåll – är också avsevärt mer tillförlitlig i Eleven v4, vilket förbättrar upplevelsen av att arbeta i ElevenLabs Studio och ElevenLabs Reader App.
Hör skillnaden själv
Eleven v4 och Eleven v4 Turbo är resultatet av vår senaste forskning inom uttrycksfull talgenerering. De är byggda för innehåll där framförandet är lika viktigt som själva orden, oavsett om det gäller ljudböcker, karaktärsporträtt, voice-over, dubbning eller lokalisering av konversationsagenter.
Båda modellerna är tillgängliga nu i ElevenAgents, ElevenCreative och via ElevenAPI. Skapa ett kostnadsfritt konto för att börja generera med Eleven v4 eller Eleven v4 Turbo i dag.
- Artificial Analysis, Provider Voice Arena Leaderboard, september 2026
- Baserat på blinda användarpreferenstester där Eleven v4 jämfördes direkt med Cartesia Sonic 3.6, Inworld TTS-2, Google Gemini 3.8 Flash-Lite TTS och Google Gemini 3.8 Flash TTS, september 2026. För varje par fick bedömarna höra samma replik från Eleven v4 och en konkurrent, presenterad utan information om vilken modell som användes, och bedöma vilken som var mer uttrycksfull och vilken som lät mer naturlig. Oavgjorda resultat räknades som en halv poäng.
- Mediantid från begäran till hörbart tal. Uppmätt i september 2026 med identiska manus och standardinställningar mot Cartesia Sonic 3.6, xAI TTS, Google Gemini 3.8 Flash-Lite TTS och OpenAI GPT-4o mini TTS. Nätverkslatens mättes och togs bort för alla system. Eleven v4 Turbo via WebSocket-streaming.