Hur skapas syntetiska röster för naturligt tal?
- Skriven av
- Jack Limebear
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
Dagens sofistikerade AI-modeller skapar syntetiska röster som låter som naturligt tal. Modellerna tränas på enorma datamängder med riktiga mänskliga röster och använder avancerade neurala nätverk för att identifiera och återskapa autentiska talmönster. Att skapa en syntetisk röst kallas också talsyntes eller röstsyntes, medan ljudet som den producerar kallas syntetiskt tal.
För att skapa en ny syntetisk röst spelar en användare in sig själv när hen pratar. AI-modellen analyserar samtidigt personens unika fonetiska mönster och intonation och använder datan för att återskapa rösten. Sedan kan användaren justera röstegenskaper som accent, ton och tempo för att skapa slutresultatet. Vissa syntetiska röster är en direkt kopia av en persons tal, medan andra är en blandning av flera röster. Röster kan också designas utifrån en textbeskrivning, helt utan inspelning.
Syntetiska röster öppnar upp många kreativa möjligheter för poddar, ljudböcker, videospel och reklam. I den här artikeln utforskar vi hur syntetiska röster skapas, vad som får dem att låta naturliga och hur du bygger din egen syntetiska röst med ElevenLabs.
Sammanfattning
- Syntetiska röster skapas med neurala AI-modeller som analyserar och återskapar mänskliga talmönster.
- Syntetiska röster är användbara för att berätta ljudböcker, skapa dialog till videospel, producera poddar och voice-over i stor skala, skapa AI-agenter för kundtjänst eller till och med bevara röster som riskerar att gå förlorade.
- Voice Cloning fungerar genom att analysera inspelningar av en specifik persons röst och återskapa personens unika accent och talmönster.
- Moderna AI-röster låter naturliga eftersom de återskapar mänsklig prosodi och förstår sammanhang, i stället för att bara återskapa enskilda ord eller stavelser.
Så skapas syntetiska röster, steg för steg
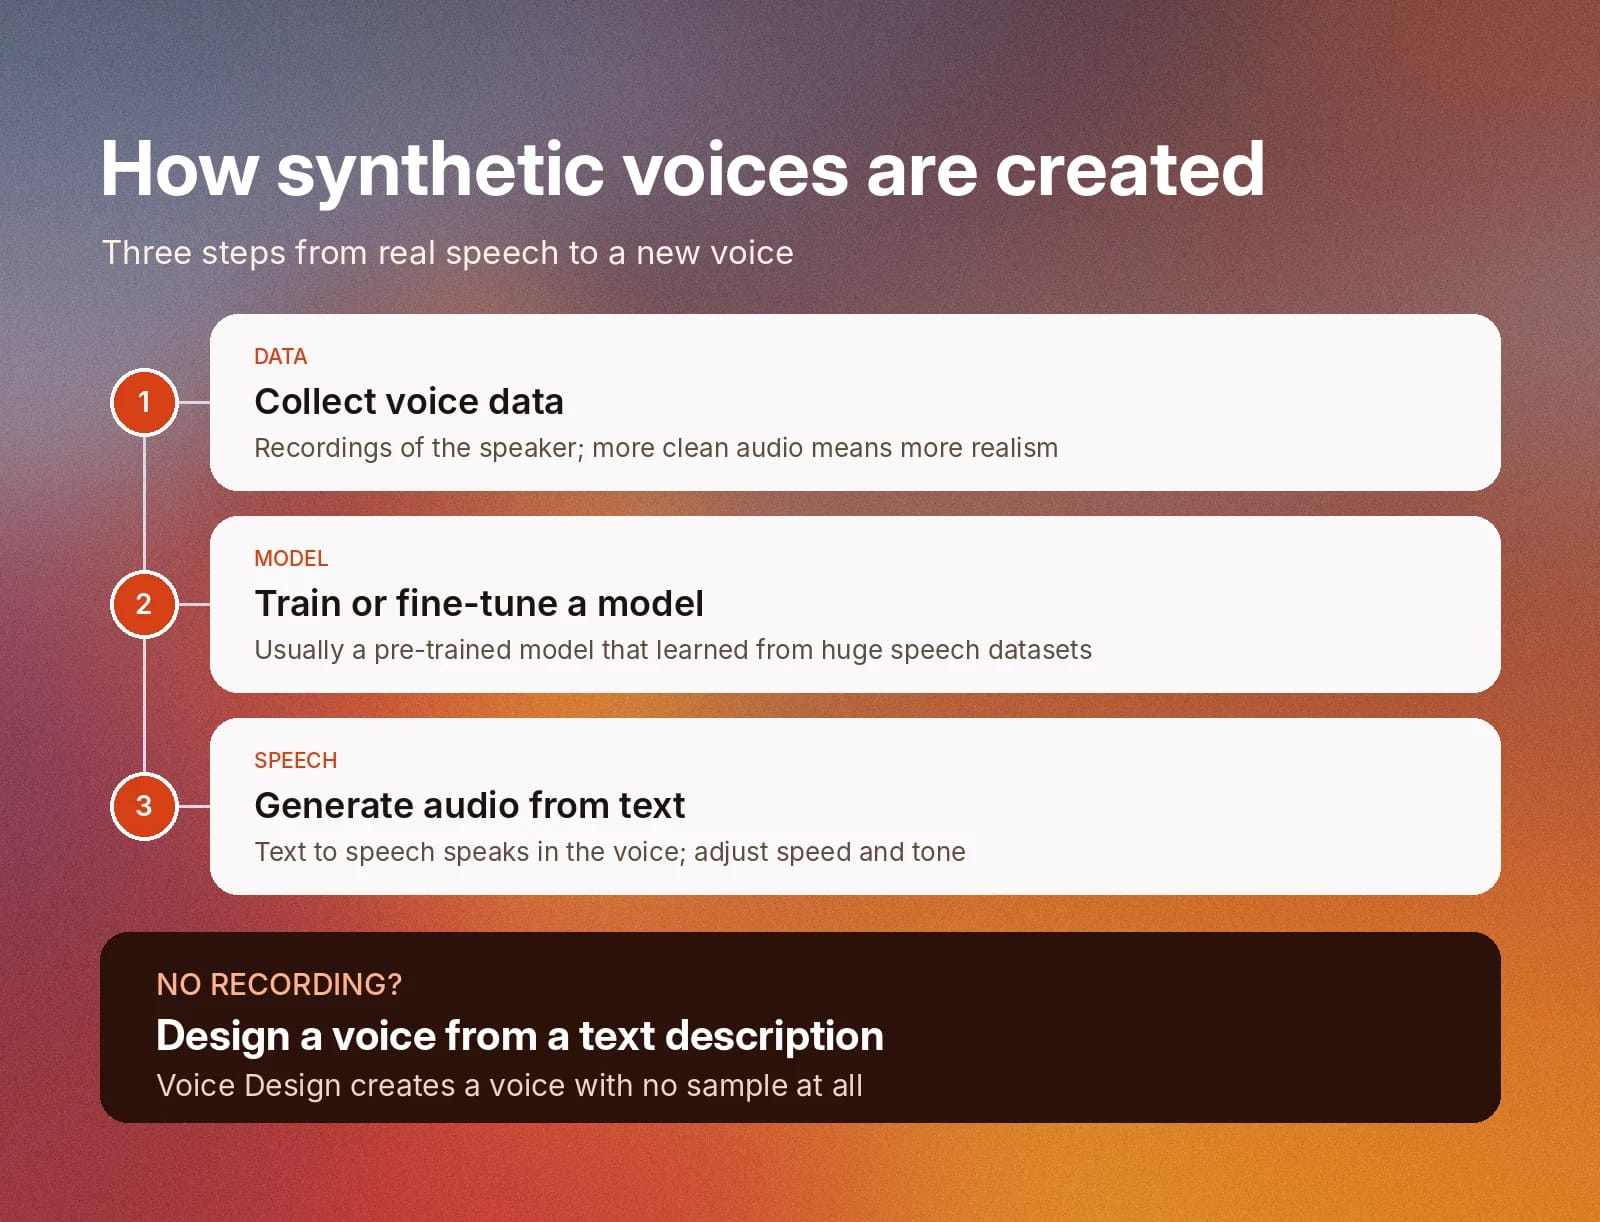
Att skapa en syntetisk röst är en process i tre steg.
Så här ser det ut i praktiken:
- Steg 1: Samla in röstdata: Syntetiska röster utgår från riktigt mänskligt tal. För att skapa en ny röst behöver du ljudinspelningar av de talare du vill återskapa. Ju mer data du tillhandahåller, desto mer korrekt och realistisk blir den färdiga rösten. Här är några bästa praxis för Voice Cloning.
- Steg 2: Träna eller finjustera en AI-modell: För att skapa syntetiska röster analyserar AI-modeller först omfattande datamängder med ett brett urval av talinspelningar. Modellerna använder datan för att förstå mänskliga talmönster. När en AI-modell har tränats kan den klona verkliga röster med hjälp av en enda talinspelning. I de flesta fall använder du en förtränad modell i stället för att bygga en egen från grunden.
- Steg 3: Generera ljud från text: Syntetiska röster använder text to speech för att generera ljud. Du kan justera faktorer som hastighet och tonläge så att de passar dina preferenser. Läs vår guide om hur text to speech-teknik fungerar för en djupare genomgång.
Från taldata till neuralt text to speech
Neurala text to speech-modeller tränas på många dataset med inspelningar av verkligt tal. Dessa dataset innehåller inspelningar på olika språk, med olika accenter, känslor och tonhöjder. Neural text to speech är i dag en vanligt använd form av talsyntes.
Traditionella modeller satte ihop befintliga inspelningar av ord, stavelser och fonem. Resultatet lät väldigt robotaktigt eftersom modellerna inte kunde återskapa variationerna i tonläge, rytm och uttryck som får tal att låta mänskligt.
I stället för att bara lära sig hur bokstäver och stavelser låter lär sig moderna neurala text to speech-modeller naturliga mänskliga uttalsmönster och talrytmer. När de omvandlar text till tal analyserar modellerna texten, omvandlar den till akustiska egenskaper och använder sedan dessa för att skapa vågformer.
Eftersom akustiska egenskaper som tonläge, rytm och ton är inbyggda i neurala AI-modeller låter det resulterande talet mycket mer naturligt och autentiskt än tidigare modellers.
Resultaten går också att anpassa: du kan ändra faktorer som hastighet, känsla och till och med accent för att få exakt den röst du söker. Ditt varumärke kan till exempel använda samma syntetiska röst på hela webbplatsen, men med entusiasm och brådska i marknadsföringsinnehåll och lugn i kundtjänstinteraktioner.
Standard-, neuralt och generativt text to speech
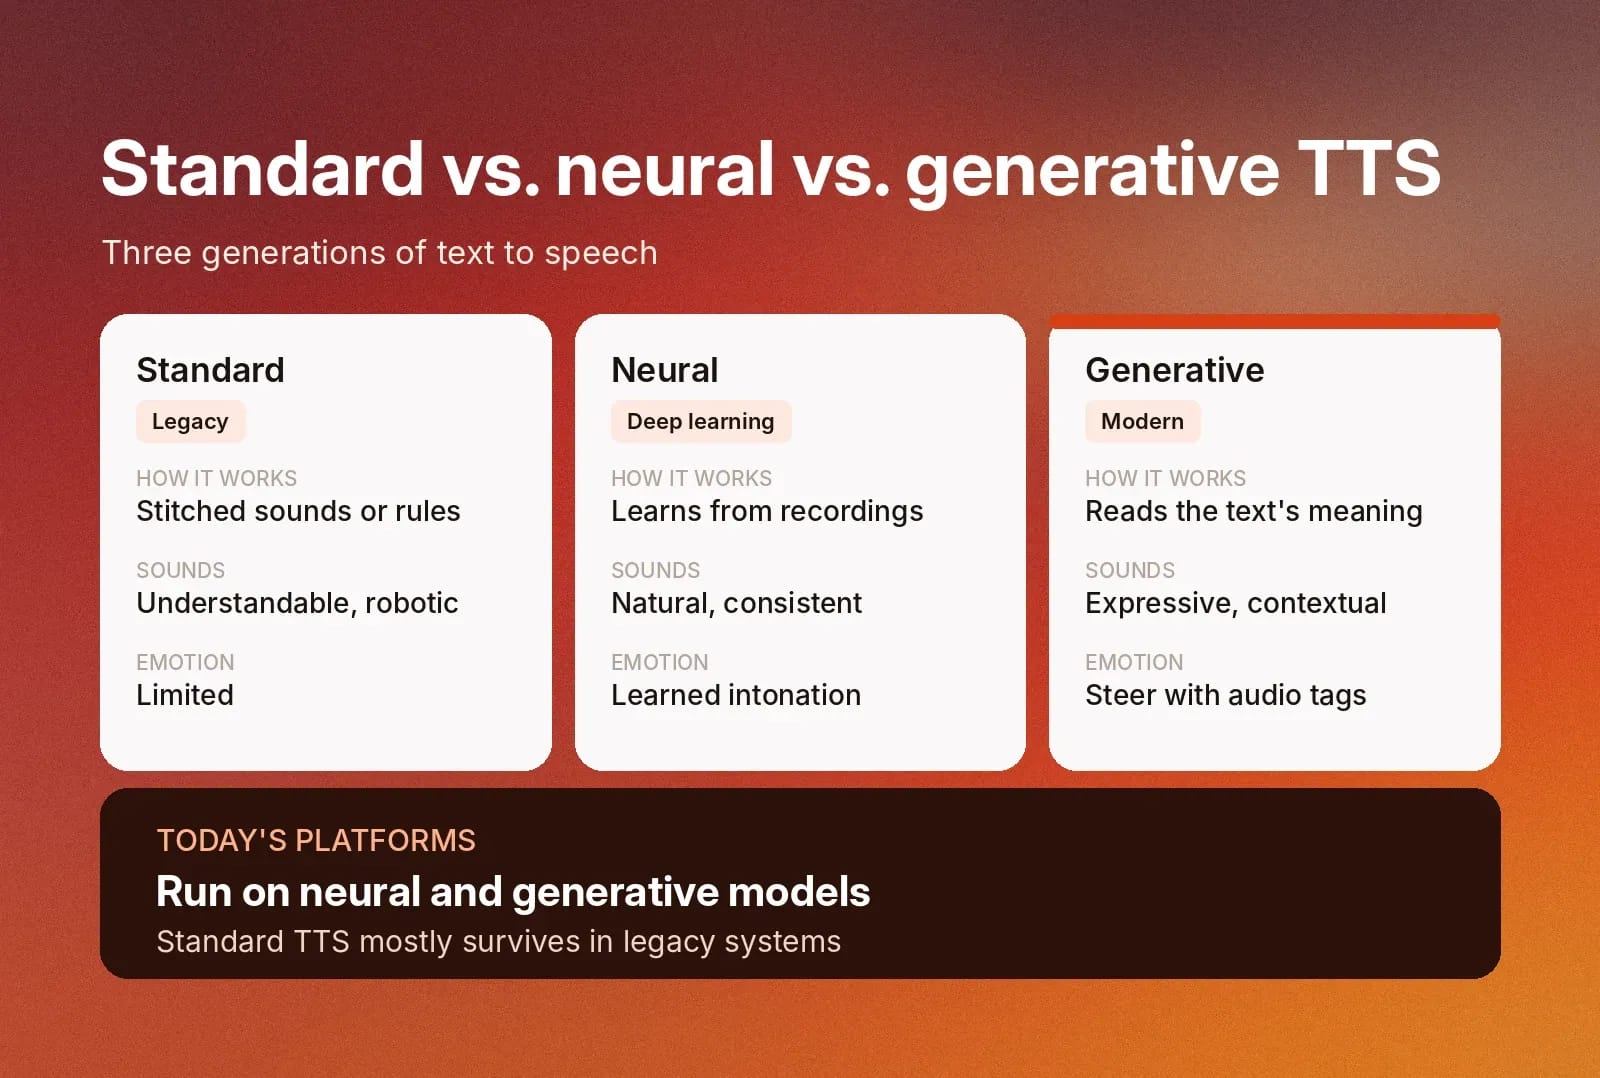
Text to speech-modeller delas in i tre övergripande generationer.
Genom att förstå skillnaderna mellan dem blir det lättare att se varför moderna modeller, som ElevenLabs Text to Speech, kan låta så naturliga.
- Standard text to speech: Dessa system sätter ihop förinspelade ljud eller följer regler och statistiska modeller för att uttala text. Resultatet är begripligt men robotlikt, med begränsat känslouttryck.
- Neuralt text to speech: Djupinlärningsmodeller lär sig uttal, rytm och intonation från stora mängder inspelningar och genererar tal som låter betydligt mer naturligt och konsekvent.
- Generativt text to speech: Generativa modeller tränas på ännu större och mer varierad taldata och använder textens betydelse för att avgöra känsla, tempo och betoning. Du kan styra hur de levererar talet med instruktioner, till exempel ljudtaggar.
Moderna röstplattformar förlitar sig på neurala och generativa modeller, medan standard text to speech främst lever kvar i äldre system.
Vad får AI-röstgenerering att låta naturlig?
Syntetiska röster som genereras av AI låter mycket lika mänskliga röster. Det kan faktiskt vara svårt att höra skillnaden om du inte lyssnar noga.
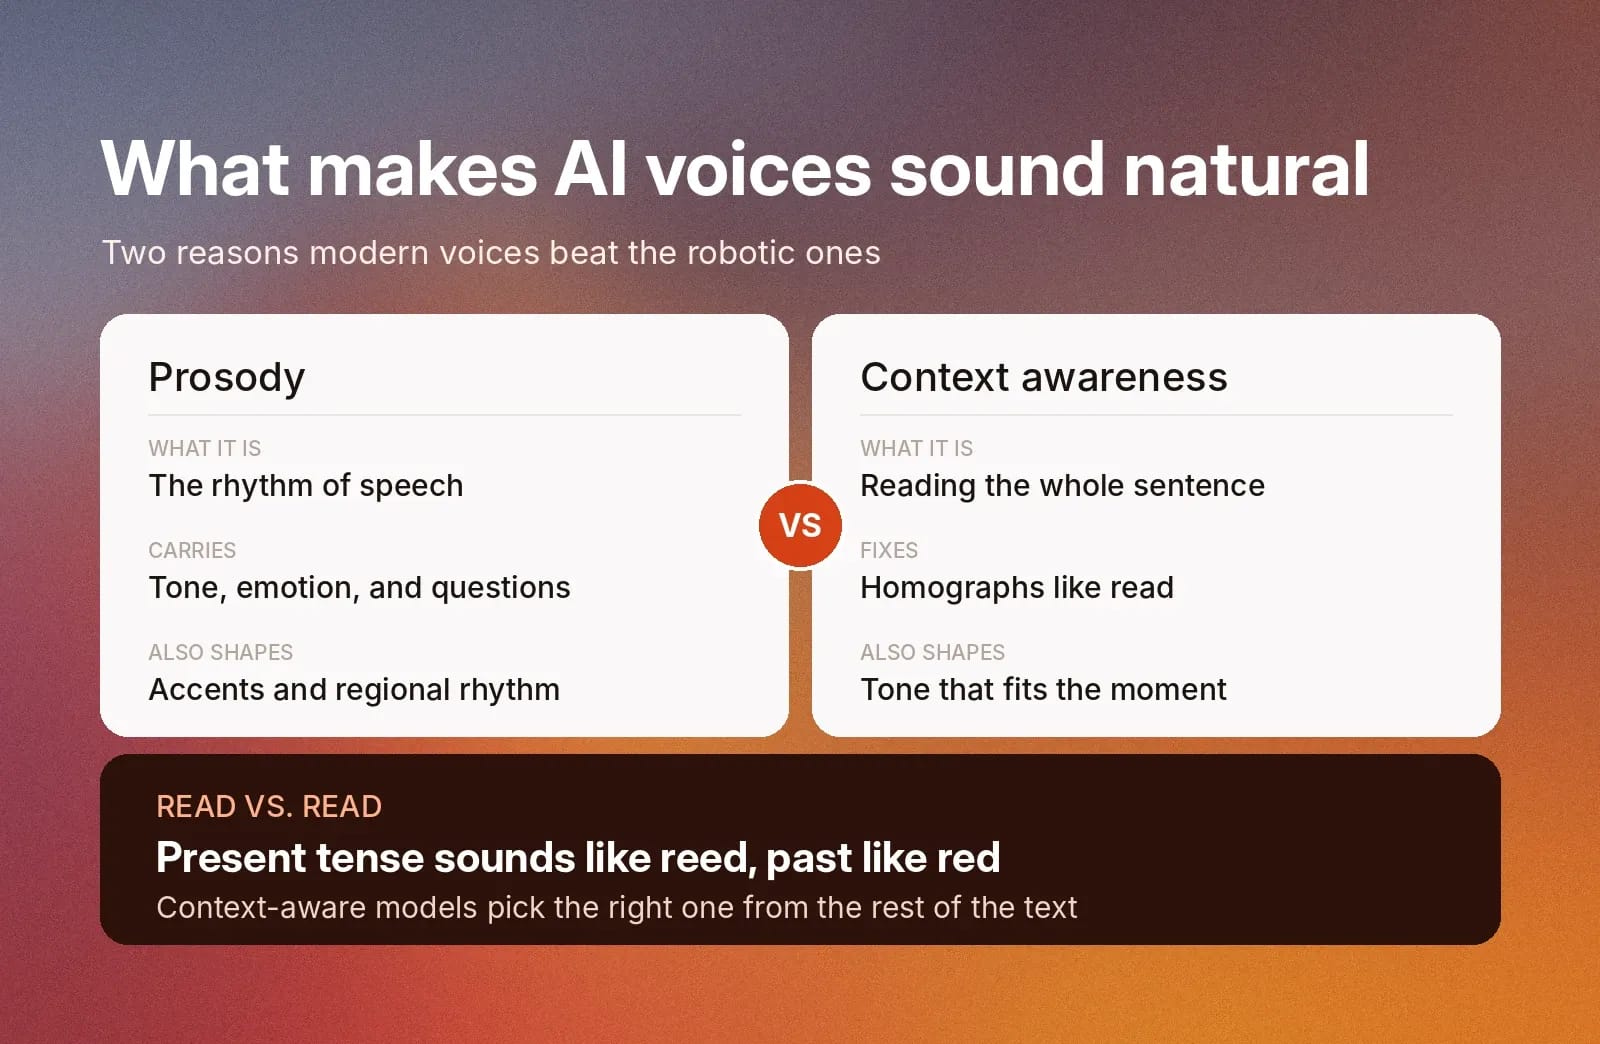
Det finns två skäl till att AI-genererade röster låter mer naturliga än tidigare robotröster: prosodi och kontextmedvetenhet.
Prosodi
Prosodi är rytmen i naturligt mänskligt tal. Små förändringar i intonation och hastighet förmedlar ton och känsla när vi pratar. Att till exempel tala snabbt kan signalera stress eller entusiasm, medan ett höjt tonläge i slutet av en mening förvandlar ett påstående till en fråga.
Dagens AI-röstmodeller tränas för att förstå och återskapa prosodi. Det innebär att resultatet speglar flödet i naturliga mänskliga samtal i stället för att låta stelt eller platt.
Om du använder en syntetisk röst för att berätta en ljudbok eller skapa dialog till ett videospel använder den prosodi för att spegla karaktärens känslor. Om du skapar en voice-over för utbildningsinnehåll eller en AI-agent för kundtjänst justerar AI-modellen prosodin för ett lugnt och empatiskt framförande.
Genom att förstå prosodi kan AI-modeller också återskapa unika accenter. Rytmen i en nordamerikansk engelsk accent låter till exempel mycket annorlunda än i en brittisk, skotsk eller irländsk engelsk accent, även om språket är detsamma.
Kontextmedvetenhet
I stället för att bearbeta varje ord för sig analyserar AI-drivna TTS-modeller hela frasen, meningen eller samtalet och anpassar framförandet efter sammanhanget.
Det finns till exempel många ord som stavas på samma sätt men uttalas olika beroende på tempus och sammanhang. Det engelska ordet ”read” uttalas till exempel som ”reed” i presens men som ”red” i preteritum.
Eftersom AI-röster är kontextmedvetna identifierar de rätt uttal utifrån resten av texten. De anpassar också framförandet så att ton och känsla passar situationen.
Hur fungerar Voice Cloning?
Voice Cloning använder AI för att analysera en verklig persons röst och sedan tillämpa personens röstegenskaper på syntetiskt tal.
Först måste personen som klonar sin röst tillhandahålla ett kort ljudprov. AI-modellen använder ljudprovet för att identifiera personens accent, tonläge, ton och talrytm. Modellen använder dessa egenskaper för att skapa en digital kopia av personens röst. Användare kan generera nytt tal med denna röst med hjälp av text to speech-teknik.
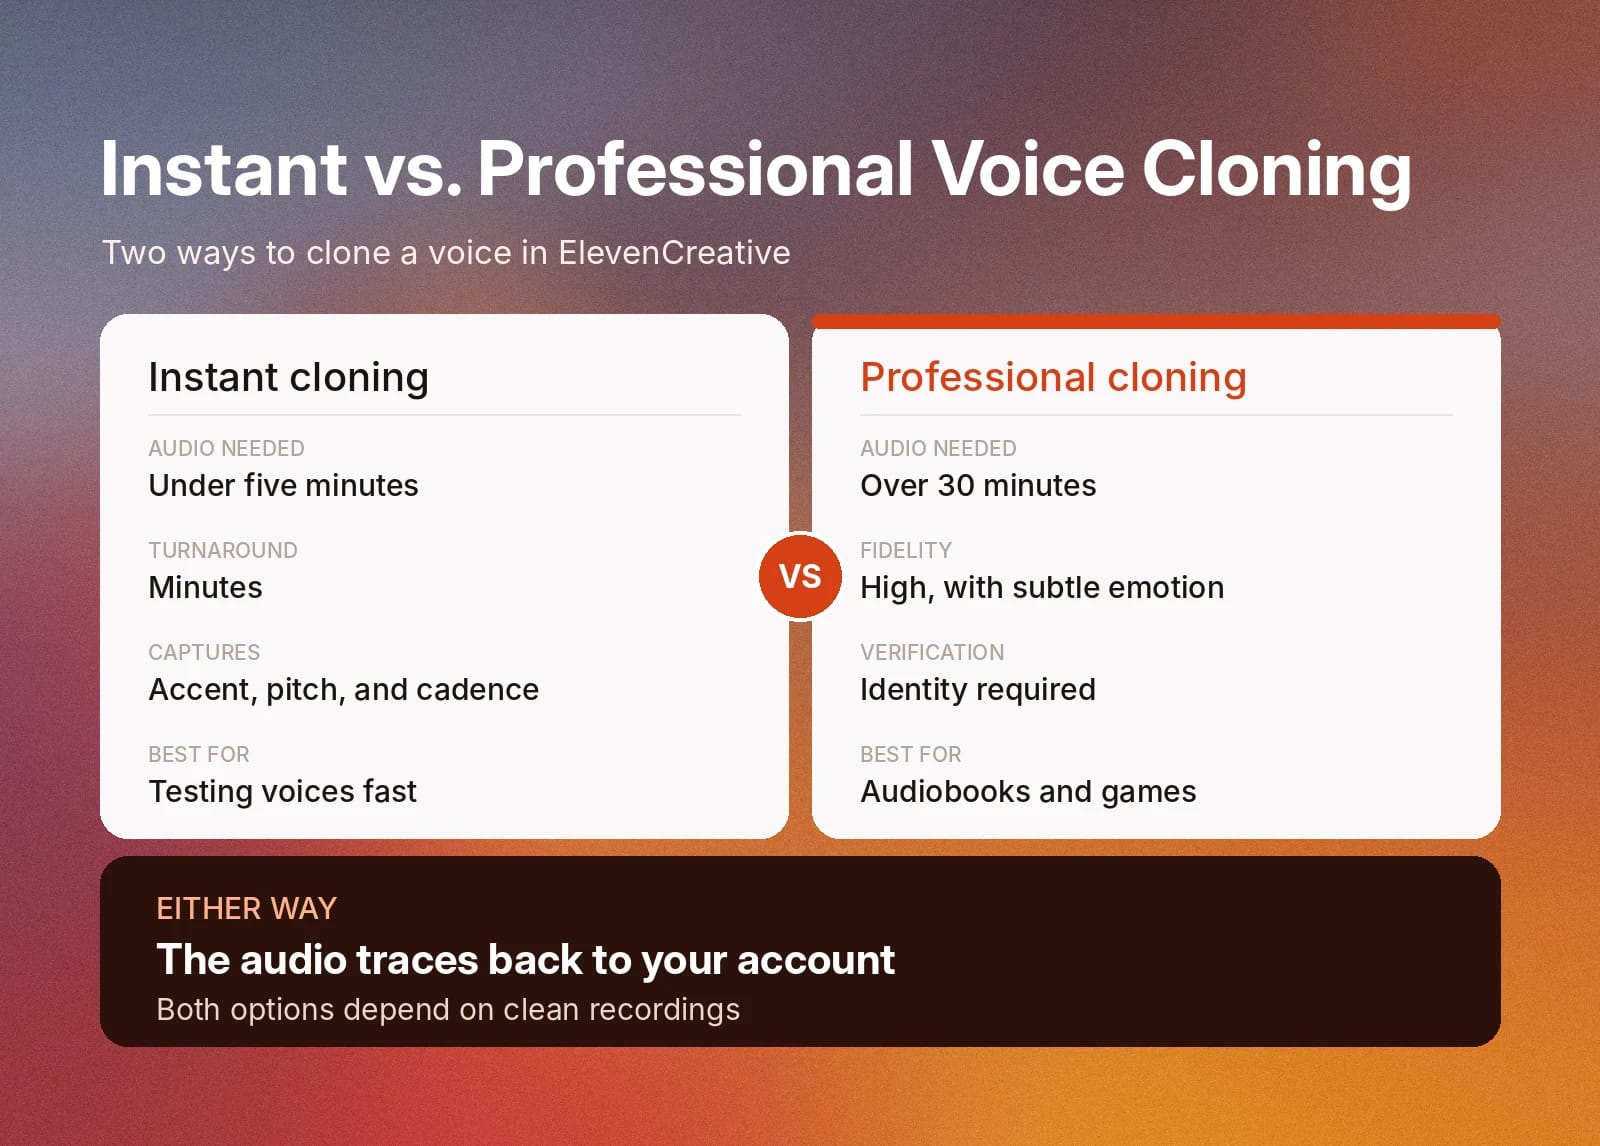
Det finns två typer av Voice Cloning: Instant och Professional. Instant Cloning skapar en röstkopia med mindre än två minuters exempelljud. Det gör det enkelt att testa röstalternativ innan du satsar på ett större projekt.
Professional Cloning använder mellan 30 minuter och tre timmar av ljudprover för att skapa en röstklon med hög återgivningstrohet. Professional Voice Clones bevarar subtila detaljer som känslor och intonation som saknas i Instant Clones. De kräver också identitetsverifiering.
Voice Cloning har många användningsområden, från att snabbt generera voice-over till att bevara röster som annars kan gå förlorade.
Så spelar du in bra röstprover för talsyntes
Kvaliteten på en röstklon beror på inspelningens kvalitet. Även utan dyr inspelningsutrustning finns det många små saker du kan göra för att förbättra hur din röstklon låter.
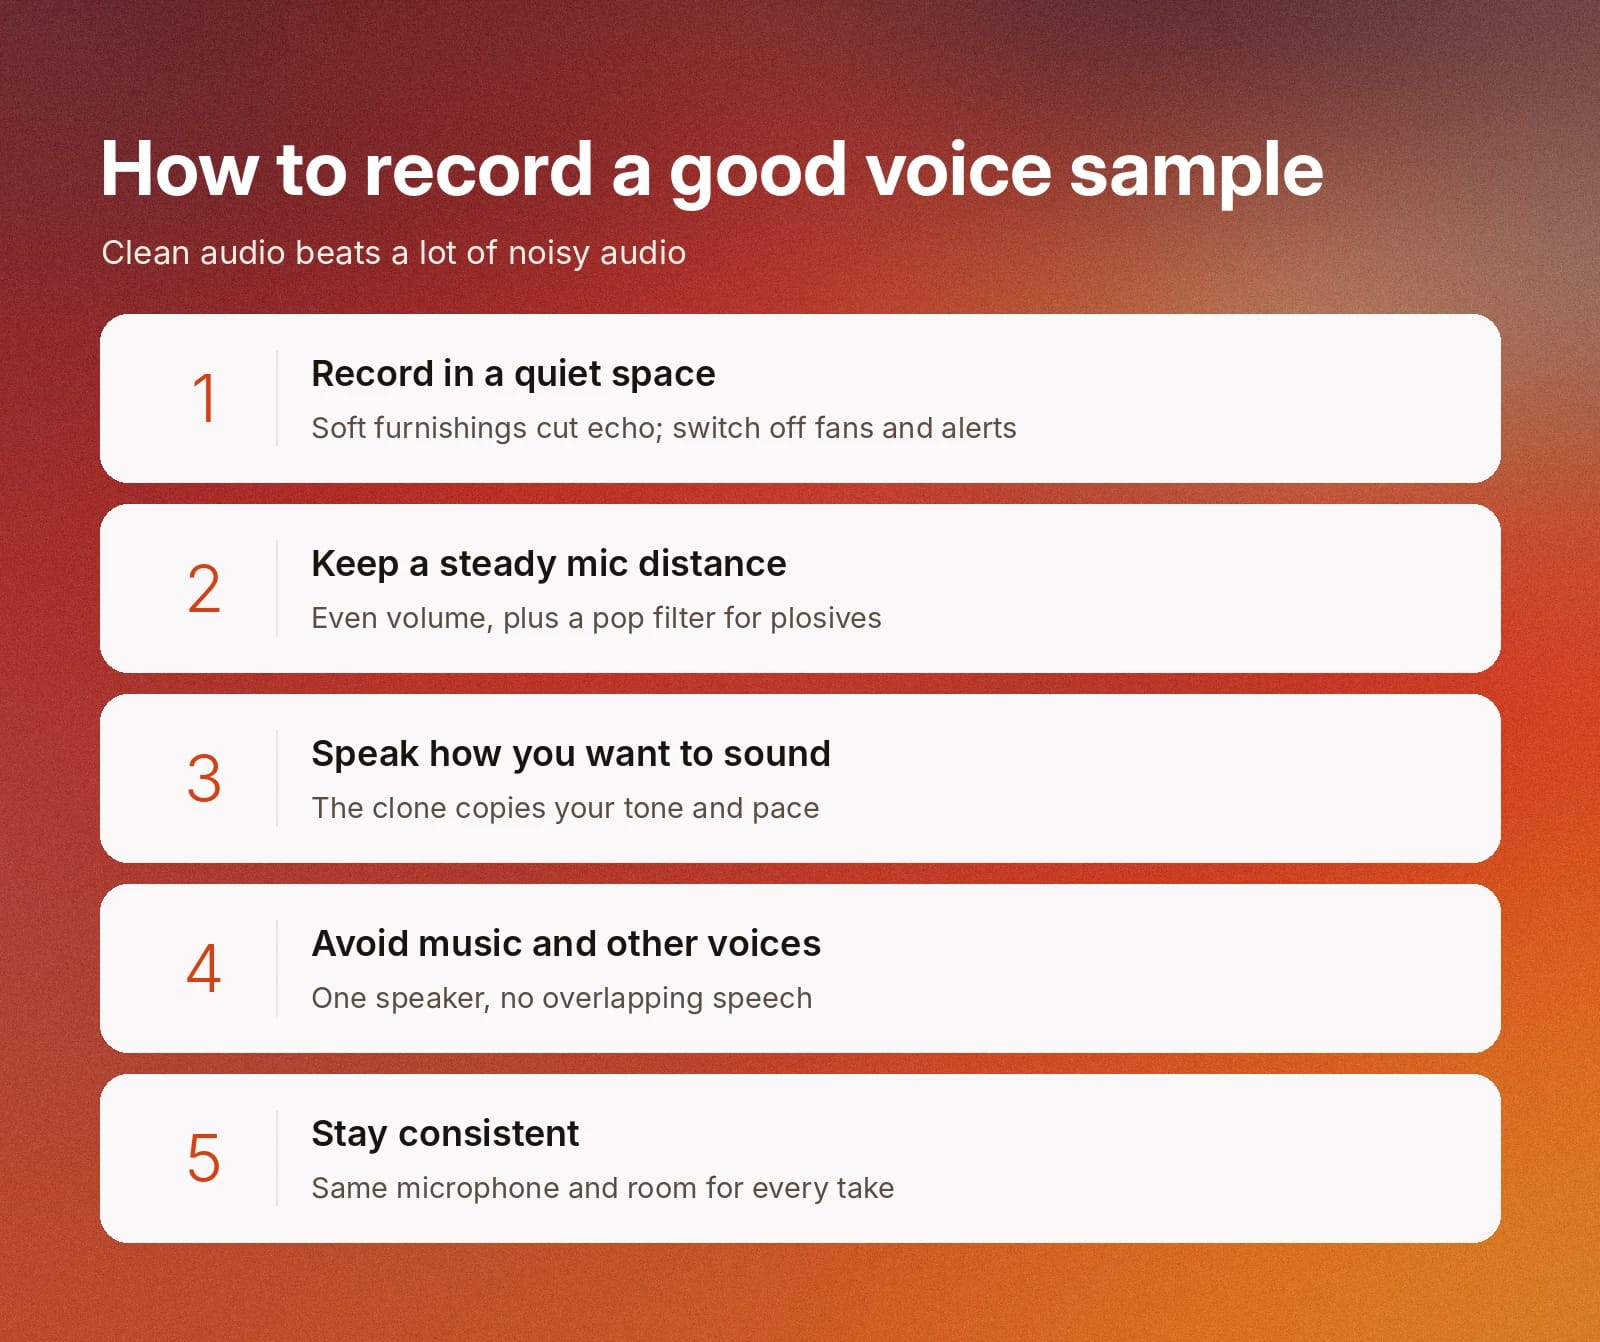
De här vanorna hjälper dig att få rena ljudprover:
- Spela in på en tyst plats: Mjuka möbler som gardiner och mattor minskar ekon, och om du stänger av fläktar och notiser försvinner bakgrundsljud.
- Håll mikrofonen på ett jämnt avstånd: Ett konsekvent avstånd håller volymen jämn, och ett popfilter minskar hårda plosivljud.
- Prata så som du vill att klonen ska låta: Klonen kopierar ditt sätt att tala. Spela in med den ton och det tempo du planerar att använda.
- Undvik musik och andra röster: Använd en enda talare utan bakgrundsmusik eller överlappande tal.
- Var konsekvent: Använd samma mikrofon och rum för alla dina inspelningar.
Instant Cloning behöver mindre ljud och Professional Cloning behöver mer, men båda kräver rena inspelningar. Rent ljud med rätt längd ger bättre resultat än stora mängder brusigt ljud.
Så skapar du en röst utan inspelning: Voice Design
Alla syntetiska röster börjar inte med en inspelning. Med Voice Design beskriver du rösten du vill ha i text, med detaljer som ålder, kön, accent, ton och tempo, och AI-modellen genererar röstalternativ som matchar din beskrivning. Du kan lyssna på alternativen, välja det du gillar och spara det i ditt röstbibliotek.
Voice Design är användbart när du behöver en röst för en karaktär, ett varumärke eller en produkt och det inte finns någon verklig person att klona. Läs dokumentationen för Voice Design för att lära dig skriva effektiva röstbeskrivningar.
Så avgör du om en röst är AI-genererad
Det finns inget enskilt tecken som bevisar att en röst är AI-genererad. Det fungerar bättre att kombinera noggrann lyssning, detekteringsverktyg och en kontroll av var ljudet kommer ifrån än att förlita sig på något av dem var för sig.
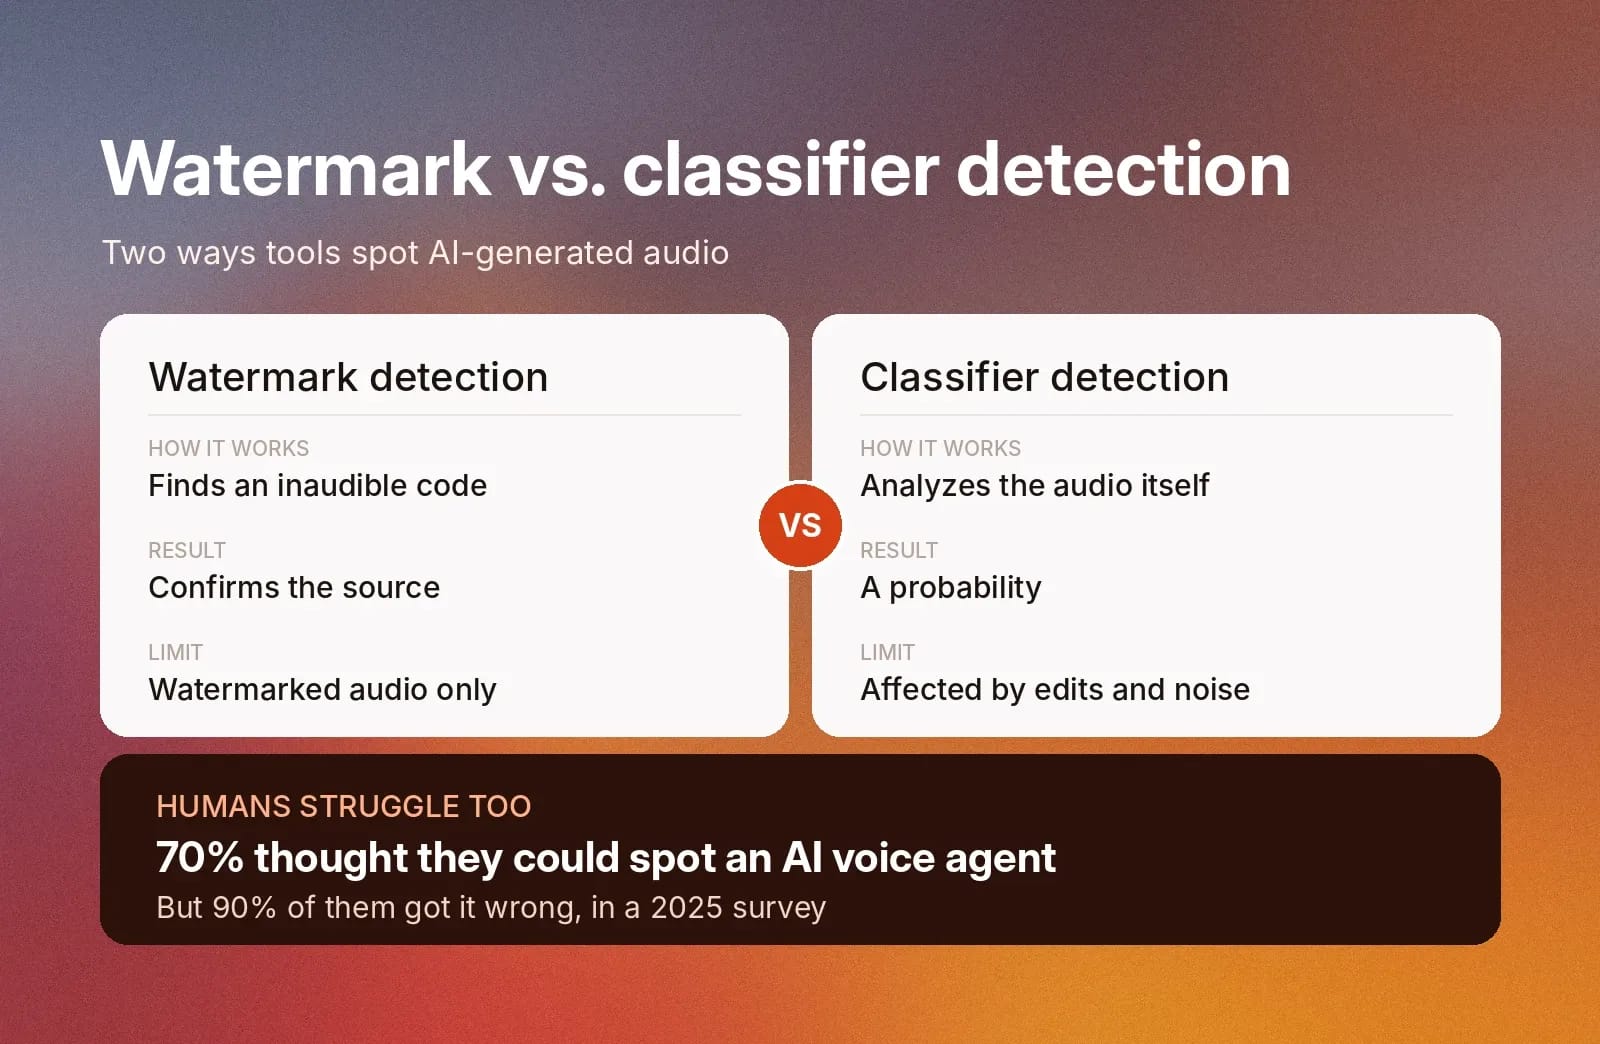
Många tror att de kan höra skillnaden mellan en riktig röst och en AI-genererad röst, men de har inte alltid rätt. En undersökning från 2025 visade att 70 % av konsumenterna trodde att de kunde identifiera en AI-röstagent korrekt, men 90 % av dem lyckades inte göra det.
I stället för att förlita dig på det mänskliga örat kan du använda ett detekteringsverktyg. Detekteringsverktyg fungerar på två huvudsakliga sätt:
- Detektering av vattenmärke: Vissa AI-leverantörer bäddar in ett vattenmärke, en kod som människor inte kan höra, i ljudet de genererar. En detektor kan hitta vattenmärket och bekräfta var ljudet kommer ifrån. Det fungerar endast för ljud som har ett vattenmärke.
- Klassificerarbaserad detektering: En klassificerare analyserar ljudet och uppskattar sannolikheten för att det är AI-genererat. Den kan flagga ljud utan vattenmärke, men resultatet är en sannolikhet och kan påverkas av komprimering, bakgrundsljud eller redigering.
Ingen av metoderna är perfekt. Se ett detekteringsresultat som en del av underlaget och jämför det med vad du vet om källan. Vi har skrivit en guide om detektering av ljuddeepfakes, där vi går in mer i detalj.
ElevenLabs Speech Classifier är ett verktyg som identifierar sannolikheten för att ett ljudprov har genererats med ElevenLabs AI-röstmodeller. ElevenLabs har också inlett ett samarbete med Reality Defender kring initiativ för deepfake-detektering för att identifiera och förhindra röstbedrägerier.
Vad du ska lyssna efter
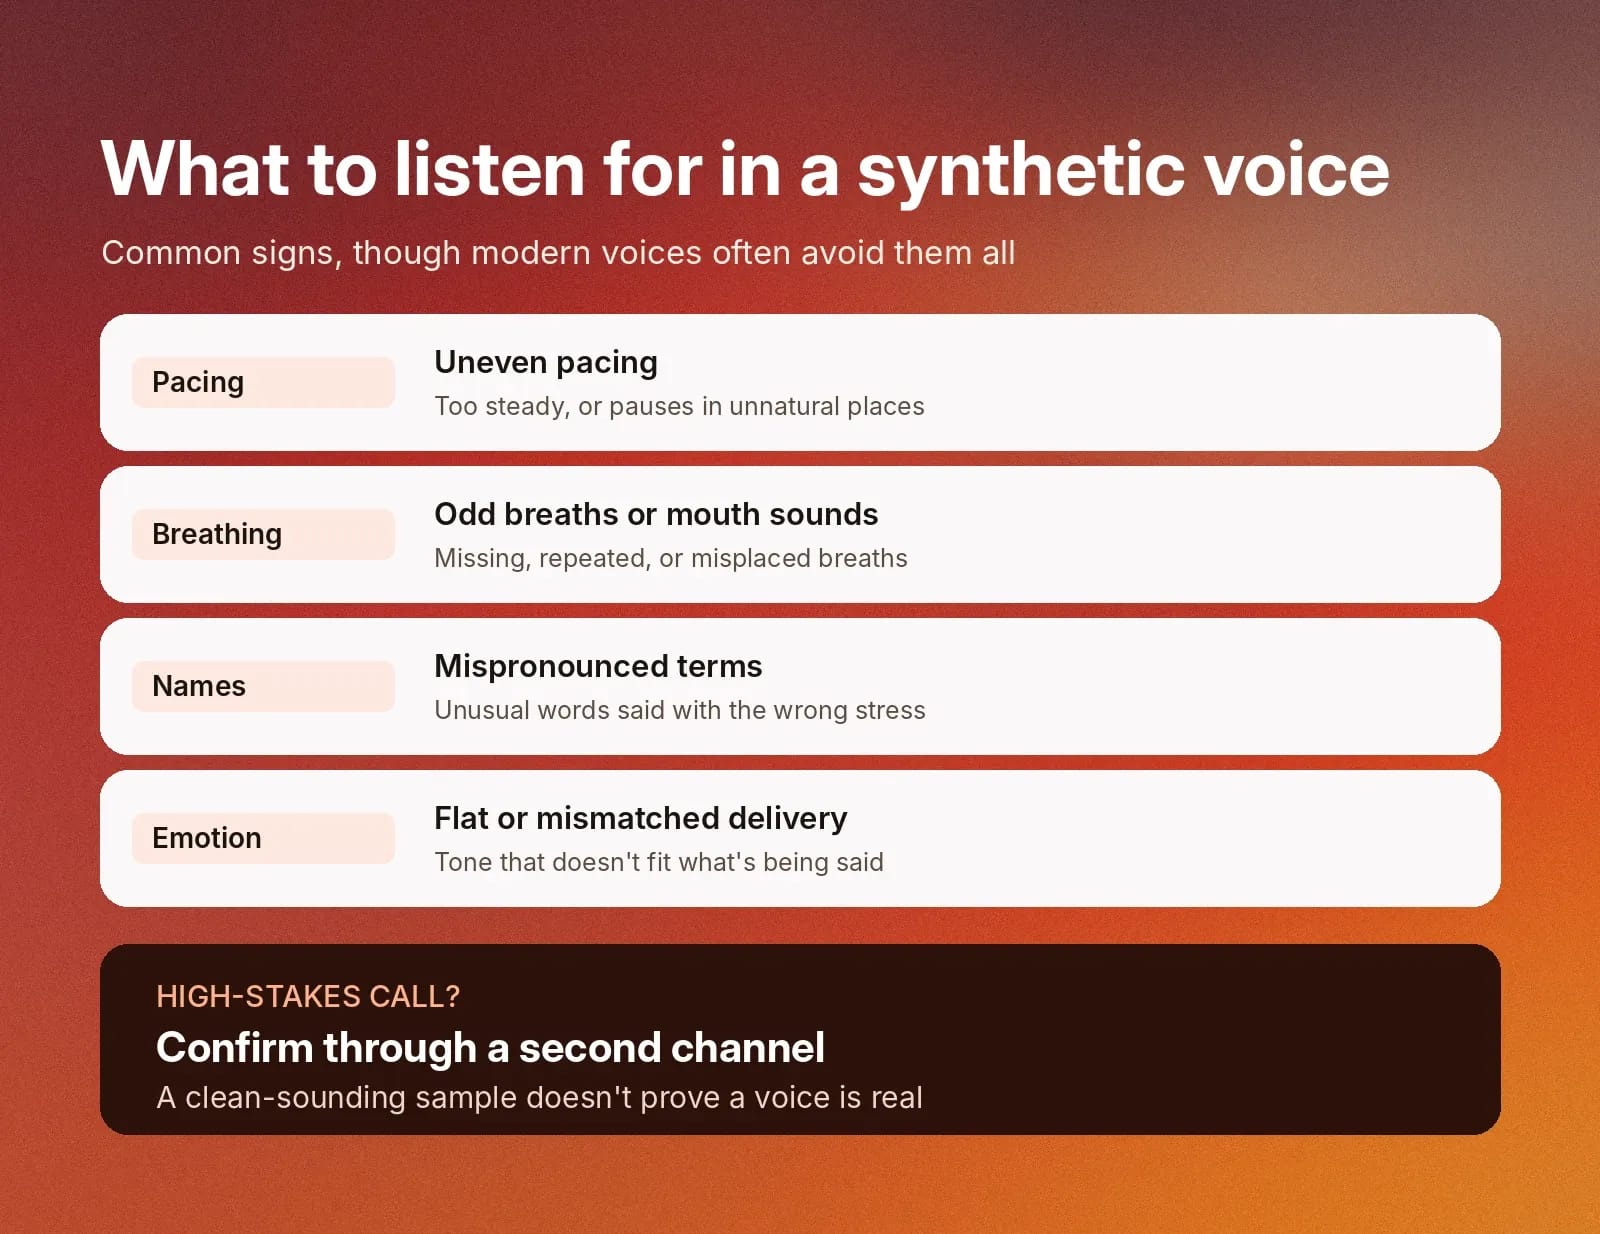
Detekteringsverktyg finns inte alltid till hands, så det hjälper att känna till de vanliga tecknen på en syntetisk röst.
Lyssna efter:
- Ojämnt tempo: Tal som är för jämnt eller pausar på onaturliga ställen.
- Ovanliga andnings- eller munljud: Andetag som saknas, upprepas eller hamnar fel. De kan tyda på ljudartefakter som en modell oavsiktligt har genererat.
- Feluttalade namn eller termer: Ovanliga ord som sägs med fel betoning. Detta är ännu vanligare i språk som använder accenttecken för att betona vissa stavelser i ord, som spanska.
- Platta eller felaktiga känslouttryck: Ett framförande som inte passar ordens betydelse. Det visar på bristande förståelse för själva texten, vilket är ett vanligt problem med äldre TTS-modeller.
Moderna syntetiska röster undviker ofta allt detta. Ett ljudprov som låter rent bevisar inte att rösten är äkta. När det gäller något med höga insatser, till exempel ett samtal där någon ber om pengar, bör du bekräfta det via en annan kanal.
Skapa anpassade röstupplevelser med ElevenCreative
ElevenCreative hjälper dig att skapa anpassade röstupplevelser för dina kreativa projekt. Välj från ett omfattande bibliotek med över 20 000 färdiga röster eller skapa en egen med träffsäker och säker Voice Cloning.
Använd ElevenCreative för att återskapa din röst med Instant Voice Cloning eller Professional Voice Cloning. Instant Voice Cloning fungerar på några minuter och hjälper dig att testa röstalternativ eller snabbt starta personliga projekt. Professional Voice Cloning använder längre ljudprover för att skapa högkvalitativa röster som passar längre projekt som ljudböcker, videospel eller poddar. Oavsett vilket alternativ du väljer kan ljudet spåras tillbaka till ditt konto av säkerhetsskäl.
ElevenCreatives anpassningsbara Voice Library och verktyg för Voice Cloning hjälper dig att förverkliga dina kreativa projekt. Registrera dig för ElevenCreative för att utforska ikoniska röster eller skapa en egen.
Vanliga frågor

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.