Så fungerar text to speech-teknik: Från text till naturligt tal
- Skriven av
- Jack Limebear
- Publicerad
LyssnaLyssna på den här artikeln
Text to speech-teknik (TTS) omvandlar skrivna ord till talat ljud. Systemet avgör först vad texten säger och hur den ska låta, sedan genererar en AI-modell ljudet.
Först normaliserar en TTS-motor textinmatningen och omvandlar den till matematiska token och vektorrepresentationer som ett datorsystem kan hantera. Därefter omvandlar modellen dessa matematiska konstruktioner till digitala ljudrepresentationer och slutligen till ljudutdata.
I den här artikeln utforskar vi hur olika verktyg för text to speech fungerar och hur den senaste generationens generativa neurala talsyntes ger det mest naturliga talet hittills.
Sammanfattning
- Text to speech-system omvandlar skrivna ord till ljud i två steg. De omvandlar text till token, alltså matematiska representationer av språk. Sedan omvandlar de token till en akustisk representation som spelas upp som ljud.
- Nyare neurala TTS-motorer använder AI-modeller för att skapa naturligt tal. Företagsteam använder dem för innehållsskapande, undertextning och för att driva kundtjänst-agenter.
- Uttalslexikon och fonetisk taggning är två sätt att finjustera TTS-utdata så att de låter så naturliga som möjligt och säkerställa att teknisk jargong och namn uttalas korrekt.
- Ett Text to Speech API låter dig ansluta företagsapplikationer till högkvalitativ röstgenerering.
Vad är TTS? Så fungerar text to speech-teknik
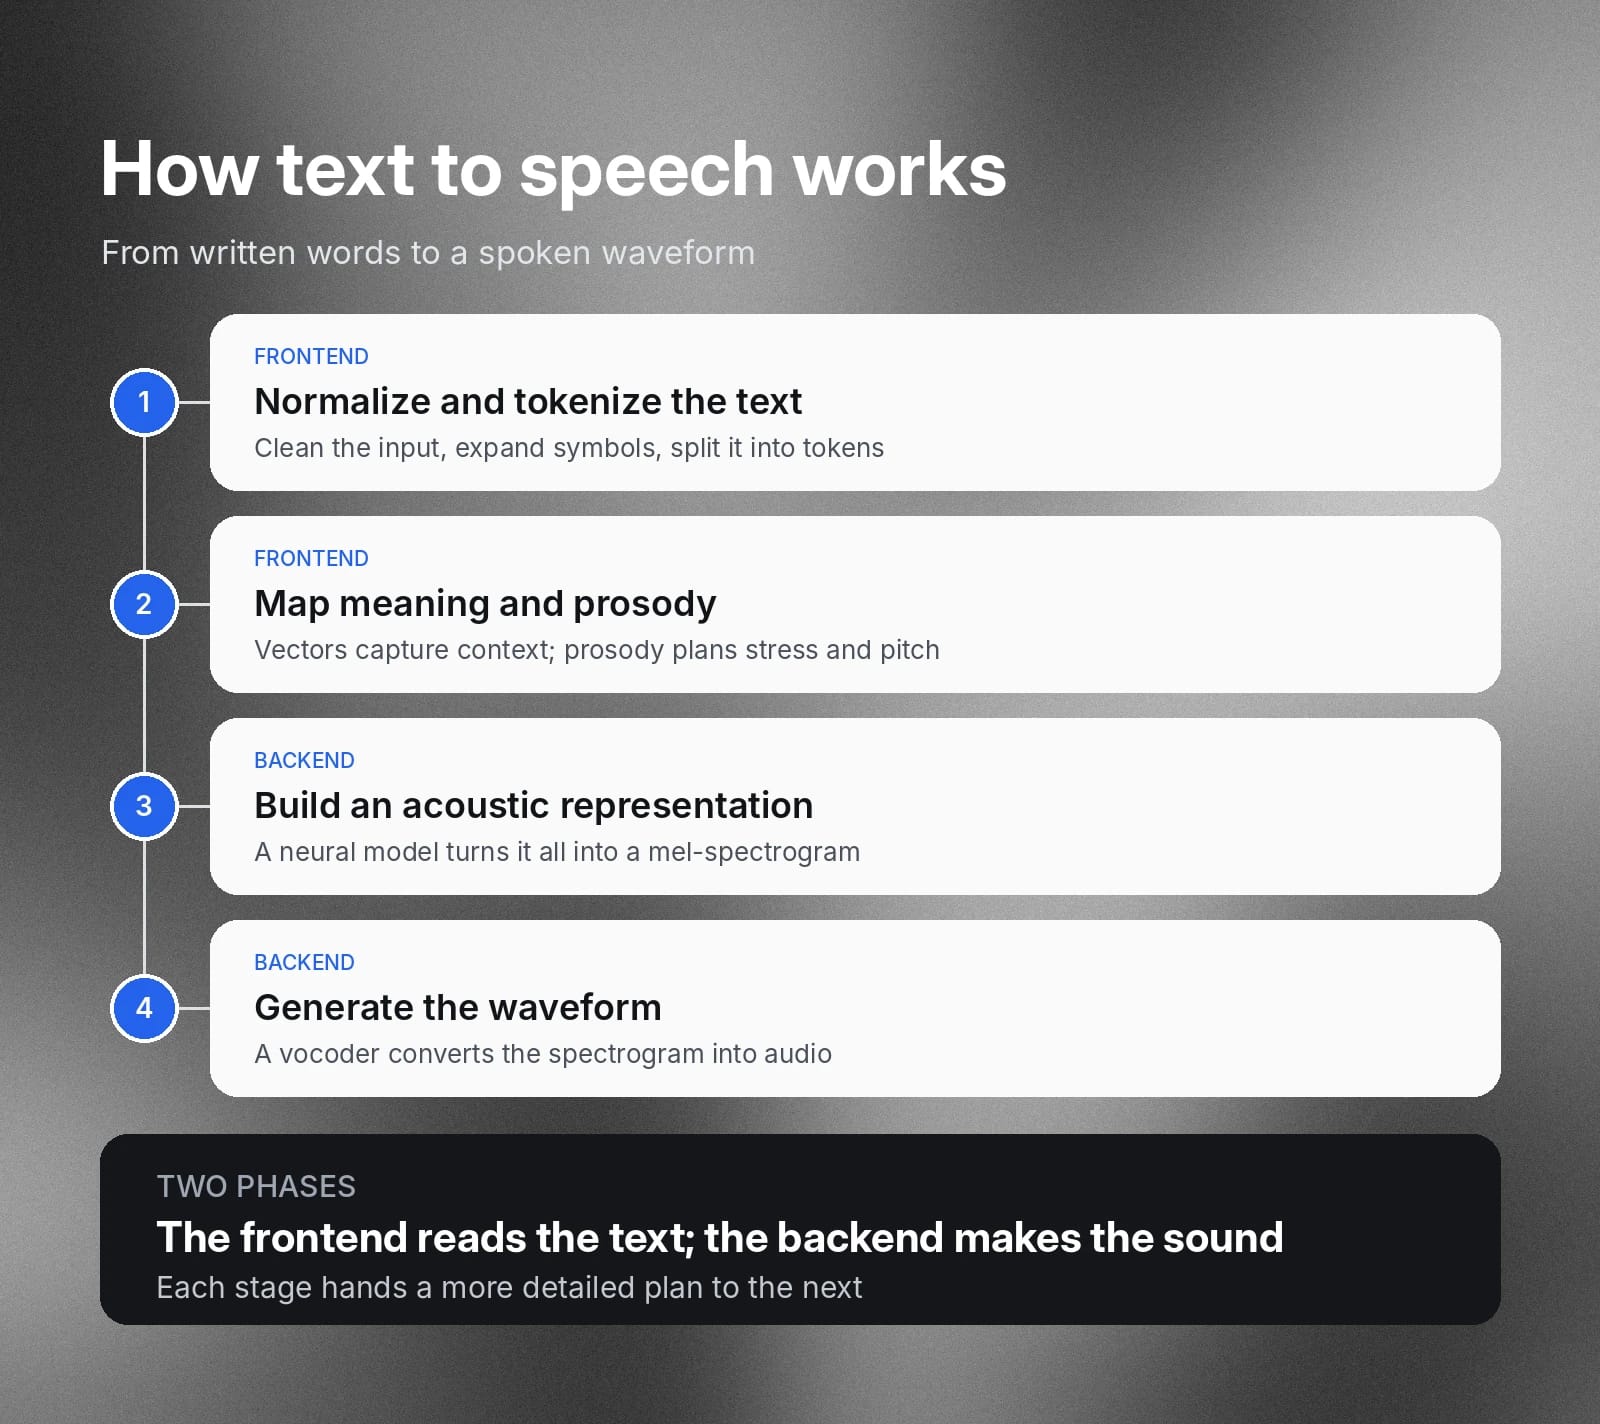
Text to speech fungerar genom att analysera skriven text, avgöra hur varje ord ska låta och sedan använda både en neural modell och en vocoder för att generera det talade ljudet.
TTS kan i stora drag delas in i två faser:
- Frontend: Systemet omvandlar text till en matematisk form som TTS-motorn kan arbeta med.
- Backend: Systemet tar resultatet från den första fasen och omvandlar det till vågformer som modellerar tal.
Låt oss titta närmare på delarna som får TTS att fungera.
Textnormalisering och språklig analys
Det första steget i en TTS-process är naturlig språkbehandling (NLP): att rensa, tokenisera och avlägsna tvetydigheter i rå textinmatning. Texten delas upp i token, enskilda enheter i skriftspråket som en TTS-motor kan hantera. Ett token kan vara ett helt ord, en "delords"-enhet eller skiljetecken.
Text innehåller ofta andra symboler än hela ord, till exempel förkortningar och siffror. En TTS-motor måste också avgöra hur dessa ska uttalas. Till exempel läser TTS-motorn "$11" och omvandlar texten till ljuden för "elva dollar".
Semantisk betydelse och prosodi
Prosodi är talets tonhöjd och rytm, vilket är det som får TTS att låta naturligt. När motorn bearbetar texten skapar den även ett lager av prosodisk information som kopplar förändringar i betoning och intonation till texten för att få den att låta mer naturlig.
En TTS-motor måste också anpassa sitt uttal från text till tal utifrån sammanhanget. Den sammanställer informationen som vektorrepresentationer, numeriska data som kartlägger den semantiska likheten mellan ord och fraser. Tänk på det som en X-Y-graf där en linje ritas genom flera olika punkter, men i betydligt fler än två dimensioner.
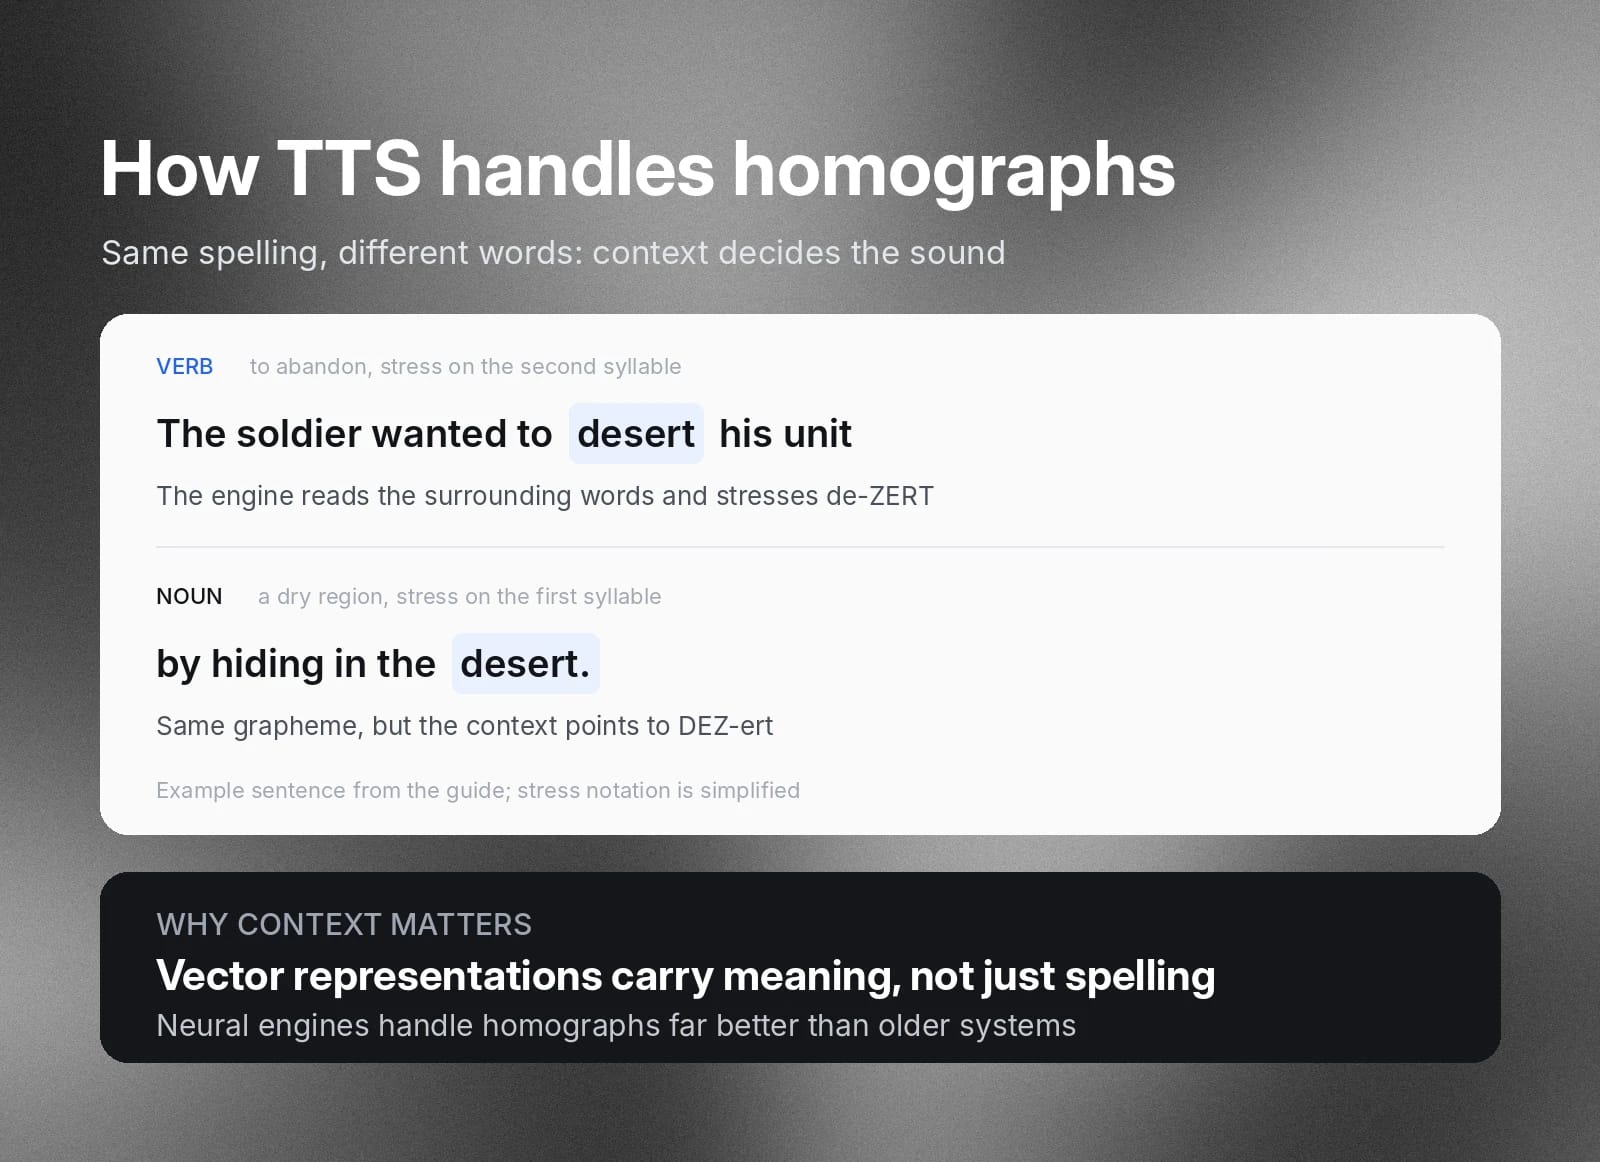
Ett specifikt exempel är homografer. Homografer, alltså olika ord med samma stavning, behöver ibland uttalas olika. TTS-motorn måste identifiera vilken intonation och betoning som ska användas för varje ord när det uttalas. Till exempel hur grafemet "desert" ska uttalas i meningen "The soldier wanted to desert his unit by hiding in the desert."
Se hur Eleven v4 väcker det här exemplet till liv.
Akustisk modellering och syntes av vågform (tal)
TTS-motorn tar den tokeniserade informationen och kontextuella vektorerna, som nu är numeriska data, och omvandlar dem till en akustisk representation, till exempel ett mel-spektrogram. Det omfattar olika frekvenser, energinivåer och ljud som hjärnan tolkar som känslor. Många olika system har använts för detta tidigare, men neurala modeller hör i dag till de mest effektiva.
I det sista steget används en vocoder för att omvandla dessa spektrogram till ljud som mänskliga lyssnare uppfattar som tal. Processen kallas vågformsgenerering.
Så fungerar TTS i praktiken: Ett genomarbetat exempel
Det enklaste sättet att se hur TTS-stegen hänger ihop är att följa en enda mening genom processen.
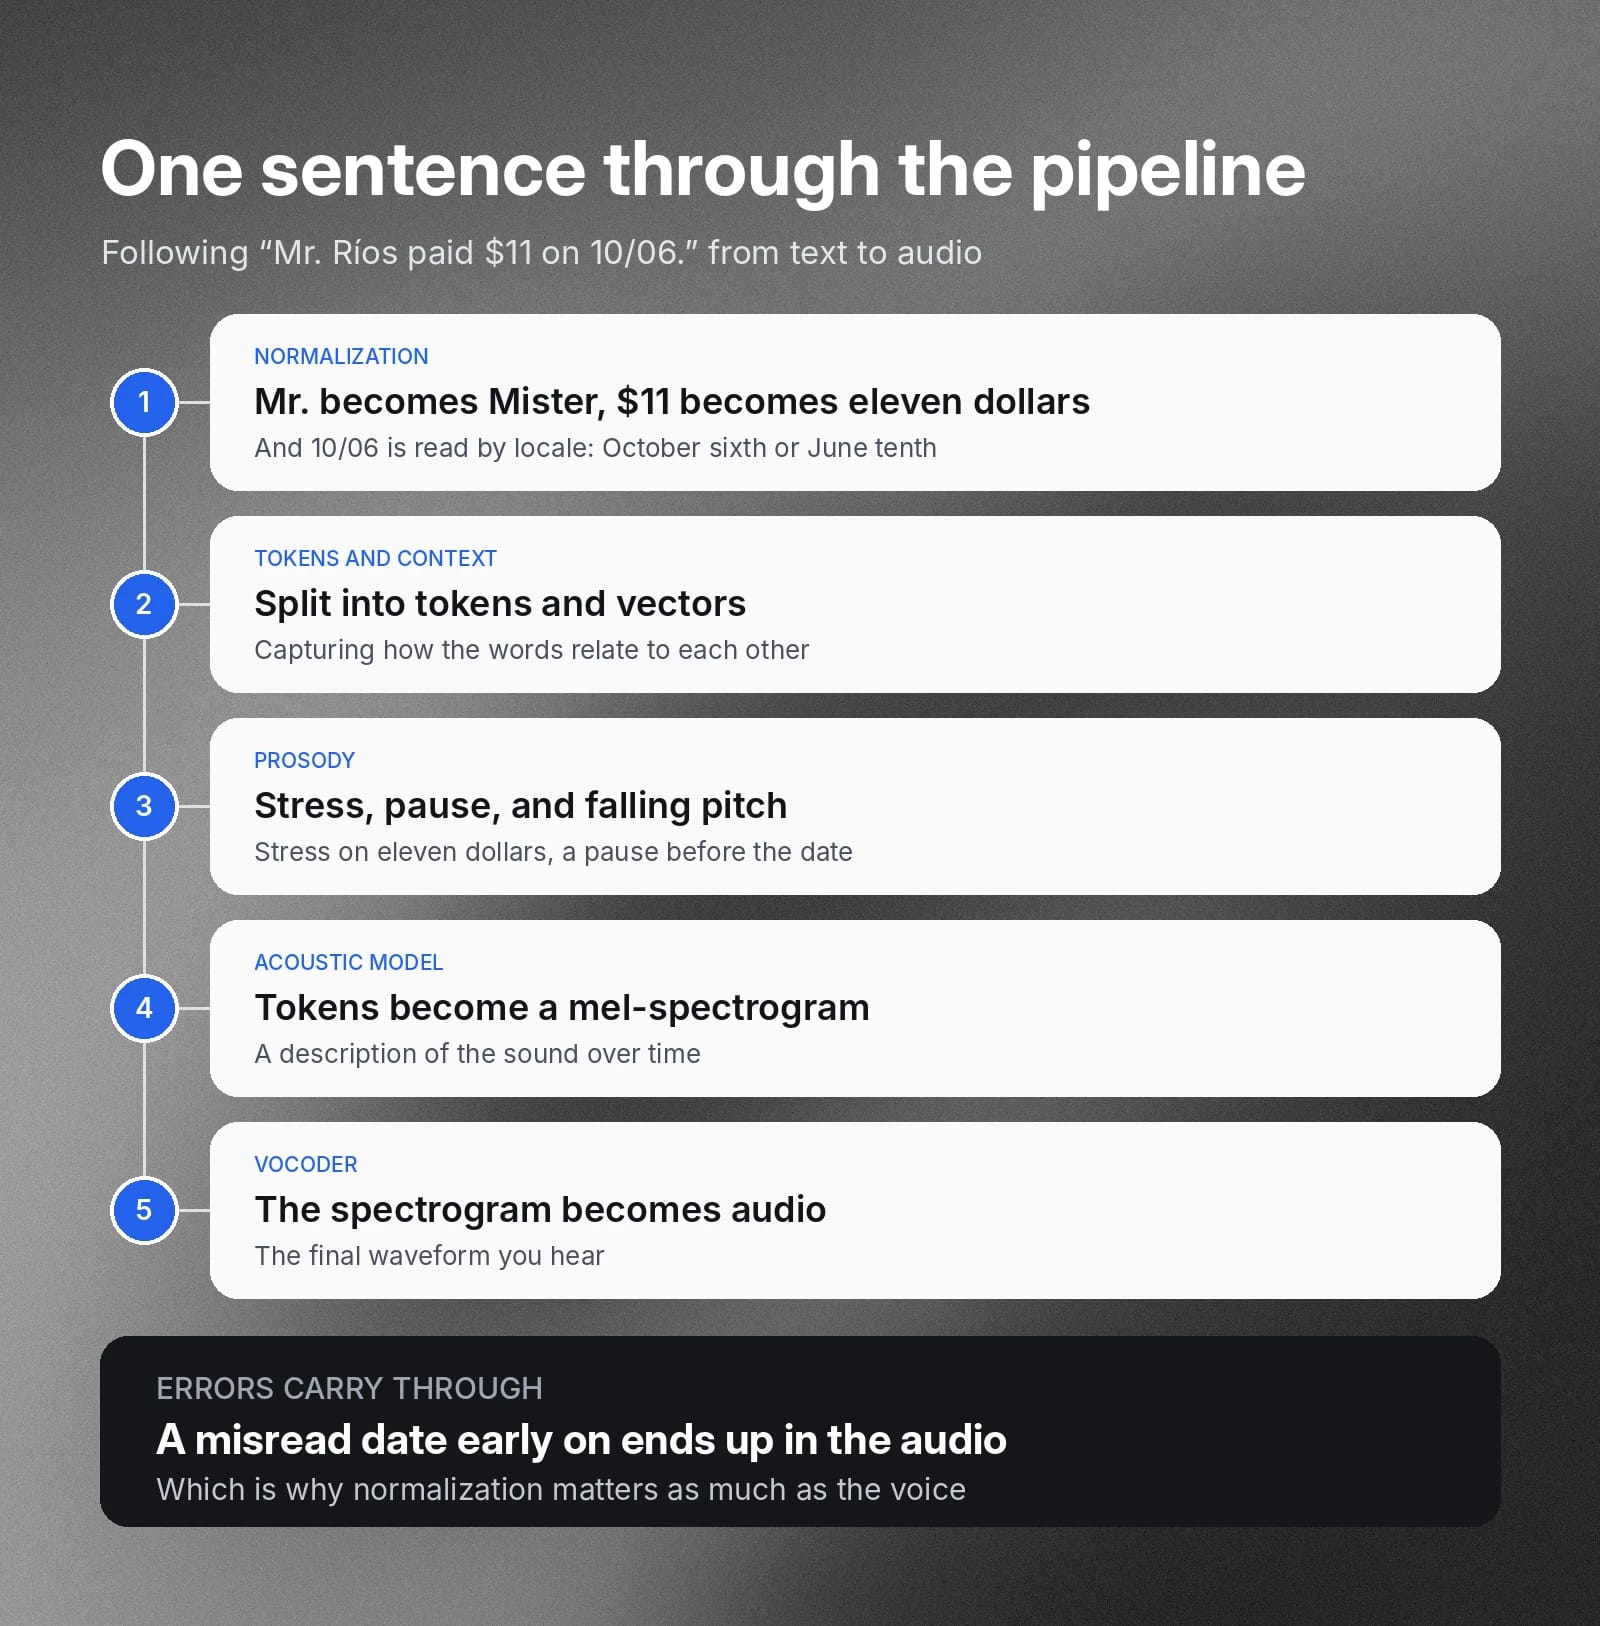
Ta texten "Mr. Ríos paid $11 on 10/06."
- Normalisering: Motorn skriver ut "Mr." som "Mister", läser "$11" som "elva dollar" och avgör om "10/06" betyder "sjätte oktober" eller "tionde juni", beroende på språkvariant och sammanhang.
- Tokenisering och sammanhang: Den rensade texten delas upp i token och omvandlas till vektorer som fångar hur orden förhåller sig till varandra.
- Prosodi: Motorn betonar "elva dollar", lägger till en kort paus före datumet och låter tonhöjden sjunka i slutet av meningen.
- Akustisk modell: Den neurala modellen omvandlar token och prosodiplanen till ett mel-spektrogram som beskriver ljudet över tid.
- Vocoder: Vocodern omvandlar spektrogrammet till den slutliga ljudvågform du hör.
Varje steg lämnar en mer detaljerad plan till nästa, vilket är varför fel tidigt i processen, som ett felläst datum, följer med till det färdiga ljudet.
Varför låter neural text to speech mer mänskligt?
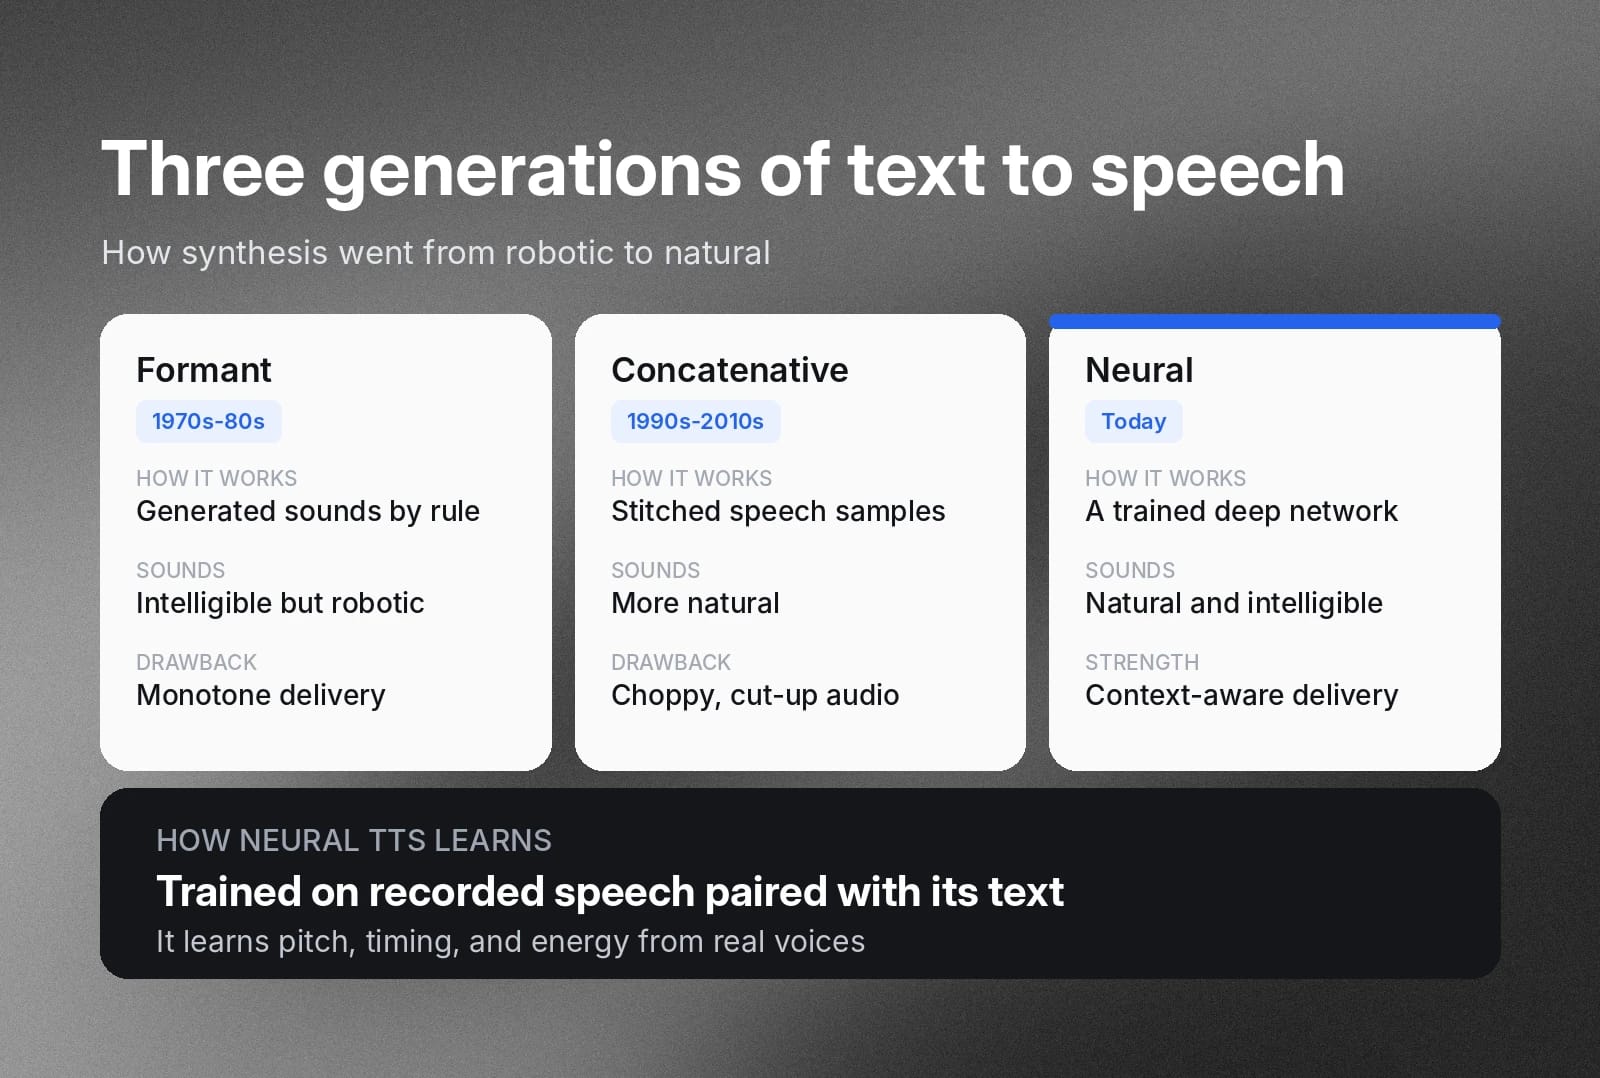
Neural talsyntes är särskilt bra på att skapa naturligt och begripligt tal, två egenskaper som ingenjörer använder för att utvärdera TTS-motorer. Neural TTS fungerar genom att träna ett djupt neuralt nätverk (DNN) att skapa tal från textinmatning. DNN:et tränas på stora mängder inspelat tal tillsammans med tillhörande text.
Motorer för neural talsyntes är bara den senaste generationen av TTS för företag. De föregicks av två generationer kommersiell syntesteknik.
Formantsyntes var den dominerande metoden på 1970- och 80-talen. I stället för att sampla mänskligt tal för utdata vid körning skapade den syntetiska ljud som modellerade tal. Talet var begripligt, men monotont och robotliknande.
Konkatenativ syntes dominerade från 1990-talet till 2010-talet och lät mer naturlig än tidigare formantsystem. I stället för att skapa toner utifrån matematiska regler satte systemen ihop, eller konkatenerade, små samplingar av mänskligt tal. De använde språkliga uppslagstabeller för att matcha normaliserad text med ljud och gav sedan ut små enheter av sammanfogat talljud från ett stort bibliotek, eller "korpus". Trots att resultatet låter mer naturligt än tal från en formantmotor kan konkatenation fortfarande få talet att låta hackigt eller uppstyckat.
Vad är skillnaden mellan en AI-röstgenerator och text to speech?
"AI-röstgenerator" är en term som ofta används i marknadsföring för att beskriva ett brett utbud av rösttekniker, inklusive text to speech. Text to speech syftar specifikt på system som tar skriven text som indata, modellerar dess semantik och prosodi och skapar ljudvågformer.
AI-röstgeneratorer är ett helt ekosystem av sammanlänkade rösttekniker, inklusive TTS och andra generativa system för Voice Design, Voice Cloning, och överföring av röststil. Även om termen ofta används synonymt med text to speech i marknadsföring är AI-röstgeneratorer bäst att se som ett samlingsnamn för den bredare kategorin av generativa röstverktyg där TTS ingår.
Så använder du text to speech för innehåll, tillgänglighet och support
Text to Speech-modeller har blivit en central del av arbetsflöden världen över, både för privat och kommersiell användning.
Här är några av de främsta användningsområdena för text to speech.
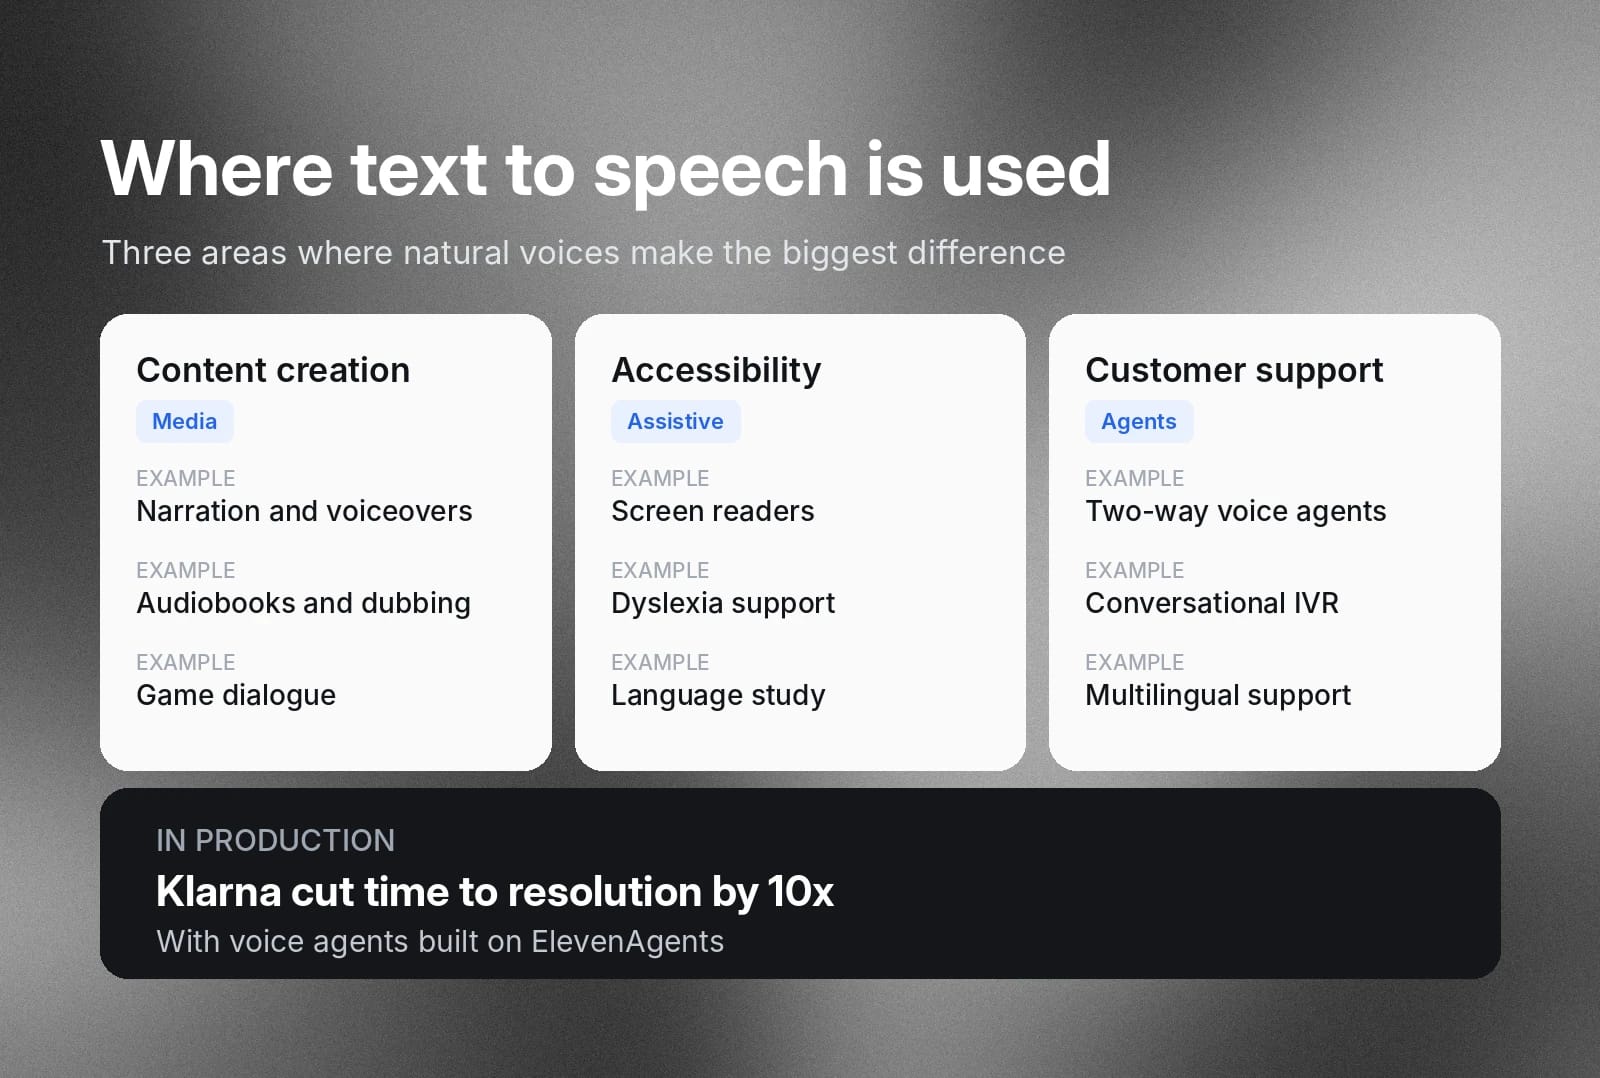
Innehållsskapande
Verktyg för text to speech kan minska kostnaderna för storskalig medieproduktion och tiden i studion för berättarröst och kompletterande inspelningar i efterproduktionen.
Exempel på användningsområden:
- Berättarröst
- Voice-over
- Dubbning
- Ljudboksproduktion
- Speldialog
Till exempel använde TAP ElevenLabs TTS för att skala upp utbildningsinnehåll för skolor i hela Indien.
Tillgänglighet
Text to speech är en av de mest använda hjälpmedelsteknikerna eftersom den låter människor ta till sig skriftligt innehåll genom att lyssna. Naturligt tal ökar lyssnarens engagemang och minskar mental trötthet vid längre material.
Vanliga användningar av TTS för tillgänglighet är:
- Skärmläsare: Läs upp hela sidor med en skärmläsare och TTS.
- Stöd för dyslexi och läsning: Minska läsbördan genom att låta en TTS-röst följa med under läsningen.
- Nedsatt syn och blindhet: Skärmläsare läser upp gränssnittselement och sidinnehåll så att människor kan navigera i programvara och på webbplatser utan att se skärmen.
- Kognitiva skillnader och uppmärksamhetssvårigheter: Att höra text kan göra det lättare att läsa långa dokument och hålla fokus.
- Lärande och språkstudier: Elever hör korrekt uttal av nya ord och kan lyssna på läroböcker under pendling eller studier.
Skärmläsare är kompletta tillgänglighetsverktyg som beskriver allt på skärmen, inklusive knappar och menyer. Uppläsningsverktyg fokuserar på att läsa upp själva innehållet, ofta med markering som följer med, och de gynnas av mer naturliga röster eftersom människor använder dem under längre perioder.
Kundtjänst
Neural talsyntes kan ge en kundupplevelse av hög kvalitet när den kombineras med en LLM som klarar agentbaserade interaktioner. Plattformar som ElevenAgents kombinerar röstlagret med taligenkänning, en LLM och anslutna verktyg som låter en agent förstå vad en uppringare behöver och svara med en naturlig röst.
Agenter som byggts med ElevenAgents fungerar i telefon, på webben, WhatsApp, e-post och SMS, så att kunder kan fortsätta ett samtal mellan kanaler utan att upprepa sig. Exempel på användningsområden:
- Tvåvägs AI-röstagenter: Hantera direktsamtal genom att besvara frågor från en kunskapsbas eller styra kunder till specifika flöden, till exempel återbetalningar eller köp.
- Interaktiva talsvarssystem (IVR)-system: Ersätt föråldrade menyträd som "Tryck 3 för försäljning" med samtal där kunderna kan prata naturligt.
- Flerspråkig support: Hjälp kunder på deras eget språk från en enda agentkonfiguration.
Klarna minskade till exempel tiden till lösning med 10 gånger med ElevenAgents
Hur styr text to speech-motorer uttalet?
Moderna motorer för neural talsyntes kan skapa mycket naturligt tal, men specialfall kommer alltid att finnas i något så brett, djupt och dynamiskt som mänskligt språk. Du kanske vill behålla accenter, slang eller regionala uttal i ditt genererade tal. Du kanske producerar ljud inom en bransch med särskilda uttal av tekniska termer. Eller så vill du helt enkelt att ditt varumärkesnamn ska uttalas på ett mycket specifikt och konsekvent sätt.
Uttalslexikon och fonemöverskrivningar
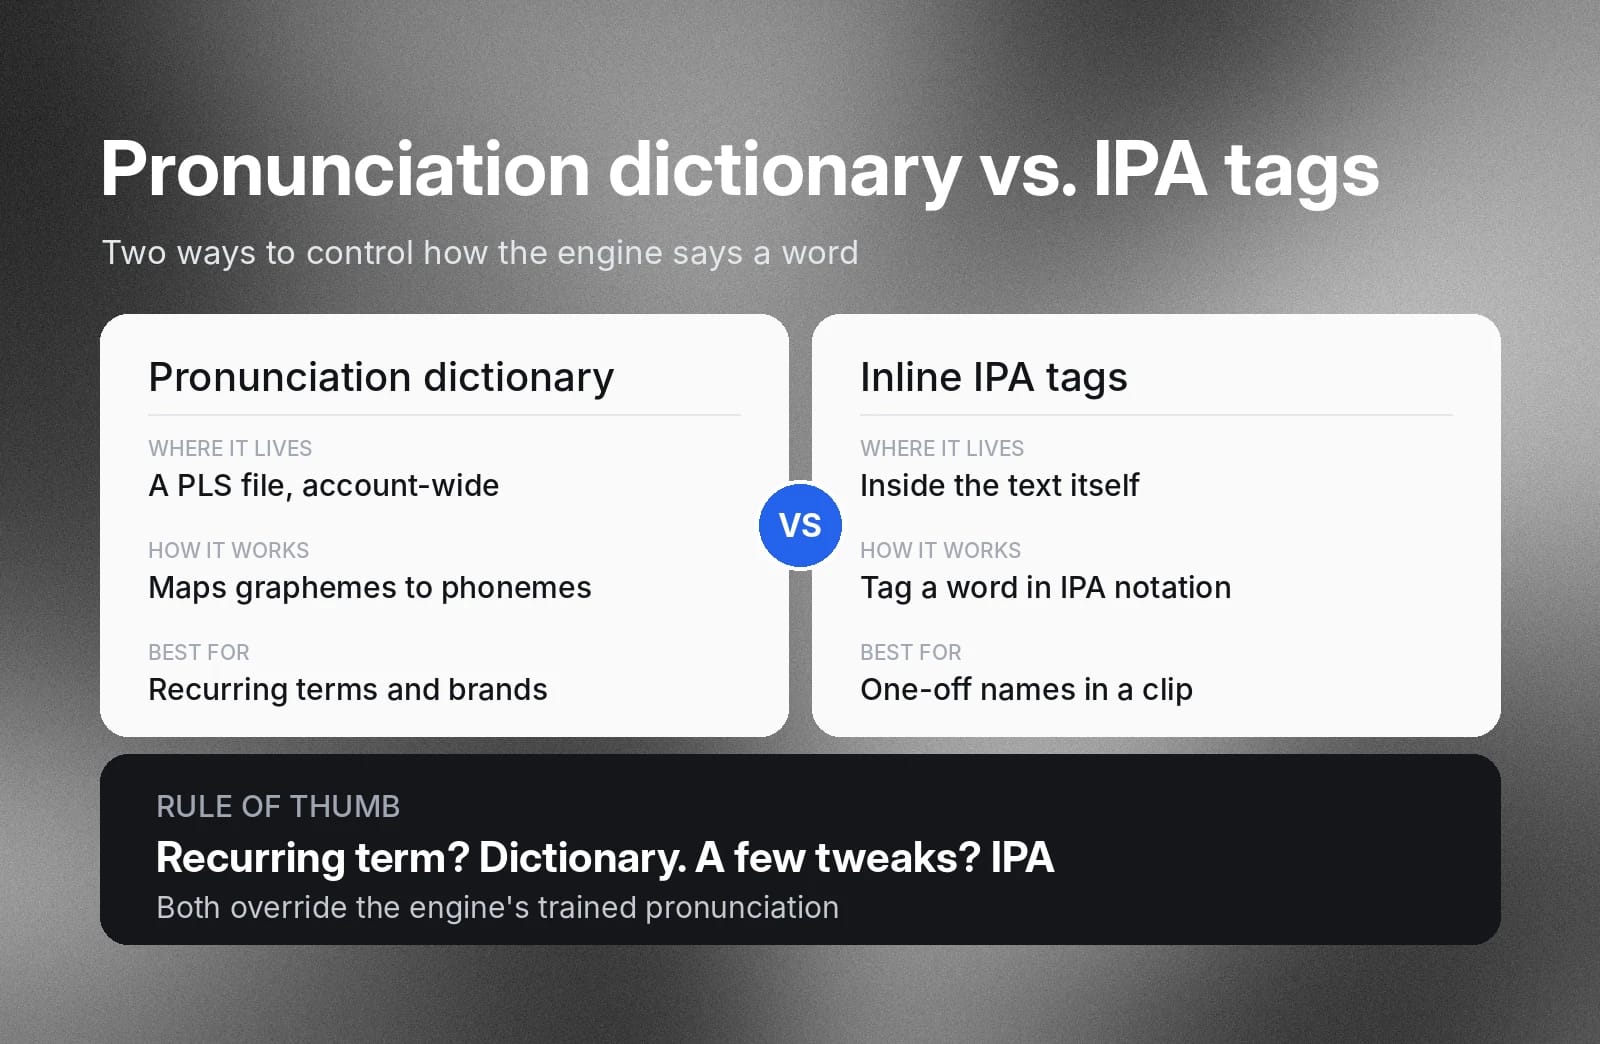
ElevenLabs ElevenAPI innehåller ett uttalslexikon som låter dig anpassa hur motorn talar. Du skapar ett lexikon i en W3C-standardiserad Pronunciation Lexicon Specification-fil (PLS) som mappar grafem (symboler i text) till fonem (talade ord uppdelade i ljud). När TTS-motorn stöter på ett av de listade grafemen åsidosätter den sitt inlärda uttal och använder det fonetiska uttalet från lexikonet.
I dokumentationen Använda uttalslexikon kan du lära dig hur du bygger ett uttalslexikon i ElevenAPI.
Inbyggd IPA och fonetisk prompting
Vissa TTS-modeller kan också känna igen uttalstaggar direkt i textinmatningen. I stället för att skapa ett lexikon för hela kontot kan du alltså tagga orden i texten med standardiserad IPA-notation om du bara vill justera uttalet i ett eller två ljudklipp. Till exempel om du spelar in en ljudbok och vill att en fiktiv karaktärs namn ska uttalas på ett särskilt sätt.
Vanliga utmaningar med text to speech och hur du hanterar dem
Även de starkaste TTS-modellerna kan ha svårt med nyanserna i mänskligt språk. Två av de vanligaste problemen är feluttal av nya ord och monotont tal. Så här hanterar du dem.
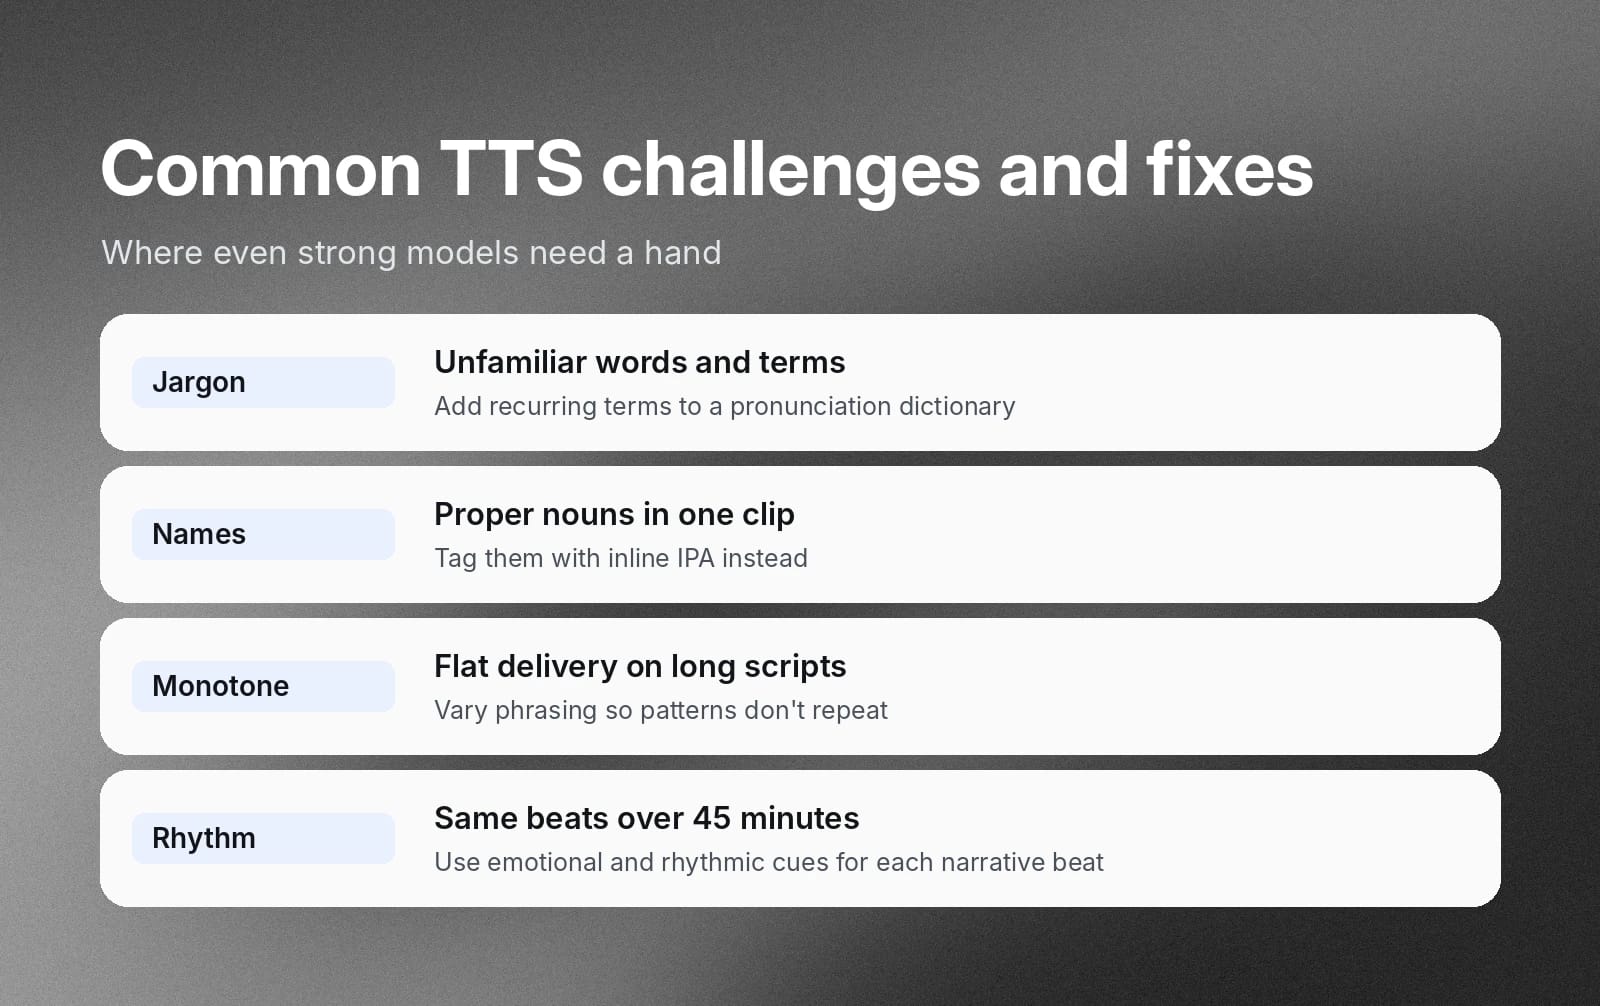
Feluttal av obekanta ord, jargong och egennamn
TTS-motorer använder algoritmer för att förutsäga hur normaliserad text ska uttalas utifrån hur grafem mappas till fonem i träningsdatan. De gör sin bästa bedömning utifrån texten och sammanhanget de har bearbetat. Men som vi nämnde i föregående avsnitt finns det många specialfall där du vill att något ska uttalas på ett mycket specifikt sätt.
Uttalslexikon eller riktade IPA-taggar är dina bästa verktyg för dessa specialfall. Om du har en term som återkommer ofta och ska uttalas konsekvent är ett lexikon den bästa lösningen. Om du bara vill göra riktade justeringar av några få termer använder du fonetiska IPA-taggar.
Monoton leverans
De här problemen är vanligast vid bearbetning av längre manus där samma ord eller fraser sägs om och om igen. En motors syntetiserade tal kan låta bra i tio sekunder långa klipp, men att höra samma mekaniska uttal och rytmiska mönster under en 45 minuter lång föreläsning blir snabbt tröttande för lyssnaren.
Variera formuleringarna i dina manus och använd fonetiska taggar med omdöme för att periodvis variera uttalet. Använd emotionella och rytmiska signaler för att göra talutdata mer dynamiska, med tonhöjningar och sänkningar i olika delar av berättelsen.
Bygg naturliga röstupplevelser med ett Text to Speech API
Smidiga webbverktyg kan vara utmärkta för att skapa små ljudklipp, men de skalar inte väl för större affärsbehov. Om du ska hantera tusentals kundinteraktioner per minut eller skapa högkvalitativt ljudinnehåll i långt format behöver du mer robusta TTS-verktyg.
Ett Text to Speech API som ElevenAPI låter dig ansluta din programvara direkt till modeller för neural talsyntes. Du kan använda REST-anrop eller beständiga WebSockets för att generera ljud på begäran för agenter eller andra ändamål i stor skala.
Så fungerar en API-begäran för text to speech
Även om modellerna är komplexa är utvecklarflödet lätt att förstå och komma igång med.
Med ElevenAPI kan du integrera Text to Speech i dina applikationer på några minuter:
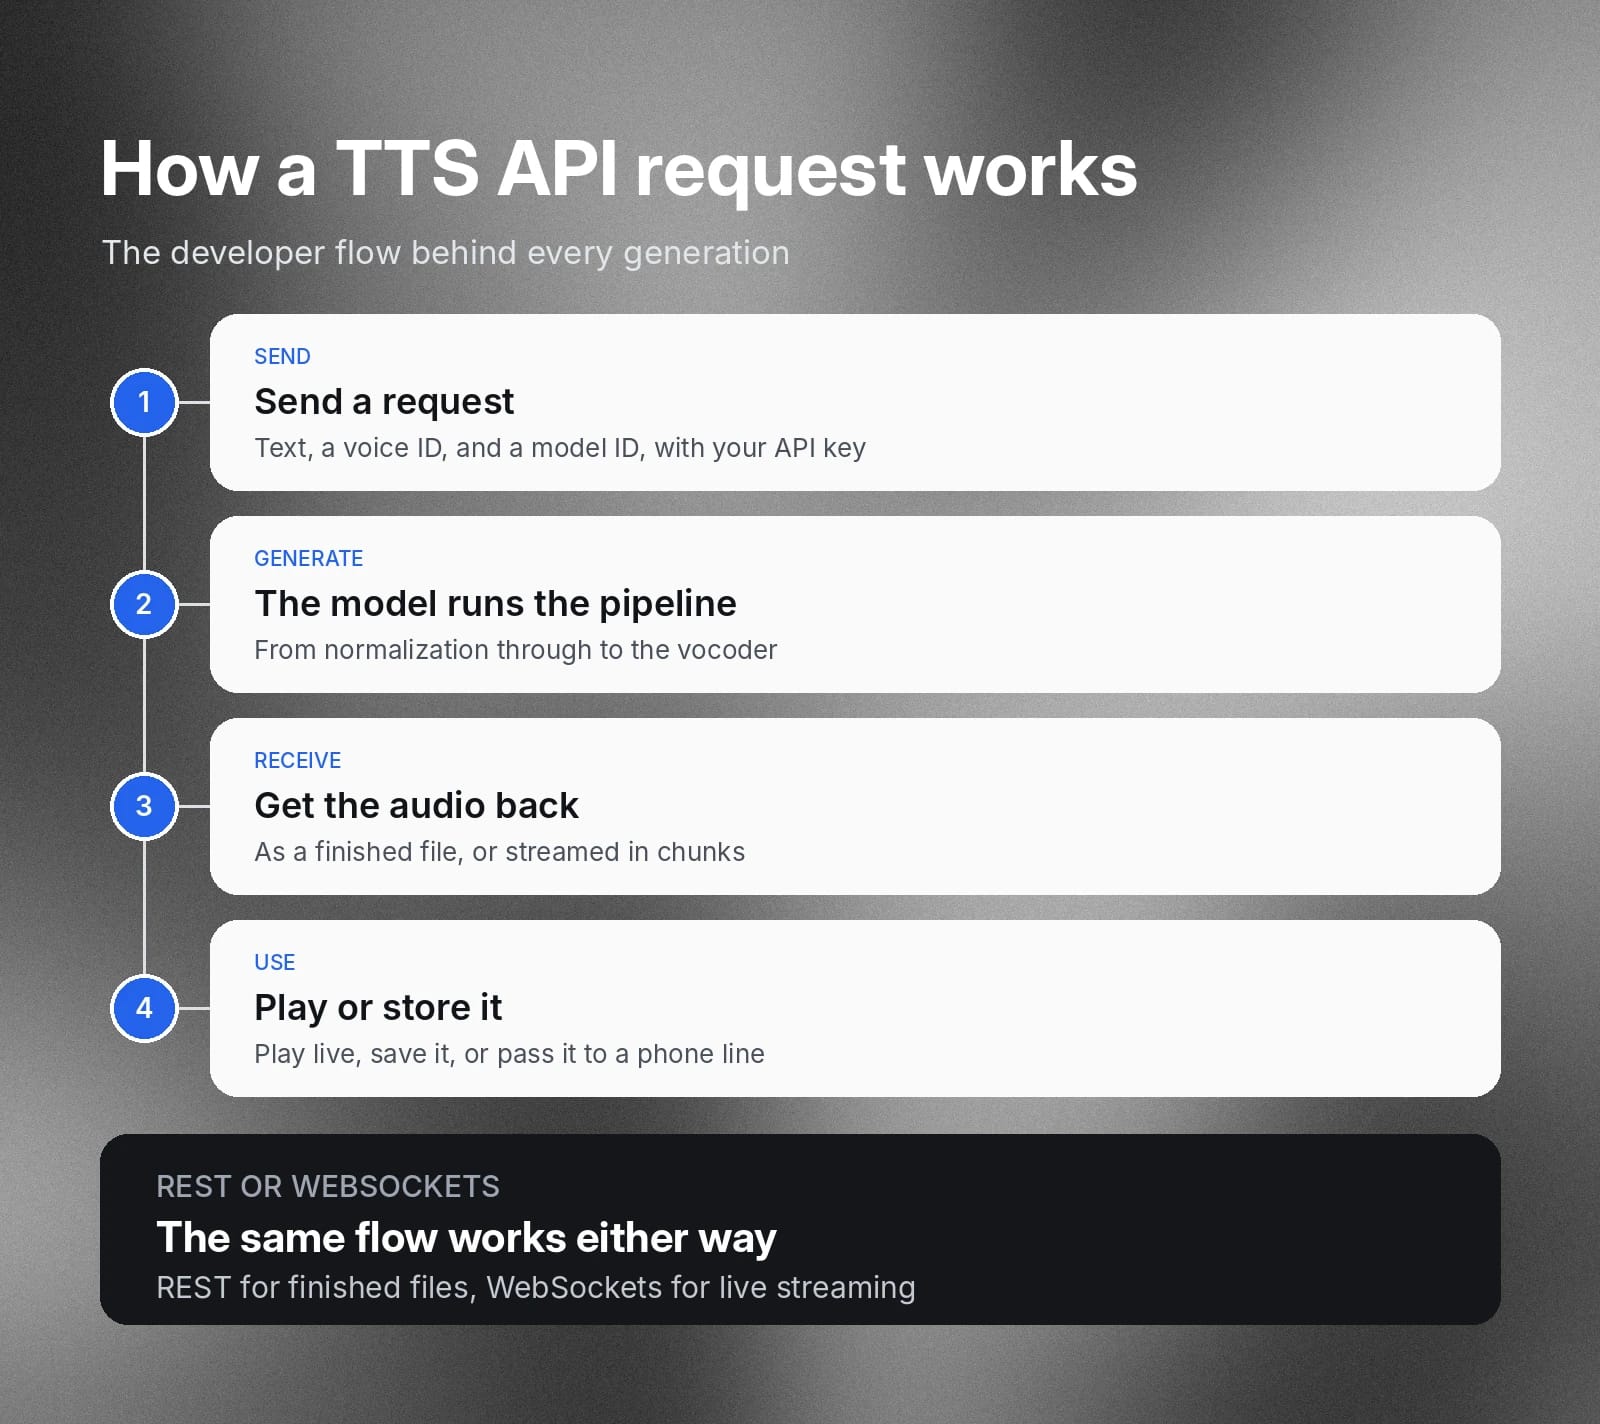
- Skicka en begäran: Din applikation skickar texten, ett röst-ID och ett modell-ID till API:et med din API-nyckel.
- Generera: Modellen kör processen som beskrivs ovan, från normalisering till vocoder.
- Ta emot ljud: API:et returnerar den färdiga ljudfilen eller streamar tillbaka den i delar så att uppspelningen kan börja innan genereringen är klar.
- Spela upp eller spara: Din applikation spelar upp ljudet live, sparar det eller skickar det vidare till ett annat system, till exempel en telefonlinje.
Samma flöde gäller oavsett om du använder REST för färdiga filer eller WebSockets för livestreaming, och SDK:erna som beskrivs nedan paketerar dessa anrop åt dig.
Arkitektoniska överväganden för utvecklare
Beroende på ditt användningsfall kan du behöva väga avvägningar mellan bearbetningshastighet, ljudåtergivning, nätverkslatens och protokoll samt integrationsmöjligheter.
Latens kontra ljudåtergivning
För att samtalsagenter ska låta naturliga bör du sikta på ungefär 100 ms till första ljudet, vilket innebär att du minimerar latensen i nätverket och till TTS-motorn. Det viktiga är vilken ljudkvalitet agentens arkitektur kan ge inom den begränsningen.
Omvänt spelar latens mindre roll när du producerar ljud i långt format, som en podcast eller föreläsning. I stället för att minimera latensen vill du maximera utdata med hög ljudåtergivning.
Streamingprotokoll
Protokollen du använder för API-anslutningen kan också påverka latens och prestanda. WebSockets möjliggör verklig tvåvägsstreaming av ljud, vilket innebär att du kan bearbeta textdelar i taget i stället för att vänta på att ett helt flöde ska renderas. Uppspelningen kan börja med de första delarna medan TTS-motorn fortfarande bearbetar senare delar.
SDK:er
Text to Speech API:er för företag, som ElevenAPI, erbjuder kompletta programvaruutvecklingskit (SDK:er) för Python och TypeScript/JavaScript, samt REST API:er, så att du snabbt kan sätta upp en ny arkitektur. Använd dem för att minska integrationsarbetet för ditt utvecklingsteam.
Kom igång med ElevenAPI för Text to Speech
Naturlig TTS-syntes från en ledande talmodell ger det högkvalitativa ljud som dina agenter och ljudproduktioner behöver för att hålla lyssnarna engagerade. Oavsett om du söker en högkvalitativ samtalsagent för att stödja kundflöden eller vill bygga in TTS i din applikation har ElevenLabs en lösning.
Kom igång i dag genom att skapa ditt eget högupplösta ljud med ElevenAPI, eller läs mer om ElevenAgents.
Vanliga frågor

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.