Guide till uttalslexikon: Rätta vilket ord som helst i TTS med Eleven v4
- Skriven av
- Jack Limebear
- Publicerad
LyssnaLyssna på den här artikeln
Eleven v4 sätter en ny standard för uttal i Text to Speech-modeller och hanterar förkortningar, tekniska termer, namn och text på flera språk mer korrekt än någon tidigare modell. Samtidigt har varje varumärke sitt eget ordförråd, från unika produktnamn till branschspecifik jargong, så du behöver full kontroll över hur orden låter.
Eleven v4 erbjuder flera sätt att rätta uttal, så att du får detaljerad kontroll över hur modellen talar. Du kan bygga ett omfattande uttalslexikon som gäller för alla manus du skriver i TTS-appen. Eller skriva IPA direkt i texten för en enstaka korrigering.
Här är ett kort exempel på hur Eleven v4 hanterar ett manus fullt av svåra termer:
Den här guiden visar hur du skapar och använder ett TTS-uttalslexikon samt alla strategier runt omkring som hjälper dig att få ljudet att låta så nära din vision som möjligt.
Sammanfattning
- Ett uttalslexikon är en uppsättning regler som du skriver för att tala om för en Text to Speech-modell hur specifika ord eller fraser ska uttalas.
- TTS-uttalsregler är antingen aliasbaserade, som ersätter text med annan text, eller fonembaserade, som använder fonetisk stavning.
- Eleven v4 har stöd för fonemregler och IPA direkt i texten (internationella fonetiska alfabetet).
- SSML-taggar för fonem och pauser fungerar inte i Eleven v4, men du kan använda ett uttalslexikon eller Audio Tags som ett naturligt språkligt alternativ.
- Du kan använda upp till tre uttalslexikon per begäran via ElevenAPI.
Vad är ett uttalslexikon?
Ett uttalslexikon är ett verktyg som låter dig ställa in exakt hur en text to speech-modell uttalar vissa ord. Genom att lägga till ord eller fraser i ett uttalslexikon anger du hur de ska låta varje gång de förekommer i ett TTS-manus.
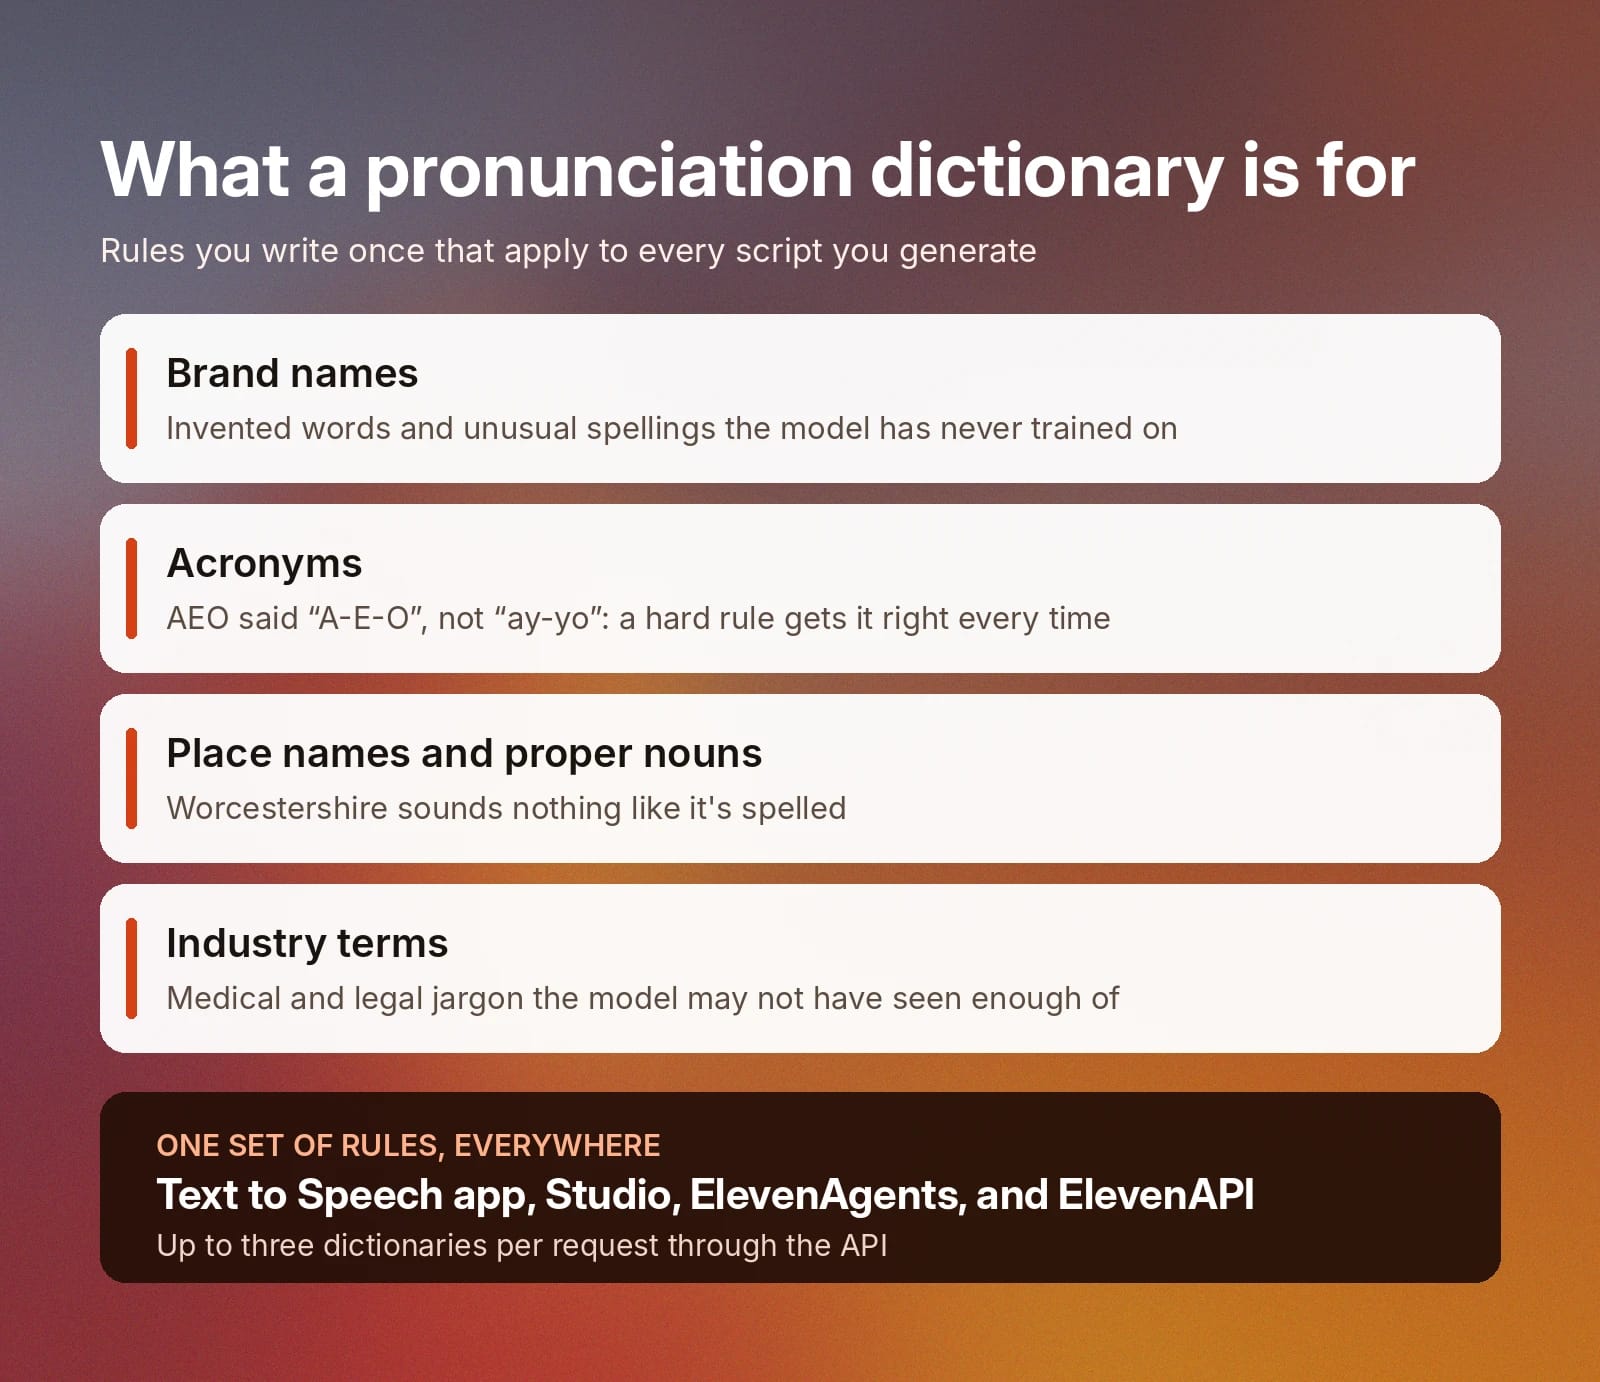
Uttalslexikon används vanligtvis för:
- Varumärkesnamn: Varumärkesnamn är vanliga poster i uttalslexikon, särskilt när de har unik eller ovanlig stavning.
- Akronymer: Vissa akronymer har ett specifikt uttal. AEO ska till exempel låta som /ˌeɪ.iːˈoʊ/ (”A-E-O”), inte /eɪˈjoʊ/ (”ay-yo”). En fast lexikonregel ser till att modellen uttalar det rätt varje gång du skriver det.
- Ortnamn och andra egennamn: Vissa ortnamn kan uttalas helt annorlunda än man föreställer sig när man ser dem skrivna. Worcestershire är ett välkänt exempel där en uttalsguide kan hjälpa till att undvika problem.
- Branschtermer: Branschjargong eller specialiserade termer från exempelvis medicin eller juridik kan behöva ett uttalslexikon om modellen inte uttryckligen har tränats på data från dessa områden.
Utanför text to speech är uttalslexikon vanligtvis crowdsourcade samlingar av ljudklipp från modersmålstalare, som elever använder för att höra hur vissa ord uttalas.
Så styr du TTS-uttal i Eleven v4
Eleven v4 rankas som Text to Speech-modellen med högst kvalitet av Artificial Analysis' Provider Voice Arena.1 En del av det som gör Eleven v4 marknadsledande är modellens förmåga att hantera komplex text och samtidigt få resultatet att låta naturligt.
För att ge användare bästa möjliga upplevelse med Eleven v4 erbjuder modellen flera sätt att anpassa uttal, så att varje resultat uppfyller dina krav på precision.
Så här kan du styra uttal med Eleven v4:
- IPA direkt i texten: Du kan skriva IPA i dina manus mellan snedstreck för att styra uttalet utan att använda uttalslexikonet. Vi går snart igenom exakt hur du gör.
- Fonemregler i lexikon: Skriv fonembaserade regler i dina uttalslexikon för att styra det fonetiska ljudet för återkommande ord.
- Flytande uttal på olika språk: Eleven v4 kan skapa naturligt tal på över 90 språk. Behåll det inhemska uttalet på varje språk medan du använder samma röst för en enhetlig ljudprofilering-upplevelse.
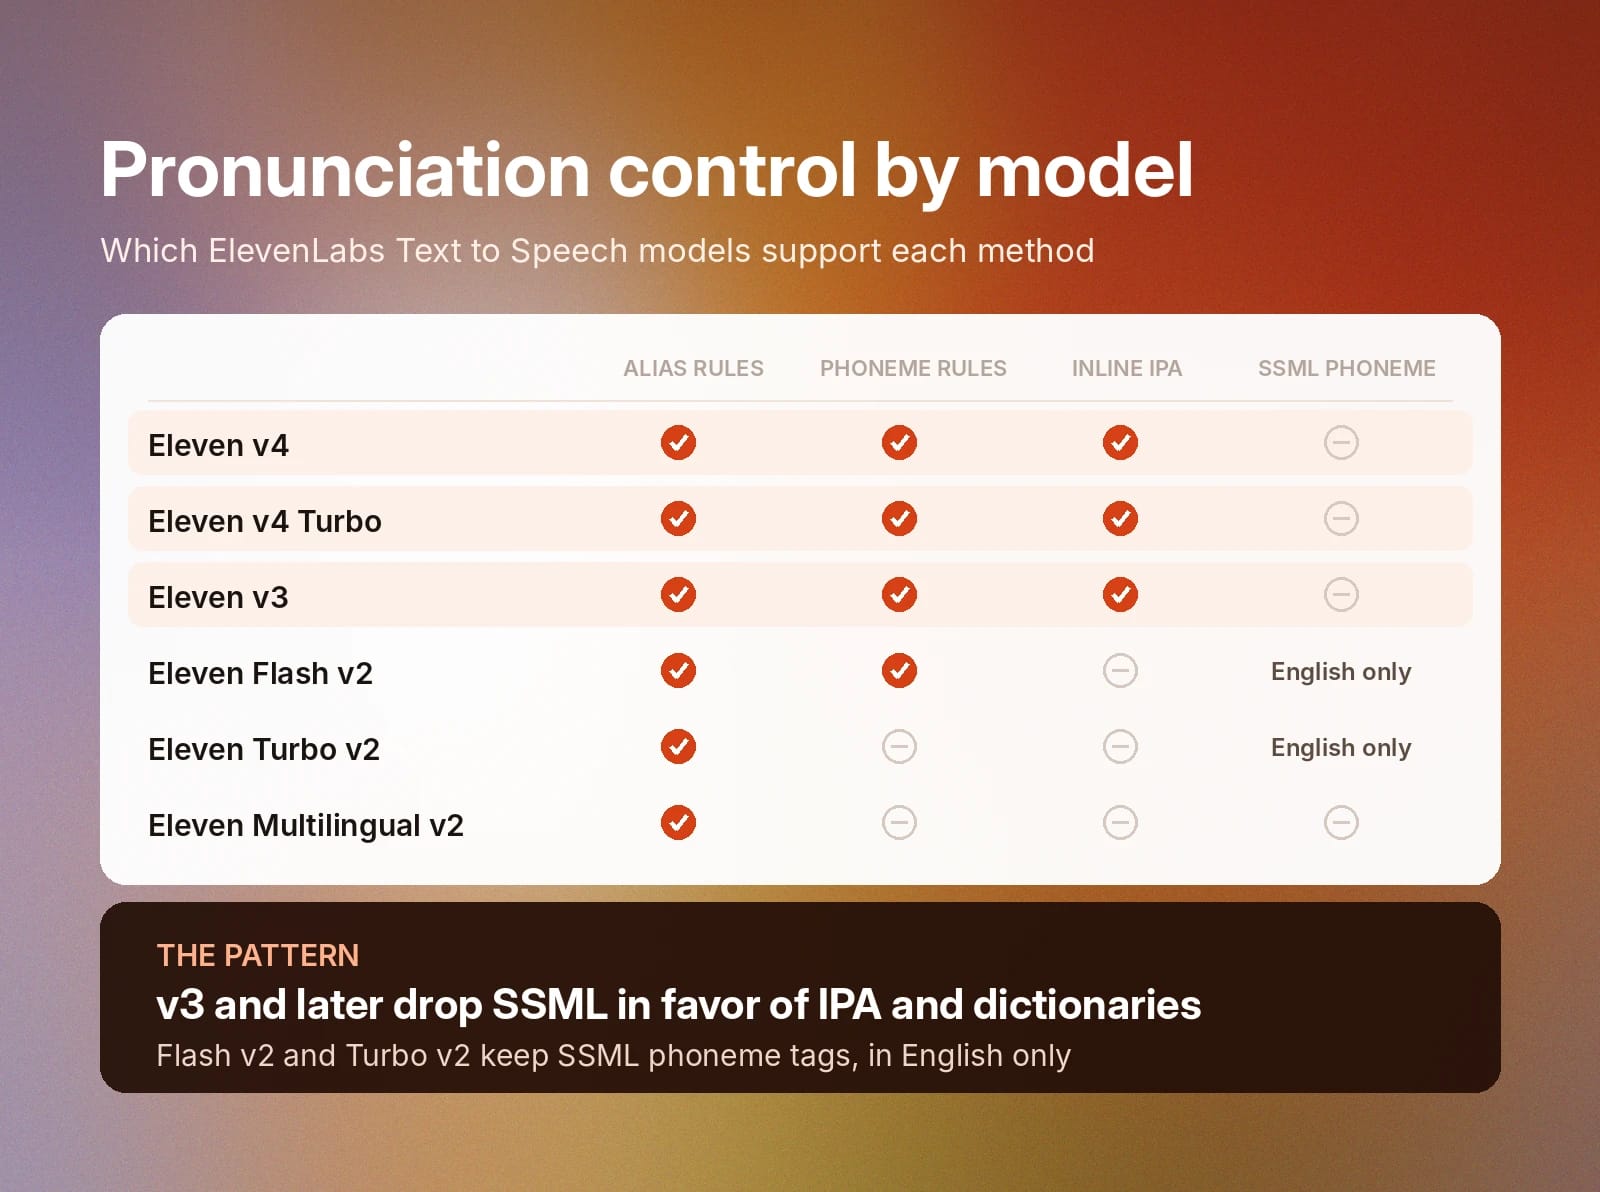
Så här skiljer sig olika TTS-modeller från ElevenLabs åt när det gäller uttalskontroll:
Modell | Aliasregler (lexikon) | Fonemregler (lexikon) | IPA direkt i texten (/.../) | SSML-fonemtaggar (<phoneme>) |
Eleven v4 | Ja | Ja | Ja | Nej |
Eleven v4 Turbo | Ja | Ja | Ja | Nej |
Eleven v3 | Ja | Ja | Ja | Nej |
Eleven Flash v2 | Ja | Ja | Nej | Ja (endast engelska) |
Eleven Turbo v2 | Ja | Nej | Nej | Ja (endast engelska) |
Eleven Multilingual v2 | Ja | Nej | Nej | Nej |
Vad är skillnaden mellan alias- och fonemregler i ett uttalslexikon?
Aliasregler för uttal ersätter en textdel med en annan innan modellen uttalar ordet. Det sker i bakgrunden när en modell genererar ljud och ersätter uttalet av ett ord eller en fras med det du har angett i ditt uttalslexikon.
Här är några exempel på aliasregler för uttal:
- ”SaaS” blir ”sass”
- ”UN” blir ”United Nations”
- ”OAuth” blir ”oh auth”
Fonemregler ger däremot modellen en exakt fonetisk stavning att använda. De är svårare att skapa eftersom du själv behöver skriva eller generera IPA-transkriptionen och lägga in den i lexikonet. Till exempel blir ”Kubernetes” /ˌkuː.bərˈnɛt.iːz/.
Så rättar du uttalet av ett varumärkesnamn i en TTS-modell
Varumärkesnamn är en av de vanligaste posterna i uttalslexikon eftersom de inte alltid är riktiga ord. Om ditt företag har hittat på ett ord eller en unik stavning för ditt varumärke kan TTS-modeller ha svårt att uttala det korrekt, eftersom det finns mycket lite tillgänglig träningsdata med just det uttalet.
Så här rättar du uttalet av ett varumärkesnamn i Eleven v4:
- Testa standarduttalet: Öppna Text to Speech-appen och skriv ditt varumärkesnamn. Generera ett klipp och lyssna på hur det låter. Om uttalet är fel går du vidare till nästa steg.
- Prova en aliasregel: Det enklaste sättet att rätta ett felaktigt uttal av ett varumärke är att skapa en aliasregel. De är snabba att skriva och enkla att förstå.
- Byt till en fonemregel: Om aliasregeln inte fungerar riktigt kan du använda IPA. Transkribera ditt varumärkesnamn med IPA och skapa sedan en regel i uttalslexikonet för Text to Speech för att rätta uttalet.
- Täck alla versaliseringar: Se till att inkludera IPA-transkriptionen för både gemena och versala versioner av ditt varumärkesnamn, om du använder båda.
- Använd IPA direkt i texten för enstaka ändringar: Om du bara vill ha en snabb korrigering för en enstaka generering kan du lägga till IPA direkt i manuset i stället för att skapa en lexikonpost.
När du har skapat en regel för ett varumärkesnamn finns den framöver i alla delade projekt, oavsett om den används i din AI-agent eller nås via ett API.
Så skapar du ett uttalslexikon med ElevenLabs
Du kan skapa ett uttalslexikon genom att lägga till regler i Text to Speech-appen, ladda upp en .pls-fil eller via ElevenAPI. I den här guiden går vi igenom det första alternativet, som bara kräver några få steg.
Följ de här stegen för att skapa ett uttalslexikon:
- Öppna panelen för uttalslexikon: Klicka på sökfältet högst upp på Text to Speech-sidan, skriv ”Pronunciation dictionary” och välj Pronunciation dictionaries under Actions.
- Skapa eller välj ett lexikon: Klicka på New för att skapa ett nytt lexikon, eller välj ett befintligt i listan till vänster.
- Lägg till en regel: Klicka på Add rule för att skapa en ny rad. Skriv in ordet du vill rätta. Ange ordet eller frasen precis som den förekommer i dina manus i fältet Input. Regler är skiftlägeskänsliga, så använd samma versalisering som i dina manus.
- Välj regeltyp: Välj Alias för att ersätta med annan text eller Phoneme för att ange en IPA- eller CMU-stavning.
- Ange ersättningen: Skriv aliaset eller den fonetiska stavningen i fältet Output. Använd röstväljaren högst upp i panelen för att höra regeln med rösten du arbetar med.
- Spara ändringarna: Klicka på Save changes längst ned i panelen.
Om du vill koppla en uttalsguide till en agent eller använda en via API:t följer du vår dokumentation om uttalslexikon.
Så använder du IPA i text to speech med Eleven v4
För mindre ändringar eller ovanliga ord behöver du inte nödvändigtvis skapa en ny post i ditt TTS-uttalslexikon för att rätta ett fel. I stället kan du använda IPA direkt i texten för att ange exakt hur modellen ska uttala ett ord.
I Eleven v4 kan du aktivera IPA direkt i texten genom att använda snedstreck. Precis som Audio Tags placeras de direkt i manuset för att göra det så enkelt som möjligt. Här är några exempel på IPA i Eleven v4:
- Tekniska termer: Termen "/ˌbaɪoʊˈkemɪstri/" syftar på studiet av kemiska processer.
- Medicinskt ordförråd: "/ɡluːˈkoʊs/" och "/ˈɪnsjəlɪn/" används ofta för att hantera tillstånd som "/ˌdaɪəˈbiːtiːz/".
- Varumärkes- och produktnamn: Våra servrar kör på "/ˌɛndʒɪnˈɛks/" för att hantera trafiktoppar.
Som en sidonot kan en IPA-konverterare hjälpa dig som inte har en examen i lingvistik att få rätt IPA från vanlig text att klistra in i ditt manus.
Varför SSML-fonemtaggar inte fungerar i Eleven v4
Eleven v4 har inte stöd för SSML utan använder i stället mer flexibla funktioner, som Audio Tags och uttalslexikon, som ger dig större kontroll över den färdiga ljudproduktionen.
Varje funktion som SSML erbjuder har en direkt ersättning i v4:
SSML-tagg | Vad den gjorde | Ersättning i Eleven v4 |
<phoneme> | Angav ett fonetiskt uttal | IPA direkt i texten (/…/) eller en fonemregel i lexikonet |
<sub alias> | Ersatte text före uppläsning | En aliasregel i lexikonet |
<break> | Lade till en paus | Audio Tags som [pause], ellipser eller radbrytningar |
<prosody rate> | Ändrade talhastighet | Audio Tags för tempo, som [slowly] eller [rushed] |
<emphasis> | Betonade ett ord | Versaler eller en Audio Tag för uttryck |
Kom igång med naturligt uttal i text to speech med Eleven v4
Med en rad verktyg som hjälper dig att förbättra uttalets precision i Eleven v4 kan du skriva detaljerade manus och få modellen att framföra dem precis som du har tänkt dig.
Bygg uttalslexikon i ElevenLabs Text to Speech-app och använd dem i stor skala med ElevenAPI.
Registrera dig för att komma igång eller läsa mer om Eleven v4 i dag.
Vanliga frågor
- Artificial Analysis, Provider Voice Arena Preference Elo, 30 september 2026