Neural Text to Speech (TTS) förklarat: Så fungerar AI-röster
- Skriven av
- Jack Limebear
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
Neural text to speech (TTS) är tekniken bakom AI-rösterna du hör överallt: den lilla knappen på nyhetssajten som läser upp artikeln, automatiserade supportsamtal och videoberättarröster på TikTok och YouTube. Listan kan göras lång. Neural TTS har ersatt traditionella, robotlika former av text to speech.
TTS-marknaden översteg 4,8 miljarder dollar år 2026 och växer med en sammansatt årlig tillväxttakt (CAGR) på 22,4 %. Marknaden växer kraftigt från år till år när fler användningsområden lanseras och både kreatörer och företag tar till sig tekniken.
I den här guiden förklarar vi vad neural Text to Speech är och varför tekniken är central för branschens snabba tillväxt. Vi går igenom hur den skiljer sig från traditionell TTS och vad du bör tänka på när du integrerar ett TTS-API i dina applikationer.
Sammanfattning
- Neural text to speech använder djupinlärning för att generera tal från grunden.
- Neurala röster fångar prosodi, intonation, betoning och rytm för att förstå hur en mänsklig röst låter.
- Traditionell konkatenativ och parametrisk TTS finns fortfarande i äldre system, men neural syntes har ersatt den där röstkvalitet spelar roll.
- Utvecklare kan integrera neural TTS via API:er, och streaminglatensen är nu tillräckligt låg för samtal i realtid.
Vad är neural text to speech?
Neural text to speech (neural TTS) är en form av talsyntes som använder djupa neurala nätverk för att skapa tal som låter mänskligt. Ett neuralt nätverk inom AI består av lager av sammankopplade bearbetningsenheter och har fått sitt namn eftersom det löst liknar neurala nätverk i människans hjärna.
Tidigare text to speech-modeller förlitade sig på handskrivna regler och inspelade ljudfragment för att kartlägga språk och lära sig skapa tal från textprover. En neural TTS-modell härleder sina egna regler och lär sig av sammanhang för att hantera mer utmanande delar av talet, som var den ska pausa eller vilket ord som ska betonas i en mening.
Förståelse för exempelvis prosodi och känslor skiljer neural TTS från traditionella modeller.
Så fungerar neural TTS: teknisk översikt
På ytan omvandlar neural TTS text till ljud och bevarar egenskaperna som bär betydelse: uttal, känslomässig avsikt, rytm, betoning och tonfall. Under ytan samarbetar en pipeline av modeller för att omvandla text till tal som låter mänskligt.
De exakta arkitekturerna varierar mellan olika leverantörer, men neural TTS har vanligtvis följande kärnsteg.
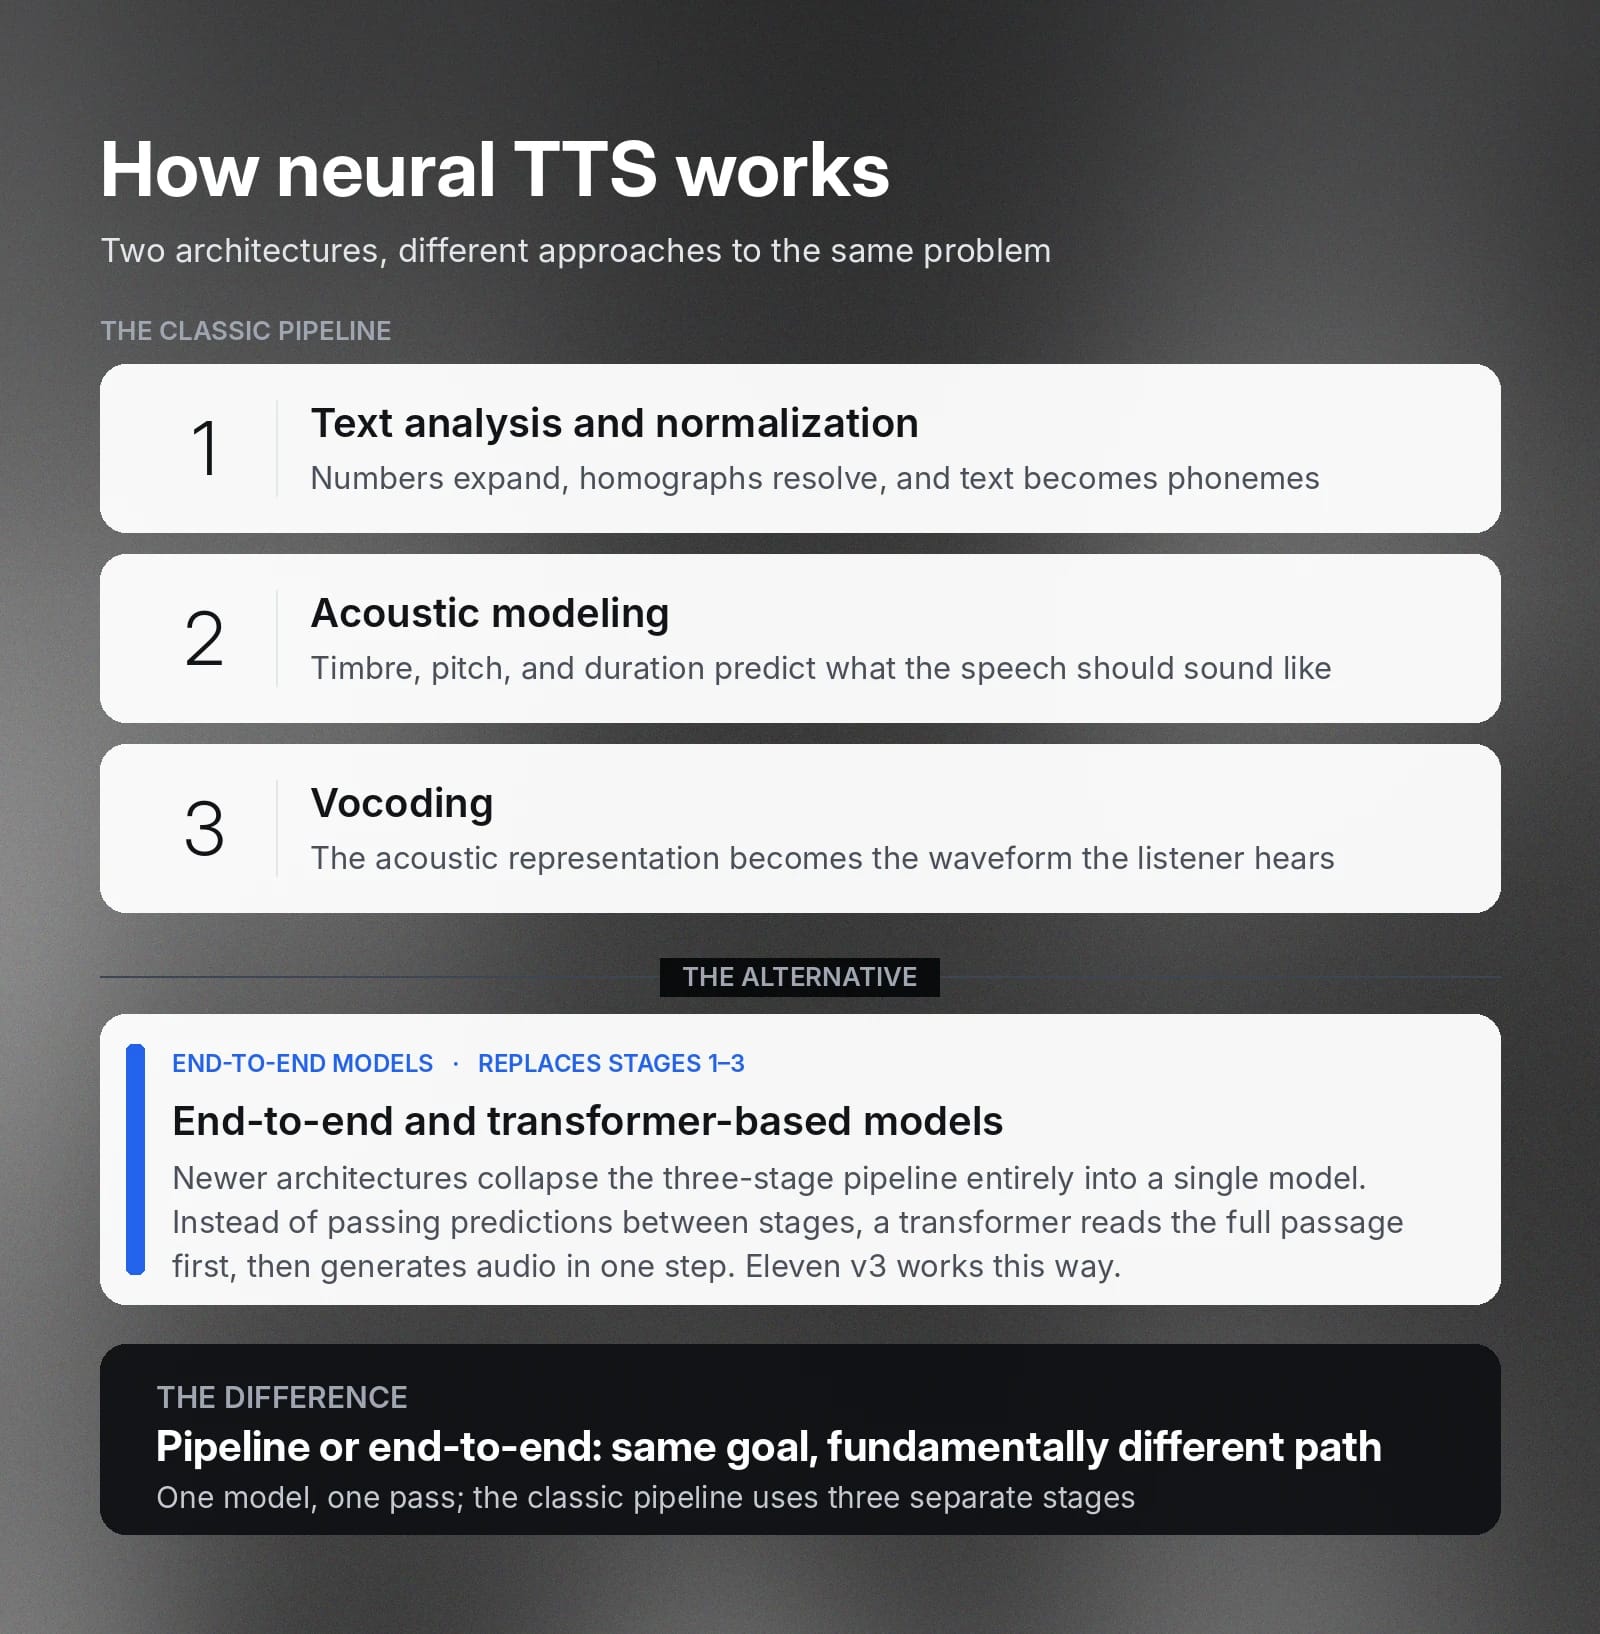
Textanalys
Skriven text är full av tvetydigheter. Det finns en välkänd exempelmening på engelska där betydelsen ändras beroende på vilket ord som betonas: ”I didn't say he stole the money.” Betona ”I”, så antyder du att någon annan sa det. Betona ”he”, så antyder du att någon annan stal det. Betona ”money”, så var det plötsligt något annat som stals.
Textanalysen löser den här tvetydigheten innan ljud genereras. Den utvecklar förkortningar och omvandlar vanliga textelement, som datum, siffror och symboler, till talade former. Homografer som ”read”, ”lead” och ”bass” identifieras och uttalas korrekt utifrån sammanhanget i den större meningen. Den förutser också prosodisk uppmärkning och identifierar vilka ord som väger tyngst. Den akustiska modellen återger uppmärkningen i nästa steg.
Den normaliserade texten omvandlas sedan till enskilda fonem i en process som kallas grafem-till-fonem-konvertering. Steget bidrar till att slutljudet blir stabilt och korrekt, även i språk som engelska med sina ökända opålitliga uttalsregler.
Vi har skrivit en fonemguide som förklarar det här lagret mer ingående.
Akustisk modellering
Den akustiska modellen är systemets neurala kärna. Den tar fonemsekvensen och förutser hur talet bör låta.
Det akustiska lagret har tre huvuddimensioner:
- Klangfärg: Den textur som gör en röst igenkännbar som en viss talare, ibland kallad en persons ”röstavtryck”.
- Tonhöjd: Tonkurvan genom en mening, inklusive intonationen i en fras samt uppgången i en fråga eller fallet i ett påstående.
- Varaktighet: Hur länge modellen håller varje fonem, vilket styr en menings tempo och förhindrar att ett ord som ”jump” blir ”jjjjump”.
Tillsammans avgör dessa en menings prosodi. Neural TTS använder dem för att skapa en mindre robotlik uppläsning. Genom att tränas på timmar av verkligt tal placerar modellen pauser och betoningar på ett sätt som liknar mänskligt tal. Det är kontextbaserad inlärning som hämtar mönster från träningsdata, i stället för från specifika regler som implementerats av utvecklare.
Arkitekturer som FastSpeech och Tacotron 2 är grundpelare i detta steg och är kända för sin förmåga att omvandla en fonemsekvens till ett melspektrogram. Ett melspektrogram är en karta över ljudets frekvenser över tid. Det beskriver tal, men är inte uppspelningsbart ljud, utan bara en digital representation av ljuden.
Vokodning
En vokoder är det sista nätverket i en klassisk pipeline. Den omvandlar den akustiska representationen vi gick igenom ovan till en faktisk vågform, vilket är det slutanvändaren hör.
Ett problem som branschen stötte på vid utveckling och användning av vokodrar var att de vanligtvis var alldeles för långsamma för riktiga produktionspipelines. Det var först med iterationer som HiFi-GAN, som förbättrade tidiga vokodrar som DeepMinds WaveNet, som hastigheten blev tillräcklig för verkliga produktionsscenarier.
Neural TTS i realtid blev möjlig först tack vare innovationer i denna del av pipelinen.
End-to-end- och transformerbaserade modeller
Traditionella TTS-modeller går igenom de tre stegen ovan för att skapa ljud från text. Nyare generationer slår ihop hela denna pipeline. En transformerbaserad modell, som använder samma arkitektur som stora språkmodeller, mappar text till ljud i en enda end-to-end-process i stället för att skicka förutsägelser mellan separata akustiska nätverk och vokodernätverk.
En pipelinemodell måste bearbeta en mening i taget, medan en transformer läser hela textstycket innan den med hjälp av det bredare sammanhanget avgör hur en rad ska låta. Samma mening kan läsas helt olika i en komedi och ett drama.
ElevenLabs modeller, som Eleven v3, anpassar sig till den nyansen och tar emot inline-ljudtaggar som [whispers] eller [nervous], så att användare får mer kontroll över hur deras manus låter.
Neural text to speech jämfört med traditionell TTS
Innan neurala nätverk blev populära använde TTS-system ett av två huvudsakliga tillvägagångssätt. Båda förekommer fortfarande i äldre IVR-menyer och skärmläsare.
Här är de två traditionella TTS-typerna:
- Konkatenativ TTS: En röstskådespelare spelades in när hen läste tusentals meningar, som sedan delades upp i små fragment. När tal skulle skapas fogades fragmenten samman. Enskilda ord kunde låta mänskliga, men skarvarna mellan fragmenten skapade en hackig och robotlik rytm som många fortfarande förknippar med datorgenererade röster.
- Parametrisk TTS: Genererade ljud från en statistisk modell av talparametrar i stället för inspelningar. Den var mindre och mer flexibel än konkatenativ syntes, men ljudet fick en dämpad, surrande kvalitet eftersom den förenklade modellen utelämnade de fina detaljerna i verkligt tal.
Neural TTS genererar däremot hela vågformen från en inlärd modell av tal och undanröjer båda dessa problem samtidigt.
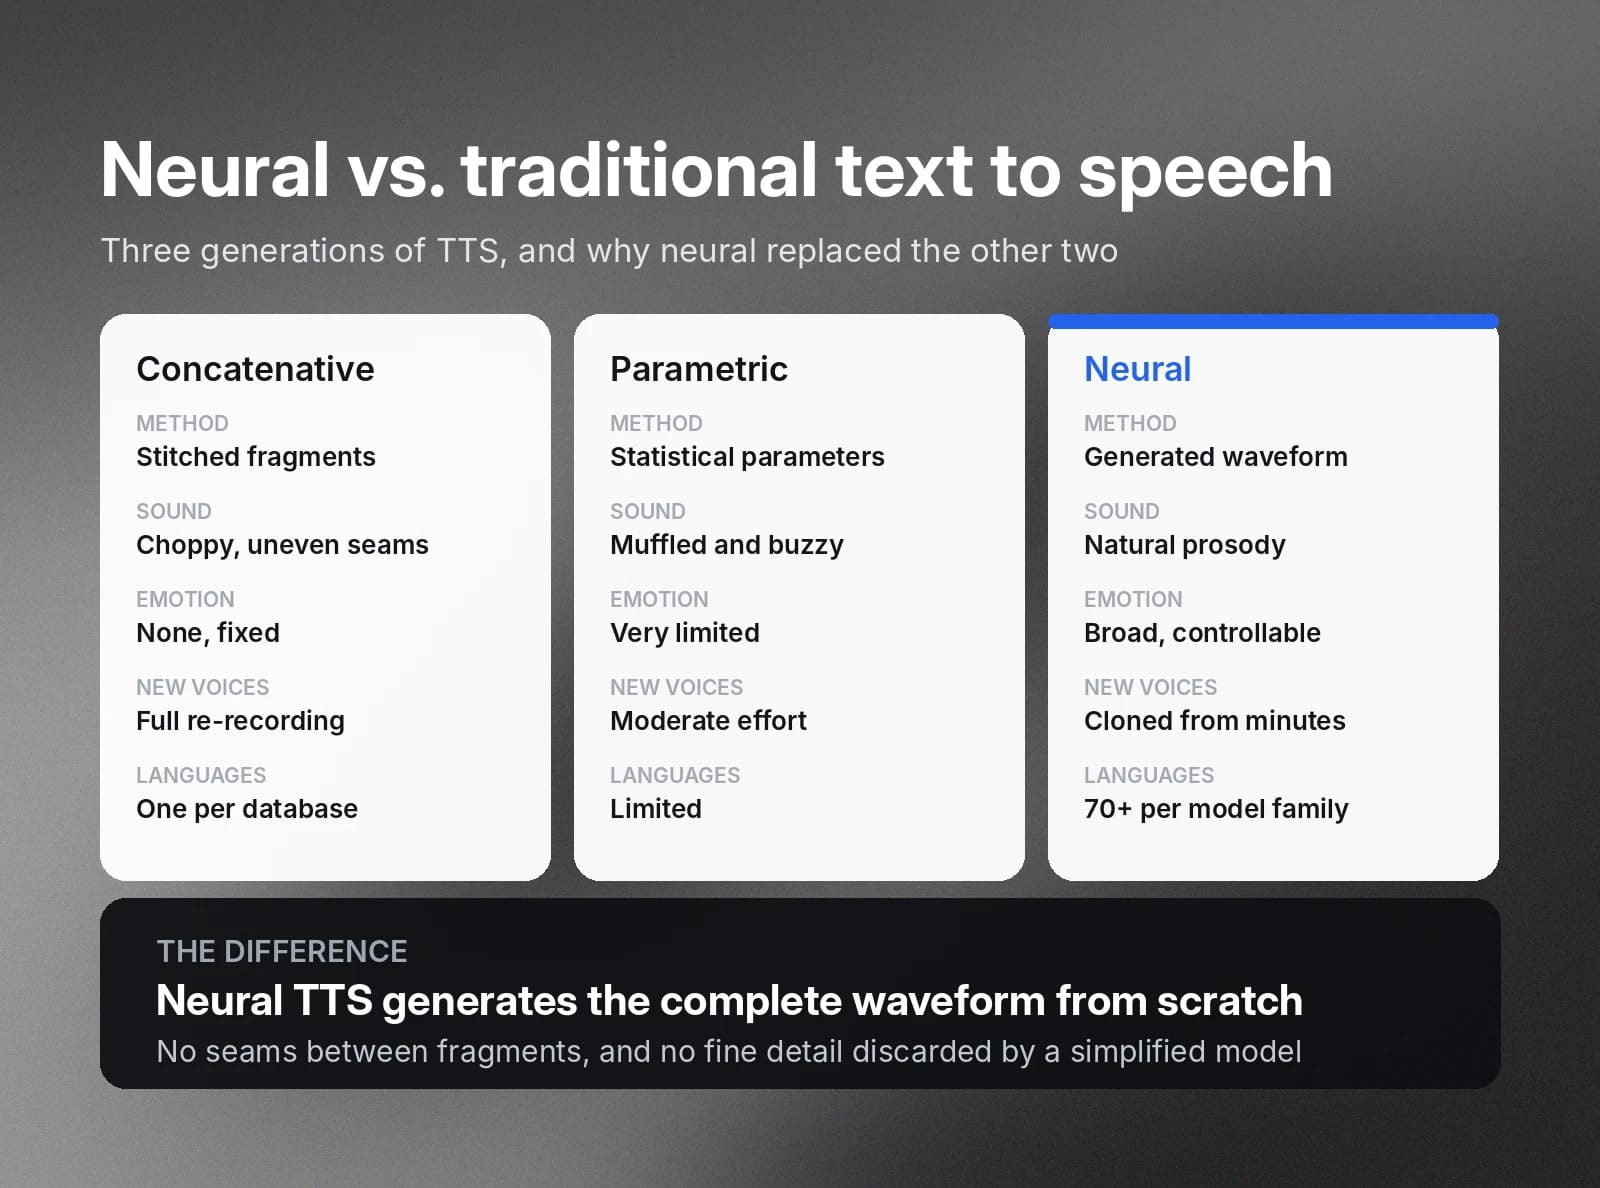
Så här står sig neural text to speech mot traditionell TTS på alla områden.
Viktiga funktioner och fördelar med neural TTS
Det mjuka, mänskligt klingande ljudet från neural TTS möjliggör många användningsområden, och det stora klivet i naturlighet öppnar nya möjligheter som inte var möjliga med traditionell TTS.
Här är några av de viktigaste funktionerna och fördelarna med neural text to speech:
- Naturlig prosodi: Röster placerar betoningar, pauser och intonation som en mänsklig talare skulle göra. Det håller lyssnare engagerade i långt innehåll i stället för att frustrera eller trötta ut dem.
- Känslomässiga uttryck: Moderna modeller kan skapa uttrycksfullt tal, från dramatiska monologer till lugna uppläsningar. Med Eleven v3 styr skribenter detta med ljudtaggar som skrivs direkt i manuset.
- Voice Cloning: En neural modell lär sig en viss talares klangfärg och stil från ett kort prov. Du kan använda Voice Cloning (Instant eller Professional) för att behålla en konsekvent röst i alla dina TTS-distributioner.
- Flerspråkig räckvidd: En neural modell kan tala dussintals språk, medan en röstklon behåller sin identitet i samtliga. Ett varumärke kan använda detta för att säkerställa att den valda rösten låter likadant i London som i Rom.
- Hastighet i realtid: En neural text to speech-modell kan syntetisera tal snabbare än det spelas upp, med streaminglatens som är tillräckligt låg för direkta samtal.
- Skalbarhet: När en neural TTS har tränats kan en röst enkelt läsa in miljontals ord, inklusive nya produktnamn och beskrivningar, vilket kraftigt sänker kostnaderna för studioupptagningar.
Neural text to speech förändrar i grunden hur TTS fungerar. Den förändringen skapar nya möjligheter för tillgänglighet, företag, räckvidd och känslomässiga uttryck.
De främsta användningsområdena för neurala TTS-lösningar
Genom att förändra den grundläggande arkitekturen i en text to speech-modell möjliggör förbättringarna i hastighet och leverans en rad nya användningsområden.
Här är några av de användningsområden där tekniken ger störst värde i dag.
Conversational AI och röstassistenter
Kundsupport-agenter, virtuella receptionister, telefonbaserade assistenter och AI SDR:er är alla beroende av röster som låter trovärdiga och svarar nästintill omedelbart.
Conversational AI är det mest krävande användningsområdet för neural TTS och kombinerar högsta möjliga kvalitetskrav med de strängaste latenskraven.
Ljudböcker och publicering
Neural berättarröst gör det ekonomiskt att producera ljudutgåvor av titlar från äldre kataloger som normalt aldrig skulle motivera kostnaderna för studioinspelning. Du kan skapa en komplett ljudbok på några timmar med neural Text to Speech.
ElevenCreative gör det så enkelt som möjligt, med Character Casting som automatiskt hittar de bästa rösterna för en karaktär och tilldelar dem karaktärens repliker genom hela manuset.
Spel och interaktiva medier
Dynamiska dialoger, procedurellt genererat innehåll och NPC-samtal är enorma projekt när de spelas in manuellt i en studio. Neural TTS låter studior skapa röster i stor skala och rätta misstag genom att redigera text i stället för att betala för fler studiotimmar.
Lokalisering och dubbning
Neural TTS i kombination med översättning för video- och ljudinnehåll till nya marknader, samtidigt som den ursprungliga talarens röstidentitet bevaras.
En kreatörs publik i Medellín hör samma igenkännbara röst som publiken i Boston, men på spanska.
Så integrerar du neural text to speech i din applikation
För utvecklare är neural TTS bara ett API-anrop bort.
Här är ett komplett exempel som omvandlar text till tal med ElevenAPI och Python SDK.
Samma endpoint finns via REST eller SDK:er för Python, JavaScript och andra språk. Det finns tre integrationsmönster som täcker de flesta applikationer:
- Batchsyntes: Skicka text och få en komplett ljudfil. Detta passar för förproducerat innehåll som artiklar, IVR-promptar, ljudböcker och videor.
- HTTP-streaming: Ljudsegment kommer in i takt med att de genereras, så uppspelningen börjar innan syntesen är klar. Använd detta för att läsa upp långa dokument eller skapa poddliknande innehåll på begäran.
- WebSocket-streaming: För konversationsbaserade agenter tar en beständig WebSocket-anslutning emot text stegvis, exempelvis tokens som strömmas från en LLM, och returnerar ljud med lägsta möjliga latens.
Produktions-integrationer behöver också logik för omförsök, tidsgränser för förfrågningar och rimlig felhantering. Läs vår guide om mönster för integrering av Text to Speech API för mer information.
Välja ett Text to Speech API: vad du bör tänka på
Text to Speech API:er kan verka likartade, men under ytan finns mängder av funktioner som kan göra ett bättre än ett annat för just ditt användningsområde.
Listan är inte fullständig, men här är vad du bör leta efter i ett TTS-API:
- Ljudkvalitet: Framför allt: om ljudet från ett neuralt TTS-API inte låter bra är leverantören inte rätt för dig. Genomför blinda lyssningstester, särskilt med längre berättarröst, eftersom det är där bristerna sannolikt märks.
- Latens: För pipelines eller applikationer med Conversational AI bör du titta på time to first byte. Regional infrastruktur spelar också roll. Vi kunde minska den globala API-latensen med upp till 40 % genom att dirigera trafik via datacenter närmare användarna.
- Streamingstöd: Kontrollera att både HTTP- och WebSocket-streaming finns och är dokumenterade. API:er som endast stödjer batchbearbetning utesluter helt användningsområden i realtid.
- Språk- och röststöd: Leta efter neurala text to speech-API:er med brett språkstöd, särskilt för de språk du regelbundet behöver i dina appar.
- Uttryckskontroll: Leta efter verktyg som låter dig styra hur neural TTS faktiskt låter. ElevenLabs ljudtaggar ger detaljerad kontroll över talet.
- Röstlikhet: Om du använder Voice Cloning bör du kontrollera hur väl modellen bevarar en klonad rösts framförande och prosodi i längre stycken. Manus med fler karaktärer kan försämras över tid, så att rösten börjar låta annorlunda än originalprovet.
- Licensiering och etik: Bekräfta att du får kommersiella rättigheter till resultatet och granska hur leverantören hanterar exempelvis röstsamtycke, datalagring och förebyggande av missbruk. Företagskunder bör fråga om SOC 2-efterlevnad och tredjepartscertifiering för AI-säkerhet, som AIUC-1 och ISO 42001.
- Dokumentation och utvecklarupplevelse: En timme med att gå igenom utvecklardokumentationen berättar allt du behöver veta om hur omfattande en produkt är. Välj dokumentation och råd från ingenjörer framför säljpitchar.
- Prismodell: Många API:er tar betalt per tecken eller kredit. Beräkna din månatliga volym och jämför nivåerna utifrån den, inte introduktionspriset.
Kom igång med ElevenAPI för neural TTS med hög kvalitet
ElevenAPI ger utvecklare direkt åtkomst till de neurala Text to Speech-modellerna bakom ElevenLabs, med fler än 70 språk och tusentals röster. Vi erbjuder HTTP-streaming och WebSocket-stöd samt låg latens som är byggd för samtal i realtid.
Utforska produktsidan för Text to Speech API för att höra modellerna, eller registrera dig och skapa en kostnadsfri API-nyckel för att komma igång.



