
Text to Speech API-integration: streaming, batchning, omförsök
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
Att integrera ett Text to Speech API är enkelt … efter några konkreta beslut: vilket överföringsläge du ska använda, hur du väljer modell och utdataformat, hur du streamar, hur du hanterar stora volymer utan att överskrida samtidighetsgränsen, hur du cachelagrar och försöker igen så att du aldrig betalar för att rendera samma ljud två gånger, samt hur du jämför tid till första byte med en annan leverantör.
För att hjälpa dig att integrera Text to Speech API har vi gått igenom vart och ett av de här arkitekturbesluten och vad du ska göra. Den här guiden hjälper dig att integrera ElevenLabs Text to Speech API och skala upp, med kodavsnitt som du kan klistra in i produktion för att komma igång.
För en mer utförlig genomgång av begreppen som nämns här, se våra guider om att förstå ljudstreaming, att optimera latens, och översikten över ElevenLabs modeller.
Sammanfattning
- Det finns en endpoint för ElevenLabs Text to Speech API som du kan använda på tre sätt: batchkonvertering, HTTP-streaming och stream-input-WebSocket.
- Över HTTP räknas varje pågående begäran mot din samtidighetsgräns, medan endast aktiv generering räknas över WebSocket.
- Begränsa parallelliteten till strax under gränsen för din plan och cachelagra en hash för varje parameter som påverkar resultatet, så att du aldrig debiteras för samma text två gånger.
- Försök igen vid 429 och 5xx med exponentiell backoff och full jitter, så att du minskar belastningen innan du når samtidighetsgränsen.
Tre sätt att integrera Text to Speech API
Det finns en Text to Speech-endpoint, men hur du integrerar den påverkar latens, komplexitet och kostnad.
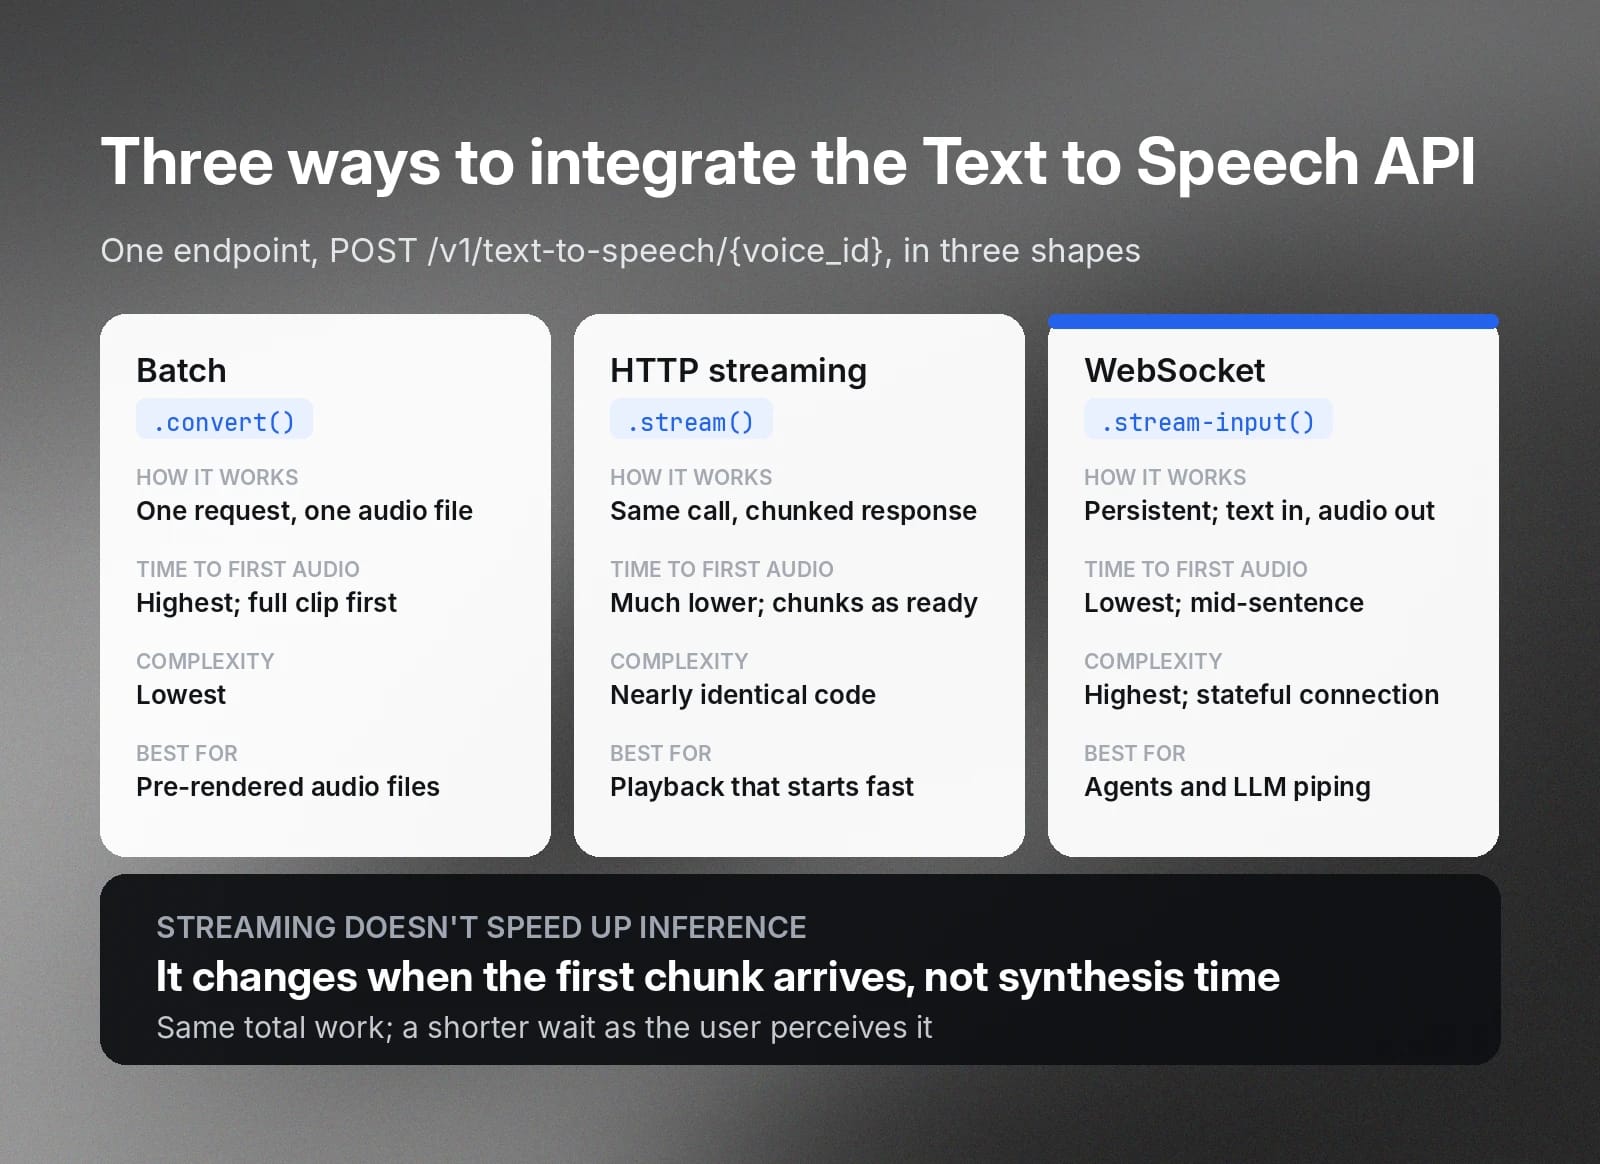
Samma anrop, POST /v1/text-to-speech/{voice_id}, fungerar på tre sätt, där varje sätt passar en något annorlunda uppgift. Här följer en genomgång av alla tre sätt att integrera Text to Speech API:
- Batch (convert) är den enklaste integrationen: Du skickar en begäran och får ett ljudsvar tillbaka. Det är alternativet med lägst komplexitet och högst tid till första ljud, eftersom hela klippet syntetiseras innan några byte returneras.
- HTTP-streaming (stream) använder samma begäran men delar upp svaret i delar: Du lägger till /stream i sökvägen, anropar stream-metoden och får ljudet som ett chunked-svar. Koden är nästan identisk, men den upplevda latensen är mycket lägre.
- WebSocket (stream-input) håller anslutningen öppen: Du skickar text stegvis och får ljudsegment tillbaka under tiden. Den är byggd för interaktiva agenter och för att mata ett LLM:s utdata till tal medan token genereras, innan meningen är klar.
Streaming gör inte att modellen genererar ljud snabbare; inferenstiden är oförändrad. Det streaming förändrar är när du får det första segmentet: det skickas innan hela klippet är klart, så användaren upplever en kortare väntan även om det totala arbetet är detsamma.
Beslutstabell: batch, streaming eller WebSocket
När du väljer mellan de här tre metoderna finns det flera faktorer att ta hänsyn till.
Som snabb guide: välj batch för offlinerendering, HTTP-streaming för känd text som en användare väntar på och WebSocket för agenter och livekonvertering från LLM till tal.
Tabellen nedan visar avvägningarna mellan de dimensioner som är viktiga i stor skala.
Över HTTP räknas varje pågående begäran, oavsett om du använder batch eller streaming, mot samtidighetsgränsen för din plan under hela dess varaktighet. Över WebSocket räknas bara tiden då modellen aktivt genererar ljud; en öppen men inaktiv socket kostar i stort sett ingenting.
För en kaskadkopplad röstagent som håller anslutningen öppen under ett helt samtal men bara genererar ljud under agentens turer är skillnaden stor. Det är den främsta anledningen att använda WebSockets när du bygger agenter. Hela protokollet dokumenteras i guiden för Text to Speech WebSocket i realtid.
Välja modell och utdataformat
Två val formar ljudet du får tillbaka från din TTS API-integration. Först modellen, som avgör kvalitet och hastighet. Sedan utdataformatet, som avgör container, bithastighet och samplingsfrekvens.
Om du gör rätt val från början faller allt längre fram i flödet, som latens och kompatibilitet med telefoni, på plats.
Modeller
Vi erbjuder flera Text to Speech-modeller. De är inte rankade från bäst till sämst; var och en innebär olika avvägningar.
Observera att siffran ~75 ms avser modellinferens under representativa förhållanden, exklusive nätverks- och applikationslatens. Den ökar med längre indata och under belastning. Mät alltid från din applikation, inte utifrån ett benchmarkvärde.
Flash-modeller är mindre och använder mer aggressiva approximationer för att minska inferenstiden. Eleven v4 och Multilingual v2 är större modeller som lägger mer tid per tecken på att ge ett mer innehållsrikt resultat.
För en realtids- eller agentlösning använder du eleven_flash_v2_5; det är alternativet med lägst latens för flera språk. För berättarröst, ljudböcker eller marknadsförings-voice-over använder du eleven_multilingual_v2 när du vill ha stabil hög kvalitet, eller eleven_v4 när du behöver maximal uttrycksfullhet och känslomässig bredd.
När uttalet är viktigt, till exempel för telefonnummer, datum eller valutor, bör du normalisera siffrorna själv i din applikation innan texten når API:et. Skriv ut den talade form du vill ha.
Genom att normalisera själv blir uttalet förutsägbart mellan modeller och du slipper förlita dig på modellspecifika standardvärden som kan ändras.
Utdataformat
Parametern output_format styr containern, samplingsfrekvensen och bithastigheten för ljudet du får tillbaka. De värden du kommer att använda mest är:
Röstinställningar
Följande inställningar styr hur det genererade talet levereras:
- Stabilitet: Styr konsekvens kontra uttrycksfullhet. Lägre värden ger mer varierat och uttrycksfullt tal, medan högre värden ger ett jämnare och mer förutsägbart framförande.
- Likhetsförstärkning: Styr hur nära resultatet följer referensrösten.
- Stil: Förstärker röstens naturliga talstil när värdet höjs.
- useSpeakerBoost: Gör likheten med den ursprungliga talaren tydligare, till en liten kostnad i latens.
- Hastighet: Justerar taltempot kring standardvärdet 1.0.
Av dessa inställningar har Stability vanligtvis störst påverkan på den upplevda kvaliteten. Lägre värden ger ett mer uttrycksfullt men mindre konsekvent resultat, medan högre värden prioriterar konsekvens och förutsägbarhet.
När du väljer röst är kombinationen med lägst latens Flash tillsammans med en Instant Voice Clone eller en standardröst. Professional Voice Clones låter utmärkt, men medför extra kostnad per generering som du bör ta med i beräkningen.
I hela den här guiden är exempelröstens id JBFqnCBsd6RMkjVDRZzb (George).
Streamingintegration (HTTP och WebSocket)
I det här avsnittet går vi igenom den praktiska kärnan i integrering av Text to Speech API. Vi tar upp hur du installerar SDK:n, öppnar en stream och hanterar ljudet när det kommer in. HTTP-spåret täcker uppspelning i de flesta webb- och appmiljöer, medan WebSocket-spåret täcker agenter och liveutdata från LLM.
Båda dessa metoder förutsätter att du har initialiserat ElevenLabs-klienten nedan.
Streamingalternativet öppnar en stream och hanterar segment när de kommer in. voiceId är det första positionella argumentet, följt av ett optionsobjekt med camelCase-nycklar (modelId, outputFormat, voiceSettings):
För WebSocket-varianten ansluter du till wss://api.elevenlabs.io/v1/text-to-speech/{voice_id}/stream-input, skickar ett första meddelande med dina röstinställningar och ett inledande mellanslag, skickar sedan textmeddelanden när de blir tillgängliga och läser tillbaka JSON-ramar vars audio-fält innehåller base64-kodade segment.
Batchning och samtidighetsgränser för hög genomströmning
Integration med hög genomströmning styrs av samtidighet, alltså antalet begäranden som genererar ljud i samma ögonblick. Varje plan har en gräns per modellfamilj.
Varje plan har en egen samtidighetsgräns:
- Gratis: 4 samtidiga Flash-begäranden.
- Starter: 6 samtidiga Flash-begäranden.
- Creator: 10 samtidiga Flash-begäranden.
- Pro: 20 samtidiga Flash-begäranden.
- Scale och Business: 30 samtidiga Flash-begäranden, med anpassade gränser för Enterprise.
Gränserna för Multilingual v2 är ungefär hälften av ovanstående.
En begränsad pool löser detta genom att sätta ett tak för hur många begäranden som körs samtidigt:
Sätt MAX_CONCURRENCY lite under gränsen för din plan i stället för exakt på den. Den marginalen absorberar annan trafik som delar samma nyckel och håller dig under tröskeln där ett 429-svar returneras.
Teckengränser och uppdelning av lång text
Varje modell har en gräns för hur många tecken den accepterar i en enskild begäran. Varje integration för långformat måste dela upp texten och sätta ihop ljudet igen.
Här är teckengränserna per begäran för varje modell:
- Flash v2.5: Accepterar upp till 40 000 tecken per begäran.
- Flash v2: Accepterar upp till 30 000 tecken per begäran.
- Multilingual v2: Accepterar upp till 10 000 tecken per begäran.
- Eleven v3: Accepterar upp till 5 000 tecken per begäran.
- Eleven v4: Accepterar upp till 10 000 tecken per begäran.
Allt längre måste delas upp i flera begäranden. Försök dela vid meningsgränser så att prosodin bevaras i övergången mellan segmenten.
Rendera segmenten i ordning och sammanfoga ljudet. För lång berättarröst där varje segment är oberoende sätts de två delarna ihop direkt: mata resultatet från splitText till den begränsade poolen ovan och låt den hantera resten.
Cachelagring och idempotens
Text to Speech-resultat är tillräckligt deterministiska för att det ska vara slöseri att rendera samma text igen med samma röst, modell och inställningar. Cachelagra resultatet med en hash av indata som påverkar ljudet som nyckel, så fungerar samma nyckel även som idempotenstoken vid nya försök.
Så här gör du båda delarna.
Regeln som får detta att fungera är att varje parameter som ändrar ljudet måste finnas med i nyckeln, inklusive outputFormat och röstinställningar. Om det görs rätt fungerar samma nyckel även som en idempotenstoken. När en klient försöker igen med en begäran som redan lyckades returnerar du de cachelagrade byten i stället för att generera på nytt.
Felhantering och hastighetsgränser (429)
En produktionsklient behöver återförsök med backoff och jitter, samt hantering som skiljer sig beroende på statuskod, eftersom vissa fel är värda att försöka igen efter medan andra inte är det.
Tabellen nedan kopplar varje status till rätt åtgärd, och avsnittet förklarar varför 429 är en mjuk gräns snarare än en hård vägg.
Ett 429 är inte en hård vägg, och det hjälper att förstå mekanismen. När du överskrider samtidighetsgränsen köas begäranden först efter prioritet, vilket vanligtvis lägger till cirka 50 ms. Du får bara ett 429 om du fortfarande ligger över kapaciteten efter det.
Svaret innehåller även headers för current-concurrent-requests och maximum-concurrent-requests som visar din aktuella marginal, så att du kan läsa dem och minska belastningen innan du når gränsen.
När du behöver mer marginal snarare än bättre återförsöksbeteende uppgraderar du din plan. Enterprise-kunder kan begära högre gränser via sin account manager.
Benchmarking av latens och tid till första byte
Latens beror på din region, dina indata och den aktuella belastningen, vilket innebär att det enda latensvärde du bör förlita dig på är ett du har mätt i din egen miljö.
Det här avsnittet ger dig tid till första byte (TTFB) för Flash-streamingendpointen och är utformat så att du kan använda samma testharness mot en annan leverantör och jämföra dem under identiska förhållanden.
Se detta som en metodik, inte ett publicerat resultat. En enskild körning är ingen garanti för någonting.
Här är några förbehåll som är viktiga när du benchmarkar latensen för en Text to Speech API-integration:
- Ta med nätverkets tur- och returtid: TTFB beror på var du befinner dig geografiskt och leverantörens närmaste kluster, så kör testet från den plats där dina servrar vanligtvis körs.
- Uteslut en uppvärmningskörning: Den första begäran till en kall anslutning är långsammare och kan snedvrida dina siffror.
- Håll indata konstanta: Indatalängd, röst, modell och belastning påverkar alla resultatet, så håll dem identiska mellan leverantörer.
- Rapportera en fördelning: Siffrorna varierar mellan körningar, så publicera medianen och p95 i stället för ett enda värde.
Med detta i åtanke är du redo att benchmarka.
För att jämföra med en annan leverantör skriver du en funktion med samma form. Kör sedan båda med ett litet skript som utesluter ett uppvärmningsanrop, tar cirka 20 tidsmätta prover med mellanrum så att de inte krockar med varandra, och rapporterar median och p95 i millisekunder.
En rättvis jämförelse handlar om att kontrollera variablerna.
Kör båda leverantörerna från samma maskin och nätverk, helst en server i den region där du faktiskt distribuerar, snarare än från en bärbar dator på ett vanligt hemnätverk. Använd samma indatatext och håll ljudet kort så att modellinferens dominerar siffran i stället för genereringslängden. Rapportera medianen och p95 över många körningar, eftersom en enda mätning är brus.
Tänk på att TTFB över det publika internet omfattar 20–200 ms nätverkstid tur och retur som inte har något med modellen att göra. Vi levererar från kluster i Nordamerika, Europa och Sydostasien och dirigerar till det närmaste, så placera testklienten därefter. Annars benchmarkar du mest avståndet till datacentret.
Viktigaste insikterna för din Text to Speech API-integration
En produktionsklar Text to Speech API-integration handlar om en handfull viktiga beslut.
Om du gör rätt här faller allt annat på plats:
- Välj modell efter uppgift: Använd Flash v2.5 för allt interaktivt och en modell med högre kvalitet, som Multilingual v2 eller Eleven v4 för offlinerendering där latens spelar mindre roll.
- Streama när en användare väntar: Använd HTTP-streaming för känd text och WebSocket för agenter, så att inaktiv tid inte räknas mot din samtidighetsbudget.
- Begränsa parallelliteten till din plans gräns: Sätt taket för samtidiga begäranden strax under gränsen för din plan och cachelagra utifrån en hash av varje parameter som påverkar resultatet, så att samma ljud aldrig debiteras två gånger.
- Försök igen vid 429 och 5xx med exponentiell backoff och full jitter: Minska belastningen vid 429 och 5xx med full jitter, och bevaka samtidighetsheaders för att se hur nära gränsen du är.
- Dela upp lång text vid meningsgränser: Dela vid meningsgränser inom varje modells teckengräns så att prosodin bevaras i övergången.
Om du vill gå ännu djupare kan du läsa guiden för streaming, konceptet ljudstreaming, autentisering, och engångstoken för användning på klientsidan.
Bygg din Text to Speech-integration med ElevenAPI
Efter att ha läst den här guiden har du alla mönster du behöver för en produktionsklar Text to Speech API-integration. Du är redo att omsätta streaming, batchning, cachelagring, återförsök och även benchmarking i praktiken.
Kom igång genom att läsa mer om Text to Speech API eller registrera dig för att göra ditt första anrop med ElevenAPI i dag.
Vanliga frågor om integrering av Text to Speech API

Tadas Petra är Developer Relations Engineer och hjälper utvecklare att bygga med ElevenLabs produkter. Han är också grundare av Hungrimind, en plattform för utvecklarutbildning. Tidigare var han Lead Developer Advocate på Agora och instruktör på Zero To Mastery.



