
Bygg en röstagent på 20 minuter med ElevenLabs och Twilio
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
En röstagent kan svara på inkommande telefonsamtal, transkribera den som ringer i realtid med tal till text (STT), skapa ett svar med en stor språkmodell (LLM) och svara muntligt med en text till tal-modul (TTS). Med ElevenLabs och Twilio kan du ha en fungerande agent på ett riktigt telefonnummer på ungefär 20 minuter.
För utvecklare består den fullständiga stacken av ElevenLabs för talsyntes (Flash v2.5) och transkribering (Scribe v2 Realtime), Twilio för telefoni samt OpenAI eller Anthropic som LLM. Alla dessa kan dock bytas ut, så du kan välja de komponenter du känner dig mest bekväm med i stället.
Den här artikeln visar hur du bygger en röstagent på 20 minuter med Node.js och Typescript. Om du vill ha ett hanterat alternativ som tar hand om turtagning, avbrott och telefoni utan att du själv underhåller kedjan, gå till ElevenAgents.
Så fungerar arkitekturen för röstagenter
Innan du skriver kod är det bra att förstå hur de tre tjänsterna i din teknikstack kopplas ihop.
- Twilio: Hanterar telefonsamtalet och ljudöverföringen.
- ElevenLabs: Hanterar STT via Scribe v2 Realtime och TTS via Flash v2.5.
- LLM: Hanterar verktygsanrop och skriver svaret.
Varje steg är en tunn adapter, vilket innebär att du kan byta ut en tjänst utan att röra resten. Du kan till exempel byta OpenAI-LLM:en mot Anthropic utan att behöva skriva om dina andra komponenter.
Ett telefonsamtal når din server via Twilio. Twilio besvarar PSTN-samtalet, öppnar en WebSocket tillbaka till din server och vidarebefordrar den uppringandes ljud som en ström av base64-kodade mu-law-ramar. Din server kör kedjan och strömmar syntetiserat ljud tillbaka via samma WebSocket, som Twilio spelar upp för den som ringer.
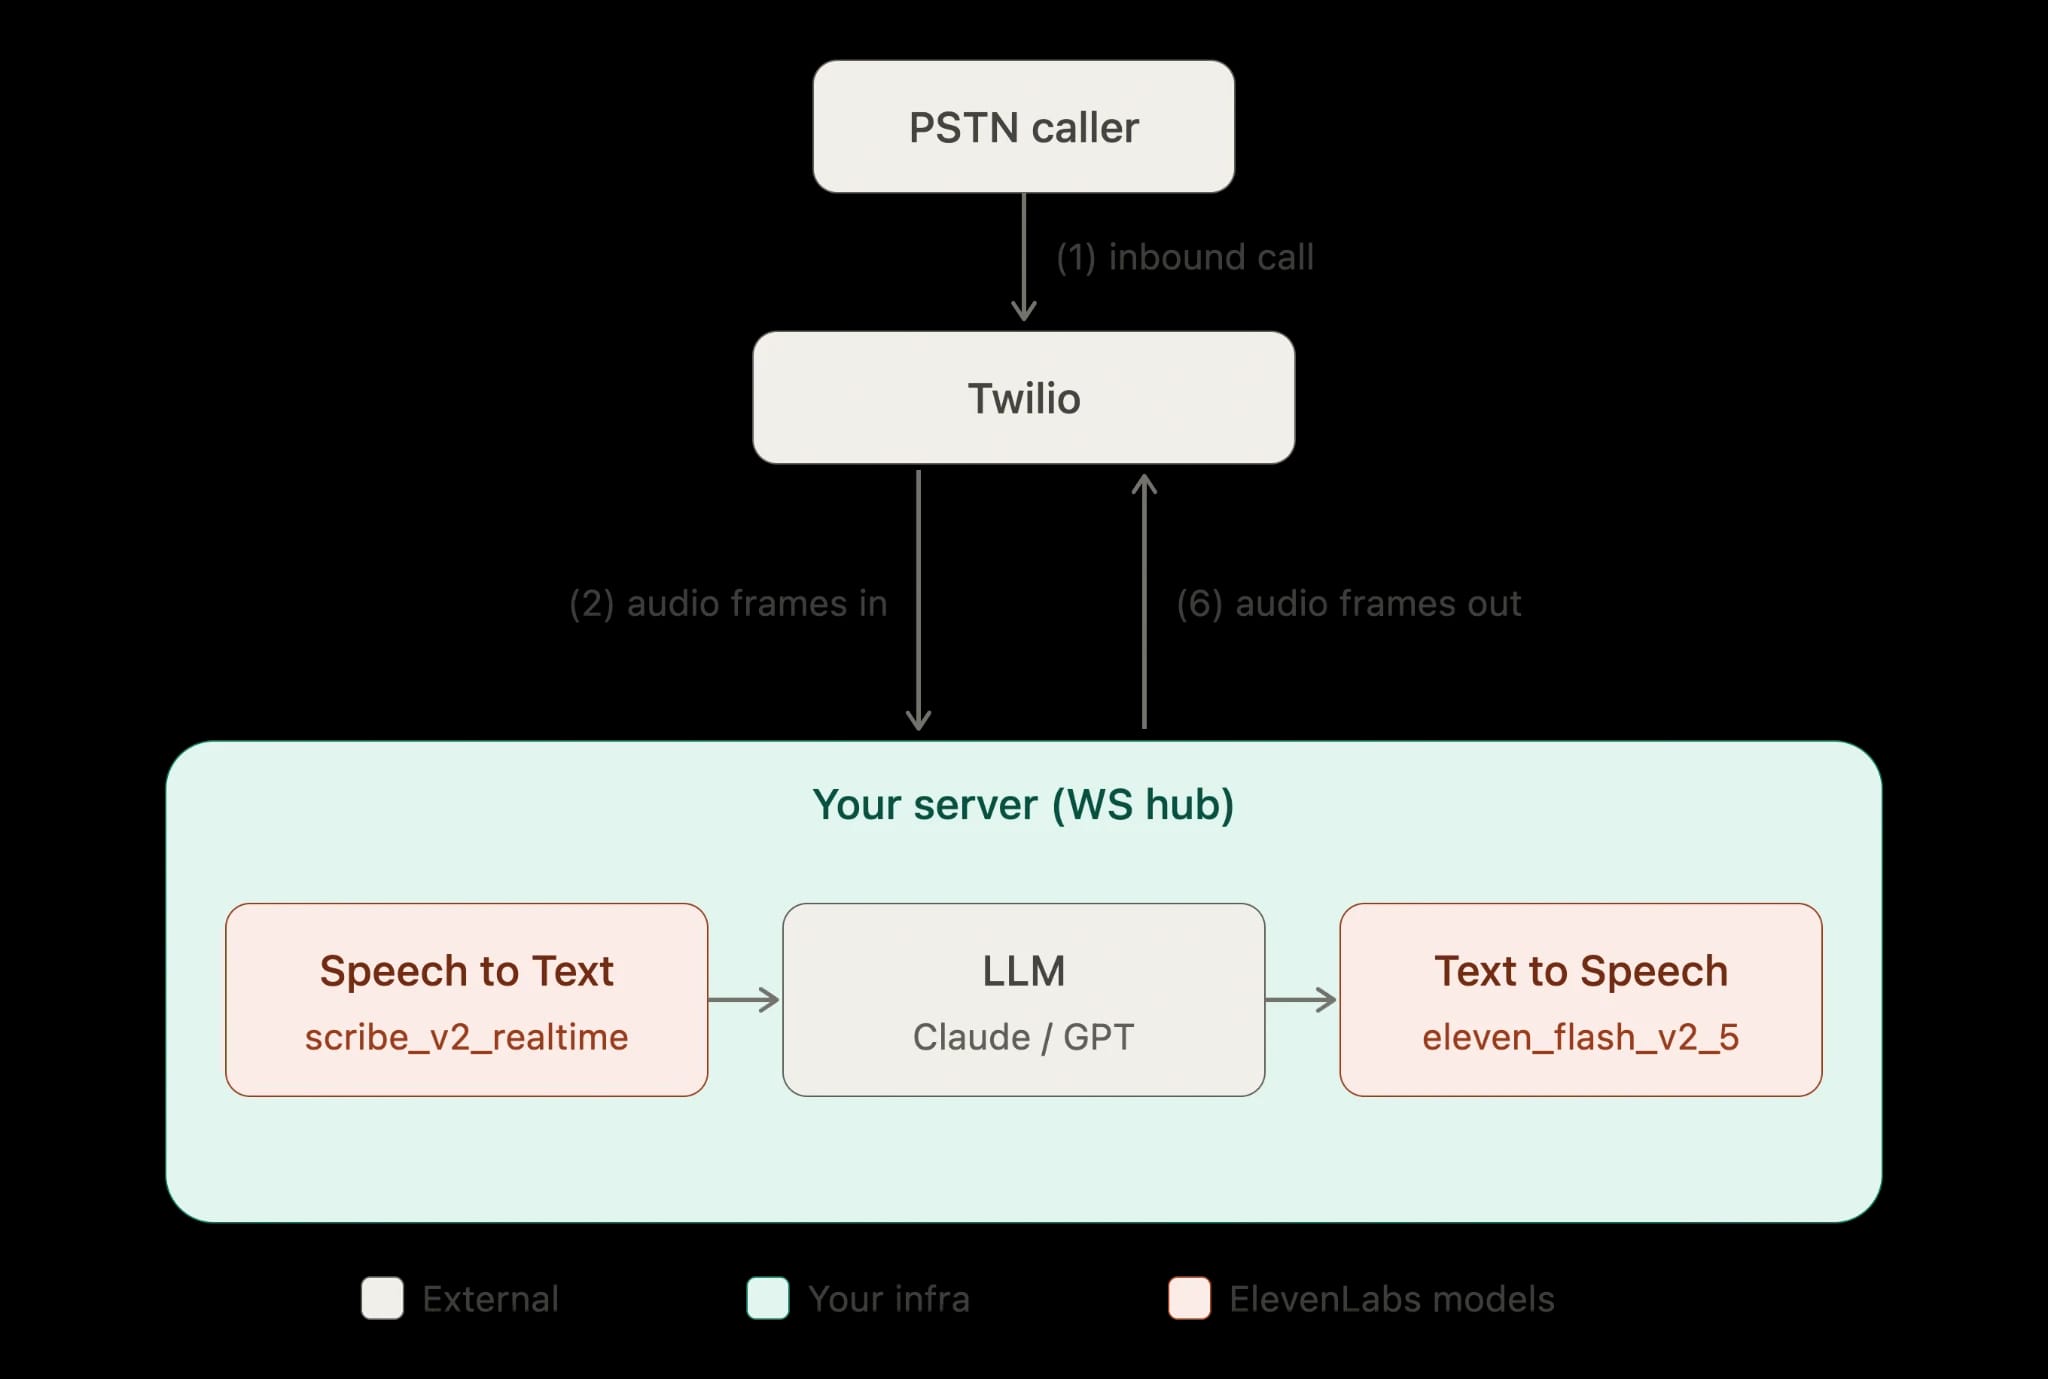
Här är flödet du använder för att bygga en röstagent:
En person ringer ditt Twilio-nummer. Twilio hämtar ett TwiML-dokument från din webhook. TwiML-dokumentet säger åt Twilio att öppna en Media Stream till din WebSocket-slutpunkt. Twilio strömmar inkommande ljud som JSON-händelser med base64-kodade mu-law-nyttolaster (ulaw_8000).
Din server vidarebefordrar ljudsegment till Scribe v2 Realtime för strömmande transkribering. När en samtalstur är klar skickar du transkriberingen till LLM:en och syntetiserar sedan svaret med Flash v2.5 i ulaw_8000. Du skickar tillbaka de syntetiserade mu-law-ramarna till Twilio via WebSocket, base64-kodade, och Twilio spelar upp dem för den som ringer.
Scribe v2 Realtime levererar partiella transkriberingar med ungefär 150 ms latens, och Flash v2.5 har cirka 75 ms modellinferens, exklusive nätverks- och programlatens. LLM:en är den största och minst förutsägbara faktorn för tiden till första ljudet, och det är där större delen av latensbudgeten går åt. För att hålla pausen kort strömmar vi LLM-utdata token för token och börjar syntetisera innan modellen har avslutat meningen.
Information om modellavvägningarna bakom dessa val finns i modellöversikten och genomgången om att förstå latens.
Det här behöver du innan du börjar bygga en röstagent
Guiden förutsätter att du har fyra saker på plats. Alla går snabbt att konfigurera, men om någon saknas kan servern inte köras.
Här är förutsättningarna att kontrollera:
- Ett Twilio-telefonnummer med Voice-funktion: Anteckna numret samt ditt Account SID och Auth Token från Twilio-konsolen.
- ElevenLabs API-nyckel: Skapa den i din ElevenLabs-panel. Nyckeln skickas i xi-api-key-headern och är hemlig, så förvara den endast på serversidan. Se API-autentisering.
- LLM API-nyckel: I den här guiden behandlas Anthropic Claude och OpenAI som utbytbara backends, så välj en av dem.
- Ngrok (eller annan tunnel) för lokal utveckling: Twilio måste kunna nå din server via en offentlig HTTPS- och WSS-URL, och ngrok tillhandahåller det utan att du behöver driftsätta något.
Ange dina hemligheter som miljövariabler och checka aldrig in dem.
Starta sedan en tunnel som pekar på porten servern ska använda:
Förstå Twilio Media Streams-protokollet
Twilio ger dig inte ett rått ljuduttag. I stället omsluter tjänsten allt i ett strukturerat JSON-protokoll via WebSocket. Om du förstår de fyra händelsetyperna och sändformatet blir WebSocket-hanteraren i steg 2 helt tydlig innan du skriver den.
När Twilio ansluter till din WebSocket skickas en följd av JSON-textmeddelanden, som kan ha fyra händelsetyper.
Händelsen connected kommer först och bekräftar att WebSocket-anslutningen är aktiv. Händelsen start skickas en gång när medieströmmen börjar. Den innehåller ett streamSid som du måste spara för att kunna skicka tillbaka ljud, och inkluderar även samtalsmetadata under start.customParameters och start.callSid.
Händelsen media återkommer: media.payload är ett base64-kodat segment med 8 kHz mu-law-ljud, 20 ms per ram, och media.track är inbound för ljud från den som ringer. Slutligen skickas stop när strömmen avslutas, vanligtvis för att samtalet lades på.
För att spela upp ljud skickar du ett meddelande av typen media med samma streamSid och en base64-kodad mu-law-nyttolast. För att avbryta ljud som redan har köats skickar du ett clear-meddelande med streamSid, vilket tömmer Twilios utgående buffert.
Kodningen för inkommande och utgående ljud är identisk (ulaw_8000). Vi begär ulaw_8000 från ElevenLabs Text to Speech och vidarebefordrar byte direkt till Twilio utan omsampling däremellan.
Steg 1: Hantera TwiML-webhooken
När ett samtal kommer in skickar Twilio en HTTP-begäran till din webhook, och du svarar med TwiML som ansluter samtalet till din Media Stream. Verbet <Connect><Stream> öppnar en dubbelriktad WebSocket. Använd <Connect> i stället för <Start> här: det håller samtalet aktivt under hela strömmen och låter dig skicka tillbaka ljud, vilket är syftet med den här konfigurationen.
TwiML som webhooken returnerar är:
I Express är det en enda POST-hanterare som fyller i värden och returnerar dokumentet:
I Twilio-konsolen ställer du in numrets webhook för ”A call comes in” till https://your-subdomain.ngrok.app/incoming-call med HTTP POST.
Steg 2: Acceptera Media Stream-WebSocketen
WebSocket-hanteraren läser Twilio-händelser, driver kedjan och skickar tillbaka ljud.
Vi lagrar en liten mängd tillstånd per samtal: streamSid, en STT-anslutning och en flagga för om agenten talar just nu. Hanteraren avkodar varje inkommande medieram från base64 och vidarebefordrar de råa mu-law-byten till STT:
Steg 3: Transkribera med Scribe v2 Realtime
Scribe v2 Realtime tar emot strömmande ljudsegment och returnerar partiella och slutgiltiga transkriberingar. Tjänsten har direkt stöd för mu-law-kodning, så vi skickar Twilios ramar oförändrade.
Den erbjuder även Voice Activity Detection för segmentering baserad på tystnad och manuell commit-kontroll för att avsluta ett segment. För en telefonagent är VAD-styrd segmentering vanligtvis rätt val, eftersom en naturlig paus är den mest tillförlitliga signalen på att en samtalstur har avslutats.
Så här gör du: Öppna en STT-ström när samtalet börjar. Skicka varje inkommande mu-law-segment. Reagera på slutförda transkriberingar genom att anropa LLM:en.
Klientgränssnittet för STT i realtid utvecklas fortfarande, så strukturen nedan ligger bakom en liten TypeScript-adapter (openRealtimeStt) som du implementerar mot det aktuella API:et i stället för en fast uppsättning fältnamn. Se onFinal som hooken som lämnar över en slutförd samtalstur till nästa steg.
Latensen för igenkänning i realtid är ungefär 150 ms för partiella resultat, vilket håller den upplevda pausen mellan att den som ringer avslutar och agenten börjar kort. Information om batchmotsvarigheten och hela funktionsuppsättningen finns i dokumentationen för Speech to Text och produktsidan för Speech to Text i realtid.
Steg 4: Skapa ett svar med en LLM
Det här är steget som skapar svaret. LLM:en tar konversationshistoriken och returnerar assistentens text. Strömma svaret så att du kan börja syntetisera vid första meningen.
Här används OpenAI som backend:
Modell-ID:t ovan, gpt-4.1-mini, är ett exempel på ett alternativ med låg latens. claude-haiku-4-5 är ett jämförbart alternativ från Anthropic. Båda leverantörerna kan användas med samma llmReply-kontrakt: byt ut funktionskroppen, så förblir resten av agenten oförändrad.
Systemprompten begränsar svarslängden, vilket är viktigt i telefon: långa svar känns långsamma och är svåra att avbryta på ett naturligt sätt.
Steg 5: Syntetisera med Flash TTS i ulaw_8000
Texten måste nu bli ljud som Twilio kan spela upp. Begär Flash v2.5 med outputFormat: "ulaw_8000" så att byten matchar Twilios förväntade kodning, strömma sedan ljudet och vidarebefordra varje segment via WebSocketen som en media-händelse.
Samla LLM-token i fragment i meningsstorlek och syntetisera varje fragment så fort det är klart, i stället för att vänta på hela svaret. Det förkortar tiden till första ljudet eftersom den som ringer hör första meningen medan modellen fortfarande skapar den andra. För mer detaljerad kontroll över inkrementell syntes visar guiden för TTS WebSocket i realtid hur du matar in text i en enda öppen syntessocket. HTTP-strömningsmetoden nedan är enklare och räcker för korta samtalsturer.
Gör din AI-röstagent redo för produktion
Efter de fem stegen ovan har du en fungerande agent. Det är inte samma sak som en produktionsdriftsättning.
Det finns flera saker du behöver tänka på innan du ansluter agenten till en riktig telefonlinje.
Validera Twilio-webhooksignaturer
Alla som känner till din webhook-URL kan skicka POST-begäranden till den, så första steget är att bekräfta att begäran verkligen kommer från Twilio. Twilio signerar varje begäran med din Auth Token i headern X-Twilio-Signature, och du avvisar allt som inte klarar valideringen. Signaturen beräknas utifrån hela URL:en och POST-parametrarna, så du måste beräkna den på samma sätt som Twilio.
Twilios hjälpfunktion gör det åt dig:
Hantera hemligheter på rätt sätt
Förvara ELEVENLABS_API_KEY, LLM-nyckeln och TWILIO_AUTH_TOKEN i en hemlighetshanterare, inte i källkoden eller okrypterade env-filer som checkas in i ett repo. Begränsa ElevenLabs-nyckeln till enbart de slutpunkter tjänsten behöver och ge den en kreditkvot, så att en läcka får begränsad påverkan i stället för obegränsad.
Enterprise-planer kan dessutom begränsa en nyckel till specifika IP-intervall med IP-vitlistning. Den här servern använder API-nyckeln direkt eftersom den aldrig lämnar din backend. Om någon ljudlogik flyttas till en webbläsare eller mobilklient bör du byta till engångstoken, så att nyckeln aldrig exponeras på klientsidan.
Förstå samtidighetsgränsen
Varje plan har en samtidighetsgräns som skiljer sig mellan modellfamiljer. Gränsen räknar hur många begäranden som aktivt genererar ljud samtidigt.
För en telefonagent fungerar den beräkningen till din fördel. Ljudgenereringen går snabbare än uppspelningen, så varje samtal använder bara TTS-samtidighet under de korta perioder då ett svar syntetiseras, inte under hela samtalet. Som en grov tumregel kan en samtidighetsgräns på omkring fem stödja cirka 100 samtidiga samtal, eftersom genereringen avslutas långt före uppspelningen.
Övervaka ändå kapacitetsmarginalen i stället för att gissa. ElevenLabs svar exponerar headerarna current-concurrent-requests och maximum-concurrent-requests. Logga dem och skapa varningar när du närmar dig maxvärdet. När du överskrider gränsen köas begäranden efter prioritet, vilket vanligtvis lägger till cirka 50 ms, och ihållande överbelastning returnerar HTTP 429.
Hantera HTTP 429-svar med en kort backoff. Om de fortsätter höjer du gränserna genom att uppgradera på prissidan eller, för Enterprise-kunder, via din kontoansvariga.
Hantera avbrott och överlappande tal
En person som börjar prata medan agenten talar förväntar sig att agenten ska sluta. Det kallas barge-in, och att hantera det korrekt är en stor del av det som får en agent att kännas naturlig snarare än skriptad.
Identifiera tal från den som ringer under agentens uppspelning med STT:ns VAD-signal. När du upptäcker det gör du två saker. Först slutar du vidarebefordra TTS-segment, vilket flaggan agentSpeaking i speak redan hanterar genom att avbryta loopen. Sedan skickar du ett clear-meddelande till Twilio för att tömma ljudet som redan har köats där.
Om du hoppar över clear fortsätter Twilio att spela buffrat ljud efter att du slutat skicka, så agenten verkar prata över den som ringer.
Logga, övervaka och hantera fel smidigt
Instrumentera varje steg så att du kan härleda latens när ett samtal känns långsamt. Mät tiden från slutgiltig transkribering till första LLM-token, från första LLM-token till första TTS-byte och från första TTS-byte till ramen som skickas till Twilio. Du kommer att se att merparten av den varierande latensen finns i LLM-steget. STT- och TTS-stegen är jämförelsevis stabila.
Planera sedan för partiella fel. LLM:en kan få timeout, STT-strömmen kan brytas och nätverksrundresan till ElevenLabs varierar från ungefär 20 till 200 ms över det offentliga internet beroende på geografiskt läge. Placera servern nära dem som ringer, inte bara nära ElevenLabs, eftersom ElevenLabs redan dirigerar till det närmaste av sina kluster i Nordamerika, Europa och Sydostasien.
När ett steg misslyckas ska du inte lämna den som ringer i tystnad: syntetisera en kort reservreplik (”Förlåt, kan du säga det igen?”) och håll samtalet aktivt. Omslut varje steg med timeout och try/catch så att en misslyckad samtalstur inte stänger hela WebSocketen.
Några fler standardinställningar är värda att göra innan du lanserar:
- Begränsa svarslängden i systemprompten, som visat, så att turerna förblir korta och kan avbrytas.
- Begränsa konversationshistoriken så att långa samtal inte låter LLM-kontexten växa utan gräns.
- Ange en maximal samtalslängd som skydd mot fastnade sessioner som i det tysta förbrukar samtidighet.
För att fortsätta finjustera de delar du styr över förklarar latensdokumentet var tiden till första ljudet kommer från, modellöversikten beskriver avvägningarna mellan hastighet och kvalitet, och guiden för TTS WebSocket i realtid visar hur du kan sänka synteslatensen med inkrementell textinmatning.
Bygg produktionsklara röstagenter med ElevenAPI
Nu när 20 minuter har gått har du alla lager som krävs för en produktionsklar röstagent. Twilio hanterar telefoni, Scribe v2 Realtime transkriberar, en LLM skapar svar och Flash v2.5 svarar muntligt via samma WebSocket.
Om du hellre slipper underhålla kedjan själv erbjuder ElevenAgents turtagning, avbrottshantering och telefoniintegration som en hanterad tjänst byggd på samma modeller som du precis kopplade samman för hand.
För att fortsätta finjustera en stack du styr över kan du utforska produktsidan för ElevenAPI med information om planer, samtidighetsgränser och röstbiblioteket. Du kan också registrera dig och komma igång redan i dag med ditt första samtal.
Vanliga frågor om att bygga en röstagent med Twilio och ElevenLabs

Tadas Petra är Developer Relations Engineer och hjälper utvecklare att bygga med ElevenLabs produkter. Han är också grundare av Hungrimind, en plattform för utvecklarutbildning. Tidigare var han Lead Developer Advocate på Agora och instruktör på Zero To Mastery.




