
Ramverk för utvärdering av voice agents: 6 pelare förklarade
- Skriven av
- Jack Limebear
- Publicerad
- Senast uppdaterad
Röstagenter måste samordna en symfoni av nästan samtidiga verktyg. Det är en finstämd balans mellan att spela in kundens kommentarer med tal-till-text i realtid tal till text (STT), ta in sammanhang och skapa ett svar med en stor språkmodell (LLM), och sedan generera en ljudfil med text till tal-programvara (TTS).
Med så många rörliga delar, hur utvärderar du en röstagents prestanda korrekt?
I den här artikeln presenterar vi ett ramverk med sex delar för utvärdering av röstagenter, som beskriver exakt vad du ska mäta när du bedömer agentens framgång. Vi berör också varför olika branscher bör väga dessa delar olika och vanliga misstag att undvika vid utvärdering.
Sammanfattning
- De sex viktigaste områdena för utvärdering av röstagenter är TTS-röstkvalitet, samtalskvalitet, verktygsanvändning och uppgiftsutförande, intelligens, efterlevnad och säkerhet samt tillförlitlighet.
- De viktigaste produktionsmålen är ett MOS på 4,3, en TSR över 85 % och en tid till första ljud under 500 ms.
- Olika branscher väger varje område på olika sätt, och vissa driftsättningar prioriterar ett framför de andra.
- Vanliga testmisstag är att bara utvärdera rent ljud och att ignorera toppar i P99-latens.
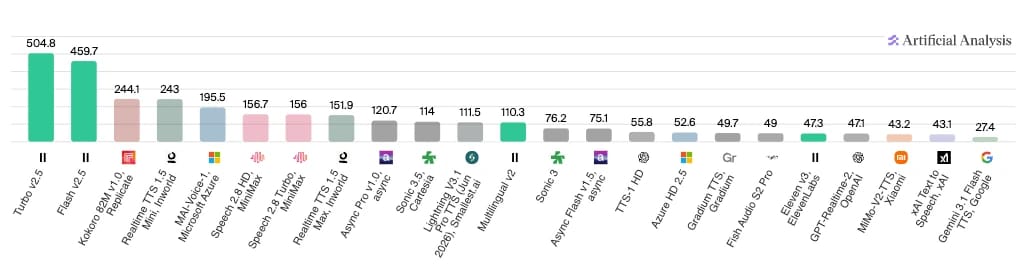
- ElevenLabs leder inom de viktigaste måtten: Scribe v2 uppnår marknadens lägsta WER på 2,2 % (Artificial Analysis, juni 2026), Flash v2.5 och Turbo v2.5 är toppmodeller för hastighet (Artificial Analysis, juni 2026), och ElevenAgents ger cirka 75 ms latens för modellinferens.
Vad är ett ramverk för utvärdering av röstagenter?
Ett ramverk för utvärdering av AI-röstagenter är ett strukturerat system som låter dig testa prestanda ur flera perspektiv. Ett heltäckande ramverk innehåller mått för att bedöma allt från ljudåtergivning till samtalsflöde och regelefterlevnad.
Till skillnad från en textchattbot skickar en röstagent varje interaktion genom minst tre sammankopplade tekniker: automatisk taligenkänning (ASR), som omvandlar användarens ord till text; en LLM som sätter ihop ett svar; och ett TTS-system som omvandlar svaret tillbaka till ljud. Om ett av systemen fallerar försämras hela upplevelsen.
Den här komplexiteten är precis varför företag behöver utvärdera röstagenter innan de väljer leverantör och driftsätter. Extra latens eller oprecisa svar kan få verkliga följder, såsom kunder som lämnar eller, i värsta fall, tillsynsböter och skadat anseende.
Ett ramverk för att utvärdera röstagenter använder benchmarking och mätbara data för att avgöra om en agent passar för vissa användningsområden. Ur ett affärsperspektiv gör möjligheten att utvärdera olika röstmodeller att du kan välja den bästa för dina kunder.
De sex områden för utvärdering av röstagenter som du bör bedöma
Även om att skapa och driftsätta en AI-agent aldrig har varit enklare, är de aktiva processerna bakom kulisserna ganska komplexa. Flera komponenter arbetar tillsammans för att lyssna på användaren, förstå vad personen vill, mata informationen till en LLM och sedan skapa ett ljudsvar, vilket innebär många nästan samtidiga åtgärder.
Företag som vill samarbeta med bästa möjliga röstagent behöver ett rigoröst ramverk att jämföra med.
Om du hellre vill se testresultat erbjuder Artificial Analysis flera agentjämförelser baserade på olika komponenter. Nedan ser du resultatet av deras jämförelse av modellhastighet, där ElevenLabs Turbo v2.5 och Flash v2.5 leder med stor marginal i antal bearbetade tecken per sekund.
För utvecklare eller företag som vill genomföra egna experiment är detta de sex delar av ett ramverk för bedömning av AI-agenter som du bör använda:
- TTS-röstkvalitet: Hur naturligt, tydligt och uttrycksfullt det syntetiserade talet låter för slutanvändare. Ledande modeller, som Eleven v4, ger mänskligt och känslofullt tal på fler än 70 språk.
- Samtalskvalitet: Förstår modellen mänskligt tal, tolkar betydelsen och svarar snabbt i rätt sammanhang under flera turer?
- Verktygsanvändning: I vilken utsträckning en AI-agent slutför uppgifter med tillgängliga resurser utan mänsklig hjälp.
- Intelligens: Hur väl en modell resonerar, hanterar nya indata och undviker felaktiga eller hallucinerade svar.
- Efterlevnad och säkerhet: Utöver alla funktioner måste AI-röstagenter följa alla lagkrav och krav på regelefterlevnad, inklusive aktiva skyddsräcken.
- Tillförlitlighet: Komponenter som total tillgänglighet och jämn prestanda under belastning avgör om en Conversational AI-agent kan skalas efter efterfrågan.
Även om varje område är självständigt samverkar de för att ge användaren en slutupplevelse av hög kvalitet. Om en modell till exempel förbättrar röstkvaliteten men fortfarande har hög latens får kunden besvärliga väntetider innan modellen börjar tala.
Låt oss utforska vart och ett av dessa områden för utvärdering av röst-AI mer ingående.
TTS-röstkvalitet
Vi börjar med röstkvalitet, eftersom det sannolikt är det första en människa lägger märke till vid interaktion med en AI-agent för samtal. Om rösten låter robotaktig eller kuslig blir den subjektiva upplevelsen av agenten betydligt sämre.
Ett av de ursprungliga bedömningsmåtten, enligt International Telecommunication Union Telecommunication Standard Sector (ITU-T), är Mean Opinion Score (MOS). MOS använder en skala från 1 till 5, där 1 är oanvändbart och 5 är utmärkt. Som subjektivt mått bygger det på mänskliga lyssnare och insamlad återkoppling efter ett samtal.
Allt under MOS 3,5 på denna skala är ganska svagt, särskilt med dagens mått, och påverkar sannolikt kundnöjdheten.
MOS är ett människocentrerat mått, men flera tekniska krav bidrar till resultatet:
- Konsekvent tonhöjd och jitter: Tonhöjd och jitter är två språkliga element som människor naturligt uppfattar när de lyssnar. ”Tonhöjd” syftar på varierande intonation i talet, som när du naturligt höjer rösten när du ställer en fråga. Jitter uppstår när en röstmodells tolkning av tonhöjd varierar, så att den inte kan bibehålla sammanhängande prosodi genom en mening. Branschens riktvärde för jitter är 30 ms.
- Känslomässig uttrycksfullhet: En röst som är tydlig och exakt låter ändå fel om tonen inte matchar den avsedda känslomässiga laddningen i en mening. Utan korrekta tonala signaler får mänskliga lyssnare sämre kontakt med AI-agenter för samtal och betygsätter dem lägre. ElevenAgents erbjuder uttrycksfullhet nära mänsklig nivå så att varje svar matchas med en tydlig känslomässig avsikt.
- Bakgrundsljud: Bakgrundsljud i röstagenter har två tydliga dimensioner värda att utvärdera. På utgångssidan läggs diskret omgivningsljud till i svar för att få agenter att låta mer naturliga. På ingångssidan är filtrering av bakgrundsljud i STT-lagret en valfri inställning som förbättrar noggrannheten. Testa båda när du utvärderar en agent: lyssna efter om omgivningsljudet låter naturligt och bedöm STT-noggrannheten med brusfiltret på respektive av.
När du beräknar MOS bör du sikta på 4,3–4,5, vilket visar höga resultat i alla dessa perceptuella kategorier. För MOS-prognoser i stor skala utan mänskliga paneler kan du använda verktyg som UTMOS och NISQA.
Samtalskvalitet
Samtalskvalitet är ett sammansatt område mellan röstkvalitet och uppgiftsutförande. Det mäter hur effektivt en röstagent förstår användarens behov, avbryter i rätt sammanhang och följer detta genom en dialog med flera turer till ett avslut.
Det primära måttet här är noggrannhet i avsiktsklassificering, där det typiska resultatet ligger mellan 85 % och 92 % och de bästa når över 96 %. Även om 85 % kan verka högt innebär det fortfarande att 15 % av all inkommande trafik felklassificeras och skickas till fel resurser.
De tekniska faktorer som bidrar till hög noggrannhet i avsiktsklassificering är:
- Turtagning: Turtagning avgör hur väl en röstagent hanterar samtalets naturliga flöde. Den bedömer när agenten ska lyssna, svara eller vänta på mer indata. Det omfattar också hantering av avbrott, där modellen rensar ett pågående svar och skapar ett nytt utifrån den nya inmatningen. ElevenLabs använder en websocket med flera kontexter för att smidigt hantera dessa graciösa avbrott.
- Latens: Latens beskriver fördröjningen från att användaren avslutar sin mening till att agenten påbörjar sitt ljudsvar. Röstagenter för produktion bör sikta på en tid till första ljud under 500 ms, där under 300 ms är bättre. ElevenLabs Flash-modeller erbjuder branschledande modellinferens på cirka 75 ms, vilket ger dig goda förutsättningar i denna kategori.
- Reservfallsfrekvens: Reservfallsfrekvens är ett mått på hur ofta en AI-agent inte förstår användaren och ber om förtydligande eller upprepning. Det är till stor del en följd av STT-noggrannhet: om taligenkänningslagret hör fel eller återger kundens ord fel får LLM:en förvanskad indata. Reservfallsfrekvens beräknas enligt formeln: Reservfallsfrekvens (%) = (Antal reservfall / Totalt antal interaktioner) * 100.
ElevenLabs Scribe V2 har lägst WER, 2,2 %, i Artificial Analysis utvärdering av tal-till-text-modeller
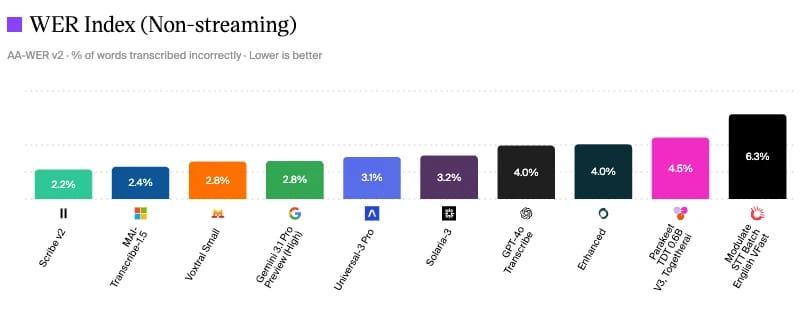
Artificial Analysis utvärdering av tal-till-text-modeller
Ett sätt att mäta samtalskvalitet är att titta på branschens benchmarkstandarder för olika komponenter. Som du ser har ElevenLabs Scribe v2 lägst Word Error Rate, 2,2 % i juni 2026, vilket innebär färre feltolkningar, färre reservfall och mer korrekt avsiktsklassificering.
Företag kan också uppleva att samtalskvaliteten beror på det workflow där röstagenten används. I kundtjänst kan till exempel kvaliteten på överlämning vid eskalering eller lösning av vanliga frågor vara viktig.
Verktygsanvändning och uppgiftsutförande
Medan kvalitet mäter hur ett samtal upplevdes, mäter uppgiftsutförande om det ledde till ett lyckat resultat. Företag bör ägna stor uppmärksamhet åt denna del av ramverket för utvärdering av röstagenter, eftersom den är direkt kopplad till affärsresultat.
Ett mått på verktygsanvändning är noggrannhet vid ifyllnad av fält, som avgör hur väl AI-agenter kan slutföra relativt rutinmässiga uppgifter, såsom att fylla i ett formulär med kundinformation. Hög noggrannhet vid ifyllnad visar att agenten kan gå sömlöst från samtal till handling utan att förlora information på vägen.
Task Success Rate (TSR) är ett procentbaserat mått på vilka uppgifter från början till slut som en agent har slutfört. Slutförandet baseras på agentens förmåga att både förstå en begäran och sedan använda rätt anslutna verktyg (API:er, databaser, Retrieval-Augmented Generation (RAG) och interna kunskapsbaser) för hjälp.
Formeln för TSR är:
TSR = (Fullständigt slutförda uppgifter / Totalt antal påbörjade uppgifter) x 100
Röstagenter redo för produktion bör sikta på en TSR över 85 %, med övervakning av noggrannhet och tillförlitlighet för verktygsanrop. För att undvika försämring av TSR bör du regressionstesta alla ändringar av promptar eller anslutna modeller. Även en liten avvikelse kan få stora konsekvenser för din TSR.
Intelligens
Intelligens omfattar en röstagents resonemang och mer avancerade förmågor. Det är detta område som tydligt skiljer en röststyrd IVR (Interactive Voice Response) från en AI-röstagent.
Viktiga dimensioner att utvärdera här är:
- Risk för hallucinationer: Hallucinationer, där agenten ger information som är felaktig eller inte stämmer överens med företagets dokument, är särskilt skadliga inom röst-AI eftersom de kan förmedlas med stort självförtroende. Nya studier visar att vanliga hallucinationer skadar kundnöjdheten med röstagenter avsevärt.
- Hantering utanför användningsområdet: Intelligenta agenter förstår när en fråga ligger utanför deras kontextuella område och kan svara lämpligt. I stället för att hallucinera ett svar avböjer de eller leder tillbaka samtalet till ett område som täcks av kontexten.
- Bevarande av kontext: Kan agenten under flera turer hålla reda på entiteter och åtaganden som gjorts tidigare? Utan denna förmåga kan kunder behöva upprepa sig eller få motsägelsefulla svar.
- Resonemang och logik i flera steg: Kan agenten korrekt hantera villkorslogik eller kedja slutsatser genom flera turer? Särskilt i mer tekniska användningsområden, som finansiella tjänster, är förmågan att resonera inom en fördefinierad kontext avgörande för framgång.
Det finns flera tredjepartsbenchmarks för dessa dimensioner och komponenter. Stanfords Holistic Evaluation of Language Models (HELM) benchmarkar till exempel LLM-prestanda i olika kategorier. För hallucinationer erbjuder TruthfulQA en robust analys av hur ofta falska svar smyger sig in i svaren.
En fördel med ElevenAgents är att du, till skillnad från vissa röstplattformar som låser dig till en enda underliggande modell, kan byta ut hela LLM-lagret. I praktiken innebär det att du kan ansluta den modell som leder resonemangsbenchmarks för just ditt användningsområde.
Efterlevnad och säkerhet
Företag behöver införa aktiva skyddsräcken för att förhindra skadliga eller policystridiga resultat. Till skillnad från promptinstruktioner på systemnivå, som kan kringgås eller åsidosättas, körs oberoende kontroller av skyddsräcken som ett separat lager utanför själva modellen. De utvärderar resultat innan de når användaren och avbryter samtalet om det hamnar i farligt område.
Granskningsbarhet är ett närliggande krav, där produktionsagenter måste föra detaljerade loggar över beslut och resultat i ett format som stöder efterhandsgranskning. Särskilt i hårt reglerade branscher är det lika viktigt att kunna visa efterlevnad i efterhand som att uppnå den från början.
Exakt vilka regler ditt företag måste följa varierar per bransch. Några av de vanligaste tillämpliga regelverken är:
- HIPAA: För skyddade hälsodata i amerikanska vårdsammanhang.
- PCI-DSS: För alla agenter som hanterar betalkortsdata.
- GDPR: Skyldigheter kring dataskydd för EU och företag med kunder i EU.
För företag som utvärderar sin regelefterlevnad har ElevenLabs AICPA SOC Type II- och GDPR-efterlevnad samt AIUC-1-certifiering. AIUC-1 är en säkerhetsstandard som utformats särskilt för AI-agenter.
Tillförlitlighet
Tillförlitlighet är den sista delen i vårt ramverk för utvärdering av röstagenter och handlar om huruvida en agent kan leverera konsekvent i realtid.
När du bedömer en röstagent bör du leta efter följande egenskaper:
- Tillgänglighet: Alla kundnära driftsättningar förväntar sig 99,9 % tillgänglighet för att undvika avbrott. Särskilt för användningsområden som alltid är aktiva, såsom inkommande support, är tillförlitlig tillgänglighet en viktig faktor.
- Kontrollerad degradering: På grund av röstagenters underliggande komplexitet bör agenten hantera försämringen kontrollerat om en komponent börjar fallera. I praktiken innebär det att koppla samtalet till en människa, i stället för att fortsätta fungera under ökad belastning eller med felmeddelanden.
- Prestanda under belastning: Belastningstester bör simulera minst 2x din förväntade högsta samtidiga belastning innan du går live. Tester under hög belastning kan identifiera ökande latens eller försämrad prestanda som bara visar sig i stor skala.
Även en högkvalitativ modell som uppfyller alla andra krav kan vara oanvändbar om den inte kan skalas efter kundernas efterfrågan. ElevenAgents används av 1 000 000 ledande kreatörer och företag, vilket visar plattformens förmåga att stödja driftsättning i företagsskala utan att kompromissa med prestandariktvärden.
Så mäter du MOS för röstagenter (steg för steg)
Om ditt företag vill mäta MOS manuellt behöver du en stor grupp mänskliga lyssnare och ett urval ljudklipp från verkliga samtal. Det är en strukturerad process som omfattar insamling av återkoppling, beräkning av genomsnitt och tolkning av data.
Så här mäter du MOS för röstagenter i praktiken:
- Förbered din testuppsättning: Välj ett representativt urval av ljudutdata från din agent, med minst 100 klipp från olika typer av samtal.
- Genomför betygssessionen: Be dina mänskliga lyssnare att betygsätta varje klipp på en skala från 1 till 5 utifrån kommunikationsupplevelsens kvalitet.
- Sammanställ betyg och beräkna poäng: Beräkna genomsnittet för varje klipp och sedan för alla klipp i urvalet för att få ett övergripande MOS. Ett MOS på 4,3 eller högre visar att din röstagent är redo för produktion.
Även om processen kräver mycket manuellt arbete ger den dig ett stabilt MOS för den röstagent du valt. Om du vill köra testet i stor skala kan du ersätta mänskliga lyssnare med automatiserade verktyg som NISQA, vilka förutsäger MOS-poäng programmatiskt. Du kan integrera dessa system i dina aktiva pipelines för att kontinuerligt övervaka MOS över tid.
Benchmarks för testning av AI jämfört med människor: FCR, AHT och CSAT
Att beräkna MOS upprepade gånger över tid är ett sätt att se om modellen förbättras eller försämras, men du kan få mer sammanhang genom att benchmarka mot mänsklig prestation. Genom att se vad människor faktiskt uppnår i liknande roller kan du avgöra om din röstagent presterar nära en idealisk nivå.
Här är några mått att ta hänsyn till vid benchmarks för AI jämfört med människor.
AI-agenter bör kunna matcha mänskliga agenters FCR och CSAT samtidigt som de förbättrar AHT avsevärt. Detta beror på att AI-agenter vanligtvis hanterar mer allmänna samtal än mänskliga agenter. Många företag använder ett workflow där AI-agenter är första kontakt och bara kopplar vidare samtal till mänskliga agenter om de är för komplexa att hantera självständigt.
Data från 2025 från Poe, en aggregator för AI-jämförelser, visar att ElevenLabs behöll den starkaste övergripande förmågan att uppfylla begäranden, med 74,4 % av alla inkommande begäranden slutförda. Framgången har lett till snabbt växande användning, där Eleven v3 och v2.5-Turbo över tid står för mer än 60 % av meddelandena till AI-modeller.
För en bättre upplevelse, använd Eleven v4 för vår mest känslofulla TTS-modell.
Meddelanden som skickats till AI-modeller över tid, där ElevenLabs leder Poes ramverk för utvärdering av röstagenter
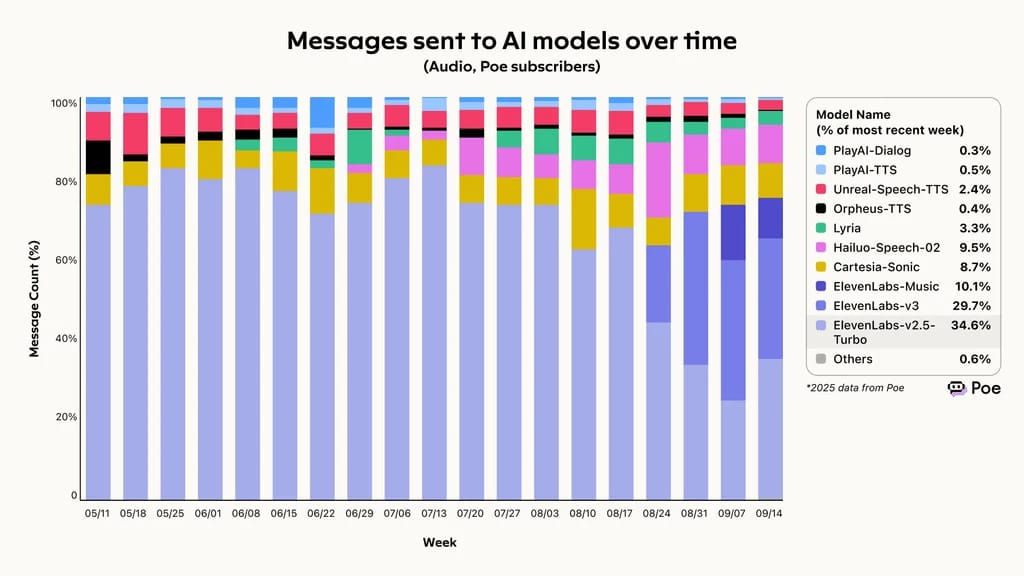
Meddelanden som skickats till AI-modeller över tid, benchmarkade av Poe
Vanliga misstag vid testning av röstagenter
När du följer ett ramverk för utvärdering av röstagenter är det lockande att testa bästa möjliga scenarier. Men kundernas vardagliga upplevelse av dina röst-AI-system utgår inte från idealiska förhållanden.
Här är tre vanliga misstag vid testning av röstagenter och hur du åtgärdar dem:
- Testa den enklaste vägen: Se till att inkludera gränsfall, särskilt när du väljer ljudklipp för MOS. Klipp med bakgrundsljud eller tal med accent är mycket vanliga i verkligheten, så tester med enbart ”rena” ljudfiler leder till felkalibrerat MOS.
- Prioritera inneslutning framför lösning: Att optimera modellerna för att behålla användare i agentsystemet höjer inneslutningsgraden utan att förbättra resultaten. Om din FCR är låg trots en hög inneslutningsgrad skickar agenten användare runt i en frustrerande loop. Ha rutiner som gör det möjligt för användare att prata med mänskliga agenter om de vill.
- Ignorera latenspercentiler: SLA:er anger ofta latens på P95-nivå. Måttet är viktigt för att ge en konsekvent upplevelse för majoriteten av kunderna, men glöm inte att de sista 5 % också är verkliga kunder. I stor skala innebär 5 % av ett system som hanterar 10 000 samtal om dagen fortfarande 500 personer som upplever ett långsamt samtal. Fokusera på P99 som ditt huvudsakliga SLA-mål, inte enbart median eller P95.
Genom att ha detta i åtanke kan du fastställa rättvisa och representativa baslinjer i stället för att utgå från idealiserade genomsnitt.
Argumentet för utvärderingar anpassade till användningsområdet
De sex delar som beskrivs i detta ramverk ger vägledning om områden att undersöka, men hur mycket varje del väger beror på din bransch. Ett företag inom finansiella tjänster kan till exempel prioritera efterlevnad och verktygsanvändning, medan ett konsumentvarumärke kan låta TTS-röstkvalitet vara vägledande.
Här är två exempel på utvärderingar anpassade till användningsområdet och hur de kan förändra balansen mellan de olika delarna.
Kundtjänst
I vissa branscher, som callcenter, är andra mått på uppgiftsutförande, exempelvis lösning vid första samtalet (FCR), en viktig del av diskussionen. Att kunna hantera ett inkommande samtal utan mänsklig hjälp minskar avsevärt belastningen på mänskliga kundtjänstagenter. McKinsey uppskattar att callcenter som använder röstagenter kan minska interaktionsvolymen med upp till 50 %.
Även om det inte är lika viktigt som graden av lyckade uppgifter är inneslutningsgrad en annan dimension att överväga här. Inneslutningsgrad är ett mått som undersöker ett samtals totala längd. Om din inneslutningsgrad är mycket hög men FCR är låg, håller dina agenter kvar personer i samtalet utan att ge kunden en lösning. I praktiken kan det innebära en frustrerande upplevelse där kunden går runt i cirklar.
Andra mått att följa är AHT, där AI-agenter ska lösa rutinproblem snabbt. Därför skulle området kundtjänst prioritera samtalskvalitet, särskilt turtagning och reservfallsfrekvens, framför andra områden.
Hälso- och sjukvård
Hälso- och sjukvård är ett hårt reglerat område med strikta krav på efterlevnad som gör driften av röstagenter mycket känslig. Efterlevnad är centralt och flyttar tyngden i ramverkets säkerhetsdel kraftigt mot detta och intelligens framför allt annat.
Chattbotar för hälso- och sjukvård måste hantera tidsbokning, vägar till tillgång till vård på distans, symtomtriage och försäkringsfrågor. Allt detta kräver en hög grad av intelligens och verktygsanvändning, vilket återigen visar att bransch- eller rollspecifika krav påverkar vilken del som är viktigast.
Oavsett vilket område ditt företag verkar inom hjälper en förståelse för kärnområdena vid utvärdering av röstagenter och en balanserad tillämpning av dem dig att hitta de bästa agenterna för dig.
Bygg med ElevenAgents för hög prestanda och låg latens
Plattformen du väljer att bygga på påverkar direkt hur dina röstagenter fungerar i verkliga workflows. Särskilt i kontakt med kunder behöver du kunna lita på att agenten presterar på topp i varje kategori.
ElevenAgents är byggt för röstdriftsättningar i produktion och kombinerar branschledande TTS via Eleven v4, STT i realtid genom Scribe v2, och ett lager för agentorkestrering utformat för företagsskala. Varje komponent är byggd för att prestera enligt riktvärdena i detta ramverk, så att du kan ge dina kunder upplevelser av hög kvalitet.
Oavsett om du väger dina alternativ eller är redo att börja bygga har ElevenLabs en väg för dig. Utforska ElevenAgents-plattformen för att se hur den passar ditt användningsområde, eller registrera dig och börja bygga i dag.
Vanliga frågor om utvärdering av röstagenter

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.



