
Vad är en LLM? En praktisk guide till språkmodeller
- Skriven av
- Jack Limebear
- Publicerad
LyssnaLyssna på den här artikeln
En stor språkmodell (LLM) är ett system för artificiell intelligens som tränats på en enorm datamängd för att analysera, förutsäga och generera naturligt språk. Populära LLM:er omfattar OpenAI:s GPT-modeller, Anthropics Claude och Googles Gemini, som ofta används för exempelvis skrivande, redigering och kodning.
Till en början innehöll LLM-dataset främst text från källor som böcker, bloggar och även internetforum. Moderna LLM:er använder nu multimodala data för att bredda användningsområdena, till exempel genom att driva röstagenter för konversationer eller skapa musik.
Innan organisationer implementerar den här tekniken behöver de ofta svar på frågor som: Vad är en LLM, hur fungerar en LLM och vilka arkitekturer bör teamet använda? Den här guiden besvarar frågorna och visar samtidigt teknikens tillämpningar i verkligheten och deras konkreta fördelar.
Sammanfattning
- En stor språkmodell (LLM) är en AI-modell som tränats på enorma dataset med text och multimodala data för att analysera, förutsäga och generera resultat.
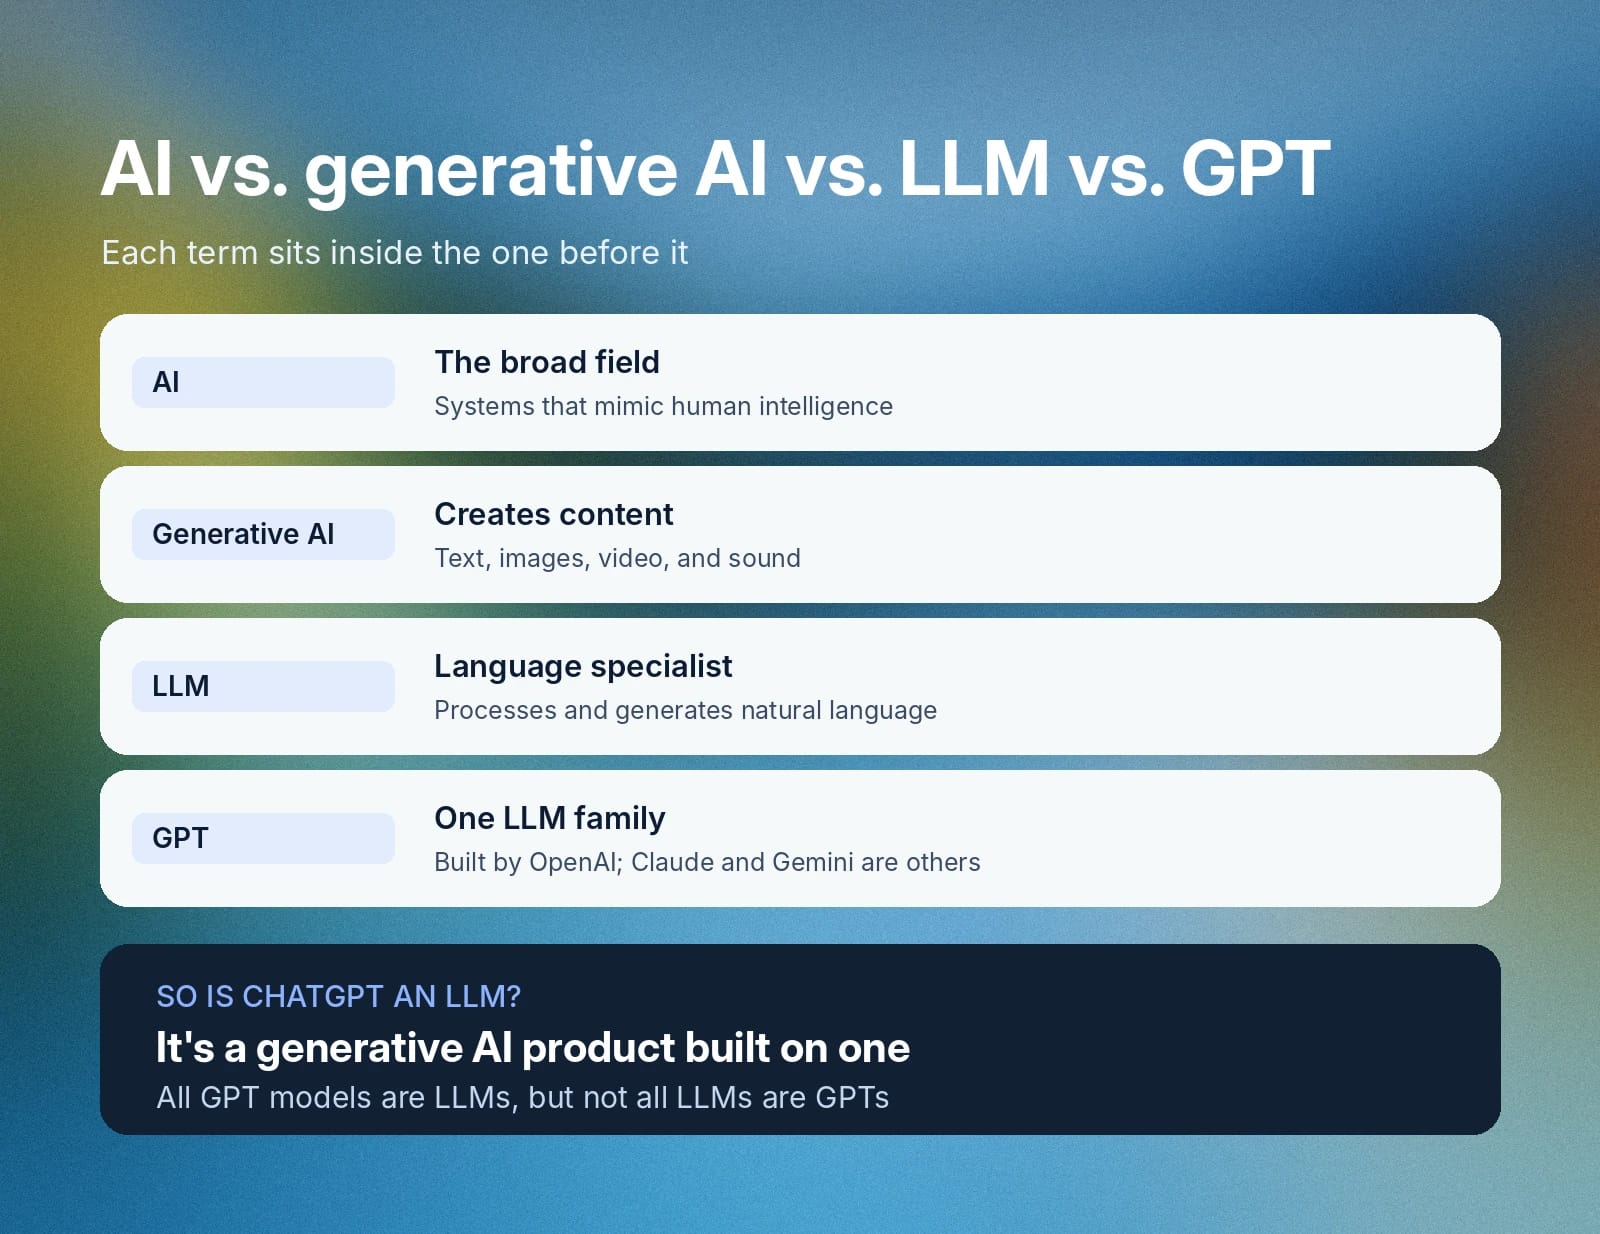
- Den främsta skillnaden mellan GPT:er och LLM:er är att GPT (Generative Pre-trained Transformer) är en specifik familj av LLM:er skapad av OpenAI, medan LLM är samlingsbegreppet för modeller som Claude och Gemini.
- Generativ AI är den breda kategorin för modeller som skapar många olika typer av innehåll baserat på träningsdata, medan LLM:er är en specialiserad undergrupp av generativ AI som fokuserar på bearbetning av naturligt språk.
- LLM:er fungerar genom att använda neurala transformer-nätverk för att dela upp text i mindre enheter som kallas tokens och sedan förutsäga nästa token utifrån kontextuell information från prompten och den befintliga chatthistoriken.
- Praktiska exempel på stora språkmodeller är kundtjänstchattbotar, automatiserade skrivverktyg, kodgeneratorer och lager för naturlig språkbehandling i röstapplikationer.
Vad är en LLM? Definitionen av en stor språkmodell
En stor språkmodell är ett AI-program som bygger på neurala nätverk för djupinlärning för att analysera, förutsäga och generera naturligt språk. Utvecklare har tränat dessa modeller på dataset som innehåller miljarder verk från böcker, akademiska uppsatser, webbplatser och bloggar. Begreppet ”stor” syftar både på den enorma mängd data som används för att träna modellerna och de miljarder interna parametrar som styr deras beteende.
Stora språkmodeller innebär ett stort skifte jämfört med hur tidigare programvara fungerade. Traditionell programvara förlitade sig på explicita syntaxkommandon, men det gör inte LLM:er. I stället för att bearbeta varje ord isolerat använder LLM:er kontextuella samband för att känna igen komplexa språkliga mönster och grammatik. De tolkar ostrukturerat mänskligt språk och fortsätter att svara på öppna användarprompter genom att anpassa sig till kontextförändringar mitt i samtalet.
Dessa framsteg inom naturlig språkbehandling gör att ElevenAgents kan förstå komplexa kundavsikter och utföra automatiserade arbetsflöden.
Hur fungerar stora språkmodeller?
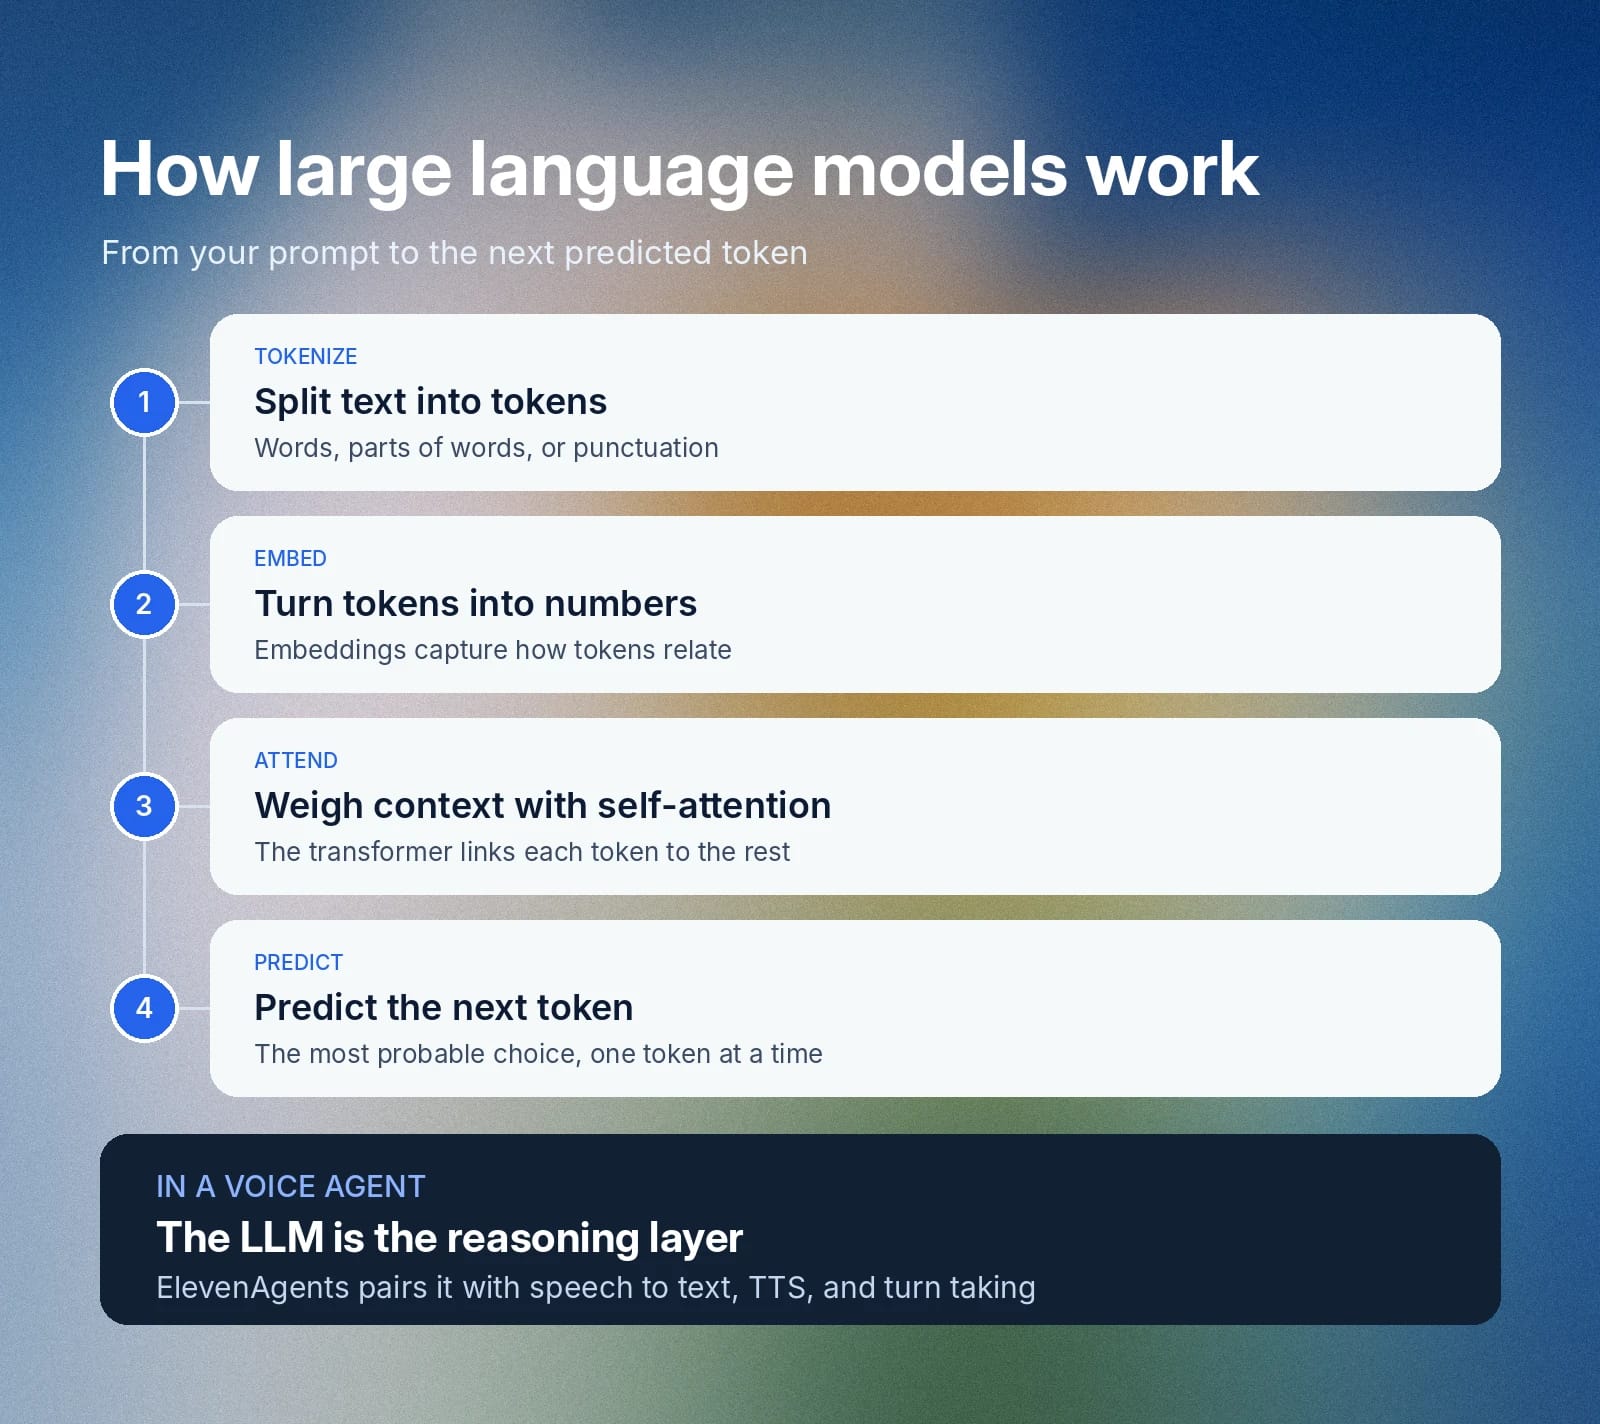
Stora språkmodeller bearbetar text genom artificiella neurala nätverk för att analysera indata på naturligt språk och generera relevant innehåll. Processen börjar med tokenisering, där modellen delar upp inmatad text i mindre enheter som kallas tokens. Modellen översätter sedan dessa tokens till numeriska representationer (kallade embeddings) för att bedöma matematiska eller statistiska samband mellan tokens.
De flesta moderna LLM-system bygger på arkitekturen med neurala transformer-nätverk. Transformers använder mekanismer för self-attention, som bedömer de kontextuella sambanden mellan tokens. Modellen förutsäger den statistiskt mest sannolika token som slutför en sekvens genom att använda inlärda mönster för att beräkna sannolikhetsfördelningar.
Self-attention gör det möjligt för modeller för naturlig språkbehandling att behålla långväga kontext och anpassa sig till förändringar mitt i ett samtal. Plattformintegrationer med ElevenAgents bygger vidare på dessa funktioner för att ge relevanta svar med låg latens som efterliknar naturliga mänskliga samtal.
Vad är temperatur i en LLM?
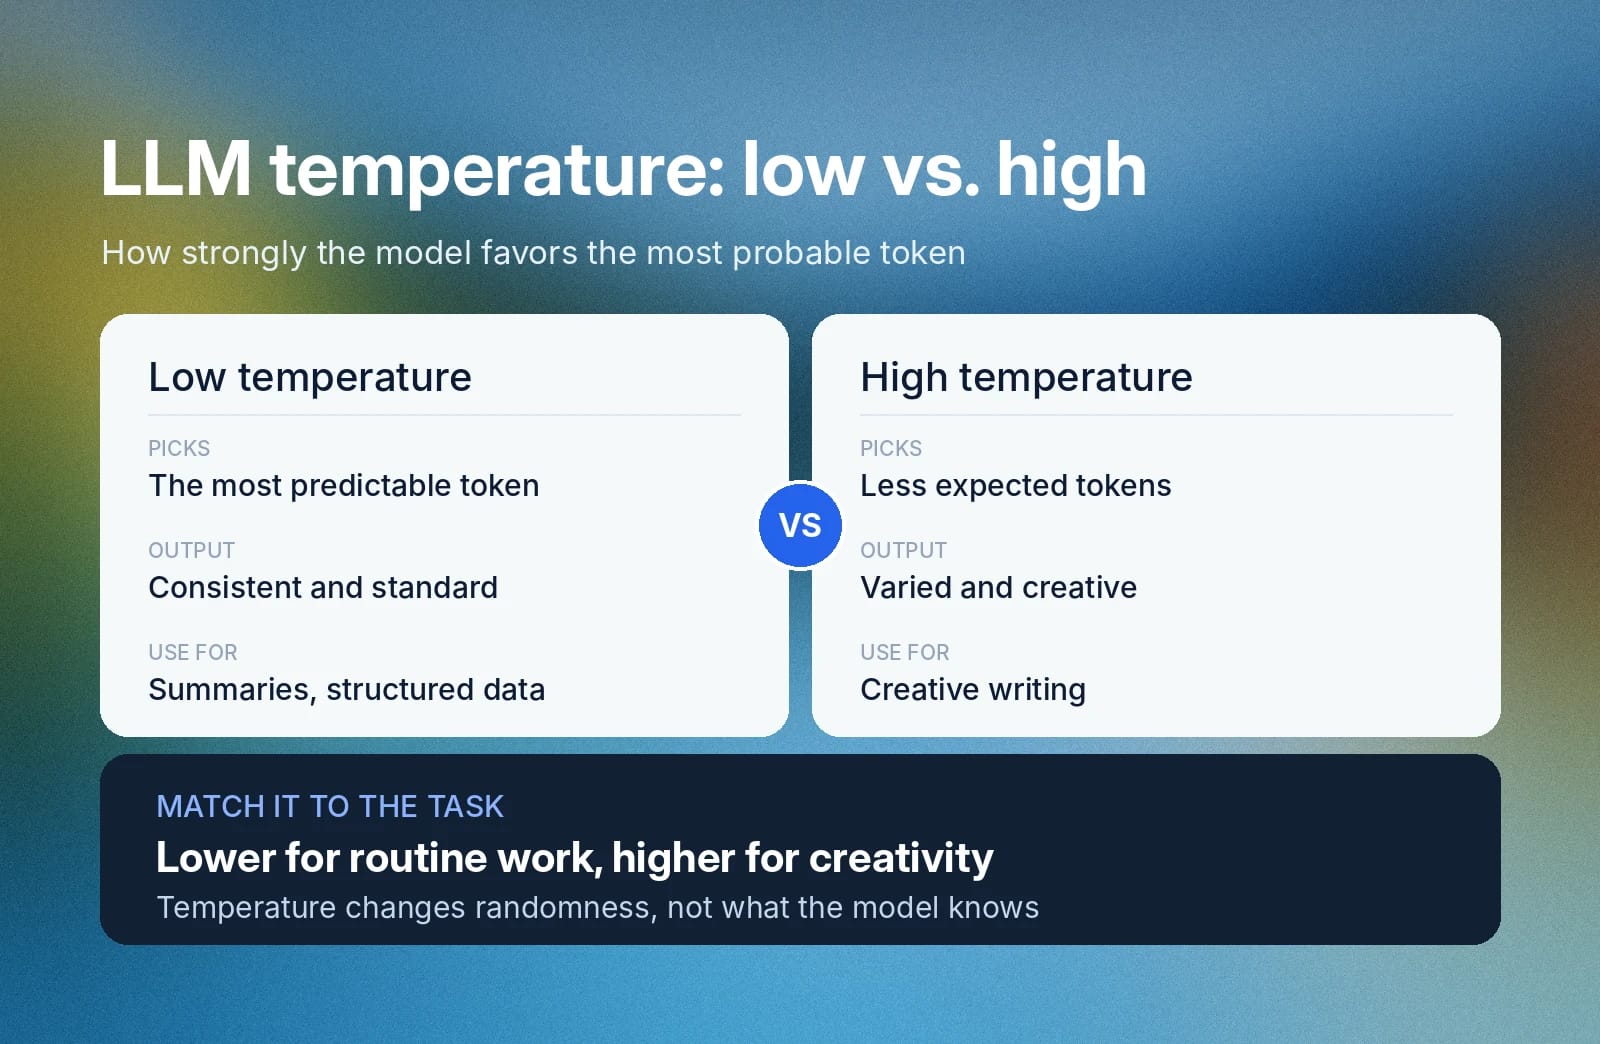
LLM-temperatur är en variabel inställning som utvecklare kan konfigurera för att avgöra hur slumpmässiga en LLM:s resultat ska vara. LLM:er genererar nästa token i en ordsekvens genom att välja det vanligaste alternativet. Men för varje val en LLM gör kan det finnas flera andra alternativ med liknande viktning.
Genom att justera LLM-temperaturen ändrar du hur starkt en LLM föredrar det mest sannolika alternativet. En låg temperaturinställning ger ett standardiserat och konsekvent resultat, eftersom den lutar åt att alltid välja den mest förutsägbara nästa token i en sekvens. En hög temperatur avviker däremot oftare från det förväntade valet och ger mer kreativa och varierade resultat.
Du bör anpassa LLM-temperaturvärdet efter uppgiften du vill utföra. Allt som behöver ett inslag av kreativitet bör använda högre temperaturer, medan rutinuppgifter eller strukturerade resultat, som datasammanfattningar, bör använda lägre temperaturer.
Hur tränas och finjusteras LLM:er?
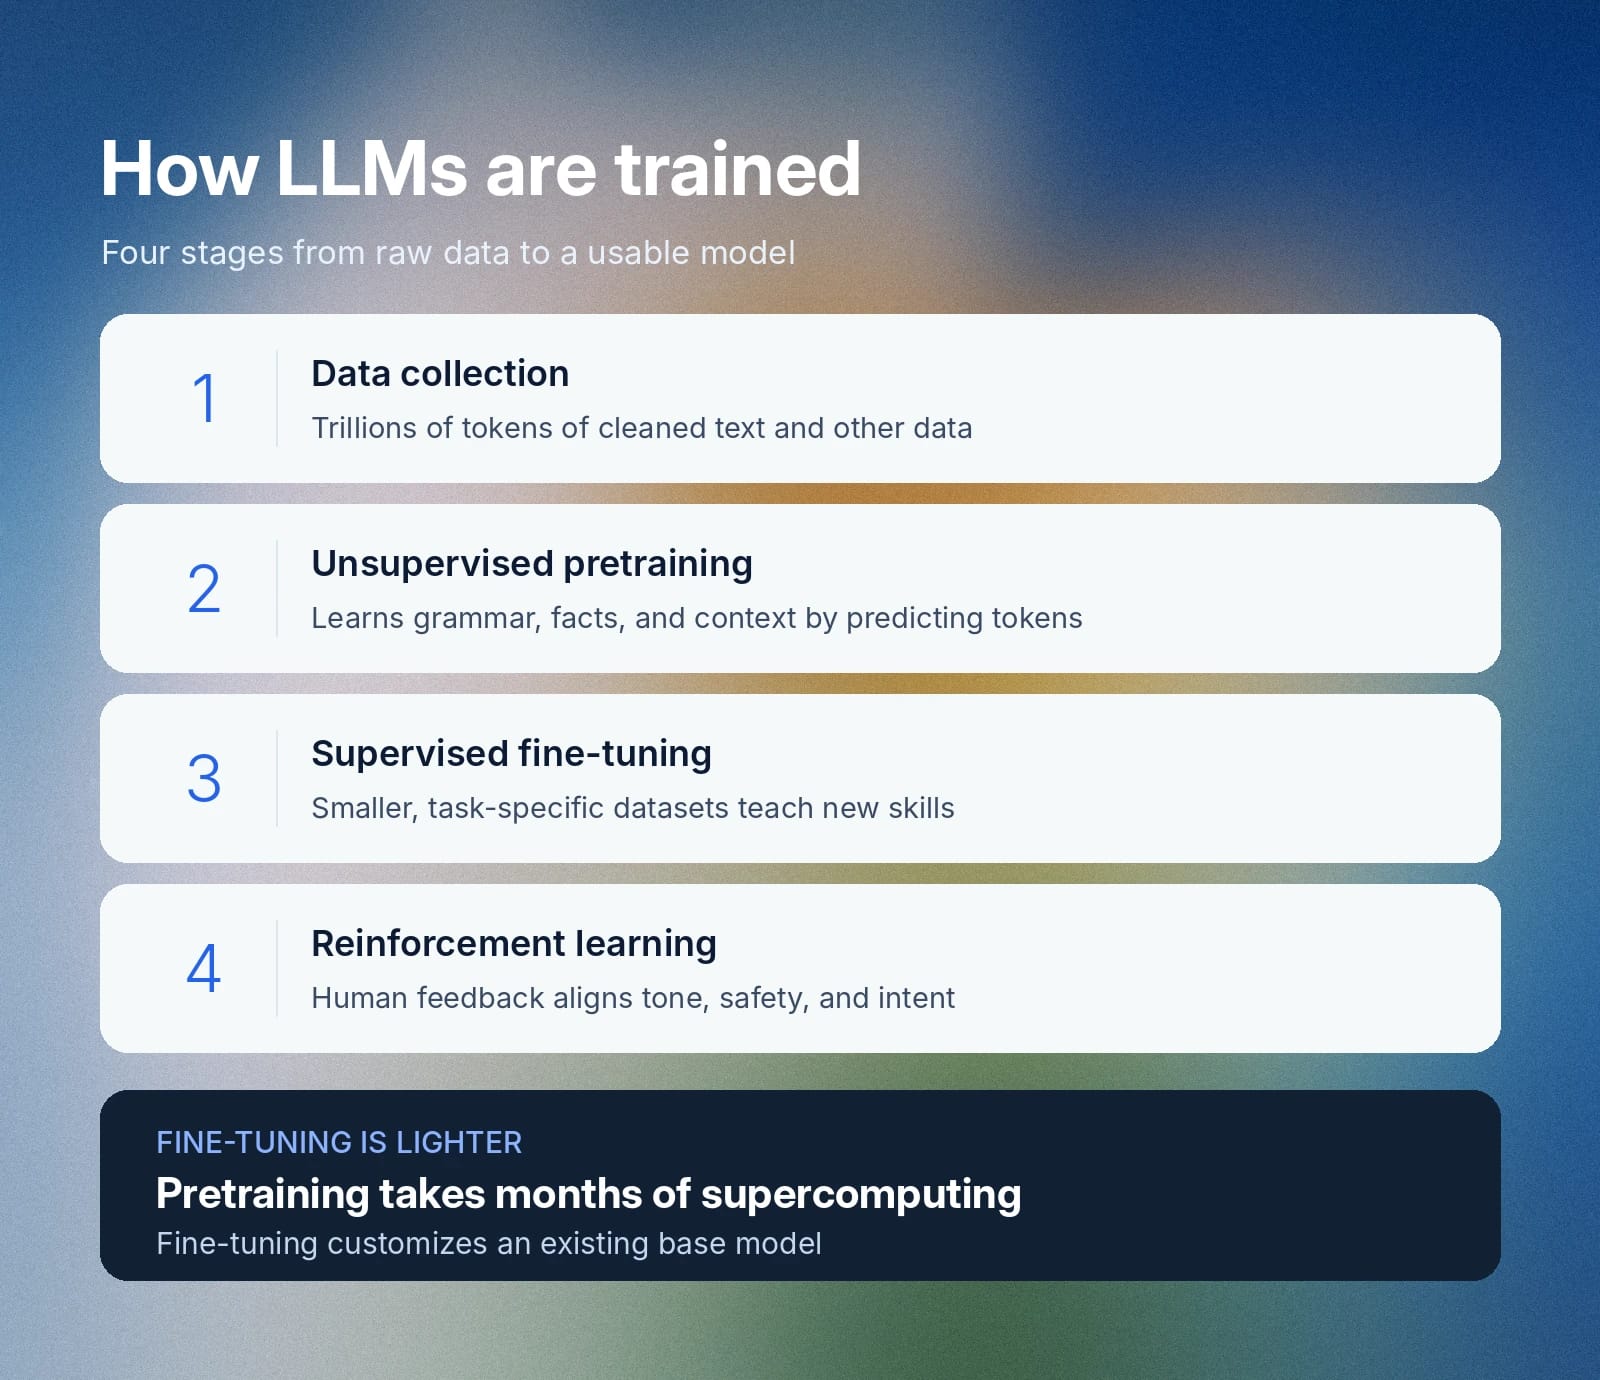
Att träna LLM:er kräver en process i flera steg för att omvandla råtext och multimodala data till fungerande språksystem. Företag behöver avancerad superdator-kapacitet som körs i flera månader, medan finjustering är en enklare process som anpassar den befintliga basmodellen.
Ledande AI-företag behandlar ofta sin exakta träningsprocess som företagshemlig information, och de flesta offentliggör inte källkod eller vikter. Vanligtvis följer träningen ändå den här processen:
- Datainsamling och förbehandling: Utvecklare bygger dataset från flera källor med korpusar för förträning som innehåller biljoner tokens från terabyte av rensad text. Att samla in eller utvinna text från internetkällor är ett av de främsta sätten företag bygger dessa dataset på.
- Oövervakad förträning: Den stora språkmodellen läser biljoner tokens för att lära sig grammatikregler, faktasamband och språklig kontext. Den förtränar i praktiken sig själv genom autoregressiv språkmodellering med mekanismer för self-attention som beräknar den statistiskt sannolika nästa token i en sekvens.
- Övervakad finjustering: Ingenjörer använder mindre och mer uppgiftsspecifika dataset för att justera den förtränade modellen. Detta steg lär modellen specifika färdigheter, från att besvara allmänna frågor till att generera logotyper eller bedriva laboratorieforskning.
- Förstärkningsinlärning och anpassning: Utvecklare förfinar modellens beteende med återkoppling från mänskliga granskare och belöningsmodeller. I detta steg anpassas modellens resultat till säkerhetsriktlinjer, tonkrav och mänskliga avsikter.
Typer av LLM-arkitekturer: kodare, avkodare och hybridmodeller
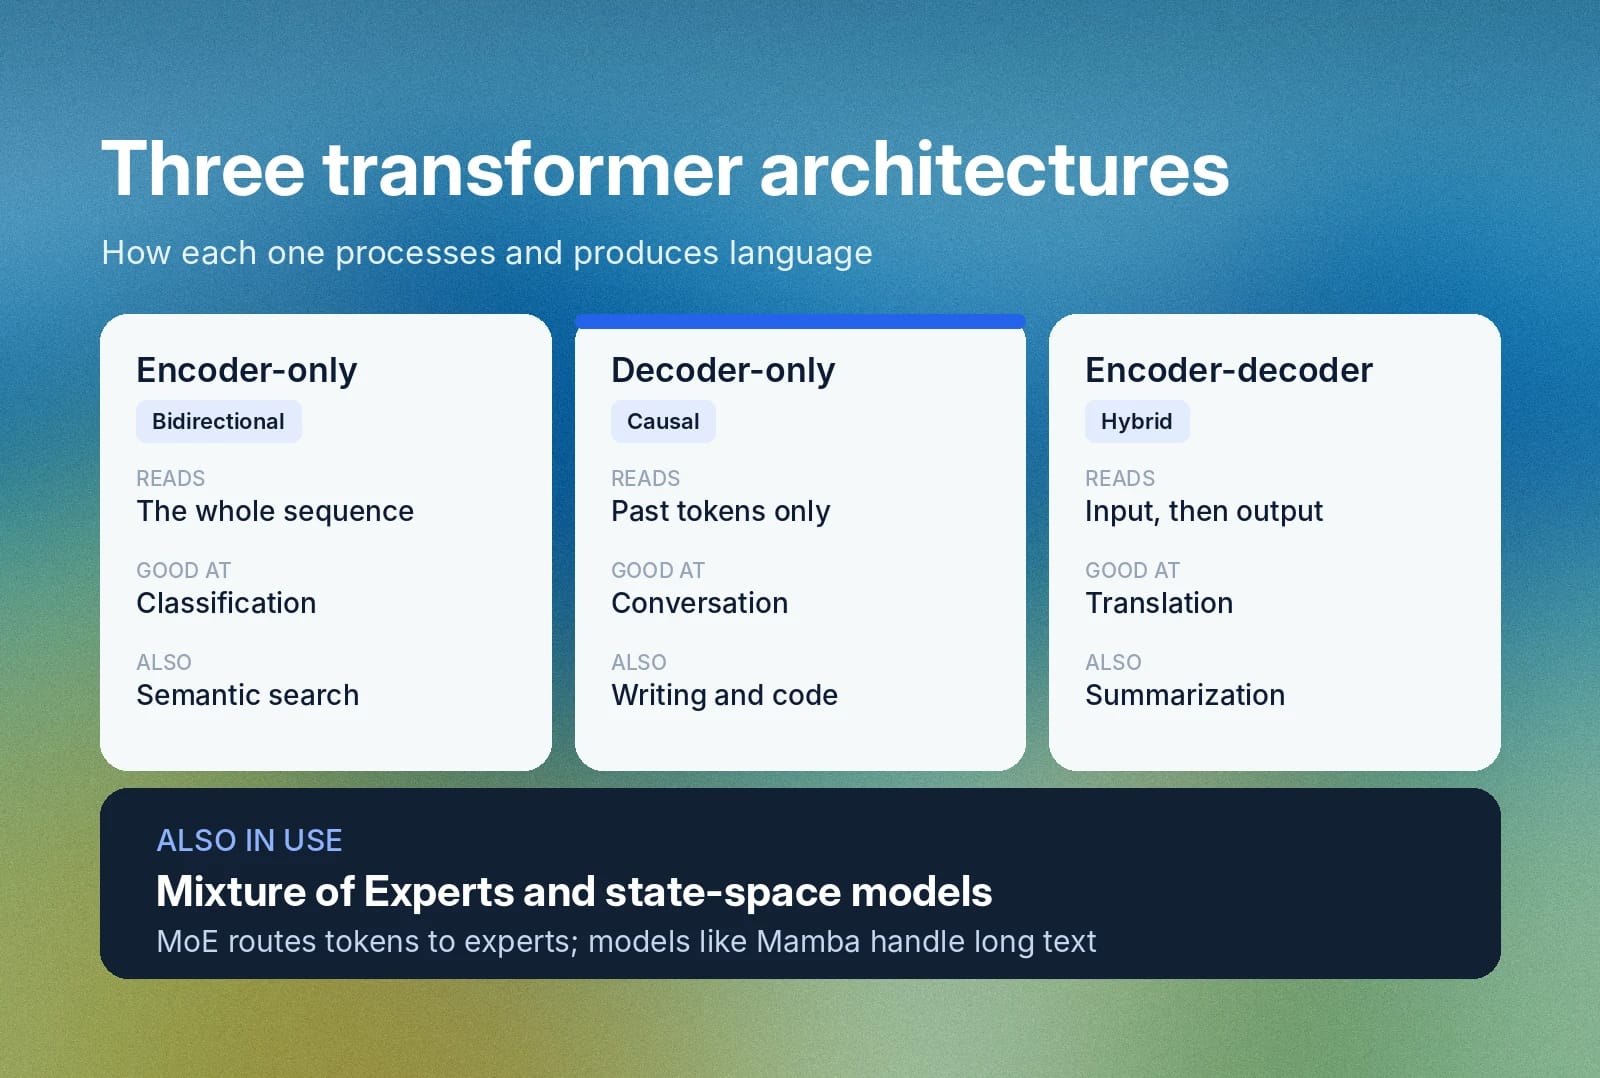
Transformer-arkitekturer organiserar lager i neurala nätverk på olika sätt för att bearbeta indata och skapa innehåll. Klassiska transformers delas in i tre huvudkategorier: modeller med enbart kodare, enbart avkodare och kodare-avkodare (hybridmodeller). Moderna system använder dock även effektivitetsarkitekturer för att skala prestandan.
Modeller med enbart kodare
Arkitekturer med enbart kodare bearbetar hela sekvenser samtidigt med dubbelriktad self-attention. Det gör att maskinen kan väga varje tokens relation till andra tidigare och framtida tokens. I praktiken optimerar detta modellerna för uppgifter som:
- Textklassificering
- Sentimentanalys
- Informationshämtning
- Semantisk sökning
Sådana uppgifter förekommer också i arbetsflöden för tal. ElevenLabs Scribe-modell för speech to text transkriberar tal på över 90 språk, och dess funktion för entitetsidentifiering markerar känsliga uppgifter och kränkande språk i transkriptioner.
Modeller med enbart avkodare
Arkitekturer med enbart avkodare använder kausal uppmärksamhet för att bearbeta tokens och förutsäga varje ord utifrån tidigare tokens. Dessa modeller skapar flytande samtal och är huvudarkitekturen bakom moderna chattbotar för konversationer, skrivassistenter för öppna uppgifter och verktyg för kodgenerering.
I ElevenAgents genererar den LLM du väljer, som vanligtvis är en modell med enbart avkodare, agentens svar, medan en egenutvecklad modell för turordning hanterar samtalets timing.
Kodare-avkodare (hybridmodeller)
Kodare-avkodare-modeller använder en kodare för att bearbeta indata och en avkodare för att generera utdata. Detta tillvägagångssätt med dubbla strukturer gör hybridmodeller bättre lämpade för uppgifter som kräver strikt bevarande av kontext, till exempel dokumentsammanfattning, språköversättning och omformatering av data.
Översättning är en klassisk kodare-avkodare-uppgift, och ElevenLabs Dubbing har stöd för fler än 90 språk.
Mixture of Experts (MoE) och tillståndsrymdmodeller
I stället för att aktivera varje parameter i det neurala nätverket för varje ord styr Mixture of Experts (MoE) enskilda tokens till mindre team av specialiserade ”expert”-undernätverk. Det ger ett resonemangsdjup jämförbart med massiva modeller, men med högre hastighet och lägre beräkningskostnader. Samtidigt bearbetar tillståndsrymdmodeller, som Mamba, mycket långa texter effektivt.
ElevenAgents innehåller LLM:er med öppen källkod som ElevenLabs driftar i vår egen infrastruktur.
Exempel på stora språkmodeller och vardagliga användningsområden
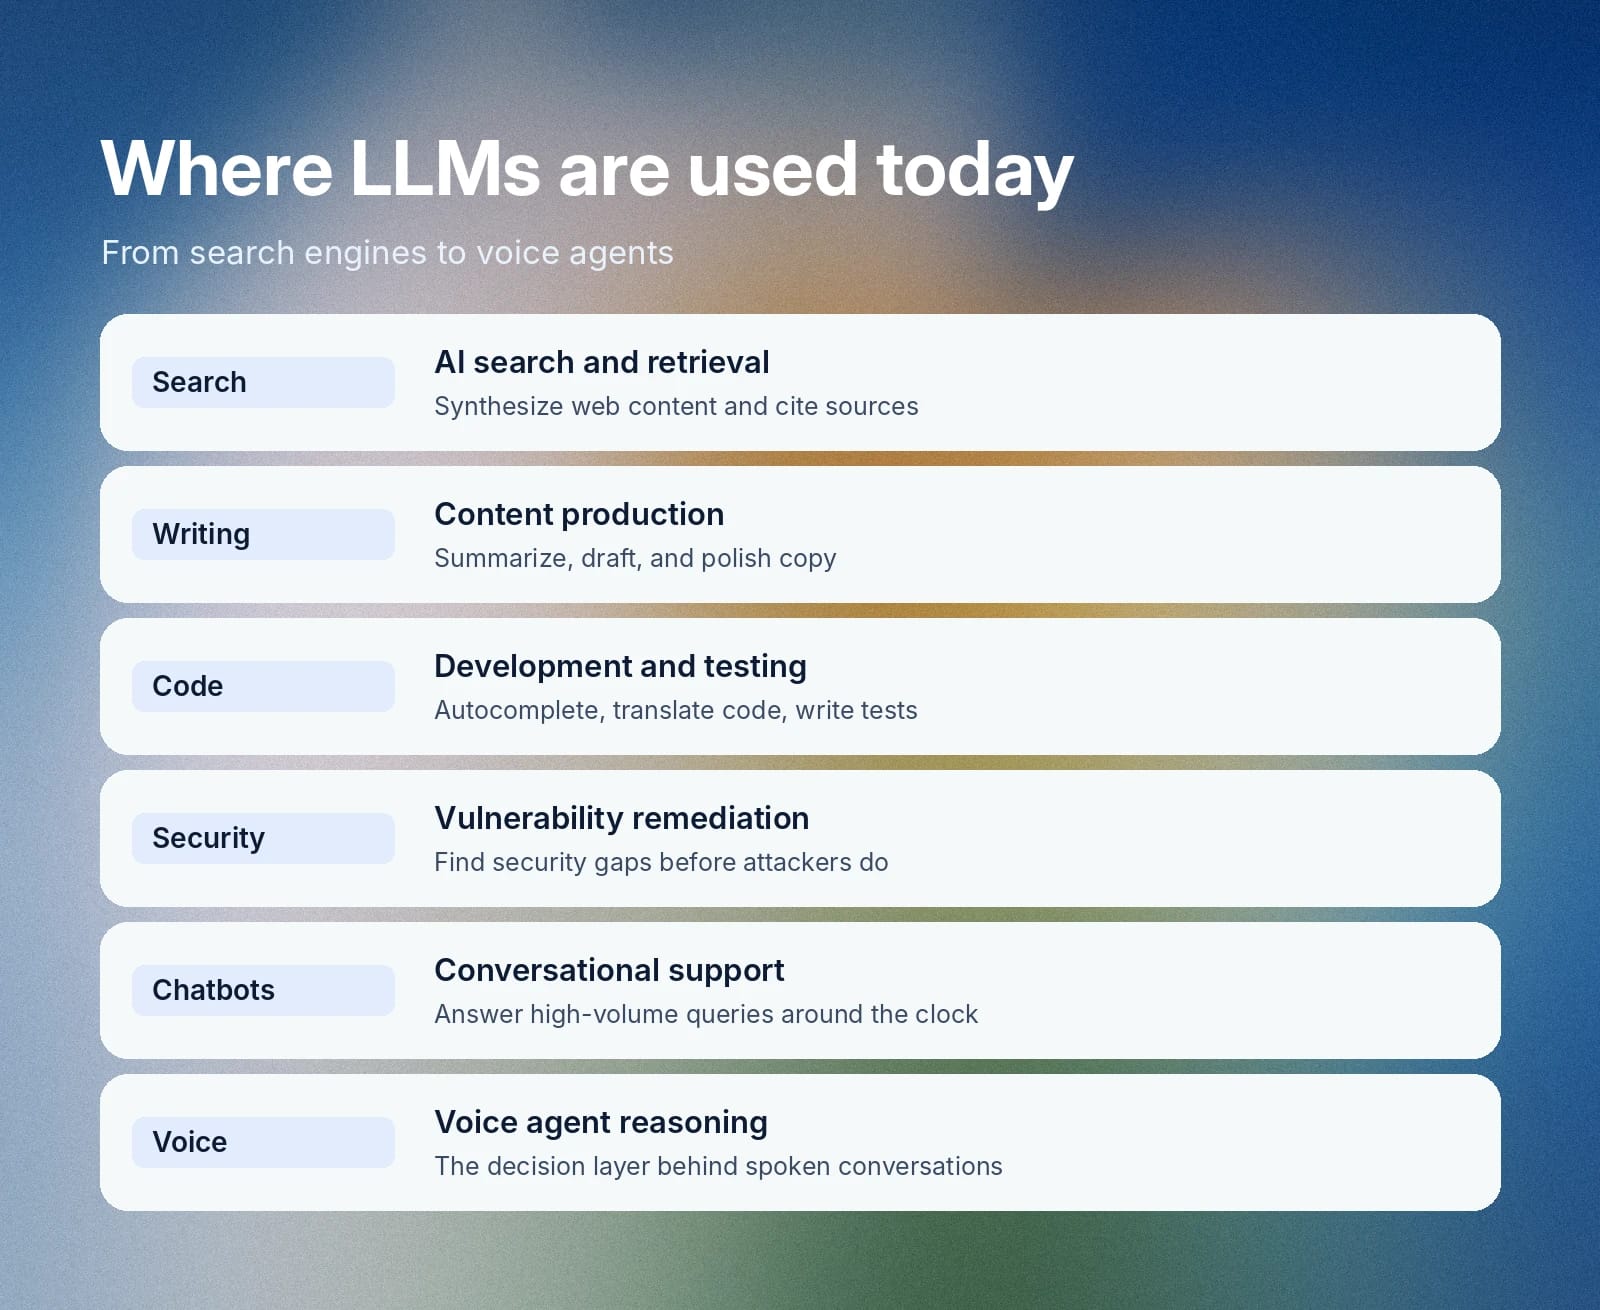
Organisationer har hittat en mängd användningsområden för stora språkmodeller. De visar hur AI har gått från experimentell forskning till en standardfunktion på webben, i programvaruapplikationer och i vardagliga enheter. AI-forskare fortsätter att studera och optimera den underliggande arkitekturen, men exempel på LLM:er i verkligheten visar hur team hittills har implementerat dem:
- AI-sökning och informationshämtning: Konversationsbaserade sökmotorer som Bing, Google AI Overviews och Perplexity använder LLM:er för att analysera webbinnehåll i realtid. Modellerna sammanställer information, hänvisar direkt till källor och låter användare ställa följdfrågor.
- Skrivande, redigering och innehållsproduktion: LLM:er och andra AI-drivna verktyg gör det enkelt att skriva och redigera material för internt och externt bruk. Exempelvis sammanfattar NotebookLM långa rapporter, Jasper AI skriver annonser och Grammarly putsar texter.
- Kodgenerering, utveckling och testning: AI driver kodverktyg som GitHub Copilot för att autokomplettera funktioner och översätta kod från ett programmeringsspråk till ett annat. Team kan även använda den för att generera automatiserade testsviter, så att de enkelt kan identifiera och åtgärda buggar före driftsättning.
- Cybersäkerhet och åtgärdande av sårbarheter: Ledande AI-företag har lanserat specialiserade modeller för att upptäcka säkerhetsbrister, vilket hjälper organisationer att implementera åtgärder innan angripare hinner hitta och utnyttja dem.
- Chattbotar och konversationsassistenter: Organisationer använder konversationsgränssnitt för att erbjuda kundsupport dygnet runt. Genom att integrera plattformar som ElevenAgents kan företag automatisera frågor i stora volymer med konversationslösningar i stället för att förlita sig på vanliga frågor och svar.
- Resonemangsmotor för röstagenter: LLM:er fungerar också som det centrala resonemangslagret för AI-röstsystem. ElevenAgents kombinerar den LLM du väljer med Speech to Text, Text to Speech med låg latens och en egenutvecklad modell för turordning för att föra naturliga samtal i realtid.
Vilka begränsningar har stora språkmodeller?
LLM:er är en kraftfull del av arkitekturen bakom de flesta AI-produkter som konsumenter använder, och de hjälper till i många arbetsflöden och användningsområden. Men om du vill bygga med LLM:er eller träna din egen modell bör du känna till deras viktigaste begränsningar:
- Hallucinationer: Det finns ingen garanti för att det en LLM genererar är korrekt. Ett svar kan lätt innehålla påhittad eller helt enkelt felaktig information.
- Statisk kunskap: Utan RAG är en LLM begränsad till den kunskap den fick under träningsprocessen.
- Partiskhet: Om dina träningsdata är partiska kommer modellen att återspegla dessa snedvridningar. Det är särskilt viktigt att tänka på om du använder en LLM för att klassificera data eller fatta beslut baserade på information, eftersom vissa implicita snedvridningar i dina data kan påverka resultatet negativt utan att du vet om det.
- Begränsat kontextfönster: LLM:er fungerar vanligtvis bara med en fast mängd text, vilket innebär att längre samtal kan börja tappa detaljer och bli mindre effektiva över tid.
- Kostnad och latens: Ju större LLM, desto mer beräkningskapacitet krävs för att köra den. Om du väljer kraftfullare modeller får du sannolikt betala mer för den förbättrade tjänsten.
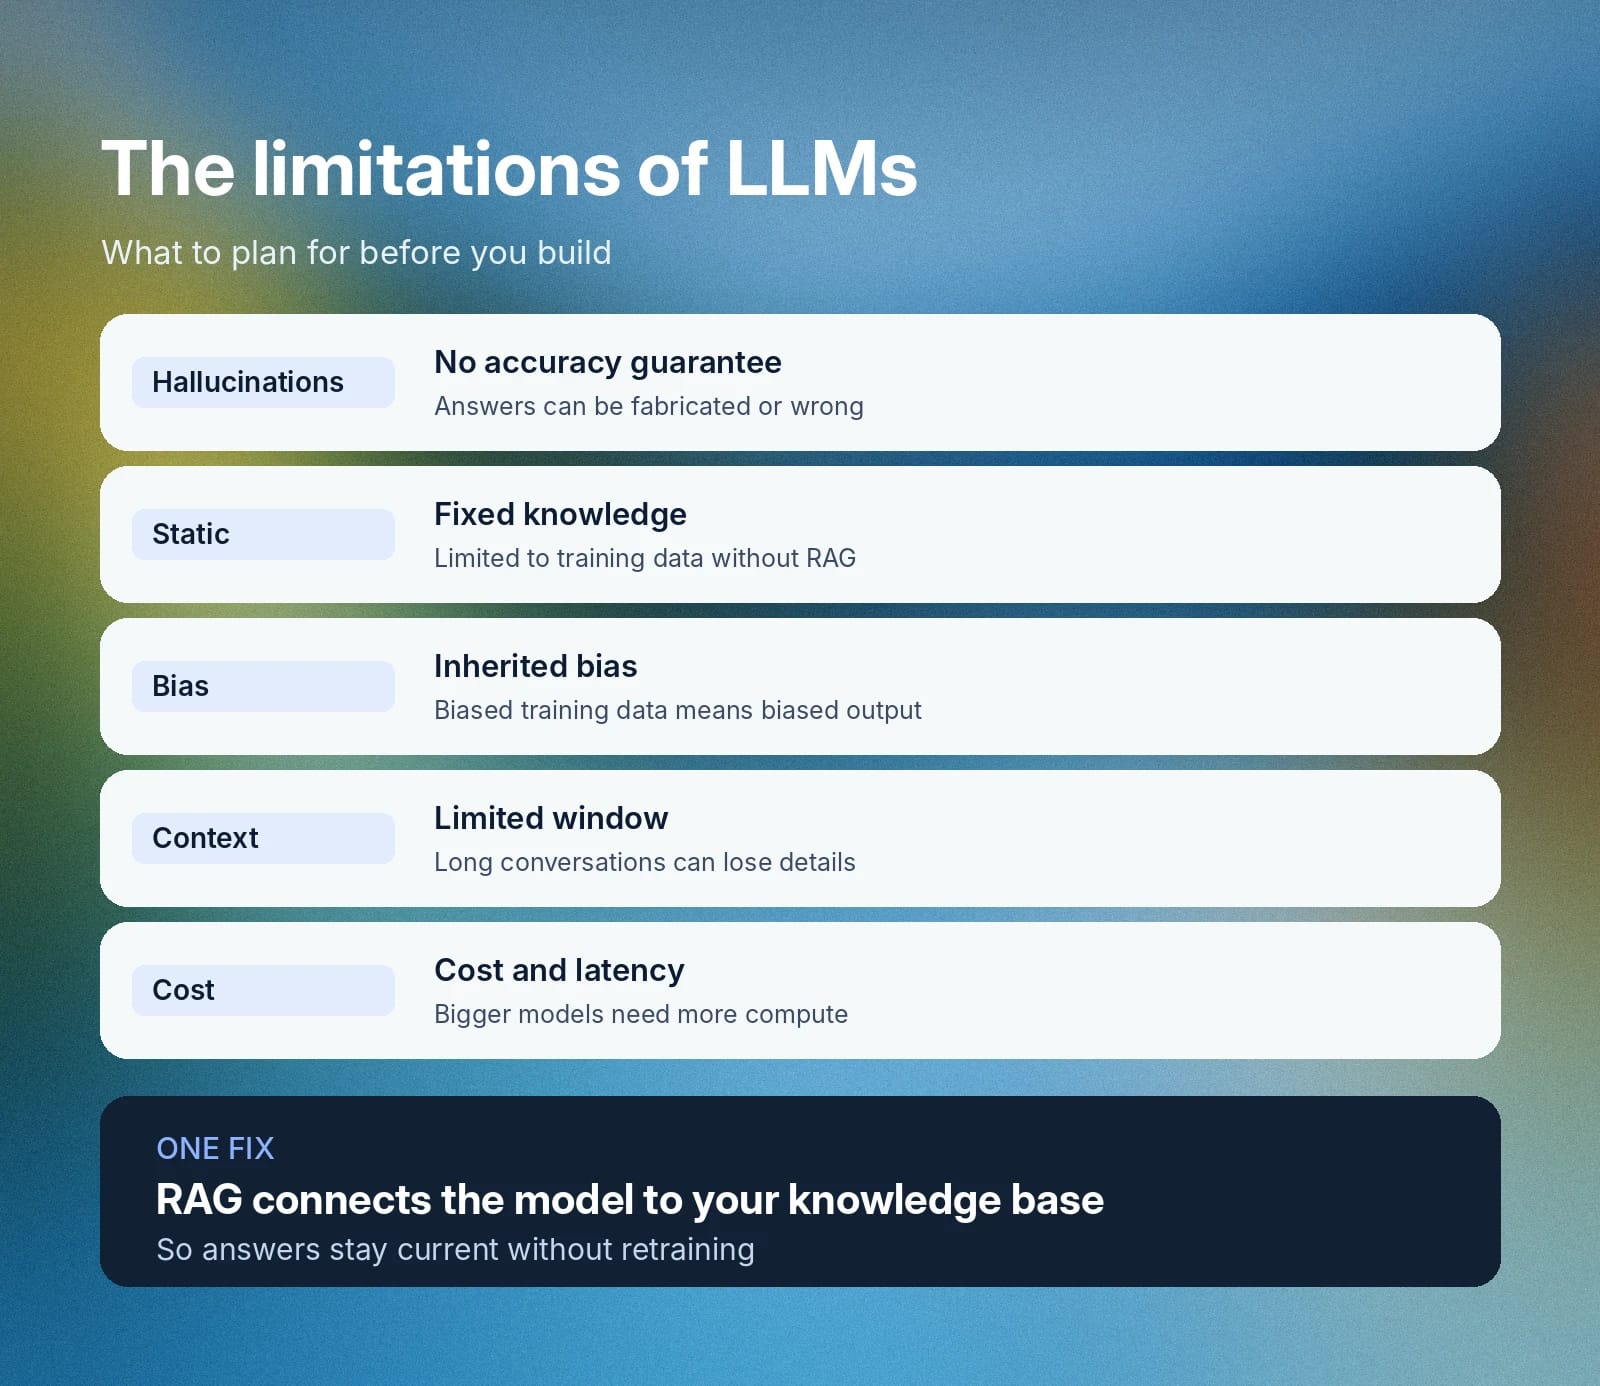
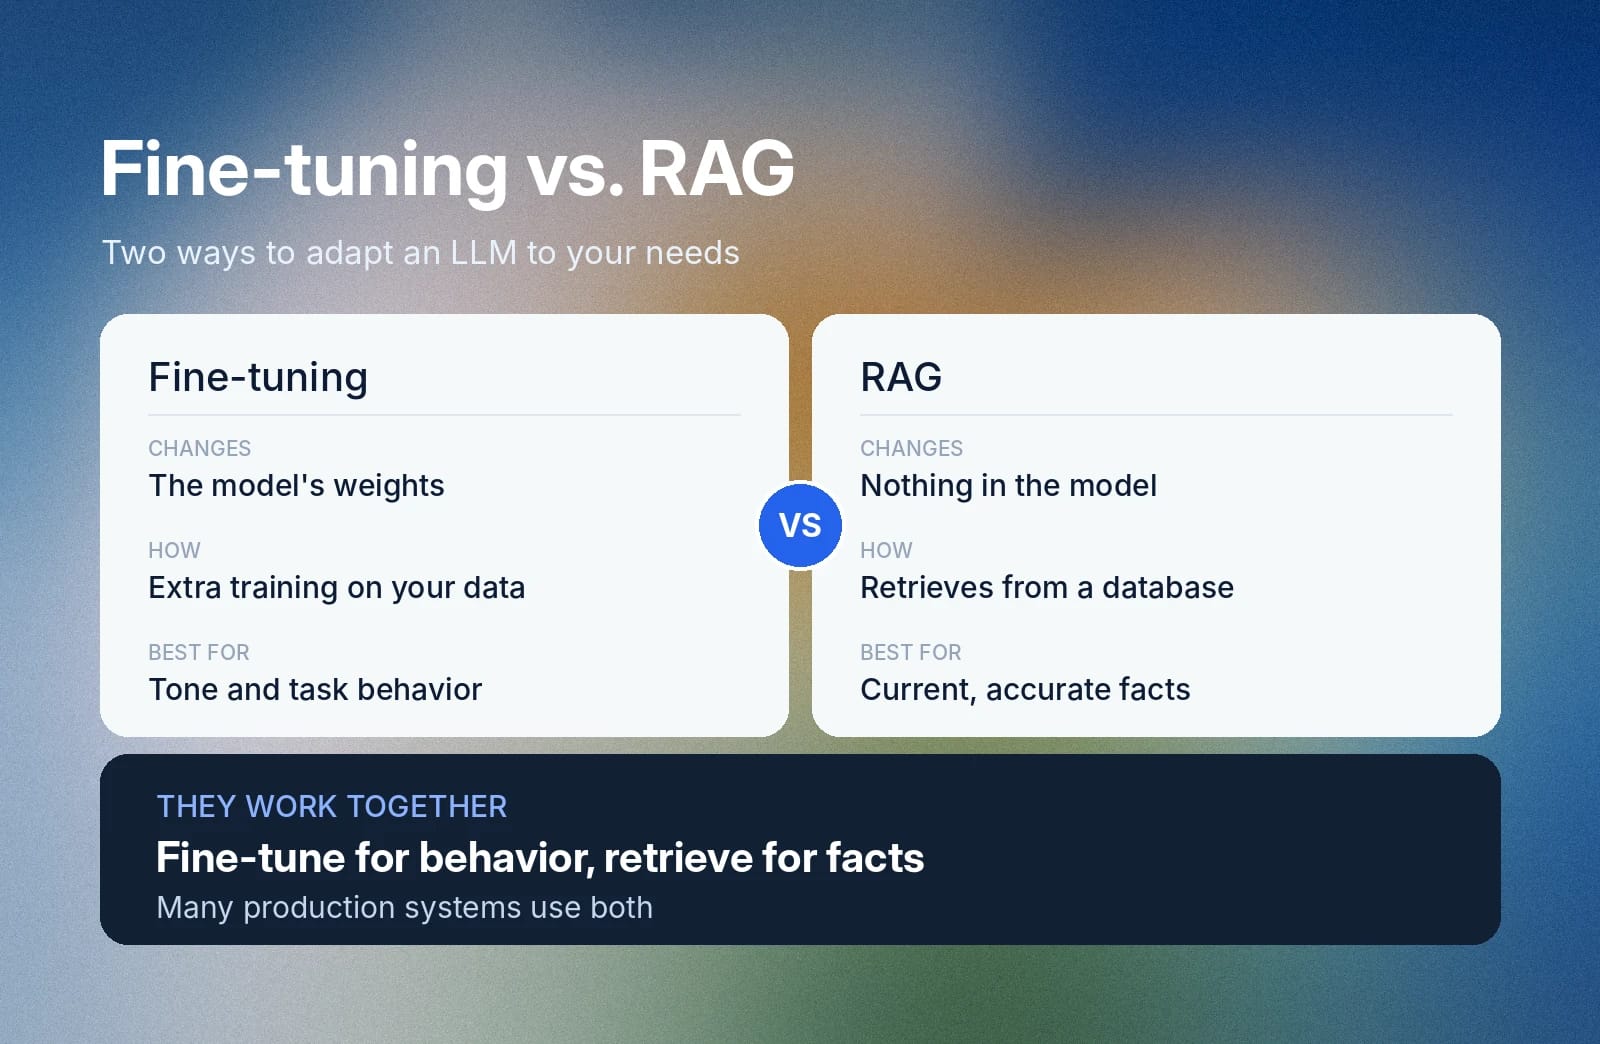
Det finns flera strategier och implementationer du kan använda för att minska effekten av dessa begränsningar. Att till exempel aktivera RAG i en LLM och ansluta en ständigt växande kunskapsbas skulle lösa problemet med statisk kunskap.
Bygg röstaktiverade LLM-upplevelser med ElevenAgents
Att välja en stor språkmodell för ditt användningsområde är ett viktigt beslut som du kan behöva justera när verksamhetens behov och även regelkrav förändras. Genom att undvika inlåsning hos en leverantör behåller du flexibilitet när du bygger konversationslösningar med AI-röst.
Med ElevenAgents kan du välja bland LLM:er som stöds från leverantörer som OpenAI, Anthropic och Google, eller ansluta din egen anpassade modell via en OpenAI-kompatibel endpoint. Det gör det enkelt att välja den bästa balansen mellan hastighet, resonemangsförmåga och kostnad för just dina behov.
Utforska ElevenAgents för att se hur driftade LLM:er effektiviserar röstbaserade arbetsflöden, eller kontakta säljteamet för att börja bygga dina röstagenter med låg latens redan i dag.
Vanliga frågor om LLM:er

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.


