
Vad är en vektordatabas? Så hittar AI-sökning betydelse
- Skriven av
- Jack Limebear
- Publicerad
LyssnaLyssna på den här artikeln
En vektordatabas är ett lagringssystem som låter AI-modeller söka i och hämta ostrukturerad data utifrån semantisk likhet. Den hjälper AI att skapa svar med kunskap som går utöver träningsdatan.
Vektordatabaser lagrar information i ett format som LLM:er enkelt kan bearbeta. De ger AI-modeller ytterligare information för att skapa relevanta och korrekta svar.
Den här guiden förklarar vad en vektordatabas är, hur den fungerar, vanliga användningsområden, typer, exempel och hur den jämförs med relations- och grafdatabaser.
Sammanfattning
- En vektordatabas lagrar inlärda funktionsrepresentationer som vektorinbäddningar i ett flerdimensionellt rum.
- Till skillnad från traditionella databaser som förlitar sig på nyckelordsmatchning hämtar vektordatabaser semantiskt liknande data vid sökningar.
- En vektor-DB lagrar interna dokument som hjälper röst-AI och kundtjänst att ge kontextmedvetna svar med hjälp av ett RAG-system.
- Applikationer som chattbottar, AI-sökmotorer och Conversational AI drar nytta av den semantiska sökningen och de ostrukturerade datatyper som vektordatabaser stöder.
- Vektor-DB:er skiljer sig från grafdatabaser. Grafdatabaser kopplar samman relaterade entiteter för att stödja flerstegssökningar med graftraverseringsalgoritmer, medan vektordatabaser passar enkla sökningar som kräver ytterligare kontext.
Vad är en vektordatabas och vad lagrar den?
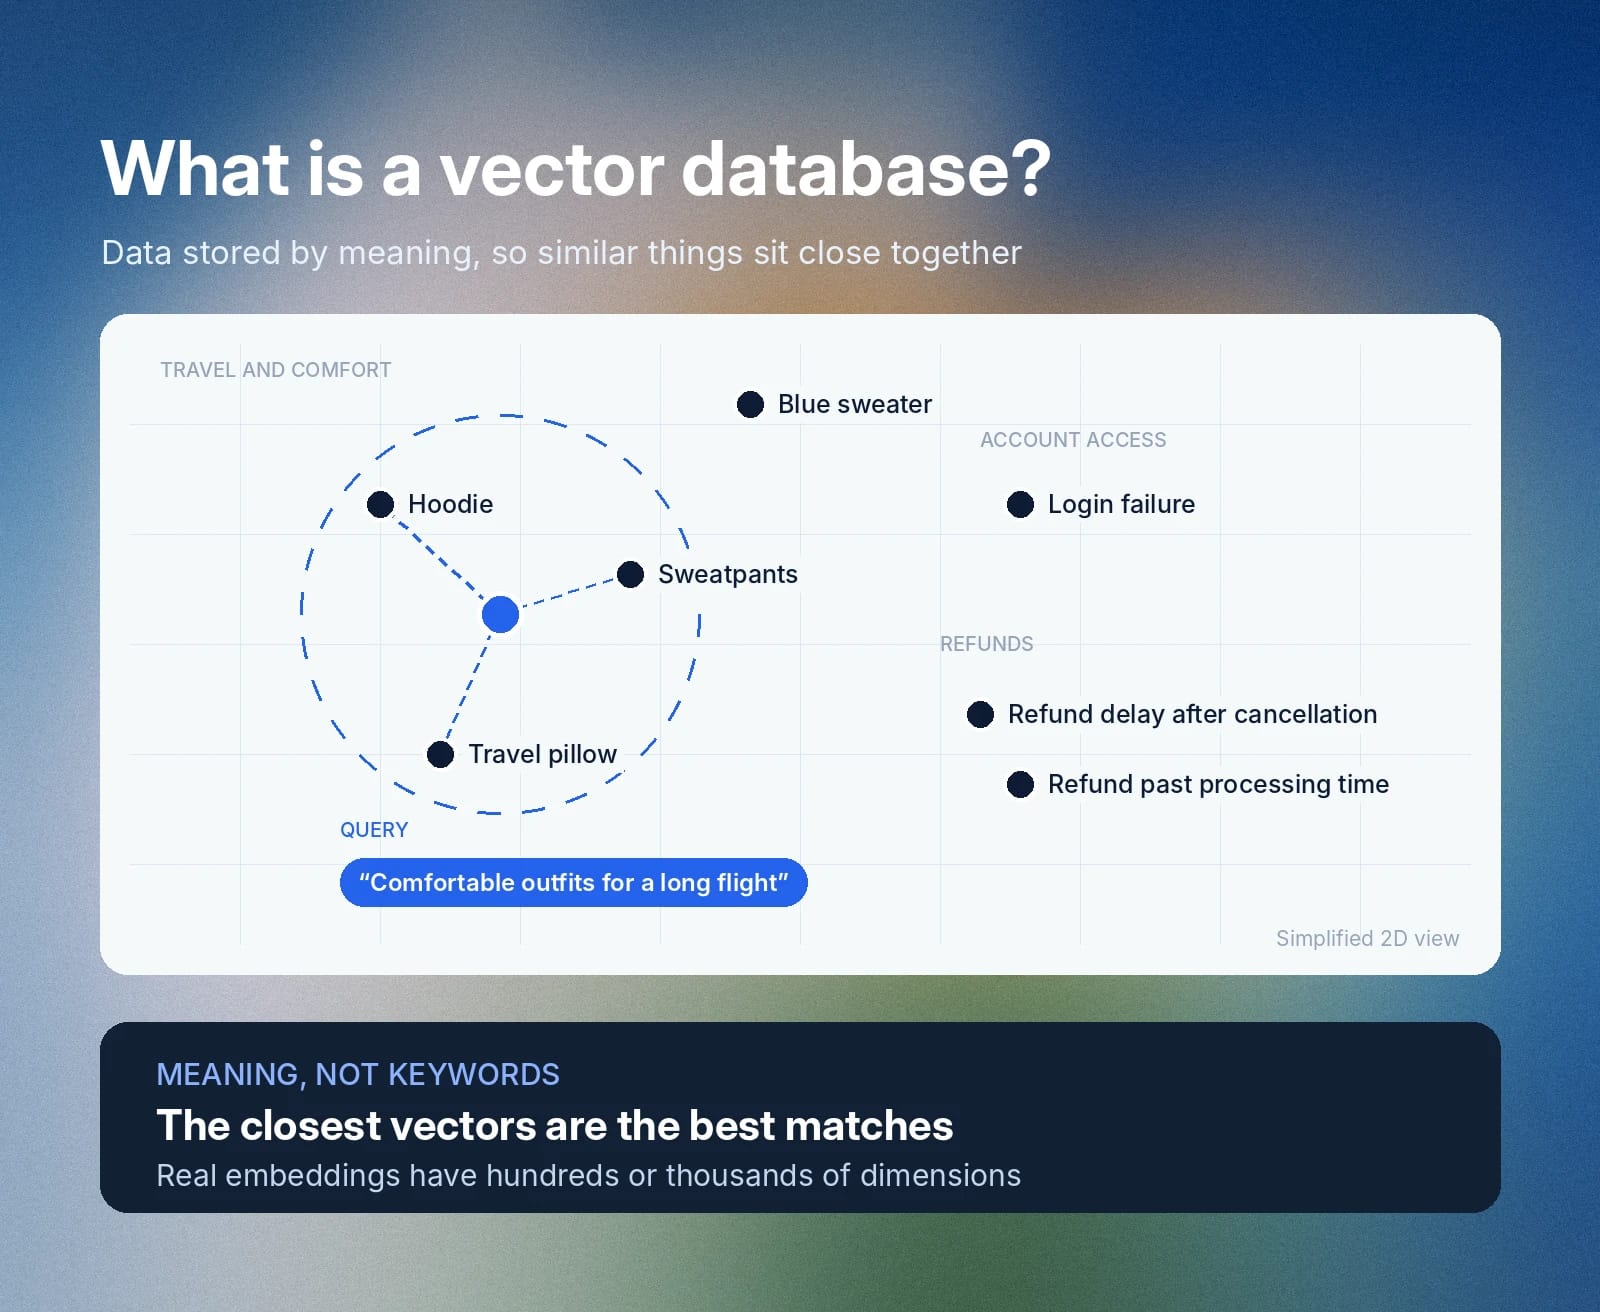
En vektordatabas lagrar data som numeriska representationer, så kallade inbäddningar, vilket möjliggör semantisk sökning med låg latens för AI-modeller. Till skillnad från en traditionell databas, som lagrar information i rader och kolumner, grupperar en vektor-DB inbäddningar i ett flerdimensionellt rum baserat på semantiska likheter.
Inom AI beskriver termen ”dimension” inlärda egenskaper eller kännetecken hos ett specifikt objekt. Du kan till exempel föreställa dig att en hund har dimensioner som pälsfärg och ras. I praktiken motsvarar enskilda dimensioner i en inlärd inbäddning sällan en enda läsbar egenskap.
Generativa AI-applikationer, särskilt sådana som ansluter till en extern kunskapskälla, använder en vektordatabas för att snabba upp hämtningen. I stället för att söka efter en direkt nyckelordsmatchning i en traditionell databas hittar hämtningssystemet de mest liknande inbäddningarna i vektor-DB:n.
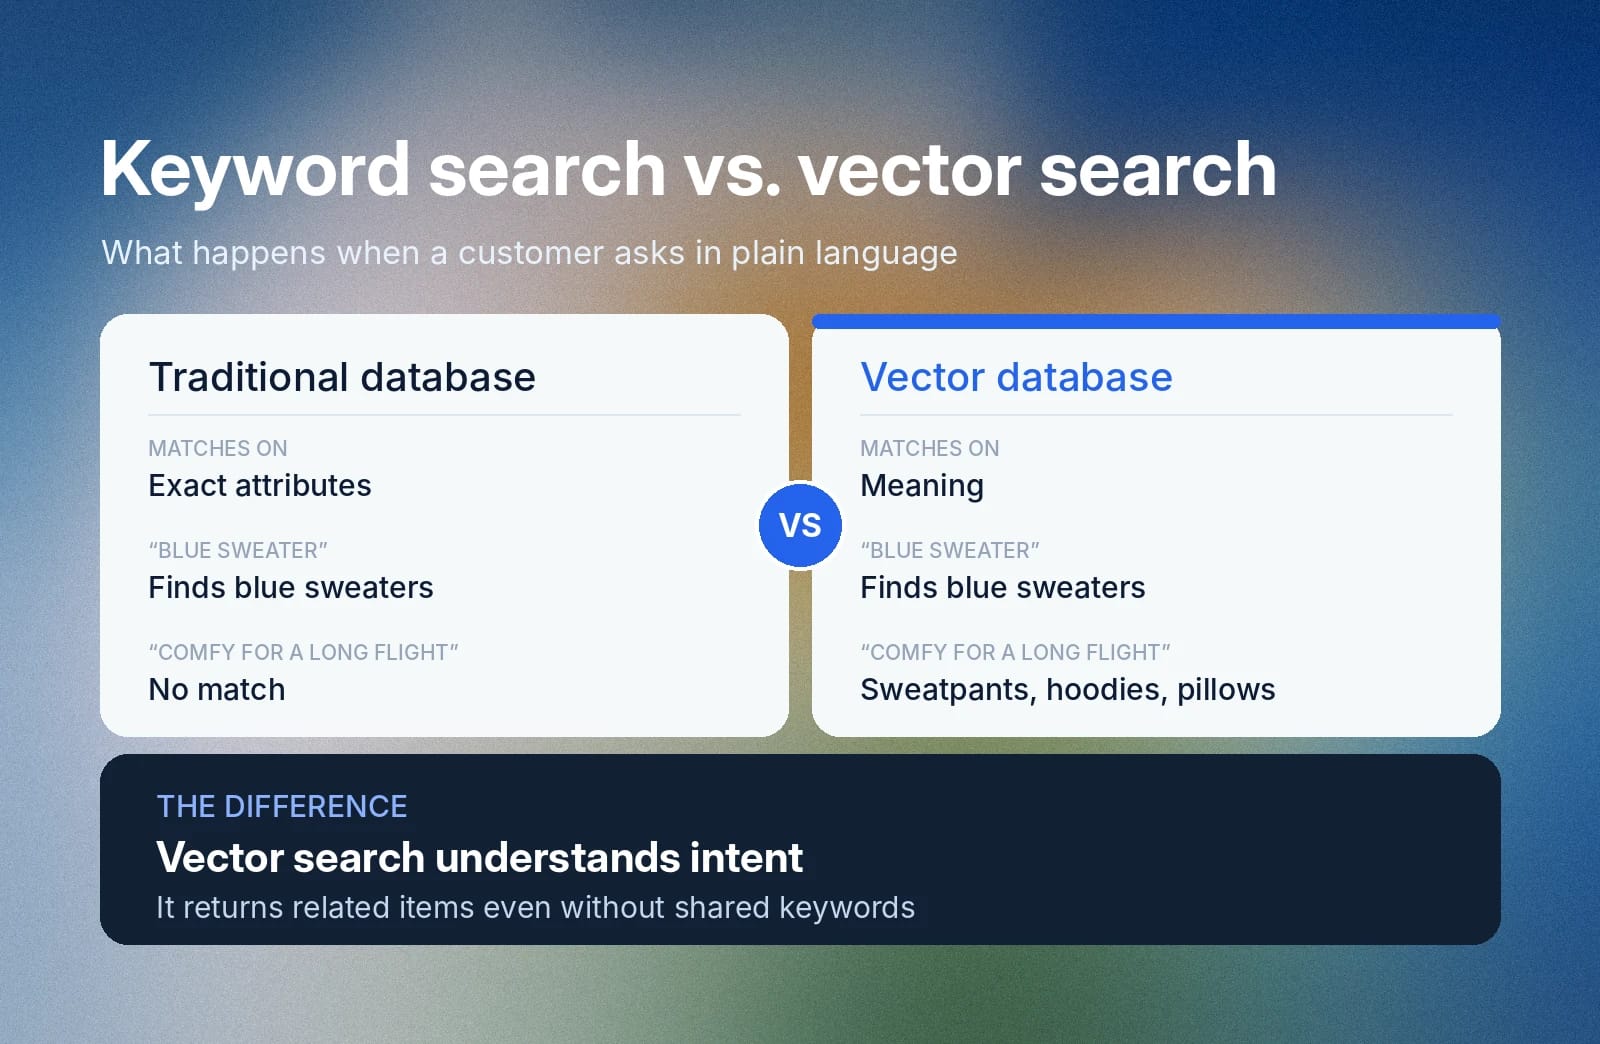
Säg att en kund ringer och ber dig rekommendera en ”blå tröja”. Med en traditionell databas letar du efter produkter som matchar attributen ”blå” och ”tröja”. Men om kunden vill ha ”kläder som känns bekväma under en lång flygresa” kan en traditionell databas inte ge ett svar.
En vektordatabas fångar däremot förfrågans semantiska betydelse. Genom att mappa den till vektorrummet returnerar systemet plagg som mjukisbyxor, hoodies och resekuddar, som har närbesläktade funktionsrepresentationer. Den här förmågan att matcha betydelse är det som skiljer en vektor-DB från en traditionell databas.
Vektorinbäddningar: gör röst, text och bilder till siffror
Vektorinbäddningar är talarrayer som representerar ostrukturerad data som text, bilder och video så att AI-modeller enkelt kan bearbeta den.
En vektor är den matematiska representationen av tal över olika dimensioner. En vektor fångar dock inte kontexten, strukturen och innebörden i ett specifikt dataset.
Till exempel är en lista med flyttal [0.82, 0.14, 0.67] en vektor, men vad den representerar avgörs av inbäddningsmodellen.
Inbäddningar fångar datans egenskaper och lagrar dem som en vektor i ett flerdimensionellt rum. De ger betydelse åt det som annars bara skulle vara en lista med siffror. Varje tal i vektorn är en dimension i den inlärda representationen.
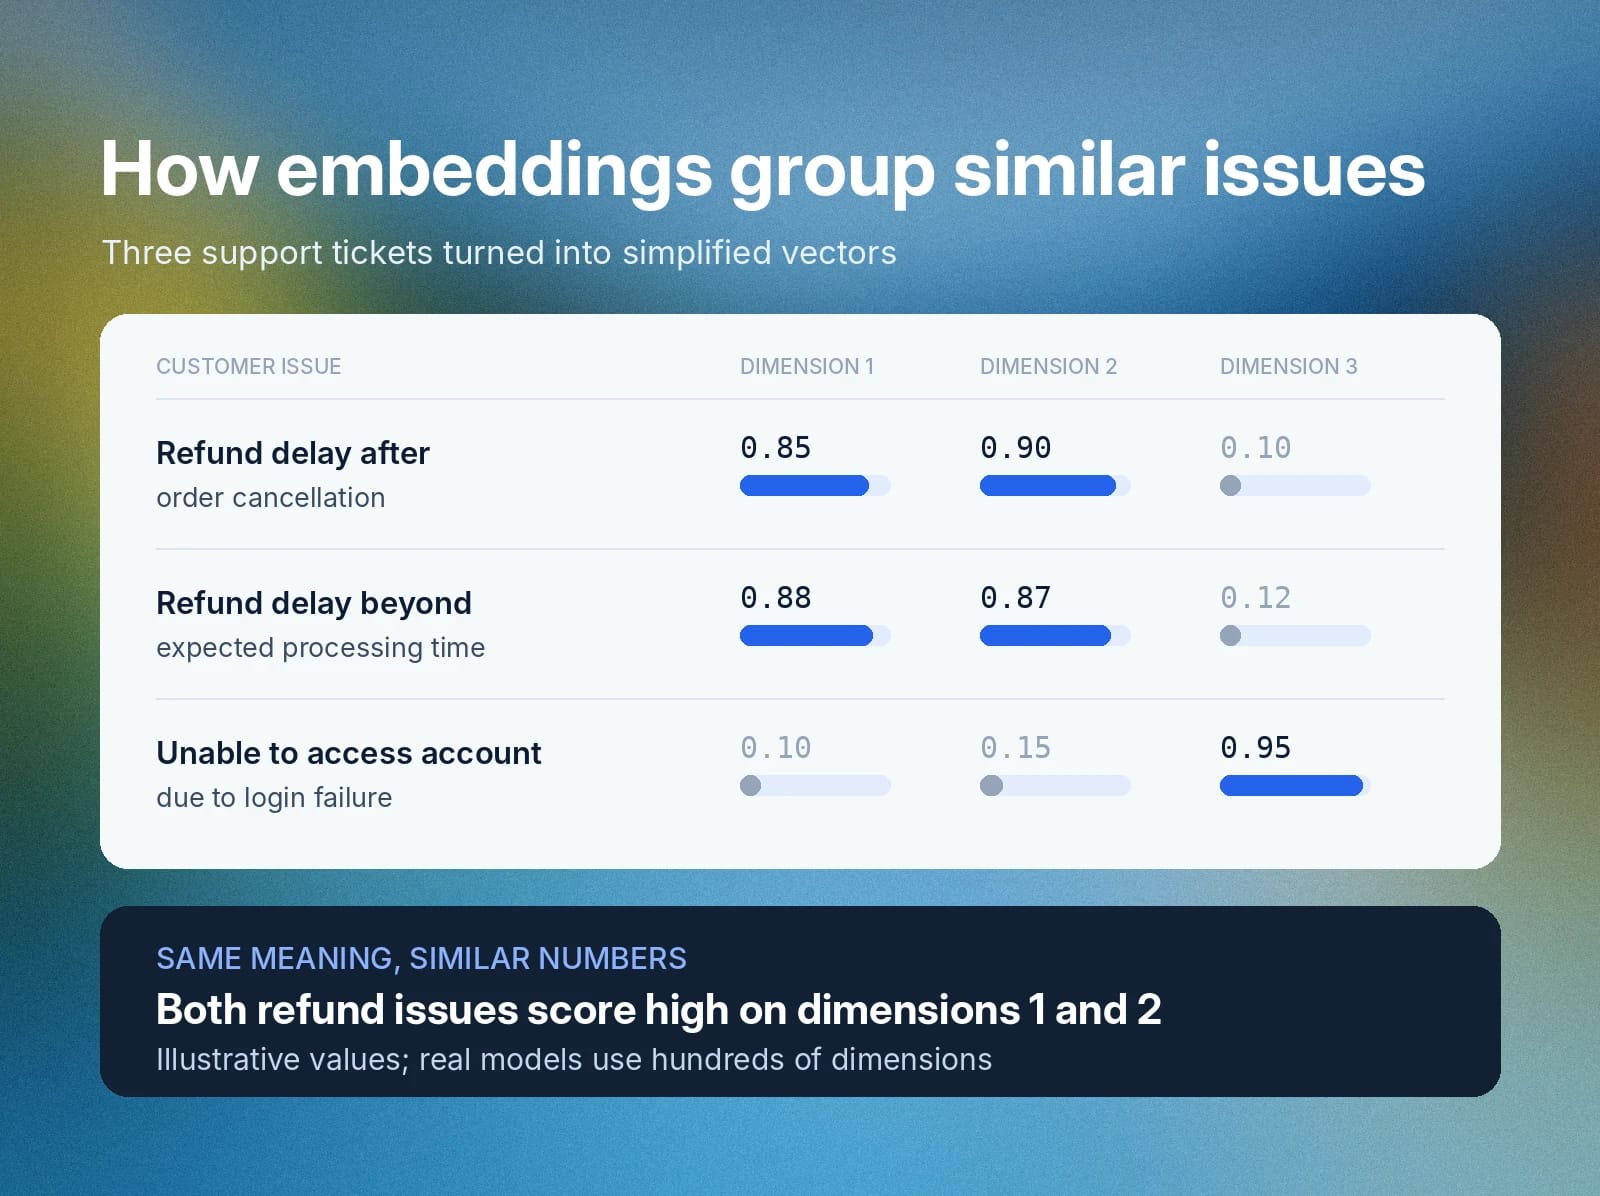
Säg att du vill lagra kundärenden i en vektor-DB. Med en inbäddningsmodell omvandlar du ärendetyper till inbäddningar med distinkta värden över olika dimensioner. Värdena nedan är förenklade i illustrativt syfte.
Kundärende
Inbäddningar
Försenad återbetalning efter orderannullering
[0.85, 0.90, 0.10]
Försenad återbetalning efter förväntad handläggningstid
[0.88, 0.87, 0.12]
Kan inte komma åt kontot på grund av inloggningsfel
[0.10, 0.15, 0.95]
Båda återbetalningsärendena har, trots olika orsaker, högre siffror i den första och andra dimensionen, medan inloggningsärendet har sitt högsta tal i den tredje. Inbäddningsmodeller producerar vanligtvis hundratals eller tusentals dimensioner, vilket är anledningen till att vektordatabaser är byggda för att snabbt jämföra dem.
Hur fungerar vektordatabaser?
Vektordatabaser omvandlar ostrukturerad data till inbäddningar, lagrar dem i ett flerdimensionellt rum och möjliggör sökning efter semantisk likhet. Inbäddningar som är nära kopplade till varandra har i viss utsträckning ett mindre avstånd i vektorrummet.
När vektordatabasen tar emot en fråga använder den approximate nearest neighbor-algoritmer (ANN) för att hämta de mest liknande inbäddningarna utan att genomsöka hela databasen.
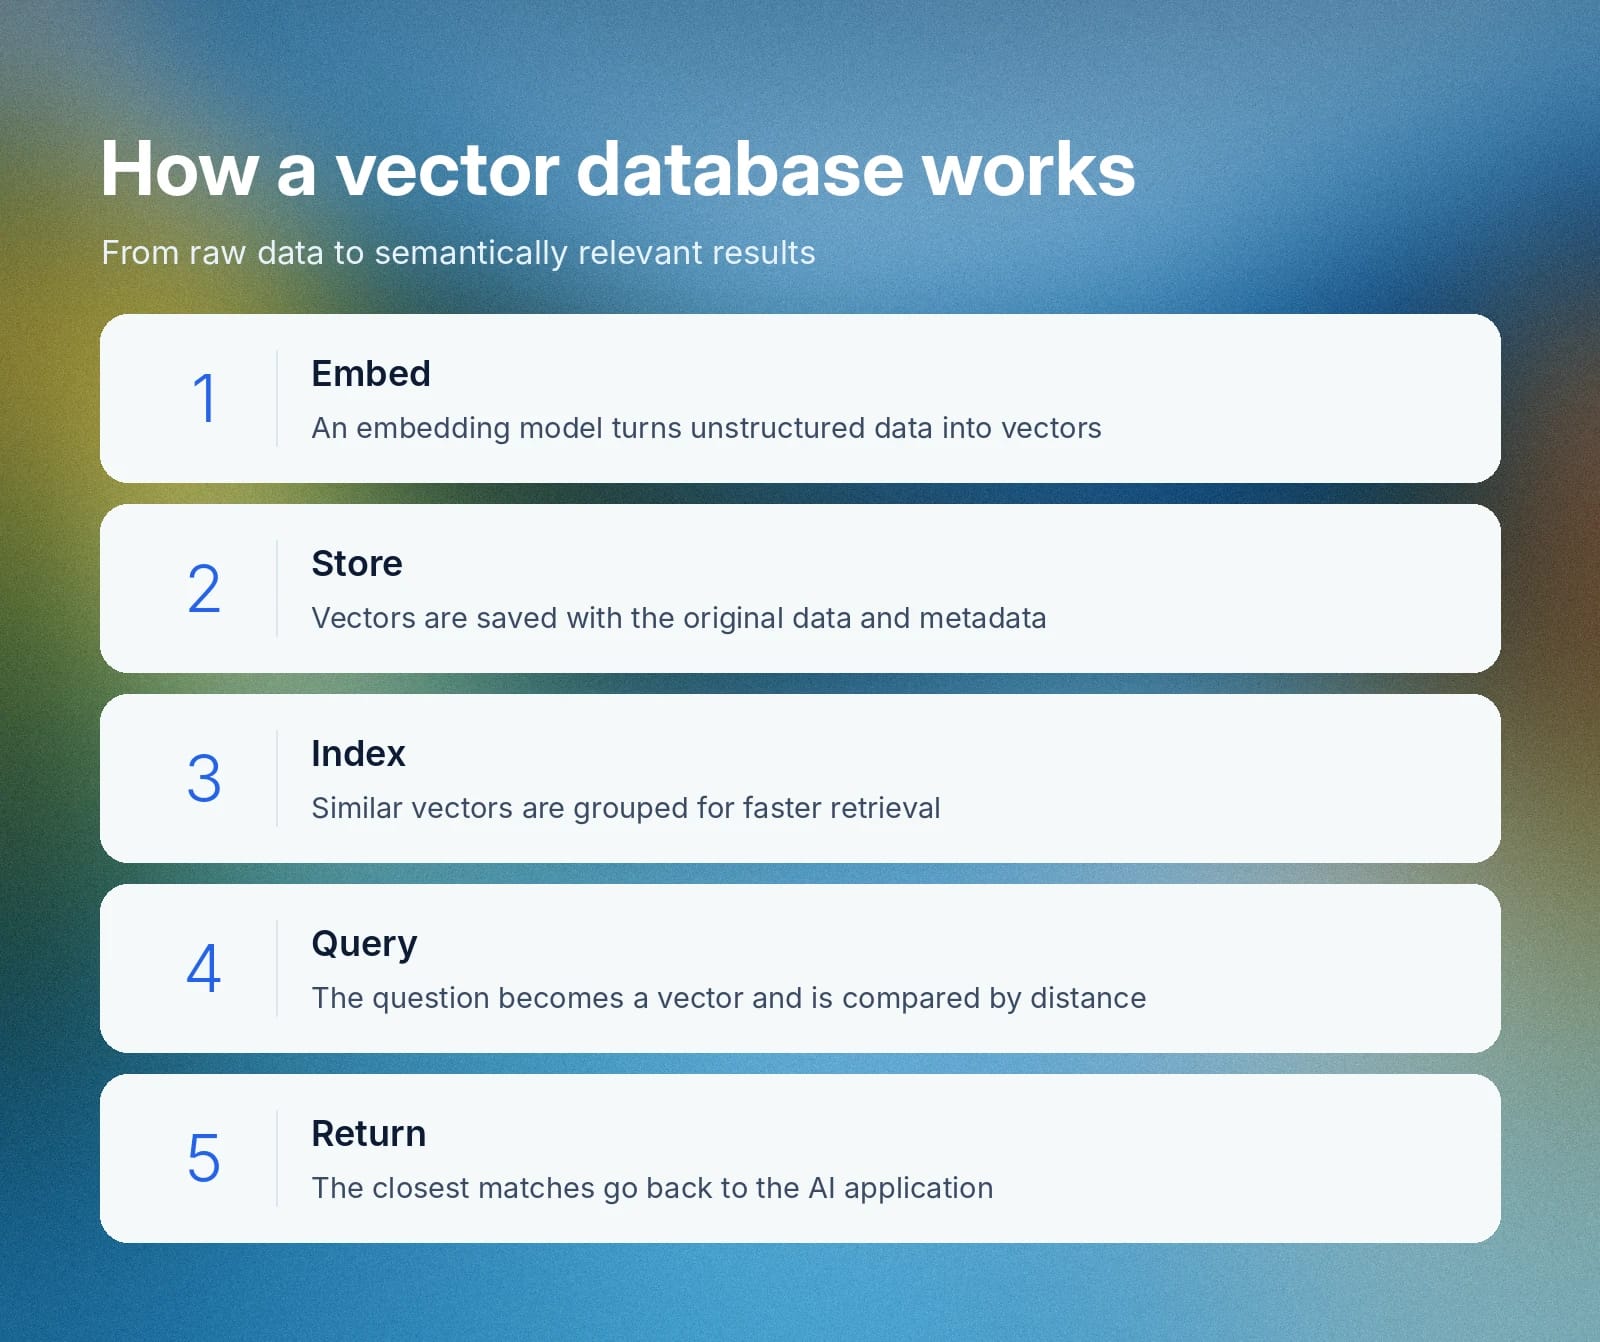
Här är stegen för att konfigurera och hämta data från en vektordatabas.
Lagring av inbäddningar
Först omvandlar en inbäddningsmodell ostrukturerad data till inbäddningar. Varje inbäddning representerar egenskaper som bär den semantiska innebörden hos objektet i verkligheten. Därefter lagrar systemet inbäddningarna, tillsammans med originaldata och metadata, i vektor-DB:n.
Eftersom inbäddningar med liknande betydelse ligger nära varandra i vektorrummet kan databasen hämta relevanta matchningar genom att mäta avståndet mellan vektorer.
Indexering för snabbare hämtning
Indexering är en process som organiserar vektorinbäddningarna för att effektivisera hämtningen. Vektordatabaser använder flera indexeringstekniker för att gruppera nära relaterade inbäddningar. En vektor-DB kan till exempel använda en list-, graf- eller trädstruktur, beroende på hämtningskraven.
Utöver indexering kan vektor-DB:n komprimera data med en teknik som kallas produktkvantisering. Produktkvantisering komprimerar inbäddningar till kompakta koder, vilket sparar minne till priset av en liten försämring i sökprecisionen.
Söka efter semantiskt relevanta data
När vektordatabasen tar emot en fråga omvandlar den den till en inbäddning. Därefter jämför den frågans inbäddning med dem som lagras i vektorns flerdimensionella databas med tekniker som cosinuslikhet, skalärprodukt och euklidiskt avstånd.
Baserat på resultaten returnerar vektordatabasen inbäddningar med närmast semantisk likhetspoäng, som generativa AI-applikationer använder för att komplettera sina svar. Tillsammans gör lagring, indexering och frågor att databasen snabbt kan returnera relevanta resultat.
Hur vektorsökning och likhetssökning returnerar relevanta resultat
Likhetssökning är en bred kategori av system för informationsmatchning. Den omfattar nyckelordsbaserade metoder som matchar de exakta orden i en fråga, samt vektorsökning, som matchar utifrån betydelse.
Vektorsökning använder en vektordatabas för att returnera semantiskt relaterade svar. I stället för att göra en exakt nyckelordssökning jämför vektorsökningen avståndet mellan frågan och svarskandidaterna för att välja det mest lämpliga resultatet.
Vektor-DB:n använder ofta metadata för att förfiltrera inbäddningarna innan den kör en likhetssökning. Den kan till exempel begränsa sökningen genom att filtrera inbäddningar inom en viss tidsperiod. På så sätt går hämtningen snabbare.
Användningsområden för vektordatabaser inom röst-AI och kundtjänst
Vektordatabaser hjälper kundtjänstteam att använda röst-AI och chattbottar som kan svara med korrekt produktkunskap. I ett AI-drivet kundtjänstsystem lagrar vektordatabasen egna kunskapsbaser, såsom produktguider, företagspolicyer och kundärenden.
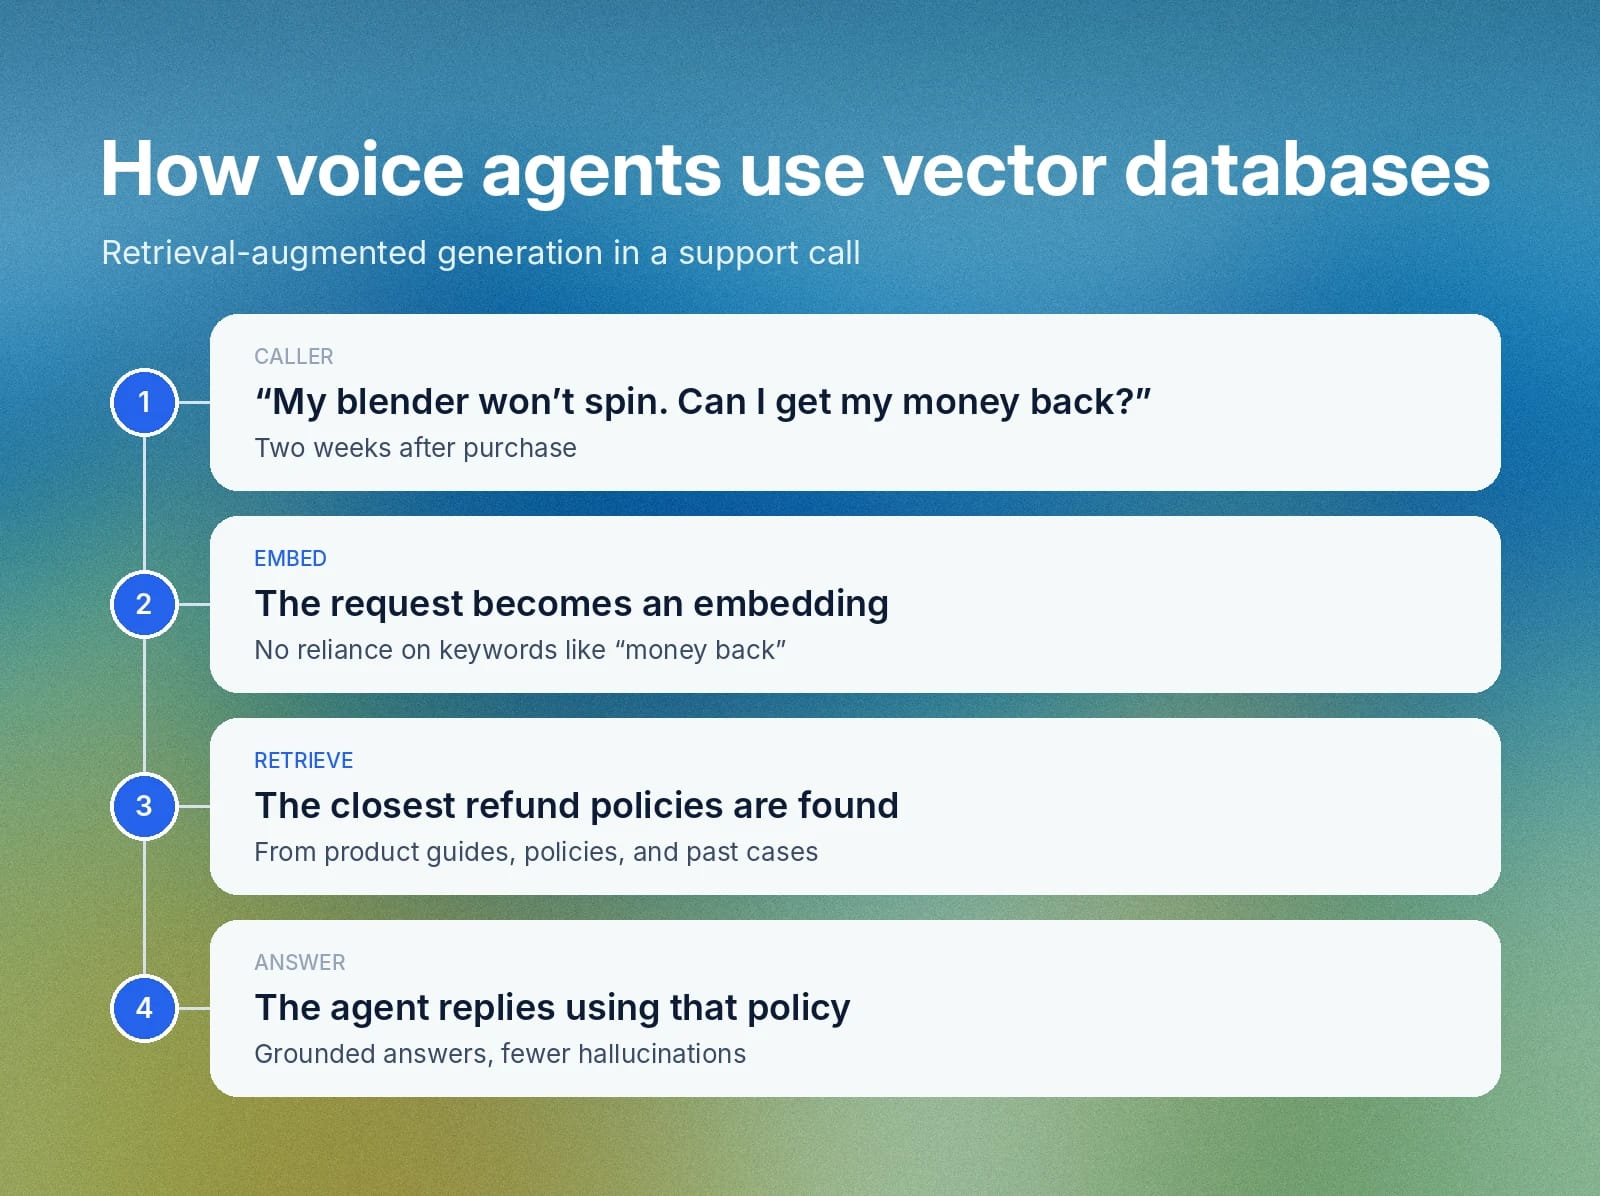
AI-agenten ansluter till vektor-DB:n med ett system för hämtningsförstärkt generering (RAG) .
När AI-röstagenten tar emot en fråga kontrollerar den om den har tillräckligt med information för att svara kunden. Om den saknar aktuell eller tillräcklig data hämtar RAG:en semantiskt matchande data för att komplettera svaret.
Säg att en röstagent tar emot följande klagomål: ”Min mixer snurrar inte efter två veckor. Kan jag få pengarna tillbaka?” I stället för att söka efter exakta nyckelord som ”snurrar inte” och ”pengarna tillbaka” omvandlar RAG:en förfrågan till en inbäddning. Sedan hämtar den återbetalningspolicyer med närmast betydelse.
Genom att hämta relevanta interna dokument hjälper ett RAG-system med stöd av en vektordatabas till att minska hallucinationer i röstagenter, även om det inte eliminerar dem. I stället för att gissa kan både AI-agenter och mänskliga agenter använda interna dokument för att lösa kundfrågor.
Vektordatabas jämfört med relationsdatabas: viktiga skillnader
En relationsdatabas använder rader och kolumner tillsammans med ett fast schema för att lagra data. En vektor-DB använder i stället inbäddningar som representerar ostrukturerad data.
Relationsdatabaser lämpar sig för exakta matchningar och strukturerade frågor, som att hitta varje order som lagts ett visst datum. Vektordatabaser hämtar däremot de lagrade inbäddningar vars betydelse ligger närmast frågan, vilket är effektivare för frågor på naturligt språk.
Oftast använder team båda, eftersom de fyller olika funktioner vid arbete med data.
Vektordatabas jämfört med grafdatabas: när ska du använda vilken?
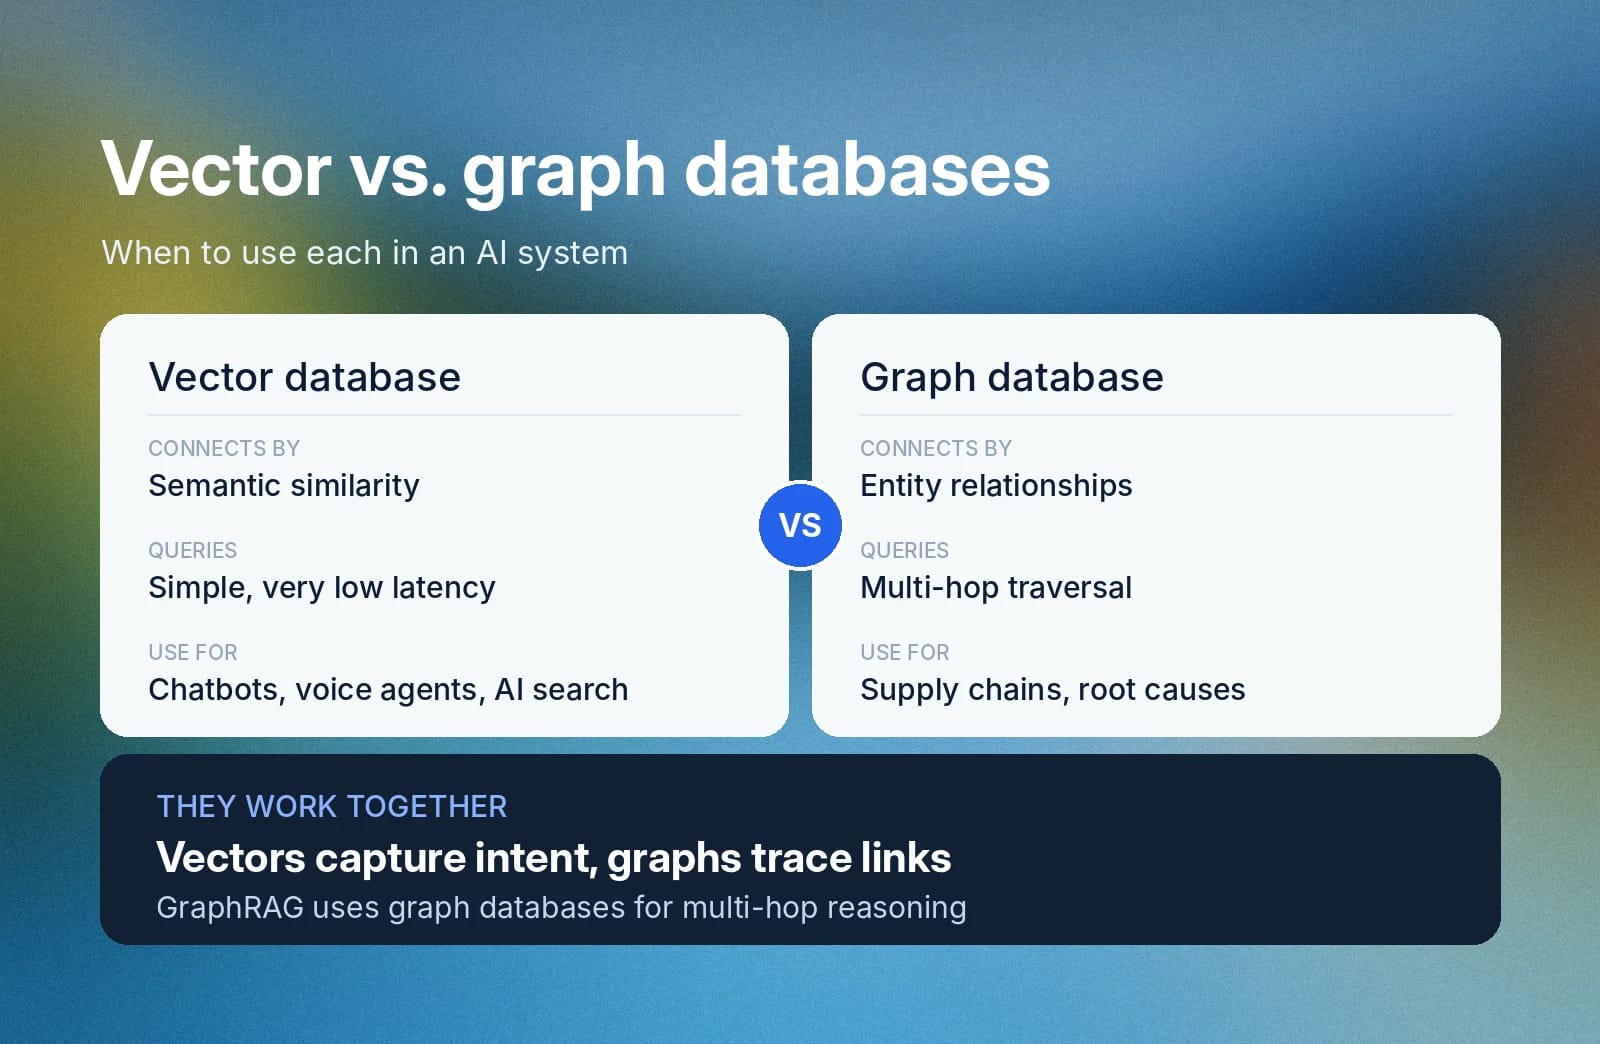
Grafdatabaser använder kunskapsgrafer för att koppla samman olika entiteter på sätt som återspeglar deras hierarki och relationer. AI-system som GraphRAG använder grafdatabaser för att svara på frågor som kräver resonemang i flera steg.
När du frågar en grafdatabas hittar den startdatapunkten och använder en graftraverseringsalgoritm för att hitta relaterade entiteter. Kundnamn kan till exempel kopplas till förnyelsedatum och supportärenden i följd.
Vektordatabaser lagrar däremot ostrukturerad data som numeriska representationer utifrån dess semantiska betydelse. De låter RAG-system utföra enkel frågematchning med mycket låg latens. En vektor-DB kan till exempel ta fram återbetalningspolicyn när den behandlar ”Jag vill ha en återbetalning.”
Både vektor- och grafdatabaser är användbara för AI-system. Du kan använda dem tillsammans:
- Använd en vektor-DB när du vill driva en chattbot, röstagent eller AI-sökmotor som måste förstå avsikten i mänskligt språk.
- Använd en grafdatabas när du vill lösa frågor om beroenden, som att spåra leveranskedjor, rekommendera relevanta produkter eller utföra rotorsaksanalys.
Vilka typer av vektordatabaser finns?
Generellt finns det två typer av vektordatabaser, som skiljer sig åt genom sin arkitektur.
- Fristående vektor-DB: Det här är oberoende, specialbyggda databaser som stöder flerdimensionella likhetssökningar med låg latens. Många generativa AI-applikationer ansluter till fristående vektor-DB:er för att skala krävande frågebelastningar.
- Vektordatabastillägg: Befintliga databaser kan lägga till funktioner för vektorsökning för att möjliggöra semantisk hämtning för AI-modeller. Dessa databaser behåller sin ursprungliga arkitektur, till exempel ett radbaserat SQL-schema, men har stöd för vektordatatyper.
Valet mellan dem beror främst på om du behöver ett dedikerat system för stora frågebelastningar eller om du vill lägga till semantisk sökning i en databas som du redan använder.
Exempel på vektordatabaser
Här är två exempel på vektor-DB:er:
- Fristående vektor-DB:er: Pinecone är en hanterad tjänst för vektordatabaser. Milvus, Weaviate, Qdrant och Chroma är vektordatabaser med öppen källkod.
- Vektor-DB-tillägg: pgvector lägger till vektorlikhetssökning i PostgreSQL, och MongoDB Atlas Vector Search lägger till det i MongoDB.
Vilken som passar beror på din skala och hur mycket infrastruktur du vill hantera.
Kom igång med ElevenAgents för röstagenter med stöd för hämtning
ElevenAgents låter röstagenter hämta information från din egen kunskapsbas för att ge konversationsbaserade, kontextmedvetna svar. Med RAG hämtar agenten det semantiskt mest liknande innehållet från de dokument, URL:er eller den text du lägger till i kunskapsbasen. Du kan ställa in hämtning på ”Vid behov”, så att agenten bara söker i kunskapsbasen när den bedömer att den behöver det.
Det är förståeligt att RAG ökar latensen för att generera svar. Tack vare våra tekniska framsteg har vi dock minskat medianlatensen för ElevenAgents RAG från 326 ms till 155 ms.
Kom igång med ElevenAgents och läs hur du konfigurerar din kunskapsbas här.
Vanliga frågor

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.


