Möt Scribe
- Publicerad
Scribe, vår första Speech to Text-modell, är världens mest exakta transkriberingsmodell. Scribe är byggd för att hantera oförutsägbarheten i ljud från verkligheten och transkriberar tal på 99 språk med tidsstämplar på ordnivå, talarseparering och taggning av ljudhändelser – allt levererat i ett strukturerat svar för smidig integrering.
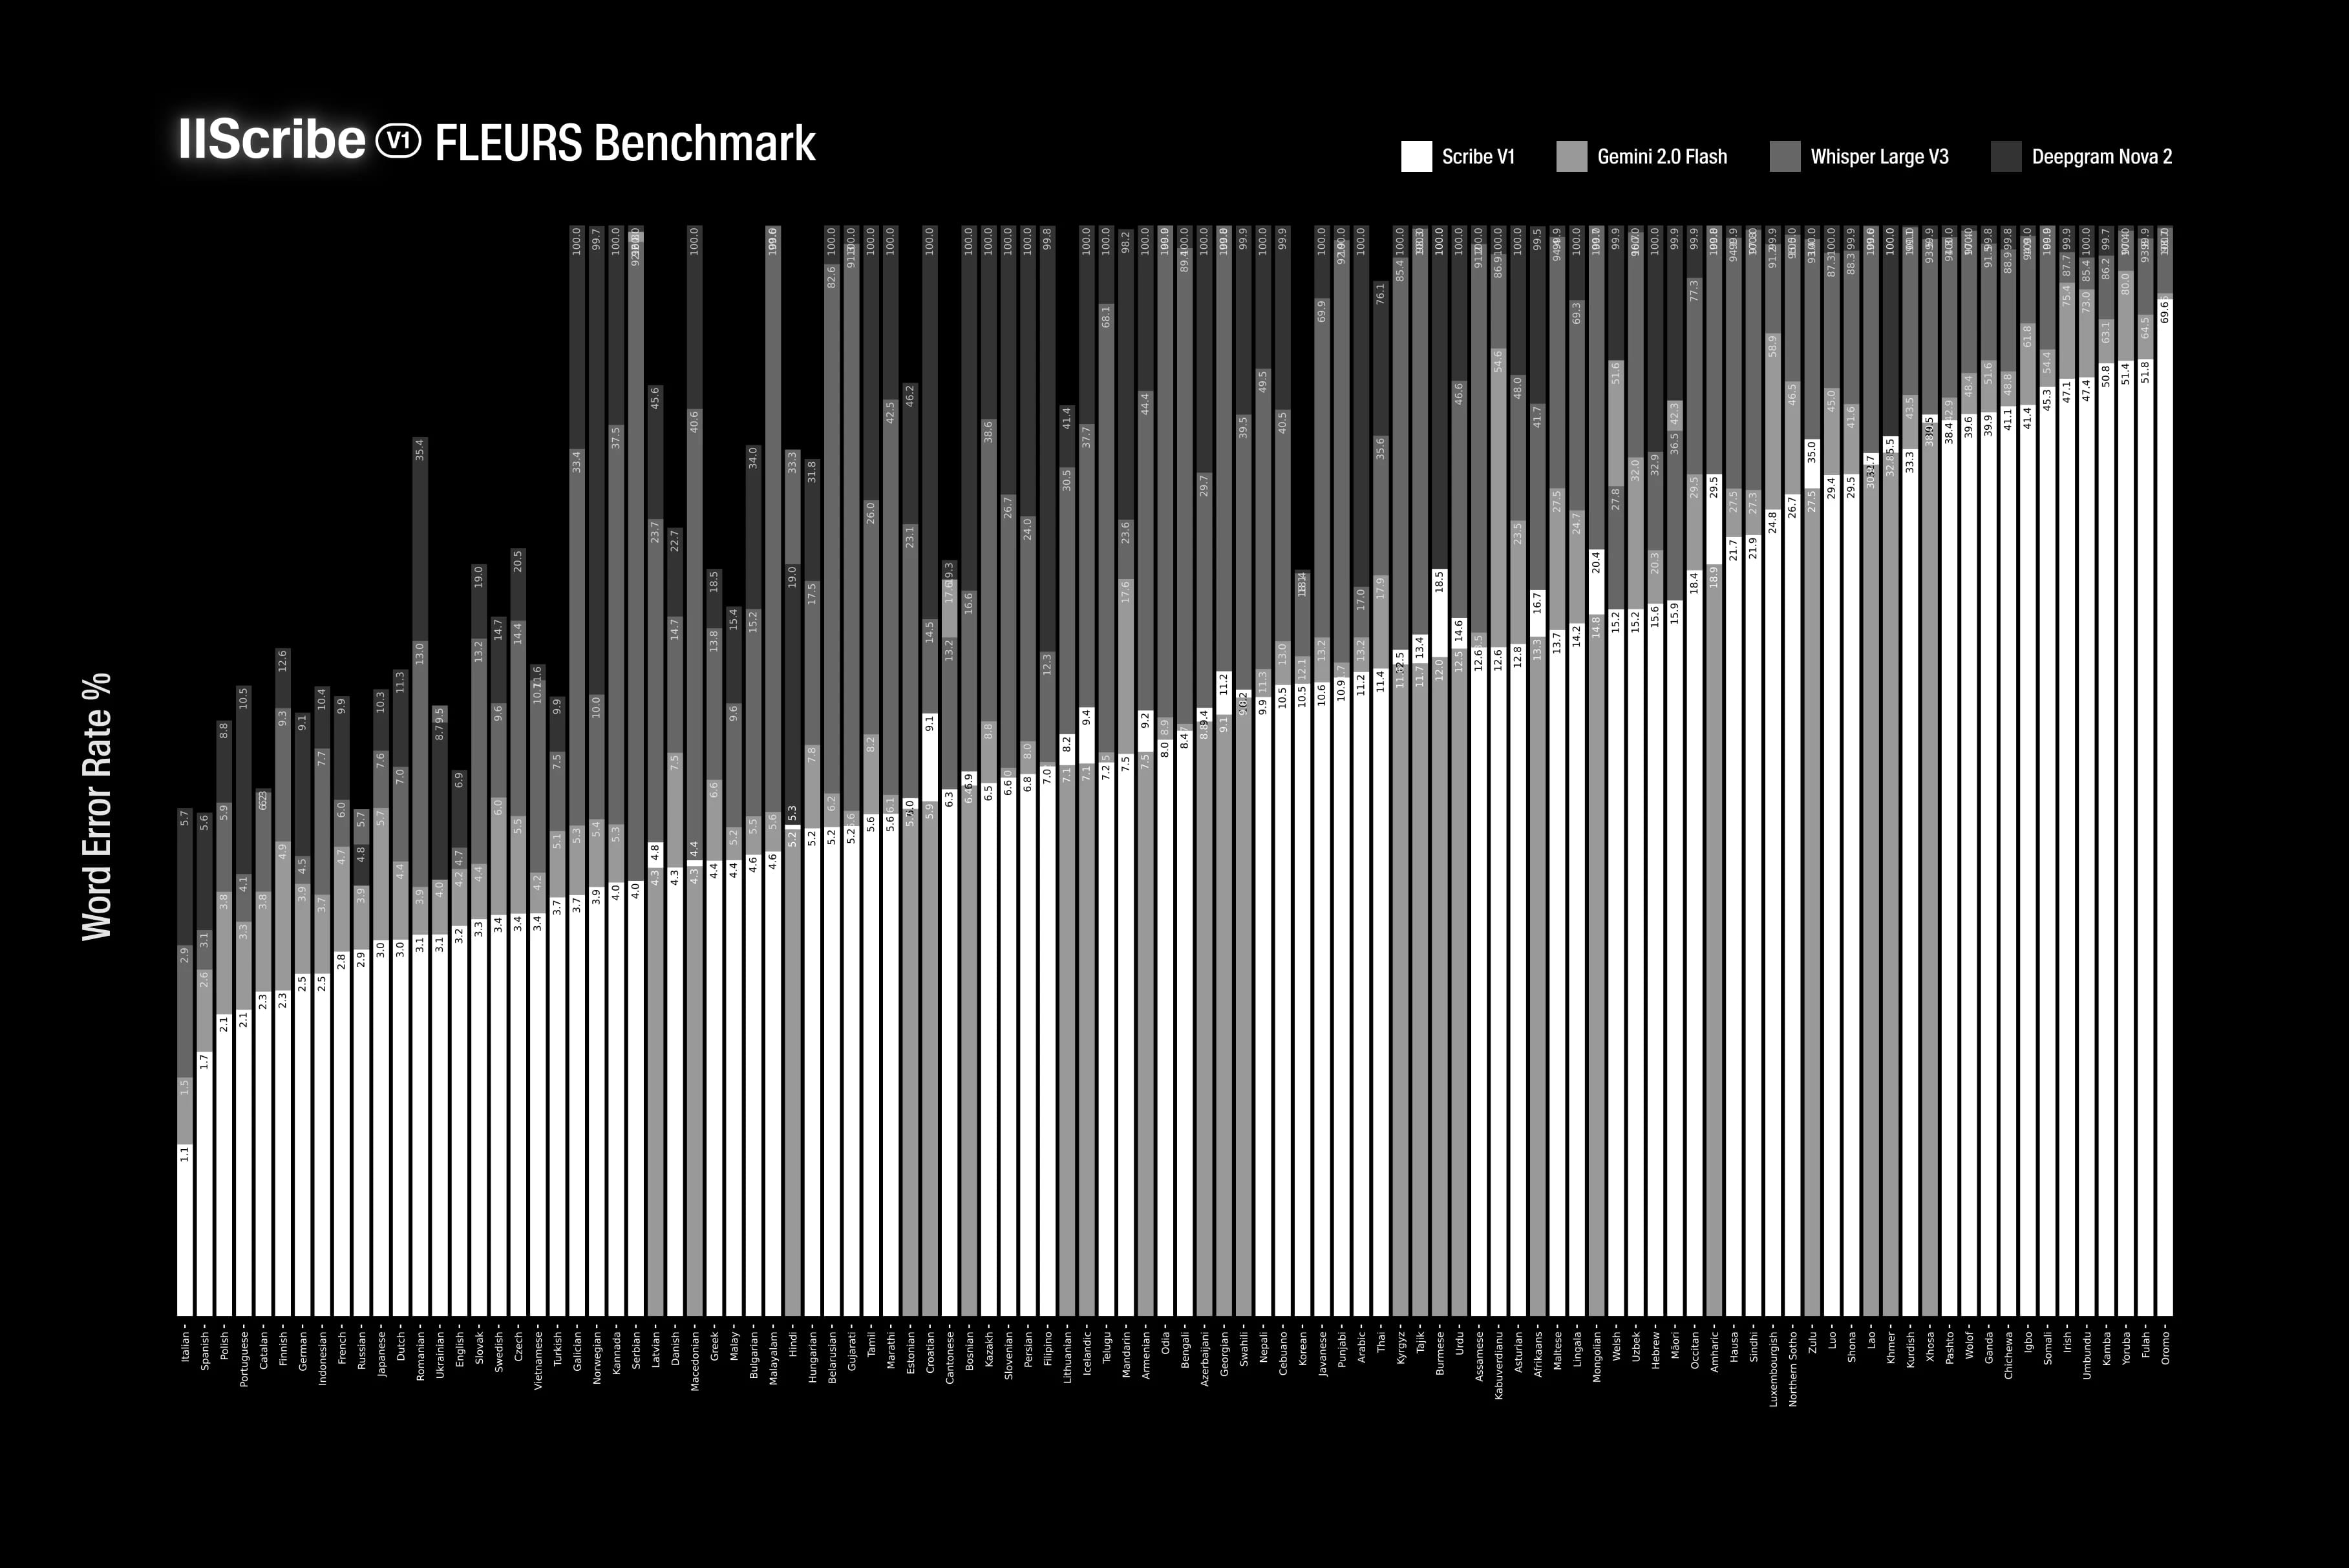
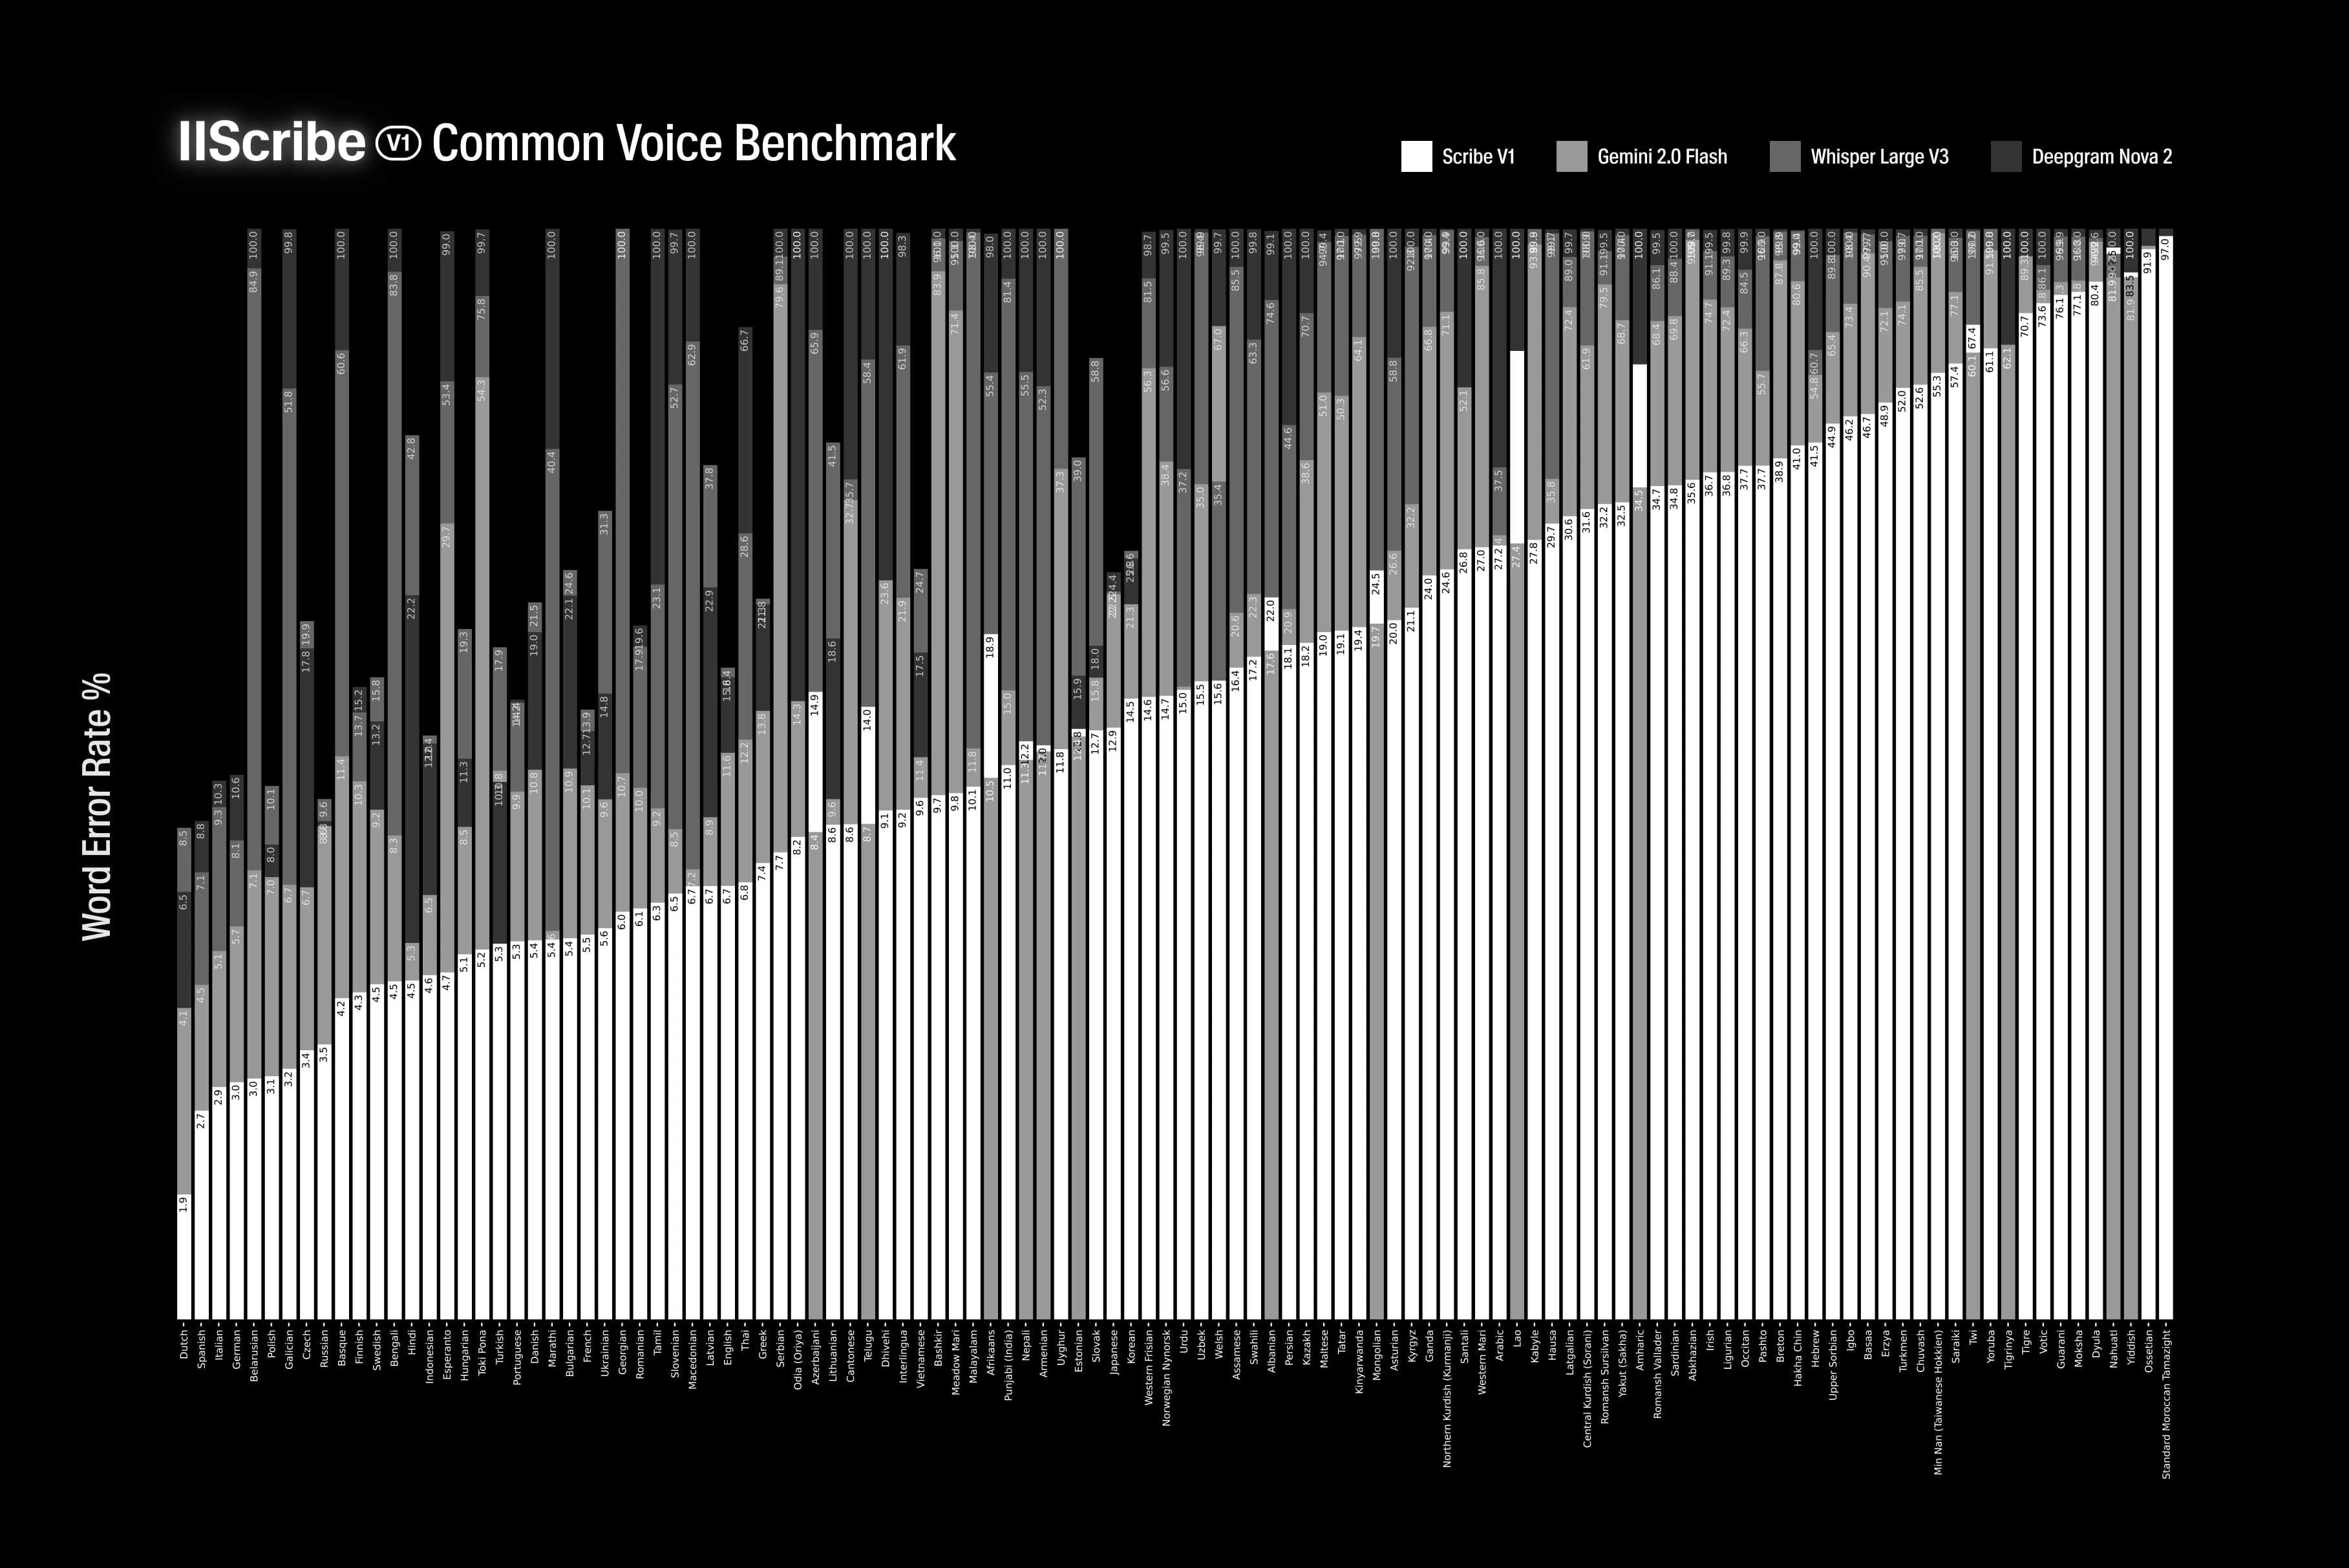
Scribe är utvecklad för precision. I benchmarktester med FLEURS & Common Voice på 99 språk överträffar den konsekvent ledande modeller som Gemini 2.0 Flash, Whisper Large V3 och Deepgram Nova-3. Oavsett om det gäller mötessammanfattningar, filmundertexter eller till och med sångtexter ger Scribe den lägsta automatiserade ordfelsfrekvensen vid transkribering på italienska (98,7 %), engelska (96,7 %) och 97 andra språk.
Scribe gör ASR tillgängligt för alla och minskar dramatiskt antalet fel i språk som traditionellt fått mindre stöd, som serbiska, kantonesiska och malayalam, där konkurrerande modeller ofta har en ordfelsfrekvens på över 40 %.
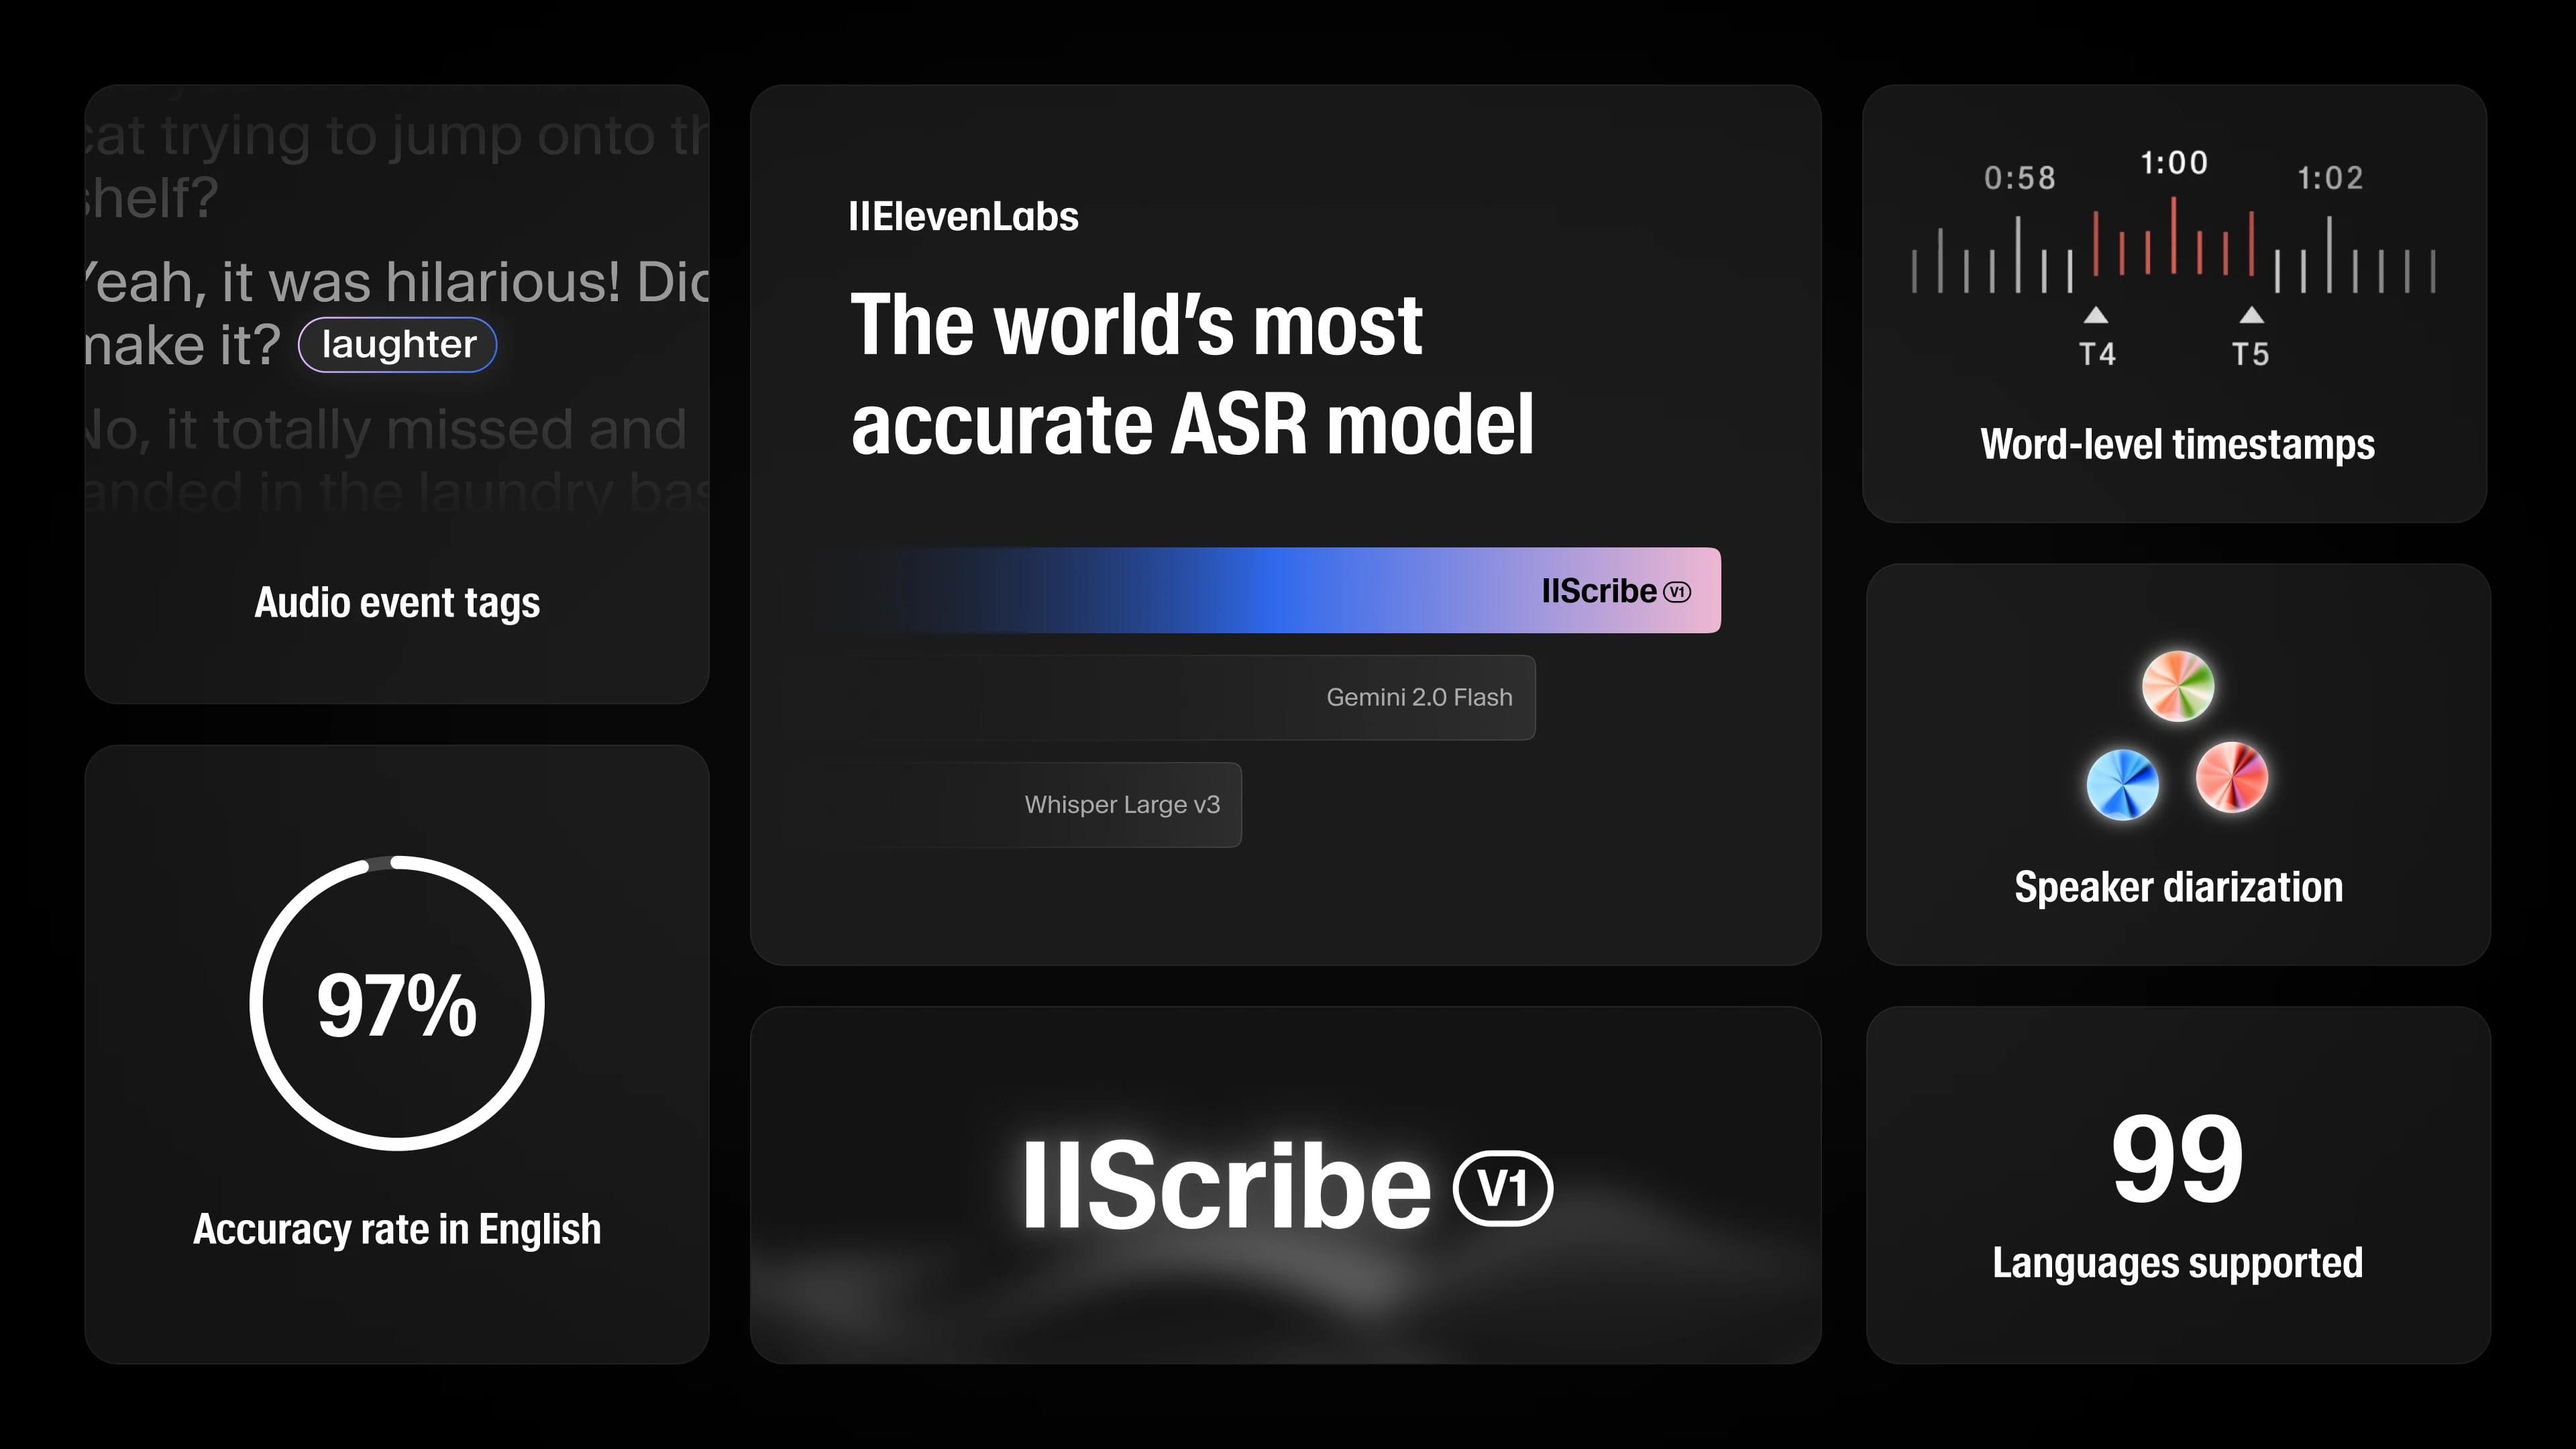
Utvecklare kan redan i dag integrera Scribe via vårt Speech to Text API för att få strukturerade JSON-transkriberingar med talarseparering, tidsstämplar på ordnivå & markörer för händelser utan tal (t.ex. skratt). En version med låg latens för realtidsapplikationer släpps snart.
Kreatörer och företag kan använda Scribe direkt via ElevenLabs dashboard för att ladda upp ljud- eller videofiler och skapa formaterade transkriberingar.
Börja bygga med Scribe:
API-dokumentation | Prova i ElevenLabs Dashboard
Benchmarktester
FLEURS - Ordfelsfrekvens % - 102 språk
Common Voice - Ordfelsfrekvens % - 102 språk
Medverkande
Forskningsansvarig, träning, arkitektur
Flavio Schneider
Projektansvarig, data för förträning, data för finjustering
Tim von Känel
Inferens, optimeringar
Maximiliano Levi
Bidragsgivare inom forskning
Johan Nordberg, Piotr Dabkowski
Frontend
Austin Malerba
Backend
Hristo Stoychev
Datainsamling
Alex George

Tim är med i vårt forskningsteam och fokuserar på ASR och musik.