Så vet ditt transkript var varje ord sägs
- Skriven av
- Mike Murphy
- Publicerad
LyssnaLyssna på den här artikeln
Om du någon gång har sett en film på tv där det är problem med sändningen och skådespelarnas repliker är helt osynkroniserade med undertexterna, vet du hur distraherande det kan vara och hur det rycker dig ur berättelsen. Videor och programvara som använder röstmodeller har samma problem: En undertext som visas en sekund för sent eller en transkribering som markerar fel ord kan kännas lika trasig.
”Människor är ganska bra på att synkronisera medier, åtminstone på ordnivå”, säger Danila Kozlov, forskare på ElevenLabs som arbetar med synkronisering. ”Vi har ofta en intuitiv känsla för var ett ord börjar, men på teckennivå och med precision på mindre än en millisekund är det mycket svårare.”
I dag berättar ElevenLabs mer om Cue, en modell för forcerad synkronisering som placerar varje tecken i en ljudfil på en exakt tidslinje. Cue driver ElevenLabs modellfamilj Scribe och är, i verkliga inspelningar, mer träffsäker än alla synkroniseringsmodeller som ElevenLabs testade i riktmärkets samtliga 29 språk. Den hanterar också inspelningar av valfri längd i ett enda pass och synkroniserar en timmes ljud på mindre än en sekund.
Vad är forcerad synkronisering?
Tänk dig att någon ger dig en video och en transkribering och ber dig matcha varje ord med ögonblicket då det sägs. Det är forcerad synkronisering. När du klickar på ett ord i en ElevenLabs-transkribering och spelaren hoppar till exakt den platsen är det en synkroniseringsmodell som gör jobbet.
Forcerad synkronisering skiljer sig dock från det mer diffusa begreppet AI-anpassning. Det handlar om att utforma AI-system så att deras beteende stämmer överens med människors värderingar och verksamhetspreferenser. Med forcerad synkronisering menar vi helt enkelt att synka text och ljud.
Cue är det sista steget i tal-till-text-processen. Scribe, ElevenLabs Speech to Text-modell, transkriberar ljudet och synkroniseringsmodellen anger tidsinformationen. Varje Scribe-begäran passerar genom den. Samma modell används även för undertexter, dubbning och tidssättning av sångtexter i musik, och finns även separat via Forced Alignment API.
Eftersom så många produkter är beroende av den måste en synkroniseringsmodell vara exakt på alla språk som stöds, extremt snabb och kunna hantera många begäranden samtidigt.
Där traditionella synkroniseringsmodeller brister
Innan den nya modellen byggde teamet synkroniseringsmodellen som hittills använts i alla ElevenLabs produkter. Den var kraftfull, men de visste att de kunde göra en ny version ännu bättre. När Kozlov kom till företaget började han och teamet med att intervjua kunder och interna användare på ElevenLabs om vad som frustrerade dem med den tidigare synkroniseringsmodellen. Deras klagomål motsvarade begränsningarna i de verktyg med öppen källkod som teamet testade.
Längden är det första stora problemet. Många synkroniseringsmodeller fungerar i dag bra för klipp på omkring 30 sekunder, men längre filer måste delas upp i delar. Varje ny del kan skapa ett litet tidsfel, och att sammanfoga delarna kan ge fler. För hela inspelningar är Cues genomsnittliga tidsfel bara 179 millisekunder, medan verktygen med öppen källkod låg på mellan 283 ms och över 6 000 ms.
Ljud inspelat i verkliga miljöer är en ännu större utmaning. Bakgrundsljud, överlappande tal och stämningsmusik gör att många verktyg tappar bort sig när de matchar text med ljud. Men det är sådana filer som många faktiskt vill transkribera, eftersom vi alla tenderar att leva på platser som inte är helt tysta. För engelska inspelningar med störande bakgrundsljud är Cues genomsnittliga fel 57 ms, jämfört med 65–920 ms för de andra.
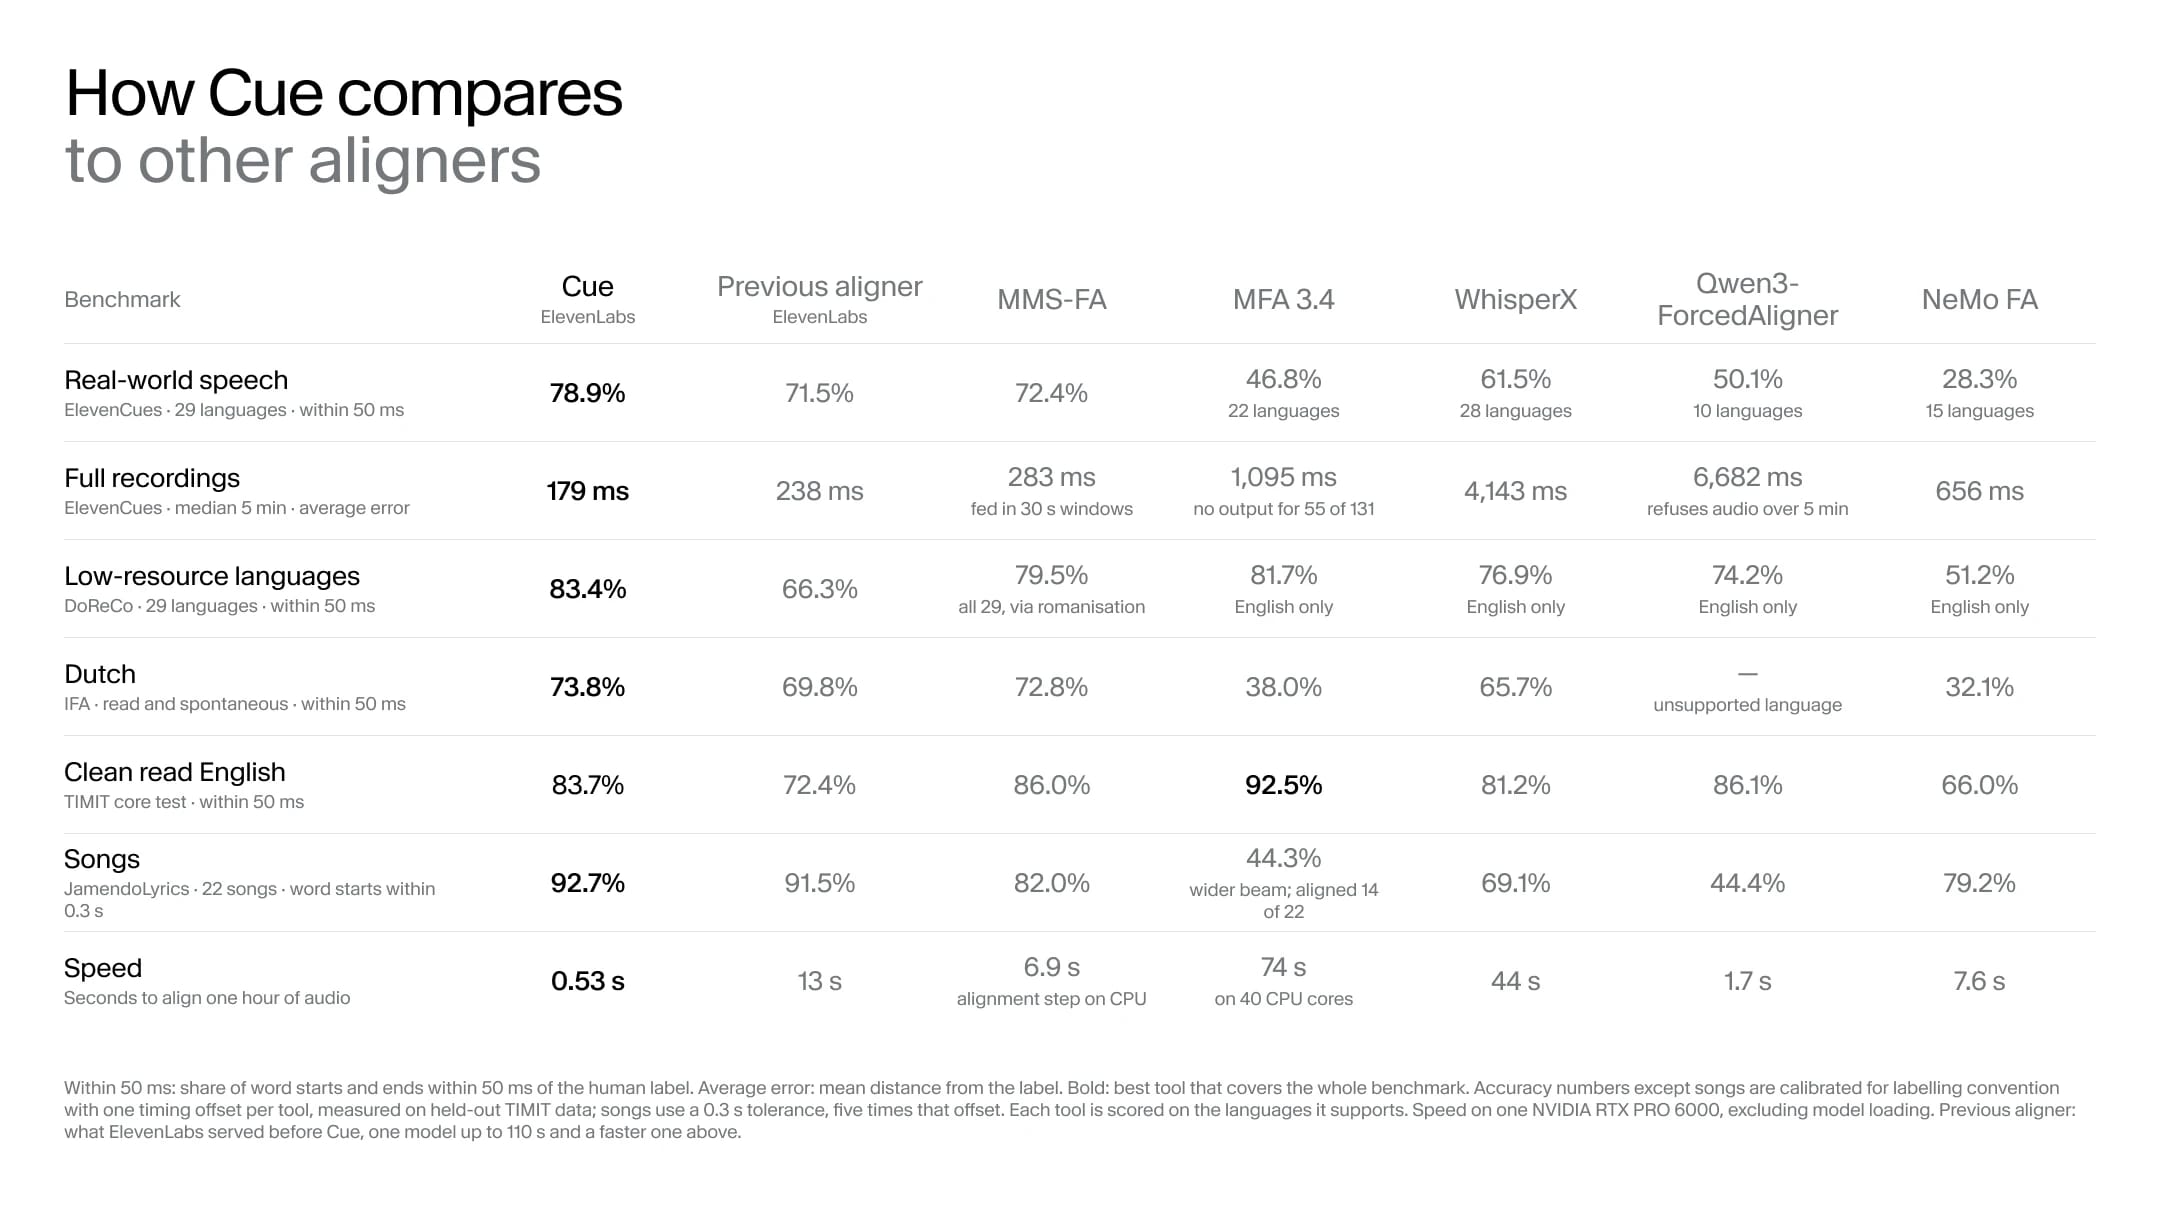
Språkstöd är en annan begränsning. De flesta synkroniseringsmodeller med öppen källkod behöver en separat modell för varje språk de stöder, så språk med mindre träningsdata presterar ofta sämre eller stöds inte alls. MMS-FA är det enda andra verktyget som hanterar alla 29 språk i riktmärket, och Cue var generellt snabbare på att avgöra gränserna mellan ord.
Hastighet är också ett problem för dessa modeller, eftersom synkronisering av stora ljudvolymer snabbt kan bli dyrt. Cue kan synkronisera en timmes ljud på omkring en halv sekund på vår produktions-GPU. Nästa snabbaste verktyg, Qwen3-ForcedAligner, tar nästan 2 sekunder, och det långsammaste som testades tog betydligt över en minut.
Så skiljer sig Cue
Cue är en enda modell som täcker fler än 90 språk i riktmärket, till skillnad från de flesta konkurrenter. Den kan också hantera inspelningar av valfri längd i ett enda pass, vilket undviker den uppdelning som gör att tidsfel byggs på i långa filer.
Nyp ihop eller Control-skrolla för att zooma. Svep horisontellt eller Shift-skrolla för att panorera. När ett ord är markerat kan du använda plus och minus för att zooma, eller Shift och vänster eller höger piltangent för att panorera.
Välj ett ord för att se dess tecken
Medan de flesta modeller har blivit större i takt med att deras prestanda förbättrats är Cue mindre än ElevenLabs tidigare synkroniseringsmodell, säger Kozlov. Den körs fortfarande på en GPU, men synkroniserar en timmes ljud på ungefär en halv sekund.
Teamet byggde Cue utifrån de typer av ljud som människor faktiskt laddar upp. Med den tidigare synkroniseringsmodellen som utgångspunkt skapade de ett riktmärke baserat på verkliga begäranden och poängsatte varje verktyg på samma sätt, där varje ord som ett verktyg inte kunde placera räknades som ett fel. Cue arbetar på teckennivå, vilket är mer detaljerat än de etiketter på ordnivå som de flesta riktmärken använder, så resultaten underskattar sannolikt dess precision.
”Vid någon punkt når man människans nivå”, säger Kozlov om synkroniseringsmodeller. ”Vår nuvarande synkroniseringsmodell ligger över den nivån, och då blir det mycket svårare att kontrollera om den är helt korrekt eller hur exakt den är, eftersom det inte finns något perfekt riktmärke för detta. Vi var tvungna att använda riktmärken på ordnivå för att utvärdera ett system på teckennivå, vilket inte nödvändigtvis visar Cues fulla potential.”
Cues kvalitet visar också hur snabbt ElevenLabs kan agera på användarfeedback. Kort efter att Cue lanserats uppmärksammade en kund teamet på att georgiska och ett par andra språk med mindre resurser presterade sämre än förväntat. ElevenLabs håller forskningen nära de team och kunder som använder våra produkter, vilket gjorde att vi snabbt kunde upptäcka problemet, undersöka möjliga modellförbättringar, träna en ny version av modellen och släppa den — allt inom mindre än 24 timmar från att kunden först tog upp problemet.
Synkronisera låtar
Musik är svårt eftersom sång drar ut på och suddar ut ord, och få modeller klarar det bra. Teamet förväntade sig inte att Cue skulle hantera det så väl som den gör. Cue kunde synkronisera ett urval av låtar från den Creative Commons-licensierade JamendoLyrics MultiLang-datamängden. Det gick att göra på engelska, franska, spanska och tyska — i ett enda pass — med förvånansvärd precision. Cue placerade 92,7 % av orden inom 0,3 sekunder från etiketten, jämfört med 82,0 % för det näst bästa verktyget.
Cues genomsnittliga startfel var 0,82 sekunder, ungefär hälften så stort som den närmaste konkurrentens. Den var mer träffsäker än alla andra verktyg på minst 19 av de 22 låtarna. Möjligheten att sjunga dina nya favoritlåtar på karaoke samma dag som de släpps är enorm.
Prova Cue i dag
Cue används redan bakom varje Text to Speech-transkribering på ElevenLabs. Om du vill använda den direkt kan du prova Forced Alignment API.
Tack
Arbetet med ElevenLabs synkroniseringsmodeller hade inte varit möjligt utan många personer i hela företaget. Teamet vill tacka alla som arbetade med den tidigare och den nya versionen av modellen, bland andra medgrundaren och CTO:n Piotr Dąbkowski, forskarna Danila Kozlov, Luca Lanzendörfer, Flavio Schneider, Max Levi, Tim von Känel och Angelos Perivolaropoulos, samt Ani Janelidze inom Data Operations, våra team för Forward Deployed Engineer och Support, och Lorenzo Dossi för hans arbete med visualiseringen i det här blogginlägget.
Mike Murphy är chefsredaktör och skribent för ElevenLabs blogg, där han omvandlar komplex forskning och teknik till tydliga, engagerande berättelser. Innan han började på ElevenLabs arbetade han i många år som teknikreporter, bland annat på Quartz, och ansvarade för innehållet på IBM Research. Han har en masterexamen i journalistik från Northwestern.