
JavaScript-guide till taligenkänning: Skapa röststyrd UX
- Skriven av
- Jack Limebear
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
Det är nu enklare att lägga till taligenkänning på webbplatser och i webbläsarbaserade appar, tack vare webbläsarbaserade API:er för tal till text (STT), som Web Speech API. Utvecklare kan enkelt strömma mikrofoninmatning, analysera ljuddata och bearbeta transkriberingar med API-anrop, utan att bygga en lokal server för automatisk taligenkänning.
Web Speech API är ett vanligt API för taligenkänning som används för att implementera röstkommandon i JavaScript. Det tillhandahåller metoder, argument och egenskaper som låter dig köra realtidstranskribering i en webbläsare. Men utvecklare kan uppleva att Web Speech API är begränsat för komplexa webbklienter.
Den här guiden visar hur du konfigurerar en enkel webbapp för taligenkänning i JavaScript med Web Speech API, dess begränsningar och alternativ för att bygga mer robusta klienter för realtidstranskribering.
Sammanfattning
- Web Speech API är ett webbläsarbaserat API för tal till text som skickar mikrofonljud till en molntjänst på serversidan för bearbetning.
- Utvecklare använder API-klassen SpeechRecognition för att bygga JavaScript-appar med röstkommandon.
- När du bygger en app för taligenkänning bör du värna om användarnas integritet genom att visa när ljud spelas in.
- Web Speech API har flera begränsningar, bland annat ojämn transkriberingskvalitet, beroende av webbläsaren och avsaknad av avsiktsförståelse.
- ElevenLabs erbjuder mycket exakta API:er för tal till text i produktionsklass som har stöd för streaming både på klient- och serversidan.
Så fungerar Web Speech API
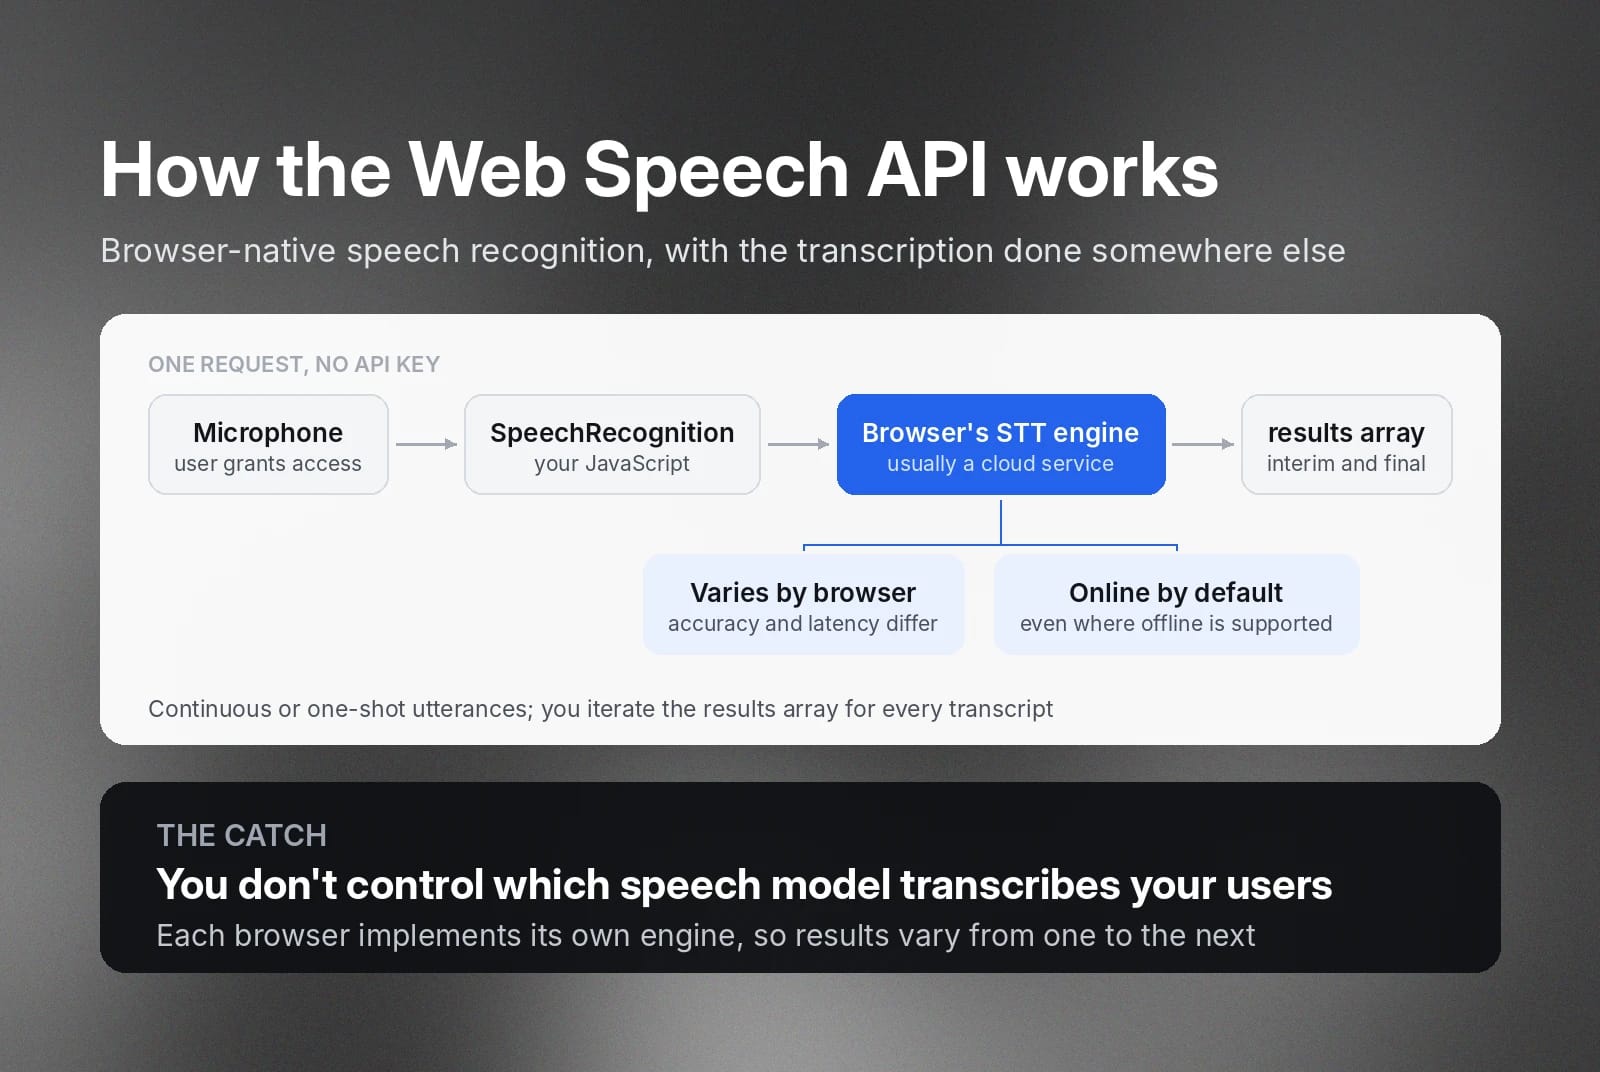
Web Speech API ger webbutvecklare webbläsarbaserad taligenkänning utan behov av en lokal server. I praktiken skickar Web Speech API en ljudström från din webbläsare till en molntjänst på serversidan som bearbetar, analyserar och omvandlar ljudet till transkriberingar. Eftersom transkriberingen körs av webbläsarens backendmotor får du olika resultat i olika webbläsare.
Vanligtvis kräver Web Speech API en aktiv internetanslutning för att transkribera ljudströmmar, särskilt om du utvecklar för Chrome och Safari. Vissa webbläsare har dock nu stöd för offline-transkribering. Vid offline-transkribering fungerar webbläsaren som tal-till-text-motor, identifierar fonem och omvandlar dem till sammanhängande text.
Oavsett vilken webbläsare du använder är API:ets grunder desamma.
- Du behöver ingen API-nyckel för att göra ett API-anrop.
- Web Speech API har stöd för kontinuerliga yttranden och engångsyttranden.
- Det returnerar både preliminära och slutliga transkriberingar.
Eftersom varje webbläsare kan implementera STT-motorn på olika sätt kan dock noggrannhet och latens variera.
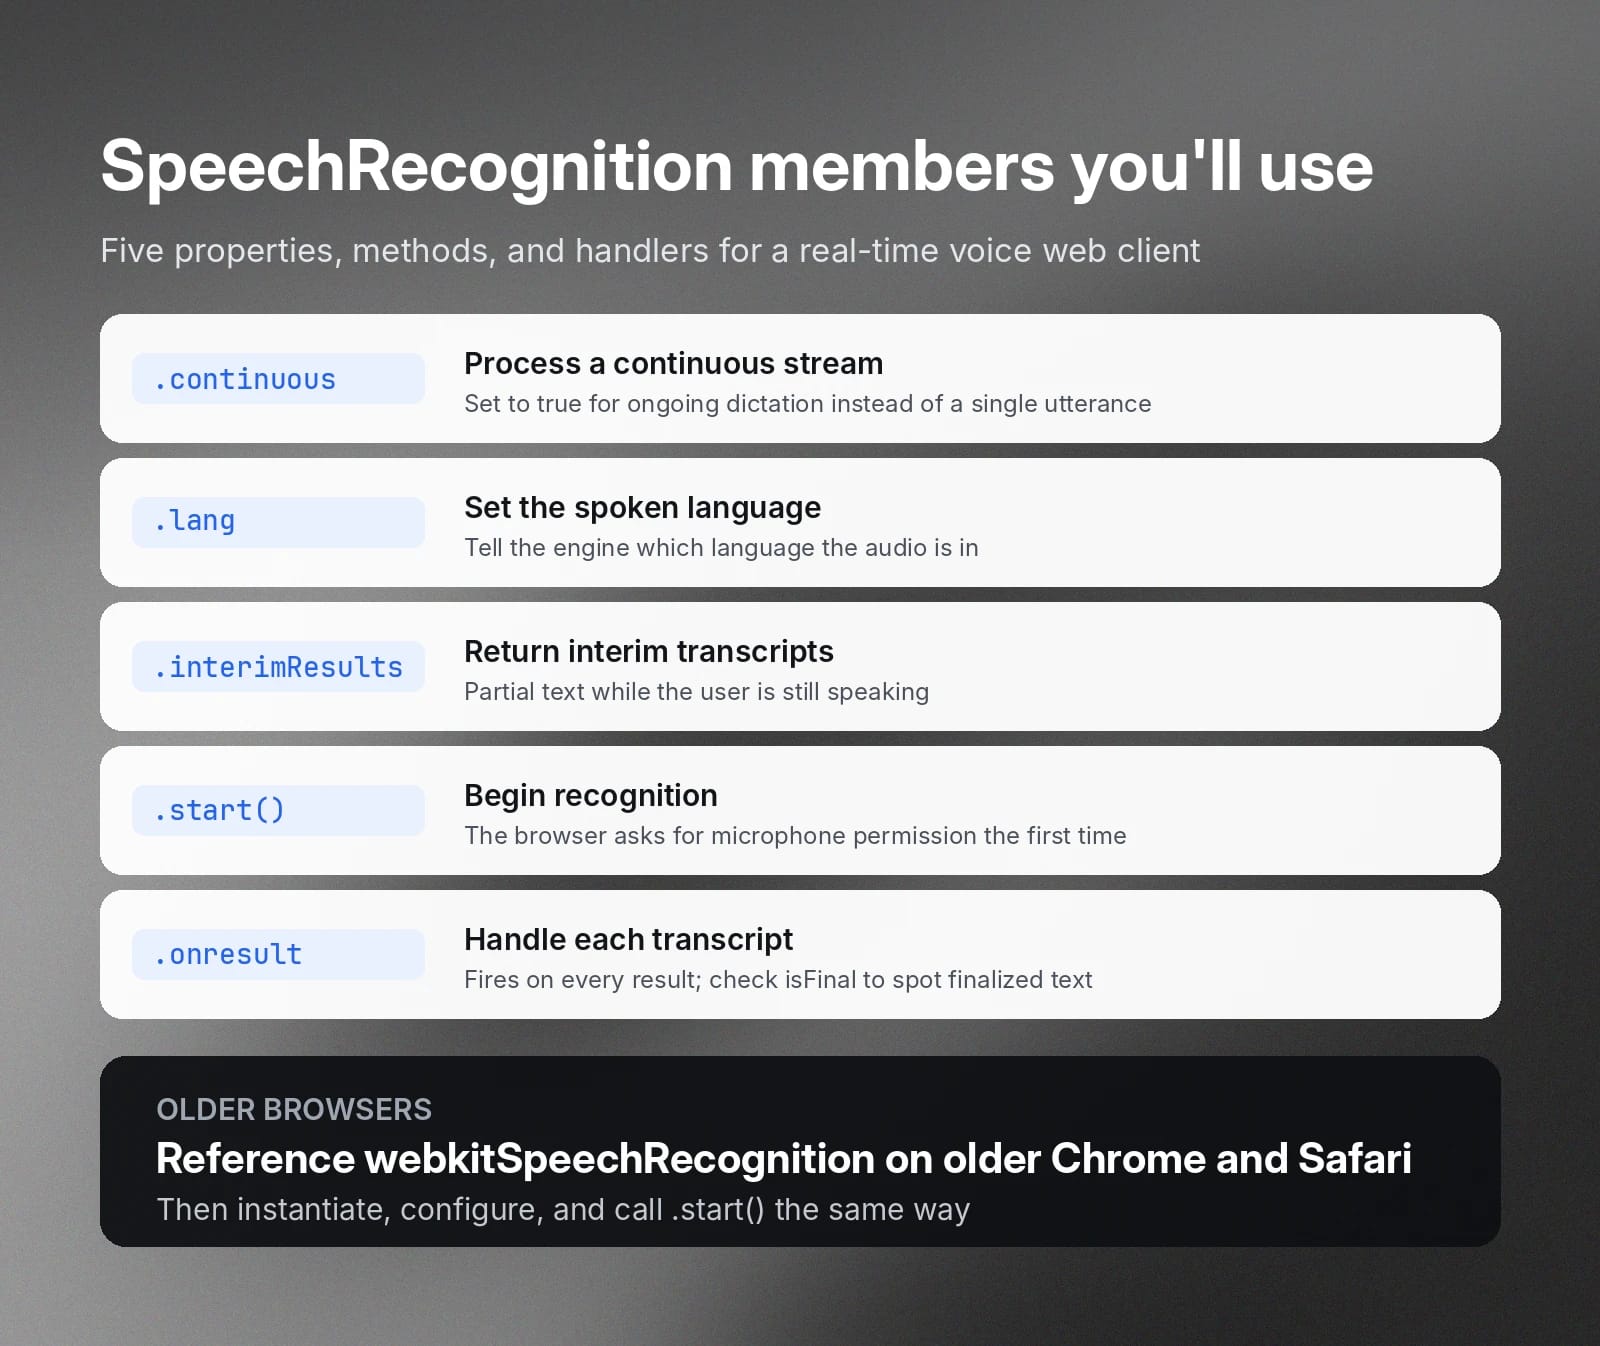
För att använda Web Speech API initierar du SpeechRecognition-gränssnittet i din JavaScript-kod. Sedan använder du metoder, attribut och händelsehanterare medan du kodar. Här är några som du använder för att bygga en webbklient för röstsökning.
- SpeechRecognition.continuous: Aktiverar taligenkänningsmotorn för att bearbeta en kontinuerlig ström när den är inställd på true.
- SpeechRecognition.lang: Anger ljudets språk.
- SpeechRecognition.interimResults: Instruerar motorn att returnera preliminära transkriberingar.
- SpeechRecognition.start(): Startar taligenkänningsprocessen.
- SpeechRecognition.onresult: Accepterar en händelsehanterare som API:et utlöser när transkriberingen är klar.
Web Speech API returnerar transkriberingen i en strängarray. När STT-motorn returnerar en transkribering, preliminär eller slutlig, hittar du den i arrayen results. Den kan returnera en eller flera strängar. Därför behöver du iterera genom resultatsträngarna för att hämta all transkriberad text.
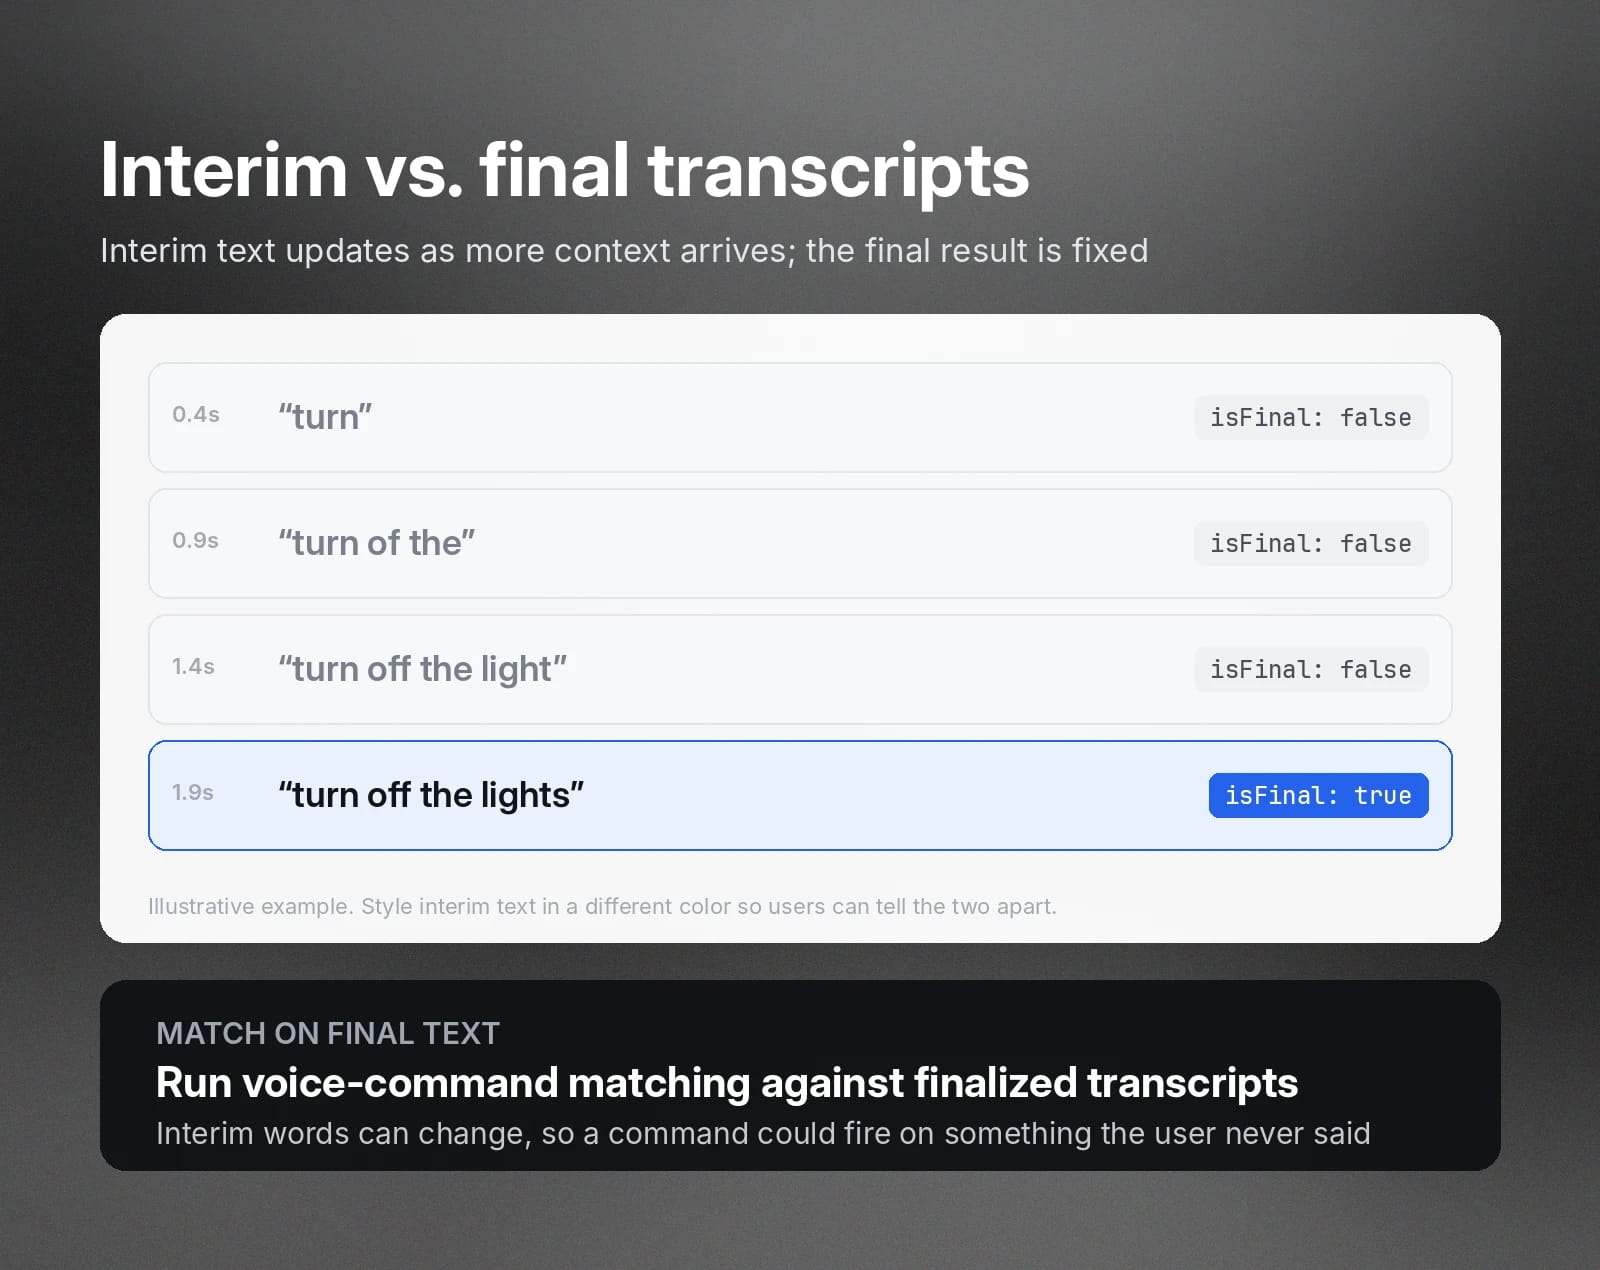
Obs: Om du har aktiverat preliminär transkribering kontrollerar du egenskapen isFinal för att avgöra om texten är en färdig transkribering.
Bygg ett exempel på taligenkänning i JavaScript
Det här exemplet använder JavaScript-gränssnittet SpeechRecognition för att bygga en webbapp för realtidstranskribering. Skärmbilden nedan visar den färdiga sidan.
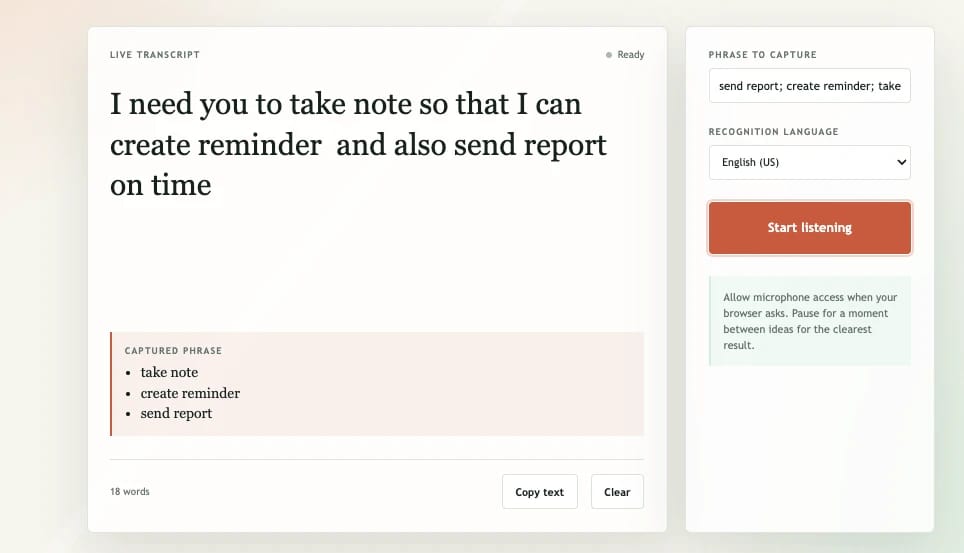
På exempelsidan startar knappen Start listening inspelningen. När användaren talar skickar webbläsaren ljudet till STT-motorn, väntar på transkriberingen och visar både preliminär och slutlig text.
Exemplet innehåller också en funktion för röstkommandon som fångar upp särskilda termer som användaren anger. Den jämför transkriberingen med en fördefinierad fraslista i din egen kod, vilket skiljer sig från nyckelordsstyrning i ett API för tal till text.
Kodsnuttarna nedan visar de viktigaste delarna i exemplet.
Konfigurera SpeechRecognition API och begär mikrofonåtkomst
För att använda det i din kod behöver du först instansiera klassen SpeechRecognition. Om du använder en äldre version av Chrome eller Safari refererar du till webkitSpeechRecognition.
Skapa sedan en SpeechRecognition-instans och konfigurera streamingläget, stöd för preliminär transkribering och talat språk.
Därefter kan du börja transkribera genom att anropa metoden .start().
När taligenkänningsprocessen startas för första gången ber webbläsaren användaren om behörighet. Användaren måste klicka på Tillåt för att starta transkriberingen. Annars returnerar API:et värdet "not-allowed” i hanteraren för SpeechRecognitionErrorEvent .
Visa live-transkriberingar och slutliga resultat
I det här exemplet visar vi transkriberingen medan användaren talar i mikrofonen. Det gör vi genom att lägga till en funktion i händelsen onresult.
Preliminära transkriberingar är inte färdigställda. Därför kanske den visade texten inte motsvarar exakt det du har sagt. När STT-motorn får mer sammanhang från efterföljande ord korrigerar den transkriberingen och returnerar den i strängen.
Du kan också formatera preliminär text i en annan färg så att den skiljer sig från den slutliga transkriberingen. Den här CSS-koden gör det:
Lägg till röstkommandon i JavaScript
Lägg till ett textfält där användare anger de fraser de vill upptäcka, separerade med semikolon. (Du kan också lagra fraserna i en JSON-fil och läsa in dem i din kod.)
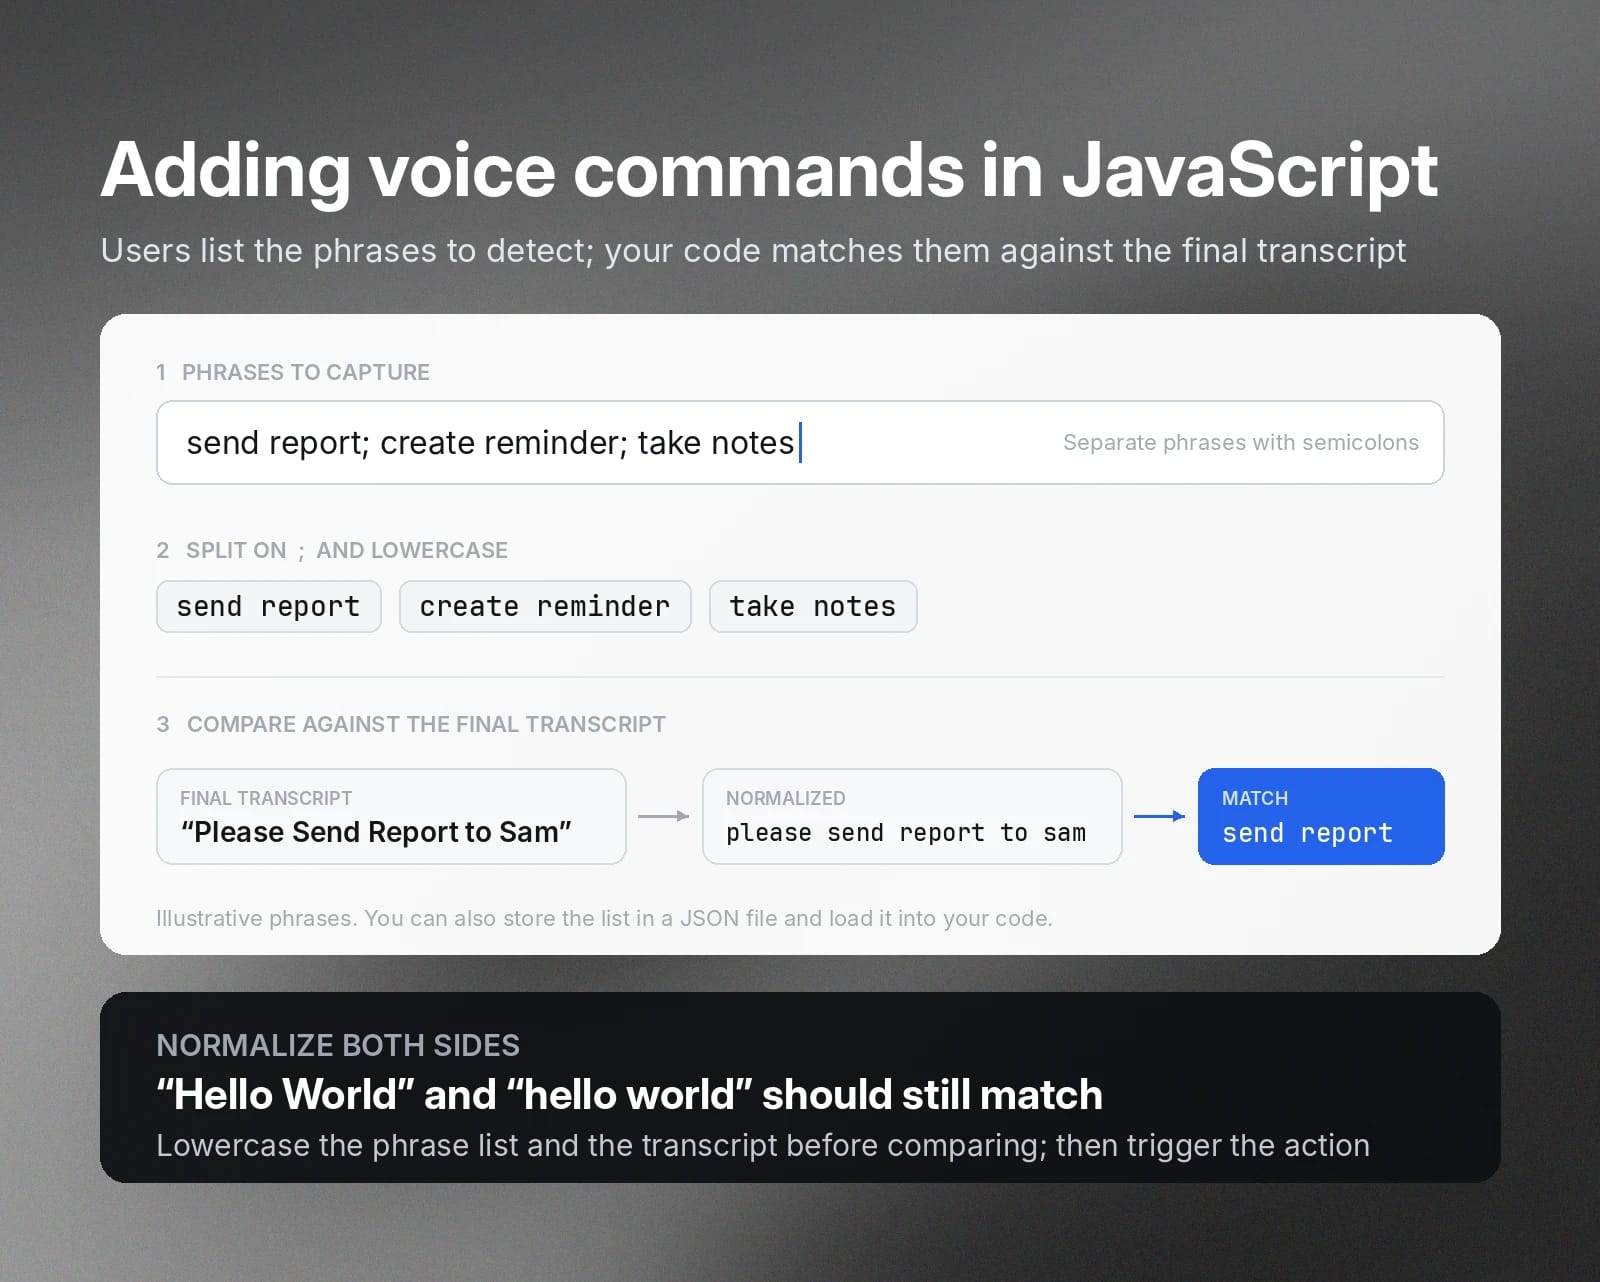
Skapa sedan en funktion som jämför den slutliga transkriberingen med fraslistan. När du matchar text normaliserar du båda listorna genom att konvertera dem till gemener. Användare kan nämligen skriva ord med stor begynnelsebokstav, vilket kan orsaka en felmatchning även om det är samma ord. Till exempel ska ”Hello World” och ”hello world” matcha, även om den ena skrivs med stor begynnelsebokstav.
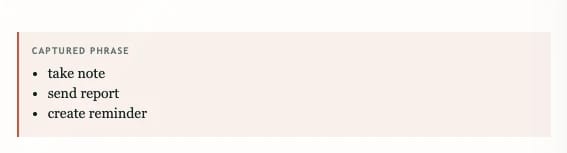
Varje gång koden tar emot en transkribering itererar den genom fraslistan. Om det finns en matchning utlöser du en åtgärd, till exempel att öppna en applikation eller, som i det här fallet, visa den matchande frasen i en separat panel.
Hantera webbläsarstöd, behörigheter och igenkänningsfel
Web Speech API gör tal-till-text-igenkänning i JavaScript lättillgänglig, men den fungerar inte alltid utan problem. Användare kan ha en webbläsare med begränsat eller inget backendstöd för SpeechRecognition API. I vissa fall gör nätverksproblem att transkriberingen misslyckas.
Därför behöver din kod hantera dessa förhållanden och informera användarna på rätt sätt.
Du kan till exempel informera användare om att använda Chrome eller Edge, där SpeechRecognition API bevisligen fungerar.
För att hantera fel kopplar du en felhanteringsfunktion till händelsehanteraren onerror och bearbetar respektive felkod.
Till exempel:
Felkod | Åtgärd |
not-allowed | Visa text som uppmanar användaren att kontrollera webbläsarens inställningar. |
no-speech | Uppmana användaren att tala närmare mikrofonen |
network | Be användaren kontrollera sin internetanslutning |
aborted | Informera användaren om att taligenkänningsprocessen stoppades. |
Gör JavaScript-taligenkänning tillgänglig och integritetsmedveten
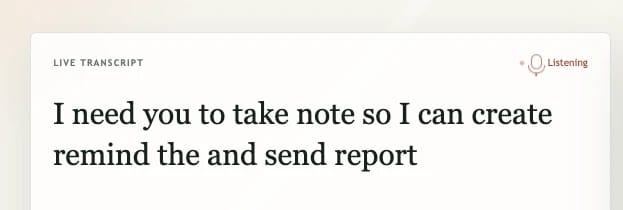
Tänk på integriteten när du integrerar Web Speech API. Visa alltid en visuell eller muntlig indikator innan webbklienten börjar spela in. Visa till exempel en lyssningsikon som visuell signal medan JavaScript-koden för taligenkänning aktivt skickar mikrofonsignalen till tal-till-text-motorn.
Ett annat område som utvecklare bör uppmärksamma är dataintegritet. När du transkriberar med SpeechRecognition API utför API:et transkriberingen online som standard. Även om webbläsaren har stöd för offline-tal till text försöker API:et först transkribera online.
De här tekniska specifikationerna är avgörande när du bygger transkriberingstjänster där datalagringsplats, styrning och regelefterlevnad är strikt reglerade.
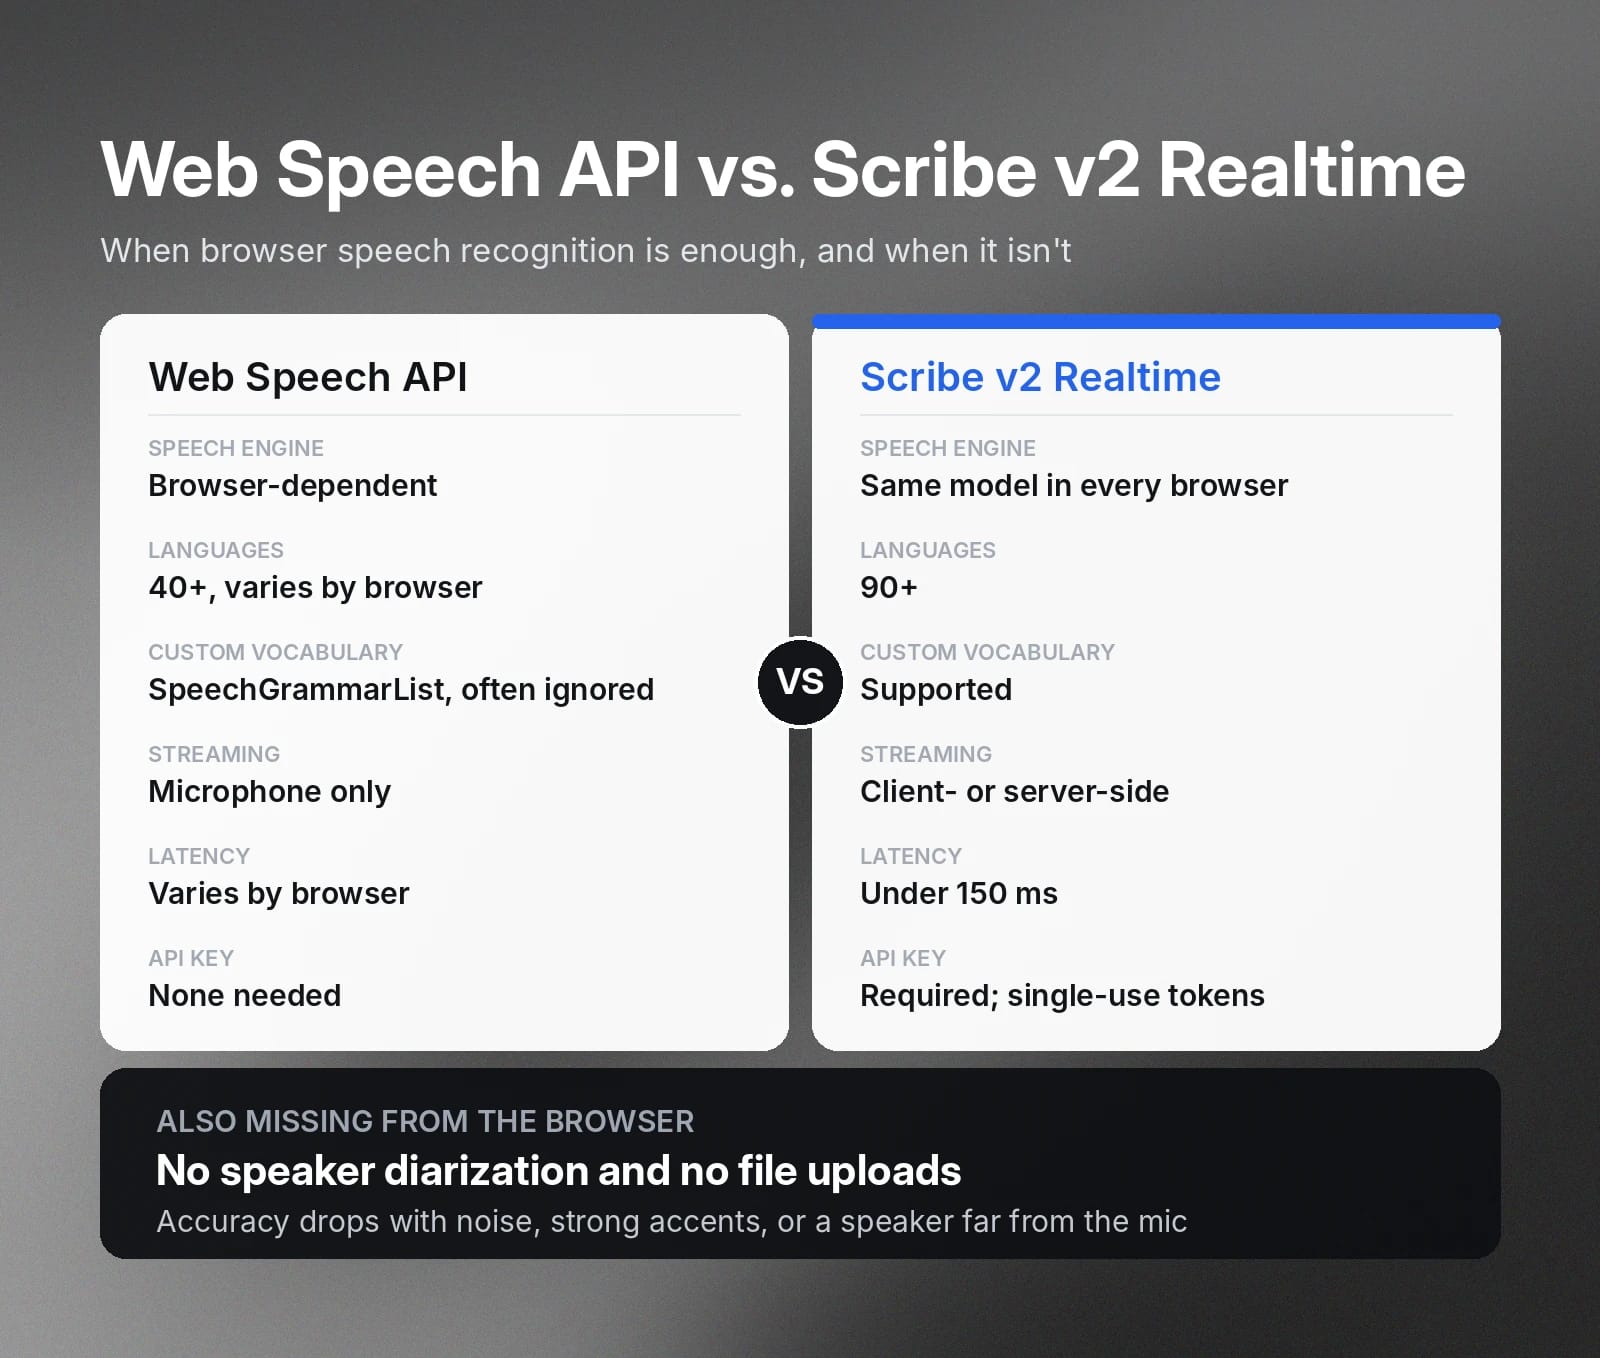
När webbläsarens taligenkänning inte räcker för produktion
Vi har visat hur du bygger automatisk taligenkänning för webbläsarbaserade röstappar med Web Speech API. API:et gör funktioner för tal till text tillgängliga för JavaScript-utvecklare. Flera begränsningar inskränker dock användningsområdena, särskilt för kommersiella webbprodukter.
- Webbläsarberoende: Transkriberingen är starkt beroende av användarens webbläsare. Utvecklare har ingen kontroll över de specifika röstmodeller som används, vilket ger ojämn transkriberingsprestanda.
- Begränsat språkstöd: API:et har stöd för fler än 40 språk, men det exakta antalet kan variera mellan webbläsare.
- Talardiariisering: Du kan inte upptäcka vem som talar och återge enskilda talare i transkriberingen.
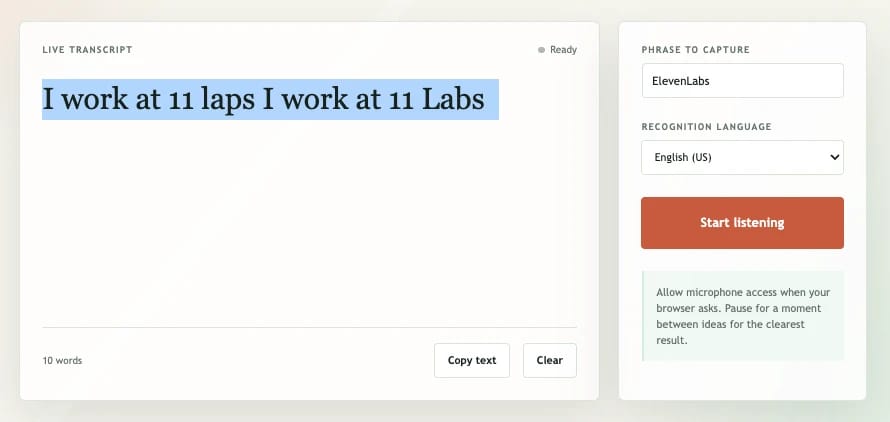
- Anpassade vokabulärer: SpeechRecognition API saknar tillförlitligt stöd för anpassade vokabulärer. Det kan till exempel inte transkribera ”ElevenLabs” korrekt. (Det officiella SpeechRecognition API erbjuder ett gränssnitt för anpassade vokabulärer med SpeechGrammarList, men moderna webbläsare ignorerar det ofta.)
- Noggrannhet: Transkriberingsnoggrannheten försämras när talaren befinner sig i en bullrig miljö, har en stark accent eller är långt från mikrofonen.
- Streaming på serversidan: Du kan bara strömma från mikrofonen eftersom Web Speech API inte har stöd för streaming från servern eller manuella uppladdningar av ljudfiler.
Om de här begränsningarna hindrar dig från att kommersialisera din produkt för röstigenkänning rekommenderar vi att du använder ElevenLabs Scribe v2 Realtime.
ElevenLabs Scribe v2 Realtime är en taligenkänningsmodell som erbjuder mycket exakt realtidstranskribering med latens under 150 ms. Den har stöd för över 90 språk, konsekventa resultat oavsett webbläsare och anpassade vokabulärer. Med ElevenLabs Scribe v2 Realtime kan du köra streaming på klient- eller serversidan så att det passar webbappens arkitektur.
JavaScript-guide till röstigenkänning med ElevenLabs Scribe v2 Realtime
Att bygga ett röstkommando i JavaScript med ElevenLabs följer en liknande metod. Du behöver dock skapa en ElevenLabs API-nyckel för att auktorisera API-anropen. Nedan följer snabba steg för att skapa en webbklient som strömmar från en mikrofon.
- Installera ElevenLabs SDK
- Skapa en token för engångsbruk för att skicka API-nyckeln utan att exponera den
- Konfigurera och anslut till modellen Scribe v2 Realtime med önskade parametrar
- Skapa händelsehanterare för att bearbeta transkriberingar och hantera undantag
För utförlig vägledning om Scribe v2 Realtime, se vår officiella dokumentation.
Kom igång med ElevenAPI för tal till text i produktion
ElevenAPI erbjuder modeller i produktionsklass för tal till text för utveckling av webbklienter och servrar. Utöver taligenkänning i realtid använder utvecklare ElevenAPI:s modeller för tal till text för att möjliggöra batchtranskribering med talardiariisering, tidsstämplar på ordnivå och asynkron bearbetning.
I stället för att kontinuerligt fråga tal-till-text-motorn kan du skapa en webhook på ElevenLabs-kontrollpanelen och ange en callback-URL dit API:et levererar den färdiga transkriberingen.
Oavsett om du vill bygga en webbklient eller serverapp med automatisk taligenkänning erbjuder ElevenAPI ljudmodeller som du enkelt kan integrera i din kod.
Hämta din ElevenLabs API-nyckel och utforska API-dokumentationen för att börja bygga.
Vanliga frågor

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.


