
Python-guide för taligenkänning: Från ljudfil till transkript
- Skriven av
- Jack Limebear
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
Att lägga till taligenkänning i en Python-app brukade vara krångligt. Python-utvecklare behövde själva koda kring transkriberingsprocessen, inklusive ljudförbehandling, extraktion av egenskaper och modellintegrering. Dessutom brottas utvecklingsteam med ljudhantering på låg nivå, bristfällig transkriberingskvalitet och fördröjningar mellan talade ord och liveundertexter.
Framsteg inom ljudmodeller och SDK:er för taligenkänning förändrar detta.
I den här guiden till taligenkänning i Python lär du dig att integrera ElevenLabs Speech to Text-ljudmodeller i ditt Python-projekt för att skapa transkriberingsappar redo för kommersiell användning.
Sammanfattning
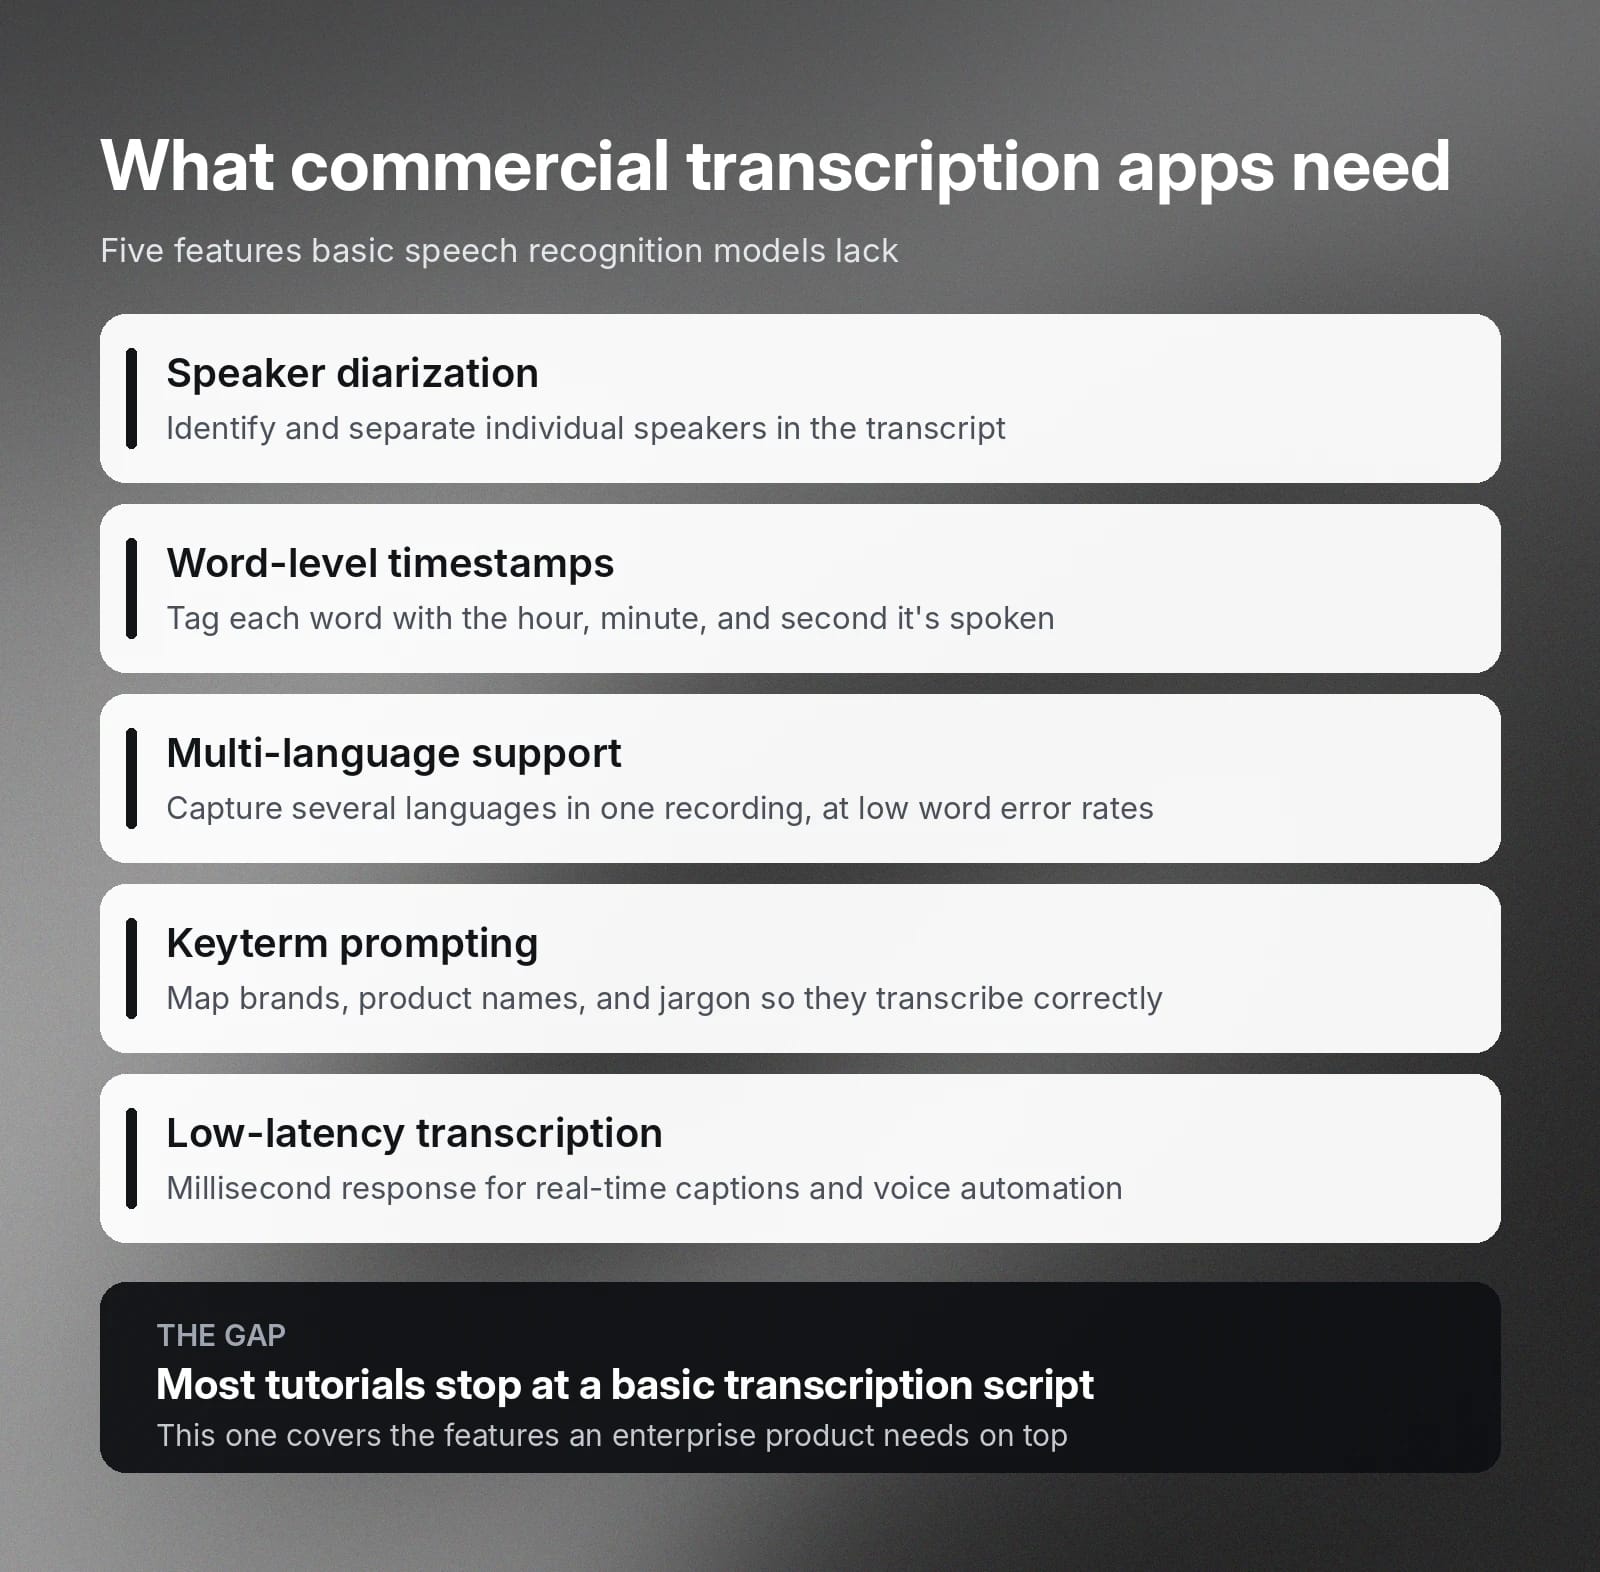
- Kommersiella Speech to Text-modeller erbjuder funktioner som talarseparering, tidsstämplar på ordnivå och prompting med nyckeltermer, vilket grundläggande taligenkänningsmodeller saknar.
- ElevenAPI ger din Python-kod taligenkänningsfunktioner med Scribe v2 och Scribe v2 Realtime.
- Utvecklare kan installera ElevenLabs-skills på en AI-kodningsplattform för att generera korrekt Python-kod baserad på officiell API-dokumentation.
- Du kan prova ElevenLabs API gratis innan du tecknar en betald plan för kommersiell utveckling.
Vad den här guiden till taligenkänning i Python omfattar
Den här guiden täcker förutsättningar, API-integrering och avancerade transkriberingsfunktioner som hjälper dig att bygga en Python-app för taligenkänning för företagsanvändning.
Taligenkänning har utvecklats mycket de senaste åren, särskilt eftersom stora språkmodeller och neurala nätverk för djupinlärning har förändrat hur Python-utvecklare använder SDK:er för transkribering. Många guider visar hur du bygger enkla transkriberingsappar, men få tar upp funktionerna som en produkt redo för kommersiell användning behöver.
Vi skrev den här guiden för att fylla det gapet.
Många transkriberingslösningar för företag behöver till exempel följande funktioner:
- Talarseparering: Möjligheten att identifiera och separera enskilda talare i transkriptet.
- Tidsstämplar: Att märka varje ord korrekt med den relativa timme, minut och sekund då det uttalas.
- Stöd för flera språk: Fångar upp tal på olika språk i samma inspelning eller liveström med låg felfrekvens på ordnivå.
- Prompting med nyckeltermer: Kopplar särskilda ord, till exempel varumärken, produktnamn och tekniska termer, för att undvika felstavade transkriberingar.
- Transkribering med låg latens: Svarstider från tal till text på millisekundnivå som driver transkriberingsappar i realtid.
Obs: Den här guiden går längre än att skapa enkla personliga skript för hobby- eller privatprojekt. Den omfattar inte applikationslogik som byggs ovanpå Speech to Text API-integreringen, eftersom den skiljer sig åt mellan olika verksamheter.
Förutsättningar för att integrera taligenkänning i Python
Vi utformar den här guiden kring ElevenAPI, ett produktionsklart API från ElevenLabs som förenklar interaktionen med röstmodeller i din kod. Med ElevenAPI får du tillgång till Scribe v2 och Scribe v2 Realtime, våra ledande röstmodeller för batch- och livetranskribering.
I stället för att få direktåtkomst till ElevenLabs Speech to Text-modeller skickar du ljudinspelningar, liveströmmar och argument via API-anrop. Ljudmodellen omvandlar sedan ljuddatan till text. När processen är klar får du transkripten i koden eller via en webhook.
Följ de här förberedande stegen för att komma igång.
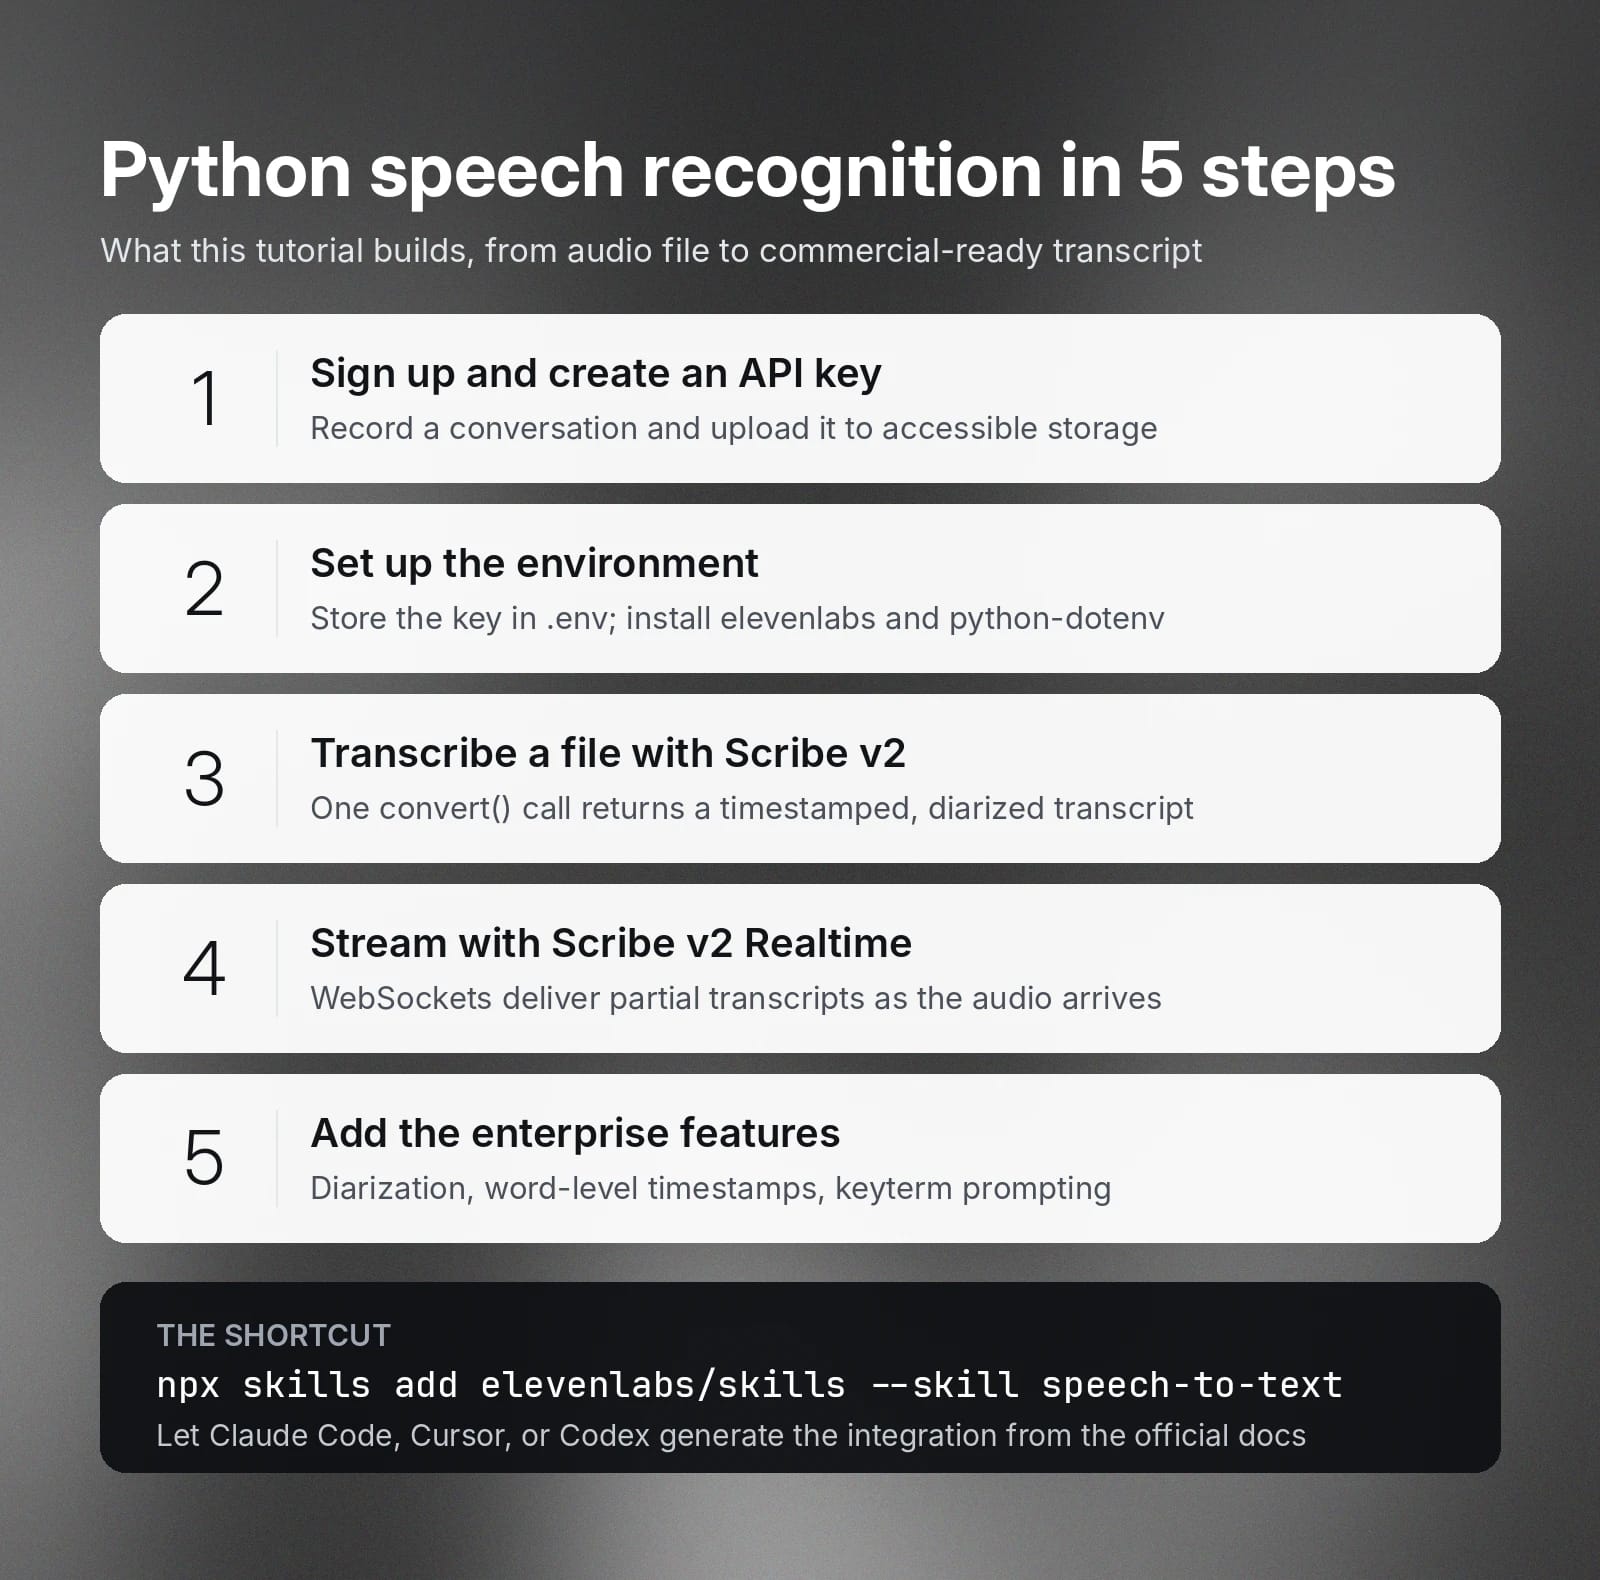
- Registrera dig för ElevenLabs.
- Skapa din API-nyckel.
- Spela in ett samtal och ladda upp det till offentligt tillgänglig lagring.
När du är klar går du vidare till nästa avsnitt.
Konfigurera din miljö
Innan du integrerar med ElevenLabs-modeller ska du konfigurera din Python-miljö för att skydda din ElevenLabs API-nyckel. Precis som med alla API-nycklar rekommenderar vi att du lagrar den som en miljövariabel (en hanterad hemlighet) i .env-filen.
När du gör ett API-anrop skickar du med miljövariabeln. Det förhindrar att du av misstag exponerar API-nyckeln när du gör API-anrop via ett offentligt nätverk.
Kör sedan ett Bash-kommando för att installera elevenlabs, ElevenLabs SDK, i din Python-miljö. SDK:t ger dig åtkomst till olika röstmodeller. I det här fallet väljer du mellan Scribe v2 och Scribe v2 Realtime.
Du behöver också installera python-dotenv, som gör det möjligt för din Python-kod att komma åt miljövariabler som lagras i .env-filen.
Skriv ditt första transkriberingsskript
När du har konfigurerat Python-miljön kan du transkribera ljudfilen med ElevenLabs Scribe v2.
ElevenLabs Scribe v2 är en branschledande modell för taligenkänning som låter dig transkribera ljudfiler i stor skala. Den identifierar fonem med hög precision även när ljudinspelningen innehåller betydande bakgrundsljud. För att transkribera ljud skickar du inspelningen till modellen via ElevenLabs API och hämtar det färdiga transkriptet.
Nedan finns ett Python-kodexempel som omvandlar en ljudfil till ett tidsstämplat transkript med talarseparering.
Koden läser in de bibliotek som tillhandahåller funktionerna den behöver. Den läser också in miljövariablerna du har deklarerat i programmets miljö.
Därefter skapar den en ElevenLabs-klient med API-nyckeln som lagras i miljövariabeln. Sedan laddar den ned ljudfilen och omvandlar den till binärdata.
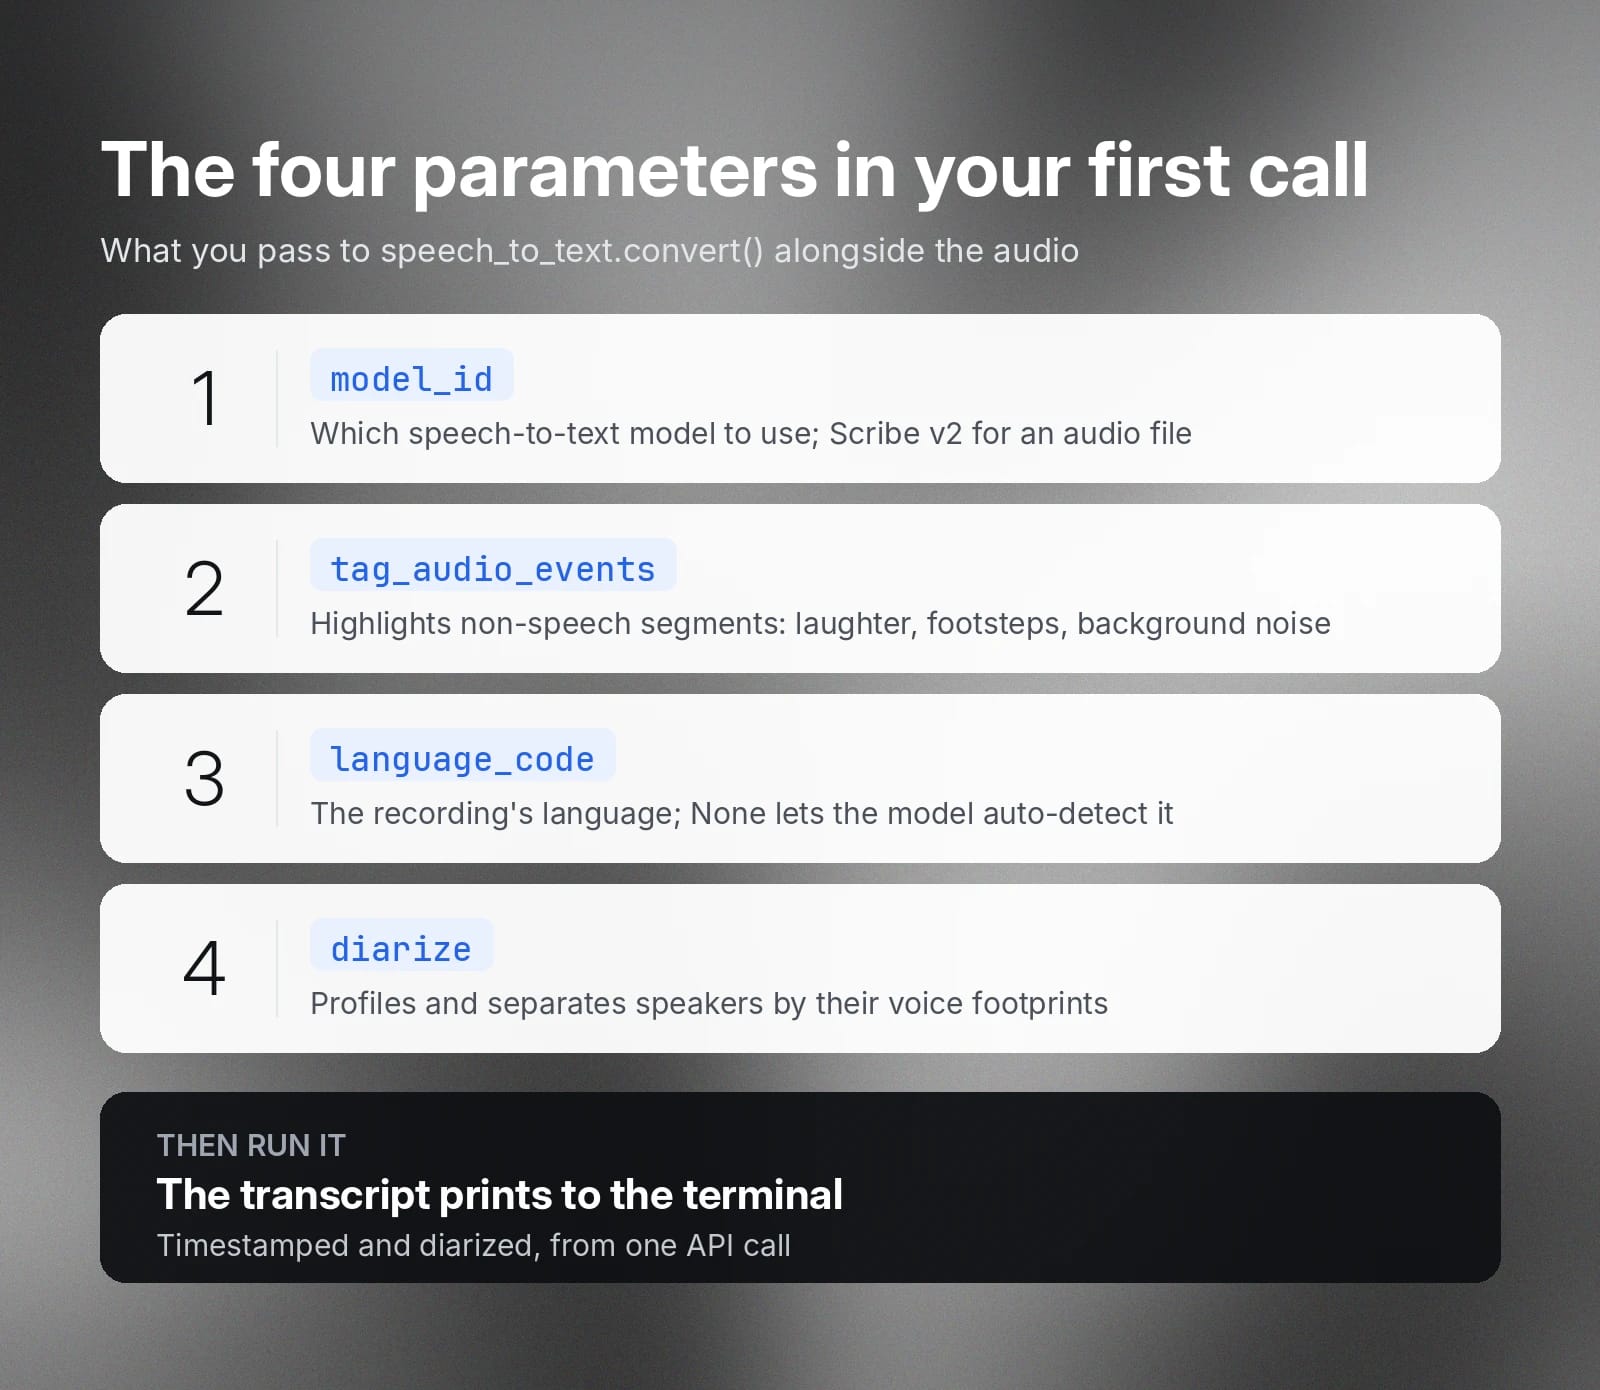
När du har rå ljuddata skickar du den till ElevenLabs API tillsammans med flera parametrar.
- model_id anger vilken tal-till-text-modell du vill använda. Eftersom du skickar en ljudfil är Scribe v2 det bästa alternativet.
- tag_audio_events låter dig markera segment utan tal, till exempel skratt, fotsteg och andra bakgrundsljud.
- language_code anger språket i samtalen i inspelningsfilen. När värdet är None identifierar modellen automatiskt språket.
- diarize anger om du vill att modellen ska profilera och separera olika talare utifrån deras röstegenskaper.
Kör till sist koden, så visas det transkriberade ljudet i terminalen.
Strömmande taligenkänning i Python
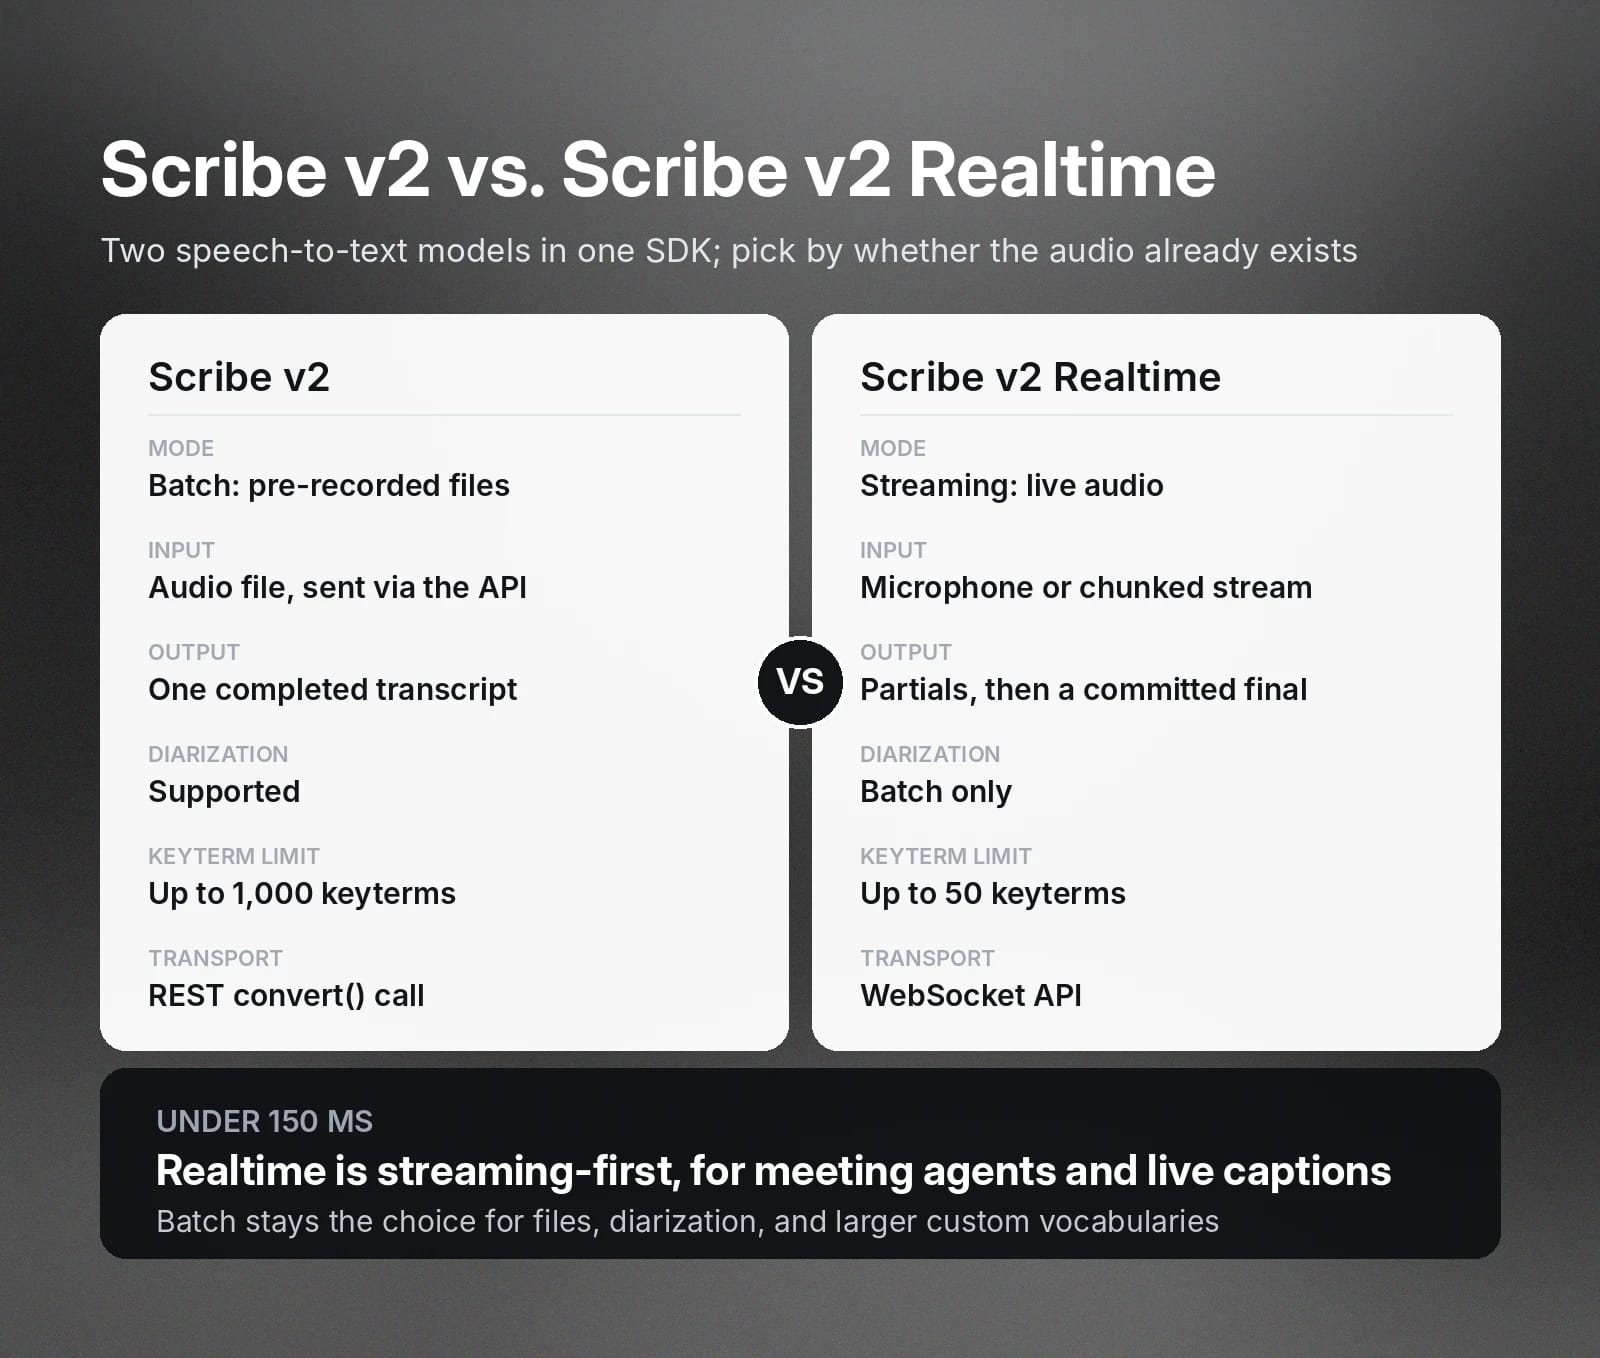
Exemplet ovan gäller batchtranskribering, som passar för förinspelade filer. ElevenLabs erbjuder dock även API:er som låter dig bygga strömmande taligenkänning. Till skillnad från batchbearbetning kör det här läget taligenkänning i realtid för att generera transkript medan samtalet pågår.
För att göra det ansluter du din Python-kod till modellen Scribe v2 Realtime med WebSocket API.
Scribe v2 Realtime erbjuder en arkitektur byggd för streaming, med transkriberingslatens under 150 ms. Du använder Scribe v2 Realtime för att bygga applikationer som mötes-agenter, tillgänglighetsverktyg och röststyrd automatisering. Modellen returnerar ett partiellt transkript medan den bearbetar ljudströmmen. Den returnerar det slutliga transkriptet först när koden bekräftar ett ljudsegment, antingen automatiskt eller manuellt.
Beroende på din ljudkälla och applikationstyp integrerar du taligenkänning med ElevenLabs API antingen på serversidan eller klientsidan.
- Streaming på klientsidan låter dig streama direkt från mikrofonen eller via manuellt uppdelade ljudströmmar.
- Streaming på serversidan skickar ljuddata från en URL eller en ljudkälla till röstmodellen.
Både streaming på klient- och serversidan låter dig använda ett asynkront workflow. I stället för att kontinuerligt polla API:t använder du WebSockets för att hantera resultaten. I din kod behöver du skapa hanterare som tar emot partiella och färdigställda transkript.
Gå vidare: talarseparering, tidsstämplar och anpassat ordförråd
Utöver automatisk taligenkänning har ElevenLabs Speech to Text-modeller stöd för talarseparering, tidsstämplar och anpassat ordförråd.
- Talarseparering: Endast batchtranskribering har stöd för talarseparering. Du aktiverar talarseparering genom att ange argumentet diarize. Transkribering med flera kanaler, ett läge inom batchtranskribering, har dock inte stöd för talarseparering.
- Tidsstämplar: Vid batchtranskribering kan du välja mellan tidsstämplar på ord- eller teckennivå. Det gör du genom att ange parametern timestamps_granularity när du använder metoden convert.
- Anpassat ordförråd: Både realtids- och batchtranskribering har stöd för prompting med nyckeltermer. Funktionen gör att modellen prioriterar att transkribera specifika nyckeltermer som du lägger till i en lista. Scribe v2 Realtime stöder upp till 50 nyckeltermer, medan Scribe v2 stöder 1 000 nyckeltermer.
Använd ElevenLabs-skillen i AI-kodningsassistenter
AI-kodningsassistenter snabbar upp utvecklingen. Om du använder verktyg som Claude Code, Cursor, Codex eller liknande AI-kodningsverktyg kan du lägga till ElevenLabs-skills i kodningsmiljön.
Du behöver bara köra det här kommandot i plattformens terminal:
AI-kodningsagenten laddar ned Speech to Text-skills från ElevenLabs GitHub-repo och installerar den i den lokala skill-katalogen. Då kan du automatiskt generera Python-kod för taligenkänning baserat på ElevenLabs officiella dokumentation, i stället för att skriva hela API-integreringen från grunden.
När den har installerats kan du generera Python-kod för taligenkänning genom att helt enkelt beskriva vad den ska göra med vanligt språk. Utifrån beskrivningen genererar kodningsassistenten automatiskt kod med Speech to Text-skills, rätt modell och rätt parametrar.
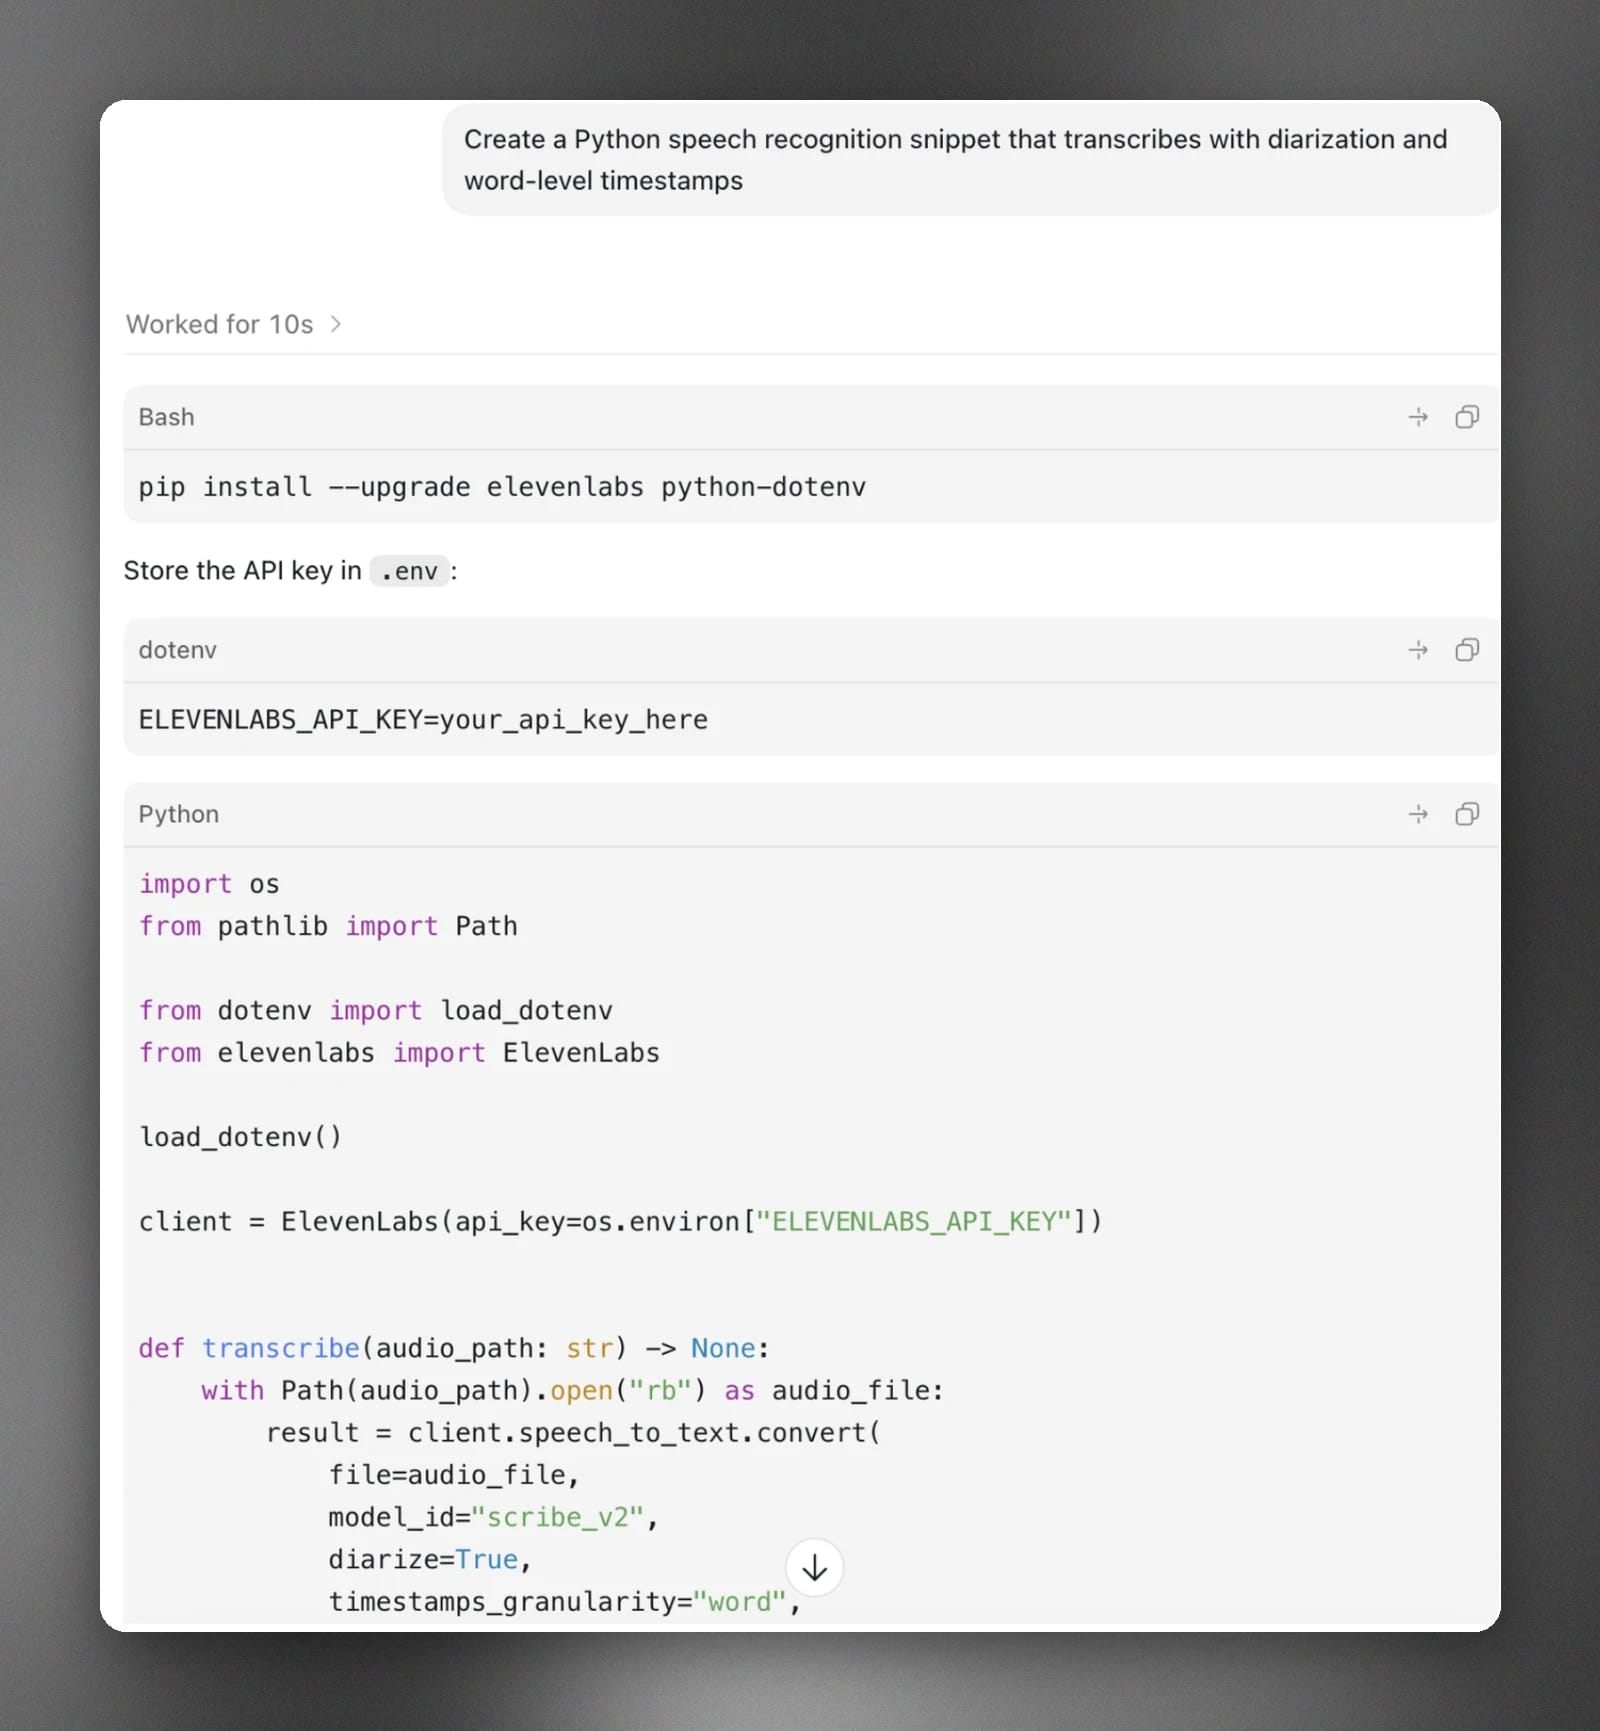
Om du till exempel skriver ”Skapa ett Python-kodexempel för taligenkänning som transkriberar med talarseparering och tidsstämplar på ordnivå” i Codex får du ett liknande exempel som det nedan.
Kom igång med ElevenAPI för taligenkänning
ElevenAPI ger dig åtkomst till avancerade Speech to Text-modeller för att bygga taligenkänningsappar i Python.
Med ElevenAPI slipper du skriva integrationskod från grunden, vilket kan försena produktutvecklingen. I stället använder du SDK:er som ger tillgång till Speech to Text-tjänster som uppfyller kommersiella krav, till exempel prompting med nyckeltermer, talarseparering och tidsstämplar.
Hämta din ElevenLabs API-nyckel nu och utforska vår officiella dokumentation för att lära dig hur API:t fungerar.
Vanliga frågor

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.


