Identifiering av ljud-deepfakes: Så fungerar det och så verifierar du ljud från ElevenLabs
- Skriven av
- Jack Limebear
- Publicerad
LyssnaLyssna på den här artikeln
Identifiering av ljud-deepfakes innebär att analysera röstljud för att avgöra om talet är äkta. AI-röstsyntetiserare som skapar deepfakes blir allt mer tillgängliga. Det har blivit viktigt både i samhällslivet och näringslivet att snabbt avgöra om talet du hör är äkta eller har manipulerats av en illasinnad aktör.
I den här artikeln går vi igenom hur identifiering av ljud-deepfakes fungerar, olika typer av identifiering, deras styrkor och svagheter samt hur du kan integrera deepfake-identifiering i system för bedrägeriidentifiering i stor skala.
Sammanfattning
- Deepfake-genererat tal blir allt svårare att upptäcka enbart med hörseln. Det medför en betydande risk både i samhällslivet och näringslivet.
- Det finns flera typer av programvara för identifiering av deepfakes. Traditionella verktyg använder statistisk analys för att bedöma sannolikheten att ett ljudprov är AI-genererat.
- Ny teknik för vattenmärkning ger dig ett definitivt ja- eller nej-svar på om ett röstprov har syntetiserats.
- Vattenmärkning är mycket träffsäker, men detektorer fungerar bara på en leverantörs eget ljud. ElevenLabs Audio Detector kan till exempel identifiera vattenmärken som skapats av våra egna produkter med hög träffsäkerhet, men inte vattenmärken från andra företag.
- Vattenmärkning är en viktig resurs för organisationer som behöver identifiera deepfakes i stor skala, men den bör bara vara ett av många verktyg i deras system för deepfake-identifiering.
Vad är identifiering av ljud-deepfakes?
Identifiering av ljud-deepfakes innebär att avgöra om röstljud har genererats eller manipulerats av artificiell intelligens.
En deepfake är en form av media, oftast bild, video eller ljud, som skapats av en generativ AI-applikation i syfte att förvanska vad någon säger eller gör. Ljud-deepfakes kan användas i många skadliga syften. De kan användas för bedrägerier, för att försöka få åtkomst till personliga konton, som politisk propaganda eller för att i hemlighet utge sig för att vara en make, maka eller familjemedlem i familjetvister.
Utifrån aktuella trender är följande grupper mest sannolikt offer för bedrägerier med ljud-deepfakes:
- Politiker och andra offentliga personer: Personer med omfattande röstprover tillgängliga online för träning kan få sin röst använd i deepfakes av motståndare eller tredje parter för att vilseleda allmänheten.
- Familjemedlemmar: En illasinnad aktör kan försöka använda hittade röstinspelningar för att lura äldre familjemedlemmar med deepfake-baserade förfrågningar om pengar.
- Företagsledare: Falska intervjuer, presentationer och kvartalssamtal kan användas för att skada ett företags varumärke.
- Kundtjänstteam: Bedragare kan använda insamlade röstprover för att lura kundtjänstteam att ge åtkomst till privata konton.
Tyvärr är människor inte tillförlitliga på att upptäcka deepfakes. I kontrollerade forskningsmiljöer är människors förmåga att identifiera dem inte bättre än slumpen, och den forskningen är från 2024. Generativa medier har blivit betydligt mer sofistikerade sedan dess.
Utbildning och lagstiftning kan göra mycket för att skydda samhället mot deepfakes påverkan, men tillförlitliga identifieringsmetoder behövs fortfarande.
Hur fungerar identifiering av ljud-deepfakes?
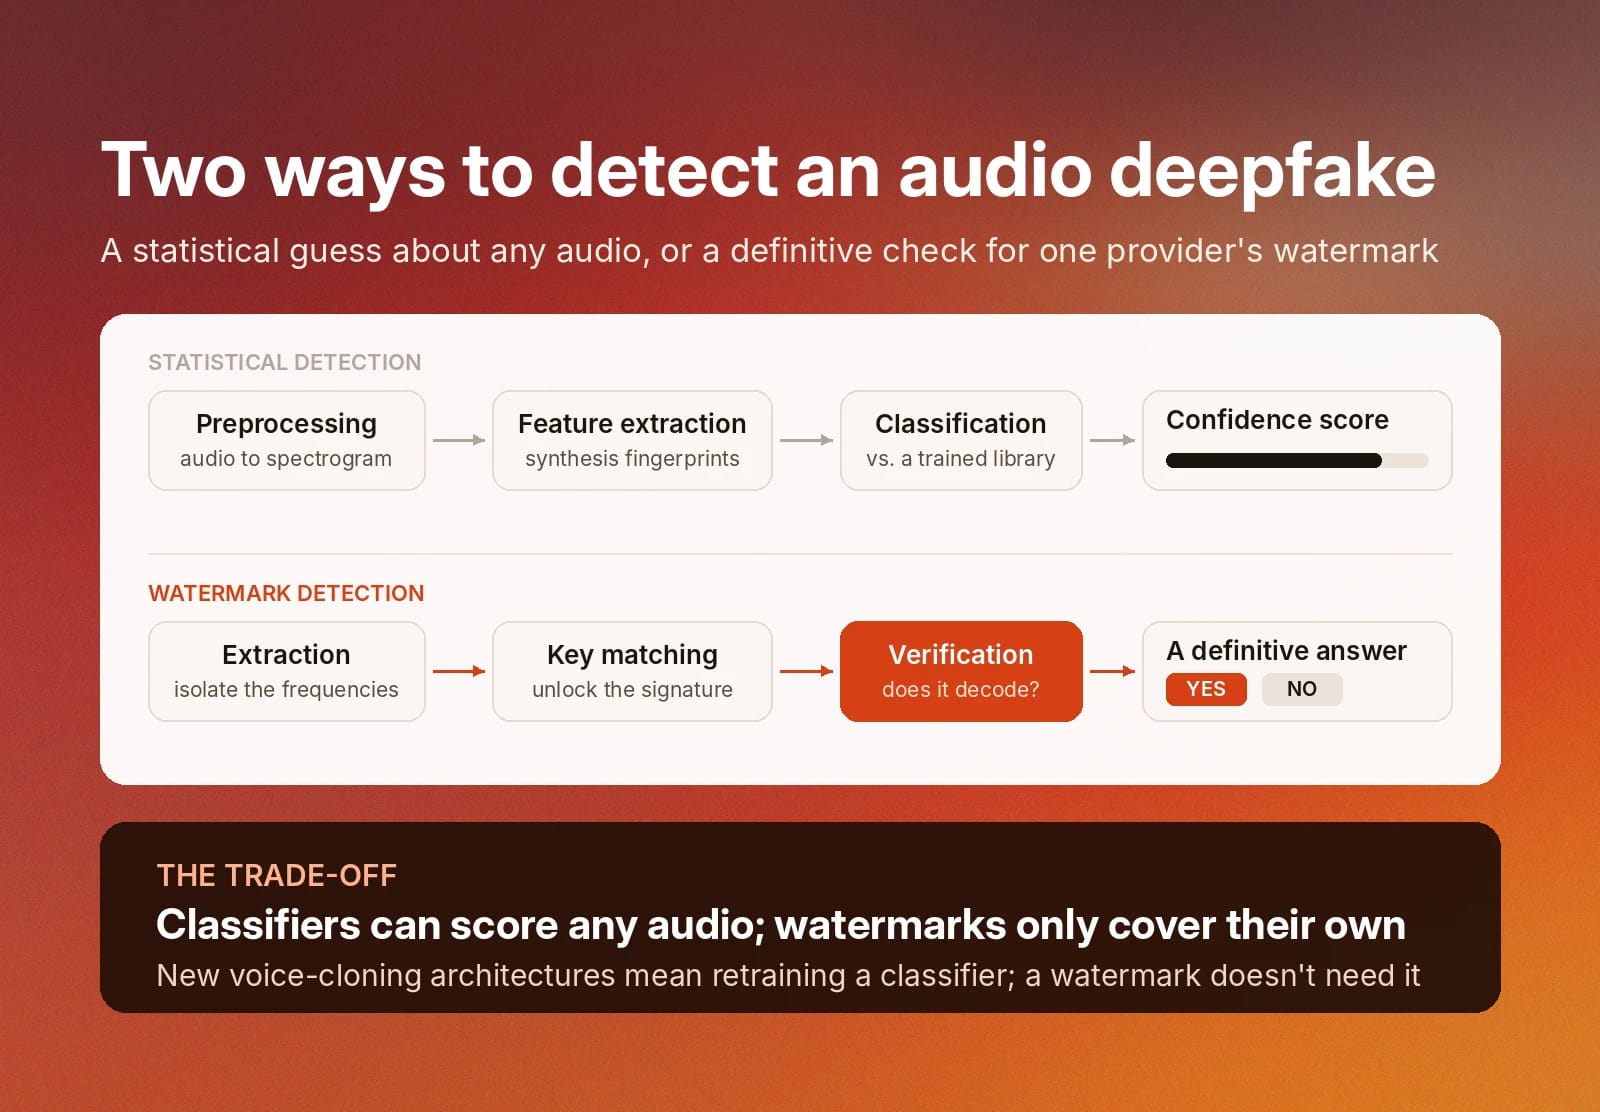
Traditionell identifiering av deepfakes använder statistisk analys för att mäta sannolikheten att media har genererats av AI. Ett identifieringsverktyg använder maskininlärning för att känna igen underliggande mönster i olika typer av syntetiserat tal.
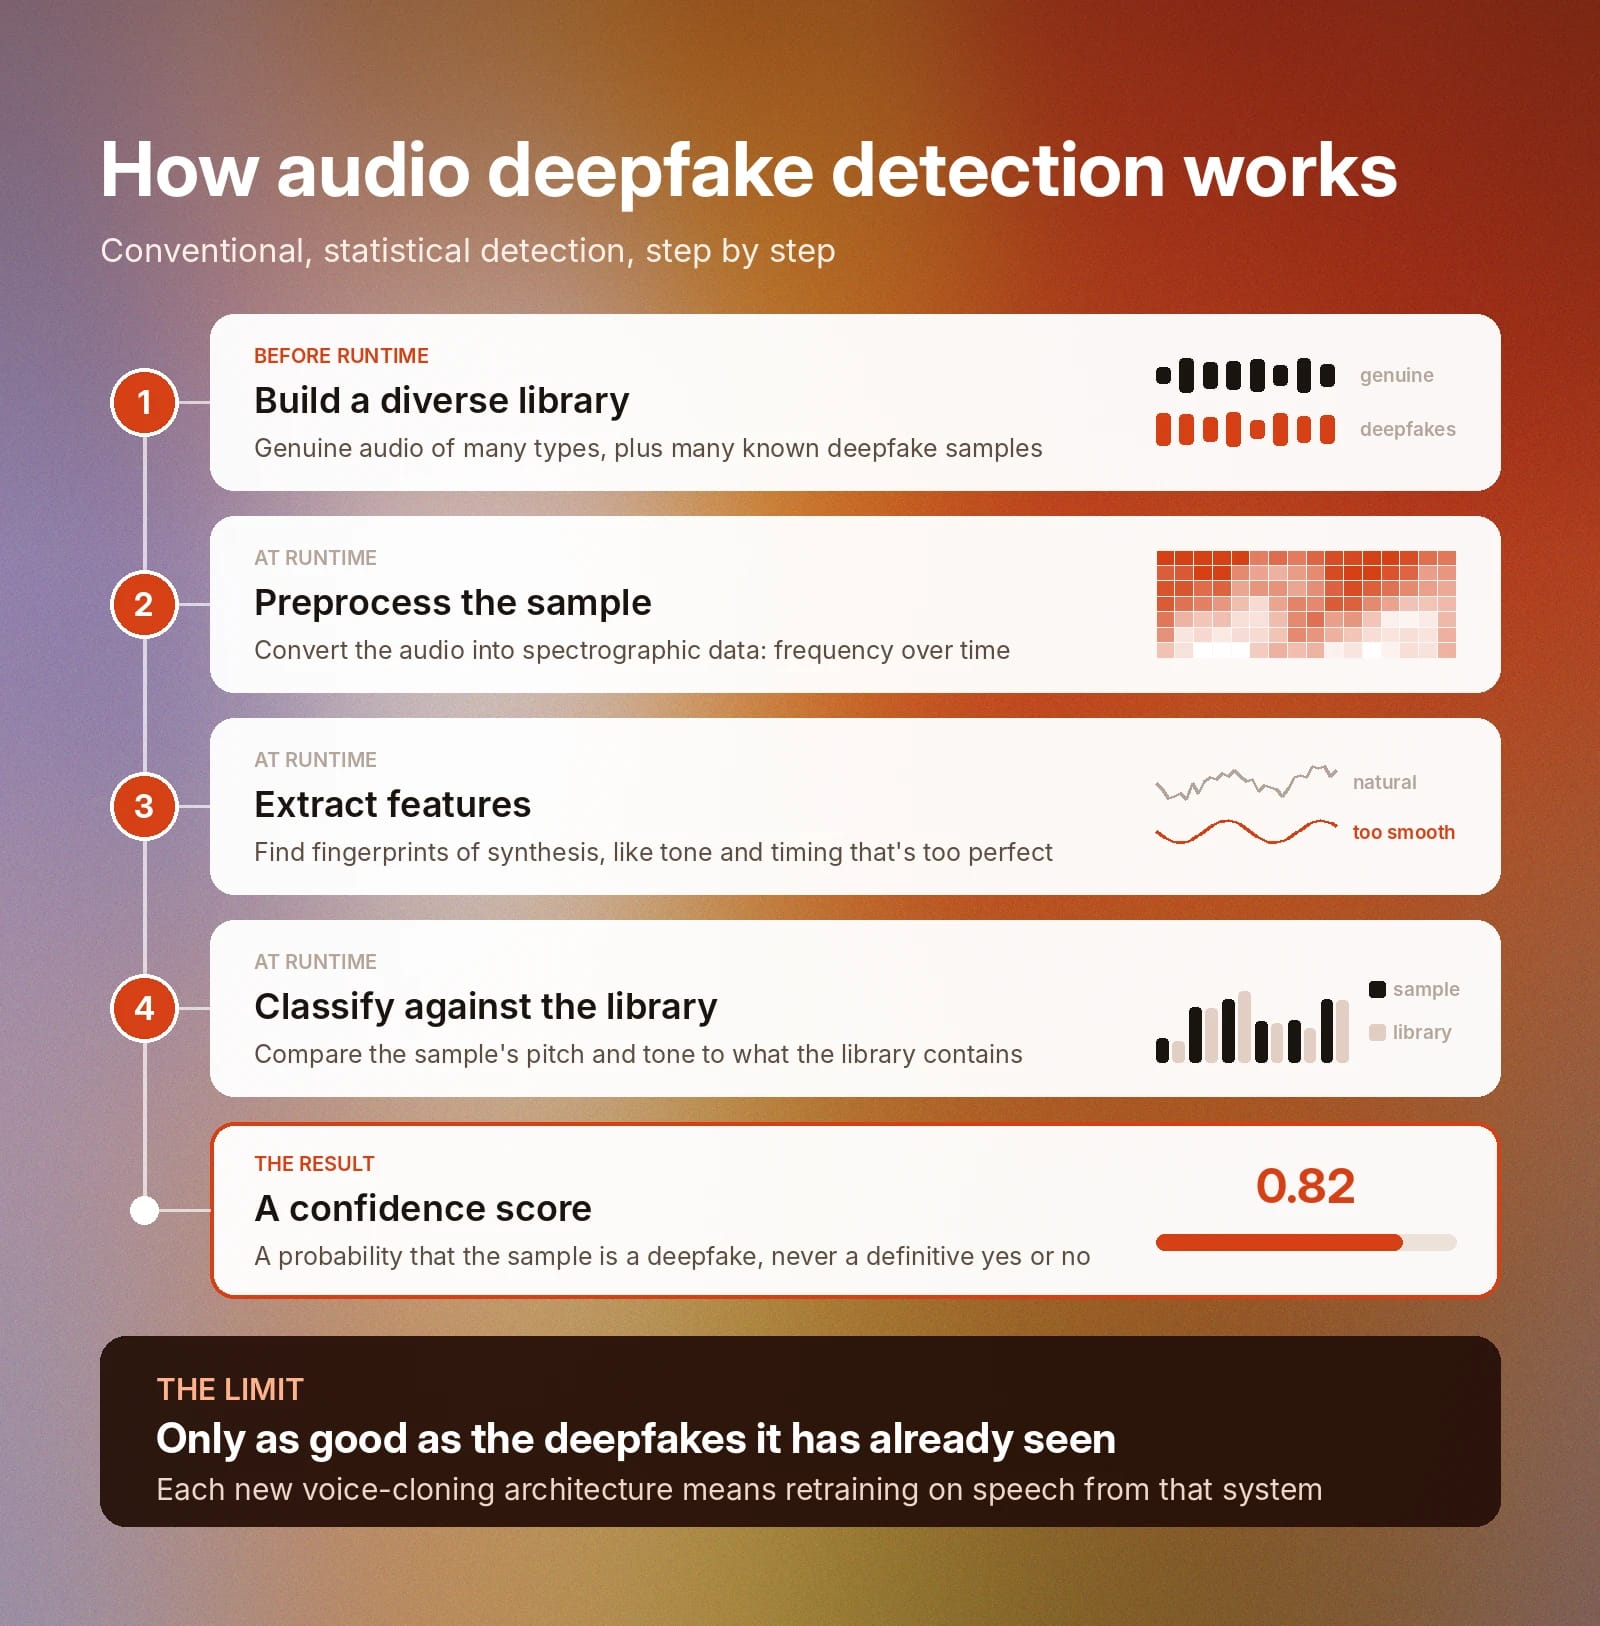
Första steget är att bygga ett bibliotek med ljudinnehåll som misstänkta deepfakes kan jämföras med. Det bör vara en varierad datamängd med äkta ljudprover av många slag och många kända deepfake-prover för att underlätta positiva identifieringar.
Vid körning följer processen tre steg: förbehandling, extraktion av egenskaper och klassificering.
Förbehandling av ljud
När du ger ett tränat identifieringsverktyg ett ljudprov omvandlar det provet till spektrografiska data, alltså en matematisk representation av frekvensförändringar över tid.
Extraktion av egenskaper
Sedan extraherar identifieringsverktyget egenskaper från provdatan som fungerar som fingeravtryck för syntetiserat tal. AI-tal är till exempel ibland för perfekt och saknar de variationer i ton och timing som finns i naturligt tal. Genom att jämföra talarens tonhöjd och tonläge med sitt bibliotek kan verktyget också identifiera andra varningssignaler.
Klassificering
Eftersom traditionell identifiering av deepfakes bygger på statistisk analys kan den inte ge ett definitivt ”ja” eller ”nej” på frågan om ett prov är en deepfake. I stället genererar den ett konfidensvärde, eller en sannolikhet, för att provet är en deepfake.
Eftersom traditionella verktyg mäter likheter mellan ett prov och ett befintligt ljudbibliotek begränsas de av de kända deepfake-prover de har tillgång till. Varje gång någon släpper en ny arkitektur för röstkloning måste du träna om identifieringsverktyget på tal som syntetiserats i det nya systemet för att kunna identifiera det korrekt.
Vad är skillnaden mellan vattenmärkning och statistisk identifiering?
Vattenmärkning är en helt annan metod för talklassificering. En maskininlärningsklassificerare gör en sannolikhetsbedömning av om ett prov är äkta utifrån vad träningsdatan visar om naturligt tal, exempelvis hur verklig känslomässig tyngd och betoning ser ut i spektrografiska data samt vilka förändringar i ton och timing som är naturliga.
Vattenmärkning är deterministisk. Ett vattenmärke är en matematisk signatur som bäddas in i ljuddata av syntetiseraren på nivåer som en mänsklig lyssnare inte kan höra. En vattenmärkesdetektor bekräftar med ja eller nej om den hittar den dolda signaturen.
En detektor arbetar i tre enkla steg:
- Extraktion: Verktyget extraherar spektrografiska data och isolerar frekvenserna där det förväntar sig att hitta ett vattenmärke.
- Nyckelmatchning: Det försöker låsa upp signaturen med en nyckel.
- Verifiering: Om signalen avkodas korrekt bekräftar verktyget att den aktuella AI-röstgeneratorn genererade ljudet.
ElevenLabs process för identifiering av vattenmärken
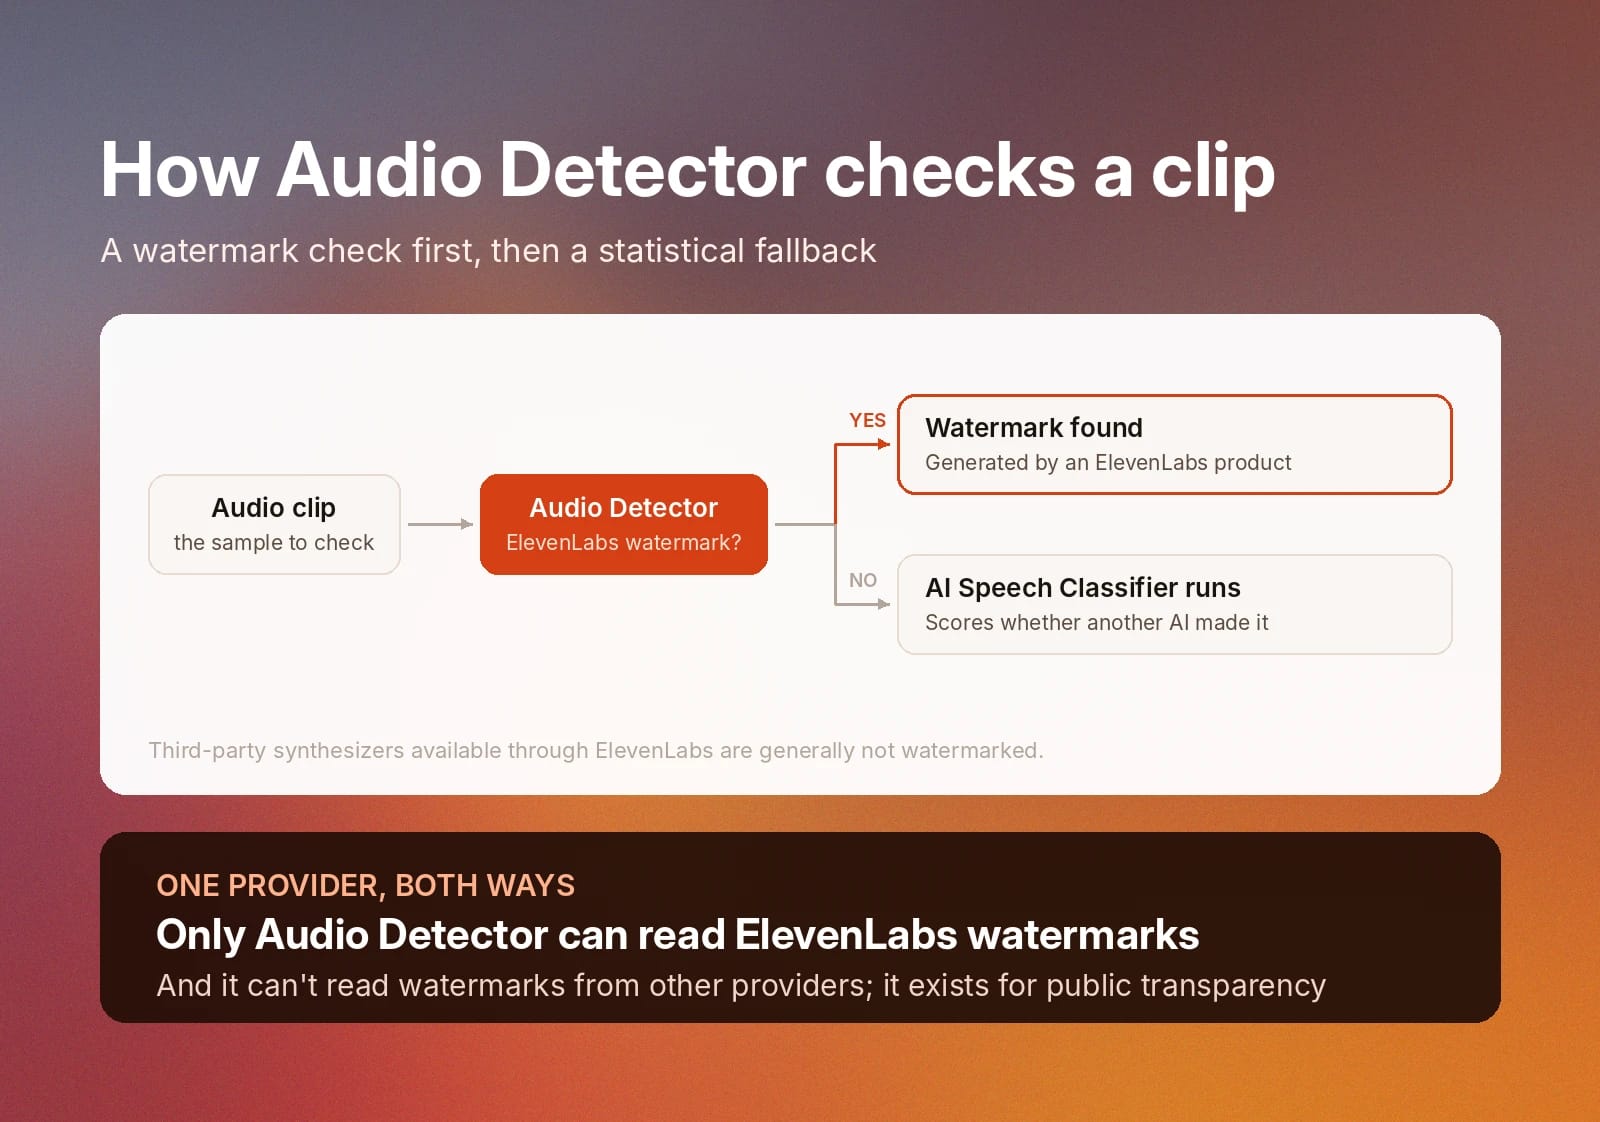
ElevenLabs verktyg för vattenmärkning är Audio Detector. Det skannar ljudprover och verifierar om innehållet har genererats av en produkt från ElevenLabs. Om det inte hittar något vattenmärke kör det sedan den statistiska AI Speech Classifier för att bedöma om ljudet är AI-genererat från en annan källa.
På grund av hur vattenmärkning fungerar identifierar ElevenLabs Audio Detector bara ljud som genererats av ElevenLabs. Den kan för närvarande inte identifiera vattenmärken från andra leverantörer av AI-röster.
Omvänt är det bara ElevenLabs Audio Detector som kan identifiera vattenmärken från ElevenLabs.
Observera också att innehåll som genereras av tredjepartssyntetiserare som är tillgängliga via ElevenLabs vanligtvis inte är vattenmärkt.
Andra alternativ för att identifiera ljud som genererats av ElevenLabs
ElevenCreative AI Speech Classifier är tillgänglig gratis och utan inloggning. Den analyserar den första minuten av ett ljudprov och ger ett konfidensvärde för hur sannolikt det är att ljudet genererats av en modell från ElevenLabs.
Observera att den inte kan klassificera ljud från Eleven v3 på ett tillförlitligt sätt. Den fungerar bäst för att klassificera ljud som genererats av äldre TTS-modeller från ElevenLabs. Träffsäkerheten minskar också när den analyserar kraftigt komprimerat eller redigerat talinnehåll.
Hur kan du identifiera syntetiska röster i stor skala?
Vissa företagsteam behöver kunna identifiera deepfakes i stor skala, i nära realtid. Ta ett nationellt banks kundtjänstteam som exempel. Dess medarbetare interagerar med tusentals kunder varje dag. Teamet måste regelbundet dela och uppdatera privata kontouppgifter.
Teamets ledning bryr sig mycket om hur snabbt de både kan identifiera en bedräglig uppringare och svara legitima kunder. De behöver ett system för röstidentifiering som kan identifiera ljud från alla stora röstgenereringsmotorer live under kundsamtal.
Bygg ett komplett system för röstidentifiering
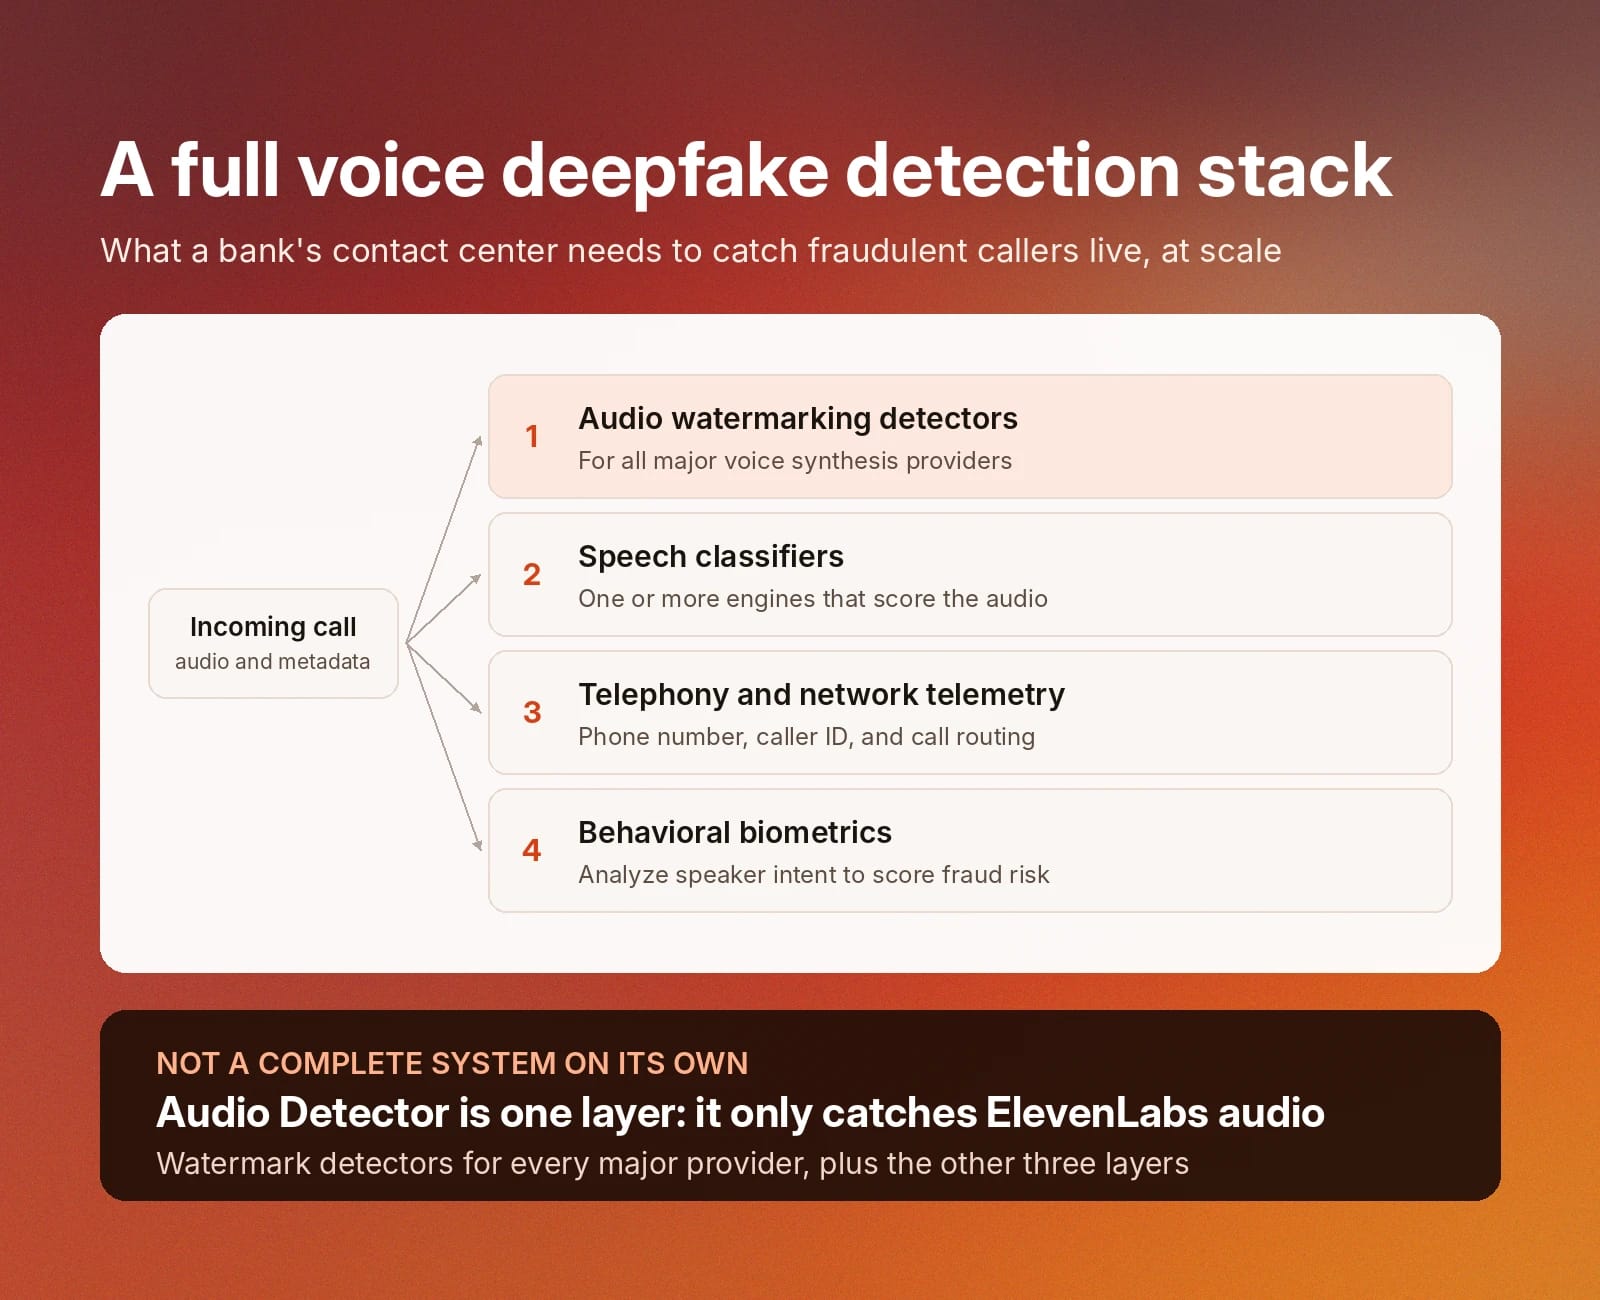
ElevenLabs Audio Detector spelar en viktig roll här, men det är viktigt att återigen notera att den bara identifierar ljud från ElevenLabs med vattenmärkning. Den är inte ett komplett system för röstidentifiering på egen hand. Organisationer som vill ha full kapacitet för röstidentifiering behöver sätta samman flera olika typer av verktyg:
- Detektorer för vattenmärkning av ljud: För alla större leverantörer av röstsyntes.
- Talklassificerare: En eller flera klassificeringsmotorer som kan bedöma ljuddata.
- Telefoni- och nätverkstelemetri: Analys av samtalsmetadata, som telefonnummer, nummerpresentation och samtalsdirigering.
- Beteendebiometri: Programvara som analyserar talarens avsikt för att bedöma risken för bedrägeri.
Kom igång med ElevenLabs identifiering av deepfakes
ElevenLabs vill bidra positivt till samhällslivet, både genom meningsfulla tjänster för röstgenerering och genom att ge allmänheten de verktyg som behövs för att identifiera deepfakes och annan skadlig användning av AI-genererat ljud.
Har du ett ljudklipp som du vill testa för deepfakes? Registrera dig för att prova ElevenLabs Audio Detector eller kom igång med AI Speech Classifier redan idag.
Vanliga frågor

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.