Testa Conversational AI-agenter
- Skriven av
- Anna Neely
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
När konversationsbaserade röstassistenter tas i drift, hur övervakar du dem i stor skala? Hur upptäcker du när de inte beter sig som avsett? Och när du har gjort ändringar, hur testar du dem?
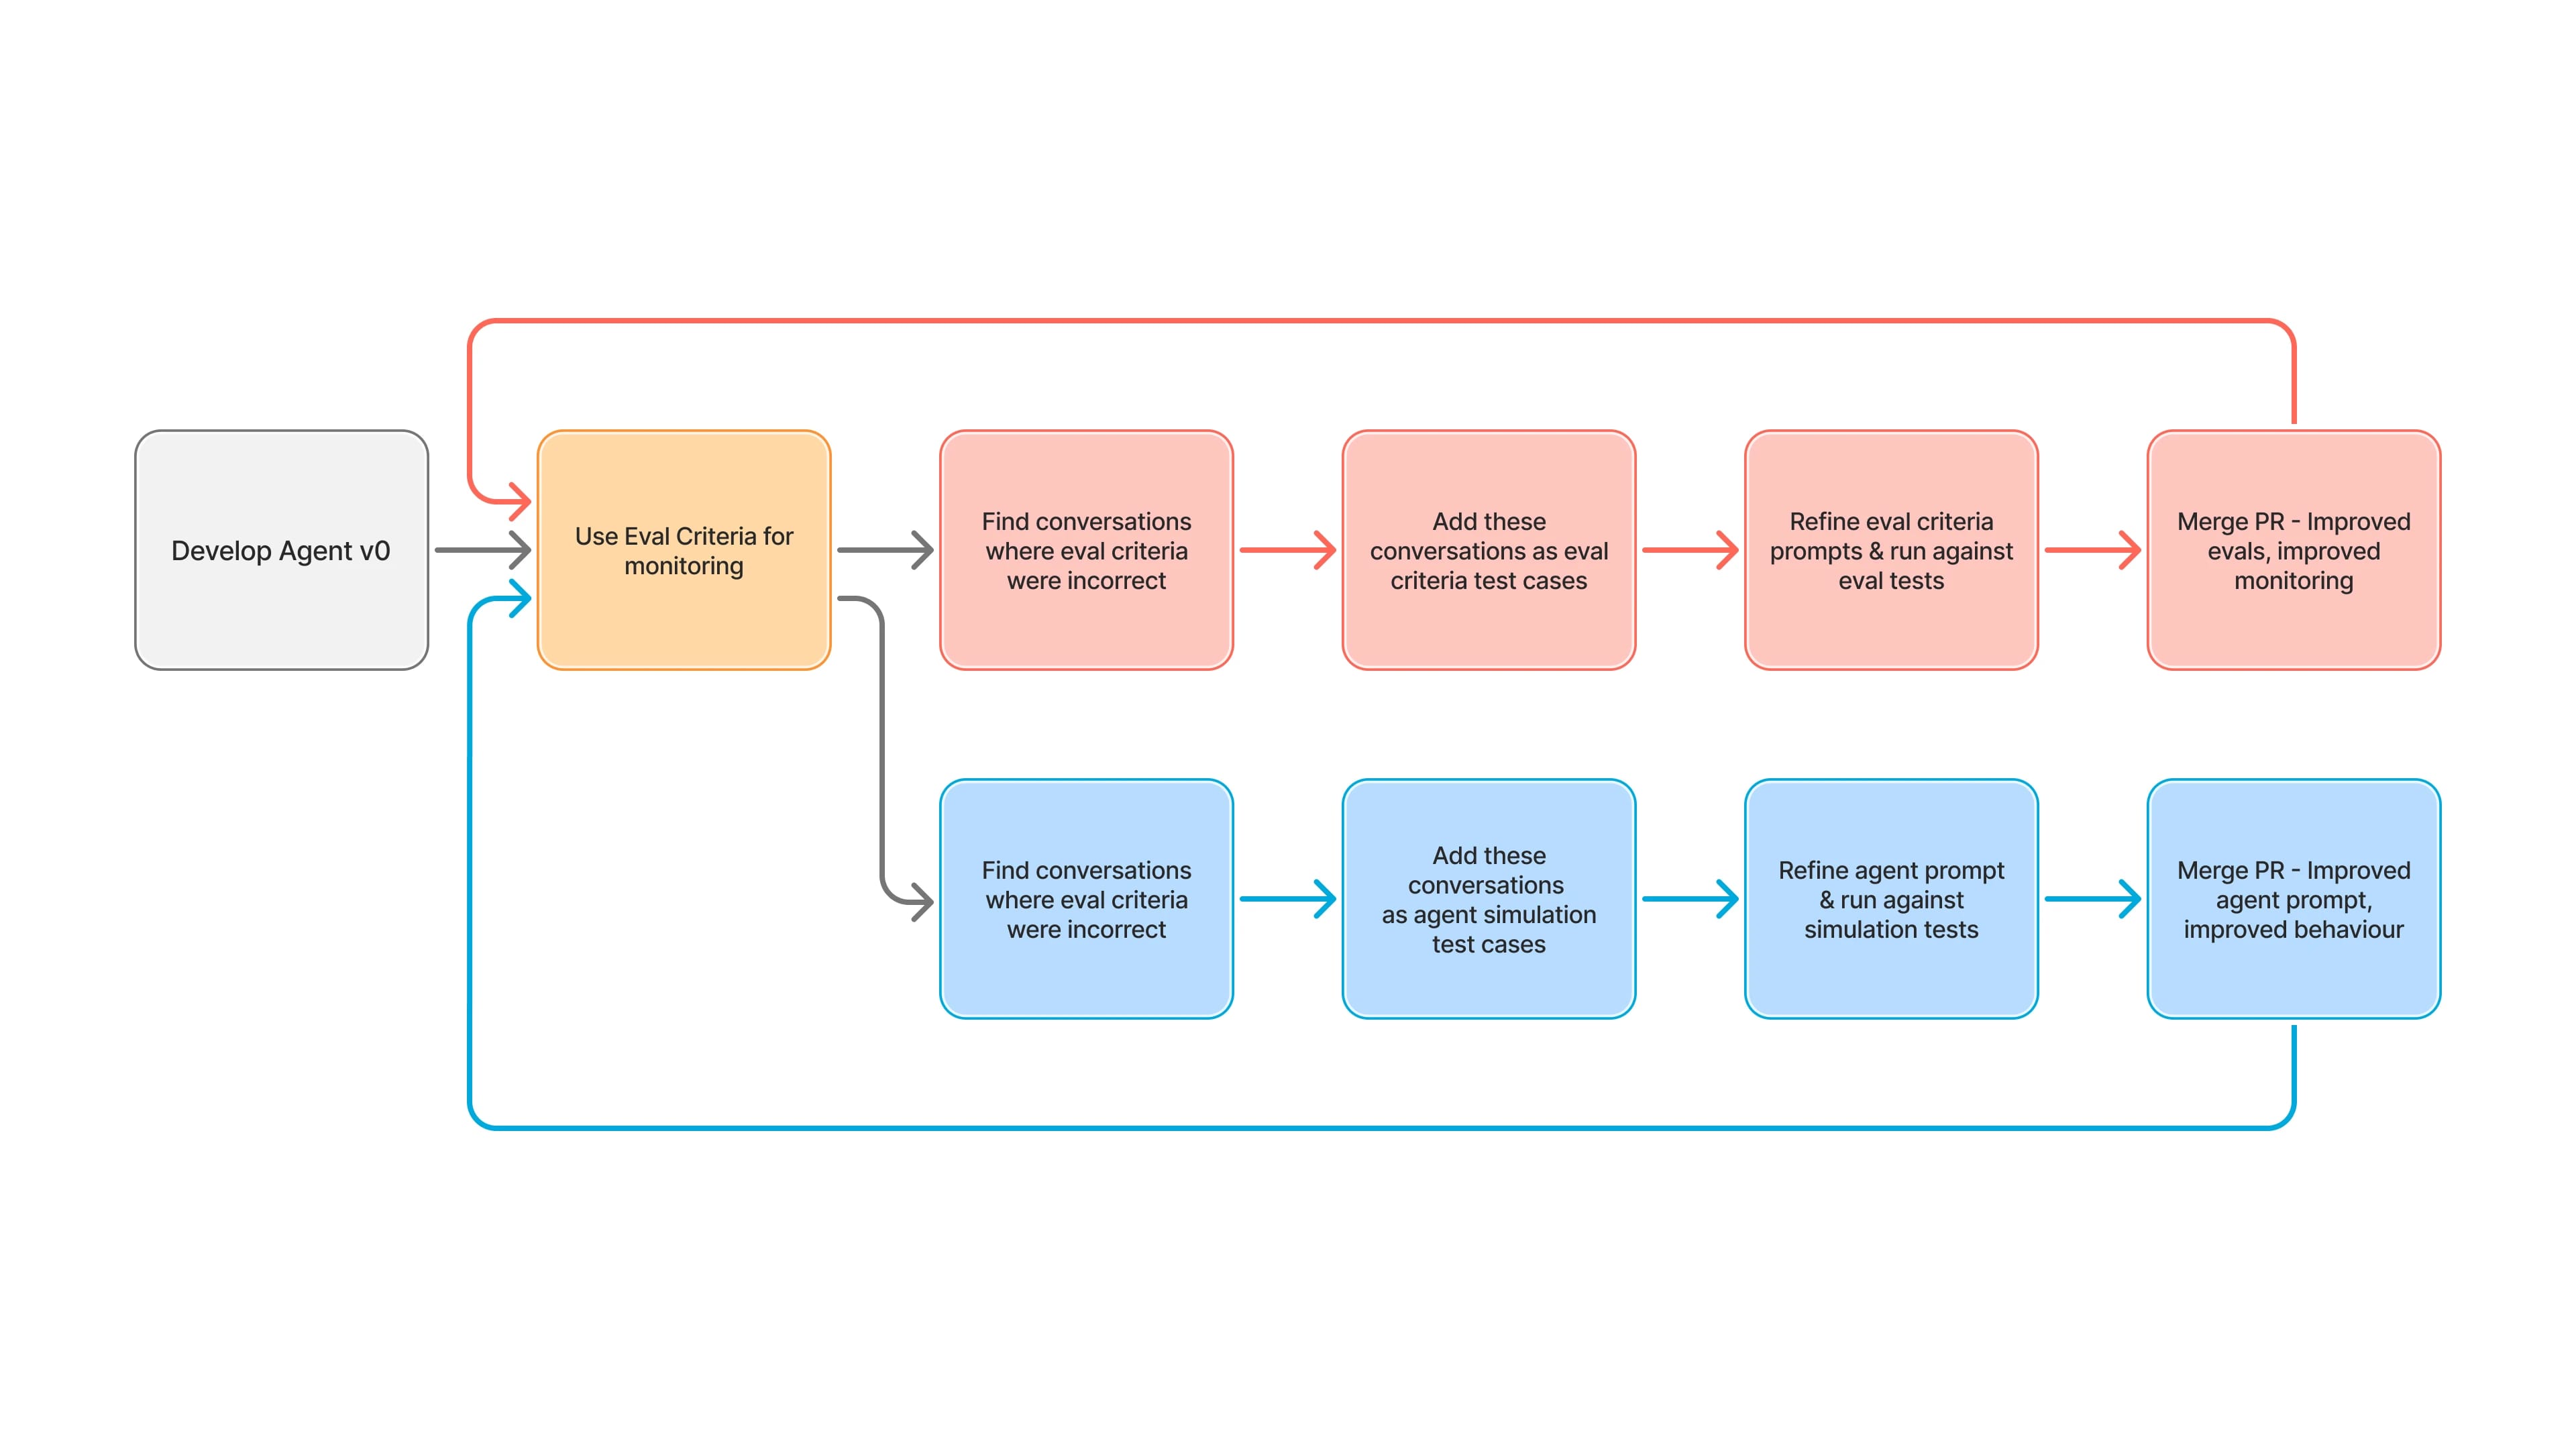
De här frågorna formade vårt arbete med El, vår dokumentationsassistent som drivs av Conversational AI. I takt med att El utvecklades byggde vi ett system för att övervaka, utvärdera och testa assistenter, baserat på utvärderingskriterier och konversationssimuleringar.
Lägg grunden: Tillförlitliga utvärderingskriterier
Att förbättra en assistent börjar med att förstå hur den beter sig i praktiken. Det innebar att förfina våra utvärderingskriterier och se till att de var tillräckligt korrekta och tillförlitliga för att övervaka assistentens prestanda. Vi definierar ett misslyckat samtal som ett där assistenten antingen ger felaktig information eller inte hjälper användaren att nå sitt mål.
Vi tog fram följande utvärderingskriterier:
- Interaktion: är detta ett giltigt samtal, ställde användaren relevanta frågor, var samtalet rimligt?
- Positiv interaktion: var användaren nöjd efteråt, eller var personen förvirrad eller frustrerad?
- Förstå grundorsaken: identifierade assistenten korrekt användarens underliggande problem?
- Lösa användarens fråga: löste assistenten användarens problem eller erbjöd den en alternativ supportmetod?
- Hallucination: hittade assistenten på information som inte finns i kunskapsbasen?
Om Interaktion misslyckas är själva samtalet inte giltigt. Om något annat kriterium misslyckas undersöker vi det närmare. Undersökningen vägleder hur vi förbättrar assistenten. Ibland handlar det om att förfina användningen av verktyg eller tidpunkter. Andra gånger lägger vi till skyddsräcken för att förhindra åtgärder som inte stöds.
Iterera med tillförsikt: Conversation Simulation API
När vi har identifierat vad som behöver förbättras är nästa steg att testa. Det är där vårt Conversation Simulation API kommer in. Det simulerar realistiska användarscenarier – både från början till slut och i riktade segment – och utvärderar automatiskt resultaten med samma kriterier som vi använder i produktion. Det stöder mockning av verktyg och anpassad utvärdering, vilket gör det flexibelt nog att testa specifika beteenden.
Vi använder två metoder:
- Fullständiga simuleringar: Testa hela samtal från början till slut.
- Delvisa simuleringar: Börja mitt i samtalet för att validera beslutspunkter eller delflöden. Det här är vår förstahandsmetod för enhetstestning och möjliggör snabb iteration och riktad felsökning.
Tydliga, fokuserade scenarier gör att vi kan styra vad LLM:en testas på och säkerställa täckning för specialfall, verktygsanvändning och fallback-logik.
Automatisering i stor skala: Bädda in tester i CI/CD
Den sista delen är automatisering. Vi använde ElevenLabs öppna API:er för att ansluta till vårt GitHub DevOps-flöde genom att bädda in utvärdering och simulering i vår CI/CD-pipeline. Varje uppdatering testas automatiskt före driftsättning. Det förhindrar regressioner och ger oss snabb återkoppling om prestanda i praktiken.
Resultat: En starkare och smartare El
Den här processen förändrade hur vi bygger och underhåller El. Vi har skapat en återkopplingsloop som kopplar samman verklig användning med strukturerad utvärdering, riktad testning och automatiserad validering. Det gör att vi kan lansera förbättringar snabbare och med större tillförsikt.
Och det är ett ramverk som vi nu kan använda för varje assistent vi bygger.



