
Word error rate (WER): Viktiga begrepp, formel och användningsområden
- Skriven av
- Jack Limebear
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
I teorin är word error rate (WER) ett mått på träffsäkerheten hos ett Automatic Speech Recognition-verktyg (ASR). Ett lågt WER innebär att det slutliga transkriptet är mer korrekt, medan en högre felkvot visar på feltranskriberad information.
I praktiken kan WER vara skillnaden mellan medicinsk transkriptionsprogramvara som skriver att en patient behöver ”femton milligram” i stället för ”femtio milligram” av ett receptbelagt läkemedel. Det är skillnaden mellan ett supportverktyg som korrekt transkriberar kundens behov och ett som gör användaren frustrerad.
I den här artikeln går vi igenom vad WER är, hur du beräknar det och hur du använder det för att jämföra din egen ASR-leverantör.
Sammanfattning
- Word error rate räknar tre typer av fel: ersättningar, utelämningar och tillägg, dividerat med antalet ord i referenstranskriptet.
- Formeln för WER är WER = (S + D + I) / N.
- Lägre WER-värden innebär att slutresultatet är mer korrekt.
- Ett WER under 5 % är ett bra riktmärke, även om juridiska eller medicinska transkriberingar kan kräva en ännu lägre Word Error Rate.
- WER behandlar alla fel som likvärdiga, vilket innebär att det inte är ett perfekt mått för bedömning utifrån sammanhanget. Nyare mått, som Semantic Word Error Rate (SWER), försöker lösa detta genom att mäta om innebörden i ett yttrande har bevarats.
Vad är word error rate?
Word error rate (WER) är standardmåttet för att mäta taligenkänningens träffsäkerhet i tal-till-text-modeller. Det anger på en skala från 0 till 1 (0,8 motsvarar en felkvot på 80 %) vad ett STT-system får fel vid transkribering, baserat på dess ersättningar, utelämningar och tillägg.
En ersättning innebär att ett ord byts ut mot fel ord. En utelämning innebär att ett ord helt missas. Ett tillägg innebär slutligen att transkriptet innehåller ett ord som aldrig uttalades. WER använder alla dessa tre komponenter och dividerar sedan med antalet ord i det korrekta transkriptet. Resultatet är ett tal som du kan använda för att jämföra olika leverantörer.
Här är formeln för WER utskriven:
WER = (S + D + I) / N
Där:
- S: Ersättningar (ordet är fel)
- D: Utelämningar (ordet saknas)
- I: Tillägg (ytterligare ett ord finns med)
- N: Totalt antal ord i referenstranskriptet
Du kan uttrycka WER som antingen ett decimaltal eller en procentsats. Ju lägre WER, desto bättre resultat, eftersom modellen gjorde färre fel vid transkriberingen.
I praktiken innebär ett WER på 10 % att ungefär 1 av 10 ord i ditt mötestranskript behöver granskas en extra gång.
Varför är word error rate viktigt i taligenkänningssystem?
Word error rate ger team ett objektivt mått för att jämföra olika leverantörer. Det ser förbi marknadsföringspåståenden och visar tydligt hur träffsäker en taligenkänningsmodell är. Med fakta som grund får företag som utvärderar sina alternativ en tydlig bild av vilka modeller som leder utvecklingen just nu.
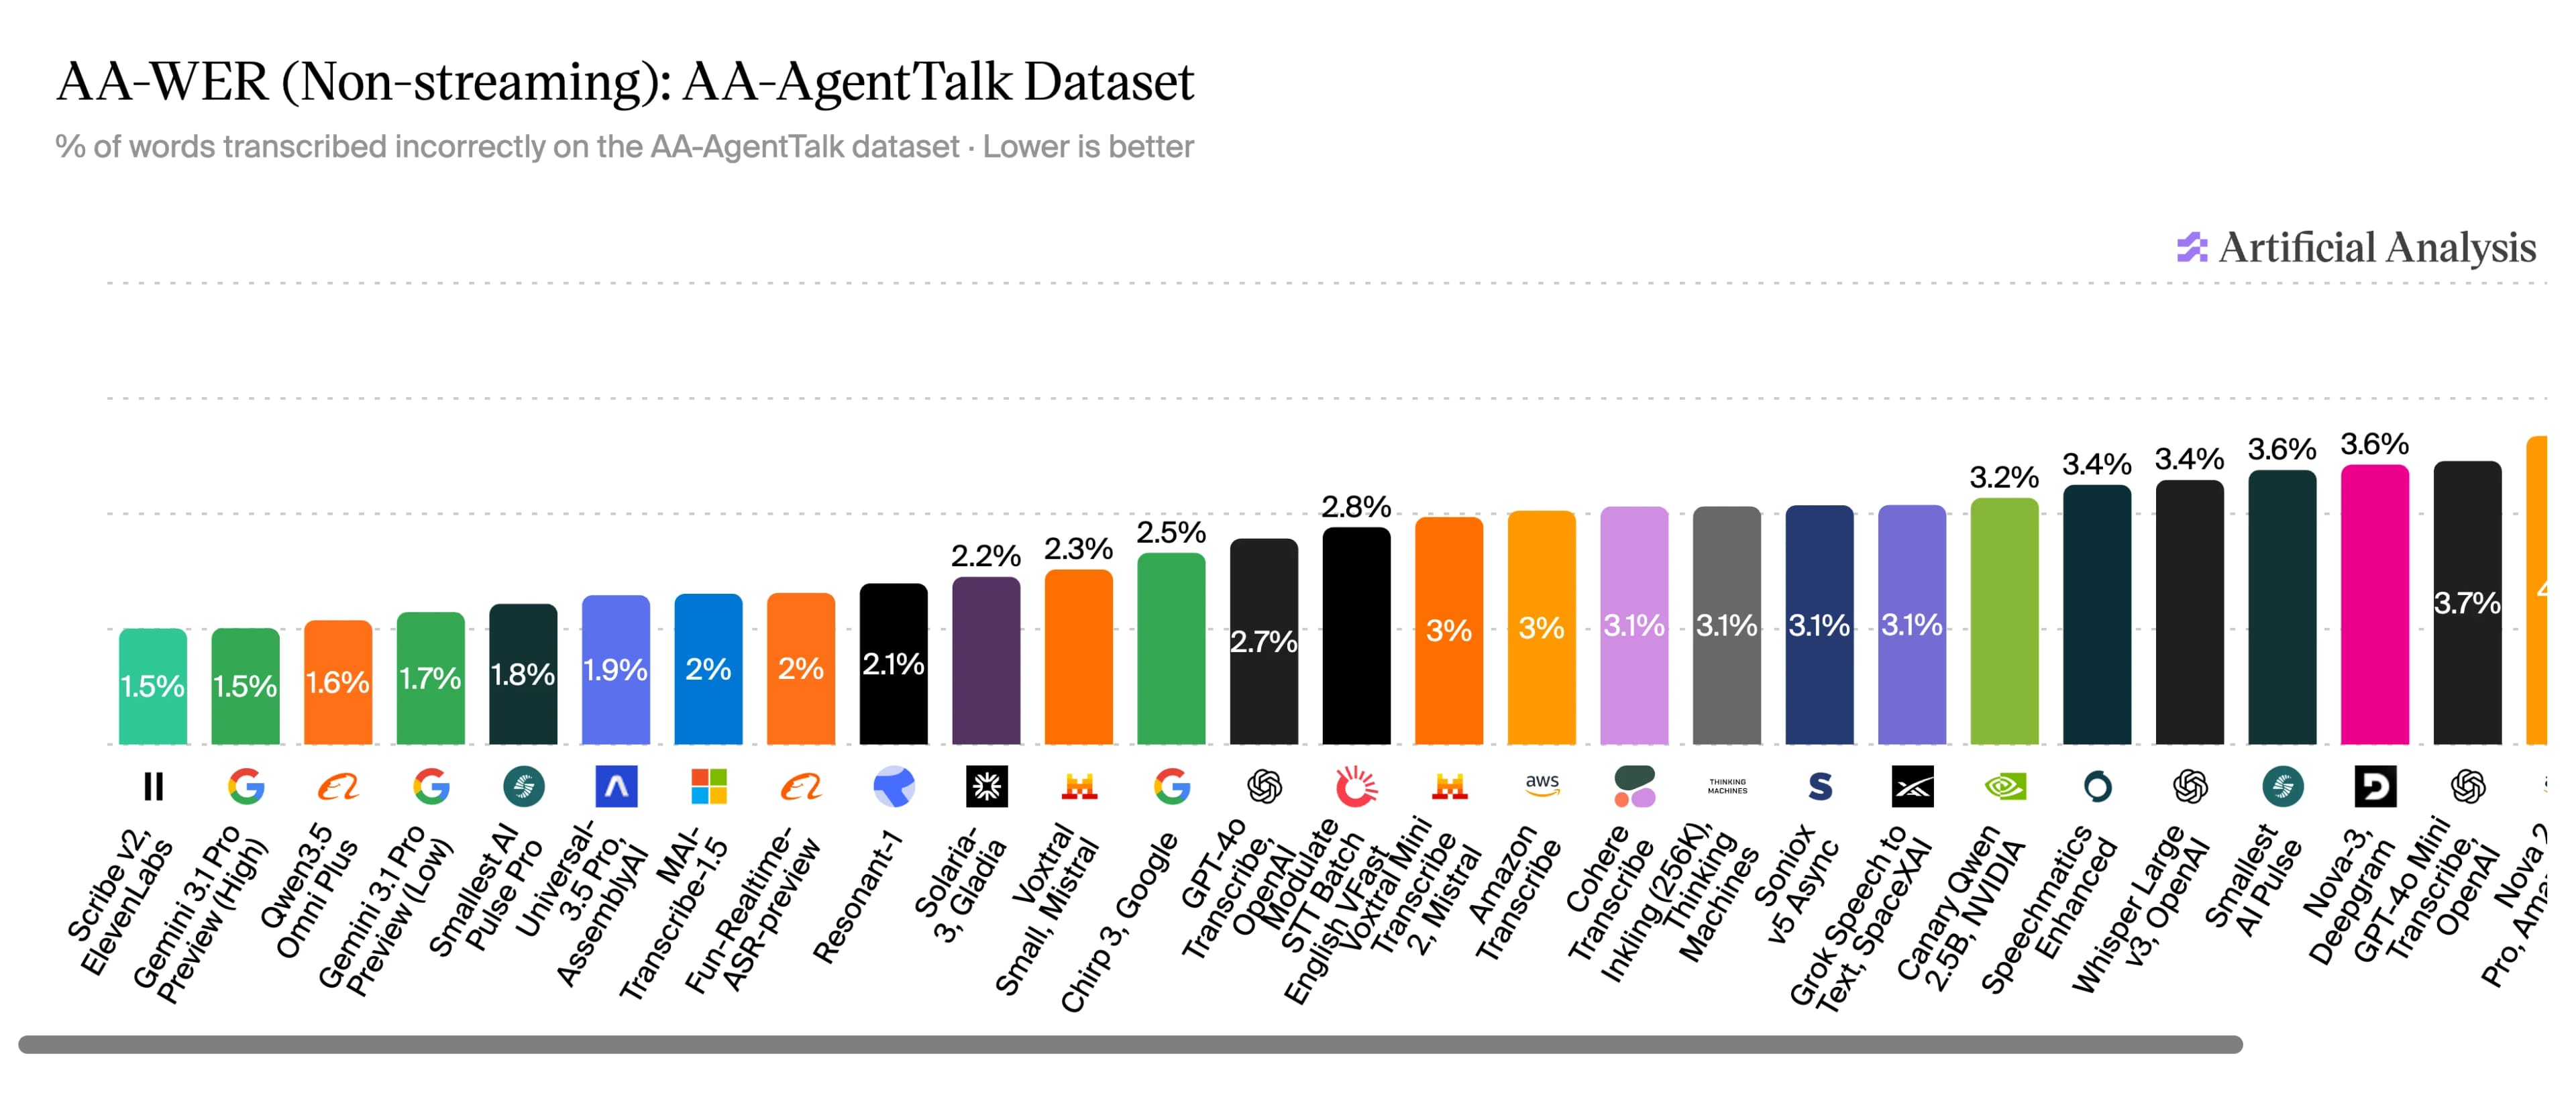
Källa: Artificial Analysis besökt den 10 juli 2026.
I juli 2026 rankar oberoende forskning från Artificial Analysis ElevenLabs Scribe v2 som branschens lägsta WER för icke-streamande transkriptionsmodeller på AA-AgentTalk-datasetet, med ett WER på 1,5 %.
Utöver utvärderingen av leverantörer har WER en verklig påverkan på produktnivå. Medicinsk transkriptionsprogramvara med ett WER på 12 % kan orsaka allvarliga fel i patientjournaler. Feltranskriberingar i ett samtal med kundtjänst kan leda till följdfel, exempelvis felaktig sentimentanalys eller bristfällig kategorisering.
Utöver dessa användningsspecifika problem är det ofta personer som bara kan få tillgång till talat innehåll via transkriptet som påverkas mest när ASR-system misslyckas. World Wide Web Consortium erbjuder omfattande dokumentation om de minimikrav som tillgänglighetsinitiativ förväntar sig, för mer sammanhang.
Så beräknar du word error rate: formel och exempel
Det är enkelt att beräkna word error rate när du känner till stegen. Som vi såg ovan använder du formeln WER = (S + D + I) / N. Alla termer beskrivs ovan, men kort sagt står de för ersättningar, utelämningar, tillägg och N för det totala antalet ord i transkriberingen.
Så här beräknar du WER:
- Skapa ett referenstranskript: Använd mänsklig transkribering och verifiering för att skapa en korrekt transkribering av ett ljudklipp.
- Använd ditt STT-verktyg: Använd en ASR-plattform för att transkribera ljudklippet och skapa ett AI-transkript som du använder som testunderlag.
- Justera de två versionerna: Använd dynamisk programmering, närmare bestämt Levenshtein-algoritmen, för att hitta det minsta antalet ändringar. Vi går närmare in på algoritmen i ett senare avsnitt.
- Använd formeln: Räkna det totala antalet fel i den AI-genererade versionen jämfört med den mänskligt verifierade kopian och använd sedan WER = (S + D + I) / N för att beräkna det exakta WER-värdet.
Det här kan verka ganska tekniskt på papperet, men är betydligt enklare i praktiken. Här är ett övningsexempel som visar vad vi menar.
Referenstranskript: Mrs. Dalloway said she would buy the flowers herself.
ASR-resultat: Miss Dalloway said she would buy flowers herself.
Om vi räknar de totala felen har vi 1 S och 1 D av totalt 9 ord.
Med formeln får vi: WER = 2 / 9 = 0.222 = 22,2 %.
Beräkna word error rate med Python
Den manuella metoden fungerar utmärkt, men du kan spara tid genom att beräkna WER med Python. jiwer-biblioteket hanterar allt detta helt automatiskt.
Med jiwer-dokumentationen kan du installera paketet, som är särskilt byggt för att utvärdera ett ASR-system och skapa centrala mått som WER. När det har laddats ned kan du använda följande kod för att snabbt beräkna WER med Python:
Observera att ASR-resultatet i det här exemplet skiljer sig från den ursprungliga referensen på två ställen. Ordet ”jumps” transkriberades felaktigt som ”leaps” (en ersättning) och ”last” lades till före ”lazy” (ett tillägg). Med två fel bland de nio orden i referenstranskriptet blir Word Error Rate (WER) 0.222, eller 22,2 %.
Jämförelse mellan word error rate och andra igenkänningsmått
WER är standardmåttet för att beräkna träffsäkerhet i ASR, men det finns även andra verktyg du kan använda. Till exempel:
- Character Error Rate (CER): Precis som WER mäter det transkriberingens träffsäkerhet på teckennivå i stället för ordnivå. Det passar bäst för språk utan tydliga ordgränser (scriptio continua) eller uppgifter där stavning är känslig.
- Match Error Rate (MER): Mäter andelen transkriberingsfel men behandlar ersättningar, tillägg och utelämningar något annorlunda än WER. Det fokuserar på andelen felaktiga fel i en mening.
- Word Information Lost (WIL): En uppskattning av hur mycket av ursprungsinformationen som gick förlorad vid transkriberingen. Det ger ett mått på begriplighet snarare än WER:s direkta felräkning.
- Embedding Error Rate (EmbER): Ger en semantisk analys mellan transkriberingarna. Det går längre än WER och ger insikt i det semantiska avståndet mellan det korrekta ordet och den felaktiga transkriberingen.
Vart och ett av dessa mått passar bäst för olika scenarier. Här är en tabell du kan använda som referens:
Exempel på Levenshtein-avstånd: matematiken bakom WER
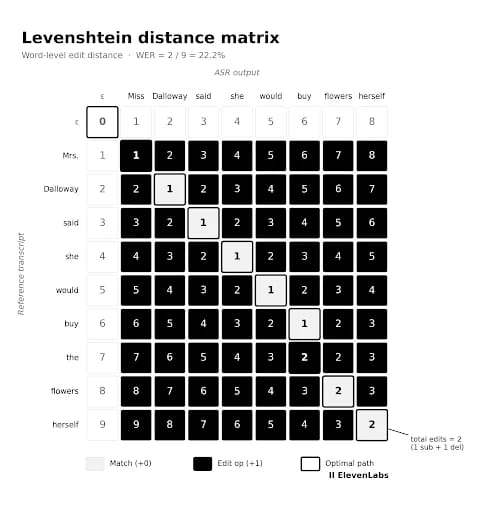
Word error rate är egentligen ett mått på avståndet mellan originalet och hypotesresultatet. För att förstå den skillnaden matematiskt använder vi Levenshtein-avståndet.
Levenshtein-avståndet räknar det minsta antalet ändringar av enskilda enheter som krävs för att omvandla en sekvens till en annan. För WER betyder det specifikt ändringarna ersättningar, tillägg och utelämningar. Om vi till exempel vill omvandla Cat till Mat behöver vi ändra bokstaven ”C” till ”M”, vilket ger ett Levenshtein-avstånd på 1.
Även om du ser betydligt mer av detta i CER-beräkningar, tar WER Levenshtein-avståndet och skalar upp det till ordnivå. Varje enhet är ett helt ord i stället för ett tecken, och det faktiska avståndet mäter hur många ordändringar som krävs för att omvandla vårt ASR-resultat till det korrekta originalet.
Vi skapar en matris där varje cell representerar det totala avståndet mellan originaltranskriptet och ASR-transkriptet. Levenshtein-avståndet fyller sedan i matrisen från övre vänstra hörnet till nedre högra, där den sista cellen ger dig det totala antalet ändringar på ordnivå. Dividerar du det talet med N får du ditt WER.
Den här matrisen beräknas vanligtvis med enskilda tecken, men här är en uppskalad version av vårt tidigare exempel för enkelhetens skull.
Vanliga fallgropar och missuppfattningar kring word error rate
Särskilt i takt med att STT-API:er blir mer tillgängliga och ASR-programvara blir en vanlig del av bredare agentstackar kommer vi att se många jämförelser mellan olika verktyg.
Innan du beräknar egna WER-värden finns det några vanliga problem och missuppfattningar du bör känna till.
- Alla fel är lika viktiga: WER behandlar varje fel som lika betydelsefullt. Det kan fungera bra i många sammanhang, men i vissa användningsfall är det oacceptabelt. På ett sjukhus kan till exempel en felkvot på 5 %, som skulle räknas som ett bra WER, ändå vara obegriplig eftersom bara ett eller två fel kan utsätta en patient för risk. Denna begränsning har lett till att nyare mått har utvecklats, som Semantic Word Error Rate (SWER), som försöker mäta om en menings betydelse bevarades i stället för om varje ord matchade exakt.
- WER kan överstiga 100 %: Även om vi tidigare sa att WER ligger mellan 0 och 1 kan ett WER ändå vara över 100 %. Det beror på att tilläggsfel kan skapa fler ord än det totala antalet i originaltranskriptet. Ett vanligt exempel är att transkribera ”I’m” som ”I am”, där ett ord blir två.
- Lägre WER är tekniskt sett inte alltid bättre: Ett WER på 5 % är på papperet bättre än ett WER på 10 %. Men om felen som bidrog till de 5 procenten ändrade sammanhanget i en mening avsevärt, medan felen i de 10 procenten inte gjorde det, ger siffran inte hela bilden. Sammanhanget spelar fortfarande stor roll, och mått som SWER utvecklas specifikt för att fånga denna semantiska påverkan.
År 2024 publicerade Apple en intressant studie som undersökte den sista punkten ovan. När människor bedömde en WER-beräkning på 9,4 % utifrån om ASR-resultatet var läsbart, gav de samma textstycke ett WER på bara 2,2 %. I exemplet de testade ansåg människor att ”felen” i många fall var obetydliga, vilket gav ett Human WER som var över fyra gånger mer förlåtande än maskinernas.
Branschriktmärken för WER
Det ideala WER-värdet beror i hög grad på branschen eller användningsfallet där du använder ASR-teknik. Även om <5 % är ett riktmärke i branschen för WER, behöver specifika branscher som medicinsk eller juridisk transkribering en mycket lägre nivå.
I Artificial Analysis studie från juli 2026 fick ElevenLabs Scribe v2 ett WER på 1,5 %. Det är dock viktigt att komma ihåg att den här statistiken vanligtvis utgår från engelska som huvudspråk. STT-teknik kanske inte är lika effektiv på andra språk.
ElevenLabs Docs beskriver de allmänna WER-intervallen för alla språk som Scribe v1 och Scribe v2 stöder.
Kom igång med ElevenAPI för bättre igenkänning
När du bygger en app eller produkt där transkriberingskvaliteten är viktig märks skillnaden mellan ett väl valt ASR-API och ett medelmåttigt först i ditt WER och sedan i användarnas upplevelser.
ElevenLabs Scribe är Speech to Text-lagret som är tillgängligt via ElevenAPI. Utöver stöd för fler än 90 språk och ett branschledande WER erbjuder det funktioner som talardiarisering, tidsstämplar på ordnivå, uppmaningar med nyckeltermer och entitetsidentifiering.
Utforska ElevenLabs Docs om du vill veta mer om ElevenAPI, eller kom igång genom att registrera dig i dag.
Vanliga frågor om word error rate

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.


