Vad är latens i Conversational AI och vad påverkar den?
- Skriven av
- Jack Limebear
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
För Conversational AI är latens det som skiljer bra applikationer från fantastiska.
Conversational AI är till sin natur strävsamt. Det försöker efterlikna samma känsla som ett samtal med en människa, med samma känslomässiga register, tonhöjd och rytm. Lägg till den fördröjning som känns ”naturlig” mellan att du slutar prata och att en AI-agent börjar svara, så får du ett latensmål grundat i hur människor faktiskt kommunicerar.
Företag som vill driftsätta Conversational AI‑agenter i stor skala behöver minska latensen så mycket som möjligt för att uppnå den naturliga upplevelsen. Den här artikeln förklarar vad latens i Conversational AI är, vad som orsakar fördröjningar i hela pipelinen och hur du kan minska dem på en övergripande nivå.
Sammanfattning
- Latens i Conversational AI är den totala fördröjningen från att en användare slutar prata tills hen hör agentens första ord.
- Agenter med en latens över 700 ms kan kännas onaturliga, och de över 1 200 ms har hög avbrottsfrekvens.
- Latens byggs på i varje steg i pipelinen för Conversational AI.
- ElevenAgents hanterar hela pipelinen i en enda enhetlig arkitektur, vilket gör Conversational AI med låg latens tillgängligt för ditt företag.
Vad är latens i Conversational AI?
Latens i Conversational AI avser den totala tid det tar för ett system att svara efter att du har pratat. För moderna AI-modeller mäts latens i ms. Bakom kulisserna består den totala latenssiffran av flera separata processer som var och en utgör en del av hela pipelinen.
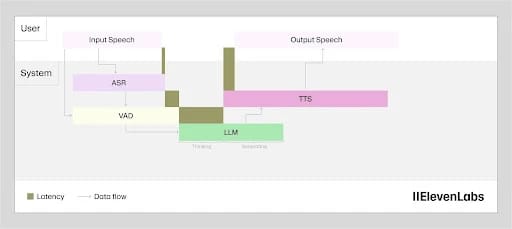
En typisk pipeline för Conversational AI ser ut så här:
- En användare pratar
- Ljudet transkriberas av en speech-to-text-modell
- Transkriptionen skickas till en LLM-modell som tar fram ett svar
- LLM:ens text syntetiseras sedan till ljud med en text to speech-modell
- Ljudet spelas sedan upp för användaren
Vart och ett av dessa steg ökar latensen i ett Conversational AI-system. Därför finns det några olika förkortningar som behöver förtydligas när man pratar om latens.
Modellens inferenslatens
Modellens inferenslatens är den tid en modell lägger på att generera utdata, mätt internt och utan externa faktorer. Det är ett modellspecifikt mått på hur snabbt din motor presterar för typiska indata. Flash v2.5 har till exempel en inferenslatens på omkring 75 ms. Med den informationen kan du jämföra hur snabba modeller är mellan olika konkurrenter.
Kom dock ihåg att detta inte är den latens som användaren faktiskt upplever. Den avser enbart den totala tid som modellen lägger på att generera utdata.
LLM:s tid till första token
En stor språkmodells (LLM) tid till första token (TTFT) är den totala tid det tar för en stor språkmodell att bearbeta en prompt och generera sin första användbara token i utdata.
TTS-genereringen börjar när den första tokenen kommer från din LLM, så detta mäter hur lång tid det tar för LLM:en att börja instruera din TTS-modell att köra. I de flesta kompletta Conversational AI-system utgör LLM TTFT en betydande del av den totala latensen.
TTS-tid till första ljudet (TTFA)
TTS-tid till första ljudet (TTFA) mäter tiden från den första TTS-begäran tills det första ljudsegmentet faktiskt lämnar modellen. Det beskriver modellens inferenslatens, men specifikt för TTS-motorer.
Komplett tid till första ljudet (TTFA)
Komplett TTFA är den totala latensen i Conversational AI. Den är summan av varje del av pipelinen, från taligenkänning, LLM TTFT, TTS och TTFA till alla nätverksöverföringar mellan stegen. När man talar om latens i Conversational AI som helhet är detta måttet som användaren upplever.
När användaren pratar väntar hen på den kompletta TTFA:n innan hen hör något från din agent. Det är ett helhetsmått, vilket innebär att varje förbättring i pipelinen förbättrar det.
Varför latens i Conversational AI är viktig
När en användare pratar med din AI-agent blir latens en central faktor för hur hen upplever interaktionen. Låg latens minskar tiden användaren behöver vänta på ett svar, vilket gör att samtalet känns naturligt och agenten kompetent.
Agenter med hög latens känns konstgjorda och mindre kompetenta, även om svarens kvalitet är densamma. För företag kan skillnaden på bara några hundra ms kännas som en evighet och få din kundsupportagent att kännas klumpig och ineffektiv.
Här är några scenarier som visar varför latens i Conversational AI spelar roll i praktiken:
- Under 500 ms: En samtalsagent känns responsiv och smidig. Användarna kanske inte märker fördröjningen mellan att de slutar prata och får sitt första svar, vilket gör att samtalet flyter på utan problem.
- 500 ms till 1 000 ms: Fördröjningen mellan att användaren slutar prata och får ett svar kan börja kännas tydligt. Den är bara lite för lång, vilket kan få användare att i förväg anpassa sig genom att upprepa sig eller pausa för att se om agenten faktiskt har förstått dem.
- Över 1 000 ms: Fördröjningarna börjar kännas långsamma, med pauser som får vissa användare att uppleva att AI-agenten inte riktigt hänger med i samtalet. Transkriptioner kan visa tillfälliga avbrott eller önskemål om att få prata med en mänsklig agent. I vissa fall kan användare avbryta samtalet.
Vart och ett av dessa tröskelvärden leder till konkreta affärsresultat.
I den lägre delen av latensspektrumet får du en kundtjänstagent som naturligt kan hantera inkommande frågor och hjälpa användare att lösa sina ärenden utan ytterligare hjälp. Det avlastar dina mänskliga agenter och håller kundnöjdheten hög. I den högre delen av latensspektrumet frustrerar du kunderna med en agent som verkar tveka alldeles för länge.
Vi har definierat riktvärden för latensbudget för röstassistenter i en annan artikel för att visa hur bra latens ser ut för både P50- och P95-värden.
Vad orsakar latens i Conversational AI?
Latens i Conversational AI är ett begrepp som sammanfattar flera olika processer, där varje del bidrar till helheten. Flaskhalsen för låg latens är därför ett problem på systemnivå, snarare än något som löses genom att bara välja en bättre modell. Flera modeller samverkar trots allt i pipelinen.
För utvecklare har vi skrivit en fördjupad teknisk guide om latensoptimering för röstassistenter som du kan använda för att förbättra varje steg i den kompletta tiden till första ljudet (TTFA).
Utöver kärnpipelinen ökar även andra faktorer, som telefoni och funktionsanrop, latensen, trots att de inte ingår i modellinfrastrukturen.
Här är en översikt över alla faktorer som bidrar till latens i Conversational AI.
Automatisk taligenkänning
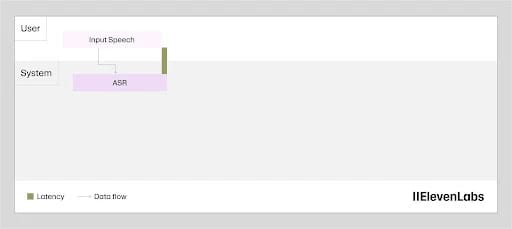
Latensen för taligenkänning är inte tiden det tar att skapa en transkription. Transkriberingsprocessen körs i bakgrunden medan användaren pratar, så när talet tar slut är texten i stort sett klar.
Latensen här är i stället glappet mellan att talet tar slut och att transkriptionen slutförs och skickas till nästa steg. Scribe v2 Realtime minskar detta glapp till cirka 150 ms genom att streama kontinuerligt, så att utdata är redo i samma ögonblick som samtalsturen avslutas.
Turtagning och slutpunktsdetektering
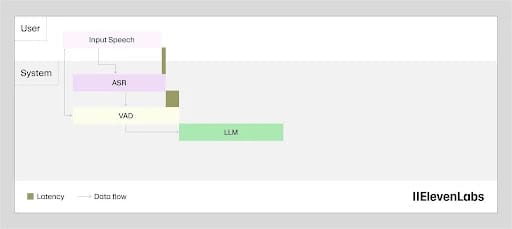
En Voice Activity Detector (VAD) finns mellan taligenkänningen och språkmodellen. Dess uppgift är att avgöra när användaren faktiskt har pratat klart.
För att undvika fel väntar VAD:en på en tröskel av ihållande tystnad innan den förklarar turen avslutad, och den väntan ökar latensen innan språkmodellen bearbetar ett ord. Den lilla extra latensen tar visserligen tid, men hindrar också systemet från att börja svara medan användaren fortfarande pratar.
Rent tekniskt skulle latensen från turtagning vara bra om alla andra komponenter i Conversational AI hade noll latens. Människor tar en liten paus innan de svarar på tal. När en maskin gör samma sak känns interaktionen mer realistisk. Eftersom andra komponenter i Conversational AI redan orsakar latens är dock minimal latens idealiskt.
Bearbetning i språkmodellen
När transkriptionen är klar från speech to text-motorn (STT) genererar språkmodellen ett svar. Latensen här är tiden det tar att börja generera token, inte att generera hela svaret. Dessa token streamas direkt till TTS-steget när de kommer, så TTFT är det viktigaste.
Utöver modellval påverkar både promptens längd och kunskapsbasens storlek detta steg. Ju mer kontext LLM:en måste ta hänsyn till, desto längre tid tar det. När du utformar dessa system i stor skala behöver du hitta rätt balans mellan en användbar kunskapsbas och en slimmad prompt för att behålla hastigheten.
Talsyntes
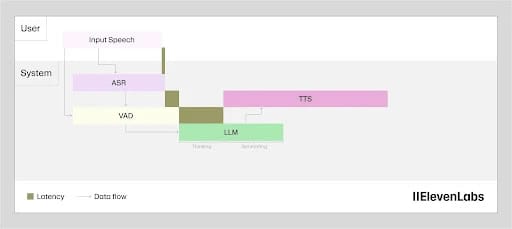
TTS-latens är tiden mellan att ta emot de första tokenen från språkmodellen och att ljudet börjar. Eftersom token anländer snabbare än mänskligt tal spelas upp väntar syntesmodellen aldrig på hela svaret. TTS-latens är strikt sett tiden till det första ljudsegmentet.
Det här steget brukade vara den största enskilda bidragsgivaren till latens i Conversational AI, eftersom äldre modeller behövde 2–3 sekunder för att börja generera tal. ElevenLabs Flash v2.5 löser detta direkt genom att leverera talsyntes med cirka 75 ms latens och minska flaskhalsen från sekunder till en bråkdel av en sekund.
Nätverkslatens
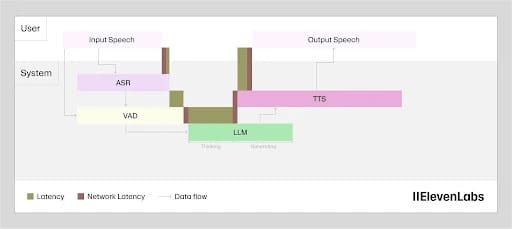
Att skicka data från en plats till en annan ökar alltid latensen, och geografiskt avstånd förvärrar bara nätverkslatensen för tur och retur.
Eftersom flera komponenter samverkar för att skapa ett komplett svar kan betydande latens byggas på genom flera nätverkshopp.
Funktionsanrop
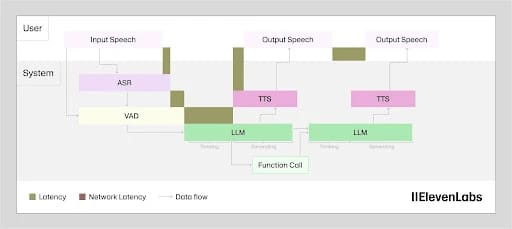
Funktionsanrop lägger till API-anrop tur och retur i LLM-steget. En snabb intern uppslagning tillför tiotals millisekunder, medan en betalleverantör eller ett lagersystem kan tillföra sekunder. Mängden latens beror helt på tjänsten som anropas, vilket gör detta till det svåraste steget att optimera direkt.
Det mest effektiva mönstret är att instruera LLM:en att svara innan verktygsanropet har slutförts. En fras som ”Låt mig kontrollera det åt dig” håller användaren engagerad medan det externa anropet slutförs, i stället för att lämna tystnad. Röstsvaret börjar medan verktyget körs parallellt.
Så minskar du latens i Conversational AI
För att minska latensen i Conversational AI måste du hantera varje steg i pipelinen utifrån hur stor påverkan det har. Enskilda förbättringar påverkar visserligen latensen, men du behöver arbeta med hela pipelinen som en helhet för att se den största förändringen.
Här är några principer som på en övergripande nivå kan hjälpa dig att minska latensen i Conversational AI:
- Val av TTS-modell: TTS-modeller som är optimerade för hastighet, som Flash v2.5, använder andra arkitekturer än kvalitetsoptimerade modeller som Eleven v3 och Eleven v4. För röstassistenter i realtid är röstassistenter det rätta valet den modell med högst kvalitet som uppfyller ditt latensmål, vilket nästan alltid är en modell optimerad för hastighet.
- Val av LLM-modell: Mindre och snabbare LLM:er ger generellt lägre tid till första token än större modeller. Att välja den snabbaste LLM:en som fortfarande uppfyller dina kvalitetskrav för uppgiften är lika viktigt som valet av TTS-modell.
- Streaming: Streamad TTS returnerar ljud i segment medan syntesen pågår, så användaren hör det första ordet medan modellen fortfarande genererar resten. Samma koncept gäller LLM-utdata: genom att börja TTS-syntesen vid den första meningen medan språkmodellen genererar följande kan du återvinna latens i pipelinen.
- Systemprompt-design: Användare kan effektivisera systemprompter genom att flytta instruktioner till procedurer eller workflows, i stället för att behålla dem som en del av varje beslutssteg. Det minskar mängden kontext som modellen måste resonera kring vid varje tur.
- Skyddsräcken: Genom att köra skyddsräcken i den streamande modellen kan utdata börja spelas upp innan kontrollen har slutförts, i stället för att uppspelningen blockeras tills kontrollen är klar.
- Samlokalisering av modeller: Att använda samlokaliserade modeller där det är möjligt, till exempel ElevenLabs Agents-stacken, håller komponenterna nära varandra så att latens inte tillkommer genom hopp mellan modeller som driftas separat.
- Geografi: Kort avstånd mellan dina servrar och dina användare kan minska latensen avsevärt, eftersom det direkt minskar nätverkets bidrag till komplett TTFA.
Utöver dessa faktorer kan du använda denna tekniska guide om att optimera latens för mer information.
Kom igång med Conversational AI med låg latens i ElevenAgents
Latens i Conversational AI är en mycket viktig faktor att ta hänsyn till när du bygger och driftsätter agenter. Med ElevenAgents är latensoptimering en inbyggd del av processen. Från överlappningstekniker som återvinner tid till låg inferenslatens i enskilda komponenter bygger ElevenAgents Conversational AI-stackar med låg latens för ditt företag.
I slutändan handlar målet om att skapa realism. Användaren ska känna samma enkelhet som i ett samtal med en människa, samtidigt som hen får fördelarna med ett datorprogram. Genom att effektivisera delprocesserna är detta nu möjligt.
Läs mer om ElevenAgents eller kontakta säljteamet för att komma igång idag.
Vanliga frågor om latens i Conversational AI

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.