Scribe v2 Medical är nu tillgängligt för alla
- Skriven av
- Min Kim
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
Kliniskt ljud är ett av de svåraste testen för korrekt taligenkänning. Läkemedelsnamn är långa, sällsynta och lätta att förväxla (hydroxizin och hydralazin skiljer sig åt med en feluppfattad stavelse). Ordförrådet är tätt, med doseringar, enheter samt termer inom anatomi och patologi som kan komma i snabb följd. Insatserna är också högre eftersom ett transkriptionsfel kan hamna i en patients journal.
Därför lanserar ElevenLabs i dag Scribe v2 Medical, vår Speech to Text-modell finjusterad för kliniskt ljud, som nu är allmänt tillgänglig på ElevenAPI. I utvärderingarna nedan uppnår den konsekvent en av de lägsta felfrekvenserna på ordnivå (WER) bland de jämförda modellerna och minskar WER för kliniskt ljud med cirka 35 % jämfört med vår grundmodell Scribe v2.
Modeller för allmänna ändamål hanterar vardagligt tal väl, men prestandan kan försämras där kliniska arbetsflöden behöver dem som mest. Vi tränade en medicinsk finjustering av Scribe v2 med fokus på läkemedelsnamn och klinisk diktering, utifrån offentliga riktmärken som vem som helst kan återskapa.
Scribe v2 Medical är optimerad för kliniska användningsfall
Klinisk diktering (MedDictate)
Cortis MedDictate testar transkribering av dikterade kliniska anteckningar, som innehåller läkemedelsnamn, doseringar och enheter i tät följd på engelska, franska och tyska. I vår utvärdering uppnår Scribe v2 Medical lägst total WER bland modellerna vi testade och cirka 35 % lägre WER än grundmodellen Scribe v2.
Modell
EN
FR
DE
Total WER
Scribe v2 Medical
3.0%
8.3%
7.2%
4.9%
OpenAI GPT Transcribe
3.9%
7.8%
9.6%
5.9%
Scribe v2 (grundmodell)
5.0%
10.7%
11.7%
7.6%
Muse Voice Transcribe 1.0
4.5%
11.0%
13.3%
7.8%
Deepgram Nova-3 Medical*
5.5%
-
-
-
*Endast engelska (24 klipp) – Deepgram Nova-3 Medical har inte stöd för franska eller tyska.
Medicinsk terminologi (MedTerm)
MedTerm är också en datamängd som publicerats av Corti och omfattar ett riktmärke med 600 prover av klinisk terminologi på samma tre språk, där de medicinska termerna i varje prov har annoterats. Annoteringarna gör det möjligt att utvärdera modeller i två dimensioner utöver WER för hela transkriptet. Termåterkallelse är andelen annoterade medicinska termer som återges korrekt i transkriptet (högre är bättre). Term-WER är felfrekvensen för enbart dessa termer, utan hänsyn till det vanliga talet runtomkring (lägre är bättre).
Scribe v2 Medical leder bland alla testade modeller i båda dimensionerna och före alla andra leverantörer på samtliga tre språk:
Modell
Termåterkallelse ↑
Term-WER ↓
Scribe v2 Medical
77.7%
10.4%
Scribe v2 (grundmodell)
77.1%
10.7%
OpenAI GPT Transcribe
74.0%
12.3%
Muse Voice Transcribe 1.0
73.4%
12.9%
Deepgram Nova-3 Medical*
72.5%
13.6%
Eka Medical ASR-riktmärke
Eka Medical ASR-riktmärket innehåller 3 619 engelska kliniska ljudprover – från enskilda läkemedels- och sjukdomsnamn till kliniska meningar och samtal mellan kliniker och patienter – med annoteringar per term och en publicerad topplista på datamängdskortet.
Eftersom den publicerade datamängden omfattar äldre modeller som Gemini 2.5 Flash och GPT-4o, genomförde vi utvärderingen mot nyare modeller. SemWER (semantisk WER) mäter om modellen uppfattade rätt innehåll, oavsett formatering (”mg” och ”milligram” räknas som samma svar), och kwWER (nyckelords-WER) tillämpar samma bedömning endast på de annoterade medicinska nyckelorden.
Modell
semWER
kwWER
Scribe v2 Medical
6.50%
6.02%
Scribe v2 (grundmodell)
7.35%
7.04%
Deepgram Nova-3 Medical
7.79%
7.65%
Muse Voice Transcribe 1.0
8.85%
8.99%
OpenAI GPT Transcribe
13.90%
13.20%
Eka annoterar de medicinska termerna i varje prov, vilket gör det möjligt att bedöma Scribe v2 Medicals förbättringar jämfört med grundmodellen mer detaljerat, enbart för de medicinska termerna. Scribe v2 Medical gör 15 % färre fel än grundmodellen (9.5 % jämfört med 11.1 %), och förbättringarna är störst när termerna förekommer i fullständiga kliniska meningar (7.5 % jämfört med 9.9 %).
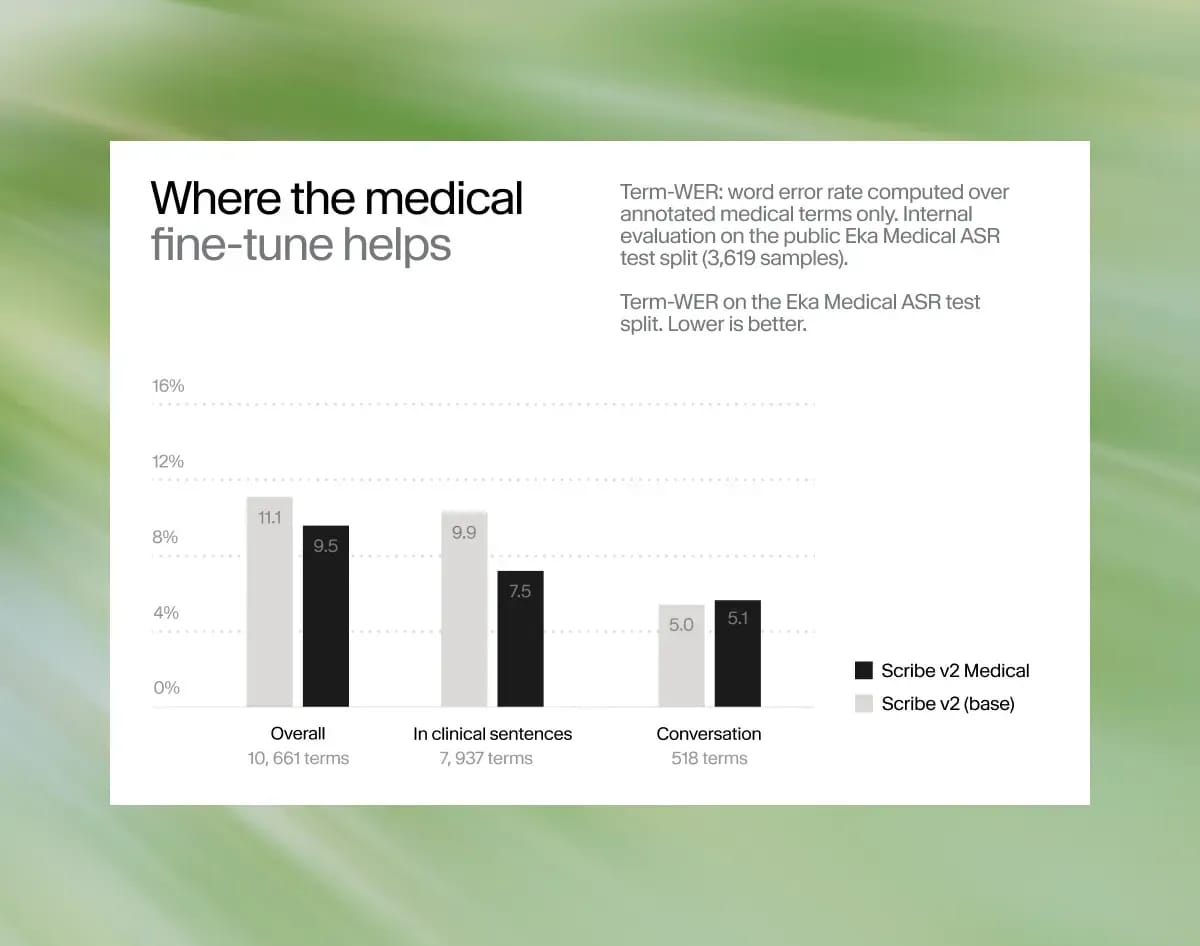
En invändning utifrån samma data är att isolerade klipp med ett enda ord (ett ensamt läkemedelsnamn som uttalas utan omgivande sammanhang) fortfarande är det svåraste fallet för alla modeller på topplistan, inklusive Scribe v2 Medical. Den fick 14.3 % WER för isolerade termer, jämfört med 7.5 % när termerna förekommer i meningar. Utan något sammanhang kan en feluppfattad stavelse leda till minnesvärda fel:
- etodolac (ett NSAID) → ”It'll do the luck”
- levomilnacipran (ett antidepressivt läkemedel) → ”Leave me alone now, Sephora.”
- methdilazine (ett antihistamin) → ”Let's play our scene.”
Ett sätt att minska dessa fel är med nyckelordspromptning, som låter dig markera läkemedelsnamn eller medicinska fraser för att styra modellen mot att transkribera dem korrekt.
Kunder i produktion
Kunder använder redan Scribe v2 Medical i produktion och ser förbättringar för kliniskt ljud.
”Sedan vi bytte från Deepgram till ElevenLabs Scribe v2 Medical har vi sett mycket högre träffsäkerhet för klinisk terminologi, och det har förändrat hur teamet arbetar”, säger Mendel Erlenwein, VD och grundare av CareCo. ”När våra koordinatorer litar på transkripten kan de ägna mindre tid åt att rätta anteckningar och mer tid åt att prata med patienter i telefon. Våra patienter har komplicerade behandlingsregimer, och anteckningen som vårdteamet läser måste vara korrekt.”
Stark prestanda för allmänt tal
Teamet verifierade också att den medicinska finjusteringen inte försämrar prestandan inom andra områden. På 6 000 prover av vardagligt, icke-medicinskt tal hämtade från Common Voice får Scribe v2 Medical, avrundat, samma resultat som grundmodellen Scribe v2: 5.3 % WER i båda fallen. Med v2 Medical får du alltså fördelarna med en specialiserad medicinsk modell utan att ge upp träffsäkerhet på detta riktmärke.
Utvecklad för skyddad hälsoinformation
Scribe v2 Medical är HIPAA-kompatibel för företagskunder som har Business Associate Agreements på plats och Zero Retention Mode (ZRM) aktiverat.
När ZRM är aktiverat för förfrågningar till Speech to Text API raderas ljudindata och textutdata omedelbart när varje förfrågan har slutförts. ElevenLabs sparar inget av detta, och din applikation får hela API-svaret och styr hur transkript sparas.
Kom igång
Scribe v2 Medical finns tillgänglig på Speech to Text API. Skicka bara med det nya modell-id:t: scribe_v2_medical
Modellen körs på batchslutpunkten för Speech to Text.