
Speech to Text pour les créateurs de contenu : guide des workflows de sous-titrage et de réutilisation
- Rédigé par
- Jack Limebear
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Un outil de Speech to Text précis est indispensable dans la boîte à outils de tout créateur de contenu. Avec le Speech to Text propulsé par l’IA, transformez vos fichiers audio existants en sous-titres vidéo, notes d’émission de podcast, articles de blog et plus encore. Vous pouvez ainsi réutiliser votre contenu sur plusieurs canaux pour toucher un public plus large.
Le Speech to Text fait aussi gagner un temps considérable aux créateurs de contenu très sollicités. Transcrire manuellement chaque voix off et podcast peut prendre des heures, mais les modèles de Speech to Text s’en chargent en quelques minutes pour vous aider à tenir votre calendrier de publication.
Dans cet article, nous verrons comment fonctionne le Speech to Text pour les créateurs de contenu, pourquoi il est si efficace et comment l’intégrer à vos workflows de création de contenu.
En résumé
- Les créateurs de contenu utilisent des modèles de Speech to Text pour générer des sous-titres vidéo, créer des notes d’émission de podcast et réutiliser du contenu audio sous forme écrite.
- Les modèles de Speech to Text propulsés par l’IA offrent une transcription et une mise en forme plus précises que les sous-titres automatisés des réseaux sociaux.
- En transcrivant des podcasts avec le Speech to Text, vous pouvez rapidement créer des notes d’émission ou les réutiliser sous forme de blogs et de newsletters.
- Avec le prompting par termes clés, vous pouvez préciser les noms et les termes propres à votre secteur pour obtenir des transcriptions plus exactes.
- Pour traduire vos sous-titres, doublez la vidéo dans la langue de votre choix, puis utilisez le Speech to Text pour transcrire l’audio doublé.
Quelles sont les principales utilisations du Speech to Text pour les créateurs de contenu ?
Les créateurs de contenu utilisent le Speech to Text pour de nombreuses tâches, notamment :
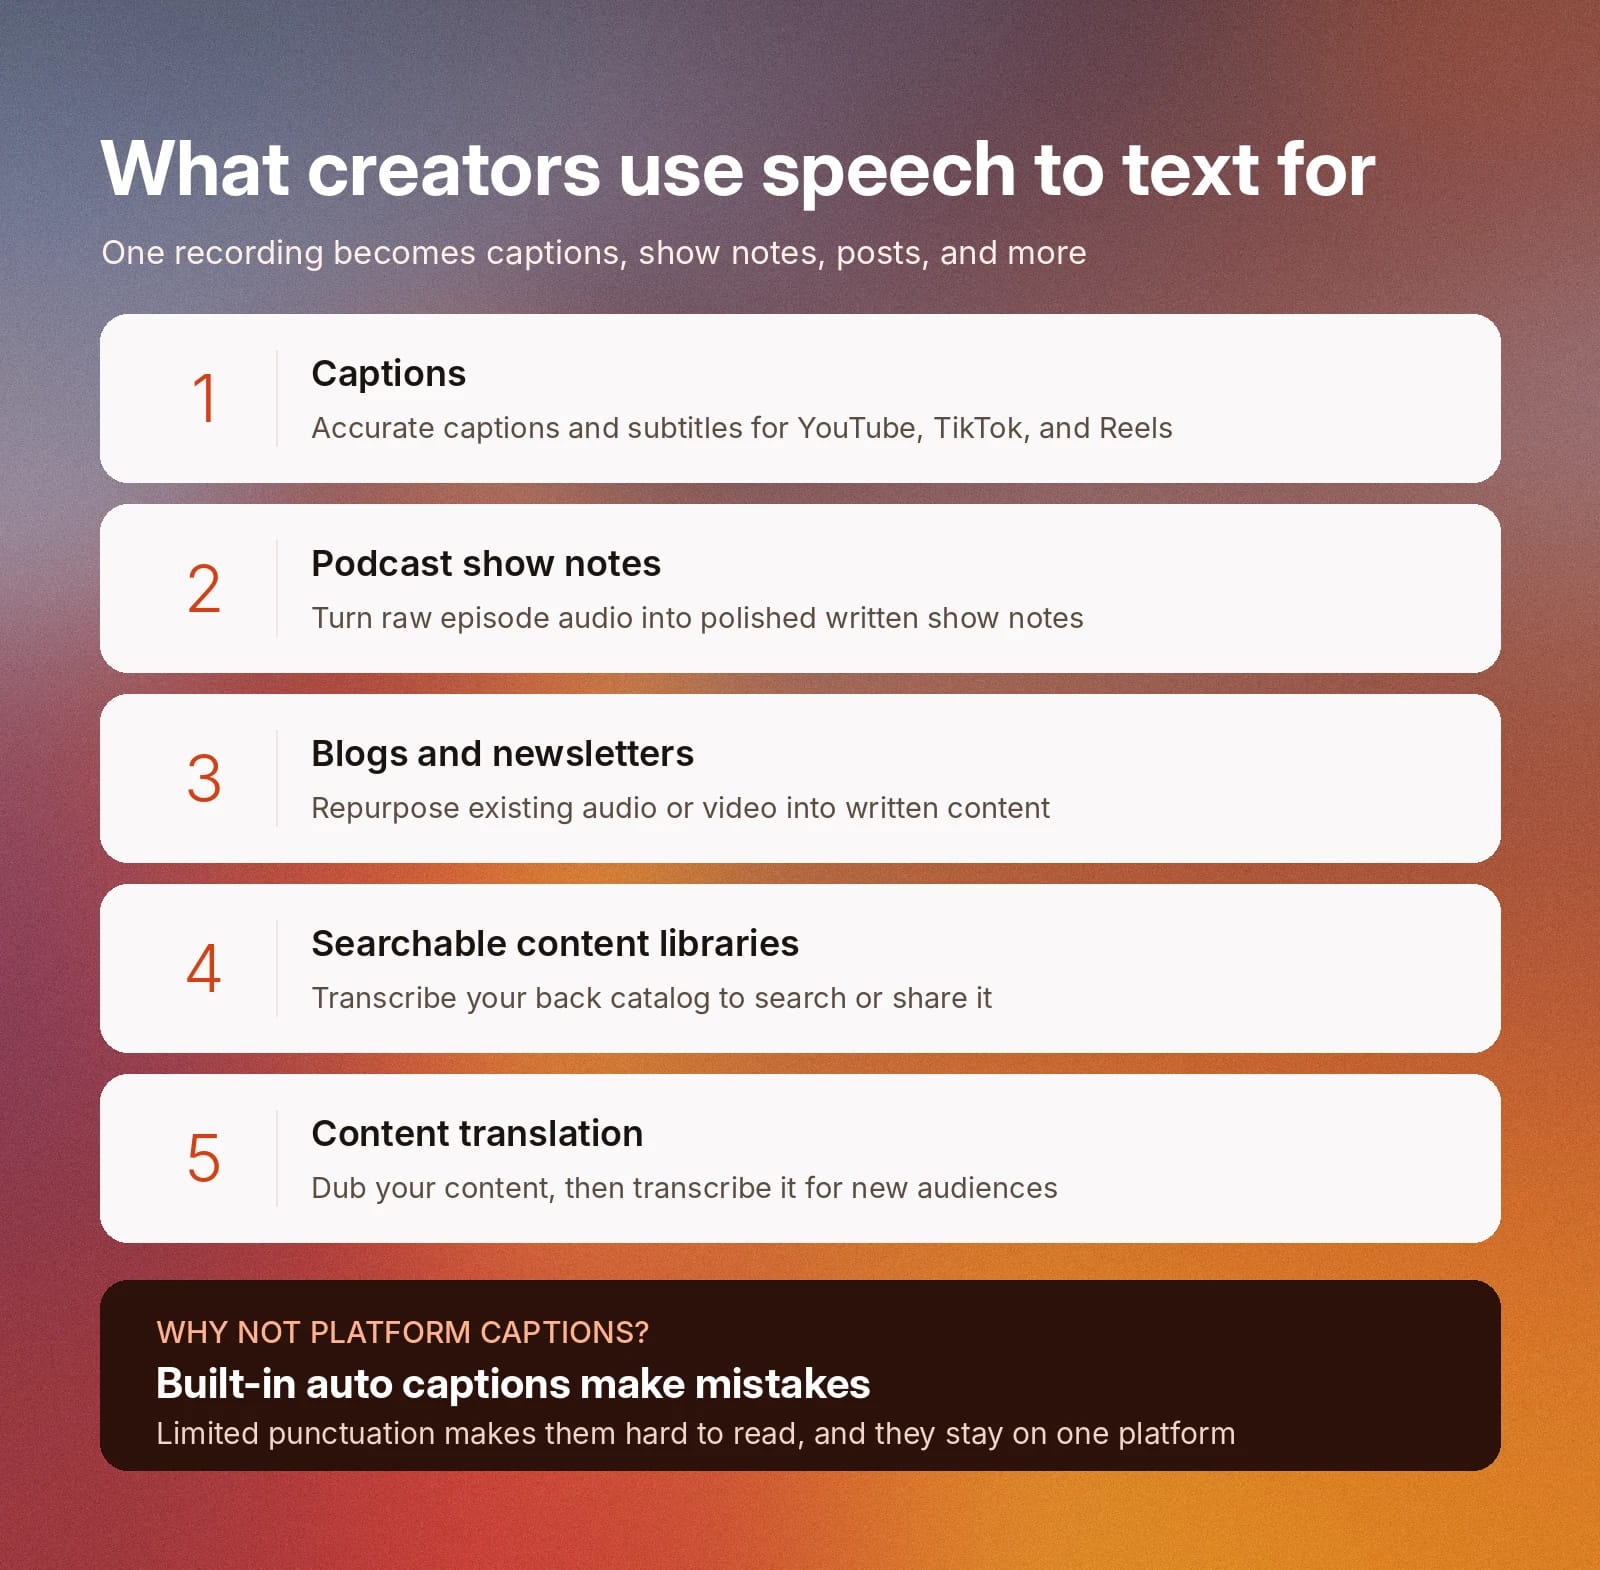
- Sous-titres : Le Speech to Text génère des sous-titres précis pour les vidéos courtes et longues sur des plateformes telles que YouTube, TikTok et Instagram Reels.
- Notes d’émission de podcast : Le Speech to Text vous aide à transformer l’audio brut d’un épisode en notes d’émission écrites et soignées.
- Blogs et newsletters : Avec le Speech to Text, transformez vos contenus audio ou vidéo existants en blogs, newsletters et autres contenus écrits.
- Bibliothèques de contenu consultables : Les outils de Speech to Text automatisés transcrivent votre bibliothèque de contenu existante afin de la rendre consultable. Utilisez-les pour rester organisé en interne ou créer une bibliothèque de ressources externe pour votre audience.
- Traduction de contenu : Le Speech to Text traduit votre contenu dans différentes langues afin de toucher des audiences du monde entier.
De nombreuses plateformes de réseaux sociaux proposent des fonctions de génération automatique de sous-titres pour les vidéos. Toutefois, ces outils peuvent faire des erreurs et utilisent une ponctuation limitée, ce qui rend les sous-titres difficiles à lire.
Un modèle de Speech to Text dédié vous aide à créer des sous-titres nets et précis pour vos vidéos. Vous pouvez également télécharger et réutiliser la transcription sur différentes plateformes.
Transformer une transcription en sous-titres
Les sous-titres ne sont plus facultatifs pour les vidéos sur les réseaux sociaux. Ils rendent les vidéos accessibles à tous, quel que soit le niveau d’audition. Ils permettent aussi de regarder vos vidéos sans le son.
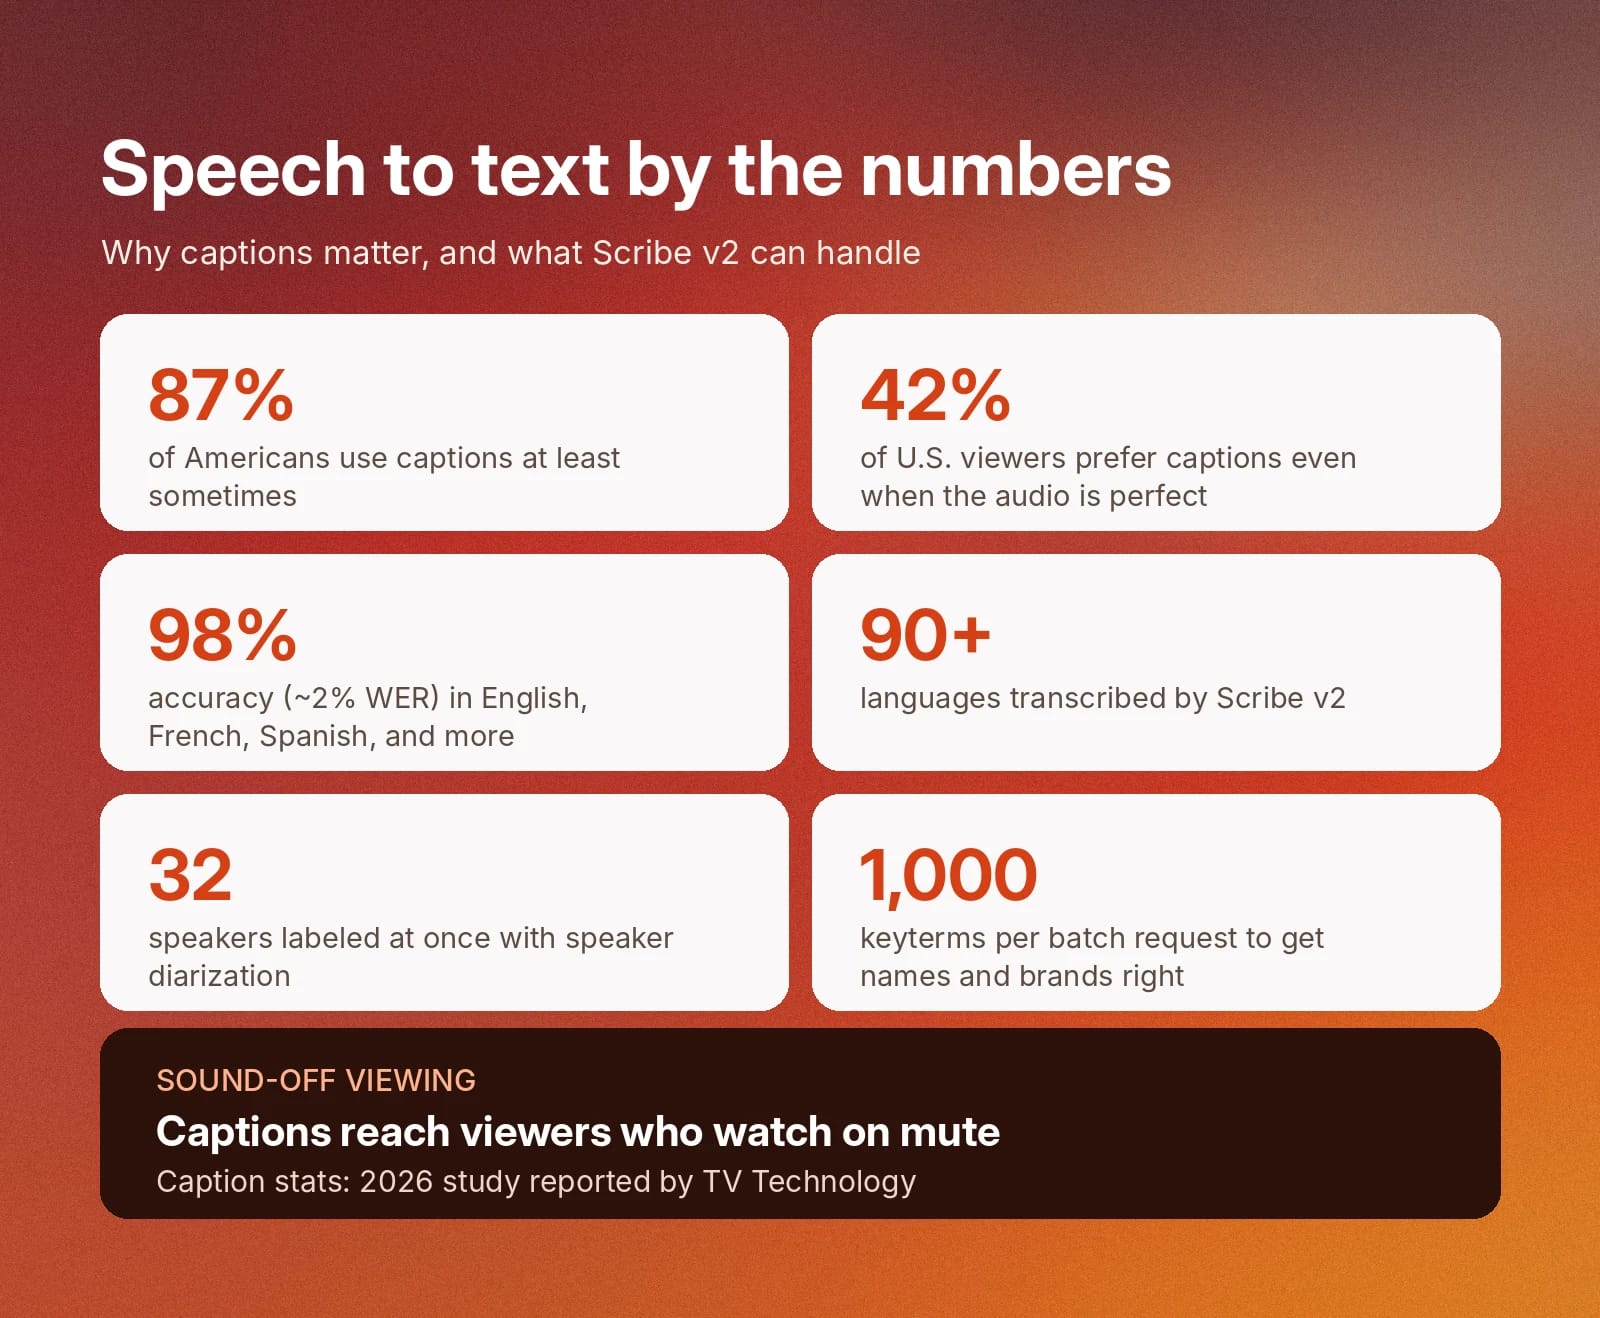
Le visionnage sans le son est devenu la norme pour de nombreux utilisateurs des réseaux sociaux, surtout dans les lieux publics ou lorsqu’ils n’ont pas d’écouteurs à portée de main. Une étude de 2026 a révélé que 87 % des Américains utilisent au moins parfois les sous-titres lorsqu’ils regardent des vidéos.
En fait, 42 % des spectateurs américains préfèrent les sous-titres même lorsque l’audio d’une vidéo est déjà parfait, ce qui montre à quel point le sous-titrage de chaque vidéo rend votre contenu plus attractif.
Speech to Text transcrit vos vidéos destinées aux réseaux sociaux pour générer des sous-titres. ElevenLabs Caption Generator crée des transcriptions avec des horodatages au niveau du mot et du caractère, afin de les synchroniser avec la parole de votre vidéo. Ces horodatages sont conservés même si vous découpez la vidéo originale en extraits plus courts pour différentes plateformes.
Les sous-titres sont également exportables aux formats SRT et VTT : vous pouvez donc les importer directement sur les réseaux sociaux ou dans votre plateforme de montage vidéo préférée. Lors du montage, veillez à ajuster les retours à la ligne pour qu’ils s’accordent avec le rythme de la conversation.
SRT ou VTT : quel fichier de sous-titres exporter ?
Les fichiers SRT et VTT contiennent les mêmes horodatages et le même texte.
Voici quand choisir chaque format :
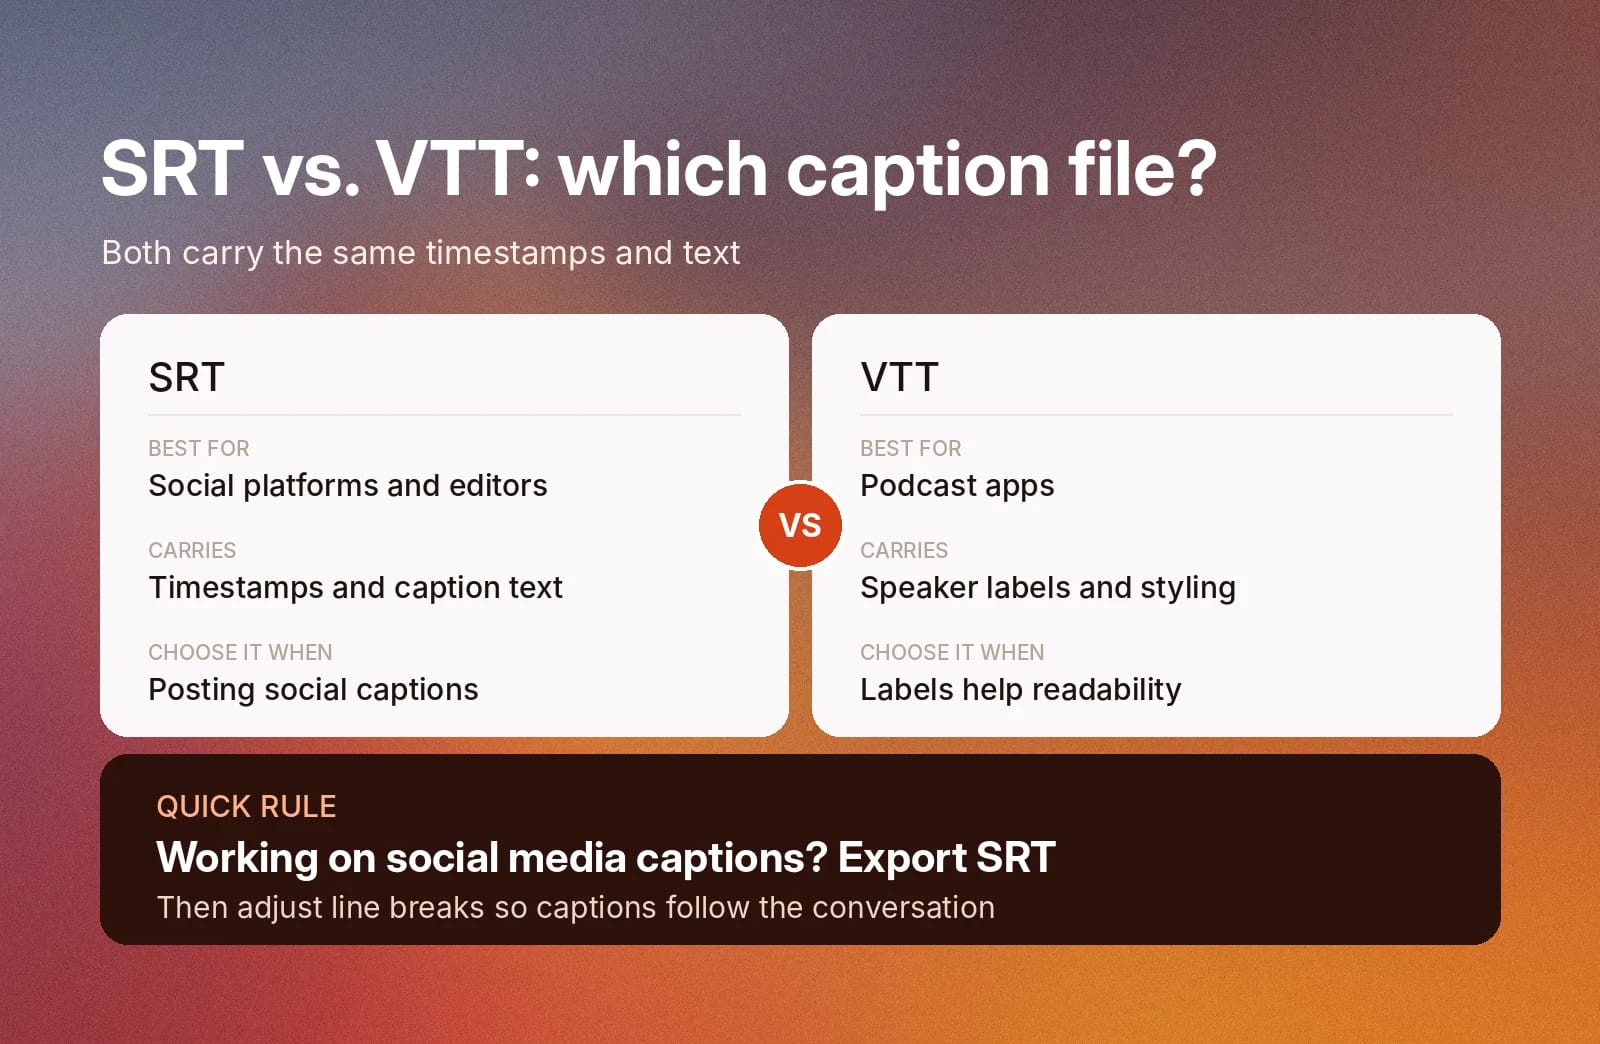
- Exportez un fichier SRT si vous souhaitez un fichier simple, compatible avec la plupart des plateformes sociales et logiciels de montage vidéo.
- Exportez un fichier VTT lorsque vous publiez des sous-titres ou des transcriptions dans des applications de podcast : il peut ajouter des étiquettes de locuteurs et une mise en forme basique qui améliore la lisibilité.
Pour les sous-titres destinés aux réseaux sociaux, le format SRT est probablement le bon choix.
Transcription épurée ou verbatim pour les sous-titres des réseaux sociaux
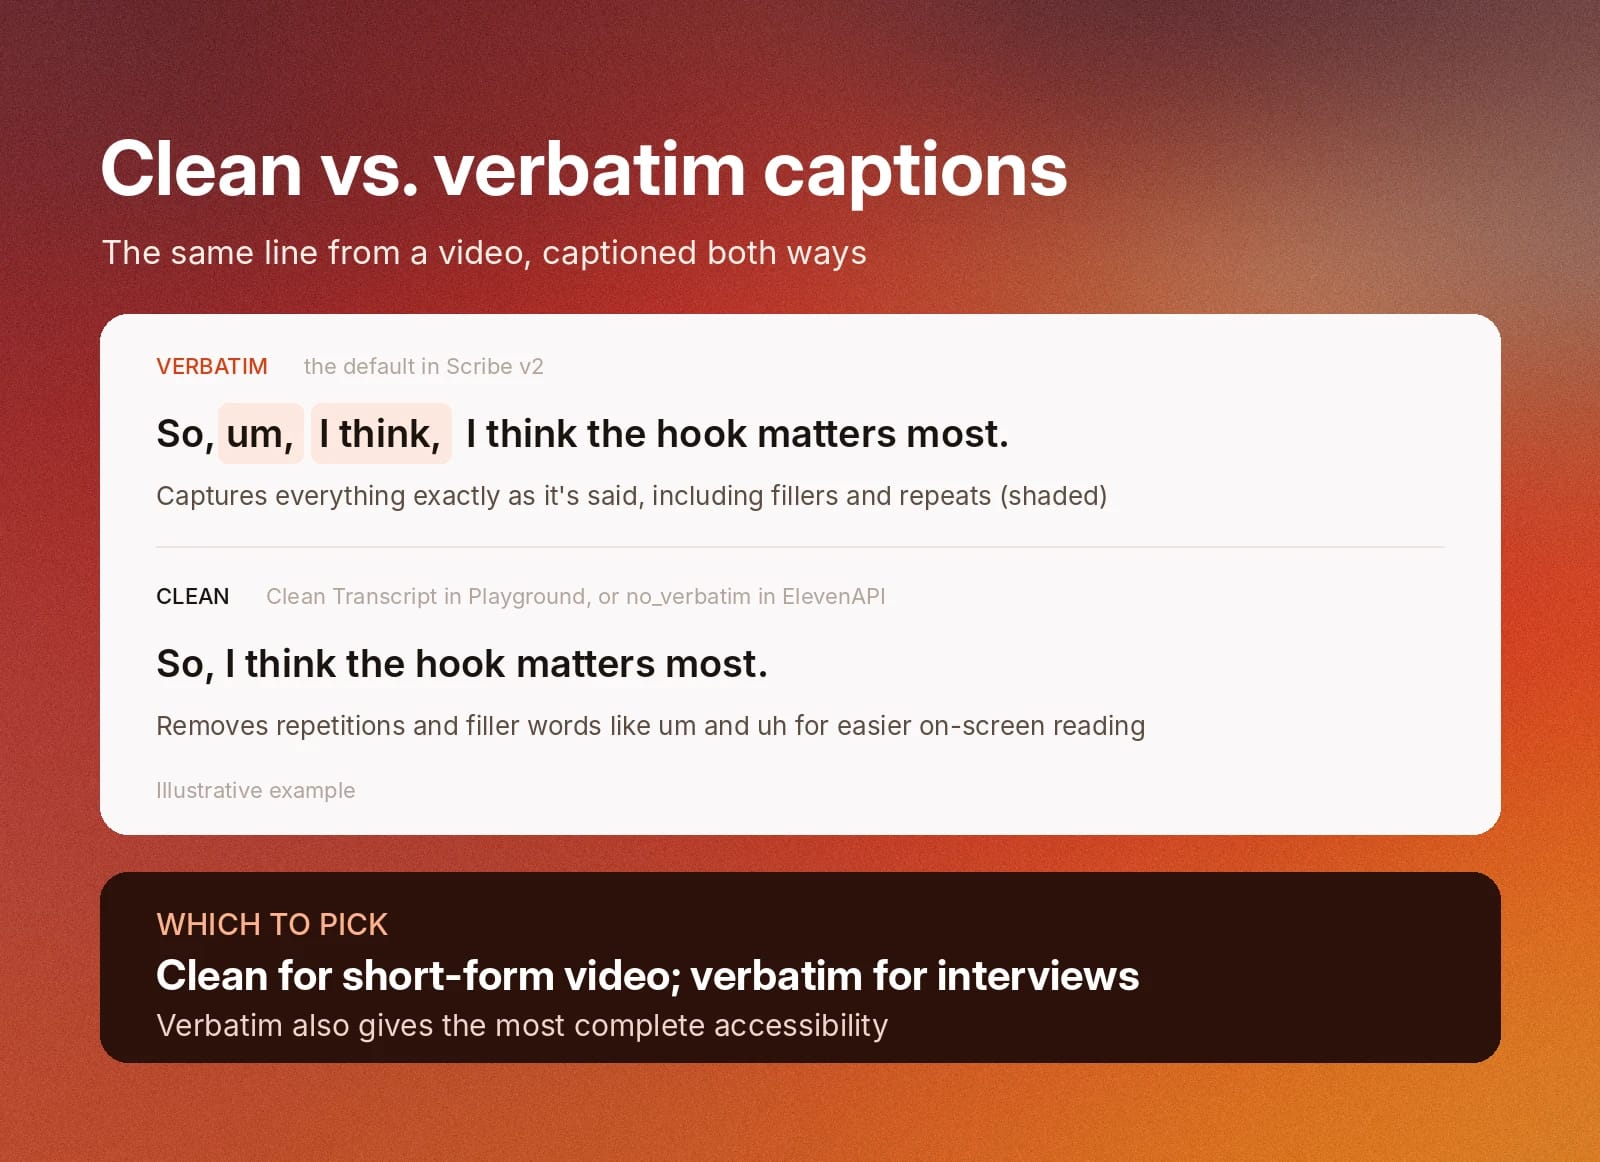
Pour créer des sous-titres destinés aux réseaux sociaux, vous pouvez choisir entre une transcription épurée et une transcription verbatim. La transcription épurée supprime les répétitions et les mots parasites comme « euh », tandis que la transcription verbatim restitue exactement tout ce qui est dit.
Les sous-titres épurés sont plus faciles à lire à l’écran, tandis que les sous-titres verbatim favorisent une accessibilité totale. Le bon choix dépend de votre audience et de ses besoins spécifiques.
ElevenLabs Scribe v2 utilise la transcription verbatim par défaut. Vous pouvez toutefois passer à une transcription épurée en activant « Clean Transcript » dans ElevenLabs Playground ou en utilisant le paramètre no_verbatim avec ElevenAPI.
Choisissez le mode épuré pour les vidéos courtes, que les spectateurs liront probablement en parcourant rapidement la vidéo. Le verbatim convient mieux aux entretiens longs ou aux recherches où la formulation exacte est importante.
Transcrire des podcasts pour créer des notes d’émission et réutiliser du contenu
Votre podcast constitue le socle de toute votre stratégie de contenu. Pour toucher un public plus large, transformez les idées abordées dans chaque épisode en notes d’émission, blogs, newsletters et contenus courts pour les réseaux sociaux.
Les outils de Speech to Text vous aident à transcrire vos épisodes de podcast afin de les réutiliser facilement. Une fois la transcription créée, vous pouvez la retravailler en notes d’émission que votre audience pourra consulter à tout moment.
Vous pouvez également transformer des sections de chaque transcription en contenu pour votre blog et votre newsletter, plutôt que de rédiger des articles de zéro. Vous touchez ainsi les audiences qui préfèrent lire plutôt qu’écouter.
Les bibliothèques de contenu écrit sont faciles à consulter. Si votre audience souhaite retrouver une idée évoquée dans un épisode précédent, il lui suffit de rechercher dans vos notes d’émission ou votre blog. Le contenu écrit apparaît aussi plus souvent dans les résultats de recherche que le contenu audio, ce qui renforce votre visibilité en ligne.
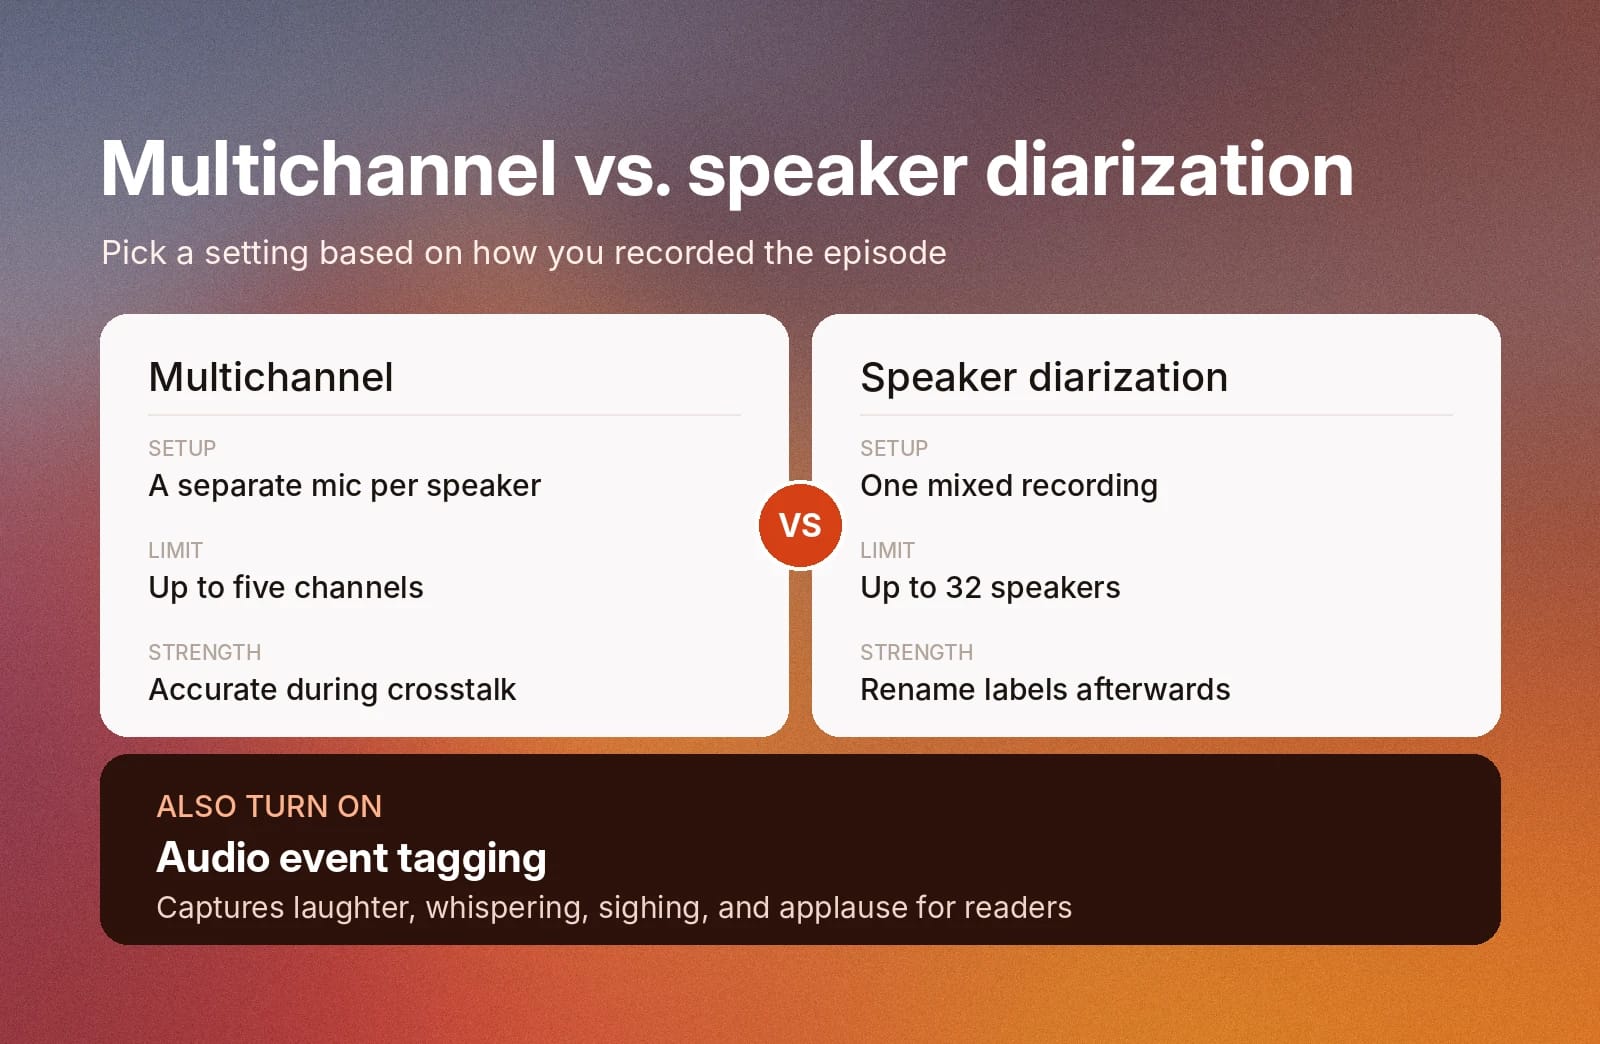
La manière la plus efficace de transcrire des podcasts consiste à utiliser une configuration de transcription multicanale. Pour cela, utilisez un microphone distinct pour chaque locuteur. Le modèle de transcription transcrira chaque locuteur séparément, pour des résultats précis même lorsque plusieurs personnes parlent en même temps.
Activez également le balisage des événements audio lors de la transcription de podcasts. Ce paramètre capture les rires, chuchotements, soupirs ou applaudissements afin que les lecteurs disposent de tout le contexte. Avec ElevenLabs Speech to Text, activez « Tag Audio Events » ou utilisez le paramètre tag_audio_events avec ElevenAPI.
Identifier les locuteurs dans un seul enregistrement
La transcription multicanale prend en charge jusqu’à cinq canaux. Si vous enregistrez toutes les voix sur une seule piste mixée ou si vous avez davantage de voix que de canaux, activez plutôt la diarisation des locuteurs. Scribe v2 attribue une étiquette à chaque locuteur dans la transcription et prend en charge jusqu’à 32 locuteurs simultanément. Après la transcription, vous pouvez renommer les locuteurs en cliquant sur le bouton de modification à côté de leur étiquette dans le Dashboard ElevenLabs.
Réutiliser des enregistrements en extraits, blogs et newsletters
Transcrivez un entretien une seule fois et réutilisez-le sur tous vos canaux de publication.
Une même transcription fournit les sous-titres et la matière première pour créer des extraits et du contenu écrit. Des créateurs et entreprises du monde entier utilisent ElevenLabs STT pour accélérer la transformation de podcasts en contenu écrit.
Chaque podcast, keynote et entretien que je réalise passe par le Speech to Text. Une seule transcription me fournit des sous-titres précis pour l’ensemble, les meilleurs passages à transformer en courtes vidéos et des citations clés que je convertis en contenu écrit.
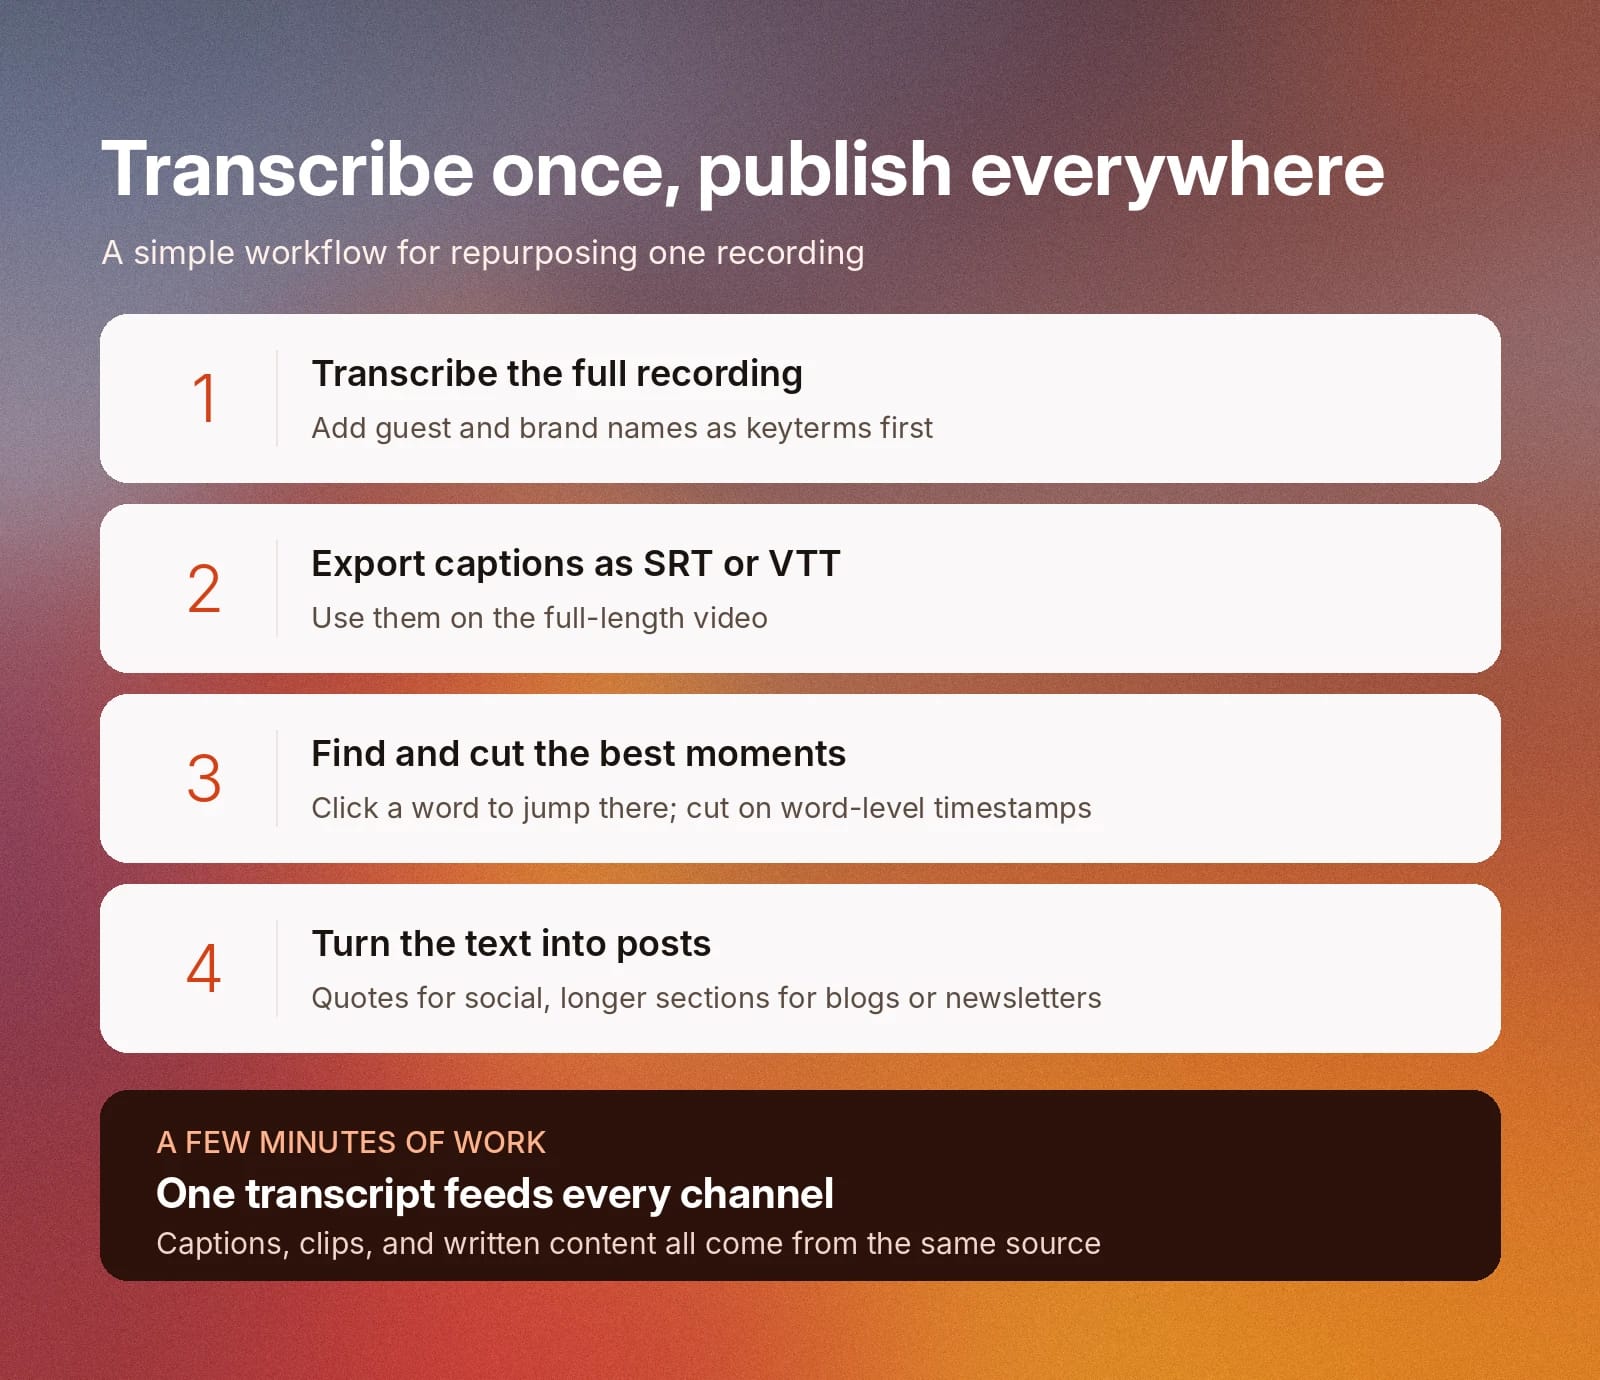
Voici un workflow simple de réutilisation que vous pouvez adopter :
- Transcrivez l’enregistrement complet et ajoutez les noms des invités et des marques à votre dictionnaire de prononciation.
- Exportez les sous-titres au format SRT ou VTT et utilisez-les sur la vidéo complète.
- Parcourez la transcription pour repérer les passages les plus forts. Cliquez sur un mot de la transcription pour accéder à ce passage dans l’audio, puis utilisez les horodatages au niveau du mot pour découper chaque extrait précisément au début et à la fin.
- Copiez les citations clés dans vos publications sur les réseaux sociaux et transformez les sections plus longues en article de blog ou newsletter.
Quelques minutes suffisent pour créer du contenu long format à partir des transcriptions STT de vos podcasts.
Transformer vos vidéos en transcriptions pour l’analyse par LLM
Après avoir transformé vos vidéos en texte, vous pouvez importer votre contenu en masse dans un LLM pour l’analyser. Identifiez de nouvelles idées, mettez en évidence les sujets que vous pouvez exploiter pour réutiliser votre contenu ou déterminez simplement ce qui fonctionne dans votre contenu.
Tout ce que je crée commence par ma voix, mais la plupart de mes outils IA fonctionnent encore mieux avec du texte. ElevenLabs Scribe est ma couche de traduction : il transforme mes vidéos en transcriptions afin que n’importe quel LLM puisse analyser ce qui fonctionne, et ce qui ne fonctionne pas. À mon avis, cela comble l’une des plus grandes lacunes de l’IA.
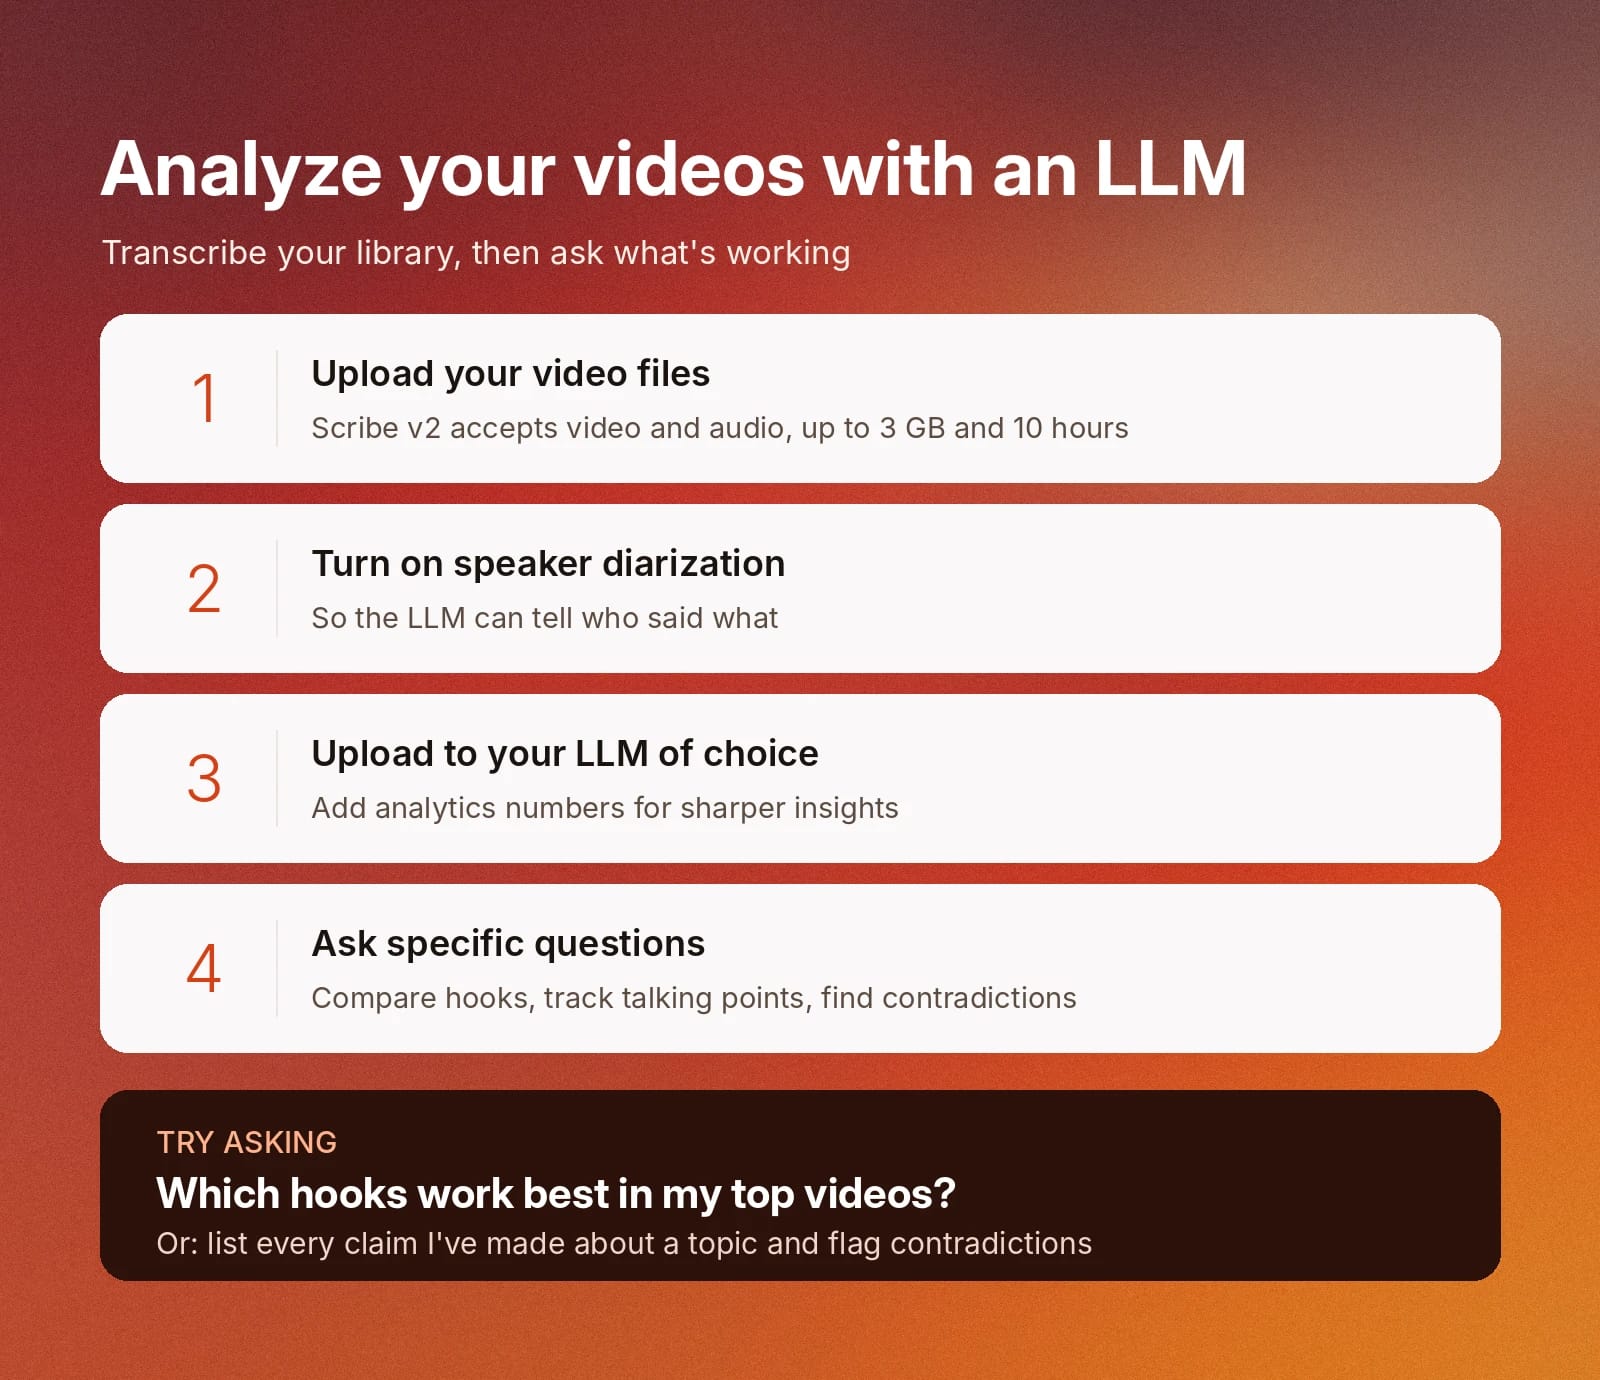
Voici comment mettre en place un workflow similaire :
- Importez vos fichiers vidéo pour la transcription : ElevenLabs STT accepte les vidéos comme les fichiers audio, jusqu’à 3 Go et 10 heures de durée.
- Activez la diarisation des locuteurs : Si plusieurs personnes parlent, activez la diarisation pour que le LLM puisse distinguer qui a dit quoi.
- Importez dans le LLM de votre choix : Ajoutez des chiffres analytiques ou des informations supplémentaires pour enrichir les enseignements que vous pouvez en tirer.
- Posez des questions précises sur votre contenu : Des requêtes telles que « Comparez les 20 premières secondes de mes vidéos les plus performantes pour voir quelles accroches fonctionnent le mieux auprès de mon audience » ou « Listez toutes les affirmations que j’ai faites sur le sujet X et signalez les éventuelles contradictions » peuvent révéler de nouveaux enseignements.
Dicter des prompts et des notes
La saisie vocale vous permet de fournir à un outil IA le contexte et les nuances que vous pourriez omettre si vous deviez tout taper. Le Speech to Text transforme vos propos en texte que vous pouvez coller directement dans un prompt, un brief ou vos notes. Certains rédacteurs utilisent même le STT pour écrire plus vite, en transcrivant leur parole plutôt qu’en tapant tout leur texte.
Je ne peux pas imaginer travailler sans cela, surtout pour rédiger des prompts. Chaque interaction avec l’IA exige tellement de nuances, et je n’ai pas envie de tout taper.
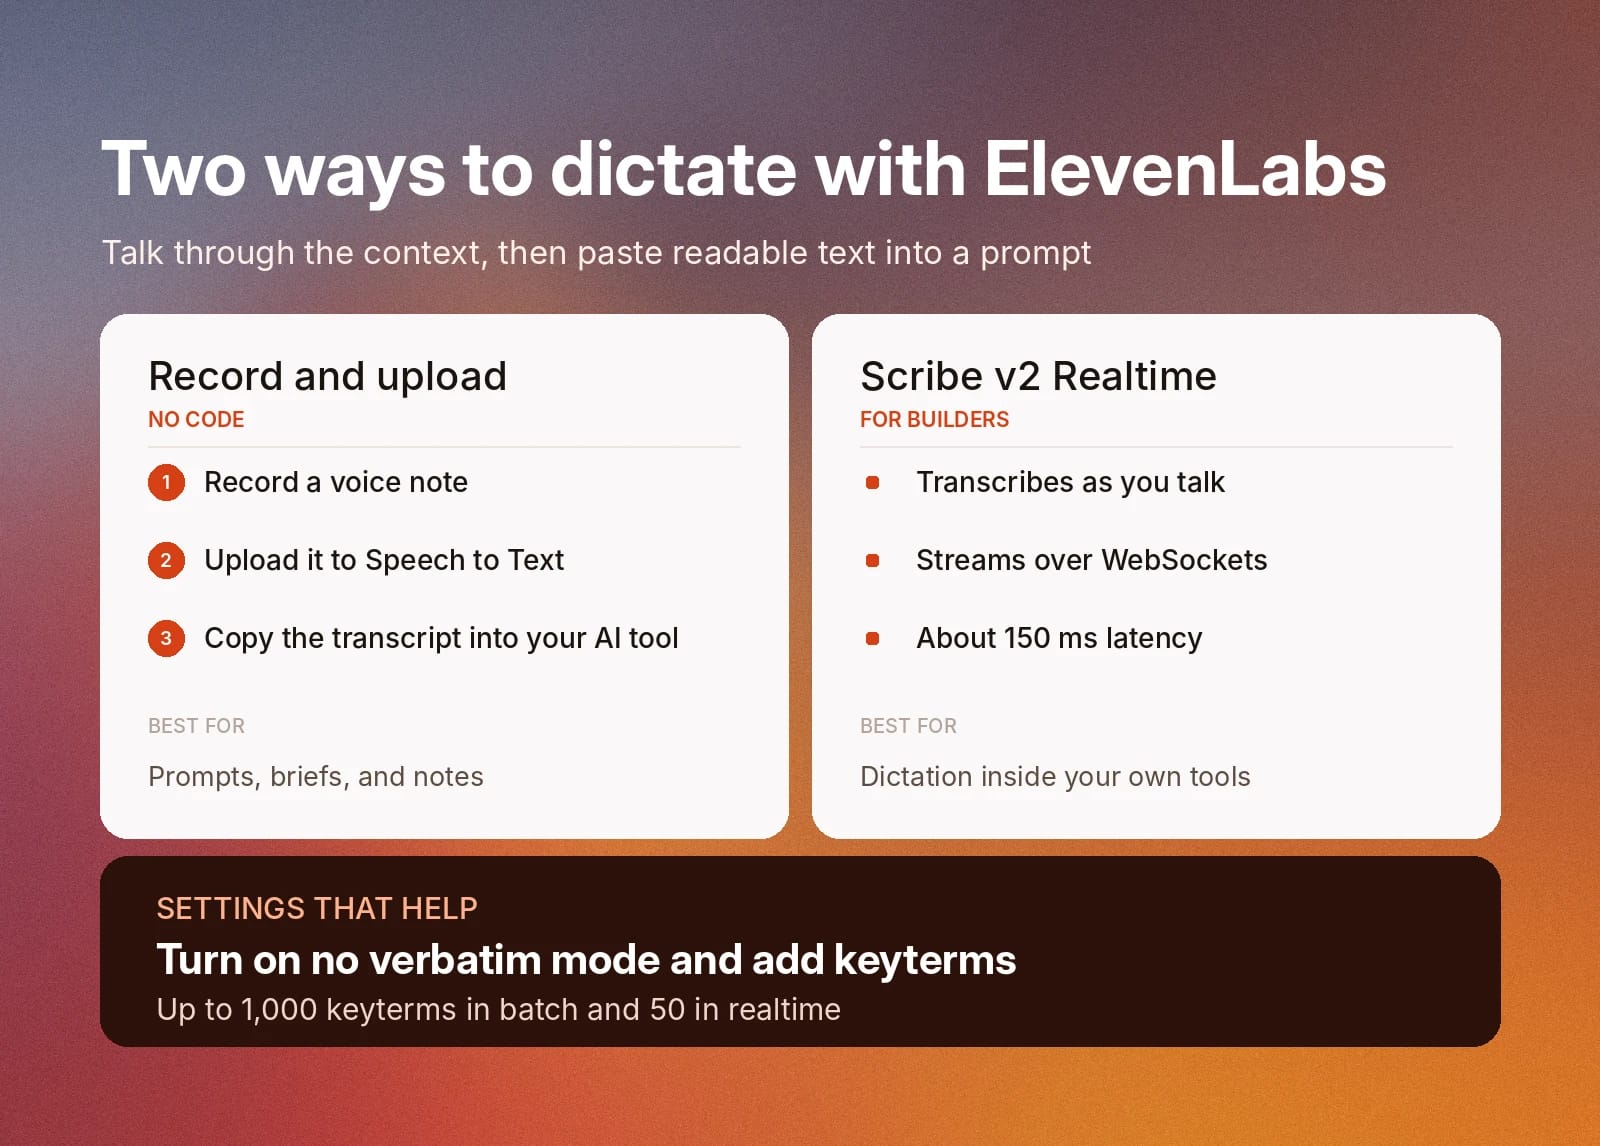
Il existe deux façons de dicter avec ElevenLabs :
- Enregistrez et importez : Enregistrez une note vocale, importez-la sur la page ElevenLabs Speech to Text, puis copiez la transcription dans votre outil IA.
- Diffusez en temps réel : Si vous concevez vos propres outils, Scribe v2 Realtime transcrit la parole au fur et à mesure que vous parlez via WebSockets, avec une faible latence d’environ 150 ms selon la documentation.
Veillez à activer le mode sans verbatim, qui supprime les mots parasites, les faux départs et les hésitations, afin qu’une note vocale décousue devienne un texte lisible. Ajoutez ensuite, avec le prompting par termes clés, les noms de produits et le jargon que vous utilisez souvent pour garantir leur transcription correcte à chaque fois. La transcription par lots accepte jusqu’à 1 000 termes clés, contre 50 en temps réel.
Bien transcrire les noms, marques et termes de niche avec le STT
Les modèles de Speech to Text ne reconnaissent pas toujours les noms des locuteurs, des marques ou les termes propres à un secteur. Lorsque vous transcrivez votre contenu, utilisez le prompting par termes clés pour préciser l’orthographe et la mise en forme.
Le prompting par termes clés vous permet de fournir l’orthographe correcte des noms ou des termes de niche avant le début de la transcription. Pour chaque vidéo ou épisode de podcast, ajoutez les noms des invités, chaînes ou marques que vous mentionnez fréquemment. Vous devrez peut-être également ajouter du jargon sectoriel ou d’autres termes de niche.
Le prompting par termes clés rend vos transcriptions plus précises et plus faciles à lire pour votre audience. Il accélère aussi le processus d’édition, car vous n’aurez pas à corriger ces termes manuellement.
Toucher des audiences dans d’autres langues
Les modèles de Speech to Text vont au-delà de la transcription. En tant que créateur de contenu, vous pouvez aussi les utiliser pour localiser votre contenu et toucher des audiences parlant d’autres langues.
ElevenLabs Scribe v2 transcrit du contenu dans plus de 90 langues. Associez-le à ElevenLabs Dubbing Studio pour mettre en place un workflow de localisation complet.
Pour cela, importez l’audio dans Dubbing Studio afin de doubler le contenu dans votre langue de prédilection. Transcrivez ensuite l’audio doublé pour créer des sous-titres, notes d’émission ou autres contenus écrits localisés.
Ce que le Speech to Text ne fait pas pour vous
Le Speech to Text est un outil puissant, mais il a ses limites. Les modèles de Speech to Text transcrivent l’audio avec des horodatages précis, mais ne sont pas des logiciels de montage vidéo. Vous devrez utiliser une plateforme de montage vidéo distincte pour créer le produit final.
Lorsque vous créez du contenu, commencez par utiliser le Speech to Text pour transcrire l’audio. Exportez ensuite la transcription brute et les sous-titres afin de les utiliser dans l’ensemble de vos contenus. Importez les sous-titres dans votre éditeur vidéo ou directement sur les réseaux sociaux, et utilisez la transcription comme base pour vos notes d’émission, articles de blog et autres contenus écrits.
Veillez à vérifier chaque transcription avant de la publier, en particulier les noms et les passages où plusieurs locuteurs parlent simultanément. Le Transcript Editor vous permet de corriger facilement les erreurs dans l’application.
Comment choisir le meilleur outil de Speech to Text pour les créateurs de contenu
Le bon outil STT transforme votre enregistrement en texte propre, correctement orthographié et horodaté, pour réutiliser votre contenu aussi facilement que possible.
Lorsque vous recherchez la meilleure plateforme de Speech to Text, assurez-vous qu’elle réunit ces cinq éléments :
- Précision dans votre langue : Les performances des STT peuvent varier selon les langues, en particulier celles pour lesquelles peu de données sont disponibles. Recherchez des chiffres publiés sur la précision. Par exemple, ElevenLabs Scribe v2 atteint 98 % de précision (environ 2 % de WER) dans des langues comme l’anglais, le français, l’italien, l’espagnol et d’autres.
- Gestion des noms et du jargon sectoriel : Votre modèle STT doit pouvoir comprendre le contexte de vos conversations et les transcrire avec précision. Recherchez des plateformes STT proposant le prompting par termes clés et des dictionnaires de prononciation.
- Horodatages et formats d’exportation : Vous aurez besoin d’horodatages au niveau du mot et de la possibilité d’exporter des sous-titres SRT ou VTT.
- Gestion des locuteurs : En particulier si vous travaillez avec des fichiers audio comptant plusieurs locuteurs, identifier précisément chaque voix aidera à conserver des transcriptions claires.
- Limites de fichiers : Pour les projets audio ou vidéo plus volumineux, comme les podcasts, vous devrez peut-être gérer des fichiers plus lourds. ElevenLabs accepte les fichiers jusqu’à 3 Go et, en mode standard, jusqu’à 10 heures.
Voici comment un modèle STT dédié tel qu’Eleven Scribe v2 se compare aux outils de sous-titrage automatisés intégrés aux plateformes sociales :
Vos besoins
Sous-titres automatiques de plateforme
Modèle dédié tel que Scribe v2
Orthographe correcte des noms et marques
Peut faire des erreurs
Prompting par termes clés, jusqu’à 1 000 termes par requête par lots
Ponctuation lisible
Souvent limitée
Résultat épuré avec le mode sans verbatim
Réutiliser le texte ailleurs
Les sous-titres restent sur la plateforme
Téléchargez la transcription et les sous-titres, puis utilisez-les partout
Synchronisation
Liée au lecteur de cette plateforme
Horodatages au niveau du mot à réutiliser dans vos extraits
Langues
Varie selon la plateforme
Plus de 90 langues
Deux façons de commencer : importation sans code ou API
Avec ElevenLabs, vous disposez de deux méthodes pour transcrire votre contenu vidéo avec le Speech to Text.
La première consiste à importer votre fichier audio dans le Dashboard ElevenLabs Playground. Ajustez vos paramètres de transcription, modifiez le résultat directement dans le Transcript Editor, puis exportez-le dans le format de fichier souhaité. Le processus est rapide, simple et sans coder.
Si vous concevez votre propre workflow de publication de contenu, vous pouvez également transcrire à l’aide de ElevenAPI. Intégrez directement l’API aux outils que vous concevez déjà pour obtenir les mêmes transcriptions précises sans changer d’outil.
S'inscrire à ElevenLabs pour commencer à utiliser le STT dès aujourd’hui, ou en savoir plus sur la manière dont le Speech to Text transforme le travail des créateurs.
FAQ

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.



